Knowledge Distillation of Large Language Models

这是大模型系列模型的文章,针对《Knowledge Distillation of Large Language Models》的翻译。

摘要

知识蒸馏(KD)是一种很有前途的技术,可以减少大型语言模型(LLM)的高计算需求。然而,以前的KD方法主要应用于白盒分类模型或训练小模型来模仿像ChatGPT这样的黑盒模型API。如何有效地从白盒生成LLM中提取知识仍有待探索,随着LLM的蓬勃发展,这一点变得越来越重要。在这项工作中,我们提出了MINILLM,它从生成的较大语言模型中提取较小的语言模型。我们首先将标准KD方法中的前向Kullback-Leibler散度(KLD)目标替换为更适合生成语言模型上的KD的反向KLD,以防止学生模型高估教师分布的低概率区域。然后,我们推导出一种有效的优化方法来学习这个目标。在指令跟随设置中的大量实验表明,MINILLM模型生成更精确的响应,具有更高的整体质量、更低的曝光偏差、更好的校准和更高的长文本生成性能。我们的方法也适用于具有120M到13B参数的不同模型族。我们将在https://aka.ms/MiniLLM发布我们的代码和模型检查点。

1 引言
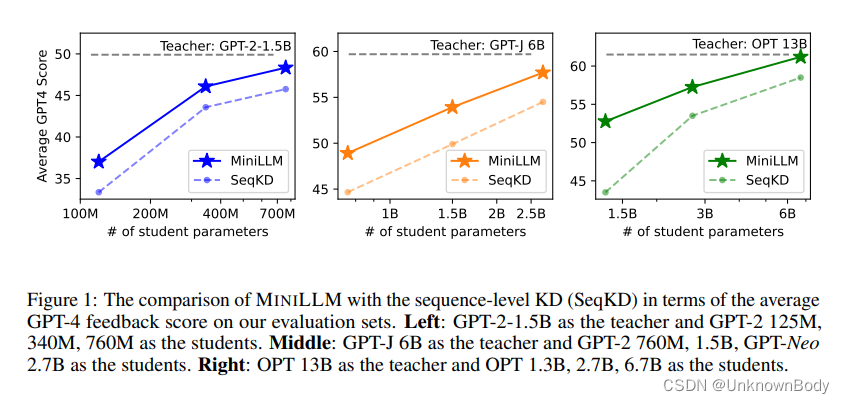
在这里插入图片描述
随着大型语言模型(LLM; H Z D + HZD^+

《MiniLLM: Knowledge Distillation of Large Language Models》论文阅读 知识蒸馏(Knowledge Distillation, KD)是一种有前景的技术,能够减少LLMs的高计算需求。然而,以往的KD方法主要应用于白盒分类模型或通过模仿黑箱模型API(如ChatGPT)来训练小型模型。如何有效地将白盒LLMs的知识蒸馏到小型模型中仍然是一个未充分探索的领域,而随着开源LLMs的兴起,这一问题变得愈发重要。在本研究中,我们提出了一种KD方法,将LLMs蒸馏到较小的语言模型中。 阅读详情

相关推荐

【大模型】大模型知识蒸馏 综述解读(Knowledge Distillation of Large Language Models)

知识蒸馏的(论文)方法总结。归纳了通过数据(如指令、对话、多模态)和训练方法(SFT、RL、数据增强),将复杂技能(如对齐、工具使用、多模态)蒸馏到开源模型的核心框架,附典型模型示例(如Alpaca、LLaVA)。

songxia928_928的博客 4337

A Survey on Symbolic Knowledge Distillation of Large Language Models

本调查论文深入探讨了大型语言模型 (LLM) 中符号知识蒸馏的新兴关键领域。随着生成式预训练 Transformer-3 (GPT-3) 和来自 Transformers 的双向编码器表示 (BERT) 等 LLM 在规模和复杂性上不断扩大,有效利用其广泛知识的挑战变得至关重要。本调查集中于将这些模型中包含的复杂、通常隐含的知识蒸馏成更具象征意义、更明确的形式的过程。这种转变对于提高 LLM 的可解释性、效率和适用性至关重要。

c_cpp_csharp的专栏 331

A Survey on Knowledge Distillation of Large Language Models

在大型语言模型(LLM)时代,知识蒸馏(KD)成为将先进功能从领先的专有LLM(如GPT-4)转移到LLaMA和Mistral等开源同行的关键方法。此外,随着开源LLM的蓬勃发展,KD在压缩这些模型和通过聘请自己作为教师促进他们的自我改进方面发挥着至关重要的作用。本文对KD在LLM领域中的作用进行了全面的调查,强调了它在向小型模型传授先进知识方面的关键作用,以及它在模型压缩和自我改进中的实用性。

c_cpp_csharp的专栏 539

The Valley of Code Reasoning: Scaling Knowledge Distillation of Large Language Models

研究背景:现有研究已证实可将大语言模型(LLM)的推理轨迹蒸馏到小模型中,但缺乏对“蒸馏数据量如何影响小模型性能”的探索,且未明确数据特征(正确性、难度)在不同蒸馏阶段的作用。核心发现存在“代码推理谷”:在1K-30K数据量范围内,小模型(Qwen2.5-7B-Instruct、Llama3.1-8B-Instruct)的代码推理性能(以LIVECODEBENCH为基准)并非随数据量单调上升,而是先下降(1K数据时性能较基线下降超50%),后以超对数线性趋势稳步提升(30K数据时性能显著超越基线)。

UnknownBody_2的博客 175

Survey on Knowledge Distillation for Large Language Models: Methods, Evaluation, and Application

大型语言模型 (LLM) 在各个领域都展示了卓越的能力,吸引了学术界和工业界的浓厚兴趣。尽管 LLM 的性能令人印象深刻,但其庞大的规模和计算需求对实际部署构成了相当大的挑战,尤其是在资源有限的环境中。在保持其准确性的同时压缩语言模型的努力已成为研究的重点。在各种方法中,知识蒸馏已成为一种有效的技术,可以在不大幅影响性能的情况下提高推理速度。本文从方法、评价和应用三个方面进行了深入的调查,探讨了专门为 LLM 量身定制的知识提炼技术,具体来说,我们将方法分为白盒 KD 和黑盒 KD,以更好地说明它们的差异。

c_cpp_csharp的专栏 340

Knowledge Editing for Large Language Models: A Survey

大型语言模型(LLM)最近改变了学术界和工业界的格局,因为它们具有基于丰富的知识和推理能力理解、分析和生成文本的非凡能力。然而,LLM的一个主要缺点是,由于其前所未有的参数数量,其预训练的计算成本巨大。当经常需要将新知识引入预先训练的模型中时,这种劣势会加剧。因此,必须开发有效和高效的技术来更新预先训练的LLM。传统方法通过直接微调将新知识编码在预先训练的LLM中。然而,天真地重新训练LLM可能是计算密集型的,并且有可能退化与模型更新无关的有价值的预先训练的知识。

c_cpp_csharp的专栏 498

LEVERAGING LARGE LANGUAGE MODELS FOR ENHANCED NLP TASK PERFORMANCE THROUGH KNOWLEDGE DISTILLATION

GPT-4等新兴的大型语言模型(LLM)彻底改变了自然语言处理(NLP),在命名实体识别(NER)等传统任务中显示出潜力。我们的研究探索了一种三阶段训练策略,该策略利用GPT-4的能力来提高BERT模型在NER上的性能。最初,GPT-4在不进行微调的情况下注释CONLL2003的一个子集和额外的BBC数据集。然后,我们使用原始数据和LLM注释数据的组合来训练BERT,分析LLM注释相对于传统方法的有效性。第二阶段涉及不同训练方案的比较实验,评估蒸馏数据和原始数据之间的协同作用。

c_cpp_csharp的专栏 241

Multimodal Intention Knowledge Distillation from Large Language Models

社交媒体已经成为一种无处不在的工具,可以与他人联系、随时了解新闻、表达意见和寻找娱乐。然而,理解社交媒体帖子背后的意图仍然具有挑战性,因为这些意图具有隐含性和常识性,需要对文本和图像进行跨模态理解,以及存在诸如标签、拼写错误的单词和复杂缩写等嘈杂信息。为了应对这些挑战,我们提出了Miko,这是一个多模态意图知识提取框架,它协同利用大型语言模型(LLM)和多模态大型语言模式(MLLM)来揭示用户的意图。具体来说,我们使用MLLM来解释图像,使用LLM来从文本中提取关键信息,并最终再次指示LLM生成意图。

c_cpp_csharp的专栏 367

IMPROVING QUANTIZED KNOWLEDGE DISTILLATION VIA SIGNAL PROPAGATION ANALYSIS FOR LARGE LANGUAGE MODELS

大型生成模型,如大型语言模型(LLM)和扩散模型,分别彻底改变了NLP和计算机视觉领域。然而,它们的推理速度慢、计算量和内存需求高,使得将它们部署在边缘设备上具有挑战性。在这项研究中,我们提出了一种轻量级的量化感知微调技术,使用知识蒸馏(KD-QAT)来提高4位加权量化LLM的性能,使用常见的数据集来实现流行的语言用例,即设备聊天应用程序。为了改进这种微调范式,作为主要贡献,我们通过实证研究训练过程中的梯度传播来深入了解KD-QAT的稳定性,以更好地理解基于KDQAT的方法对低位量化误差的脆弱性。

c_cpp_csharp的专栏 208

Direct Preference Knowledge Distillation for Large Language Models

在大型语言模型 (LLM) 领域,知识蒸馏 (KD) 是将功能从教师模型迁移到学生模型的关键技术。然而,现有的 KD 方法在蒸馏 LLM 方面面临局限性和挑战,包括效率和传统 KL 散度测量能力不足。结果表明,LLM 可以作为隐式奖励函数,我们将其定义为 KL 分歧的补充。在这项工作中,我们提出了 LLM 的直接偏好知识蒸馏 (DPKD)。我们将 LLM 的 KD 重新表述为两个阶段:首先优化和目标,包括隐性奖励和反向 KL 发散,然后提高教师产出对学生产出的偏好概率。

c_cpp_csharp的专栏 407

Evolving Knowledge Distillation with Large Language Models and Active Learning

大型语言模型(LLM)已经在各种NLP任务中展示了非凡的能力。然而,它们的计算成本高得令人望而却步。为了解决这个问题,先前的研究试图通过生成注释数据将LLM的知识蒸馏到更小的模型中。尽管如此,这些工作主要集中在LLM用于文本生成和标记的直接使用上,而没有充分探索其理解目标任务和获取有价值知识的潜力。在本文中,我们提出了EvoKD:进化知识蒸馏,它利用主动学习的概念来交互式地增强使用大型语言模型的数据生成过程,同时提高小域模型(学生模型)的任务能力。

c_cpp_csharp的专栏 280

提升AI智能体回复质量:扣子平台提示词优化技巧与案例解析

本文深入探讨了在扣子平台上优化AI智能体提示词的关键技巧与实战案例。通过分析提示词设计的核心原则、业务场景适配策略以及平台高级功能应用,帮助开发者显著提升AI Agent的回复质量。文章特别强调了结构化提示词设计和A/B测试评估的重要性,并提供了电商客服场景的完整优化案例。

weixin_30897233的博客 538

【codex教程】Codex 注册和使用教程(2026最新版)

Codex 是 OpenAI 推出的 AI 编程助手,可以帮助开发者阅读代码、修改代码、运行命令、生成测试、排查 bug、做代码审查,也可以在终端、IDE、Codex App 或网页端使用。根据 OpenAI 帮助中心,截至 2026 年 6 月,Codex 已包含在 Free、Go、Plus、Pro、Business、Edu 和 Enterprise 等 ChatGPT 方案中,但不同套餐的使用额度会有所不同。适合开发者在终端中使用。如果你想在命令行里使用 Codex,可以安装 Codex CLI。

与时俱进,开放共享 2万+

【读代码】TradingAgents:基于多智能体LLM的金融交易框架深度解析

TradingAgents是由Tauric Research团队开源的创新型金融交易框架,其核心思想是通过多智能体协作系统模拟专业交易机构的决策流程。项目采用模块化设计,整合了LLM、实时数据分析、风险控制等组件,实现了从市场分析到交易执行的完整闭环。

kakaZhui的博客 2004

【电商风控】电商风控标注是什么

本篇文章给大家谈谈。

866

树莓派+STM32+激光雷达:大学生工训赛智能物流小车全栈开发实录(附避坑指南)

本文详细记录了基于树莓派、STM32和激光雷达的智能物流小车全栈开发过程。文章从系统架构设计、硬件集成、软件框架搭建到机械臂控制与视觉辅助定位,系统阐述了如何构建一个完整的机器人系统,并分享了在电源管理、通信延迟、里程计误差等关键环节的实战避坑指南,为嵌入式与机器人开发提供了宝贵经验。

kotlin6android的博客 748

高频注入是否需要对齐和强拖操作?

高频注入技术显著优化了传统FOC启动流程,但仍需部分对齐操作。传统启动必须包含位置检测、对齐和强拖等步骤,而高频注入可实现零速闭环,简化或跳过部分环节。高频注入下的对齐主要用于验证有效性、初始化观测器和建立初始磁链,形式可大幅简化。虽然高频注入基本消除了传统强拖需求,但在重载、弱凸极等特殊情况下仍需辅助。实际应用中可采用自适应混合策略,根据负载和电机类型选择最优启动方案。高频注入使对齐和强拖从"必须"变为"可选优化项",是无传感器控制的重要进步。

汽车软件开发 207

OpenClaw终于有了图形界面,一键安装使用你的24小时AI 研究助手!

ClawX是连接强大 AI 智能体与普通用户之间的桥梁。基于OpenClaw构建,它将命令行式的 AI 编排转变为易用、美观的桌面体验——无需使用终端。无论是自动化工作流、连接通讯软件,还是调度智能定时任务,ClawX 都能提供高效易用的图形界面,帮助你充分发挥 AI 智能体的能力。ClawX 预置了最佳实践的模型供应商配置,原生支持 Windows 平台以及多语言设置。当然,你也可以通过设置 → 高级 → 开发者模式来进行精细的高级配置。

Maynor的博客 3392

增益调度控制 —— 理论、案例与交互式 GUI 实现

本文详细介绍了增益调度控制的基本原理、数学模型及公式推导,探讨了该方法在适应非线性系统和大范围工作条件下的优势与局限。通过航空飞行控制、发动机推力控制以及化工过程控制三个典型案例,我们展示了如何利用调度变量动态调整控制增益,从而使得控制系统在各个工作点均能达到优良性能。为帮助工程师和研究者更直观地理解并验证增益调度控制的实际效果,本文提供了一套基于 Python 与 PyQt6 的交互式 GUI 控制系统代码。用户不仅可以实时查看仿真数据,还能通过在线调节参数直观体验调度控制的优势。

闲人编程的博客 1480

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

上一篇: A Survey of Large Language Models
下一篇: Beyond One-Model-Fits-All: A Survey of Domain Specialization for Large Language Models
UnknownBody
博客等级 码龄16年 5601粉丝 4739原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

UnknownBody

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

