爬虫基础urllib 之(二) --- urllib基础

能爬取什么样的数据

  网页文本:如HTML文档,Json格式化文本等
  图片:  获取到的是二进制文件,保存为图片格式
  视频:        同样是二进制文件
  其他:     只要请求到的,都可以获取

如何解析数据

  1. 直接处理
  2. Json解析
  3. 正则表达式处理
  4. BeautifulSoup解析处理
  5. PyQuery解析处理
  6. XPath解析处理

抓取的页面数据和浏览器里看到的不一样的问题

  因为很多网站中的数据都是通过js,ajax动态加载的,所以直接通过get请求获取的页面和浏览器显示的不同。

  如何解决js渲染问题:

    分析ajax
    Selenium/webdriver
    Splash
    PyV8,Ghost.py

保存数据

  文本: 纯文本,Json,Xml等

  关系型数据库:   Mysql,oracle,sql server等结构化数据库

  非关系型数据库:MongoDB,Redis等key-value形式存储

urllib

 官方文档:https://docs.python.org/zh-cn/3/library/urllib.html

urllib介绍

Urllib是python内置的HTTP请求库,是python提供的一个用于发起和处理http请求和响应的框架。

后期的一些框架,比如: requests、 scrapy等都是基于它

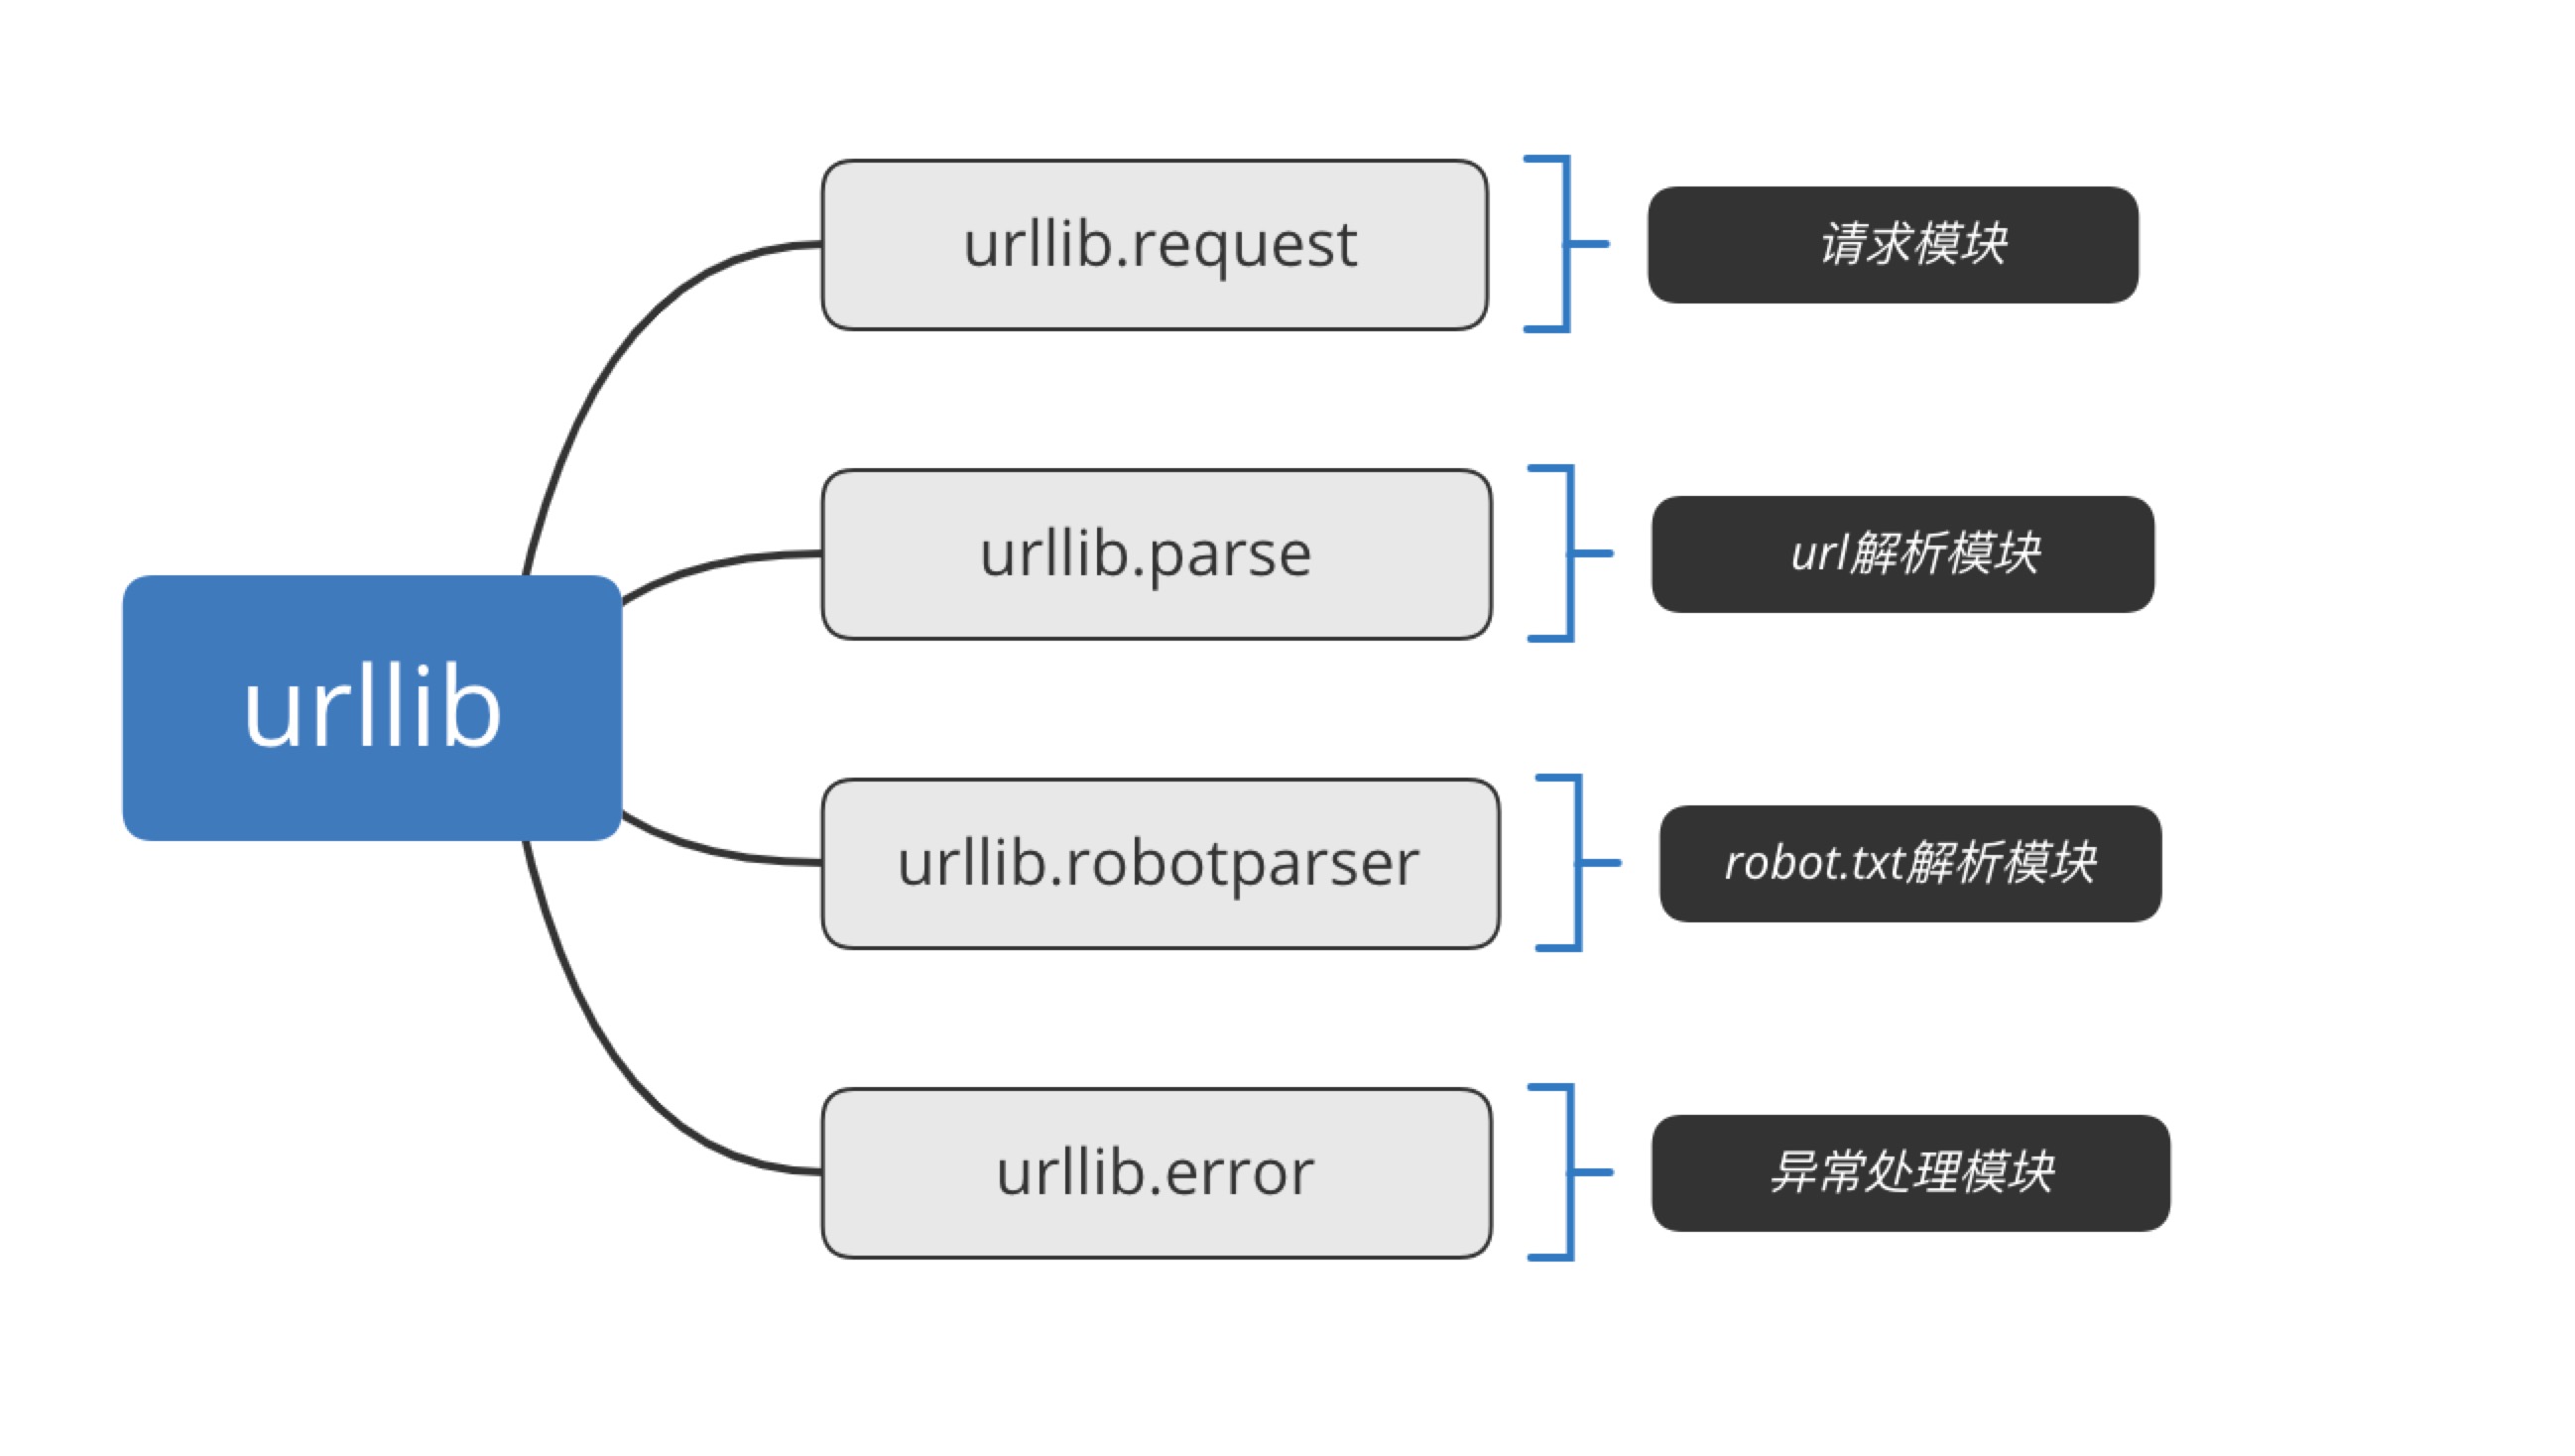
包括以下四个模块:

  urllib.error        异常处理模块
  urllib.request      请求模块
  urllib.parse       url解析模块
  urllib.robotparser     robots.txt解析模块


转载于:https://www.cnblogs.com/TMMM/p/10821797.html

【Halcon-2D测量】set_metrology_object_param 函数功能(用于配置计量对象常规参数) HALCON算子 set_metrology_object_param 是2D计量模块的核心配置工具,用于动态修改计量对象的测量区域、边缘检测和几何拟合参数。该算子需在检测前调用,支持批量或单独修改对象参数,包含三类关键参数:测量区域(如长度、间距)、边缘检测(如平滑Sigma、阈值)和几何拟合(如RANSAC阈值、最小分数)。使用时需注意参数互斥规则(如measure_distance优先于num_measures)和多线程同步要求。算子无输出参数,仅修改计量模型内部状态,需配合apply_metrolo 阅读详情

相关推荐

最新Mamba环境配置教程:从CUDA到causal-conv1d的完整安装流程

本文提供最新Mamba环境配置教程,涵盖从CUDA到causal-conv1d的完整安装流程。针对深度学习领域的长序列处理需求,详细指导如何正确配置CUDA工具链、安装PyTorch及关键依赖causal-conv1d,解决常见报错问题,并验证mamba-ssm集成效果。

bush的博客 418

爬虫基础之基本库urllib的使用

文章目录使用urllib发送请求1.urlopen()Request高级用法处理异常1.URLError2.HTTPError解析链接1.urlparse()2.urlunparse()3.urlsplit()4.urlunsplit()5.urljoin()6.urlencode()7.parse_qs()8.parse_qsl()9.quote()10.unquote()分析Robots协议1.Robots协议2.爬虫名称3.robotparser 使用urllib 在python2中,有urllib和

降温的博客 425

matlab2021a版本条件下安装spm

SPM (Statistical Parametric Mapping),中文名叫统计参数映射。统计参数映射是指构建和评估空间扩展的统计过程,用于测试关于功能成像数据的假设。这些想法已经在名为SPM的免费开源软件中得到了实例化。SPM软件包用于脑成像数据序列分析。目前的版本可以分析fMRI, PET, SPECT, EEG和MEG。 可能由于matlab版本更新的问题,按照之前教程所写的安装方法会出现错误,踩了一些坑,但好在最终解决了。。。 1、下载链接,如下 SPM12 Software -...

qq_42356925的博客 8405

常用python爬虫框架整理

Python中好用的爬虫框架 一般比价小型的爬虫需求,我是直接使用requests库 + bs4就解决了,再麻烦点就使用selenium解决js的异步 加载问题。相对比较大型的需求才使用框架,主要是便于管理以及扩展等。 1.Scrapy Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。 可...

weixin_34059951的博客 1899

汇川EASY系列之以太网通讯(套接字socket做主站)

本文讲解汇川Easy系列使用以太网套接字socket通讯,本例中EasyPLC做主站。文中按步进行操作。细节明确。

这是一个长期关注工控行业技术的博客,实现0-1的突破,期待您的关注和留言 2191

手把手教你用Cursor + 自定义MCP工具链,让AI帮你搞定App逆向(附adb-mcp/frida-mcp源码)

本文详细介绍了如何利用Cursor IDE与自定义MCP工具链构建AI驱动的App逆向工作流,涵盖adb-mcp和frida-mcp的源码实现与实战应用。通过自然语言指令,AI可自动化完成设备控制、动态Hook和数据分析,显著提升移动安全测试效率。适合安全研究人员和开发者快速掌握智能逆向技术。

weixin_33737134的博客 1301

python爬虫 (一) 爬虫基础了解,urllib

• URL的含义: 统一资源定位符,结构: URL的格式由三部分组成: ①第一部分是协议(或称为服务方式)。 ②第二部分是存有该资源的主机IP地址(有时也包括端口号)。 ③第三部分是主机资源的具体地址,如目录和文件名等。 关于URL和URI的区别:https://www.zhihu.com/question/21950864 • 环境的配置 IDE的选择。 Φ url...

weixin_30507269的博客 241

spark3.x 写入hudi报错

【代码】spark3.x 写入hudi报错。

W2484980893的博客 1578

Python爬虫基础(一)urllib2库的基本使用

爬虫也就是所谓的网络数据采集,是一种通过多种手段收集网络数据的方式,不光是通过与 API 交互(或者直接与浏览器交互)的方式。最常用的方法是写一个自动化程序向网络服务器请求数据(通常是用 HTML 表单或其他网页文件),然后对数据进行解析,提取需要的信息。实践中,网络数据采集涉及非常广泛的编程技术和手段,比如数据分析、信息安全等。 要抓取网页数据,要做的就是向服务...

weixin_30593261的博客 201

AI安全攻防:十六进制编码与表情符号如何绕过ChatGPT安全限制

在人工智能安全领域,提示词工程是影响大语言模型行为的关键技术。其核心原理在于通过精心设计的输入文本,引导模型生成特定内容或执行特定任务。这项技术的价值在于能够深入探究模型的理解机制与决策边界,对于模型优化、安全测试及功能开发具有重要意义。在实际应用场景中,研究人员常利用编码转换、符号插入等方法构造输入,以测试模型安全护栏的鲁棒性。近期,一种结合十六进制编码与表情符号的组合攻击手法受到关注,该方法通过信息伪装与语义干扰,试图绕过模型内置的内容过滤机制,这凸显了当前AI安全在输入预处理与语义理解协同防御上面临的

weixin_30633405的博客 449

从AI画稿到3D虚拟时装:Illustrator与Substance 3D的服装设计工作流

本文旨在解决传统服装与纺织品设计师在产品开发流程中,面临的“2D印花图案无法直观预见3D上身效果”、“物理打样成本高昂且周期漫长”的核心痛点。我们将介绍一套纯数字化的3D可视化工作流,核心是利用 Adobe Illustrator 进行矢量印花图案创作,通过 Adobe Substance 3D Sampler 将其转化为逼真的PBR(基于物理渲染)布料材质,并最终在 Adobe Substance 3D Stager 中,将该材质应用于3D服装模型,渲染出照片级的虚拟样衣。本指南将帮助设计师以极低的成本和

Kingsdesigner的博客 1397

小白学 Python 爬虫(11):urllib 基础使用(一)

人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Linux基础入门 小白学 Python 爬虫(4):前置准备(三)Docker基础入门 小白学 Python 爬虫(5):前置准备(四)数据库基础 小白学 Python 爬虫(6):前置准备(...

极客挖掘机 2538

【学习系列】SAP RAP 18:Unmanaged场景开发示例-基本数据更新

本文介绍了在SAP RAP中unmanaged模式下从0到1的开发步骤。unmanaged模式下需要自行实现数据更新、权限检查等逻辑,适用于操作现有数据库表或复杂业务场景。文章以两层的采购订单对象为例,详细说明了创建技术对象(表、视图、行为定义等)的过程,并重点阐述了如何实现CRUD相关方法的核心逻辑。通过创建缓冲类来处理交互阶段和保存阶段的数据操作,确保事务一致性。完整代码展示了抬头层级的增删改查功能实现,为后续明细层级的开发奠定了基础。

DeveloperMrMeng的博客 638

python爬虫需要调用什么模块_运维学python之爬虫基础篇(二)urllib模块使用

1 何为爬虫网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。摘自百度百科2 URL2.1 URL含义URL(Uniform/Universal Resource Locator的缩写,统一资源定位符)是对可以从互联网上得到的资源的位置和访问方法...

weixin_39790102的博客 109

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

爬虫框架urllib 之(二) --- urllib基础

能爬取什么样的数据   网页文本:如HTML文档,Json格式化文本等  图片:  获取到的是二进制文件,保存为图片格式  视频: 同样是二进制文件  其他: 只要请求到的,都可以获取 如何解析数据 直接处理 Json解析 正则表达式处理 BeautifulSoup解析处理 PyQuery解析处理 XPath解析处理 抓取的页面数据和浏览器...

weixin_30814319的博客 101

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

python urllib.request 爬虫 数据处理-运维学python之爬虫基础篇(二)urllib模块使用...

1 何为爬虫网络爬虫(又被称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。另外一些不常使用的名字还有蚂蚁、自动索引、模拟程序或者蠕虫。摘自百度百科2 URL2.1 URL含义URL(Uniform/Universal Resource Locator的缩写,统一资源定位符)是对可以从互联网上得到的资源的位置和访问方法...

weixin_37988176的博客 65

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

小白学 Python 爬虫(12):urllib 基础使用(二)

人生苦短,我用 Python 前文传送门: 小白学 Python 爬虫(1):开篇 小白学 Python 爬虫(2):前置准备(一)基本类库的安装 小白学 Python 爬虫(3):前置准备(二)Linux基础入门 小白学 Python 爬虫(4):前置准备(三)Docker基础入门 小白学 Python 爬虫(5):前置准备(四)数据库基础 小白学 Python 爬虫(6):前置准备(...

极客挖掘机 2163
上一篇: 爬虫基础spider 之(一) --- 初识爬虫
下一篇: 爬虫项目 --- urllib 和 正则re
baoding4359
博客等级 码龄11年 2粉丝 0原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值