


从 GPT3 到 ChatGPT、到DeepSeek横空出世,微调在其中扮演了重要角色。什么是微调(fine-tuning)?微调能解决什么问题?什么是 LoRA?如何进行微调?本文将围绕以一个AI厨师的例子,从微调,蒸馏,强化学习之前的关系,微调的分类,实施方案等为大家普及大模型微调的相关知识:文末有厨师照片。
微调,蒸馏,强化学习
随着DeepSeek等大模型的快速发展,AI训练技术正经历着从"粗放式"到"精细化"的演进过程。在这一过程中,微调、强化学习和模型蒸馏构成了现代AI模型优化的"三驾马车":微调如同给专业运动员制定个性化训练方案,强化学习像是通过实战比赛来积累经验,而模型蒸馏则好比将大师的毕生功力传授给年轻弟子。这三种技术虽然都服务于模型性能提升这一共同目标,却各自遵循着截然不同的优化哲学和实施路径。
模型微调(Fine-tuning)
微调是指在已经训练好的大型预训练模型的基础上,进一步训练该模型以适应特定任务或特定领域的数据。相比从零开始训练一个模型,微调所需的数据和计算资源显著减少;可以在特定任务上取得更好的性能,因为模型在微调过程中会重点学习与任务相关的特性;
举例: 你高薪聘请了一位米其林大厨(预训练模型),他精通法餐。现在你要开川菜馆,就让大厨用原有厨艺基础,再专门学习三个月川菜(微调数据)。最后他既能做法餐,也能做出地道的麻婆豆腐。
目标: 利用预训练模型的通用知识,快速适应新任务,减少从头训练的计算成本。
特点:
- 通常用于迁移学习(Transfer Learning)。
- 调整模型的部分或全部参数,使其在新任务上表现更好。
- 适用于数据量较小的任务,因为预训练模型已经具备较强的泛化能力。
模型蒸馏(Model Distillation)
模型蒸馏是一种模型压缩技术,通过将一个复杂的大型模型(通常称为“教师模型”)中的知识迁移到一个更小的模型(称为“学生模型”)。在这个过程中,教师模型首先对训练数据进行预测,生成软标签即概率分布。这些软标签包含了有关任务的重要信息。学生模型则使用这些软标签进行训练,以接近教师模型的性能。模型蒸馏能够在保持高精度的同时,显著减少模型的大小和计算消耗,适用于在资源受限的环境下部署机器学习模型。
举例: 这位厨师还有一台售价百万的工业级咖啡机,能精准控制水温、压力,做出冠军级手冲咖啡。现在你想开连锁店,但不可能每台都用这么贵的机器。于是,厨师让这台"大师咖啡机"冲1000杯咖啡,记录每一杯的水温曲线、萃取时间等数据,然后用这些数据训练一批平价咖啡机。虽然便宜机器硬件差些,但学会了模仿大师的手法,做出的咖啡也有8成水准。
目标: 通过教师模型的“知识转移” ,帮助学生模型提升性能,特别是计算能力有限的设备上,更便于部署。
特点:
- 适用于模型压缩(如移动端、边缘计算)。
- 学生模型学习教师模型的“软标签”(概率分布),而非原始数据标签。
- 可以结合微调或强化学习使用,进一步提升性能。
强化学习
强化学习是一种机器学习范式,其核心思想是让智能体(Agent)在环境(Environment)中通过试错(Trial and Error)学习最优策略(Policy),以最大化长期累积奖励(Reward)。它模拟了人类和动物在环境中通过经验调整行为的过程。
举例: 强化学习就像训练一位米其林大厨研发爆款菜:他需要在厨房里不断试验新配方(试错),顾客点赞加单就是奖励(正向反馈),差评退菜则是惩罚(负向信号)。通过持续的“烹饪-反馈-调整”循环,大厨不断改进他的烹饪策略(策略优化),最终能在食材变动、客流起伏的餐厅环境中实时做出最佳决策(动态决策),稳定推出让餐厅火爆的招牌菜。
目标: 让模型学会在特定环境中做出最优决策,而非仅仅拟合数据分布。
特点:
- 适用于序列决策问题(如游戏AI、自动驾驶、机器人控制)。
- 依赖奖励函数(Reward Function)指导学习过程。
- 训练过程通常比监督学习更复杂,需要大量试错。
大模型微调
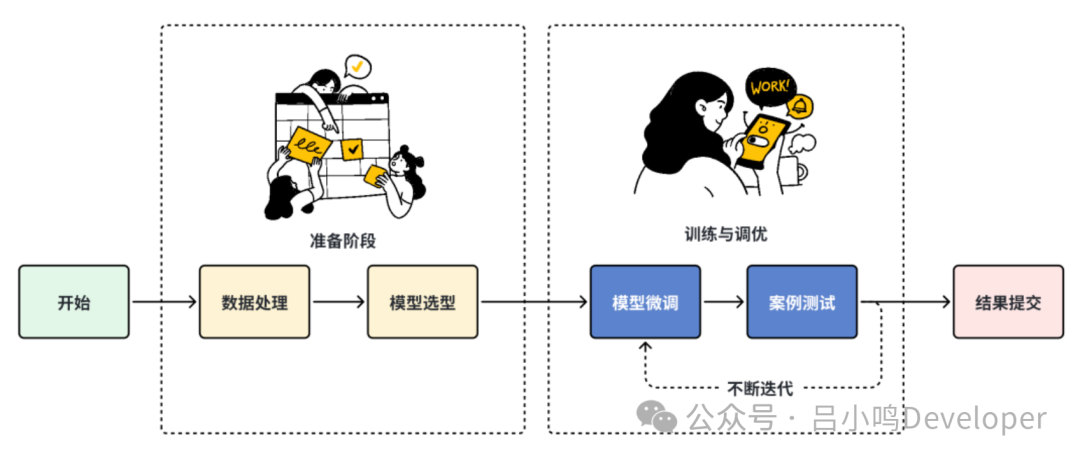
微调技术作为模型优化的核心手段与RAG(Retrieval-Augmented Generation)或Agent技术依靠构建复杂的工作流以优化模型性能不同,微调通过直接调整模型的参数来提升模型的能力。这种方法让模型通过在特定任务的数据上进行再训练,从而’永久’掌握该任务所需的技能。
微调带来的性能提升主要体现在三个维度:
- 领域适应性增强,通过调整注意力机制中的key-value分布,提升专业术语理解能力;
- 任务特异性优化,修改输出层的概率分布以适应特定任务格式;
- 计算效率优势,相比需要实时检索的方案,微调模型在推理时仅需单次前向传播。
值得注意的是,现代微调技术已发展出多种范式,包括:
- 全参数微调(Full Fine-tuning)
- 参数高效微调(PEFT如LoRA、Adapter)
- 提示微调(Prompt Tuning)
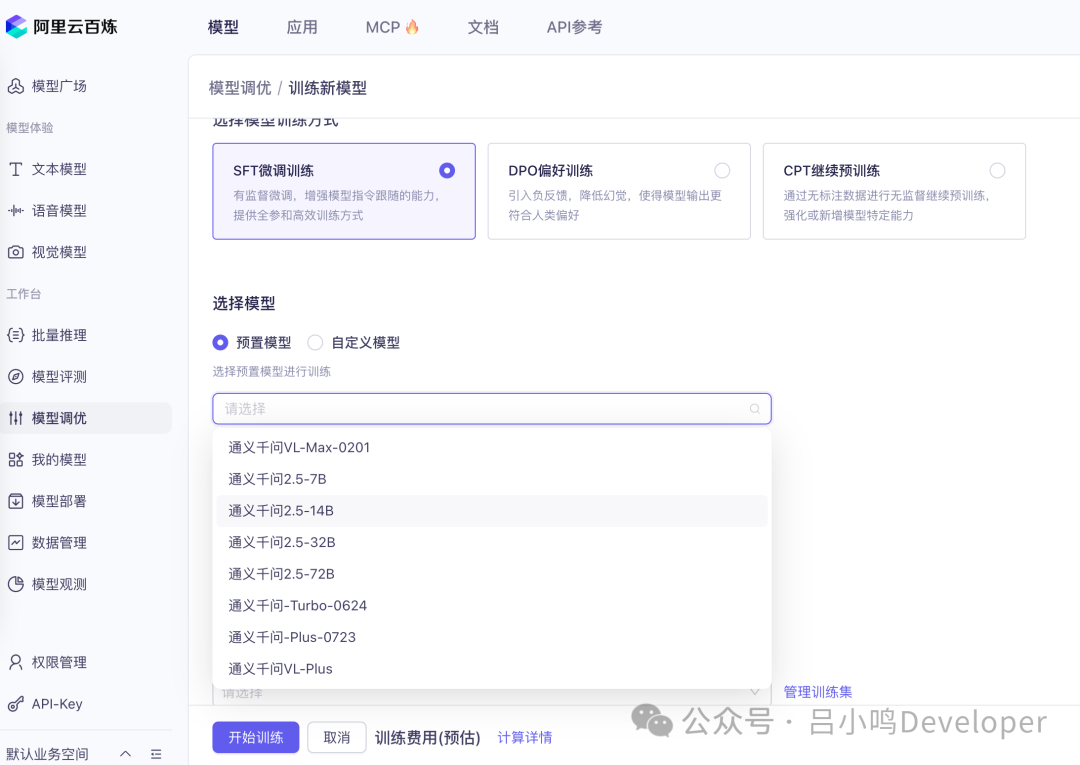
这些方法在不同计算资源约束下,为模型性能优化提供了灵活的选择空间,如下图百炼平台提供的微调方案: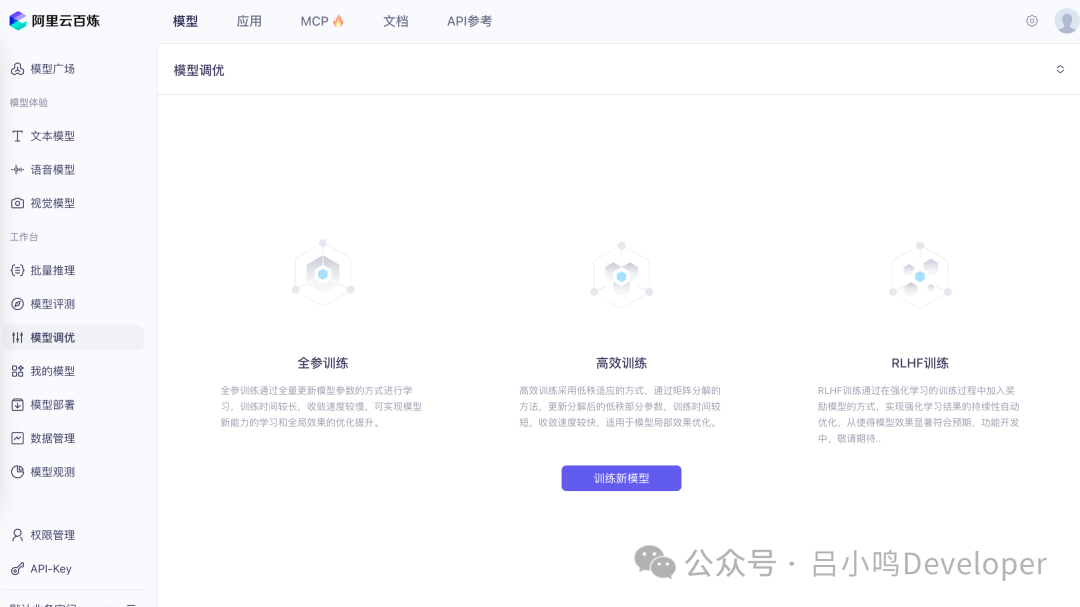
预训练模型
在了解微调方案前,需要先知道什么是预训练模型。
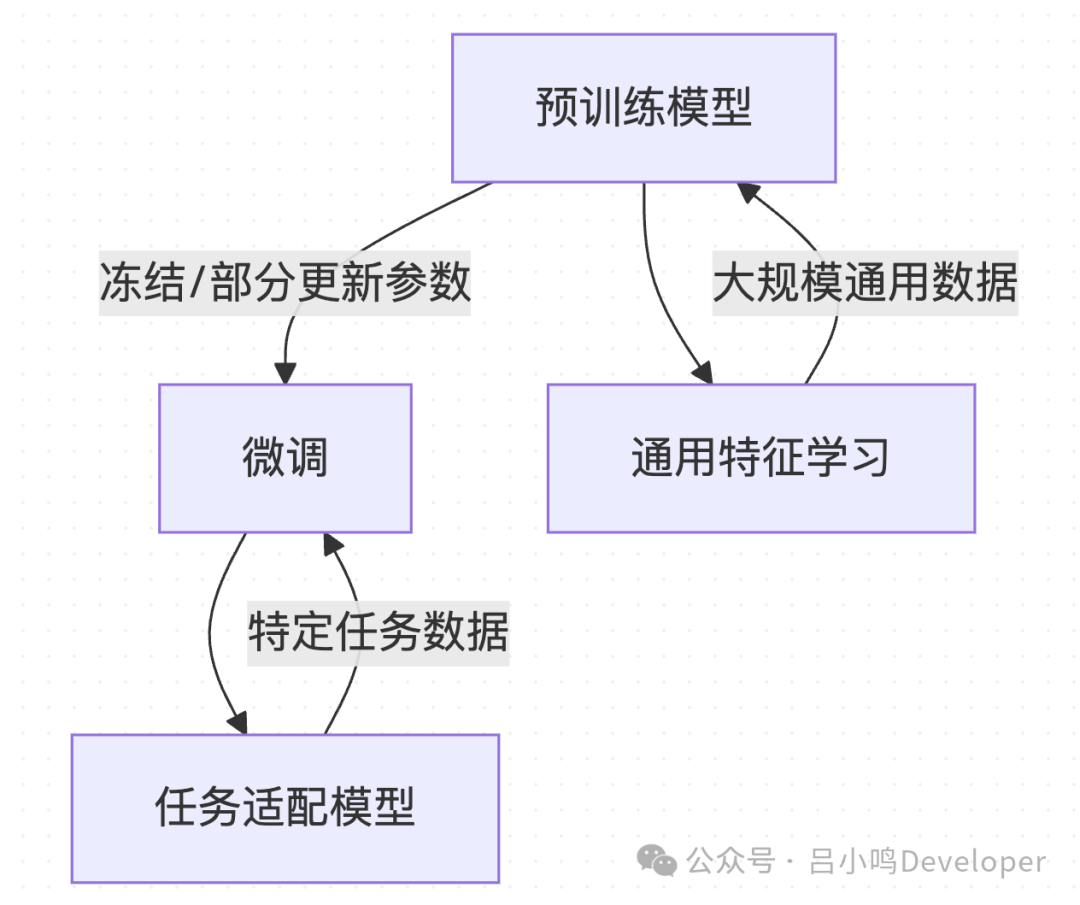
预训练模型(Pre-trained Model): 是指在大规模通用数据(如互联网文本、图像库、语音语料等)上预先训练好的模型。它通过学习数据中的通用规律和特征,获得对任务的基础理解能力。 预训练模型就像一个通才学生,在上学前已经通过大量阅读(如书籍、新闻、论文)掌握了语言、数学、科学等基础知识。 而微调是在预训练模型的基础上,针对特定任务进一步调整模型参数的过程。例如,让已经掌握语言基础的学生专门学习“医学诊断”,通过少量医学资料和案例,使他能精准回答医学问题。 所以预训练模型是基础,微调是定制。
全参数微调(Full Fine-tuning)
全参数微调是指对整个预训练模型的所有参数(权重和偏置)进行重新训练,使其适应特定任务或领域。这种方法会调整模型的所有层(包括嵌入层、注意力层、前馈层等),使其在目标数据集上达到最优性能。这种方法对计算资源的需求较高,训练时间长,显存占用大,但它能够在最大程度上提升模型对特定任务的适应能力,如果数据充足,通常比参数高效微调方法表现更好。
举例:假设你有一个预训练的“万能米其林厨师”AI,它已经学会了做全球99%的菜系(比如中餐、西餐、甜点等)。现在你想让它学会做一道全新的菜系(比如“川味麻辣火锅”)。 全参数微调就像是从头到尾重新教这位厨师,让他彻底适应新菜系的每一个细节:
- 选材:调整对辣椒、花椒、牛油等食材的识别和用量。
- 刀工:修改切菜方式(比如土豆片要更薄)。
- 火候:重新学习猛火煮底料的技巧。
- 调味:重新训练对麻、辣、鲜、香的平衡感。
关键不是只教他“最后一步加调料”,而是从选材到上桌的所有步骤都重新调整,让他的“整个大脑”(模型参数)都适应新菜系。
参数高效微调(Parameter-Efficient Fine-Tuning, PEFT)
PEFT 方法只调整模型的一小部分参数(如新增的适配层或低秩矩阵),而冻结大部分预训练参数,从而大幅降低计算成本。常见的PEFT方法包括 LoRA(Low-Rank Adaptation) 和 Adapter。
举例: 还是之前的厨师例子,参数高效微调就像是告诉厨师:“你之前学的99%都别动,最后一步多加点辣椒就行。” 有点是快,省时间。但是缺点:可能不够正宗(比如底料不够香,牛油比例不对)。
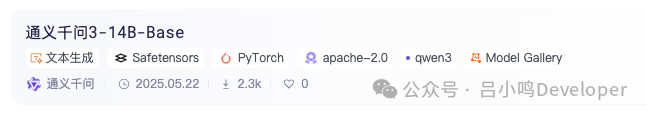
现在绝大多数开源模型,在开源的时候都会公布两个版本的模型,其一是Base模型,该模型只经过了预训练,没有经过指令微调;其二则是Chat模型(或者就是不带尾缀的模型),则是在预训练模型基础上进一步进行全量指令微调之后的对话模型:
LoRA 微调
LoRA(Low-Rank Adaptation)是一种参数高效微调方法,通过在预训练模型的权重矩阵中引入低秩矩阵(Low-Rank Matrix)来调整模型,从而实现对特定任务的适应。具体来说,LoRA 微调并不直接调整原始模型的所有参数,而是通过在某些层中插入低秩的适配器(Adapter)层来进行训练。
举例: 还是之前的厨师例子,LoRA就像是在厨师的“大脑”中加一个轻量级的“川菜秘方贴纸”,而不是让他从头学习所有步骤,具体操作:
- 厨师原本的“大脑”(模型权重)保持不变。
- 只在关键步骤(如辣椒用量、牛油比例)上贴一张“川菜秘方”(低秩矩阵)。
- 秘方只记录与川菜相关的调整(如“多加花椒”),不影响其他菜系的做法。
效果:
- 厨师能做出地道的川菜,但其他菜系的技能(如做蛋糕)依然保留。
- 秘方只有几页纸(参数量极小),成本低、速度快。
整体流程如下图: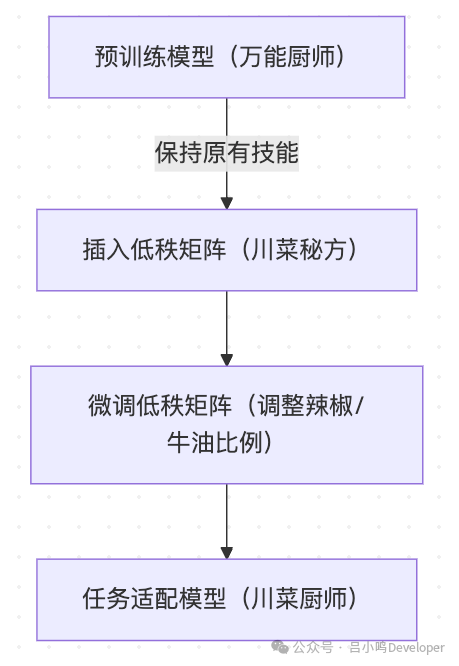
Adapter 微调
Adapter 是一种参数高效微调方法,它在预训练模型的每一步骤中插入小型模块(如“小工具”),仅训练这些新增模块的参数,而原始模型参数保持冻结。
举例: 还是之前厨师的例子,Adapter微调就好比给厨师加“小工具”,具体步骤:
-
预训练模型(厨师):厨师原本的技能(选材、刀工、火候)都已掌握。
-
Adapter 插入的小工具:
-
- 在关键步骤中插入“小工具”(如“辣椒分拣器”、“牛油温度传感器”),这些工具只在做川菜时启用。
- 选材步骤:插入一个“辣椒分拣器”,自动筛选出最辣的干辣椒。火候步骤:插入一个“牛油温度传感器”,确保牛油加热到最佳温度。
效果
- 仅训练小工具:调整辣椒分拣器的灵敏度、温度传感器的阈值。
- 原始技能不变:厨师原有的选材、刀工等能力不受影响。
整体流程如下图: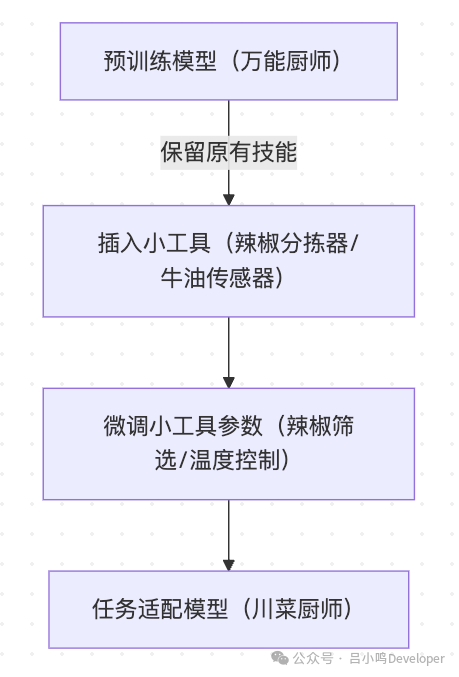
开始微调
上面介绍了这么多微调相关的概念,那么对于开发者如何进行大模型微调呢,需要准备些什么呢?
模型微调的核心步骤
- 选择预训练模型:
- 常见模型:BERT, Llama3, Qwen, ResNet, ViT 等。
- 来源:Hugging Face, 魔塔社区, OpenMMLab 等。
- 准备任务数据:
- 数据格式:文本分类需标注数据(如 CSV/JSON),生成任务需输入-输出对。
- 数据增强:清洗、去噪、分词、填充等。
- 选择微调方法:
- 全参数微调:训练所有参数(资源消耗大)。
- 参数高效微调(PEFT):仅调整部分参数(如 LoRA、Adapter、Prompt Tuning)。
- 配置训练环境:
- 硬件:GPU/TPU(如 NVIDIA A100, 4090)。
- 框架:PyTorch, TensorFlow, JAX。
- 工具库:Hugging Face Transformers, PEFT, AutoGPTQ。
- 训练与评估:
- 损失函数:交叉熵、MSE 等。
- 评估指标:准确率、F1、BLEU 等。
- 早停与正则化:防止过拟合。
- 部署与推理:
- 导出模型(ONNX, TensorRT)。
- 部署到服务(FastAPI, Flask, Docker)。
下面是一段python伪代码实现微调已LoRA为例,供参考:
from peft import LoraConfig, get_peft_model
import torch

# 1. 加载预训练模型
model = AutoModelForCausalLM.from_pretrained("llama3-8b")

# 2. 配置 LoRA
lora_config = LoraConfig(
    r=64,  # 低秩矩阵秩
    lora_alpha=16,
    target_modules=["q_proj", "v_proj"],  # 目标模块
    lora_dropout=0.1,
    bias="none",
    task_type="CAUSAL_LM"
)

# 3. 应用 LoRA
model = get_peft_model(model, lora_config)

# 4. 训练(与全参数微调类似)
# ... 使用相同数据集和训练流程 ...
云平台微调
当然,微调需要的算力可以在云平台进行,开发者不需要写大量代码,只需要准备对应的数据集,在云端完成模型微调和部署。
百炼平台
例如,在百炼平台上,选择对应的模型进行微调:
详细参考:https://bailian.console.aliyun.com/console?tab=model#/efm/model_manager
Hugging Face Space
Hugging Face Space也可以使用户直接在浏览器中训练和部署模型,而无需安装本地环境。并且给用户提供了一个 2 vCPU 16GB 的免费空间,这对于新手或者资源有限的用户来说非常方便。
- 在 Hugging Face 官网新建 Space,选择 Gradio模板:
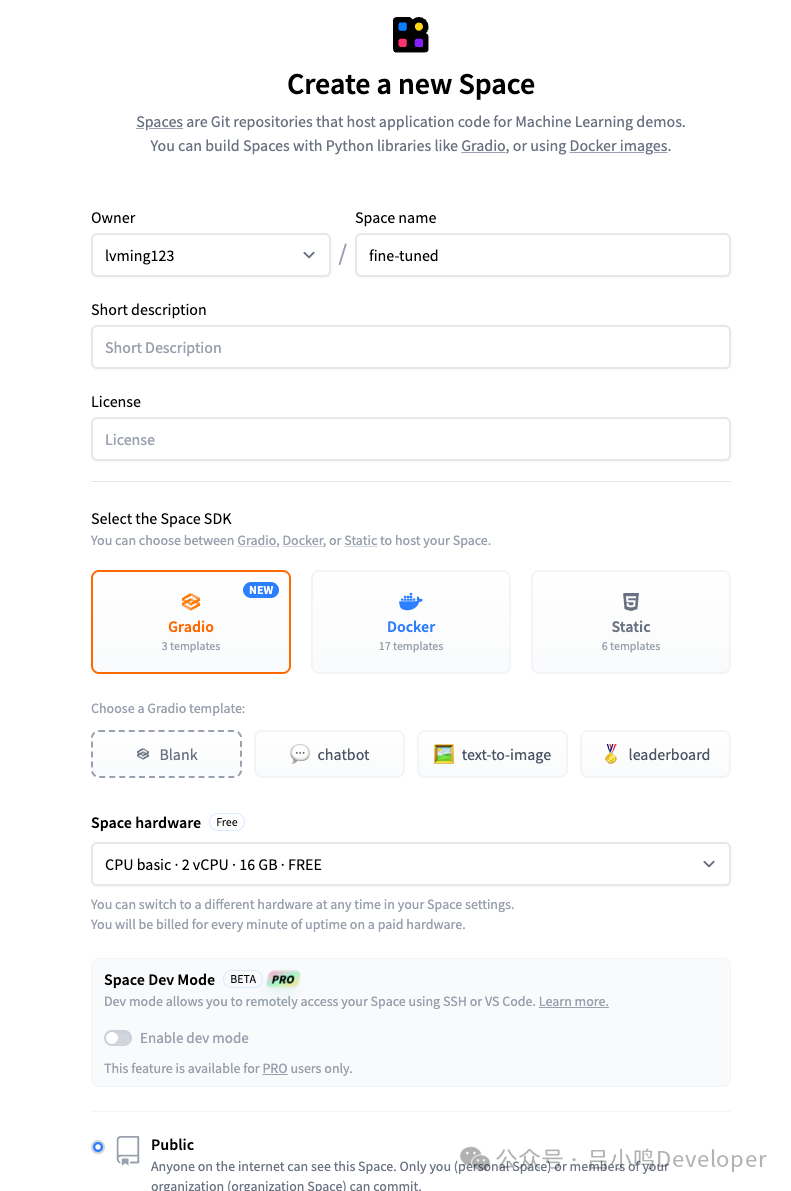 image.png
-
上传模型文件。
-
编写应用脚本(以 Gradio 为例):
import gradio as gr
from transformers import pipeline

# 加载微调后的模型
pipe = pipeline("text-generation", model="your-username/fine-tuned-llama")

def generate(text):
    return pipe(text, max_length=512)[0]["generated_text"]

gr.Interface(fn=generate, inputs="textbox", outputs="text").launch()
详细内容参考Hugging Face文档:https://huggingface.co/learn/cookbook/zh-CN
AI厨师爆照:
结语
本文介绍了微调的基本概念,以及如何对语言模型进行微调。微调技术作为迁移学习的重要实现方式,其核心在于通过特定领域数据的二次训练,使预训练语言模型获得领域适配能力。 随着分布式训练技术和模型压缩技术的进步,微调过程的计算效率持续提升。相信随着算力增长,微调的成本门槛会越来越低,微调技术应用的场景也会越来越多。 未来,随着量子计算等新型计算架构的发展,微调技术有望实现分钟级的模型迭代周期,这将彻底改变现有AI应用的开发范式。
如何学习AI大模型 ?
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。【保证100%免费】🆓
优快云粉丝独家福利
这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以扫描下方二维码&点击下方优快云官方认证链接免费领取 【保证100%免费】
读者福利: 👉👉优快云大礼包:《最新AI大模型学习资源包》免费分享 👈👈
对于0基础小白入门:
如果你是零基础小白,想快速入门大模型是可以考虑的。
一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以根据这些资料规划好学习计划和方向。
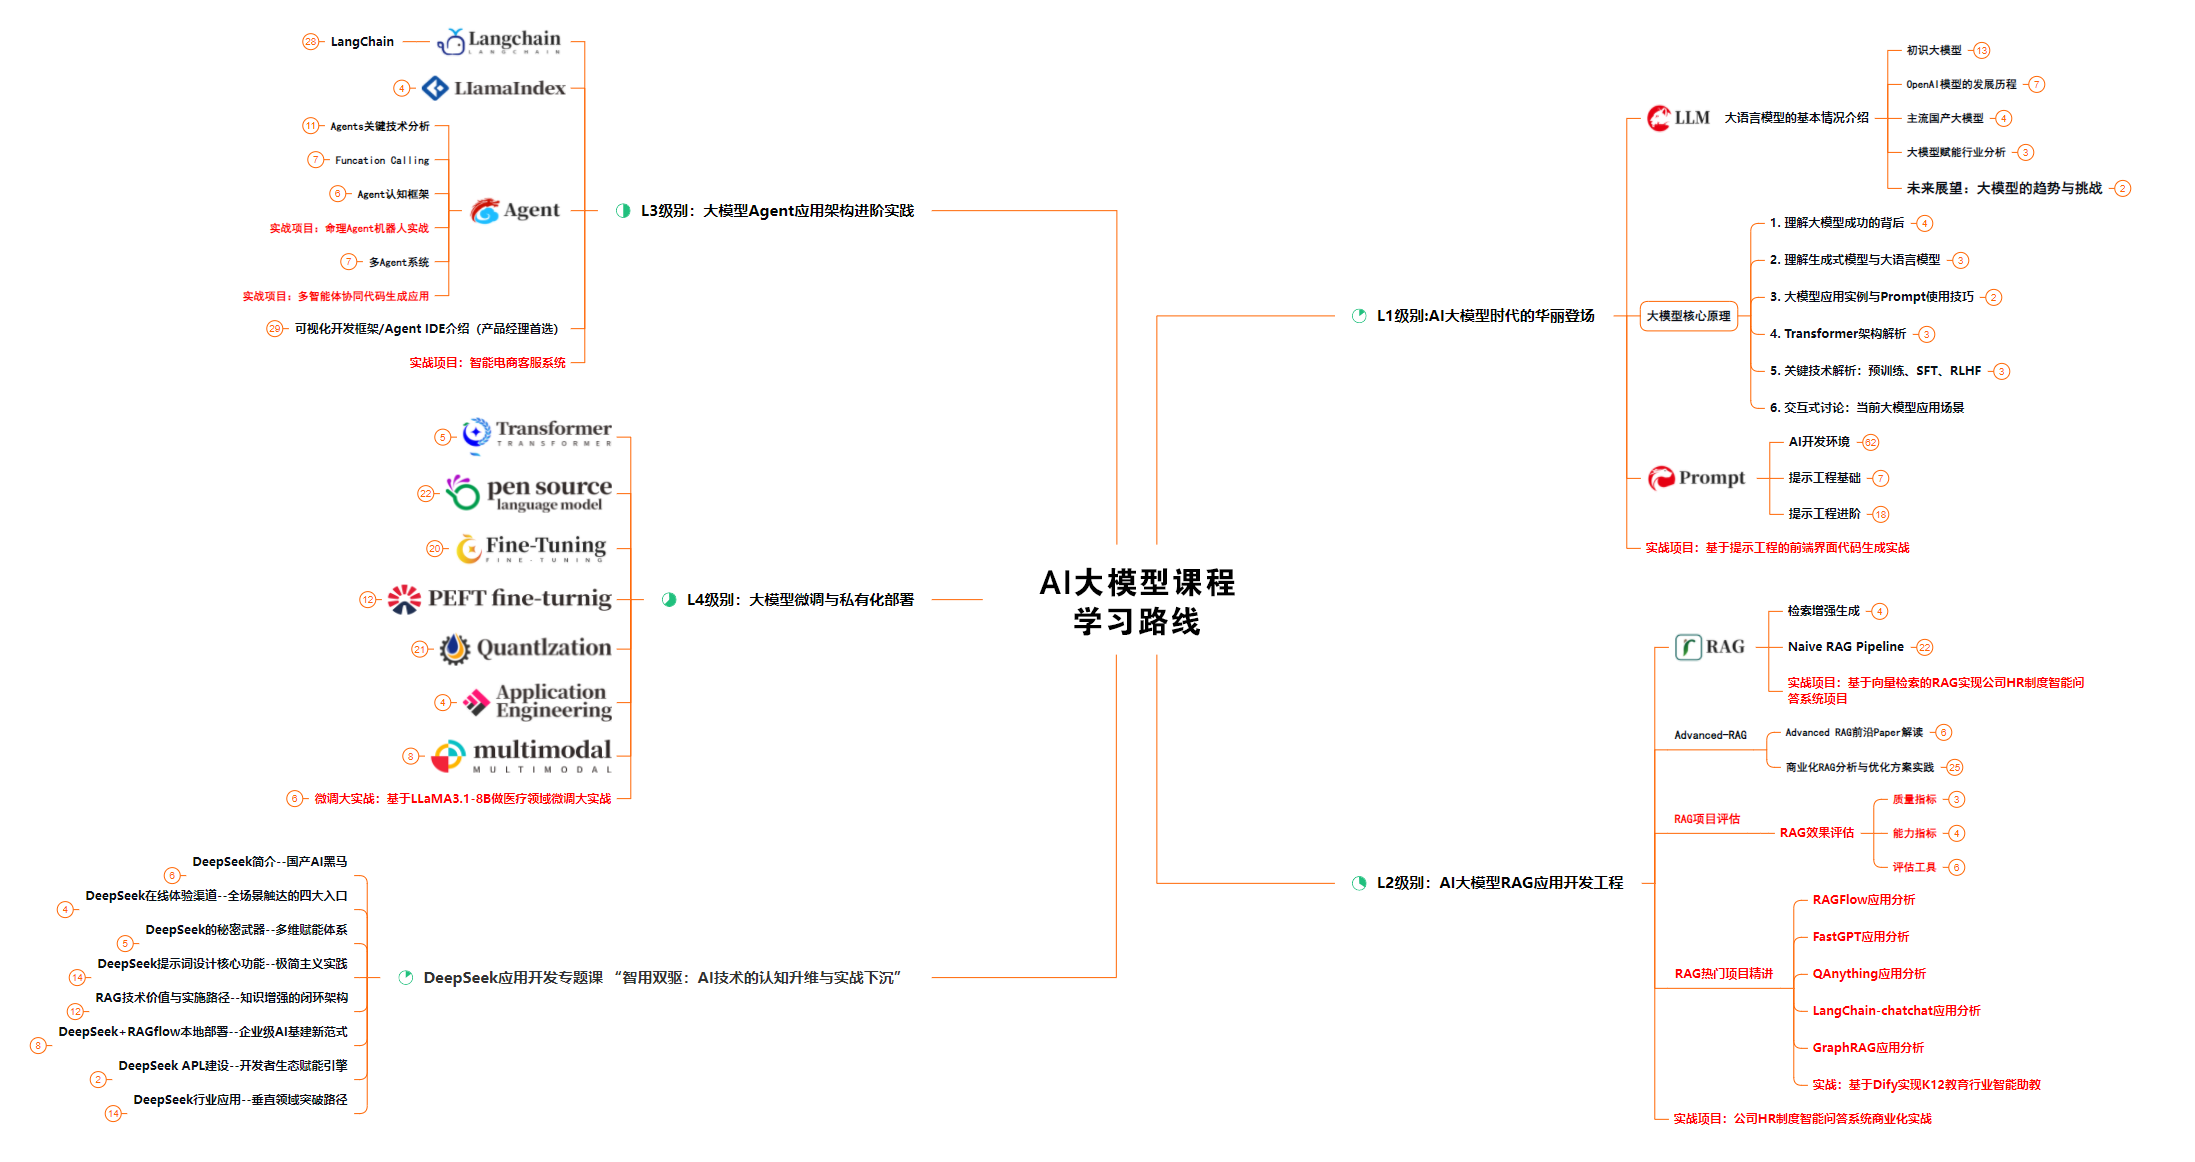
👉1.大模型入门学习思维导图👈
要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。
对于从来没有接触过AI大模型的同学,我们帮你准备了详细的学习成长路线图&学习规划。可以说是最科学最系统的学习路线,大家跟着这个大的方向学习准没问题。(全套教程文末领取哈)
👉2.AGI大模型配套视频👈
很多朋友都不喜欢晦涩的文字,我也为大家准备了视频教程,每个章节都是当前板块的精华浓缩。


👉3.大模型实际应用报告合集👈
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(全套教程文末领取哈)
👉4.大模型实战项目&项目源码👈
光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战项目来学习。(全套教程文末领取哈)
👉5.大模型经典学习电子书👈
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。(全套教程文末领取哈)
👉6.大模型面试题&答案👈
截至目前大模型已经超过200个,在大模型纵横的时代,不仅大模型技术越来越卷,就连大模型相关的岗位和面试也开始越来越卷了。为了让大家更容易上车大模型算法赛道,我总结了大模型常考的面试题。(全套教程文末领取哈)
为什么分享这些资料?
只要你是真心想学AI大模型,我这份资料就可以无偿分享给你学习,我国在这方面的相关人才比较紧缺,大模型行业确实也需要更多的有志之士加入进来,我也真心希望帮助大家学好这门技术,如果日后有什么学习上的问题,欢迎找我交流,有技术上面的问题,我是很愿意去帮助大家的!
这些资料真的有用吗?
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
优快云粉丝独家福利
这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以扫描下方二维码&点击下方优快云官方认证链接免费领取 【保证100%免费】
读者福利: 👉👉优快云大礼包:《最新AI大模型学习资源包》免费分享 👈👈
 4431


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


