AI产品经理:从入门到精通,一篇文章带你入门!(附学习资料)

产品经理内容分享(六):AI产品经理需必备那些能力 然而,不同于传统的产品经理,AI产品经理必须跨越“技术鸿沟”,对AI技术有基础且深入的理解,这样才能有效地与研发团队沟通,把握产品发展方向,并做出符合市场需求和技术创新趋势的决策。例如,在决定采用哪种推荐算法时,产品经理不仅要知道协同过滤和深度学习等方法的大致原理,还要能评估不同算法在实际场景中的优劣,比如精准度、训练所需的数据量、实时性要求等因素。这就要求产品经理具备一定的技术素养,能够读懂相关文献和技术文档,参与技术选型讨论,并在产品规划阶段就充分考虑到技术可行性及后续迭代的可能性。 阅读详情
AI摘要

本文介绍AI产品经理工作全流程,包括需求定义、模型预研、数据准备、模型构建、宣讲验收和业务上线。以筛选薅羊毛用户产品为例,阐述各环节要点。还分享AI大模型学习资料,如思维导图、视频、报告等,助零基础小白入门。

一、AI产品经理工作全流程概览

AI产品经理工作全流程中与普通产品经理的区别主要是多了算法模型部分,包括模型预研、数据准备、模型构建、模型宣讲、模型验收,协作的对象相对普通产品经理也多了算法工程师。

二、需求定义

需求定义主要要定义清楚以下几点:

1、做什么? 2、为什么要做,有什么收益和价值?3、业务预期目标、上线期限?

为了方便理解,我们以开发一套筛选薅羊毛用户的产品进行举例说明。

1、项目背景

团队发现负责的项目数据统计有些异常,细查之后,发现存在夜间偷数据的情况,大致行为路径如下:

  1. 淘宝上买一批手机号,注册新账号。

  2. 通过自动薅羊毛的方式(新手礼包、每日签到、周任务等),获取免费券等资源。

  3. 夜深人静的时候,使用免费券或积分批量下载数据。

亡羊补牢,犹未晚矣。我们决定开发一套筛选薅羊毛用户的产品,彻底堵住这个缺口。

2、做什么?

开发一套筛选薅羊毛用户的产品。具体设计大概思路如下:

  1. 在领取新手礼包或周任务奖励时,需要用户绑定手机号(薅羊毛时简单卡一下,以免影响正常的用户体验)。

  2. 在使用券进行下载操作时,判断是薅羊毛用户的概率,并根据概率高低分成 正常、疑似、高危 三类。

  3. 针对“疑似”用户,就触发 极验 或 验证码校验 等逻辑。针对高危用户,就锁定账号,并在激活时要求绑定微信,避免再出现大量偷数据的情况。

①人工智能/大模型学习路线

②AI产品经理入门指南

③大模型方向必读书籍PDF版

④超详细海量大模型实战项目

⑤LLM大模型系统学习教程

⑥640套-AI大模型报告合集

⑦从0-1入门大模型教程视频

⑧AGI大模型技术公开课名额

3、为什么要做,有什么收益和价值?

减少公司做活动发放福利时被薅羊毛,让福利触达给有效的用户。

4、业务预期目标、上线期限?
  1. 离线/实时模式:支持实时判断,所以应该定义为实时模型。

  2. 覆盖率:期望该模型的覆盖率为100%,面向所有用户。

  3. 倾向:尽可能找出所有羊毛党,追求高“召回率”,可以接受一定程度的误报。宁可错杀一千,不可放过一个。

  4. 上线期限:双十一前得上线,离现在还有半年时间。

三、模型预研

AI产品经理把需求同步给算法工程师,算法工程师需判断目前积累的数据和沉淀的算法是否可以达到业务需求。

如果现有数据不满足需求,要么增加埋点补齐数据,要么想办法获取目标数据,要么替换成其他类似数据。

如果算法支持度不够,可能需要调整需求内容,以便达到更适配的效果。以该项目为例,实时模式的话,可能会对原业务的响应速度有一定影响,所以最后调整为离线模型,每天定时处理前一天的用户数据。

四、数据准备

对于算法同学而言,他只能根据现有的数据分析哪些特征对于模型有用,但是,AI产品经理对业务理解更深,通过判断哪些数据、哪些特征对模型提升有帮助,把自己想到的要点和技术沟通,得到更完善的数据集,再动手去获取数据。

比如该用户是否主要在夜间活动?操作频率是否过高?短时间内同一台终端是否登录过多个用户?用户是否触发过新手引导?

尽可能准确的找到羊毛党用户的特征,对模型质量的提升会有极大的帮助。

获取数据时,主要分为以下三类(有时也可与其他公司联合建模):

1、内部业务数据

如果以前业务有相关数据,那么我们可以从以前业务保留的数据中选取使用;如果当前没有相关数据,而我们有相关业务可以获得数据,我们通过增加埋点的方式将数据留存。

2、跨部门数据

其他部门数据或统一的中台数据,这些数据需要我们根据公司的数据管理规范流程提取,在数据提取的时候注意筛选有效数据。

3、外采数据

根据我们的需求向外部公司购买数据。我们需要了解市场上不同公司都可以提供什么数据,比如:极光、友盟提供的是开发者服务,所以他们可以提供一些和App相关的用户画像,比如运营商可以提供上网流量、话费等相关数据。

进行外采数据需要注意两点:外采公司的资质审核、采集数据的合法性(需要考虑数据安全和消费者隐私保护)。

五、模型构建

模型构建的具体流程如下:

1、模型设计

模型设计阶段,我们需要考虑该选择什么样的算法,目标变量应该怎么设置、数据源应该有哪些、数据样本如何获取,是随机抽取还是分层抽样。

a.算法选择

于其需求定义,模型需要计算出用户是薅羊毛用户的概率,并根据概率高低分为正常、疑似、高危三类,最终技术同学决定采用逻辑回归算法来实现该需求。

逻辑回归算法具有计算速度快、可解释性强的优点,适用于解决需求中的多分类问题,而且还可以对用户“为什么封号”的质疑,有较强的解释性。

b.定义目标变量及抽取数据样本

在模型设计阶段最重要的就是定义模型目标变量,以及抽取数据样本。

不同的目标变量,决定了这个模型应用的场景,以及能达到的业务预期。

样本是用来做模型的基础。在选取样本的时候,你需要根据模型的目标、业务的实际场景来选择合适的样本。必须要考虑季节性和周期性的影响。另外,还要考虑时间跨度的问题。建议你选择近期的数据,并结合跨时间样本的抽取,来降低抽样的样本不能描述总体的这种风险。

2、特征工程

所有模型的输入都是数量化的信息(用向量、矩阵或者张量的形式表示的信息),所以我们需要通过某种方式,把各种类型的数据转化成数量化的信息,这个过程就是特征工程。

特征工程是模型构建过程中最重要的部分,如果我们可以挑选到足够优质的特征,不仅可以提升模型性能,还能降低模型的复杂度,(当选择了优质的特征之后,即使你的模型参数不是最优的,也能得到不错的模型性能,你也就不需要花费大量时间去寻找最优参数了,从而降低了模型实现的复杂度。)大幅简化构建过程。

数据和特征决定了模型的上限,而模型和算法只是逼近这个上限而已。

以薅羊毛项目为例,我们可以通过用户是否在夜间活动、操作频率、历史订单、完成活动速度、同一台终端是否登录多个账号等一系列特征,来表达是薅羊毛用户的可能性,这就是建立了薅羊毛用户的特征工程。我们可以通过这些特征来判断用户的可疑程度。

特征过程包括以下四个流程:

1. 数据清洗

数据清洗主要是算法工程师要做的工作,数据预处理的重要环节,主要是对数据进行重新审查和校验,检查数据一致性、处理无效值和缺失值等。

来解决这些数据可能存在的数据缺失、有异常值或无效值、数据不均衡(比如前面部分数据表现好,后面部分数据表现不好)、单位不一致等问题。

对数据缺失,算法工程师可以通过删除缺失值或者补充缺失值的手段来解决它。

对于数据不均衡的问题,因为数据偏差可能导致后面训练的模型过拟合或者欠拟合,所以算法工程师取数据时需要考虑均衡问题。

2. 特征提取

从原始数据中提取有用的特征,将其转化为一组更具代表性和可解释性的特征。特征提取的目的是减少原始数据的维度,提高数据的表达能力,帮助算法进行更好的完成任务。

一般提取出的特征会有 4 类常见的形式,分别是数值型特征数据、标签或者描述类数据、非结构化数据、关系型数据。

**数值型特征:**如消费金额、好友人数、浏览页面次数等(相关的业务操作数据、运营数据)。一般来说,会首先提取主体特征,再提取其他维度特征。

**标签或描述类特征:**如有房、有车、高付费,用来打标签。

**非结构化特征:**如内容评论,需要判断是否有负面情绪。非结构化数据一般存在于 UGC(User Generated Content,用户生成内容)内容数据中。提取非结构化特征的一般做法就是,对文本数据做清洗和挖掘,挖掘出在一定程度上反映用户属性的特征。

**关系型数据特征:**如通讯录、收获地址、商品分享(一般分享给亲朋)、LBS位置信息 等维度数据。比如说,在京东购物时,你和一个人在同一收货地址上,如果这个收货地址是家庭地址,那你们很可能就是家人。

3. 特征选择

特征在选择时主要有覆盖度、IV 值(信息价值)、稳定性等指标。

LV值指的是表示特征对目标预测的贡献程度,LV值有限定条件,一是面向的任务必须是有监督的任务;二是预测的模型必须是二分类模型。

4. 生成训练集和测试集

算法同学为了给模型训练做最后的准备,需要把数据分成训练集和测试集,他们会使用训练集来进行模型训练,会使用测试集验证模型效果,

3、模型训练

模型训练是通过不断训练、验证和调优,让模型达到最优的过程。就是要找到一个划分条件(决策边界),使得准确率(拟合)最高的同时兼顾稳定性(泛化性能)。这里涉及几个名词需要理解:

a、决策边界

那么怎么达到最优呢?就是要绘制一条比较好的决策边界。

决策边界:就是在符合某种条件做出某种选择的条件,根据这个条件可以将结果进行划分。比如说:下午6:00不写完这篇博客我不吃饭,那么写完了就去吃,没写完就不吃。这个条件就是我们说的决策边界。

决策边界分为:线性决策边界和非线性决策边界。下图中,图1为线性决策边界,图2、图3为非线性决策边界。

决策边界曲线的平滑程度和算法训练出来的模型能力息息相关。曲线越陡峭模型的测试精度越准确(可以理解为不是一刀切),但是越陡峭的曲线模型越不稳定。

b、拟合与泛化

模型的“最优”,指的是模型拟合能力和泛化能力的平衡点。

  • 拟合能力:模型在已知数据上(训练集)表现的好坏

  • 泛化能力:模型在未知数据上(测试集)表现的好

如果想让模型有足够好的拟合能力,就需要构建一个复杂的模型对训练集进行训练,但是模型越复杂就会越依赖训练集的数据,就越可能出现训练集的表现很好,但在测试集上表现差的情况,泛化能力比较差,这种情况叫做“过拟合”。

如果想让提高模型的泛化能力,就要降低模型复杂度,减少对训练集的依赖,但如果过度降低复杂度,又可能导致“欠拟合”的情况。

  • 过拟合:模型把数据学习的太彻底,甚至把噪声数据的特征也学习到了,就导致不能很好的识别未知数据,模型泛化能力下降。训练集表现很好,但是测试集很差。读的是“死书”,并没有真正掌握书里的精髓,自然就无法很好的应用了。产生过拟合的原因一般有:特征过多,模型复杂度过高,样本数据无法代表预定的分类,样本噪音干扰过大等。

  • 欠拟合:模型不能很好的捕捉数据特征,不能很好的拟合数据。在训练集的表现就很差,需要继续努力“学习”。产生欠拟合的原因一般有:模型复杂度过低、特征量过少等。

c、交叉验证

算法工程师就这样不断的调整模型参数、训练,再用交叉验证的方式,逐渐找到拟合能力和泛化能力的平衡点,这个平衡点就是我们训练模型的目标。

  • 交叉验证:一种评估机器学习模型性能的有效方法,可以用于选择最佳模型参数、模型选择以及避免过拟合等问题。包括简单交叉验证、留出交叉验证、自助交叉验证等方法。如把测试数据进行进行封箱处理,后随机对一些分箱测试结果取平均值。
4、模型验证

经过复杂的模型训练,我们终于得到了一个所谓的“最优解”,但是怎么证明这个最优解就是真正的最优解呢?我们需要模型验证阶段来确认这个“最优解”的真假。

模型验证一般通过模型的性能指标和稳定性指标来评估。

模型性能,就是模型预测的准确性。

  • 分类模型性能评估:分类模型的预测结果是具体的分类,一般使用召回率、F1、KS、AUC等评估指标,来判断分类模型的性能。

  • 回归模型性能评估:回归模型的预测结果是连续值,一般使用方差和MSE等评估指标,来判断回归模型的性能。

模型稳定性,指的是模型性能可以持续多久,一般使用PSI指标来评估模型的稳定性。

PSI指标,指模型稳定性指标(或称为客情稳定性指标),PSI越小越好,如果PSI>0.25说明稳定性很差。

综上:模型验收环节,AI产品经理需要知道常用的性能指标与稳定性指标,并且知道其合理的范围。AI产品经理对模型验证环节格外关注,需要深入理解评估指标、计算逻辑,并能根据指标的数据判断模型效果是否达标。

5、模型融合

为了提升模型的准确率和稳定性,有时会同时构建多个模型,再把这些模型集成在一起,确保模型有更优的整体表现。

比如薅羊毛项目这种分类模型,可以用最简单的投票方法来融合,票数最多的类别就是最终的结果。

回归模型的融合主要用算术平均或加权平均。

分类模型的融合,主要是取数据值最大的,如Blending和stacking,bagging和bossting。

模型融合的一些基本方法如下,感兴趣可进一步查资料了解。

在模型融合的过程中,产品经理需要考虑好成本问题。

五、模型宣讲与验收

模型构建完成后,产品经理需要组织技术宣讲训练好的模型,介绍内容如下:

  • 使用的什么算法?为什么选这个算法?

  • 选用了哪些特征。

  • 训练集、测试集的大致情况。

  • 模型的测试结果。

  • 是否达到了预期?哪些指标未达预期?未达预期的原因是什么。

宣讲之后,产品经理需要对模型进行评估和验收,该环节也非常重要,至于如何选择合适的评估指标,后续章节会详细介绍。

六、业务开发并上线

验收通过之后,技术会把模型部署到线上,并按之前和业务开发同事约定的接口提供能力。

业务开发完成相应功能后,和模型接口联调通过,就可以进入常规的走查、测试、上线流程了。

需要注意的是,模型上线后,还需要持续监控模型的效果,若运行一段时间后,发现模型效果有明显衰减,就需要分析原因,并针对性的升级模型。

如何学习AI大模型 ?

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。【保证100%免费】🆓

对于0基础小白入门:

如果你是零基础小白,想快速入门大模型是可以考虑的。

一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以根据这些资料规划好学习计划和方向。

😝有需要的小伙伴,可以VX扫描下方二维码免费领取🆓

👉1.大模型入门学习思维导图👈

要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。

对于从来没有接触过AI大模型的同学,我们帮你准备了详细的学习成长路线图&学习规划。可以说是最科学最系统的学习路线,大家跟着这个大的方向学习准没问题。(全套教程文末领取哈)
在这里插入图片描述

👉2.AGI大模型配套视频👈

很多朋友都不喜欢晦涩的文字,我也为大家准备了视频教程,每个章节都是当前板块的精华浓缩。

在这里插入图片描述
在这里插入图片描述

👉3.大模型实际应用报告合集👈

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(全套教程文末领取哈)
在这里插入图片描述

👉4.大模型落地应用案例PPT👈

光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。(全套教程文末领取哈)

在这里插入图片描述

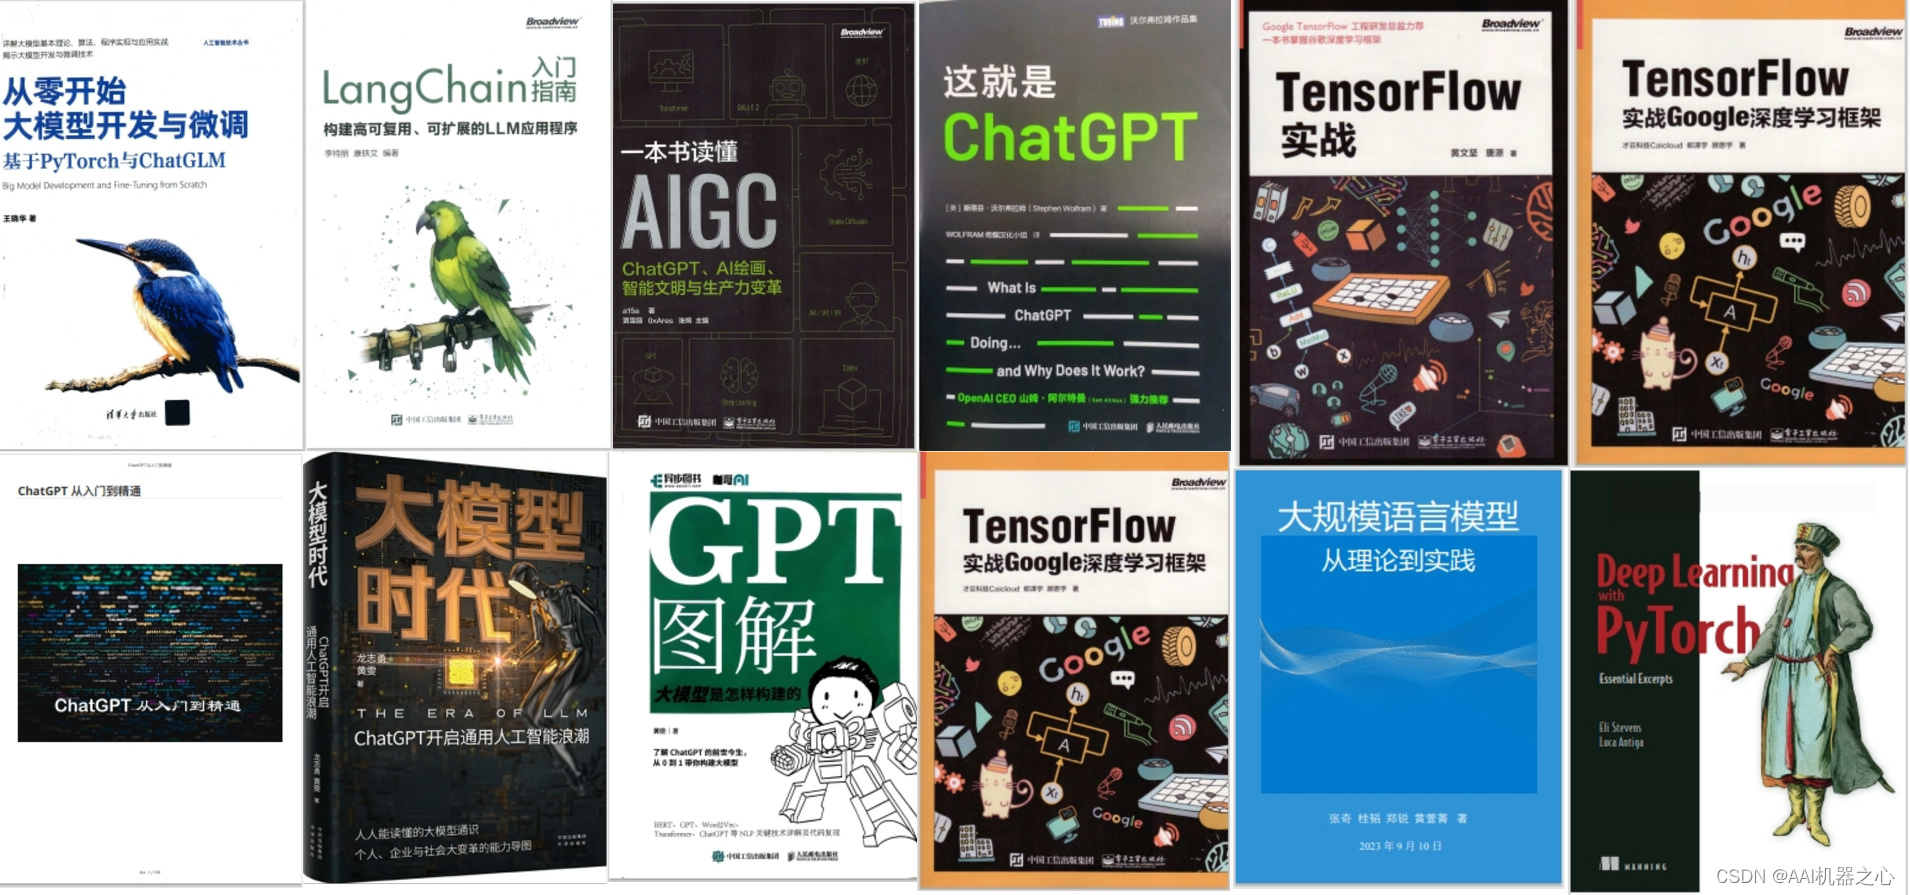
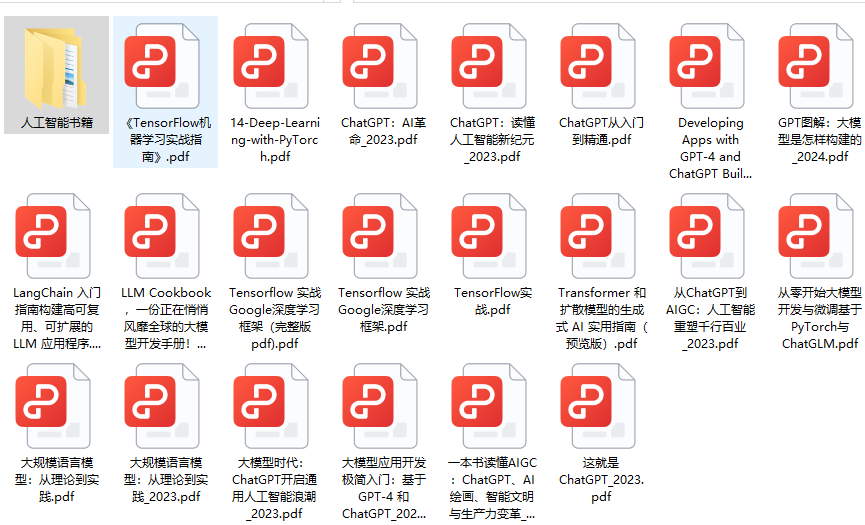
👉5.大模型经典学习电子书👈

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。(全套教程文末领取哈)
img

在这里插入图片描述

👉6.大模型面试题&答案👈

截至目前大模型已经超过200个,在大模型纵横的时代,不仅大模型技术越来越卷,就连大模型相关的岗位和面试也开始越来越卷了。为了让大家更容易上车大模型算法赛道,我总结了大模型常考的面试题。(全套教程文末领取哈)

在这里插入图片描述
👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习

这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

😝有需要的小伙伴,可以Vx扫描下方二维码免费领取🆓

解决Keil uVision许可证管理中Unknown Product错误 嵌入式开发中,IDE工具的许可证管理是确保开发环境正常运行的关键环节。Keil uVision作为ARM架构的主流开发工具,其许可证系统采用加密验证机制,通过产品版本识别实现授权控制。当出现Unknown Product错误时,通常源于版本兼容性问题或区域发行版差异,这直接影响开发工具链的可用性。特别是在维护历史项目或使用中国特供版时,开发者常会遇到此类问题。通过分析许可证类型、调整安装配置或建立虚拟化开发环境等工程实践方案,可以有效解决这类授权验证故障,保障嵌入式项目的持续集成与交付效率。 阅读详情

相关推荐

一文讲透3GPP TS 36.104发射链路相关指标

3GPP是制定移动通信标准的国际组织,其36.104规范对LTE基站射频性能提出详细要求。规范主要涵盖七方面:1)基站输出功率分类标准;2)LTE信道带宽计算方法;3)TD-LTE特有的发射机关断功率及时延要求;4)信号质量指标(频率误差和EVM)及其影响因素;5)邻道泄漏比(ACLR)的45dBc标准;6)带内频谱辐射模板(OBUE)的噪声限制;7)9kHz-12.75GHz频段的带外杂散辐射要求。这些技术要求保障了LTE基站的射频性能和网络质量。

weixin_49761275的博客 4524

AI产品经理的入门路线图,非常详细收藏我这一篇就够了

AI技术的核心是模仿人类的学习和决策过程,以在特定任务上达到并超越人类的表现。机器学习是实现AI的一种手段,它使计算机能够通过数据学习和改进。在机器学习中,算法通过对大量数据的分析学习,捕捉数据的模式和规律,并用于预测或分类任务。深度学习是机器学习的一个分支,它以人工神经网络为基础,尤其善于处理视觉和语言识别问题。深度学习模型通常需要海量的数据来训练,它可以识别和利用这些数据中的复杂模式。AI产品经理需要理解这些原理,才能准确地与团队成员和利益相关方沟通,并作出明智的决策。

m0_63171455的博客 1621

GD32F4系列定时器正交译码器实战:用TIMER1读取旋转编码器信号(附完整代码)

本文详细介绍了GD32F4系列定时器正交译码器的实战应用,重点讲解如何使用TIMER1模块高效读取旋转编码器信号。内容涵盖硬件连接、定时器配置、方向判断与速度计算等关键环节,并提供了完整的代码实现和优化建议,帮助开发者快速掌握GD32微控制器在工业控制和消费电子领域的编码器接口设计。

weixin_29169505的博客 200

大厂裸辞2个月转行AIGC产品经理,月薪3W

2024年马上过半,AIGC最近的面试机会依然非常多,陆陆续续收到很多学生的报喜,薪资10K–>19K;13K–>20K;20K–>32K;总包从45W–>60W,57W–>110W等等,所以转行要趁早呀❤️虽然AIGC领域的招聘还可以,但是今年整体就业市场不是特别好,大家要有一个心理准备。招聘量比较大的就是AIGC和新能源了。1)如果是北上广深杭等一线城市建议大家重点考虑AIGC赛道,特别是互联网行业的小伙伴;2)如果是二三线城市,可以重点靠考虑一下新能源赛道。

2301_76168381的博客 1132

PaddleOCR PP-OCRv5实战:5分钟搞定身份证信息提取(附完整代码)

本文详细介绍了如何利用PaddleOCR的PP-OCRv5模型,在5分钟内快速搭建身份证信息提取流程。文章从环境搭建、核心代码实战出发,深入解析了PP-OCRv5针对证件识别的优化特性,并提供了从OCR结果到结构化数据的完整处理方案与避坑指南,帮助开发者高效实现AI驱动的自动化信息提取。

salt9的博客 782

训练救星!EMA多尺度注意力让YOLOv11轻松攻克自定义数据集不涨点难题

在目标检测模型训练中,自定义数据集不涨点是阻碍算法落地的核心痛点之一。传统训练策略在数据分布特殊、样本量有限的场景下极易陷入收敛停滞,而 EMA(指数移动平均)结合多尺度注意力的方案,在自定义数据集上实现mAP 提升 6.5%,同时让训练曲线从“平缓停滞”转为“持续攀升”,彻底解决创新点在自有数据上的性能瓶颈。本教程将带你从原理到实践,通过 EMA 多尺度注意力为 YOLOv11 注入训练稳定性,让你的自定义数据集模型训练实现质的飞跃。EMA 衰减率:小样本数据集建议将decay。

FJN110的博客 160

详解AI产品经理工作全流程

需求定义主要要定义清楚以下几点:1、做什么?2、为什么要做,有什么收益和价值?3、业务预期目标、上线期限?为了方便理解,我们以开发一套筛选薅羊毛用户的产品进行举例说明。1、项目背景团队发现负责的项目数据统计有些异常,细查之后,发现存在夜间偷数据的情况,大致行为路径如下:淘宝上买一批手机号,注册新账号。通过自动薅羊毛的方式(新手礼包、每日签到、周任务等),获取免费券等资源。夜深人静的时候,使用免费券或积分批量下载数据。亡羊补牢,犹未晚矣。我们决定开发一套筛选薅羊毛用户的产品,彻底堵住这个缺口。

ytt0523_com的博客 2655

核磁共振常用的文件格式介绍:NIfTI volume 格式 (*.nii), GIFTI 格式 (*.gii), CIFTI 格式 (*.nii)

NIfTI volume 格式 (*.nii)GIFTI 格式 (*.gii)CIFTI 格式 (*.nii)Scene file文件 (*.scene)规格文件 (*.spec)解剖 (*.annot)一个场景文件包含一个或多个场景;每个场景实际上是保存时 wb_view 内部状态的快照。这包括有关加载哪些文件、如何显示、如何配置选项卡的信息(选择了哪些表面、在每个层中选择了哪些文件、打开了哪些层、哪些视图旋转、调色板设置、平铺选项卡等),以及在它们上面添加了哪些注释(文本、箭头、圆圈等)。

从事脑科学核磁共振方法学研究,在Nature communications等权威期刊发表研究论文,熟练掌握磁共振处理方法和统计学方法,欢迎大家和我交流。 3042

AI产品经理入门指南(非常详细)零基础入门到精通,收藏这一篇就够了

我:你为什么想做Ai产品经理?Z:不是现在都在讲人工智能,Ai么?这是个未来,应该会很有发展。我自己本身生物工程专业,就业前景不太好,所以就想转过去看看…我:你知道Ai产品经理都做些什么事吗?Z:搞机器人,各种识别啥的,你看现在「人脸支付」好牛皮,「客服机器」人帮助公司节省了大把开销等,这都是大势吧…我:你知道AI产品经理都需要什么样的能力吗?你计算机水平怎么样?Z:跟普通产品经理一样吧?发现需求,给出解决方案等?我的二级考的还行…我:~!

m0_71745484的博客 1141

Pinocchio 快速详细入门教程 —— 开源机器人运动学动力学库

本文介绍了机器人学中的数字机器人学、正逆运动学、动力学仿真与控制、最优控制等核心主题,以及Pinocchio库的应用。内容包括: 数字机器人学:通过UR5机器人模型演示了构型空间采样、碰撞检测、路径规划等基础操作,使用优化方法在约束条件下寻找有效构型。 运动学:详细讲解了二维和三维机器人的正运动学(构型到末端位置)和逆运动学(目标位置到构型),包括串联机械臂和并联机器人的处理。 动力学与控制:介绍了动力学仿真(如自由落体、摩擦效应)、PD控制、计算扭矩控制,以及接触仿真(碰撞检测与处理)。 最优控制:以独轮

机器人控制与仿真应用 2883

30天入门 SAP BTP 开发系列之二:了解 SAP BTP Region 的概念,包含账号申请的详细步骤

SAP BTP 的 Region,实际是一组按地理位置划分的、由 SAP 或合作 Hyperscaler 承载的基础设施栈。这些基础设施栈至少包含多可用区网络、对象存储、计算节点及自动化运维等服务。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 1456

AI产品经理学习路径:从零基础到精通,从此篇开始!

市面上不同的公司对产品经理的定位有很大的差别,一名合格的产品经理是能对软件产品整个生命周期负责的人。AI产品经理和通用型软件产品经理的底层思考框架是一样的,都是要经历产品立项、需求分析、产品设计、产品执行管理(研发测试)、验收、分析迭代这几个阶段。:通用型产品经理,只需要把业务流程、痛点理清楚,在进行逻辑处理、界面流程化,软件化即可。而AI产品是AI技术为出发点,为各行各业提供全新的解决方案,甚至会变更原来的业务流程和使用方式。人工智能已经成为国家的重点发展方向之一,各行各业也加入到AI这个大家庭。

2401_85375298的博客 1427

基于深度学习的水质预测:多参数监测与预测

在本篇博客中,我们详细介绍了如何使用深度学习技术处理水质预测问题,包括数据集的准备与预处理、多层感知机模型的构建、模型的训练与评估以及模型优化策略。我们使用 Python 语言基于 TensorFlow 和 Keras 框架实现了模型,并给出了各种模型优化方法及对应代码。通过实践,我们可以发现深度学习技术在水质预测方面具有很好的应用潜力。在实际应用中,我们还可以根据具体问题和数据集进一步调整和优化模型,以获得更好的预测性能。

斌擎科技 1075

一文了解什么是产品经理?从入门到精通,一篇文章带你入门!(附学习资料)

需求定义主要要定义清楚以下几点:1、做什么?2、为什么要做,有什么收益和价值?3、业务预期目标、上线期限?为了方便理解,我们以开发一套筛选薅羊毛用户的产品进行举例说明。1、项目背景团队发现负责的项目数据统计有些异常,细查之后,发现存在夜间偷数据的情况,大致行为路径如下:淘宝上买一批手机号,注册新账号。通过自动薅羊毛的方式(新手礼包、每日签到、周任务等),获取免费券等资源。夜深人静的时候,使用免费券或积分批量下载数据。亡羊补牢,犹未晚矣。我们决定开发一套筛选薅羊毛用户的产品,彻底堵住这个缺口。

2401_85373396的博客 4578

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

一文了解什么是Ai产品经理?从入门到精通,一篇文章带你入门!(附学习资料)

需求定义主要要定义清楚以下几点:1、做什么?2、为什么要做,有什么收益和价值?3、业务预期目标、上线期限?为了方便理解,我们以开发一套筛选薅羊毛用户的产品进行举例说明。1、项目背景团队发现负责的项目数据统计有些异常,细查之后,发现存在夜间偷数据的情况,大致行为路径如下:淘宝上买一批手机号,注册新账号。通过自动薅羊毛的方式(新手礼包、每日签到、周任务等),获取免费券等资源。夜深人静的时候,使用免费券或积分批量下载数据。亡羊补牢,犹未晚矣。我们决定开发一套筛选薅羊毛用户的产品,彻底堵住这个缺口。

jennycisp的博客 944

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

一文了解什么是产品经理?2025AI产品经理从入门到精通,一篇文章带你入门!(附学习资料)

需求定义主要要定义清楚以下几点:1、做什么?2、为什么要做,有什么收益和价值?3、业务预期目标、上线期限?为了方便理解,我们以开发一套筛选薅羊毛用户的产品进行举例说明。1、项目背景团队发现负责的项目数据统计有些异常,细查之后,发现存在夜间偷数据的情况,大致行为路径如下:淘宝上买一批手机号,注册新账号。通过自动薅羊毛的方式(新手礼包、每日签到、周任务等),获取免费券等资源。夜深人静的时候,使用免费券或积分批量下载数据。亡羊补牢,犹未晚矣。我们决定开发一套筛选薅羊毛用户的产品,彻底堵住这个缺口。

2401_85373396的博客 1252

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

一篇文章带你了解:产品经理怎么转型做 AI

生成式AI的迅速崛起,使我们置身于一个充满无限可能的转折点。身处其中的每个人都渴望抓住时代的机遇,成为构建新世界的一部分。在这场技术革命中,率先拥抱变化的先行者们正在采取哪些行动,已成为一个备受关注的话题。在我们身边,越来越多人投入AI领域,有些创办了模型公司,有些专注于toC应用开发,也有些人聚焦于toB服务。其中部分创业者,无论在用户规模、影响力,还是营收表现上,都取得了相当优异的成绩。我相信,AIGC浪潮将带来一批新的内容偶像,这在某些小圈子里已经初现端倪。在围绕AI创作的小型社群中,不少被称为“大神

python12345_的博客 1805

AI产品经理:从零基础到精通,一篇掌握必备技能

ChatGPT爆火后,有人就预言“所有行业都值得用AI重做一遍”,而头一个被AI浪潮吹到的领域,非产品届莫属了。从去年底开始,全球各大企业就处于空前的人AI招聘狂潮中,一些公司甚至不惜开出接近七位数的年薪来雇佣顶尖人才。亚马逊人工智能高级产品经理的薪酬达到了34.03万美元;Match Group旗下的在线约会平台Hinge招聘人工智能副总裁,基础年薪为33.2万至39.8万美元;著名兼职平台Upwork,人工智能副总裁一职的年薪为26万至43.7 万美元;

m0_70486148的博客 1954

AI产品经理入门指南:零基础到精通,看这一篇就够了!

市面上不同的公司对产品经理的定位有很大的差别,一名合格的产品经理是能对软件产品整个生命周期负责的人。AI产品经理和通用型软件产品经理的底层思考框架是一样的,都是要经历产品立项、需求分析、产品设计、产品执行管理(研发测试)、验收、分析迭代这几个阶段。:通用型产品经理,只需要把业务流程、痛点理清楚,在进行逻辑处理、界面流程化,软件化即可。而AI产品是AI技术为出发点,为各行各业提供全新的解决方案,甚至会变更原来的业务流程和使用方式。人工智能已经成为国家的重点发展方向之一,各行各业也加入到AI这个大家庭。

Cairo_A的博客 1152

【AI产品经理附学习资料】让你从入门到精通,这一篇文章通通搞定!

一、AI产品经理工作全流程概览AI产品经理工作全流程中与普通产品经理的区别主要是多了算法模型部分,包括模型预研、数据准备、模型构建、模型宣讲、模型验收,协作的对象相对普通产品经理也多了算法工程师。二、需求定义需求定义主要要定义清楚以下几点:1、做什么?2、为什么要做,有什么收益和价值?3、业务预期目标、上线期限?为了方便理解,我们以开发一套筛选薅羊毛用户的产品进行举例说明。

m0_71745484的博客 1014

一篇文章带你了解:产品经理怎么转型做 AI,零基础入门到精通,收藏这篇就够了

首先,是将已验证的人工智能技术有效地融入到各个行业的多样化场景之中,以此提高这些场景的运作效率和成果表现。其次,是依据业务具体需求,利用现有的人工智能技术或技术组合来满足,更可以与技术团队合作,自己开发全新的人工智能软件解决方案或硬件产品,增加收入与影响力。**目前正在参加秋招的大学生们,想要进入互联网行业,看到很多AI产品经理的岗位,**

资深程序员,曾自学JAVA,C#,如今从业于网安行业 1458
上一篇: 迈向大模型领域:产品经理转型全攻略
下一篇: 大模型还有未来吗?行业的未来发展之路如何?
大模型产品经理
博客等级 码龄3年 1万+粉丝 1120原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值