攻克大模型面试!RAG基础与应用痛点一网打尽!

大模型面经 | 春招、秋招算法面试常考八股文附答案(RAG专题一) 今天给大家分享一些关于大模型面试常见的RAG(检索增强生成)相关面试题,希望对大家的面试有所帮助。 阅读详情

RAG相关理论知识与经验整理。

谈到大模型在各垂直领域中的应用,一定离不开RAG,本系列开始分享一些RAG相关使用经验,可以帮助大家在效果不理想的时候找到方向排查或者优化。

本系列以医疗领域为例,用面试题的形式讲解RAG相关知识,开始RAG系列的分享~

本篇主要是理论知识与经验;后续会结合最新的优化方法给出详细的优化代码,和实践中衍生的思考。

下面是本篇的快捷目录。

1. RAG思路

2. RAG中的prompt模板

3. 检索架构设计

一、RAG思路

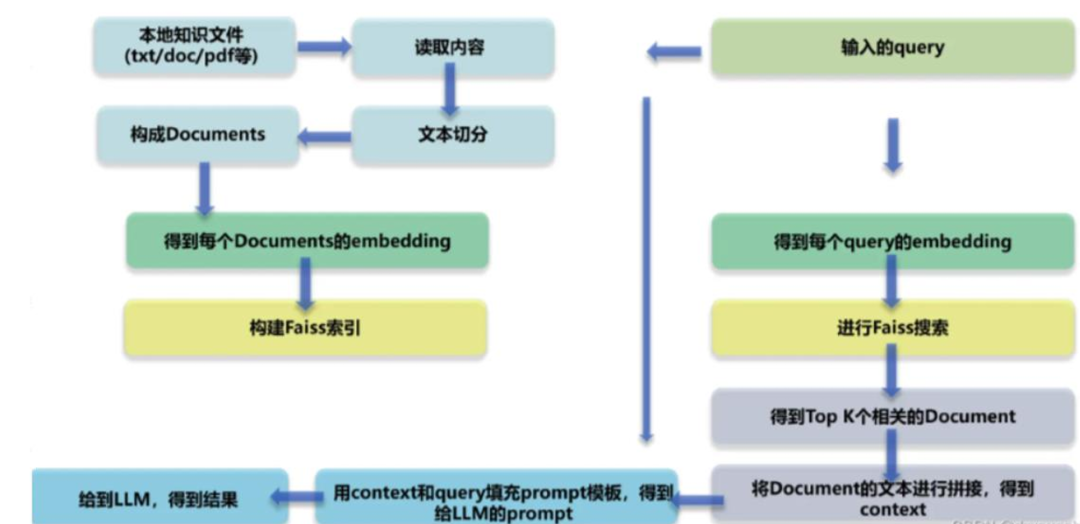
这里有一张经典的图:
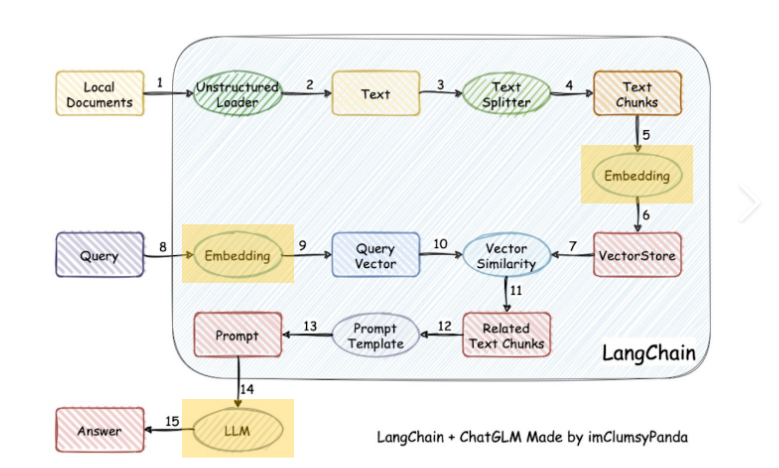
具体步骤是:

  • 加载文件

  • 读取文本

  • 文本分割

  • 文本向量化

  • 问句向量化

  • 在文本向量中匹配出与问句向量最相似的top k个

  • 匹配出的文本作为上下文和问题一起添加到 prompt 中

  • 提交给 LLM 生成回答

二、RAG中的prompt模板

已知信息:{context}

根据上述已知信息,简洁和专业的来回答用户的问题。如果无法从中得到答案,请说 “根据已知信息无法回答该问题” 或 “没有提供足够的相关信息”,不允许在答案中添加编造成分,答案请使用中文。

问题是:{question}

其中 {context} 就是检索出来的文档。

三、检索架构设计

基于LLM的文档对话架构分为两部分,先检索,后推理。重心在检索(推荐系统),推理一般结合langchain交给LLM即可。

因此接下来主要是检索架构设计内容。

1. 检索要求

  • 提高召回率

  • 能减少无关信息

  • 速度快

2. 检索逻辑

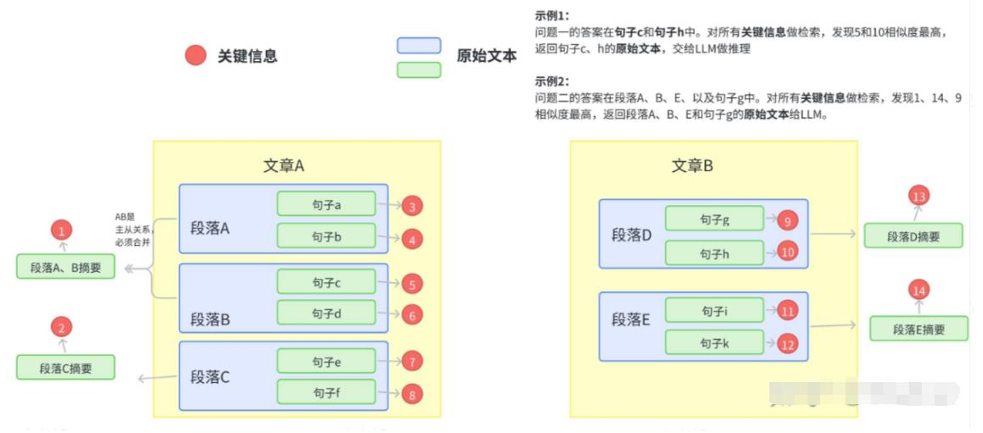
拿到需要建立检索库的文本,将其组织成二级索引,第一级索引是 [关键信息],第二级是 [原始文本],二者一一映射。 [关键信息]用于加快检索, [原始文本]用于返回给prompt得到结果。

向量检索基于关键信息embeddig,参与相似度计算,检索完成后基于关键信息与原始文本的映射,将原始文本内容作为 {context} 返回。

主要架构图如下:
3. 切分与关键信息抽取

关键信息抽取前需要先对拿到的文档进行切分。

其实文档切分粒度比较难把控,粒度过小的话跨段落语义信息可能丢失,粒度过大噪声又太多。因此在切分时主要是按语义切分。

因此拿到文档先切分再抽取关键信息,可根据实际情况考虑是否进行文章、段落、句子更细致粒度的关键信息抽取。

下面具体来讲讲方法和经验:

1)切分

  • 基于NLP篇章分析(discourse parsing)工具

提取出段落之间的主要关系,把所有包含主从关系的段落合并成一段。这样对文章切分完之后保证每一段在说同一件事情。

  • 基于BERT中NSP(next sentence prediction)的训练任务

基于NSP(next sentence prediction)任务。设置相似度阈值t,从前往后依次判断相邻两个段落的相似度分数是否大于t,如果大于则合并,否则断开。

2)关键信息抽取

  • 直接存储以标点切分的句子:只适用于向量库足够小(检索效率高)且query也比较类似的情况。

  • 传统NLP工具:成分句法分析(constituency parsing)可以提取核心部分(名词短语、动词短语……);命名实体识别(NER)可以提取重要实体(货币名、人名、企业名……)。

  • 生成关键词模型:类似于ChatLaw中的keyLLM,,即:训练一个生成关键词的模型。在医疗领域中,这个方法是目前比较靠谱且能通用的方法。

如何学习AI大模型 ?

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。【保证100%免费】🆓

对于0基础小白入门:

如果你是零基础小白,想快速入门大模型是可以考虑的。

一方面是学习时间相对较短,学习内容更全面更集中。
二方面是可以根据这些资料规划好学习计划和方向。

😝有需要的小伙伴,可以VX扫描下方二维码免费领取🆓
👉1.大模型入门学习思维导图👈

要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。

对于从来没有接触过AI大模型的同学,我们帮你准备了详细的学习成长路线图&学习规划。可以说是最科学最系统的学习路线,大家跟着这个大的方向学习准没问题。(全套教程文末领取哈)
在这里插入图片描述

👉2.AGI大模型配套视频👈

很多朋友都不喜欢晦涩的文字,我也为大家准备了视频教程,每个章节都是当前板块的精华浓缩。

在这里插入图片描述
在这里插入图片描述

👉3.大模型实际应用报告合集👈

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(全套教程文末领取哈)
在这里插入图片描述

👉4.大模型落地应用案例PPT👈

光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。(全套教程文末领取哈)

在这里插入图片描述

👉5.大模型经典学习电子书👈

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。(全套教程文末领取哈)

img

在这里插入图片描述

👉6.大模型面试题&答案👈

截至目前大模型已经超过200个,在大模型纵横的时代,不仅大模型技术越来越卷,就连大模型相关的岗位和面试也开始越来越卷了。为了让大家更容易上车大模型算法赛道,我总结了大模型常考的面试题。(全套教程文末领取哈)

在这里插入图片描述
👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习

这份完整版的 AI 大模型学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

😝有需要的小伙伴,可以Vx扫描下方二维码免费领取🆓

王爽《汇编语言》课程设计2(不涉及软盘版本) assume cs:code,ds:data,ss:stack stack segment db 128 dup (0) stack ends data segment db 256 dup (0) data ends code segment start: mov ax,stack mov ss,ax mov sp,128 ... 阅读详情

相关推荐

如何使你的直流电机闭环?(PID讲解)

看了看很多大佬写的PID讲解很全面也很复杂,实在是不适合很多萌新入坑,所以想按自己的理解写一篇通俗易懂的PID算法讲解

a2001444的博客 1万+

RAG(检索增强生成)面经(1)

MRR更关注第一个相关结果的位置,适合需要快速找到答案的场景。Hits Rate则关注前k个返回结果中是否包含相关文档,适合衡量系统在给定返回数量内找到相关文档的能力。NDCG则进一步关注结果的排序和相关性,是衡量整体检索质量的综合性指标。

m0_56569131的博客 1680

VFIO框架源码分析(一)- 从初始化到设备访问

本文深入剖析了Linux内核中的VFIO(Virtual Function I/O)框架,详细解读了其从初始化到设备访问的全过程。VFIO通过Container->Group->Device的层次化设计,利用IOMMU提供安全隔离,允许用户空间直接访问物理设备。文章基于Linux v5.15版本,重点分析了vfio_init模块入口、Container创建与配置、Group关联以及最终设备访问等关键环节,揭示了VFIO如何通过逐层授权机制构建安全可靠的设备直通模型,为虚拟化技术提供核心支持。

qq_36071928的博客 380

大模型 RAG 面试篇

大模型 RAG面试题 收集一

fan_fan_feng的专栏 2892

SPI协议详解(图文并茂+超详细)

先说串口 因为之前写过一篇UART,通用串行异步通讯协议,UART的相关资料 因为UART没有时钟信号,无法控制何时发送数据,也无法保证双发按照完全相同的速度接收数据。因此,双方以不同的速度进行数据接收和发送,就会出现问题。 如果要解决这个问题,UART为每个字节添加额外的起始位和停止位,以帮助接收器在数据到达时进行同步; 双方还必须事先就传输速度达成共识(设置相同的波特率,例如每秒9600位)。 传输速率如果有微小差异不是问题,因为接收器会在每个字节的开头重新同步。相应的协议如下图所示; 如果您注意到

一名热爱技术的工程师的博客。分享技术干货,记录美好生活。永远相信美好的事情即将发生。 33万+

【CANdelaStudio编辑CDD】-1.2-给$10服务SessionControl创建一个新Session会话并修改Session state machine会话状态机(UDS诊断)

前一篇:【UDS诊断描述文件CDD】-1.1-ISO_14229中$10服务理论部分https://blog.youkuaiyun.com/qfmzhu/article/details/120375515案例背景: 在CDD中如何给$10服务创建一个新的Session会话; 在CDD中如何给$10服务修改Session state machine会话状态机。 目录 1 查看$10服务中已有的Session会话​ 2 查看$10服务中已有的Session state machine会话状态机 3 在$10...

「汽车电子助手」的博客 6076

AI大模型面经—RAG工程实践经验总结,建议收藏起来慢慢看!!

虽然RAG工程整体有很多论文、算法和方法论,但在实际使用过程中,当数据量大了RAG很容易出现不可控的问题, 本篇就针对实践过程中遇到的问题总结面经进行分享,看看能不能给大家提供一些帮助。一. RAG如何去优化索引结构?1. 优化被检索的embedding1)微调被检索的embedding让被检索的内容与query之间的相关性更加紧密特别是术语更新较快且比较罕见的领域,可以针对性地进行微调。2)动态embedding基于上下文动态调整embedding。

Android23333的博客 870

【YOLOv12多模态融合改进】| TFAM:时序融合注意力模块 | 引入通道 - 空间双分支注意力机制,解决双模态特征融合中时序关联不足的问题

TFAM模块通过时序信息驱动的注意力机制,解决了双时相特征融合中时序关联不足的问题,实现了更精准的变化区域定位和特征表示。其结构轻量、泛化性强,为变化检测任务提供了一种高效的特征融合解决方案。

Limiiiing的博客 866

大模型面经—RAG工程实践经验总结

虽然RAG工程整体有很多论文、算法和方法论,但在实际使用过程中,当数据量大了RAG很容易出现不可控的问题, 本篇就针对实践过程中遇到的问题总结面经进行分享,看看能不能给大家提供一些帮助。下面是一个快捷目录。下面是答案。**目的:**让被检索的内容与query之间的相关性更加紧密特别是术语更新较快且比较罕见的领域,可以针对性地进行微调。**目的:**基于上下文动态调整embedding当然这只是个发论文的思路,工程落地的时候这块还是有待验证的。

2401_85375186的博客 1044

YOLOv11涨点改进 | NeurIPS2025最佳论文!注意力改进篇| 引入Gated Attention门控注意力模块、太牛了!直接拯救了大模型的发展,助力目标检测、图像分割、图像分类有效涨点

本文提出了一种基于门控注意力机制(GatedAttention)的YOLOv11改进方法。该模块通过在标准注意力机制中引入头部特定的sigmoid门控,有效提升了模型性能和训练稳定性。实验表明,GatedAttention能够增强模型对关键信息的聚焦能力,减少无关区域关注,提高检测精度。同时,门控机制带来的非线性和稀疏性优化了计算效率,并缓解了训练不稳定性问题。文章详细介绍了模块原理、实现代码及三种改进方案配置方法,为YOLOv11在复杂场景下的目标检测提供了有效解决方案。

Ai缝合怪、助力小伙伴高效发论文 495

Sigrity SPEED2000 TDR TDT Simulation模式如何进行时域阻抗仿真分析操作指导-差分信号

Sigrity SPEED2000 TDR TDT Simulation模式如何进行时域阻抗仿真分析操作指导-单端信号详细介绍了单端信号如何进行TDR仿真分析,下面介绍如何对差分信号进行TDR分析,还是以下图为例进行分析。Impedance是时域阻抗曲线,也是最主要的观测指标,注意:impedance曲线的时间刻度不是延时,延时=时间刻度/2,因为TDR测量的是用一来一回的原理去测量的。Use Lossy peeling 默认不勾选,勾选的话代表同时仿真无损和有损方案,不勾选代表仅仿真有损方案。

weixin_54787054的博客 857

面试大模型工作必备--10道RAG面试题

摘要:本文分享10道RAG(检索增强生成)领域的面试题及答案,涵盖RAG与传统微调的区别、缓解模型幻觉的原理、检索技术、文档处理策略等核心知识点。文章还提供了AI大模型学习路线和资源包,包含640份行业报告、视频教程及开源项目等,帮助读者系统掌握LLM技术。资源可通过扫描二维码免费获取,适合希望入门或进阶AI大模型的开发者学习参考。(150字)

Z4400840的博客 1235

物联网系列③——基于ESP8266与点灯科技平台的温湿度计设计(接入小爱同学)

物联网系列③——基于ESP8266与点灯科技平台的温湿度计设计(接入小爱同学)一、设计目标二、电路展示三、存在的问题四、代码五、需要注意的问题 一、设计目标       前一阵子偶然接触到点灯科技平台,产生了制作一块ESP8266电路板,拥有以下功能: 使用CH340对ESP8266进行程序下载 使用DHT11进行温湿度数据读取 使用点灯科技平台接入物联网,可通过手机APP获得室内温湿度 接入小爱同学,通过语音获取室内温湿度信息 Mico US

weixin_43278295的博客 8853

面试大模型必备!10道RAG高频面试题揭秘(含答案)!

本文分享了大模型课程中RAG(检索增强生成)技术的10道核心面试题及答案解析,涵盖RAG与传统微调的区别、缓解幻觉的机制、文档检索策略、向量处理等关键技术点。作者指出RAG通过动态检索外部知识库有效解决大模型静态知识滞后问题,并详细解析了稀疏/稠密检索、文档分块、结果融合等实现方案。同时文章附带大模型学习路径(4阶段90天计划)和免费资料包(含案例库/提示模板/学习路线),强调掌握AI工具对职业发展的重要性,适合希望系统学习大模型技术的开发者参考。

2401_85390073的博客 786

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

大模型面试全解析:从RAG到代码,小白必备,速收藏!

对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。

m0_48891301的博客 371

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

【AI大模型算法岗必看】面试全攻略:从Transformer到大模型应用,一篇文章助你攻克所有面试难题!

本文为算法岗位求职者提供全面指南,涵盖Transformer架构详解、大模型应用技术(RAG、Agent等)、性能优化方法(量化、蒸馏等)、训练中的常见问题及解决方案,以及数据并行和模型并行技术。文章还提供了AI算法交流平台信息,帮助求职者准备面试、获取内推和学习资源,是面试准备的实用宝典。

2401_84208172的博客 832

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

大模型面试全解析:从RAG到代码,小白也能轻松收藏学!

本文分享了作者在腾讯大模型算法岗面试中的真实经历和思考过程,涵盖了RAG系统、大模型训练优化、推荐算法和基础能力等多个方面,详细解答了面试中被问到的问题,并提供了实用的解决思路和反思。对于准备相关岗位或想系统学习RAG方向的读者来说,这是一篇非常有价值的参考资料。最近金三银四,后台不少读者留言让我聊聊大模型方向的面试经验。恰好上个月我完整经历了某鹅的大模型用算法岗面试,从一面到三面,整整三轮技术轰炸,出来的时候感觉脑子都被掏空了。但不得不说,这场面试让我对自己过去两年的技术积累有了全新的梳理。今天我就把面试

EnjoyEDU的博客 448

【面试必备】24 道大厂 RAG 八股文精编,吃透就能轻松过面!

【面试必备】24 道大厂 RAG 八股文精编,吃透就能轻松过面!

2301_76168381的博客 1903

RAG面试全攻略:从核心原理到工程实践,攻克AI大模型应用必考题

检索增强生成(RAG)是当前连接大语言模型能力与真实业务需求的关键工程技术。其核心原理在于通过引入外部知识检索机制,将生成过程分为检索与增强两阶段,有效缓解了大模型的幻觉问题与知识更新延迟。从技术价值看,RAG提升了生成内容的可控性、可信度与时效性,无需重新训练基础模型即可整合最新知识,在成本与效率上具有显著优势。这一技术已广泛应用于智能客服、法律咨询、医疗问答等对事实准确性要求极高的场景,成为构建可靠AI应用的基础架构。本文聚焦于RAG系统的核心组件,深入探讨嵌入模型选型、向量数据库对比及提示工程优化等工

weixin_33829657的博客 307

小白程序员必看!手把手教你攻克AI大模型面试

2026 年一晃已经过半,AI 大模型的热潮不仅没有降温,反而持续升温!金融行业用大模型做风控、医疗依靠 AI 解析影像,电商、制造、教育各行各业,都在把 AI 融入日常业务。曾经热闹的 “百模大战”,早就告别单纯比拼模型参数,正式进入落地应用时代。懂业务、懂 AI、能做出可上线项目的大模型开发工程师,岗位缺口大,薪资待遇十分可观。风口再好,不如手握高薪 offer 实在。行情火热,普通人、程序员该怎样从零入门大模型,抓住这波机会?

大模型研究中心 387

大模型面试复盘:手把手带你从RAG到代码,小白也能收藏学习!

本文通过作者面试腾讯大模型算法岗的真实经历,详细复盘了面试中被问到的问题及思考过程,涵盖RAG系统、大模型训练优化、推荐算法及基础代码能力等多个核心板块。文章不仅解答了技术细节,还深入分析了工程实践中的难点与解决方案,适合准备相关岗位或想系统学习大模型知识体系的学习者参考。最近金三银四,后台不少读者留言让我聊聊大模型方向的面试经验。恰好上个月我完整经历了某鹅的大模型用算法岗面试,从一面到三面,整整三轮技术轰炸,出来的时候感觉脑子都被掏空了。但不得不说,这场面试让我对自己过去两年的技术积累有了全新的梳理。

优快云_224022的博客 606

大模型求职急救营:6周从零基础到大厂Offer!

大模型求职急救营:6周从零基础到大厂Offer!

瓦罗兰特顶级C位的博客 980

从落地到未来:RAG、Agent、多模态的技术演进与行业应用深度剖析!看看普通人适合入哪一行?

全球机器学习大会(ML-Summit)揭示大模型技术三大核心方向:检索增强生成(RAG)突破模型知识边界,智能体(Agent)重构人机协作范式,多模态技术实现跨模态理解。三者协同攻克了数据时效性、隐私安全等关键难题,推动医疗、金融等领域的深度变革。RAG通过动态知识融合解决静态模型局限,Agent实现自主决策与工具调用,多模态技术提升真实场景认知能力。当前技术面临多模态数据处理、检索精度等挑战,未来将向统一文档处理、记忆驱动架构等方向演进,持续释放大模型的产业价值。

m0_65555479的博客 5250

AI大模型应用开发实战:RAG、Agent与LangGraph核心技术与面试指南

大语言模型(LLM)应用开发正经历从确定性编程到非确定性智能的范式转变。其核心原理在于通过工程化框架增强模型能力,解决知识过时、幻觉生成等固有局限。这一转变的技术价值在于构建可靠、强大的AI应用,使其能够处理复杂业务场景。当前,检索增强生成(RAG)和智能体(Agent)已成为连接大模型与实际应用的关键技术。RAG通过外部知识库检索为模型提供实时、准确的上下文,有效应对知识静态化问题;Agent则赋予模型自主规划与工具调用能力,以完成复杂任务。这些技术共同服务于智能问答、自动化流程等广泛的应用场景。本文聚焦

weixin_29061509的博客 343

收藏!美团面试必看:LLM大模型核心问题与RAG优化全攻略

针对以上问题,RAG(检索增强生成)技术提供了一种有效的优化方法。RAG通过结合检索和生成两个过程,利用检索到的外部信息来增强生成模型的表现。以下是一些RAG优化的大致优点:采用先进的检索技术:如密集向量检索、稀疏向量检索等,这些技术能够更好地捕捉文本之间的语义相似性,从而提高检索的准确性和效率。多向量表示:使用多个向量来表示同一个文档或查询,以捕捉不同方面的信息,从而增加检索的全面性。实时检索:对于需要处理最新信息的任务,实时检索是必不可少的。这要求检索系统能够快速响应并更新索引数据。

ytt0523_com的博客 671

收藏!2026年,AI大模型彻底迎来应用爆发之年!

脉脉高聘最新数据显示,2025年1-10月AI相关岗位需求同比暴涨543%,其中AI科学家平均月薪突破12.7万元,更令人惊喜的是,应届生岗位中已有14.68%实现年薪百万的目标。小鹏、华为、字节跳动等科技头部企业的新发岗位里,每10个就有1个聚焦AI领域——如今的AI早已不是停留在概念里的“未来科技”,而是像电力、互联网一样,深度渗透到工作与生活的方方面面,成为不可替代的核心生产力。

大模型研究中心 3808
上一篇: 从小白到入门,写给程序员的LLM学习指南
下一篇: 速成秘籍!10分钟从新手到高手,LangChain快速上手指南!
大模型产品经理
博客等级 码龄3年 1万+粉丝 1120原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值