揭秘现代AI技术前沿:深入探讨TensorFlow、LangChain、LLaMA、Qwen与GPT的应用与创新

【GraphRAG】本地部署全流程!超详细介绍! graphrag本地部署 阅读详情
AI摘要

本文介绍了TensorFlow、LangChain、LLaMA、Qwen和GPT这五个重要AI技术,阐述了它们的特点、应用场景并给出示例。TensorFlow是全面的机器学习框架,后四者在自然语言处理方面各有优势。此外,作者还分享了大模型AI学习资料,包括思维导图、视频等。

在现代人工智能领域,有众多的工具和框架助力于机器学习和自然语言处理的研究与应用。本文将讨论 TensorFlow、LangChain、LLaMA、Qwen 和 GPT 这五个重要技术,它们在设计、功能和应用上的主要区别。

一、TensorFlow

TensorFlow 是 Google 开发的开源机器学习框架,用于创建和训练深度学习模型。它支持广泛的机器学习任务,包括计算机视觉和自然语言处理。

特点

  • 深度学习: 提供构建和训练神经网络的能力,包括卷积神经网络(CNNs)和循环神经网络(RNNs)。
  • 自动微分: 内建自动计算梯度功能,简化模型训练过程。
  • 跨平台支持: 能在 CPU、GPU 和 TPU 上运行,适用于不同的计算环境。
  • 模型部署: 包括 TensorFlow Serving 和 TensorFlow Lite 等工具,便于模型部署和推理。

应用场景

  • 计算机视觉: 用于图像分类、目标检测等。
  • 自然语言处理: 处理文本分类、情感分析等任务。
  • 预测分析: 进行时间序列预测和回归分析。

TensorFlow 示例:构建一个简单的神经网络

构建一个简单的神经网络模型,用于手写数字分类(MNIST 数据集)。

import tensorflow as tf
from tensorflow.keras.datasets import mnist
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Flatten
from tensorflow.keras.utils import to_categorical

# 加载数据
(x_train, y_train), (x_test, y_test) = mnist.load_data()

# 数据预处理
x_train = x_train / 255.0
x_test = x_test / 255.0
y_train = to_categorical(y_train, 10)
y_test = to_categorical(y_test, 10)

# 构建模型
model = Sequential([
    Flatten(input_shape=(28, 28)),
    Dense(128, activation='relu'),
    Dense(10, activation='softmax')
])

# 编译模型
model.compile(optimizer='adam',
              loss='categorical_crossentropy',
              metrics=['accuracy'])

# 训练模型
model.fit(x_train, y_train, epochs=5)

# 评估模型
loss, accuracy = model.evaluate(x_test, y_test)
print(f'Accuracy: {accuracy}')

二、LangChain

LangChain 是一个框架,专注于构建和集成语言模型驱动的应用。它为开发者提供了处理语言模型的工具和接口。

特点

  • 模型集成: 支持与多种语言模型集成,包括 GPT 系列。
  • 数据处理: 提供数据处理工具,将原始数据转换为模型输入格式。
  • 上下文管理: 维护对话上下文,改进生成和理解能力。
  • 应用构建: 提供构建语言模型应用的组件和示例代码。

应用场景

  • 对话系统: 创建聊天机器人和虚拟助手。
  • 内容生成: 生成博客文章、报告等。
  • 数据查询: 实现自然语言查询和自动回答系统。

LangChain 示例:集成一个语言模型并进行简单对话

使用 LangChain 集成 GPT-3 模型,并进行简单对话。

from langchain import OpenAI
from langchain.chains import ConversationChain

# 初始化 GPT-3 模型
llm = OpenAI(model="text-davinci-003")

# 创建对话链
conversation = ConversationChain(llm=llm)

# 进行对话
response = conversation.run("Hello, how are you today?")
print(response)

三、LLaMA

LLaMA(Large Language Model Meta AI)是 Meta(前 Facebook)开发的大规模语言模型,旨在提升自然语言处理的能力。

特点

  • 高性能生成: 提供高质量的文本生成能力,适用于内容创作和对话系统。
  • 多语言支持: 支持多种语言的处理,增强了跨语言能力。
  • 上下文处理: 优化了对长文本和复杂上下文的处理能力。

应用场景

  • 对话系统: 提供自然流畅的对话体验,适用于聊天机器人和客户支持。
  • 文本分析: 用于情感分析、信息提取等任务。
  • 内容创作: 生成高质量的文章、博客和报告。

LLaMA 示例:使用 LLaMA 进行简单的文本生成

利用 LLaMA 模型生成一段文本。

from transformers import LlamaTokenizer, LlamaForCausalLM

# 加载 LLaMA 模型和 tokenizer
tokenizer = LlamaTokenizer.from_pretrained("meta-llama/Llama-2-7b")
model = LlamaForCausalLM.from_pretrained("meta-llama/Llama-2-7b")

# 输入文本
input_text = "Once upon a time in a land far, far away"

# 编码和生成文本
inputs = tokenizer(input_text, return_tensors="pt")
outputs = model.generate(inputs['input_ids'], max_length=50)

# 解码和打印生成的文本
print(tokenizer.decode(outputs[0], skip_special_tokens=True))

四、Qwen

Qwen 是 OpenAI 开发的语言模型系列中的一部分,旨在提升自然语言处理任务的性能和准确性。Qwen-2 是该系列的第二代模型。

特点

  • 多语言支持: 能处理多种语言的文本。
  • 先进深度学习技术: 结合最新的深度学习技术,提升上下文理解和生成能力。
  • 大规模预训练: 在大规模数据集上预训练,增强模型的泛化能力。

应用场景

  • 文本生成: 生成高质量的自然语言文本,适用于内容创作。
  • 文本理解: 理解和解析复杂文本,支持信息提取和问答任务。
  • 对话系统: 提供自然流畅的对话体验。

Qwen 示例:Qwen-2 进行文本分类

使用 Qwen-2 模型进行简单的文本分类任务。

from transformers import QwenTokenizer, QwenForSequenceClassification

# 加载 Qwen-2 模型和 tokenizer
tokenizer = QwenTokenizer.from_pretrained("openai/qwen-2")
model = QwenForSequenceClassification.from_pretrained("openai/qwen-2")

# 输入文本
input_text = "The weather is nice today."

# 编码和分类
inputs = tokenizer(input_text, return_tensors="pt")
outputs = model(**inputs)

# 获取预测结果
predictions = outputs.logits.argmax(dim=-1)
print(f"Predicted class: {predictions.item()}")

五、GPT

GPT(Generative Pre-trained Transformer)系列是 OpenAI 开发的一系列语言模型,包括 GPT-1、GPT-2、GPT-3 和 GPT-4。GPT 系列是基于 Transformer 架构的,专注于生成和理解自然语言。

特点

  • 大型预训练模型: 在大规模文本数据上训练,具有强大的生成和理解能力。
  • 高效能生成: 能生成流畅自然的文本,处理多种语言任务。
  • 多任务学习: 支持文本生成、翻译、问答等多种任务。

应用场景

  • 对话生成: 提供流畅的对话体验,适用于虚拟助手和聊天机器人。
  • 内容创作: 生成文章、故事和其他文本内容。
  • 文本分析: 执行情感分析、主题建模和信息提取等任务。

GPT 示例:使用 GPT-4 进行文本生成

使用 GPT-4 模型生成一段文本。

from transformers import GPT4Tokenizer, GPT4ForCausalLM

# 加载 GPT-4 模型和 tokenizer
tokenizer = GPT4Tokenizer.from_pretrained("openai/gpt-4")
model = GPT4ForCausalLM.from_pretrained("openai/gpt-4")

# 输入文本
input_text = "The future of artificial intelligence is"

# 编码和生成文本
inputs = tokenizer(input_text, return_tensors="pt")
outputs = model.generate(inputs['input_ids'], max_length=50)

# 解码和打印生成的文本
print(tokenizer.decode(outputs[0], skip_special_tokens=True))

总结

  • TensorFlow 是一个全面的机器学习框架,适用于各种机器学习任务,包括深度学习和模型部署。
  • LangChain 是一个语言模型集成框架,简化了语言模型驱动应用的构建过程。
  • LLaMA 和 Qwen 都是先进的语言模型,提供高性能的自然语言处理能力,适用于文本生成和理解任务。
  • GPT 是当前最成熟的语言模型系列之一,提供了强大的生成和理解能力,广泛应用于对话系统和内容创作。

这些技术和工具各自代表了人工智能领域的前沿发展,推动了自然语言处理和机器学习的应用和创新。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

😝有需要的小伙伴,可以Vx扫描下方二维码免费领取🆓
👉1.大模型入门学习思维导图👈

要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。

对于从来没有接触过AI大模型的同学,我们帮你准备了详细的学习成长路线图&学习规划。可以说是最科学最系统的学习路线,大家跟着这个大的方向学习准没问题。(全套教程文末领取哈)
在这里插入图片描述

👉2.AGI大模型配套视频👈

很多朋友都不喜欢晦涩的文字,我也为大家准备了视频教程,每个章节都是当前板块的精华浓缩。

在这里插入图片描述
在这里插入图片描述

👉3.大模型实际应用报告合集👈

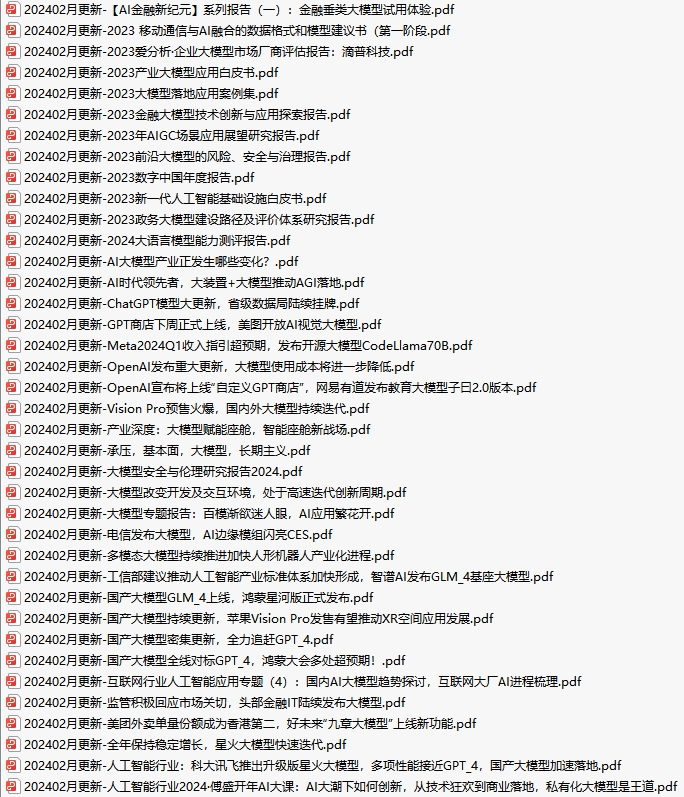
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(全套教程文末领取哈)
在这里插入图片描述

👉4.大模型落地应用案例PPT👈

光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。(全套教程文末领取哈)

在这里插入图片描述

👉5.大模型经典学习电子书👈

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

在这里插入图片描述

👉6.大模型面试题&答案👈

截至目前大模型已经超过200个,在大模型纵横的时代,不仅大模型技术越来越卷,就连大模型相关的岗位和面试也开始越来越卷了。为了让大家更容易上车大模型算法赛道,我总结了大模型常考的面试题。

在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

😝有需要的小伙伴,可以Vx扫描下方二维码免费领取🆓

大模型部署框架 FastLLM 简要解析 FastLLM支持X86/Arm/CUDA 3种架构的硬件,也就是说它的算子分别考虑了这几个架构的优化。此外,FastLLM除了支持FP32/FP16/BF16之外还支持INT8/INT4量化计算。所以FastLLM的优化就是在不同的平台上为不同的Bit数的数据实现Kernel,并且使用硬件特有的指令集来进行加速比如AVX2,Neon Instrics。在CUDA实现上,FastLLM并没有采用kernel fuse的方式进行进一步加速,这里的优化空间还是比较大的。 阅读详情

相关推荐

ChatGLM-6B (介绍以及本地部署)

ChatGLM-6B 是一个开源的、支持中英双语问答的对话语言模型,基于架构,具有 62 亿参数。结合模型量化技术,用户可以在消费级的显卡上进行本地部署(INT4 量化级别下最低只需 6GB 显存)。ChatGLM-6B 使用了和ChatGLM相同的技术,针对中文问答和对话进行了优化。经过约 1T 标识符的中英双语训练,辅以监督微调、反馈自助、人类反馈强化学习等技术的加持,62 亿参数的 ChatGLM-6B 已经能生成相当符合人类偏好的回答。

qq128252的博客 2万+

GraphRAG + Ollama 本地部署全攻略:避坑实战指南

1微软开源 GraphRAG 后,热度越来越高,目前 GraphRAG 只支持 OpenAI 的闭源大模型,导致部署后使用范围大大受限,本文通过 GraphRAG 源码的修改,来支持更广泛的 Embedding 模型和开源大模型,从而使得 GraphRAG 的更容易上手使用。2需要 Python 3.10-3.12 环境。安装完整后,需要创建一个文件夹,用来存储你的知识数据,目前 GraphRAG 只支持 txt 和 csv 格式。首先,我们需要运行以下命令来初始化。

bagell的博客 1675

什么是深度展开网络?如何将迭代算法的每一次迭代展开成深度网络对应的一层?深度展开网络进行端对端训练,其中端对端是什么意思?

在深度学习和机器学习的背景下,“端到端”(End-to-end)训练指的是将输入数据直接映射到最终输出的过程,而不需要任何中间的手动数据预处理或特征工程。- **自然语言处理**:端到端自然语言处理系统可以将自然语言输入直接转化为计算机可理解的语言输出,而不需要对语言进行分解和转化。- **推荐系统**:通过使用深度神经网络,端到端推荐系统可以直接根据用户历史行为预测其未来的兴趣爱好,并推荐相应的产品或服务。4. **直接映射**:从输入到输出的直接映射,中间没有任何拆分或分解的过程。

m0_67897882的博客 5433

汇总!7种大模型的部署方法!

选择部署框架的关键在于任务需求。只有根据实际需求来确定合适的框架,才能确保项目的顺利推进和成功实现。因此,在选择部署框架时,我们应该深入了解框架的特性、优缺点以及适用场景,综合考虑项目规模、技术栈、资源等因素,从而选择最适合的框架来支撑项目的实施。这样不仅可以提高开发效率,还能降低项目风险,确保项目的顺利推进和最终成功。

python1222_的博客 6855

HUMAnN数据库国内备份下载源(转自刘永鑫博士github)

百度云链接 R语言常用包合集 Windows 10版4.0.x:链接:https://pan.baidu.com/s/1JFwLP2SonK1howD5MNgNYg 提取码:l08k Windows 10版3.6.x:链接:https://pan.baidu.com/s/1h-qR2lmlaMgR4M7VbgtAFg 提取码:s5fi 下载后解压至当前目录,可获得3.6/4.0目录,剪切并替换文档 - R - win-library - 3.6/4.0 目录即可 扩增子数据库 宏基因组数据库 HUM.

zlabx的博客 3248

RS485 MODBUS转PROFINET网关案例丨汇川变频器接入到1200 PROFINET

本案例介绍的是用北京小疆智控(北京)技术有限公司生产的GW-PN5003型MODBUS RTU转PROFINET网关将汇川变频器接入西门子PLC1200 PROFINET网络的使用方法。

bjxjzk的博客 1880

AI大模型学习路线图:从基础到实战的保姆级指南

机器学习与深度学习是人工智能的核心基础,其原理在于通过神经网络从数据中学习规律,实现从感知到决策的智能。Transformer架构作为自然语言处理的关键突破,通过注意力机制解决了序列建模的长期依赖问题,奠定了当前大模型的技术基石。掌握这些技术,能够高效处理文本理解、生成等复杂任务,在智能对话、内容创作、代码生成等场景中创造巨大价值。本文基于Transformer和LoRA等热词,系统梳理了从理论认知、架构解析到微调部署的完整学习路径,为开发者构建大模型能力体系提供清晰指引。

weixin_34269583的博客 369

AlphaFold-multimer 复合物结构预测

是DeepMind开发的AlphaFold项目的一个扩展,旨在预测蛋白质多聚体的三维结构。蛋白质多聚体是由多个蛋白质亚单位相互组装而成的结构,如酶、膜蛋白复合物和病毒颗粒。理解多聚体的结构对于揭示蛋白质的功能和相互作用非常重要。

MurphyStar的博客 5647

零基础大模型框架部署(小白专用手册版)

最近两年大模型非常的火,自己也想部署一个来玩一玩,搜索各种资料研究,走了很多弯路,现在研究跑通之后,做了版基础小白都可用的手册篇,可运行大部分模型,如Qwen2-7b,供大家参考。部署模型步骤大致分为以下:

热爱生活,享受科技带来的智能和便利,这里是我的技术与思想碰撞的空间,一起探索科技背后的世界。 2141

保姆级教程:用CH34xSerCfg工具修改USB转串口芯片的VID/PID,避免驱动冲突

本文详细介绍了如何使用CH34xSerCfg工具修改USB转串口芯片的VID/PID,解决驱动冲突问题。通过实战案例和配置技巧,帮助开发者高效管理嵌入式设备,避免常见的USB设备识别问题,提升开发效率。

weixin_30924239的博客 224

【转载】参数估计(Parameter Estimation):频率学派(最大似然估计MLE、最大后验估计MAP)与贝叶斯学派(贝叶斯估计BPE)

基础 频率学派与贝叶斯学派 http://www.douban.com/group/topic/16719644/ http://www.zhihu.com/question/20587681 最大似然估计(Maximum likelihood estimation,MLE) http://baike.baidu.com/view/1918804.htm http://baike.baidu.co

影 的专栏 3413

ChatGLM(国内版的chatGPT)

ChatGLM-6B 是一个开源的、支持中英双语的对话语言模型,基于架构,具有 62 亿参数。结合模型量化技术,用户可以在消费级的显卡上进行本地部署(INT4 量化级别下最低只需 6GB 显存)。ChatGLM-6B 使用了和 ChatGPT 相似的技术,针对中文问答和对话进行了优化。经过约 1T 标识符的中英双语训练,辅以监督微调、反馈自助、人类反馈强化学习等技术的加持,62 亿参数的 ChatGLM-6B 已经能生成相当符合人类偏好的回答,更多信息请参考我们的博客。

qq_41771998的博客 2万+

245. 项目195:简易文字冒险游戏——《跟老吕学Python·新手》

如果您在学习本专栏教程时遇到任何问题,或有任何技术交流的意愿,欢迎在文章评论区留言,或通过优快云私信与老吕取得联系。老吕将及时回复您的留言,并与您共同探讨,以期为大家提供更为精准和有效的帮助。老吕珍视每一位读者的反馈和支持,期待与您共同学习、共同进步,共同创造美好的未来!我们的目标是不仅教会您Python语言,更是培养您解决问题的思维方式。请随意翻阅,按照自己的节奏学习,让这本专栏成为您编程旅程中的可靠伙伴。开发一个简易的文字冒险游戏,通过文本描述场景和事件,让玩家通过选择不同的选项来推动故事发展。

Python老吕的博客 712

chatglm实现基于知识库问答的应用

本文旨在通过介绍ChatGLM的使用来讲述如何将一个开源的语言模型应用于智能问答,知识库问答的场景中,通过一系列实操例子来理解整个应用思路。本文章仅仅介绍了最简单的通过向量索引库加AI模型加提示工程来实现知识库问答的方案,其中向量索引和文档的处理非常原始与粗糙,想要实现更加精准的匹配还需要根据实际文档内容和场景来进行修改。相关代码已上传github感兴趣的同学可以 clone 下来跑一跑。

爱吃回锅肉的胖子 1万+

【Zabbix实战之部署篇】Docker部署Zabbix+grafana监控平台

【Zabbix实战之部署篇】docker部署Zabbix+grafana监控平台

jks212454的博客 2578

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

ollama怎么升级版本

要升级ollama的版本,你可以根据最初的安装方式来选择升级的方法。

keyboard专栏 5万+

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

从零开始的ChatGLM 配置详细教程

最近安装了一下叶佬的一键安装包总感觉,没有被bug虐浑身不舒服遂,去github上重新git clone了官方的下来并部署玩玩。

风吹落叶的博客 1万+

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

ChatGLM两代的部署/微调/实现:从基座GLM、ChatGLM的LoRA/P-Tuning微调、6B源码解读到ChatGLM2的微调与实现

随着『GPT4多模态/Microsoft 365 Copilot/Github Copilot X/ChatGPT插件』的推出,绝大部分公司的技术 产品 服务,以及绝大部分人的工作都将被革新一遍类似iPhone的诞生 大家面向iOS编程 有了App Store现在有了ChatGPT插件/GPT应用商店,以后很多公司 很多人面向GPT编程(很快技术人员分两种,一种懂GPT,一种不懂GPT)然ChatGPT/GPT4基本不可能开源了,而通过上文《

结构之法 算法之道 6万+

【收藏必学】AI Agent核心技术与实战指南:迈向AGI的关键路径

AI Agent作为AI发展核心方向,具备自主决策、动态学习和跨系统协作能力。全球科技巨头与国内厂商积极布局平台与生态,竞逐市场。C端已形成领先产品,B端面临成本挑战。IDC预测AI支出将高速增长,AI Agent有望成为企业智能化转型的关键引擎,最终演进为人类的"认知共生助手"。

m0_59162559的博客 984

什么是大模型框架?常用的大模型框架盘点对比

大模型框架是指用于训练、推理和部署大型语言模型(LLMs)的软件工具和库。这些框架通常提供了高效的计算资源管理、分布式训练、模型优化和推理加速等功能,以便更好地利用硬件资源(如GPU和TPU)来处理庞大的数据集和复杂的模型结构。大模型框架的优点高效性:通过优化计算和内存管理,这些框架能够显著提高训练和推理的速度。可扩展性:支持分布式训练,可以在多个GPU或TPU上运行,适用于大规模数据集和复杂任务。灵活性:提供丰富的API和工具,使得研究人员和工程师可以方便地进行定制化开发。

2401_84206094的博客 2789

ChatGLM详解

ChatGLM是由清华技术成果转化的公司智谱AI发布的开源的、支持中英双语问答的对话语言模型系列,并针对中文进行了优化,该模型基于General Language Model(GLM)架构构建,ChatGLM是一款基于人工智能技术的智能聊天机器人,它具备强大的自然语言处理能力,能够理解和回答我们的问题,通过与ChatGLM的对话,我们可以轻松获取各种信息,解决生活中的疑惑,甚至寻求专业建议,ChatGLM的出现,让我们在获取信息、解决问题上更加高效便捷。

夏沫の梦的博客 3487

一步到位!7大模型部署框架深度测评:从理论到DeepSeek R1:7B落地实战

文章主要介绍了主流模型部署框架(Transformers、ModelScope、vLLM、LMDeploy、Ollama、SGLang、DeepSpeed)的技术原理、优缺点、适用场景,并以DeepSeek R1:7B为例进行全框架部署实战,包括详细步骤和关键参数说明,最后给出不同场景下的选型建议。

zhangzhentiyes的博客 7312

零基础部署chatglm

chatglm, 类chatgpt, 聊天机器人,文心一言

CHNIM的博客 1万+

ChatGLM实战 - 文本信息抽取

本文对ChatGLM-6B模型进行简单尝试,稍许改造即能满足文本抽取场景的使用,使用成本低于chatgpt,支持本地部署,单卡成本低于openai。

海贼王的博客 9971

大大大模型部署方案抛砖引玉

作者|Oldpan 编辑| oldpan博客点击下方卡片,关注“自动驾驶之心”公众号ADAS巨卷干货,即可获取点击进入→自动驾驶之心【模型部署】技术交流群借着热点,简单聊聊大模型的部署方案,作为一个只搞过CV部署的算法工程师,在最近LLM逐渐改变生活的大背景下,猛然意识到LLM部署也是很重要的。大模型很火,而且确实有用(很多垂类场景可以针对去训练),并且和Vision结合的大模型也逐渐多...

CV_Autobot的博客 1478

TensorFlow相关组件的安装

TensorFlow相关组件的安装

AAI666666的博客 3934
上一篇: AI大模型进化之路:机器学习九大算法画图详解
下一篇: 轻松上手大模型应用开发——Git教程「亲自动手实践大型模型微调」,简化学习流程!
大模型产品经理
博客等级 码龄3年 1万+粉丝 1120原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值