算法:堆排序

博途PLC如何建立与笔记本电脑端的连接?(新手必会) 对S7-1500PLC下载硬件组态或程序,需要建立PC与PLC的连接。 由于S7-1500CPU都具有PN端口,因此建立PC与S7-1500PLC的连接通常使用工业以太网来实现。 1.使用网线连接PC-PLC 使用网线,一端连接PC的以太网卡端口,另一端连接S7-1500CPU的PN端口。 2.设置本机IP地址 2.1 确认本机要设置的IP地址段 本机IP地址要和PLC程序组态IP地址段前三位保持一致,后一位使用组态中没有用到的IP地址段。如下图所示。 那么看了这个图片应该就知道了,地址应该设置成192. 阅读详情
原理:

(首先你需要了解二叉堆的概念,知道先序遍历,什么叫最大树、最小树,父子节点的下标计算,如何实现最大小树)其实就是在你构建好最大树(这里面以最大树为例子),拿到头结点(一定是这个队列里面的最大值),把他放在数组的最后面,他前面的数值一定比这个数大。然后缩小范围,将前面的数重新构建为最大树,再拿出根节点,直到剩最后一个值。这样就变为有序的数组。

图示:
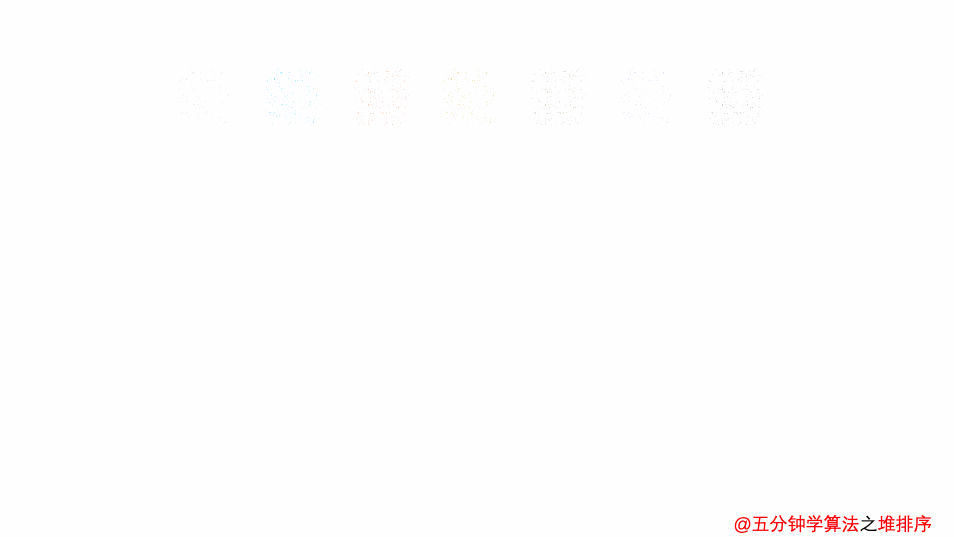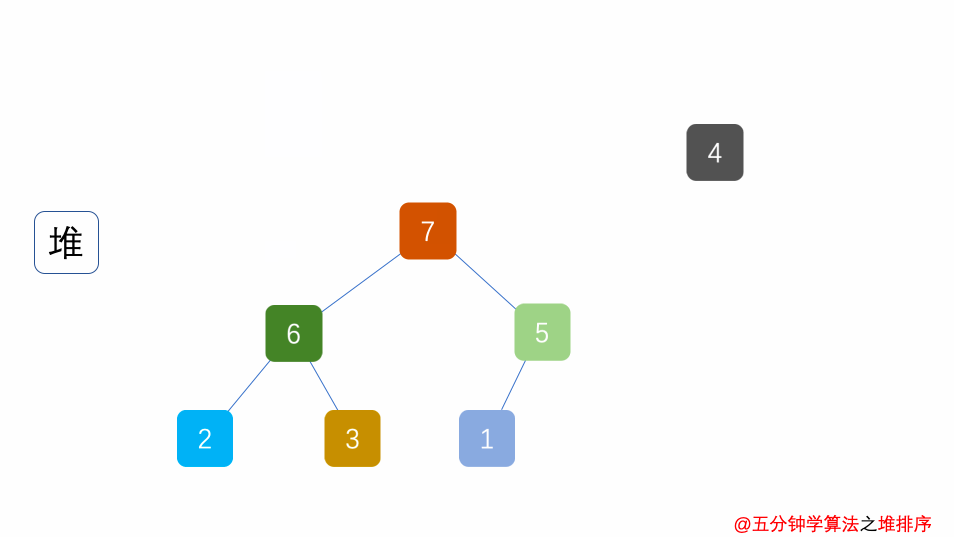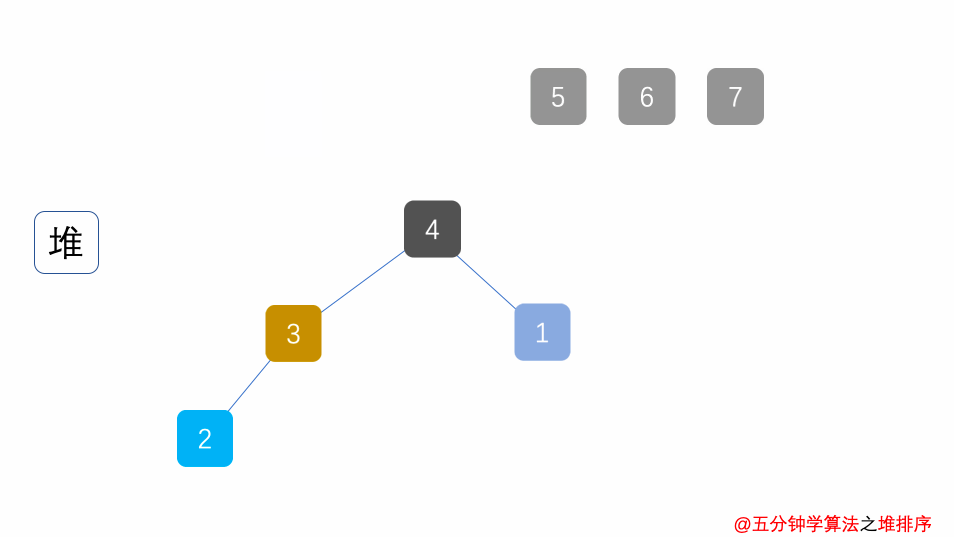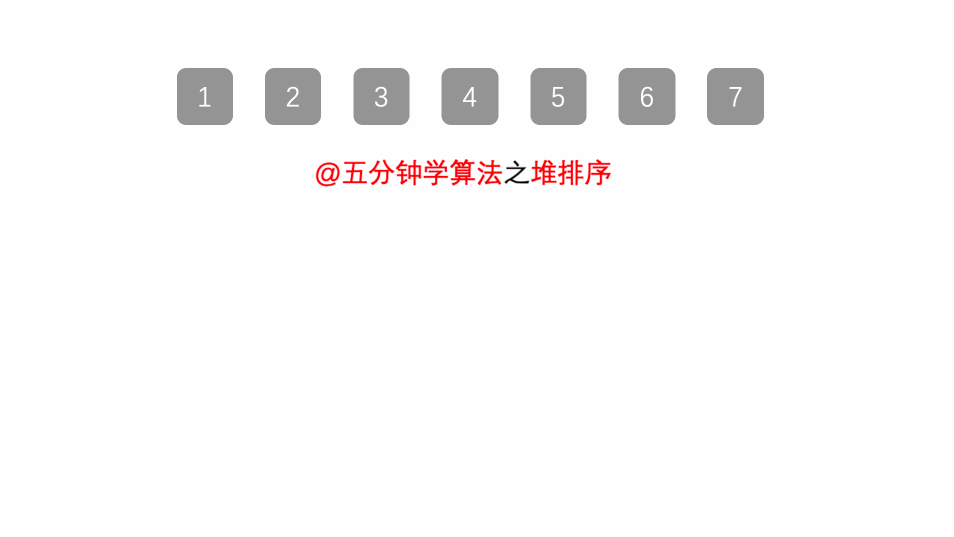
在这里插入图片描述

代码实现:
public class HeapSort {
    public void maxHeapDown(int[] arr,int start,int end){
        int l    = start*2+1;//得到待排序树的根节点的左子树节点
        int c    = start;  //指向当前节点
        int temp = arr[start];
        for(;l<end;c=l,l=c*2+1){//同时这个循环是担心替换之后,对于之前的已经生成的最大树造成影响
            //当然如果是最初始状态,这两个子节点也是叶子节点就跟不需要调整了
            //那个节点没有替换,就不需要重新调整
            if(arr[l]<arr[l+1])
                l++;//因为是中序遍历,所以l+1就是右子节点

            if(temp>=arr[l]) break;
            else {
                arr[c] = arr[l];
                arr[l] = temp;
            }
        }
    }
    public void HeapSort(int[] arr, int n){
        for(int i= n/2-1;i>=0;i--){
            maxHeapDown(arr,i,n-1);
        }

        for(int i=n-1;i>0;i--){
            int temp = arr[0];
            arr[0] = arr[i];
            arr[i] = temp;
            maxHeapDown(arr,0,i-1);
        }
    }
    public static void main(String[] args) {
        int a[] = {20,30,90,40,70,110,60,10,100,50,80};
        new HeapSort().HeapSort(a,a.length);
        System.out.println(Arrays.toString(a));

    }
}
时间复杂度

堆排序的时间复杂度是O(N * lgN)。
假设被排序的数列中有N个数。遍历一趟的时间复杂度是O(N),需要遍历多少次呢?
堆排序是采用的二叉堆进行排序的,二叉堆就是一棵二叉树,它需要遍历的次数就是二叉树的深度,而根据完全二叉树的定义,它的深度至少是lg(N+1)。最多是多少呢?由于二叉堆是完全二叉树,因此,它的深度最多也不会超过lg(2N)。因此,遍历一趟的时间复杂度是O(N),而遍历次数介于lg(N+1)和lg(2N)之间;因此得出它的时间复杂度是O(N * lgN)。

堆排序是不稳定的算法

学习链接
计算机控制技术及应用 《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。 立即下载

相关推荐

OpenHarmony 4.1/5.0 Beta上手:如何用ArkUI在非华为设备上开发你的第一个“鸿蒙”应用

本文详细介绍了如何在非华为设备上使用ArkUI开发OpenHarmony应用,涵盖从设备选型、环境搭建到应用部署的全流程。通过实战案例展示ArkTS语言在开源鸿蒙生态中的应用,帮助开发者突破设备限制,构建跨平台鸿蒙应用。

weixin_33704234的博客 365

堆排序算法分析

堆排序作为时间复杂度为O(nlogn)的三剑客之一,并且是就地排序,空间复杂度为O(1)。虽然属于不稳定排序,但是在面对大数据排序时,堆排序的效率很好。 下面就来分析下,堆排序怎么实现的。 首先堆排序,是建立在二叉堆这种数据结构上。所谓二叉堆,就是一颗二叉树,它满足父节点的值始终大于(或小于)子节点的值,此时又称为大顶堆(或叫小顶堆)。存放于数据结构中时,是以层序遍历的顺序,放在数组当中。此时

木东的博客 677

EtherCAT从站协议栈---- sampleappl.c 文件解析

这个源文件实际上包含该项目的入口函数main函数。 那么如何找到入口函数呢? 可以进入debug的simulator模式,选中run to main(), 当执行完启动文件startup_cm3.s后就进入了main函数(注意在main函数之前还进入了SystemInit函数), 如下图所示: 这个main函数主要架构如下: int main(void) { HW_Init(); /*PDI(过程数据接口)初始化,这里用的是MCI接.

Jiawei_Z的博客 3066

第三章、基于最大堆排序的LRU算法 java版

我认为,最早的人类在处理算法问题时,并不会一下子想到堆排序,归并排序,快速排序等,这些也都是在不断地实践中慢慢演化的。所以就像接下来的故事一样,我也应该从头开始,由浅入深的了解一款算法。 本期主题:堆排序版LRU 记得那一天,我被问到LRU的时候,一时无言以对,因为我只是听说过LRU这三个字,实际什么意思我根本不知道。 后来大神耐心的告诉我,这是最近最少使用算法,也就是说这是一种淘汰策略,定...

LJHSkyWalker的博客 868

国科大 雁栖湖校区 研一上 课程避坑与生存指南

本文为国科大雁栖湖校区研一新生提供全面的课程避坑与生存指南,涵盖选课策略、核心课程学习技巧、校园生活攻略及心态管理。重点解析算法设计与分析、人工智能原理等硬核课程的学习方法,并分享食堂、住宿、自习室等实用生存技巧,帮助新生高效适应研究生生活。

weixin_29304985的博客 300

QT | QT打包生成单个EXE文件

1.以release方式运行程序 2.在release文件夹中找到.exe文件 如果没有找到exe,可能是因为在项目中勾选了shadow build,你可以在构建目录中找到exe 3.将exe放在一个新建的文件夹中,因为待会儿会生成很多dll文件 4.点击电脑左下角搜索QT,打开Qt 5.8 for Desktop (MinGQW 5.3.0 32bit) 5.进入刚刚新建的文件夹,输入wi...

⊳ideal world⊲~ヽ(゚︺゚)Hi 1238

排序算法之——堆排序分析

前言 上一篇文章中对堆进行了分析,接下来趁热打铁,一起来学习一下堆排序算法。 思路 回忆建立N个元素的二叉堆的基本策略,这个阶段花费O(N)时间,然后我们执行N次deleteMin操作,按照顺序,最小 的元素先离开堆,离开之后,我们让堆缩小1,位于堆中最后的单元就可以用来存放刚刚删除的元素。这样可以得到逆序排序。 为了得到正序排序,我们用大顶堆即可,每次把堆中最大的元素删除。 有点类似选择排序的思...

日积月累,天道酬勤 1543

域自适应的理解与想法(Domain Adaptation)

这幅图是域适应非常有名的一篇论文中的插图,被很多文章转载。 什么是领域自适应? Domain Adaptation是迁移学习中很重要的一部分内容,目的是把分布不同的源域和目标域的数据,映射到一个特征空间中,使其在该空间中的距离尽可能近。于是在特征空间中对source domain训练的目标函数,就可以迁移到target domain上,提高target domain上的准确率。 上面的图主要的思想来源于GAN,上图由三部分组成:特征映射网络 标签分类网络和和域判别网络 其中,source domain的数.

yuanxue18的博客 5982

LRU算法的最小堆实现

代码实现to be continued…

moyan_wwl的博客 1099

SAP FICO应付票据平台开发说明书(包括测试样例、程序代码仅作参考,不保证一定可以运行)

SAP FICO应付票据平台开发说明书(包括测试样例、程序代码仅作参考,不保证一定可以运行)

我好像病了的博客 378

深度学习实战35-图卷积神经网络GCN模型的搭建与应用

大家好,我是微学AI,今天给大家介绍一下深度学习实战35-图卷积神经网络GCN模型的搭建与应用,GCN是一种用于处理图结构数据的深度学习模型,它可以捕捉节点之间的拓扑关系和局部特征,并进行图级别的预测和分类任务。下面将介绍如何搭建并应用GCN模型。

微学AI的博客 2226

4-1 堆排序简介,为什么要使用堆

这一章开始我们介绍堆排序 Heap Sort。首先,我们应该认识到这样一个问题:O(nlogn) 比 O(n^2) 快多少?结论:快很多。理解这一步是我们理解算法重要性的基础。堆的非常典型的应用堆的一个典型的应用是优先队列(Priority Queue)。 普通队列 优先队列 先进先出,后进后出。由进入队列的时间顺序决定。 出队顺序与入队顺序无关,只与队列中元素的优先级有关,优先级最高

李威威的博客 4275

【漏洞复现】用友U9 UMWebService.asmx 任意文件读取漏洞

用友U9存在任意文件读取漏洞,未授权的攻击者可以通过该漏洞读取服务器任意文件,造成敏感信息泄露。

qq_67810151的博客 620

排序算法:堆排序

关于排序算法中的堆排序的详细介绍,以及实现过程和时间复杂度的计算,附带图解。

Yikefore的博客 3454

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

算法:堆排序

堆排序 最近重温了经典的堆排序的算法,堆是一种优先队列,堆排序是基于完全二叉树结构的,由选择排序优化而来,常数时间内最坏最好情况时间复杂度都是O(nlogn),而堆又分为两种,分别是大顶堆和小顶堆,由于一般排序算法都是实现序列升序化,故堆排序在一般教材里都是以小顶堆形式出现,算法实现步骤分为三步:建堆,调整堆,输出堆顶元素,废话不多说,上代码 public class 堆 { public st...

长舒的博客 241

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

【算法分析】排序算法:希尔、归并、快速、堆排序

08年9月入学,12年7月毕业,结束了我在软件学院愉快丰富的大学生活。此系列是对四年专业课程学习的回顾,索引参见:http://blog.youkuaiyun.com/xiaowei_cqu/article/details/7747205 排序算法 排序是非常常用,非常基本的算法。排序的方法有很多,比如插入排序、选择排序、希尔排序、归并排序、快速排序、堆排序。 本次试验重点实现:希尔排序

小魏的修行路 2万+

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

排序算法七: 堆排序

堆排序(Heap Sort) 堆排序是指利用堆进行排序的方法。它的基本思想是,将待排序的序列构造成一个大顶堆,此时,整个序列的最大值就是堆顶的根结点。将它移走(其实就是将其与堆数组的末尾元素交换,此时末尾元素就是最大值),然后将剩余的 n-1 个序列重新构造成一个堆,这样就会得到 n 个元素中的次小值。如此反复进行,便可以得到一个有序序列了。 如下图,将 90 与 20 末尾元素互换。 堆 堆是...

qq_44587855的博客 492

基本排序算法:堆排序算法及其优化

堆结构是一个完全二叉树结构,其结构特点是一个结点有右节点就必须有右结点,而有左结点可以没有右结点,而且在最大堆上堆中某个节点的值总不大于其父节点的值。堆结构用数组实现存储。 在完全二叉树中:左节点的序号是其父节点序号的2倍(从1开始存放元素),右节点的序号是其父节点序号的2*n+1。在一棵完全二叉树中第一个非叶子结点的序号是该完全二叉树中结点总数目整除以2。 堆(Heap): clas...

weixin_41514525的博客 569

算法导论:堆排序

堆排序代码(python 2)只是实现了堆排序的核心代码:堆维护性质(max_heapify),而后的建堆、及排序都是基于堆得维护性质算法进行调用即可,暂时不做详解。注意: 为了和书中的伪代码一致,对堆(以数组的形式表示)的操作从数组的第二个元素array[1]开始,第一个元素不作处理初始为0。堆维护性质算法1、基于递归实现:""" warning: 1, This codes are b

吴雒的博客 331

算法练习:堆排序

C++代码 1: #include <iostream> #include <assert.h> using namespace std; //调整堆 //s:需要调整的非终端节点的位序 //len:整个待排序数组的长度 void HeapAdjust(int a[], int s, int len) { int tmp = a...

weixin_30902251的博客 171

算法六:堆排序

堆排序 堆排序是利用堆这种数据结构而设计的一种排序算法,堆排序是一种选择排序,它的最坏,最好,平均时间复杂度均为O(nlogn),它也是不稳定排序。首先简单了解下堆结构。 堆 堆是具有以下性质的完全二叉树:每个结点的值都大于或等于其左右孩子结点的值,称为大顶堆;或者每个结点的值都小于或等于其左右孩子结点的值,称为小顶堆。如下图: 同时,我们对堆中的结点按层进行编号,将这种逻辑结构映射到数组中就是下面这个样子 该数组从逻辑上讲就是一个堆结构,我们用简单的公式来描述一下堆的定义就是: 大顶堆:arr[i]

JerryZhang1111的博客 204

八种排序算法之八:两步学会堆排序

堆排序的基础是完全二叉树的顺序结构实现,没有实现过的可以先看一下这篇文章: 《二叉树链式结构和顺序结构区别详解+java代码实现》 https://blog.youkuaiyun.com/weixin_44537194/article/details/87405475 堆分为大顶堆和小顶堆,其实就是完全二叉树。 大顶堆要求对于任意一个子树,父节点大于任何一个子节点。 就像一个倒三角一样: 小顶堆相反,父...

Guo_ping'blog 313
上一篇: 算法:快速排序
下一篇: Java基础:throw和throws的区别
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

贝多芬也爱敲代码

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值