IJCAI 2025 | 高德首个原生3D生成基座大模型「G3PT」重塑3D生成的未来

        国际人工智能联合会议(IJCAI)是人工智能领域最古老、最具权威性的学术会议之一,自1969年首次举办以来,至今已有近六十年的历史。它见证了人工智能从萌芽到蓬勃发展的全过程,是全球人工智能研究者、学者、工程师和行业专家汇聚交流的重要平台,也是CCF A类会议。IJCAI 2025将于2025年8月16日至8月22日在加拿大蒙特利尔举办。IJCAI 2025共有5404份投稿,录用1024篇,录取率为 19.3%。

导读

G3PT是高德地图自研的3D生成基座大模型,也是自动化3D资产生产的核心引擎,目前已广泛支持用于地图渲染的3D内容资产,包括3D世界建筑、导航车标以及3D数字人等。这项突破性技术大幅度降低了3D资产的制作成本,并且极大地扩展了用户在地图上的消费内容场,未来具有巨大的商业空间。

随着OpenAI推出GPT-4o图像生成功能,首次实现了基于大型语言模型(LLM)自回归架构的原生图像生成,其性能突破了当前主流的扩散模型(Diffusion Model)架构,引发了业界对基于自回归架构统一多模态建模的高度关注与广泛期待。

我们团队同样秉持对自回归架构价值的坚定信念,历经一年的技术攻坚,成功打造了业界首个基于自回归架构的原生3D生成基座大模型——G3PT。该模型通过单张图像即可生成高质量3D Mesh,其核心创新之处在于提出了Cross-scale Querying Transformer模块,实现了3D 数据的多尺度1D Tokenizer,并且引入了Next-scale Autoregressive架构,取代了传统GPT中的Next-token Autoregressive架构,从而巧妙地解决了3D数据无序性这一长期困扰自回归建模的关键难题。

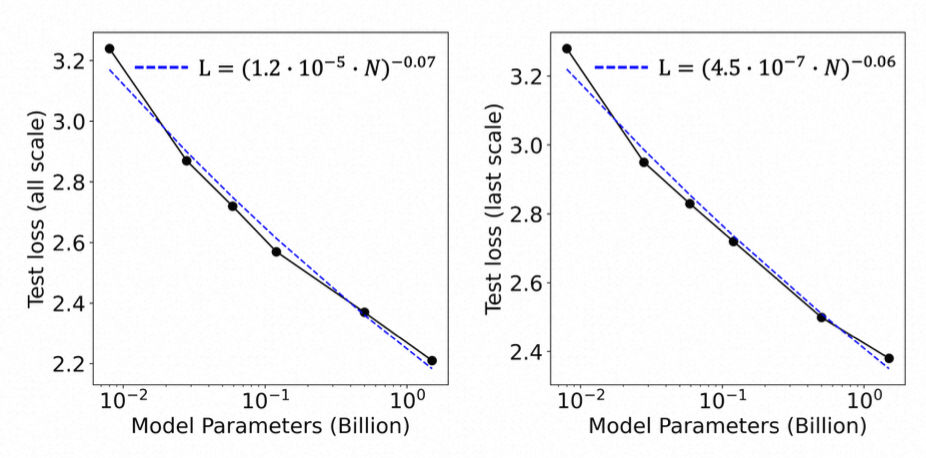
尤为值得一提的是,我们在3D生成领域首次验证了自回归架构的Scaling Law,其生成效果与业界基于扩散模型架构的同类闭源产品持平,并且生成速度远优于扩散模型架构,有力地证明了自回归架构在3D生成任务中的巨大潜力与优势。目前,我们正全力推进相关工作的开源,旨在进一步推动3D生成社区的发展,敬请期待。

  • 论文主题:G3PT: Unleash the Power of Autoregressive Modeling in 3D Generation via Cross-Scale Querying Transformer

  • 论文链接:https://arxiv.org/abs/2409.06322

Introduction

        近年来,3D形状生成领域取得了显著进展,主要方法包括利用大型重建模型(LRMs)将图像转换为3D形状,以及将2D扩散模型扩展到3D领域。然而,这些方法存在一些局限性:依赖多视图图像的保真度,难以生成高质量的网格,尤其是在捕捉复杂的几何细节方面。此外,一些基于3D变分自编码器和扩散模型的方法虽然能够生成3D形状,但受限于训练时间长和缺乏扩展策略,限制了其效果和可扩展性。

        与此同时,自回归(AR)大型语言模型和多模态AR模型的出现开启了人工智能的新纪元。这些模型通过将数据转换为离散tokens,利用自监督生成学习进行下一步token预测,在语言处理和图像生成领域取得了显著成功。然而,将这些模型扩展到3D生成任务面临挑战,因为它们依赖于序列化的token预测,这与3D数据的无序性质不兼容。

        G3PT的提出正是为了解决这一挑战。3D数据本质上具有多分辨率特性,不同尺度之间存在自然的序列关系。基于这一见解,G3PT通过多尺度分词器(CVQ)和多尺度自回归建模(CAR),将无序的3D数据映射为不同细节层次的离散tokens,从而建立适合自回归建模的序列关系。这种方法不仅避免了对人工指定顺序的依赖,还能够自然地连接不同细节层次的tokens,实现从粗到细的3D内容生成,并支持多种条件模态,如基于图像和文本的输入。

Approach

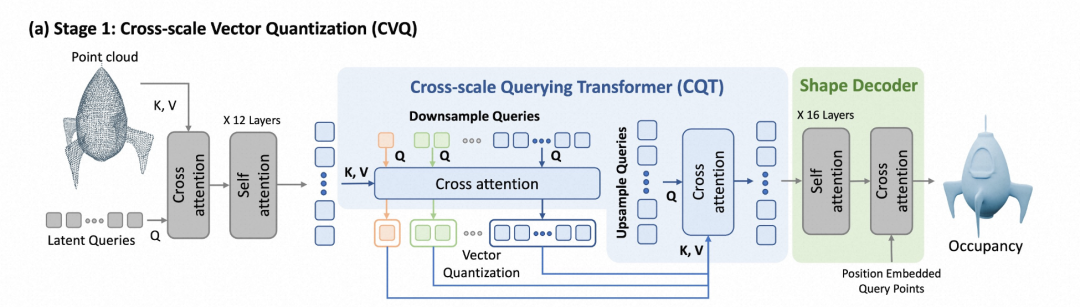
     G3PT的核心在于其创新的CVQ和CAR框架,以及跨尺度查询变换器(CQT)的应用。在CVQ阶段,G3PT首先使用基于Transformer的标记器将高分辨率点云编码为潜在tokens。具体来说,输入的点云通过交叉注意力层整合到可学习的潜在查询中。然后,CQT利用注意力机制和可学习的“下采样”及“上采样”查询,将这些tokens分解为不同尺度的离散tokens。这一过程通过多层次的残差量化实现,能够有效地捕捉不同分辨率下的几何细节。最终,通过解码器将这些量化后的tokens重新转换为3D占用网格,生成最终的3D形状。
在CAR阶段,G3PT利用CVQ阶段训练得到的CQT对不同尺度的tokens进行对齐,并通过自回归变换器预测下一个尺度的tokens。这种方法从最粗的尺度开始,逐步细化,直至达到所需的细节层次。CAR阶段的关键在于通过跨尺度的维度对齐,使得模型能够在不同尺度之间传递信息,实现逐步精细化的3D生成。
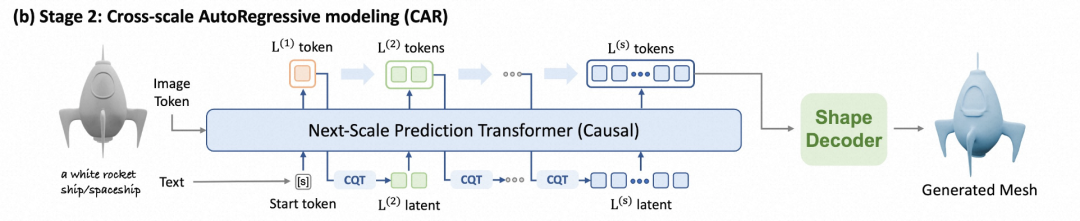
此外,G3PT还支持条件控制生成,即根据图像或文本输入生成相应的3D形状。对于图像条件,G3PT使用预训练的DINO-v2模型提取图像特征,并将其与3D tokens融合,通过注意力机制确保生成的3D形状与输入图像的语义一致性。对于文本条件,G3PT使用预训练的CLIP模型提取文本特征,并通过AdaLN机制控制生成过程,确保生成的3D形状与文本描述的语义一致。

Experiments

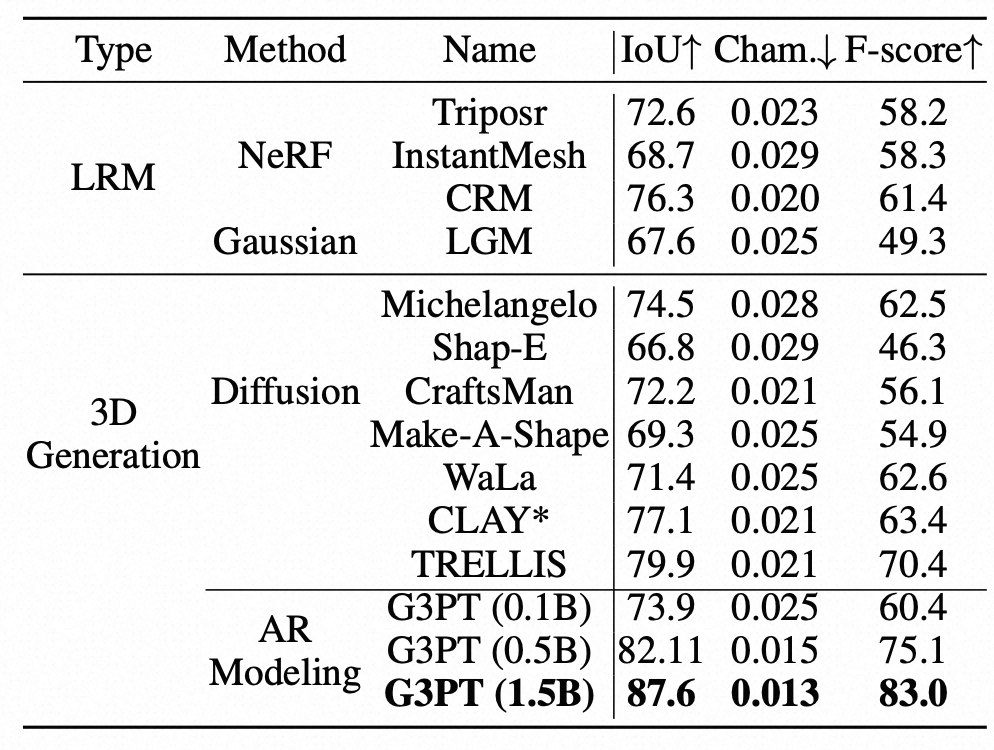
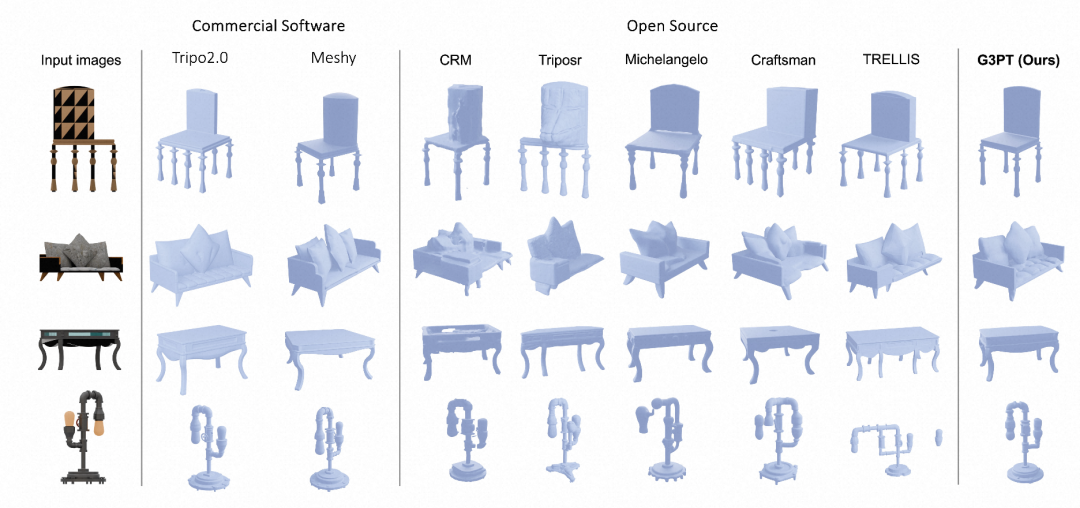
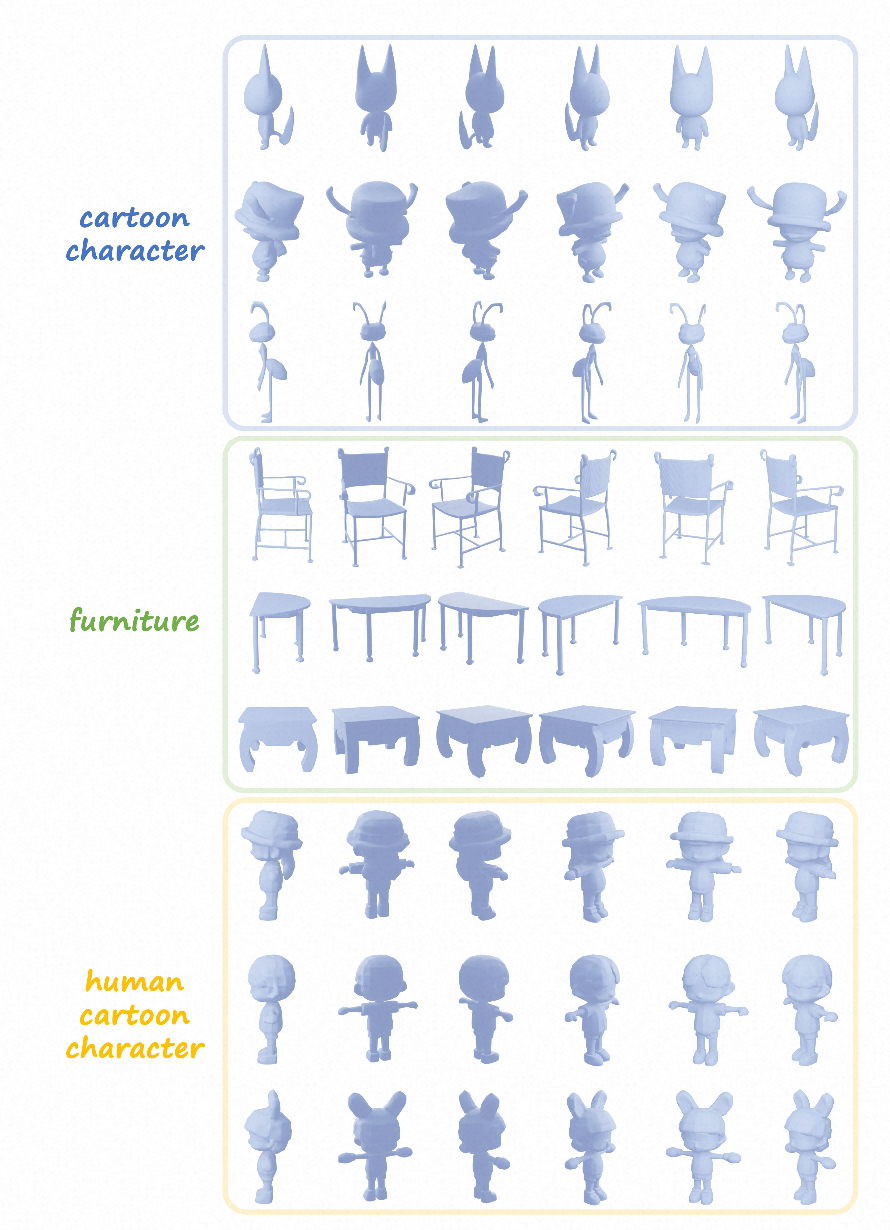
实验部分,G3PT在图像到3D形状生成任务中表现出色。在Objaverse数据集上,与多种LRM和扩散模型相比,G3PT在IoU、Chamfer距离和F-score等指标上均优于其他方法,尤其在15亿参数规模时性能显著提升。其首次揭示了3D生成中的幂律扩展行为,表明随着模型参数增加,测试损失呈幂律下降。此外,G3PT在文本到3D生成任务中也展示了出色的性能,能够根据文本提示生成高质量且语义一致的3D网格。

  • 定量指标对比


  • 可视化对比

  • 文本控制生成效果


  • 3D自回归的Scaling Law


Conclusion

G3PT通过引入交叉尺度查询变换器(CQT)和交叉尺度自回归建模(CAR),为无序3D数据的生成提供了一种创新的自回归建模框架。它有效地解决了3D数据的无序性和多分辨率特性带来的挑战,实现了从粗到细的高质量3D内容生成,并支持多种条件模态。实验结果表明,G3PT在生成质量上超越了现有的3D生成方法,成为3D内容创作的新标杆。然而,G3PT的训练需要大量的计算资源,训练过程耗时较长。未来的工作可以探索更高效的训练技术,以及更丰富的控制条件,以进一步提升模型的性能和适用性。
相关推荐

让AI读懂代码需求:大模型微调训练实践及端侧运行部署

集团内部有多个微调训练的平台,譬如openLM, 魔搭平台的SWIFT等,集团外部有LLaMA-Factory,利用服务端共享的GPU集群进行训练,支持多种先进的微调算法和模型,适用于参数量大的复杂模型训练任务,但是对简单模型训练任务,希望在单机有限GPU资源下完成,并且缩短训练周期,基于这个考虑,选择了unsloth高性能训练框架。把代码知识图谱,分片存入向量数据库,通过RAG进行匹配查找,会存在召回率和准确率的问题,在实际过程中,LLM基于查询结果会存在不稳定的输出;

高德技术 791

高德沉浸式AI“云境”助力三维数字孪生

城市级数字孪生体,正是以强大仿真引擎与神经渲染等AI前沿技术基石、同时融合了(数据实时汇入环境、交通、能源、安防等)共同孕育的“智能生命体”,它超越了静态的“三维模型”,实时数据赋予了模型一系列“生命体征”,结合大数据分析与人工智能,实现对城市运行状态的动态监测、问题预警(如交通拥堵、内涝风险)、趋势推演(如人口流动、碳排放模拟)和策略优化(如信号灯配时、应急响应)。构建一个与现实城市一模一样的“镜像”,每盏路灯的能耗、每道车流的韵律、每片绿地的呼吸,都在镜像中实时搏动。

高德技术 2212

ICCV 2025|高德USP:图像生成与理解的统一自监督预训练

在将预训练模型权重适配到下游理解和生成模型时,针对图像分类任务,ViT 编码器的预训练权重可直接继承,无需额外调整,且仍然使用Class Token作为最终表征。USP 显著提升了 DiT 与 SiT 两个扩散模型的训练效率,仅用 600K 和 150K 步即可超越原始 7M 步的表现,分别加速 11.7× 和 46.6×,同时在图像识别任务中也保持了强大表示能力,具备良好的扩展性且无额外开销。同时,USP结合其他利用外部模型加速扩散模型收敛速度的方法,可以取得比单一方法更好的效果,表现出良好的正交性。

高德技术 904

生成模型双突破|高德技术如何让AI视频「更懂人」、图像「自愈」?

本文提出了首个人类感知对齐的视频运动质量评估基准 VMBench,受人类运动感知机制的启发,分层构建了五维度的运动感知评估指标 (PMM)体系和大规模的元信息引导提示生成 (MMPG)框架,覆盖了自然界中六大运动模式,为视频生成模型的运动质量评估树立了新的行业标准。传统研究侧重于特定任务的解决方案,采用设计的网络架构,使用相应的数据集对特定类型的退化进行优化。本研究提出了首个开源的、与人类感知对齐的视频运动质量评测基准VMBench,为社区提供了标准化的评测框架、可操作的诊断工具和量化的评估标准。

高德技术 1545

ICCV 2025|车道图的链式生成!高德将车道拓扑网学习革新为链式图扩展

在nuScenes和Argoverse 2数据集上进行的大量实验表明,与现有的基于检测和基于生成的方法相比,SeqGrowGraph在拓扑准确性和网络完整性方面表现出更优越的性能,通过引入类人结构化推理与序列建模,推动了车道图构建技术的发展,从而为动态环境下的自动驾驶提供精确的中心线。相比之下,SeqGrowGraph不仅提供了稳定和鲁棒的建模,还能有效合并地面实况数据中存在的冗余点,从而在构建车道图方面取得了更优越的结果,凸显了SeqGrowGraph在克服这些挑战方面的有效性和可靠性。

高德技术 977

高德测试体系智能化升级:AI驱动质量保障新范式

上面讲了通过构建生态化能力解决测试的质量、效率与管控的问题,起了一个好开始,用俗话说在“一盘棋”里,但什么时候能走到“天下大同”的局面,得一步步来,现在是 AI 博弈的一局,不敢说能“胜天半子”,但也不能 AI 过后一泻千里。事情可真不少,每个阶段就产生了完成各种“任务/工作项”的平台,以需求为事项跟踪的 Aone,以工作时序为主的五月花,现在团队项目管理的 Teambition,以测试专业为主的老 Kelude 到现在的 Aone,这还不包括有业务或团队特色的自己的任务平台。

高德技术 1504

技术思辨|AI Coding:经验壁垒正在失效,工具进化重塑编程

你能够将一个超级庞大的项目拆解成AI可以理解和逐步执行的细粒度任务,并预见在整合这些AI"零件"时可能出现的挑战和协同问题,这正是"1000倍杠杆"的起点。而"初生牛犊"则需要警惕,不能因为有了AI这个强大的工具就忽视了基础能力的培养、批判性思维的锻炼以及对问题本质的深入理解,否则可能永远停留在"能够使用AI的初学者"阶段,难以应对未来更复杂、更具挑战性的工作。能够洞察问题的本质,发现隐藏的关联,提出全新的思路,设计出AI都"想不到"的巧妙方案——这种源于人类灵感、直觉和想象力的创造力,是AI难以复制的。

高德技术 1161

全流程开源!高德3D贴图生成系统,白模一键生成真实感纹理贴图

我们团队自研的MVPainter系统,作为业内首个全流程开源的3D贴图生成方案,仅需一张参考图与任意白模,即可自动生成对齐精确、细节丰富、具备PBR属性的高质量贴图,全面提升3D内容生产效率与真实感表现,助力构建标准化、智能化的三维视觉基座。高质量数据构建与筛选流程:我们提出了一套自动化的数据筛选与增强Pipeline,针对公开3D数据中普遍存在的纹理缺失、光照,视角单一等问题,设计了贴图质量过滤、光照,视角增强等模块,用于构建一个高质量的多视角贴图训练集。

高德技术 1934

高德地图应用OceanBase单元化构建下一代在线地图服务

IEEE International Conference on Data Engineering (ICDE) 是数据库和数据工程领域的顶级学术会议之一(与SIGMOD、VLDB并成为数据库三大顶会),自1984年首次举办以来,每年举办一次。ICDE涵盖广泛的主题,包括数据库系统及其架构、数据管理与存储、大数据技术与应用、数据挖掘与知识发现、数据流处理与实时分析、分布式与并行数据库、数据隐私与安全等。本届会议接收到1518份投稿,共有300篇论文被接收发表,此外还包括10场Tutorials,11场wor

高德技术 1287

解锁高德语音包新玩法:这个六一,用孩子的声音,导航你的世界

因此,我们设计了Teacher - Force蒸馏的方案,通过同时约束蒸馏模型预测的声学特征和真实声学特征及基础模型预测的声学特征之间的误差,确保模型既可以较低难度的学习基础模型的声学输出,也可以同时保证蒸馏模型尽可能接近真实声学特征输出。第一阶段,我们首先会基于数千位高质量录音人的数据训练一个声学基础模型,模型在训练时,会对语义信息和说话人信息进行特征分离,以确保我们通过大规模数据进行预训练时可以充分实现说话人信息和语义信息的解耦,确保模型在微调阶段仅需调整少量的参数,加速模型产出的速度。

高德技术 2066

从底层重构强化学习训练框架,高德开源新方法

通过将基于组内的决策动态直接纳入标准的PG方法,GPG简化了训练过程,并显著减少了计算开销,而不削弱模型效果。这一突破为训练能够进行复杂推理的先进LLM提供了更高效的框架,从而为更具资源效率和可扩展性的人工智能系统做出了贡献。GPG开创性地从底层重构强化学习训练框架,仅需优化原始目标,解决已有方法偏差,提高训练效率。:首次揭示现有方法的奖励偏差问题,提出轻量化且高精度的梯度估计方案,显著提升策略稳定性。在一个组中,所有奖励都是0的简单问题的比例和所有奖励都是1的困难问题的比例。

高德技术 293

高德开源数字人核心引擎,打造真实可控的音频驱动数字人

此外,我们集成了一个运动强度调制模块,显式控制表情和身体运动的强度,使肖像运动的操控不仅限于唇部动作。然而,自然说话头生成不仅需要关注与音频直接相关的唇部运动,还需关注与音频特征弱相关的其他面部组件和身体部位的运动(如眉毛、眼睛和肩膀)。为了解决这些限制,我们提出了一种新颖的框架,利用预训练的视频扩散变换模型生成高保真、连贯的说话肖像,并具备可控的运动动态。在与Hallo3的对比中,Hallo3的输出存在明显缺陷,对比的结果中Hallo3出现面部/唇部畸变和虚假背景运动和僵硬的头部运动。

高德技术 973

Tech Reader|高德技术人的灵感书单

在代码与算法的世界里,什么才是高德技术人「不迷路」的导航坐标?欢迎在评论区分享你对本期推荐书单的阅读心得或推荐你的灵感书单;在世界读书日,我们一起通过阅读校准下一段技术征程!答案或许藏在这份高德技术人的推荐书单里,选择5名粉丝随机送出本期推荐书籍!

高德技术 381

ICASSP 2025|高德推理检测助手和创新图像生成模型实力出圈

为了解决这些挑战,我们提出了一种创新的图像编辑框架,它利用Chain-of-Thought(CoT)推理和多模态大语言模型(LLMs)的定位能力来帮助扩散模型生成更精致的图像。大量的实验表明,我们的模型在图像生成方面在定性和定量上都超越了现有最先进的模型。本文提出了一种创新的图像编辑框架,该框架结合了链式思考(Chain-of-Thought, CoT)推理和多模态大型语言模型(Multimodal Large Language Models, MLLMs)的区域定位能力,以协助扩散模型生成更精细的图像。

高德技术 1756

CVPR 2025 Highlight|HumanRig:3D数字人黑科技,解锁更智能的3D角色动画框架

我们将分别介绍这些模块。这一优势主要归功于我们采用的基于Point Transformer的网格编码器,它能够有效区分不同身体部位的特征,从而生成更加精确的蒙皮权重分布,最终实现更高质量的网格变形效果。在这个过程中,我们确定粗略的三维骨架,通过计算每条射线与网格表面的交点,并使用每个三维粗略关节的第一次和最后一次交点的中点来得到结果。我们推出了一种创新的自动绑定算法,我们方法的核心模块包括:a)先验引导骨架估计器(PGSE),使用投射到3D空间中的2D先验初始化粗略骨架,显著降低绑定任务的复杂性。

高德技术 1963

高德视觉技术中心团队携CVPR论文成果亮相China3DV 2025

在"优秀论文Fastforward"环节,论文第一作者储泽栋通过现场演示与理论解析,详细展示了HumanRig技术创新,此研究不仅填补了3D人形角色绑定领域的数据集空白,还提出一种创新的自动绑定算法,推动动画行业向更高效、更自动化的角色绑定方向发展。高德视觉技术中心始终站在计算机视觉研究与应用的创新高地,是高德空间智能互联网领域重要的技术实践者。作为三维视觉领域年度盛会,本次高德视觉技术中心的创新成果展示,不仅彰显了团队在计算机视觉领域的技术积淀,更为行业提供了数字内容生产的革新方案。

高德技术 1110

技术公益|高德「卫星求救」与「无网导航」,用技术开拓无人区

无网导航通过技术保障用户体验。高德用户会在某些位置发起请求,如果是网络原因导致的请求失败,那就可以识别出来这块区域网络不顺畅,如果大量用户都在这里发出网络请求失败信息,就形成了我们所说的无网区域,用户本次导航途经无网区域,高德APP会提前缓存导航数据至后台,以备不时之需。高德通过与各大手机厂商的合作,接入厂商卫星能力SDK,统一接口标准,构建了一套通用化卫星通信解决方案,以此借助手机的硬件能力,建立与卫星的双向通信,将救援信号发送至卫星的同时也能从卫星接收对救援信息的回复,实现整个卫星救援能力上的闭环。

高德技术 1627

高德2025科研课题正式发布,研究型实习生岗位等你加入!

对于导航/定位地图而言,主要需要从众包数据中提取场景中对导航和定位重要的少量的稳定的信息,实景地图包含显著更多的细节,端云交互可以以更高效的隐式表达进行(类似Nerual Map),场景中的对象的几何和外观都可能发生显著的变化,这是实现大规模实景地图的众包渐进式构建与更新的核心难点。近年来,多模态大模型的兴起为这一领域提供了新的技术手段。这些技术的应用使平台和商家能够充分利用AI智能创作的能力,可以根据用户的特性,生成个性化的素材或者内容,高效地产出多样性的视觉效果,从而带来了巨大的商业价值。

高德技术 1501

高德终端技术总结:高可用架构如何练成?

在技术栈设计上,除调用系统平台服务的部分使用原生语言(Java//OC//ArtTS)外,其他均使用跨平台语言,来实现最大限度的跨平台,其中对于高性能要求的能力(如地图引擎、基础库)使用C++实现,而对于高效率要求的能力(如前端页面)则使用JS实现。稳定性工作属于「流水不腐,户枢不蠹」。高德地图作为国民级应用,特别是出行场景的独特性,要确保在线导航高并发和交通安全级的超稳定性,这对技术团队提出异乎寻常的高要求,无论是终端、云端,还是“终端-云端”之间的连接,都必须实现“高可用、高性能、高效率”的技术目标。

高德技术 1496

CVPR 2025|突破自动驾驶“交规困境“:高德车道级交通规则在线理解,让AI更懂交规!

其中 MEE 模型专门用于对矢量地图进行特征编码,将每个矢量点进行 tokenize,使用 learnable query 配合 Intra & Inter Instance Attention 进行矢量特征的聚合,融合后每个 query 对应一条矢量的特征信息。高德认为,遵守交通规则行驶是实现自动驾驶系统的必要条件,车道级交通规则通常包含在高精地图中,为自动驾驶系统提供了准确、可靠的规则指导。由人类驾驶过程的启发,从交通标志中理解交通规则需要完成两个任务,理解交通标志牌中指示的。

高德技术 961

CVPR 2025|突破自动驾驶“交规困境“:高德车道级交通规则在线理解,让AI更懂交规!

其中 MEE 模型专门用于对矢量地图进行特征编码,将每个矢量点进行 tokenize,使用 learnable query 配合 Intra & Inter Instance Attention 进行矢量特征的聚合,融合后每个 query 对应一条矢量的特征信息。高德认为,遵守交通规则行驶是实现自动驾驶系统的必要条件,车道级交通规则通常包含在高精地图中,为自动驾驶系统提供了准确、可靠的规则指导。由人类驾驶过程的启发,从交通标志中理解交通规则需要完成两个任务,理解交通标志牌中指示的。

高德技术 288

CVPR 2025|突破自动驾驶“交规困境“:高德车道级交通规则在线理解,让AI更懂交规!

其中 MEE 模型专门用于对矢量地图进行特征编码,将每个矢量点进行 tokenize,使用 learnable query 配合 Intra & Inter Instance Attention 进行矢量特征的聚合,融合后每个 query 对应一条矢量的特征信息。高德认为,遵守交通规则行驶是实现自动驾驶系统的必要条件,车道级交通规则通常包含在高精地图中,为自动驾驶系统提供了准确、可靠的规则指导。由人类驾驶过程的启发,从交通标志中理解交通规则需要完成两个任务,理解交通标志牌中指示的。

高德技术 181

CVPR 2025|突破自动驾驶“交规困境“:高德车道级交通规则在线理解,让AI更懂交规!

其中 MEE 模型专门用于对矢量地图进行特征编码,将每个矢量点进行 tokenize,使用 learnable query 配合 Intra & Inter Instance Attention 进行矢量特征的聚合,融合后每个 query 对应一条矢量的特征信息。高德认为,遵守交通规则行驶是实现自动驾驶系统的必要条件,车道级交通规则通常包含在高精地图中,为自动驾驶系统提供了准确、可靠的规则指导。由人类驾驶过程的启发,从交通标志中理解交通规则需要完成两个任务,理解交通标志牌中指示的。

高德技术 156

CVPR 2025|突破自动驾驶“交规困境“:高德车道级交通规则在线理解,让AI更懂交规!

其中 MEE 模型专门用于对矢量地图进行特征编码,将每个矢量点进行 tokenize,使用 learnable query 配合 Intra & Inter Instance Attention 进行矢量特征的聚合,融合后每个 query 对应一条矢量的特征信息。高德认为,遵守交通规则行驶是实现自动驾驶系统的必要条件,车道级交通规则通常包含在高精地图中,为自动驾驶系统提供了准确、可靠的规则指导。由人类驾驶过程的启发,从交通标志中理解交通规则需要完成两个任务,理解交通标志牌中指示的。

高德技术 223

CVPR 2025|突破自动驾驶“交规困境“:高德车道级交通规则在线理解,让AI更懂交规!

其中 MEE 模型专门用于对矢量地图进行特征编码,将每个矢量点进行 tokenize,使用 learnable query 配合 Intra & Inter Instance Attention 进行矢量特征的聚合,融合后每个 query 对应一条矢量的特征信息。高德认为,遵守交通规则行驶是实现自动驾驶系统的必要条件,车道级交通规则通常包含在高精地图中,为自动驾驶系统提供了准确、可靠的规则指导。由人类驾驶过程的启发,从交通标志中理解交通规则需要完成两个任务,理解交通标志牌中指示的。

高德技术 107

CVPR 2025|突破自动驾驶“交规困境“:高德车道级交通规则在线理解,让AI更懂交规!

其中 MEE 模型专门用于对矢量地图进行特征编码,将每个矢量点进行 tokenize,使用 learnable query 配合 Intra & Inter Instance Attention 进行矢量特征的聚合,融合后每个 query 对应一条矢量的特征信息。高德认为,遵守交通规则行驶是实现自动驾驶系统的必要条件,车道级交通规则通常包含在高精地图中,为自动驾驶系统提供了准确、可靠的规则指导。由人类驾驶过程的启发,从交通标志中理解交通规则需要完成两个任务,理解交通标志牌中指示的。

高德技术 298

CVPR 2025|突破自动驾驶“交规困境“:高德车道级交通规则在线理解,让AI更懂交规!

其中 MEE 模型专门用于对矢量地图进行特征编码,将每个矢量点进行 tokenize,使用 learnable query 配合 Intra & Inter Instance Attention 进行矢量特征的聚合,融合后每个 query 对应一条矢量的特征信息。高德认为,遵守交通规则行驶是实现自动驾驶系统的必要条件,车道级交通规则通常包含在高精地图中,为自动驾驶系统提供了准确、可靠的规则指导。由人类驾驶过程的启发,从交通标志中理解交通规则需要完成两个任务,理解交通标志牌中指示的。

高德技术 181

CVPR 2025|突破自动驾驶“交规困境“:高德车道级交通规则在线理解,让AI更懂交规!

其中 MEE 模型专门用于对矢量地图进行特征编码,将每个矢量点进行 tokenize,使用 learnable query 配合 Intra & Inter Instance Attention 进行矢量特征的聚合,融合后每个 query 对应一条矢量的特征信息。高德认为,遵守交通规则行驶是实现自动驾驶系统的必要条件,车道级交通规则通常包含在高精地图中,为自动驾驶系统提供了准确、可靠的规则指导。由人类驾驶过程的启发,从交通标志中理解交通规则需要完成两个任务,理解交通标志牌中指示的。

高德技术 439

CVPR 2025|突破自动驾驶“交规困境“:高德车道级交通规则在线理解,让AI更懂交规!

其中 MEE 模型专门用于对矢量地图进行特征编码,将每个矢量点进行 tokenize,使用 learnable query 配合 Intra & Inter Instance Attention 进行矢量特征的聚合,融合后每个 query 对应一条矢量的特征信息。高德认为,遵守交通规则行驶是实现自动驾驶系统的必要条件,车道级交通规则通常包含在高精地图中,为自动驾驶系统提供了准确、可靠的规则指导。由人类驾驶过程的启发,从交通标志中理解交通规则需要完成两个任务,理解交通标志牌中指示的。

高德技术 503

CVPR 2025|突破自动驾驶“交规困境“:高德车道级交通规则在线理解,让AI更懂交规!

其中 MEE 模型专门用于对矢量地图进行特征编码,将每个矢量点进行 tokenize,使用 learnable query 配合 Intra & Inter Instance Attention 进行矢量特征的聚合,融合后每个 query 对应一条矢量的特征信息。高德认为,遵守交通规则行驶是实现自动驾驶系统的必要条件,车道级交通规则通常包含在高精地图中,为自动驾驶系统提供了准确、可靠的规则指导。由人类驾驶过程的启发,从交通标志中理解交通规则需要完成两个任务,理解交通标志牌中指示的。

高德技术 131
上一篇: 高德开源数字人核心引擎,打造真实可控的音频驱动数字人
下一篇: 从底层重构强化学习训练框架,高德开源新方法
高德技术
高德技术 企业官方账号 企业官方账号
博客等级 码龄7年 1270粉丝 146原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值