深度学习的多个loss如何平衡 & 有哪些「魔改」损失函数,曾经拯救了你的深度学习模型?...

YOLO代码解读 *Box:**YOLOV5使用 GIOU loss作为bounding box的损失,Box推测为GIoU损失函数均值越小,方框越准。对于某个分类,综合了Precision和Recall的一个判断指标,F1-Score的值是从0到1的,1是最好,0是最差。**box_loss:**用于监督检测框的回归,预测框与标定框之间的误差(CIoU)。**cls_loss:**用于监督类别分类,计算锚框与对应的标定分类是否正确。**obj_loss:**用于监督grid中是否存在物体,计算网络的置信度。 阅读详情
AI摘要

本文探讨深度学习中多任务学习的loss平衡策略及改进损失函数对模型性能的影响,以MTCNN和OCR-table-SSD为例,分析loss权重调整和创新loss如weightedCrossEntropy、MSE对缺陷检测任务的作用。

这篇文章整理自我的知乎回答(id: Hanson),分别对深度学习中的多个loss如何平衡 以及 有哪些「魔改」损失函数,曾经拯救了你的深度学习模型 这两个问题进行了解答。

1. 深度学习的多个loss如何平衡?

1.1 mtcnn

对于多任务学习而言,它每一组loss之间的数量级和学习难度并不一样,寻找平衡点是个很难的事情。我举两个我在实际应用中碰到的问题。第一个是多任务学习算法MTCNN,这算是人脸检测领域最经典的算法之一,被各家厂商魔改,其性能也是很不错的,也有很多版本的开源实现(如果不了解的话,请看:https://blog.youkuaiyun.com/qq_36782182/article/details/83624357)。但是我在测试各种实现的过程中,发现竟然没有一套实现是超越了原版的(https://github.com/kpzhang93/MTCNN_face_detection_alignment)。下图中是不同版本的实现,打了码的是我复现的结果。
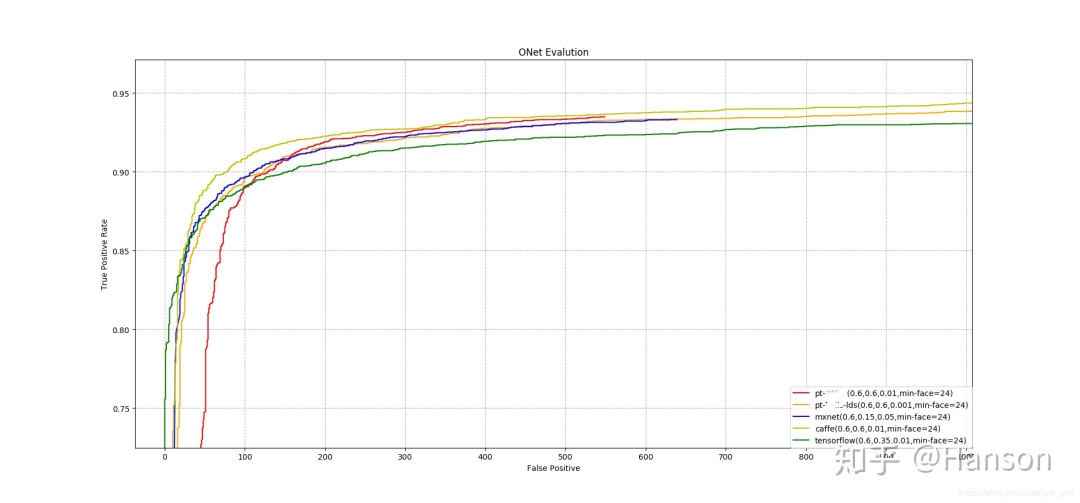
不同版本mtcnn在FDDB上roc曲线

这是一件很困扰的事情,参数、网络结构大家设置都大差不差。但效果确实是迥异。

clsloss表示置信度score的loss,boxloss表示预测框位置box的loss,landmarksloss表示关键点位置landmarks的loss。

那么,,这几个权值,究竟应该设置为什么样的才能得到一个不错的结果呢?

其实有个比较不错的主意,就是只保留必要的那两组权值,把另外一组设置为0,比如 ,, 。为什么这么做?第一是因为关键点的回归在人脸检测过程中不是必要的,去了这部分依旧没什么大问题,也只有在这个假设的前提下才能进行接下来的实验。

就比如这个MTCNN中的ONet,它回归了包括score、bbox、landmarks,我在用pytorch复现的时候,出现一些有意思的情况,就是将landmarks这条任务冻结后(即 ,,),发现ONet的性能得到了巨大的提升。能超越原始版本的性能。

但是加上landmarks任务后( ,, )就会对cls_loss造成影响,这就是一个矛盾的现象。而且和a、b、c对应的大小有很大关系。当设置成( 系数全1 )的时候关键点的精度真的是惨不忍睹,几乎没法用。当设置成(  a/b/c=1/10/100)的时候,loss到了同样一个数量级,landmarks的精度确实是上去了,但是score却不怎么让人满意。如果产生了这种现象,就证明了这个网络结构在设计的时候出现了一些缺陷,需要去修改backbone之后的multi-task分支,让两者的相关性尽量减小。或者是ONet就不去做关键点,而是选择单独的一个网络去做关键点的预测(比如追加一个LNet)。box的回归并不是特别受关键点影响,大部分情况box和landmarks是正向促进的,影响程度可以看做和score是一致的,box的精度即便下降了5%,它还是能框得住目标,因此不用太在意。

上面这个实验意在说明,要存在就好的loss权重组合,那么你的网络结构就必须设计的足够好。不然你可能还需要通过上述的实验就验证你的网络结构。从多种策略的设计上去解决这种loss不均衡造成的困扰。

和@叶不知(知乎用户)讨论后,有一篇论文也可以提供参考:

https://arxiv.org/abs/1810.04002

1.2 ocr-table-ssd

第二个是我之前做过一点OCR方面的工作,这个是我对于表格框格式化方面做的工作,基本算原创工作。

https://github.com/hanson-young/ocr-table-ssd
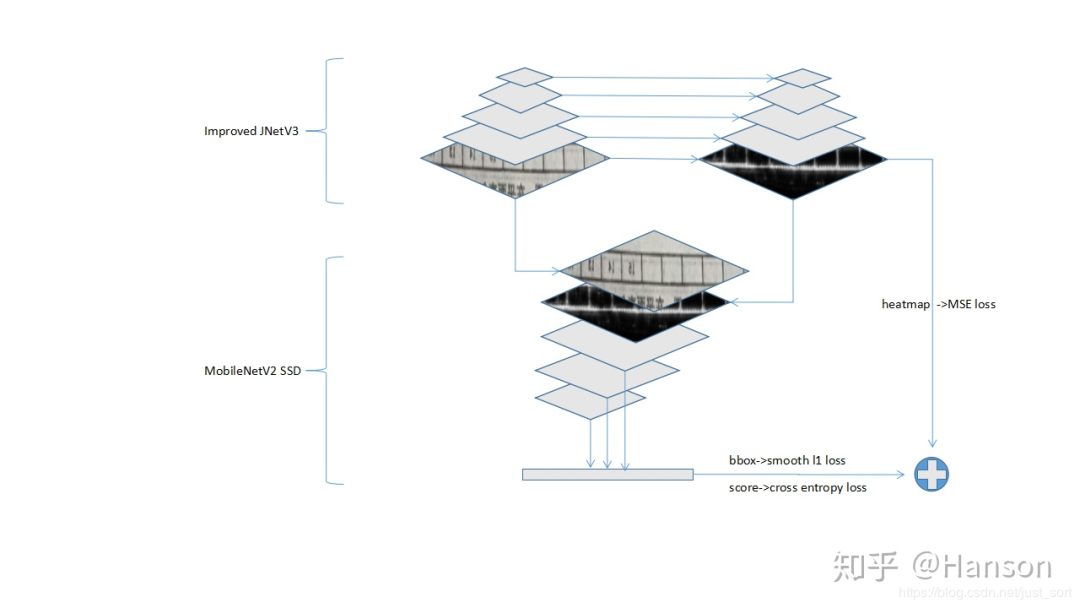
改进版本的SSD表格检测

算法是基于SSD改的,与原有SSD相比增加了一个预测heatmap的分支,算是一种attention机制的表现吧。改进后训练达到相同的精度和loss,SSD用时10小时,改进后的方法耗时仅需10-20min。在训练过程中如果两个分支一起训练,很难发挥网络的真正意义,并且收敛到不是很理想的地方,所以训练过程也挺重要的,在实验中,将原来的optimizer从SGD(不易收敛,可能和学习率有关)换到RMSProp:

  • 先冻结SSD网络,然后训练segmentation分支,到收敛

  • 再冻结segmentation分支进行SSD部分的训练,到收敛

  • 再将整个网络解冻训练到收敛,能达到比较好的效果

原图
预测结果
heatmap

因为表格尺度的影响,不加入heatmap分支会导致图像被过分拉升,导致无法检测到表格框。

加入heatmap后还有个好处就是为表格的对齐提供了可能。
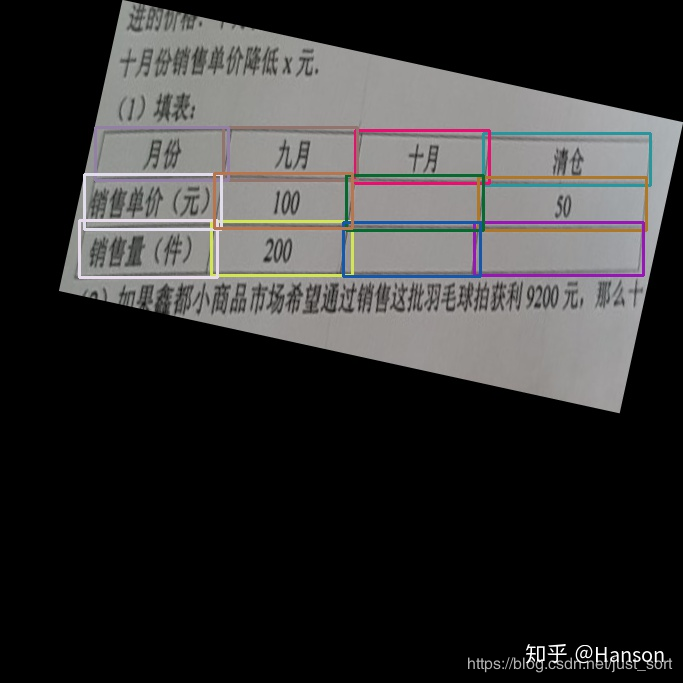
原图

如果直接检测,对于一个矩形框来说,恐怕是会非常吃力的。如果

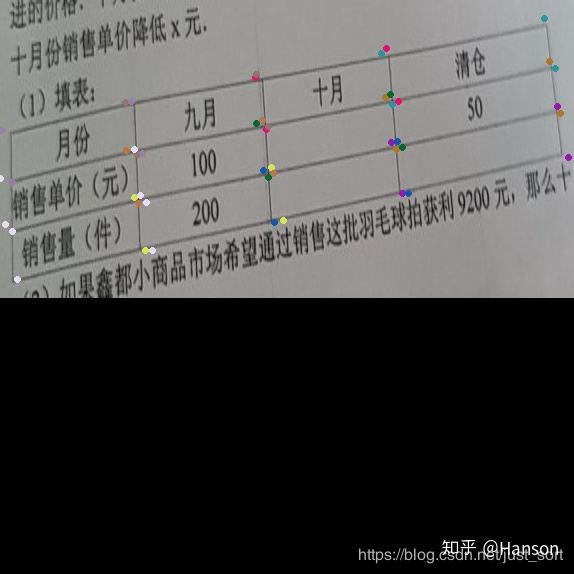
heatmap -> 阈值分割 -> Sobel -> HoughLineP -> angle

求出表格的倾斜角angle后,可以将原图和heatmap旋转统一的angle后concatenation,这样再接着跑SSD,对齐后的效果比较明显,解决了倾斜角度过大,带来bbox框过大的影响,详细见下图。
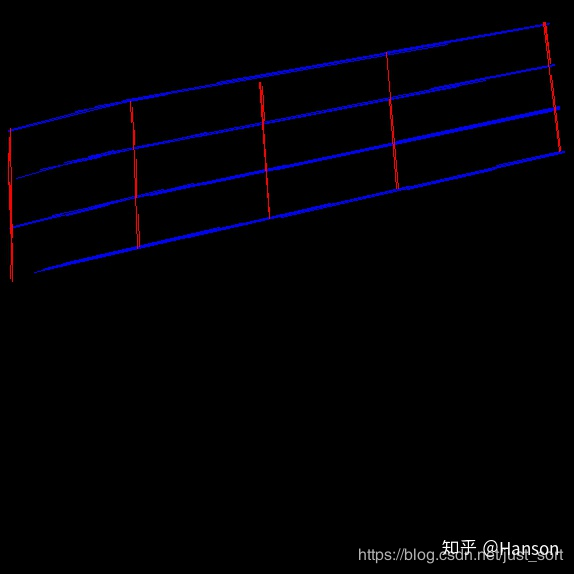
可以求出角度

然后进行对齐工作

对齐后的结果

是不是能好很多。

2. 有哪些「魔改」损失函数,曾经拯救了你的深度学习模型?

我在做缺陷检测时候对比了一些loss的性能,其实确实是那句话,适合自己的才是最好的。以下我用实际例子来说明这个问题。

2.1 实验条件

为了实验方便,我们使用了CrackForest数据集(https://github.com/cuilimeng/CrackForest-dataset)做训练测试,目的是去将裂纹缺陷分割出来,总共118张图片,其中训练样本94张,测试样本24张,采用旋转、随机缩放、裁剪、图像亮度增强、随机翻转增强操作,保证实验参数一直,模型均是类Unet网络,仅仅使用了depthwise卷积结构,进行了如下几组实验,并在tensorboard中进行图像预测状态的观测。
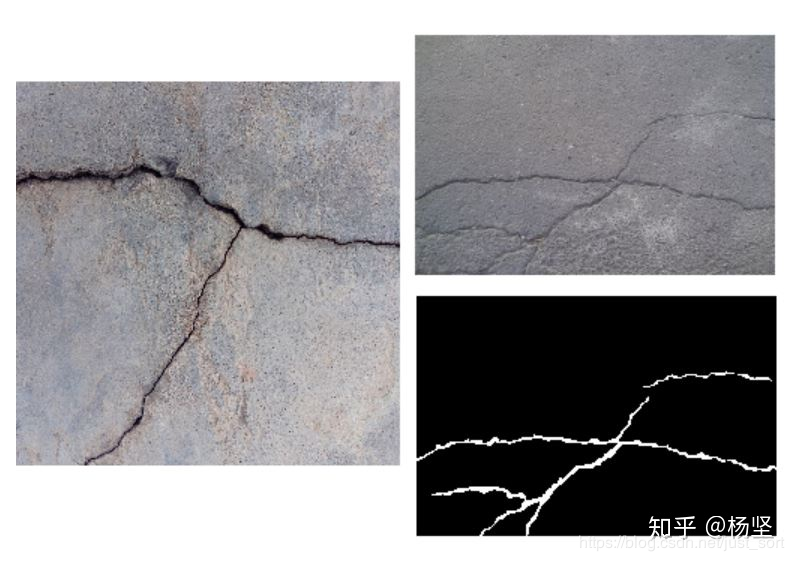
CrackForest数据集samples

2.2 weighted CrossEntropy

在loss函数的选取时,类似focal loss,常规可以尝试使用cross_entropy_loss_RCF(https://github.com/meteorshowers/RCF-pytorch/blob/master/functions.py),或者是weighted MSE,因为图像大部分像素为非缺陷区域,只有少部分像素为缺陷裂痕,这样可以方便解决样本分布不均匀的问题

validation
epoch[625] | val_loss: 2708.3965 | precisions: 0.2113 | recalls: 0.9663 | f1_scores: 0.3467
training
2018-11-27 11:53:56 [625-0] | train_loss: 2128.9360 | precisions: 0.2554 | recalls: 0.9223 | f1_scores: 0.4000
2018-11-27 11:54:13 [631-2] | train_loss: 1416.9917 | precisions: 0.2359 | recalls: 0.9541 | f1_scores: 0.3782
2018-11-27 11:54:31 [637-4] | train_loss: 1379.9745 | precisions: 0.1916 | recalls: 0.9591 | f1_scores: 0.3194
2018-11-27 11:54:50 [643-6] | train_loss: 1634.6824 | precisions: 0.3067 | recalls: 0.9636 | f1_scores: 0.4654
2018-11-27 11:55:10 [650-0] | train_loss: 2291.4810 | precisions: 0.2498 | recalls: 0.9317 | f1_scores: 0.3940
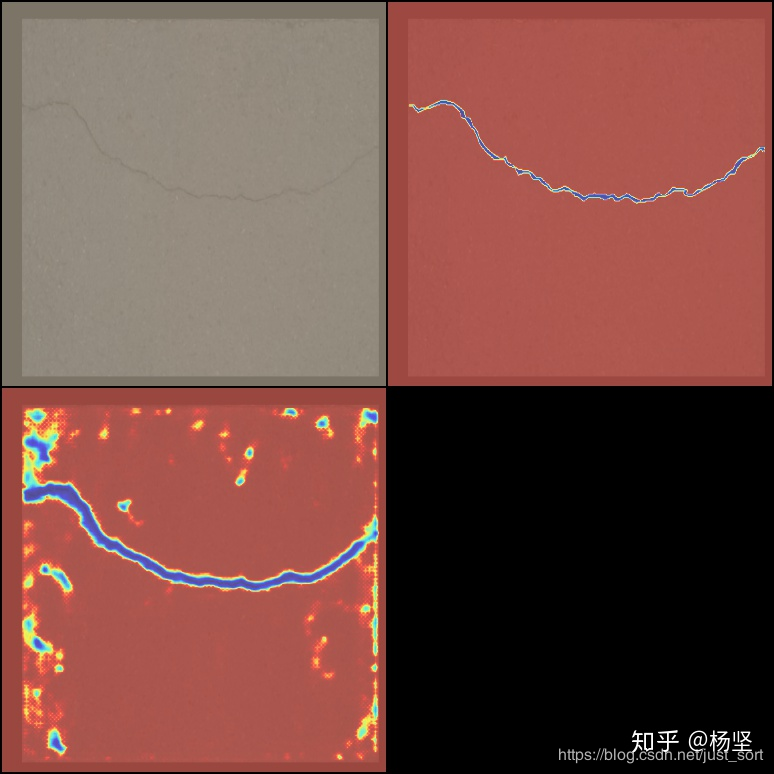
weighted CrossEntropy loss的最佳预测结果

weighted CrossEntropy 在实验过程中因为图片中的缺陷部分太过稀疏,导致了weights的选取有很大的问题存在,训练后会发现其recall极高,但是precision却也是很低,loss曲线也极其不规律,基本是没法参考的,能把很多疑似缺陷的地方给弄进来.因此只能将weights改为固定常量,这样可以在一定程度上控制均衡recall和precision,但调参也会相应变得麻烦

2.3 MSE(不带权重)

我们先来试试MSE,在分割上最常规的loss

validation
epoch[687] | val_loss: 0.0063 | precisions: 0.6902 | recalls: 0.6552 | f1_scores: 0.6723 | time: 0
epoch[875] | val_loss: 0.0067 | precisions: 0.6324 | recalls: 0.7152 | f1_scores: 0.6713 | time: 0
epoch[1250] | val_loss: 0.0066 | precisions: 0.6435 | recalls: 0.7230 | f1_scores: 0.6809 | time: 0
epoch[1062] | val_loss: 0.0062 | precisions: 0.6749 | recalls: 0.6835 | f1_scores: 0.6792 | time: 0
training
2018-11-27 15:01:34 [1375-0] | train_loss: 0.0055 | precisions: 0.6867 | recalls: 0.6404 | f1_scores: 0.6627
2018-11-27 15:01:46 [1381-2] | train_loss: 0.0045 | precisions: 0.7223 | recalls: 0.6747 | f1_scores: 0.6977
2018-11-27 15:01:58 [1387-4] | train_loss: 0.0050 | precisions: 0.7336 | recalls: 0.7185 | f1_scores: 0.7259
2018-11-27 15:02:09 [1393-6] | train_loss: 0.0058 | precisions: 0.6719 | recalls: 0.6196 | f1_scores: 0.6447
2018-11-27 15:02:21 [1400-0] | train_loss: 0.0049 | precisions: 0.7546 | recalls: 0.7191 | f1_scores: 0.7364
2018-11-27 15:02:32 [1406-2] | train_loss: 0.0057 | precisions: 0.7286 | recalls: 0.6919 | f1_scores: 0.7098
2018-11-27 15:02:42 [1412-4] | train_loss: 0.0054 | precisions: 0.7850 | recalls: 0.6932 | f1_scores: 0.7363
2018-11-27 15:02:53 [1418-6] | train_loss: 0.0050 | precisions: 0.7401 | recalls: 0.7223 | f1_scores: 0.7311
MSE loss的最佳预测结果

MSE在训练上较cross entropy就比较稳定,在heatmap预测上优势挺明显

2.4 weighted MSE(8:1)

既然MSE的效果还不错,那么是否加权后就更好了呢,其实从我做的实验效果来看,并不准确,没想象的那么好,甚至导致性能下降了

validation
epoch[2000] | val_loss: 11002.3584 | precisions: 0.5730 | recalls: 0.7602 | f1_scores: 0.6535 | time: 1
training
2018-11-27 13:12:44 [2000-0] | train_loss: 7328.5186 | precisions: 0.6203 | recalls: 0.6857 | f1_scores: 0.6514
2018-11-27 13:13:01 [2006-2] | train_loss: 6290.4971 | precisions: 0.5446 | recalls: 0.5346 | f1_scores: 0.5396
2018-11-27 13:13:18 [2012-4] | train_loss: 5887.3525 | precisions: 0.6795 | recalls: 0.6064 | f1_scores: 0.6409
2018-11-27 13:13:36 [2018-6] | train_loss: 6102.1934 | precisions: 0.6613 | recalls: 0.6107 | f1_scores: 0.6350
2018-11-27 13:13:53 [2025-0] | train_loss: 7460.8853 | precisions: 0.6225 | recalls: 0.7137 | f1_scores: 0.6650
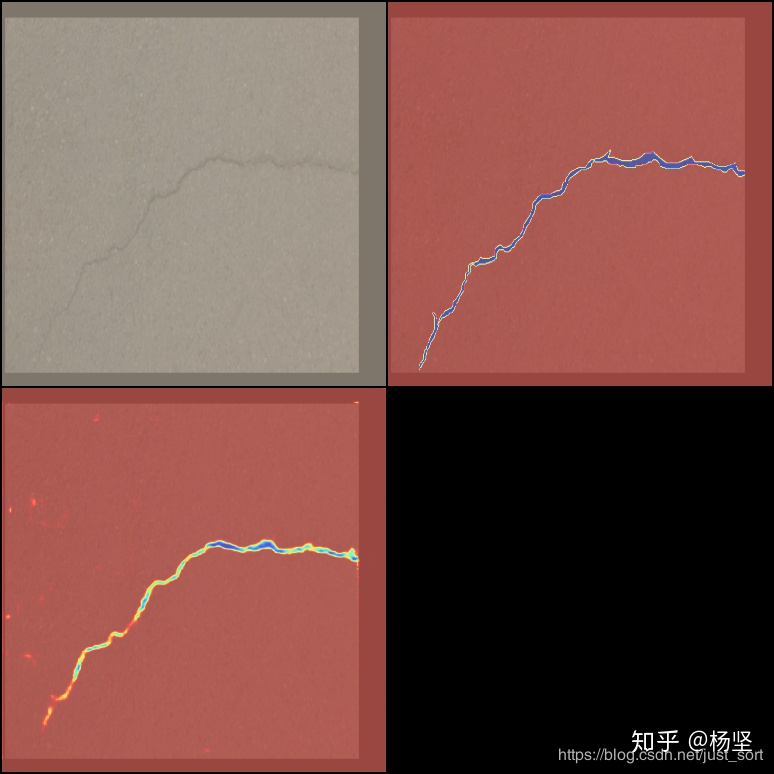
weighted MSE loss的最佳预测结果

以上loss在性能表现上,MSE > weighted MSE > weighted CrossEntropy,最简单的却在该任务上取得了最好的效果,所以我们接下来该做的,就是去怀疑人生了!

欢迎扫码关注:

深度学习实操地图:从环境搭建到YOLO部署的12个关键节点 深度学习不是数学推导,而是工程化的问题解决过程。理解模型原理是基础,但真正决定项目成败的是环境兼容性、数据预处理鲁棒性、训练稳定性与端侧部署可行性。PyTorch动态图机制、Hugging Face模型即服务范式、Ultralytics YOLO极简API共同降低了工程门槛;而M1芯片的mps后端支持、Focal Loss应对长尾分布、ONNX+Core ML轻量化路径,则体现了现代深度学习落地中的典型技术选型逻辑。本文聚焦真实开发场景中的高频痛点——CUDA版本错配、YOLO标注越界、学习率震荡、mAP指 阅读详情

相关推荐

Binary Cross-Entropy损失函数的数学起源与工程本质

二分类损失函数是监督学习的核心组件,其设计并非经验选择,而是源于统计学中的最大似然估计原理。在独立同分布假设下,模型预测概率与真实标签构成的伯努利似然函数,经对数变换解决数值下溢问题,再取负号适配梯度下降优化范式,最终导出binary cross-entropy形式。该过程自然融入信息论视角——它等价于KL散度,本质是量化预测分布与真实分布之间的信息差异。这一基础原理广泛应用于文本分类、图像识别、推荐系统等场景,也是理解标签平滑、温度缩放、Focal Loss等进阶技术的前提。

weixin_34341229的博客 381

yolov8在train时,出现box_loss、cls_loss、dfl_loss为nan,Box(P R mAP50 mAP50-95)为0的解决办法

'cpu' 将self.args.half的值设置为False 后训练yolov8n Box(P R mAP50 mAP50-95)不为0。并注释掉ultralytics/yolo/engine/validator.py 中第102行代码 # self.args.half = self.device.type!分析.half()改为.float()或者把half赋值为False,找到val.py和validator.py。查看self.args.half:的值的结果。

2301_78783836的博客 1万+

机器学习中的凸性实战指南:从优化稳定到模型可解释

凸性与凹性是机器学习中决定模型能否稳定收敛、可复现部署的核心数学属性。其本质并非二维图像的弯曲方向,而是函数空间中全局最优解存在性与可达性的几何编码——凸函数保障梯度下降收敛至唯一极小点,凹函数则天然建模边际递减与硬约束逻辑。在工程实践中,损失函数(如MSE、交叉熵)、正则项(L1/L2、ElasticNet)和激活函数(ReLU、GELU)的凸性直接左右训练稳定性、泛化能力与业务对齐程度。尤其在非凸主导的深度学习场景下,通过曲率采样、凸化正则、增强感知约束等技术手段主动管理凸性,已成为提升AUC、降低过杀

weixin_30540691的博客 495

目标检测模型中的几个损失值

DFL损失的主要作用是用于校正模型在预测物体边界框时的误差,优化后的效果可以在一定程度上针对有些模糊或者焦点不集中的图片提升对象检测的精度。Box Loss直接依赖于模型预测的边界框与实际(或称为真值)边界框之间的距离。DFL损失是一个更高级的损失函数,目标是能在某些更复杂的情况下获得更好的性能,特别是针对一些难以边界框预测的目标。Box损失函数通常用于基本的目标检测任务,如Faster R-CNN, SSD等方法,Box损失是一个相对简单的损失函数,它主要计算预测的边界框与实际的边界框之间的位置偏差。

qq_52832321的博客 1万+

从零实现神经网络:手写MLP、梯度推导与调试实践

神经网络本质是可微分的函数组合,其核心原理在于链式法则驱动的梯度反向传播。掌握这一机制的技术价值,在于摆脱框架黑箱依赖,获得对数值稳定性、内存布局和计算流的完全控制能力。典型应用场景包括模型轻量化部署、自定义损失函数开发、联邦学习梯度审计及边缘设备推理优化。本文聚焦全连接网络(MLP)这一最小可行结构,通过纯NumPy手写Dense层、ReLU激活、CrossEntropyLoss及SGD with Momentum,完整呈现前向计算、手动求导、参数更新与健康监控的工程闭环,覆盖梯度检查、NaN排查、初始化

299

正则化本质:从过拟合治理到模型泛化能力构建

正则化是机器学习中应对过拟合的核心技术机制,其本质是在损失函数中引入参数复杂度约束,通过L1(Lasso)、L2(Ridge)或混合范数(ElasticNet)实现特征筛选或系数收缩。它并非调参玄学,而是建模过程中对模型容量、数据噪声与泛化目标的系统性权衡。技术价值在于提升模型鲁棒性、增强可解释性、缓解多重共线性,并支撑高维稀疏场景下的稳定预测。典型应用场景涵盖金融风控(需L1驱动的可解释建模)、工业预测性维护(依赖Ridge保障系数稳定性)及推荐系统(ElasticNet平衡稀疏与相关性)。本文深入剖析正

duiker 423

有哪些「魔改」损失函数,曾经拯救了你的深度学习模型?

知乎高质量回答一、作者:张良怀https://www.zhihu.com/question/294635686/answer/606259229本文来自知乎问答,回答已获作者授权,禁止二...

zandaoguang的博客 2150

AI减碳的工程落地:从模型到产线的全链路实践

人工智能在碳减排中的应用,已超越概念阶段,进入以能效优化、过程控制和系统协同为核心的工程化实施期。其核心原理在于利用机器学习处理多源异构数据、实现多目标动态寻优,并在物理约束下构建可解释、低功耗的轻量级模型。技术价值体现在显著降低单位产值能耗、提升绿电消纳率及延长设备寿命等可量化指标上。典型应用场景覆盖能源系统智能调度、工业锅炉燃烧优化、交通运力协同及制造业过程能效提升等领域。本文聚焦AI减碳从数据采集、物理信息嵌入建模到OPC UA集成部署的完整工程链路,强调‘小而精模型’与‘人在环路’设计对真实产线减碳

weixin_33857679的博客 395

从YOLO到RetinaNet:聊聊Focal Loss是怎么拯救目标检测模型精度的

本文深入探讨了Focal Loss如何通过解决样本不平衡问题,显著提升目标检测模型的精度。从YOLO到RetinaNet的演进中,Focal Loss作为关键创新,重塑了计算机视觉领域的目标检测格局。文章详细解析了其核心思想、参数选择策略以及在RetinaNet中的成功实践,为深度学习从业者提供了宝贵的工程洞见。

weixin_30271335的博客 245

YOLOv5损失函数定义

YOLOv5的三种损失函数

WZT725的博客 4万+

04训练——基于YOLO V8的自定义数据集训练——训练结果说明

PR_curve 是 P-R 曲线的简称,它是精确率和召回率之间的关系曲线,精确率表示预测为正类的样本中有多少是真正的正类,召回率表示真正的正类中有多少被预测为正类。当你看到如下图所示的结果,就证明训练已经结束,并且可以在左侧文件夹中找到生成的weights文件夹,其中的best.pt就是生成的效果最好的模型文件,last.pt是生成的训练到当前状态最新的模型文件。例如,all类别的mAP50-95是0.316,表示整个模型在测试集上按照IOU从0.5到0.95的不同标准,目标检测的平均精度是31.6%。

raozhongbo的博客 4561

换个角度看GAN:另一种损失函数

转载自:机器之心选自Medium作者:Phúc Lê机器之心编译参与:张玺「本质上,GAN 就是另一种。」Jeremy Howardf 老师曾在(GAN)课程中说过:「…...

AI 算法笔记 1121

深度学习核心概念——从感知机到LLM的“中间件“

本文深入解析了神经网络中的关键"中间件"组件,包括前向传播与反向传播机制、激活函数的发展与比较、归一化方法的选择,以及应对过拟合的正则化技术。主要内容可概括为: 神经网络基础:从感知机的局限引出多层网络通过非线性激活函数实现复杂建模的原理,并解释前向传播和反向传播(基于链式法则)的工作机制。 激活函数演进:分析Sigmoid、ReLU等传统函数的优缺点,重点探讨GELU的概率学设计(被BERT/GPT采用)和SwiGLU的门控架构(LLaMA使用),后者通过增加参数量提升表现力。 归一化方法:对比Batch

求知若渴、虚心若愚 63

A/B测试突现异常:AI工程师用Transformer+联邦学习拯救误杀危机

在A/B测试中,某智能客服系统出现误杀投诉激增的突发状况。面对实时推理延迟突增、数据漂移告警以及标注量超10万条的浩瀚数据挑战,团队决定用Transformer模型结合联邦学习技术,快速定位误判问题并调整策略。在关键时刻,团队成员通过现场手写自定义损失函数、用AutoML搜索最优网络结构以及引入可解释性工具排查异常,最终在50ms内完成实时推荐,将召回率提升至98%,同时实现零误杀风控。

itAred的博客 817

避坑指南:RK3588上编译EtherCAT 1.6时遇到的权限问题和模块安装错误

本文详细解析了在RK3588平台上编译EtherCAT 1.6时常见的权限问题和模块安装错误,提供了两种实战解决方案和嵌入式开发的通用权限管理策略。通过优化内核配置和编译参数,显著提升实时性能,帮助开发者高效完成EtherCAT主站部署。

weixin_33724046的博客 453

在树莓派5(8G版)上运行Ollama + LLM

直接上结论,Ollama在树莓派上能安装,且本身运行起来毫无压力,但具体到大语言模型,Deepseek似乎不总是最佳选择。

ki1381的专栏 1652

人工智能、机器学习、深度学习:技术革命的深度解析

本文系统介绍了人工智能、机器学习和深度学习三大技术领域。第一部分阐述了人工智能的定义、发展历史、核心概念(如知识表示、搜索算法等)及其在自然语言处理、计算机视觉等领域的应用。第二部分详细讲解了机器学习的基本理论,包括监督学习、无监督学习等关键概念,重点介绍了常用的机器学习算法及其实际应用案例。第三部分深入探讨了深度学习技术,包括神经网络、激活函数等核心要素,并分析了CNN、RNN等主流架构及其创新应用。文章通过代码示例展示了各领域的基础实践,并展望了未来发展方向,强调这些技术正在深刻改变人类社会。

小相探索IT世界 6617

Qt 5.12.8在Linux下编译qtvirtualkeyboard模块,我踩过的那些坑(附完整解决方案)

本文详细介绍了在Linux系统下为Qt 5.12.8单独编译qtvirtualkeyboard模块的完整解决方案。通过分析模块缺失原因、提供精准的编译步骤和常见问题处理,帮助开发者高效解决虚拟键盘模块缺失问题,避免重新编译整个Qt源码的繁琐过程。

weixin_29248611的博客 461

PyTorch深度学习入门:从零跑通完整MNIST任务

深度学习不是API调用,而是端到端的数据流与控制流系统。理解张量维度契约、梯度更新机制和模型-数据-损失三者间的形状匹配原理,是避免‘能跑不能调’的关键。PyTorch凭借动态图执行、Pythonic接口和成熟调试工具链,为新手提供了可观察、可打断、可验证的实操基础。本文以MNIST分类为载体,覆盖数据加载、模型定义、训练循环、验证评估与模型推理五大闭环环节,聚焦真实工程中高频出现的shape不匹配、梯度累积、标准化失效等典型问题,帮助学习者建立系统级调试能力,迈出可复现、可部署、可演进的第一步。

weixin_34212762的博客 259

Oracle到金仓数据库信创改造迁移实施规划方案

**性能测试和优化**:对金仓数据库的性能进行测试,根据业务负载情况进行必要的调优,确保系统能够稳定高效运行。- **数据兼容性**:评估Oracle数据库中的数据结构和金仓数据库的兼容性,明确需要重构的数据模型。- **性能测试**:通过对金仓数据库的性能测试,预估在实际业务环境下的表现,是否能达到业务需求。- **工具选择**:选择适合的迁移工具,如金仓数据库提供的迁移工具,能够提升迁移效率和准确性。- **全面迁移**:在初步迁移成功后,进行全面数据迁移,确保所有数据完整迁移到金仓数据库上。

hdrhdrjdididrr的博客 482

Python+Appium实现泛微OA自动打卡:5分钟搭建移动端自动化脚本

移动端自动化测试是软件测试与办公自动化领域的重要技术方向,其核心原理是通过程序模拟用户对手机应用界面的操作,实现重复性任务的自动执行。Appium作为主流的开源移动端自动化框架,基于WebDriver协议,支持跨平台且无需修改被测应用,为自动化脚本开发提供了标准化接口。在工程实践中,结合Python简洁的语法和丰富的生态,可以快速构建稳定可靠的自动化解决方案。这一技术组合的价值在于能够高效处理“重复性、低价值、高频率”的日常操作,例如考勤打卡、数据填报等办公场景,显著提升工作效率。本文以泛微OA Emobi

weixin_28836875的博客 391

NCF实战:工业级神经协同过滤从零落地指南

神经协同过滤(NCF)是推荐系统从传统统计建模迈向端到端深度学习的关键范式,其核心在于用多层感知机替代线性内积,自动建模用户与物品间高阶非线性交互。原理上依托Embedding表征与通用函数逼近能力,在稀疏交互场景下显著提升长尾召回与冷启动效果。技术价值体现在轻量、稳定、可解释、易监控,兼顾推理延迟与训练效率,成为GNN等复杂模型的校准基线和工程落地首选。典型应用于电商‘猜你喜欢’、内容平台个性化排序等需实时响应与渐进优化的业务场景。本文聚焦NCF在真实工业环境中的完整实现——涵盖Embedding初始化策

weixin_34121304的博客 387

配置xen上VM混杂模式,使其能捕获物理网络流量

本文目的:配置VM和xen相应的物理网卡(pif)和虚拟网卡(vi

LeoDuo的专栏 3721
上一篇: Transformers是一种图神经网络
下一篇: 博士毕业后,去哪儿?
机器学习算法那些事
博客等级 码龄9年 1633粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值