零代码也能抓数据:用 Web Scraper API 快速搭建数据采集流程

[医学图像分割综述] Medical Image Segmentation Using Deep Learning: A Survey 本综述有两个独创之处,首先,与传统的调查方法直接将医学图像分割的文献划分为多个组,并对每个组详细介绍文献的方法相比,我们将目前流行的文献按照从粗到细的多层次结构进行分类。其次,本文重点研究了监督学习和弱监督学习方法,但未包括无监督方法,这种方法目前在医学图像领域并不流行。对于监督学习方法,我们从骨干网络的选择、网络块的设计和损失函数的改进三个方面对文献进行了分析。对于弱监督学习方法,我们分别根据数据增强,迁移学习和交互式分割研究文献。与已有的调查相比,本次调查的文献分类与以往有很大的不同,更便于读者了解相关 阅读详情
AI摘要

中小企业在数据获取上存在难题,亮数据平台的Web Scraper API可快速搭建数据采集流程。它无需写代码,能应对网站限制,可批量或实时采集数据,节省时间精力。文章还给出了该API的快速入门图文教程,降低了数据采集上手门槛。

1.前言

随着物流的愈加发达,比如一家小型跨境电商想跟踪竞争对手的新品上架信息,却因没有技术团队只能手动复制粘贴,物流公司每天要查询上百个包裹的物流状态,人工核对效率极低,说明中小企业在数据获取上的共性难题 —— 缺技术、缺预算,但又急需数据驱动决策

推荐的解决方案: 亮数据平台的 Web Scraper API 快速搭建数据采集流程

零代码快速搭建,无需编程基础,普通人也能在 10 分钟内完成数据采集流程,帮助中小企业用低成本实现数据化运营

2.亮数据Web Scraper API强大的地方

  • 不用自己瞎折腾写代码

你不用学那些复杂的编程,不用研究怎么扒网页数据,直接填个网址、选要啥信息(比如价格、评论),点一下就完事了。哪怕你啥技术不懂,跟着步骤点点鼠标也能搞定

  • 网站再刁难也不怕

有些网站会封 IP、弹验证码、不让机器扒数据,这工具自带 “隐身术”—— 自动换 IP、帮你过验证码,你不用管这些乱七八糟的,只管等数据就行

  • 快慢多少都能搞

想一次性扒 成千上万条数据(比如整个电商平台的商品),它能批量干;想实时看某个页面的最新信息(比如某商品现在多少钱),它也能马上给你结果

  • 省时间省精力

自己搞可能研究好几天还弄不明白,用这个几小时就能拿到数据。不用雇技术大佬,不用买服务器维护,花点小钱省大事

总之,就是把 “扒网页数据” 这件麻烦事变得跟 “用外卖软件点饭” 一样简单 —— 你只管说要啥,剩下的它全帮你搞定,因此我还是十分推荐亮数据这个平台的

3.Web Scraper API - 快速入门图文教程

3.1 前提准备

3.1.1 注册账号
在这里插入图片描述

传送门:亮数据

在这里插入图片描述

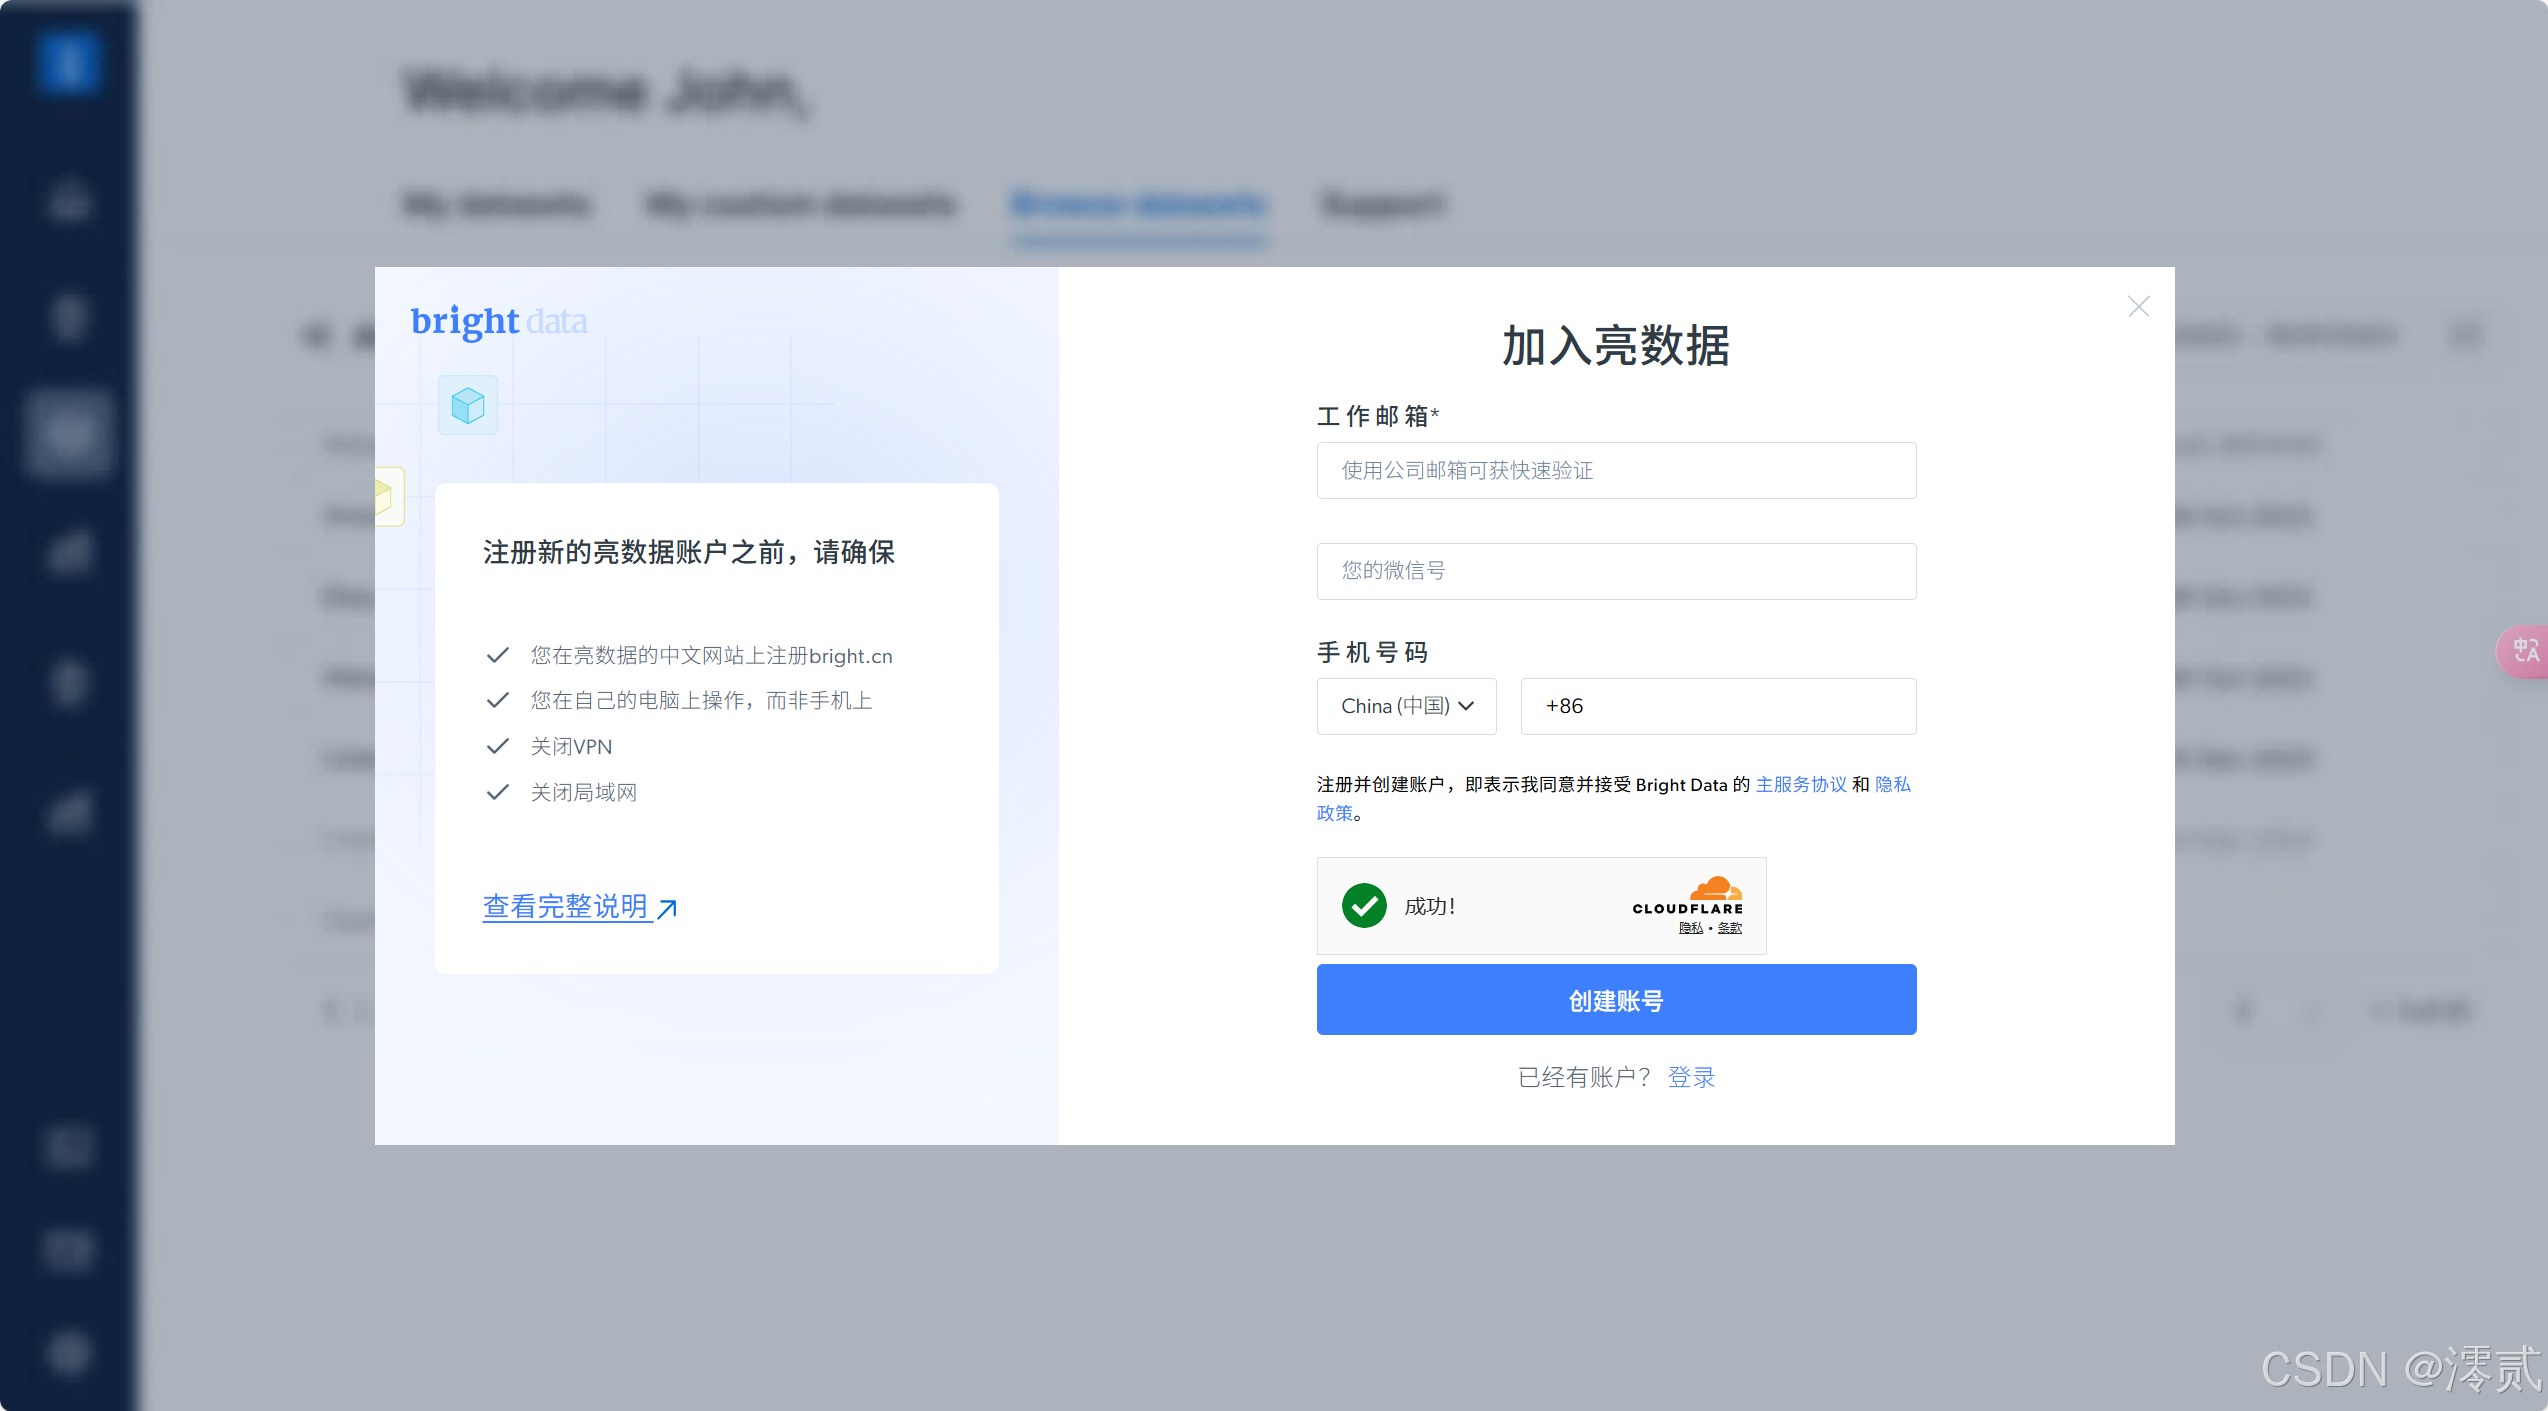
点开链接后,有个免费试用,点击他,自动弹出注册弹窗,填写信息注册一个 Bright Data 帐户(注册→ 2 分钟)

🔥注意: 亮数据平台对登录有要求限制

  • 在亮数据的中文网站上注册 bright.cn
  • 在自己的电脑上操作,而非手机上
  • 关闭 VPN
  • 关闭局域网

实在还无法解决的可以查看官方登录解决文档

3.1.2 获取API密钥
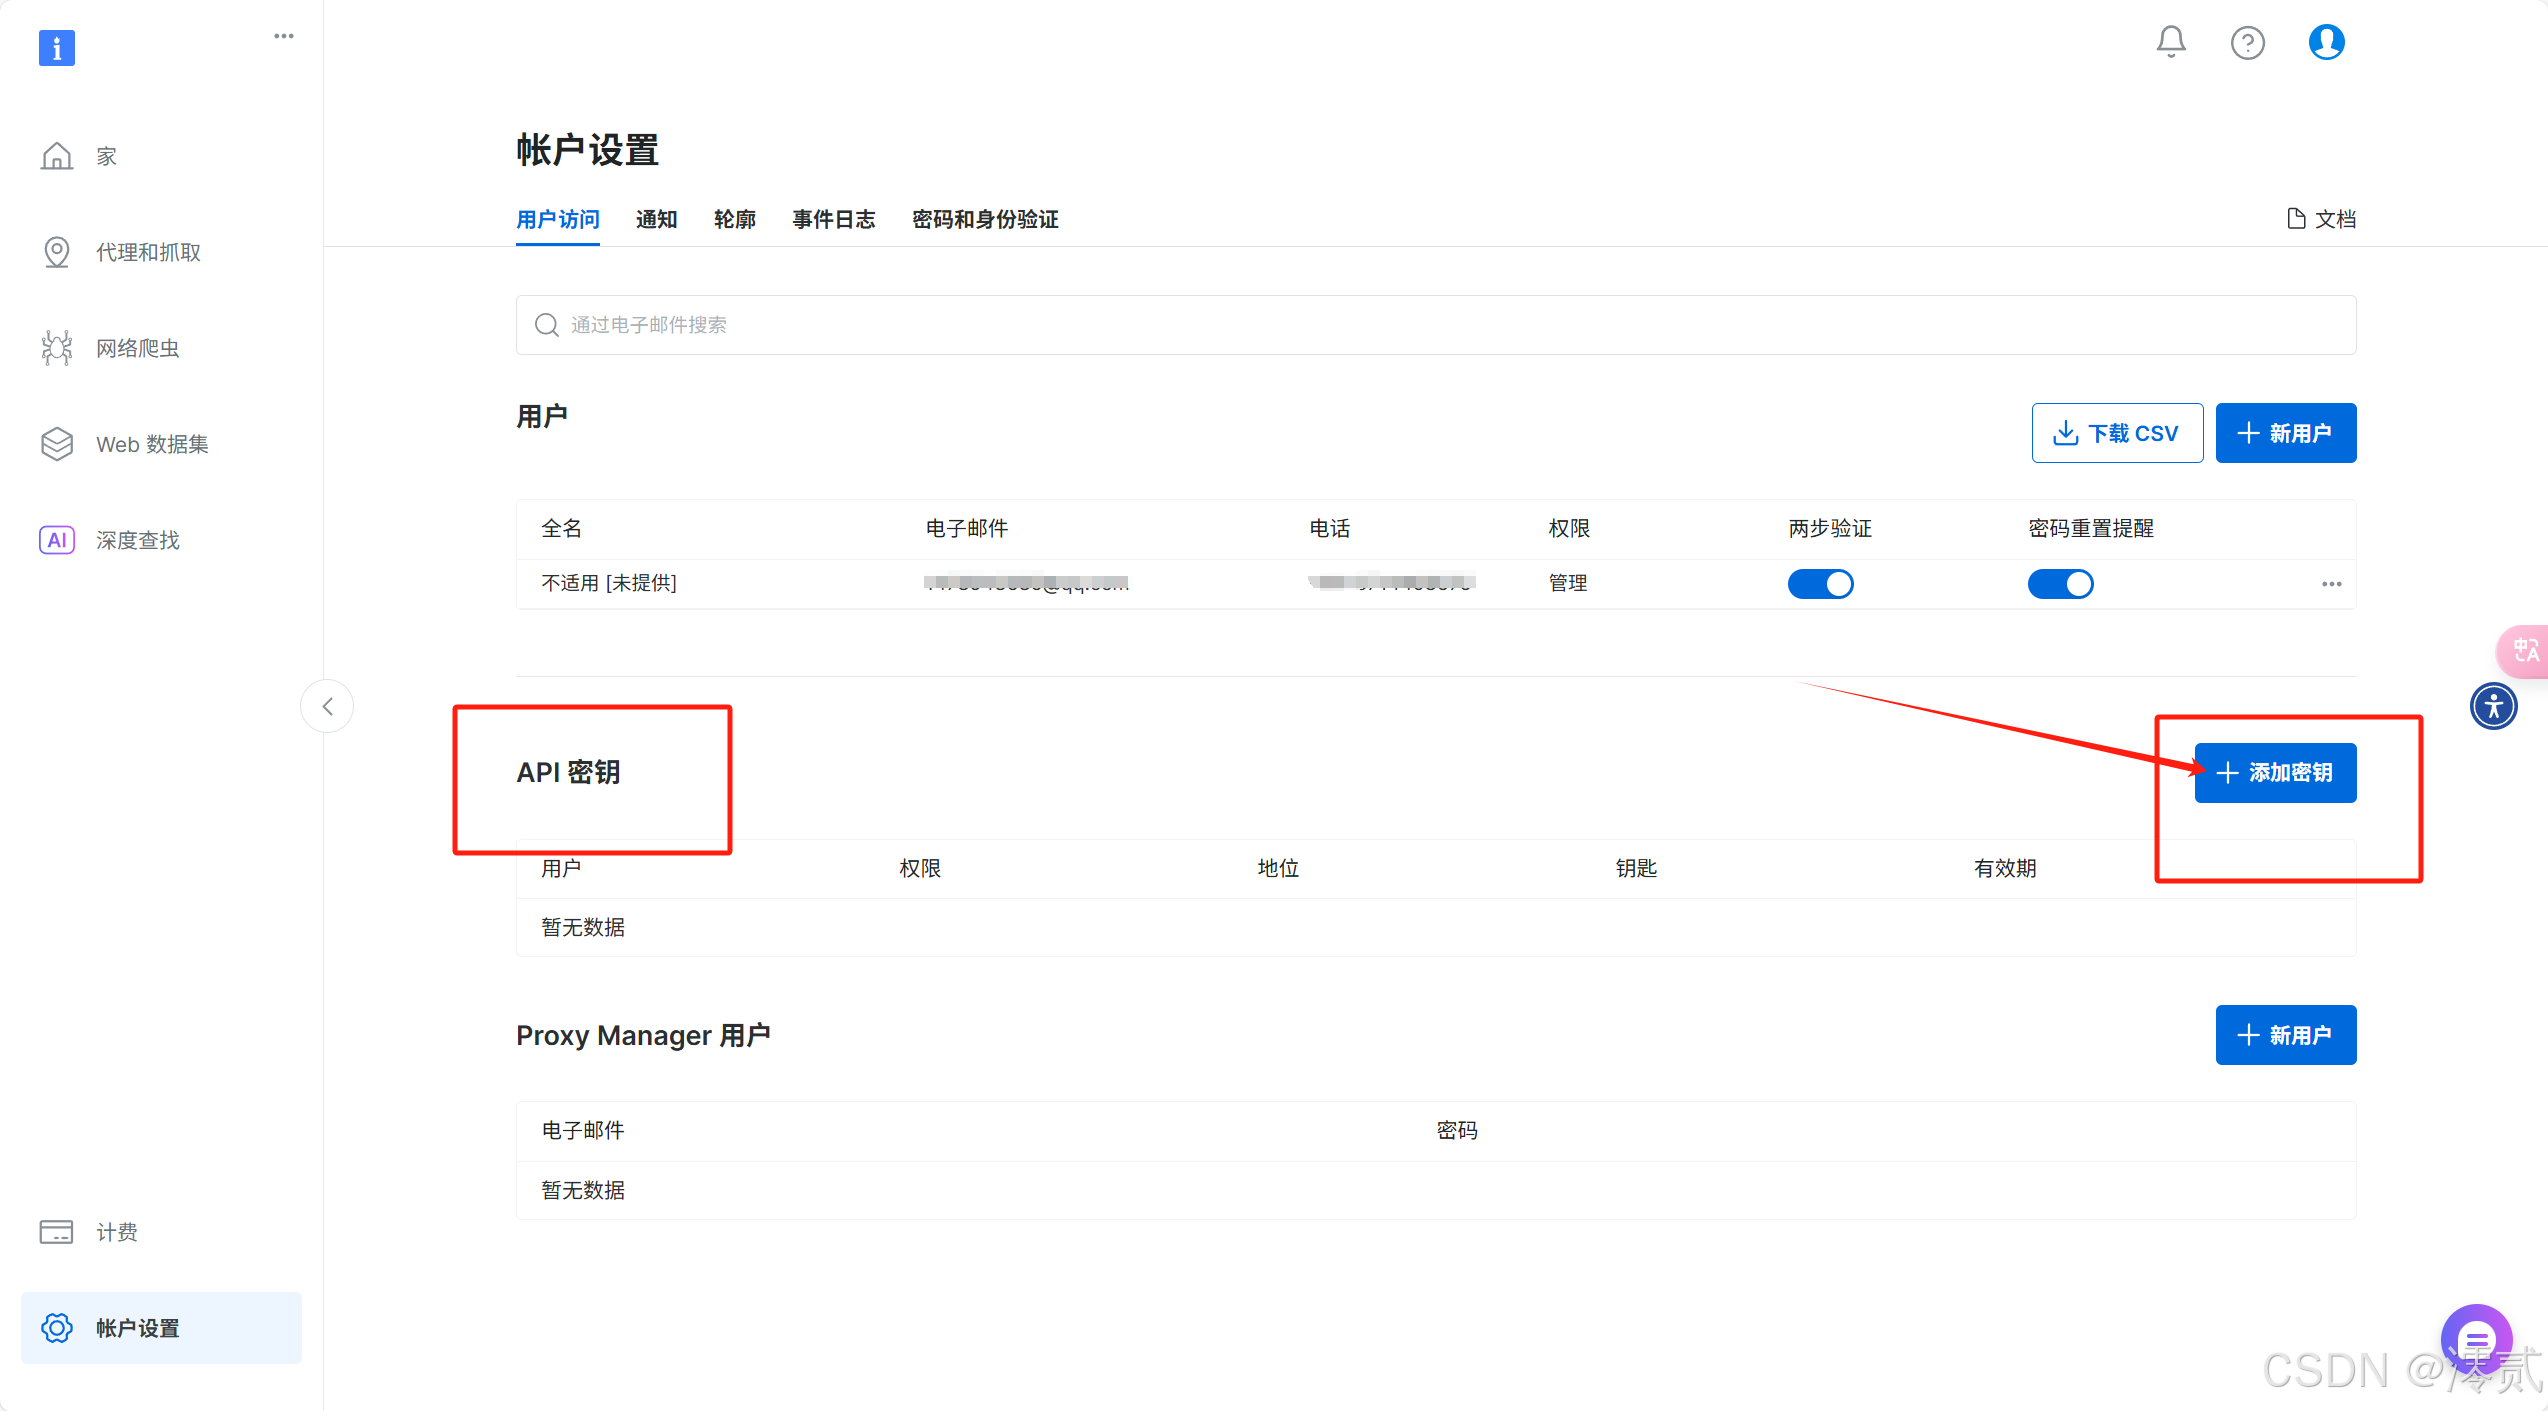
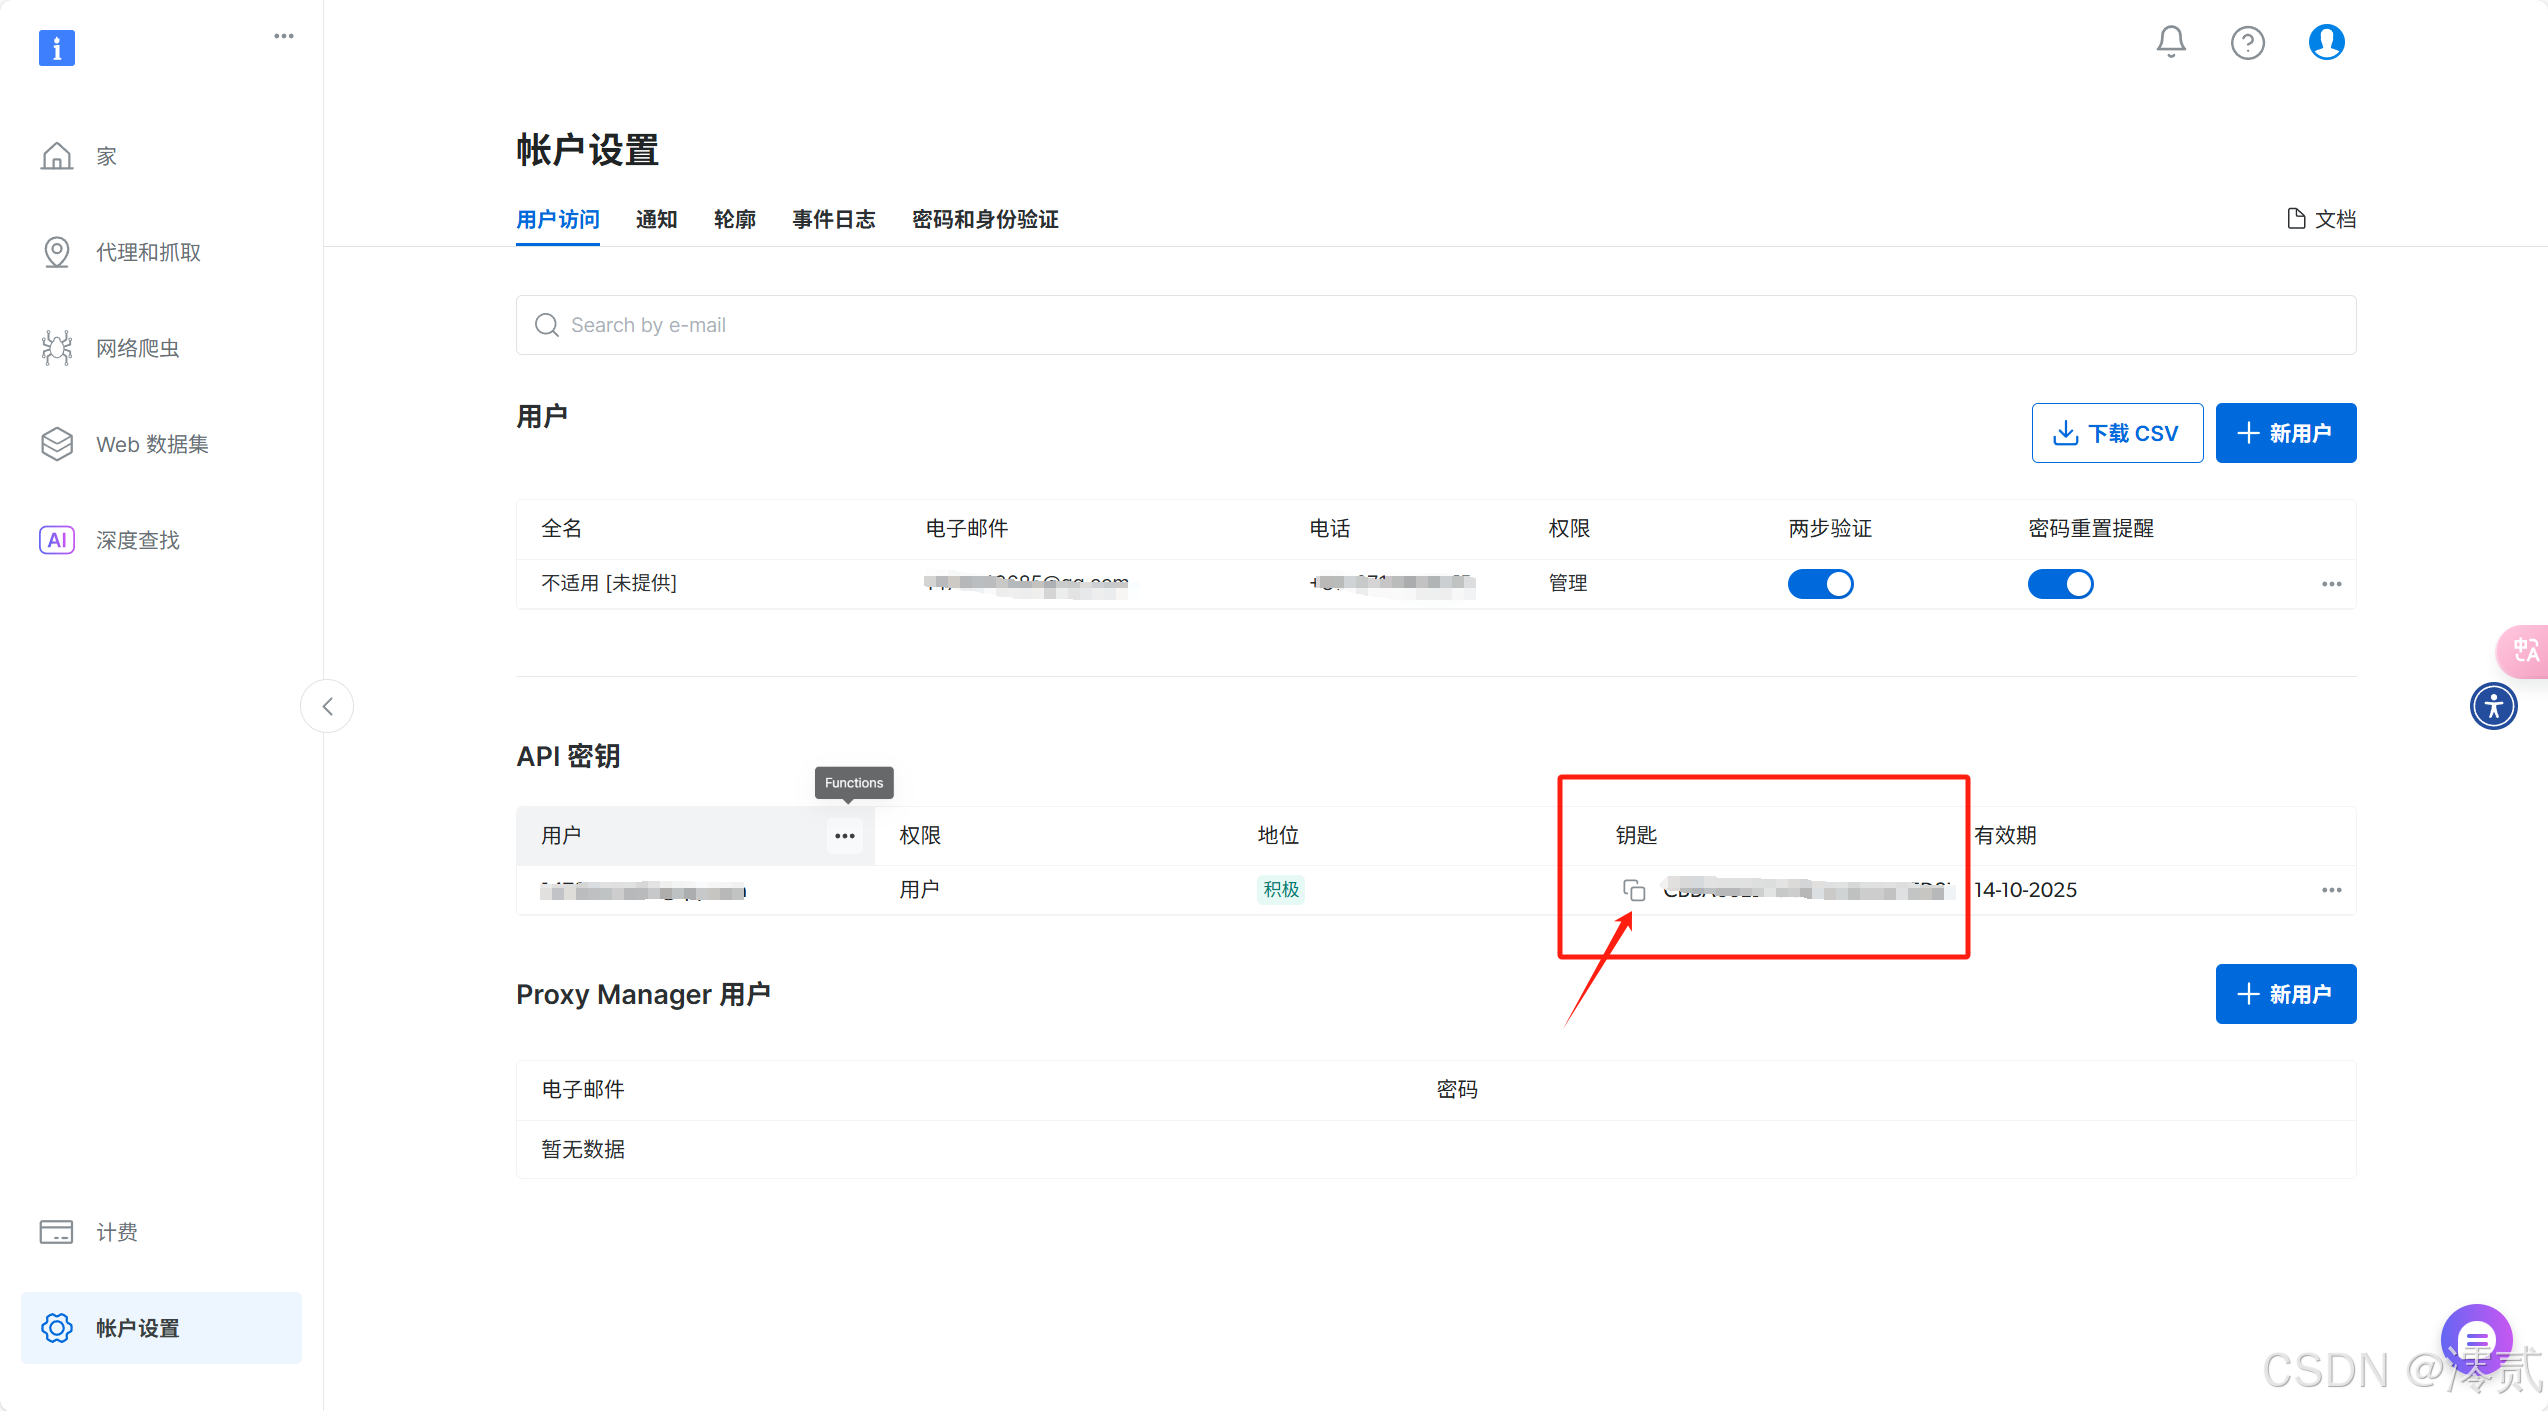
在这里插入图片描述

API密钥获取

点击链接进入 API 密钥获取界面,可能会弹出让你再次登录的界面,登陆即可

单击 API 密钥部分右上角的添加 API 密钥按钮
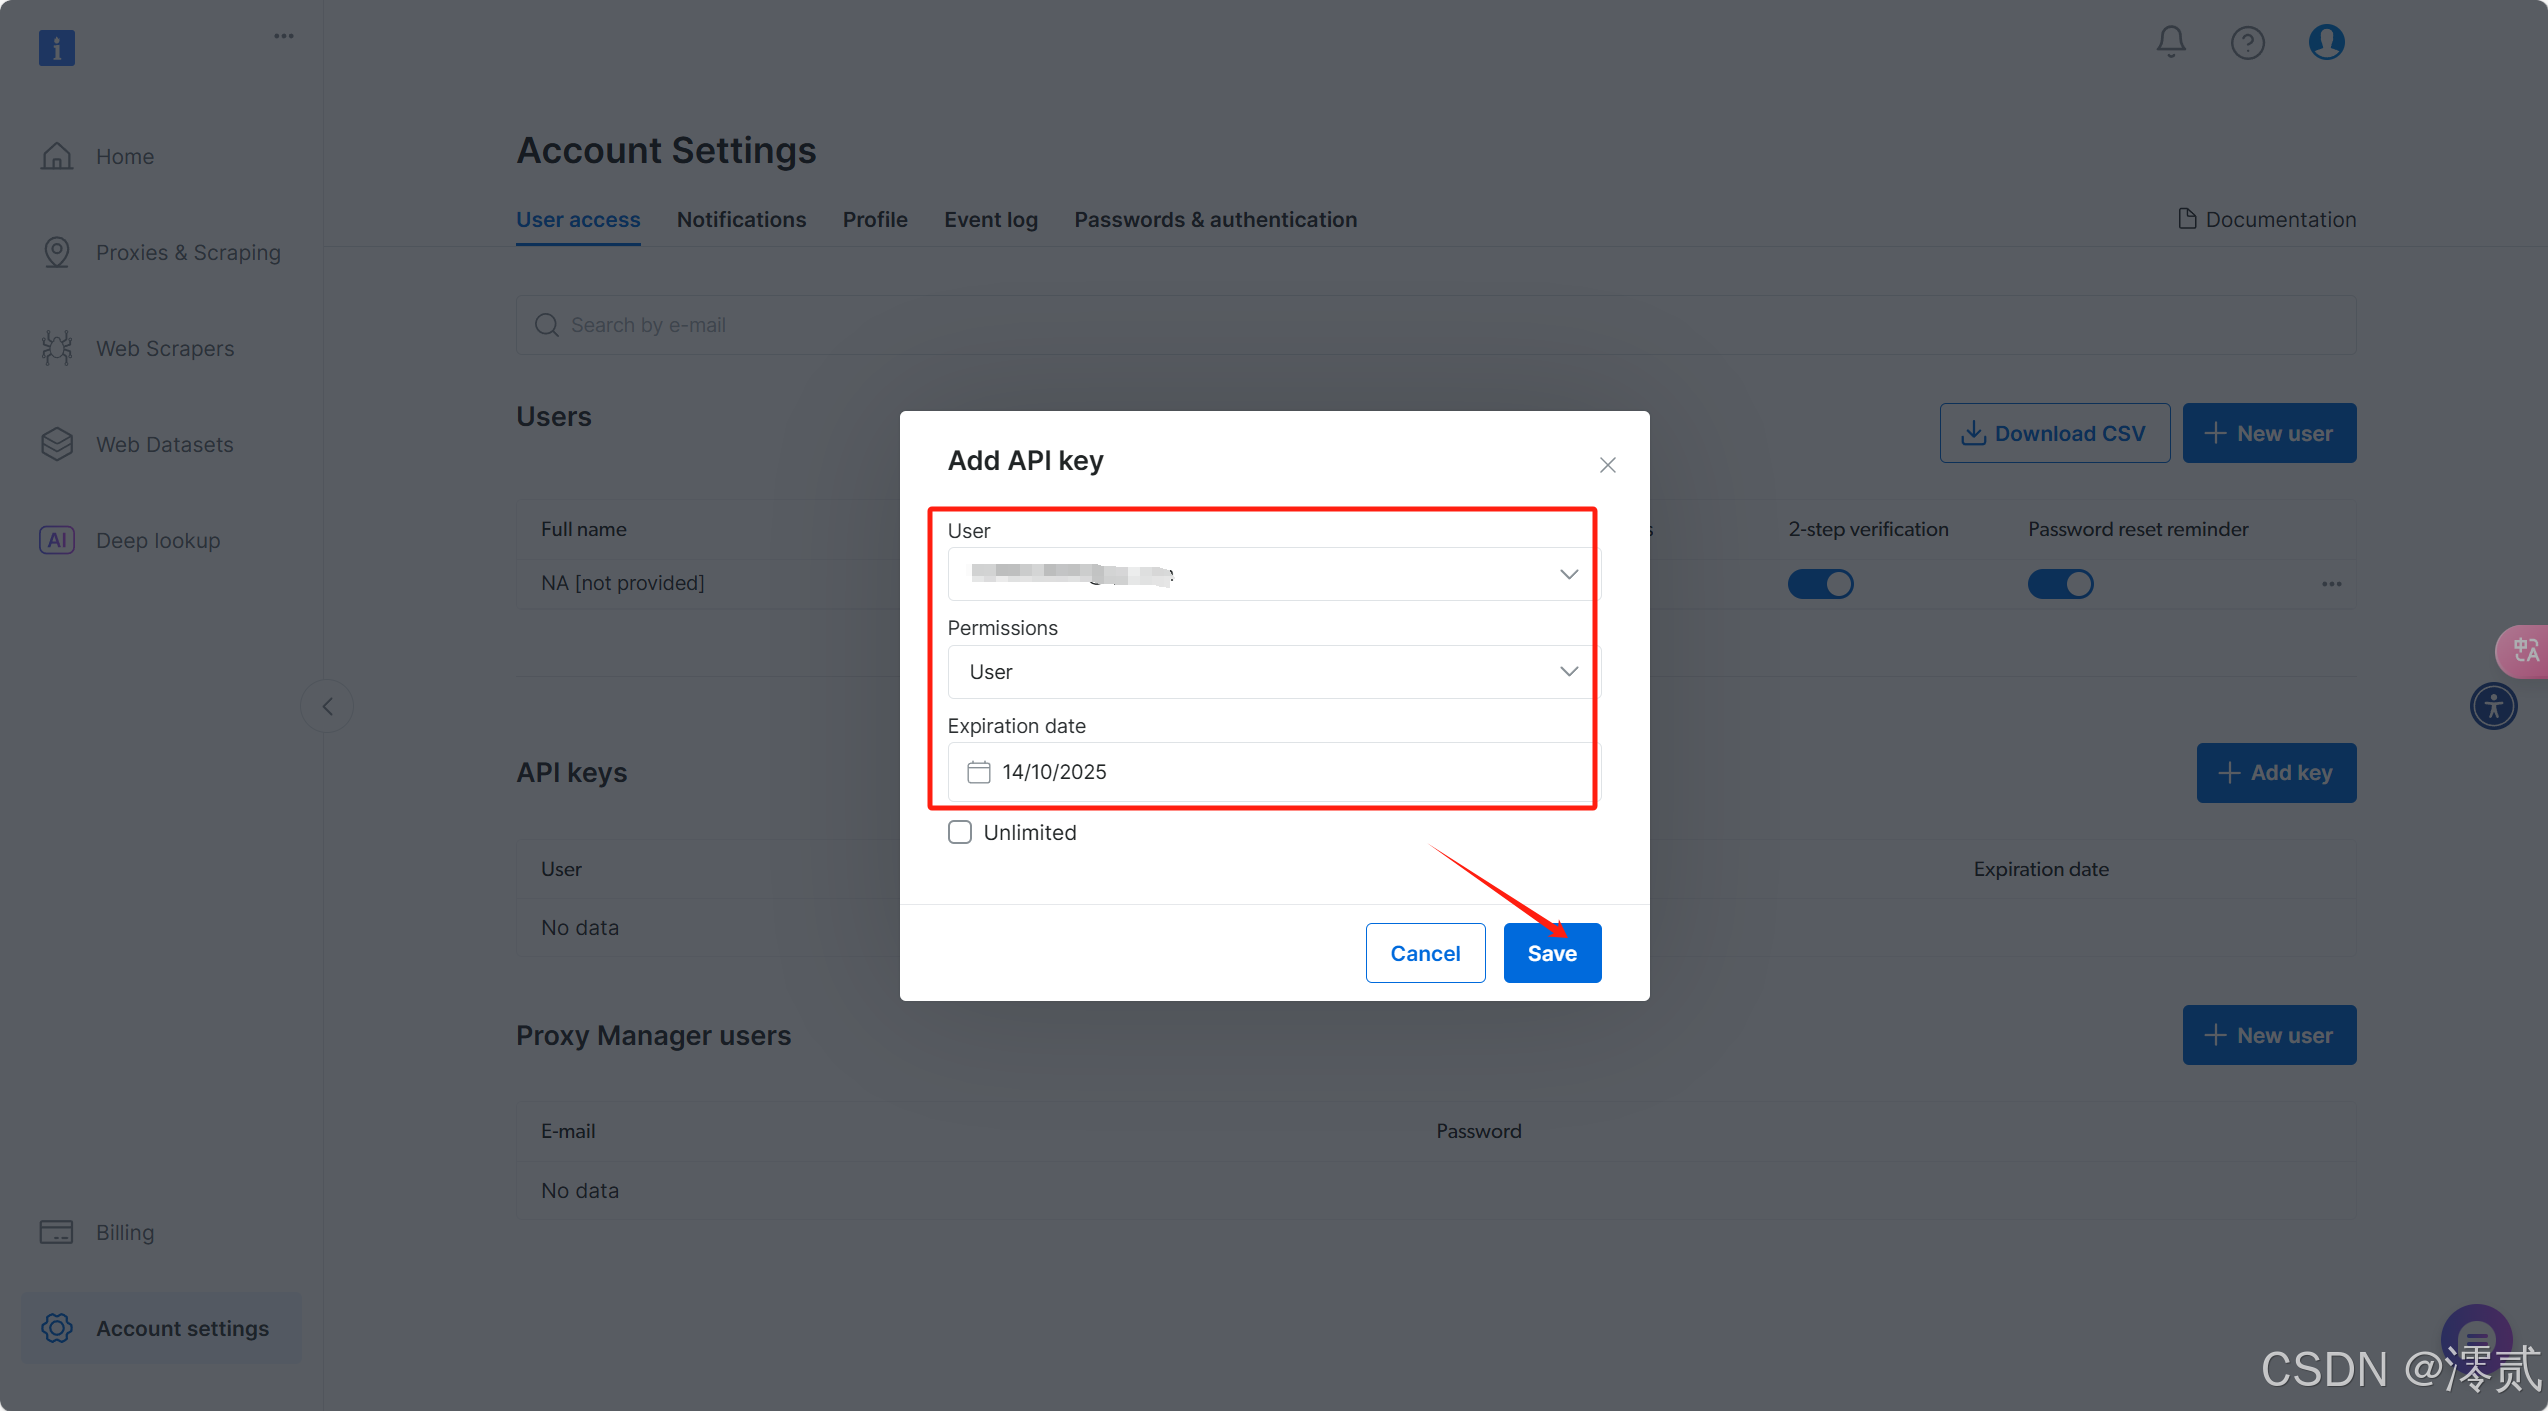
在这里插入图片描述

配置您的用户、权限和 API 密钥到期日期(或“无限制”),然后单击保存

在这里插入图片描述
然后就会的得到 API 密钥,将其复制下来保存好,后面会用到

🔥注意: 生成 API 密钥后,确保将其保存到本地安全位置,因为它只会显示一次!

3.2 选择目标站点
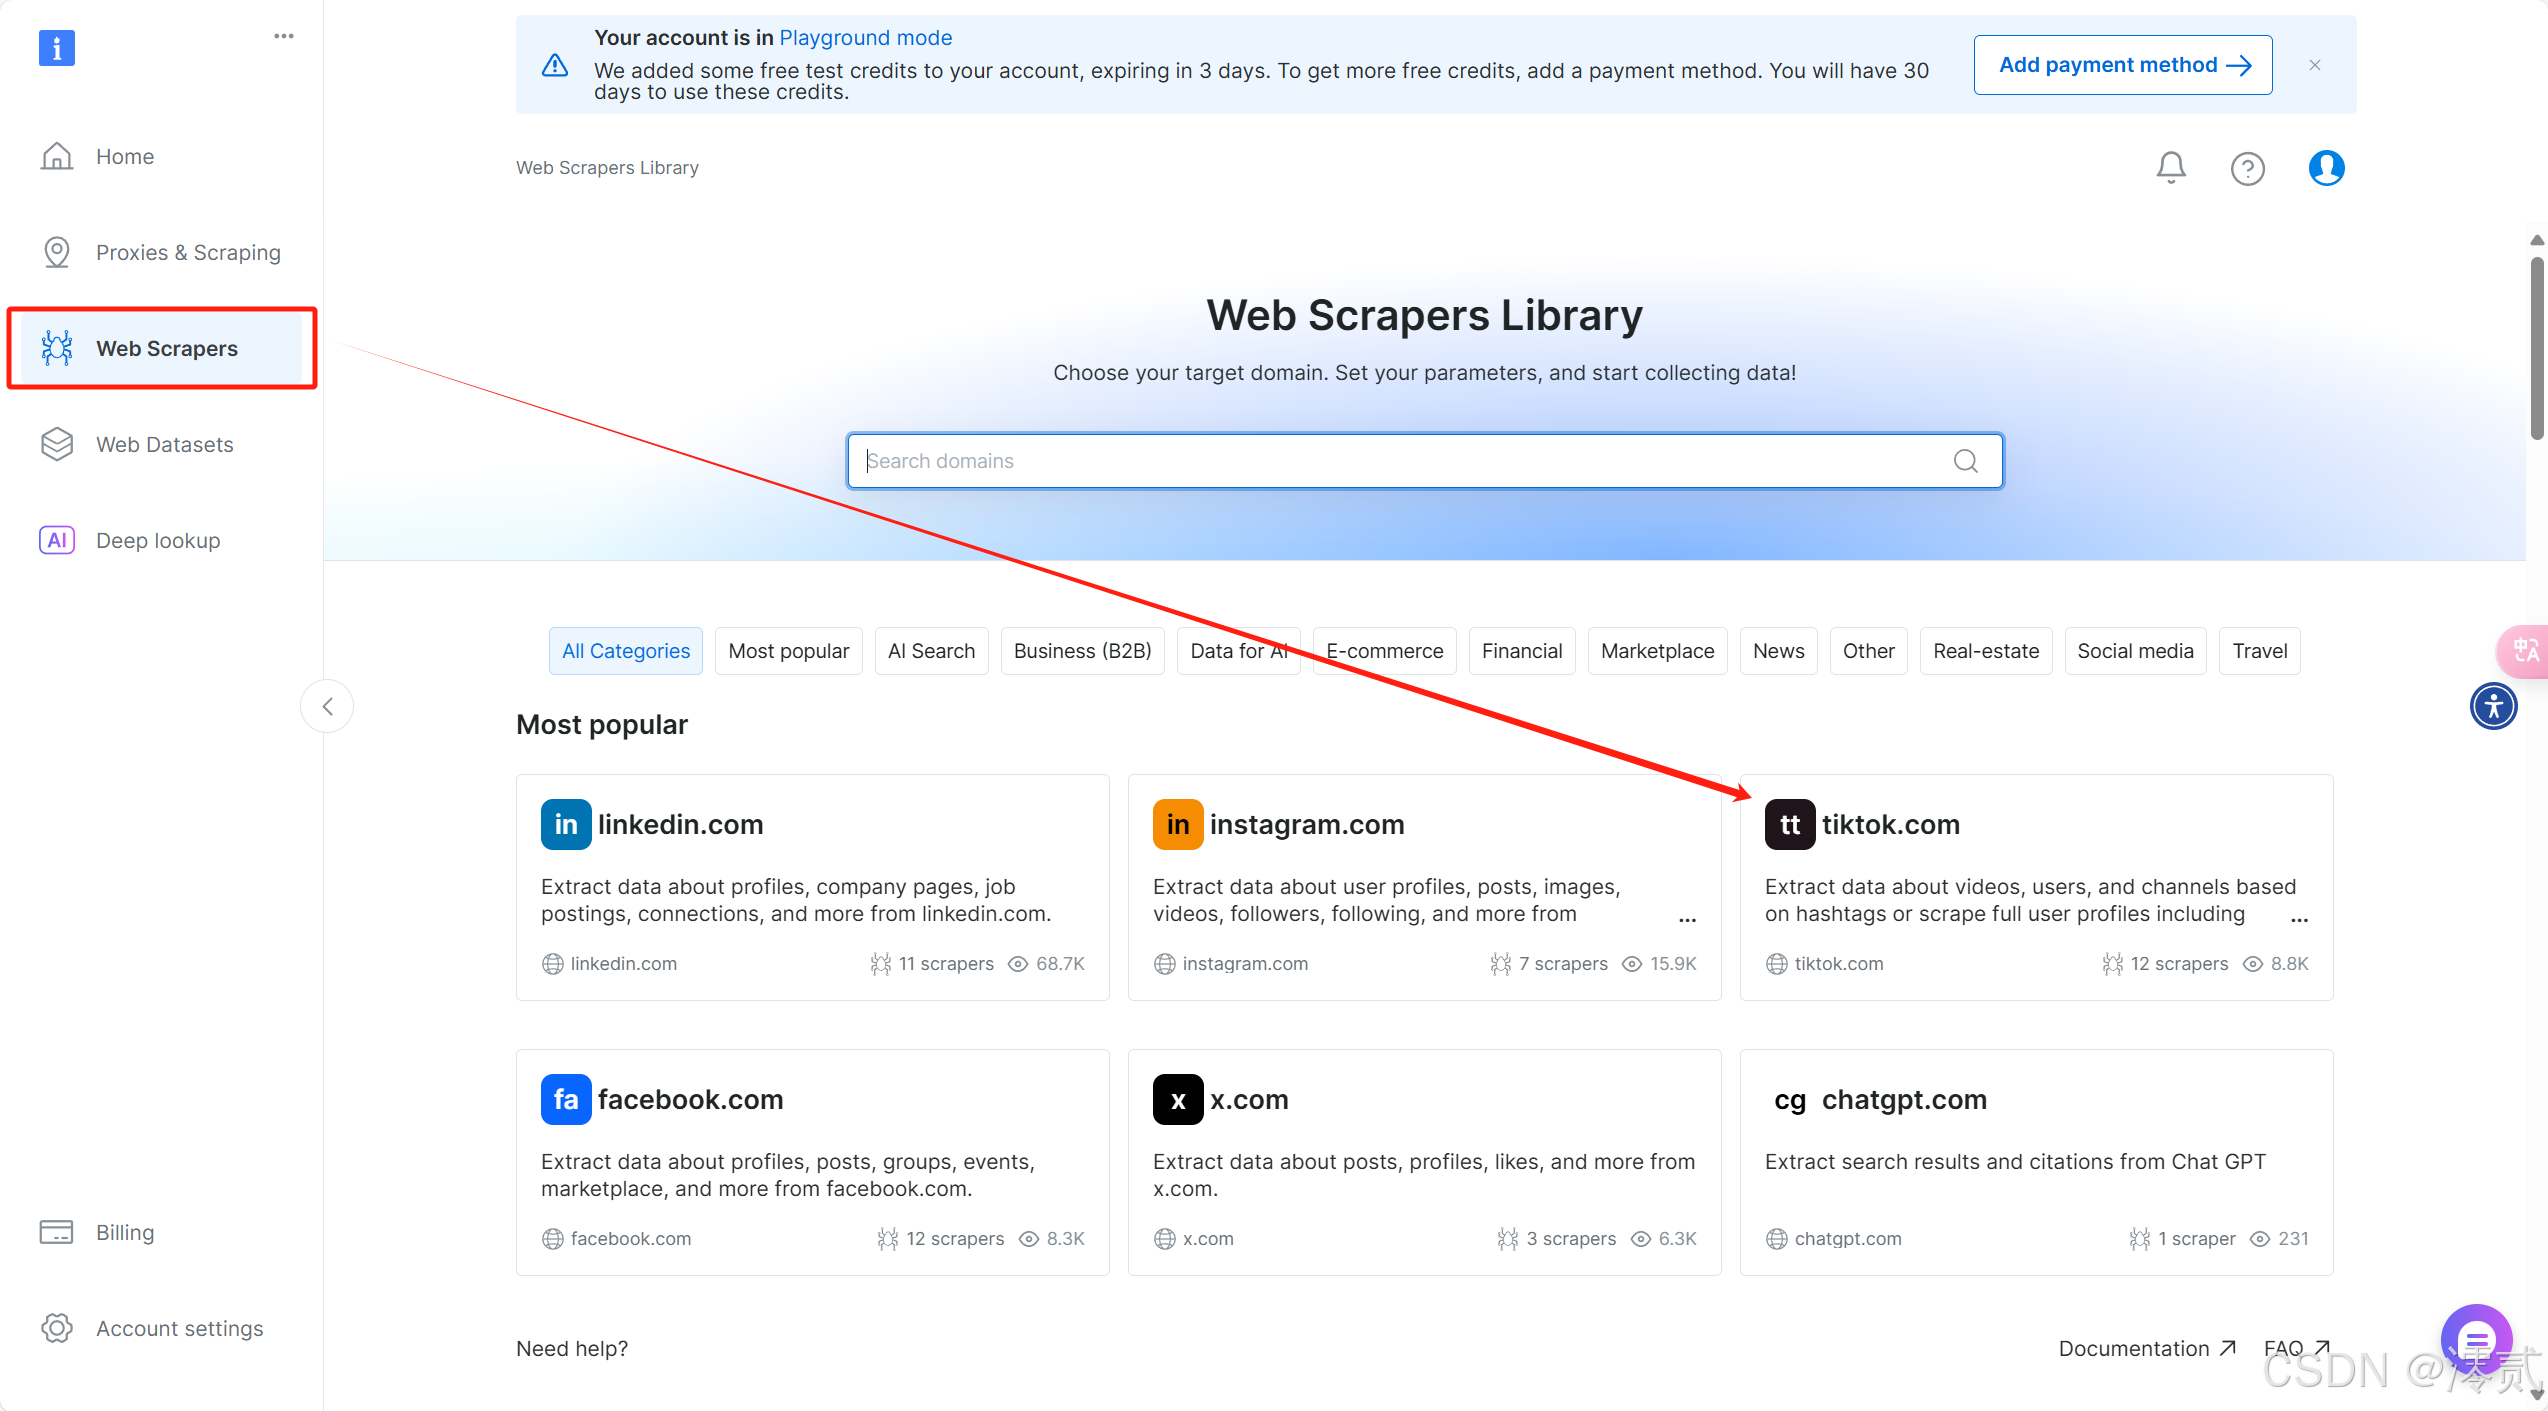
在这里插入图片描述

传送门:Scraper库

点击链接转到 Scraper 库,点击 Web Scrapers ,进入数据采集集市,在这里你能看到各种网站的 API 数据采集器,选取符合你需求的站点,后面就以 Tiktok 为例讲下采集器的使用
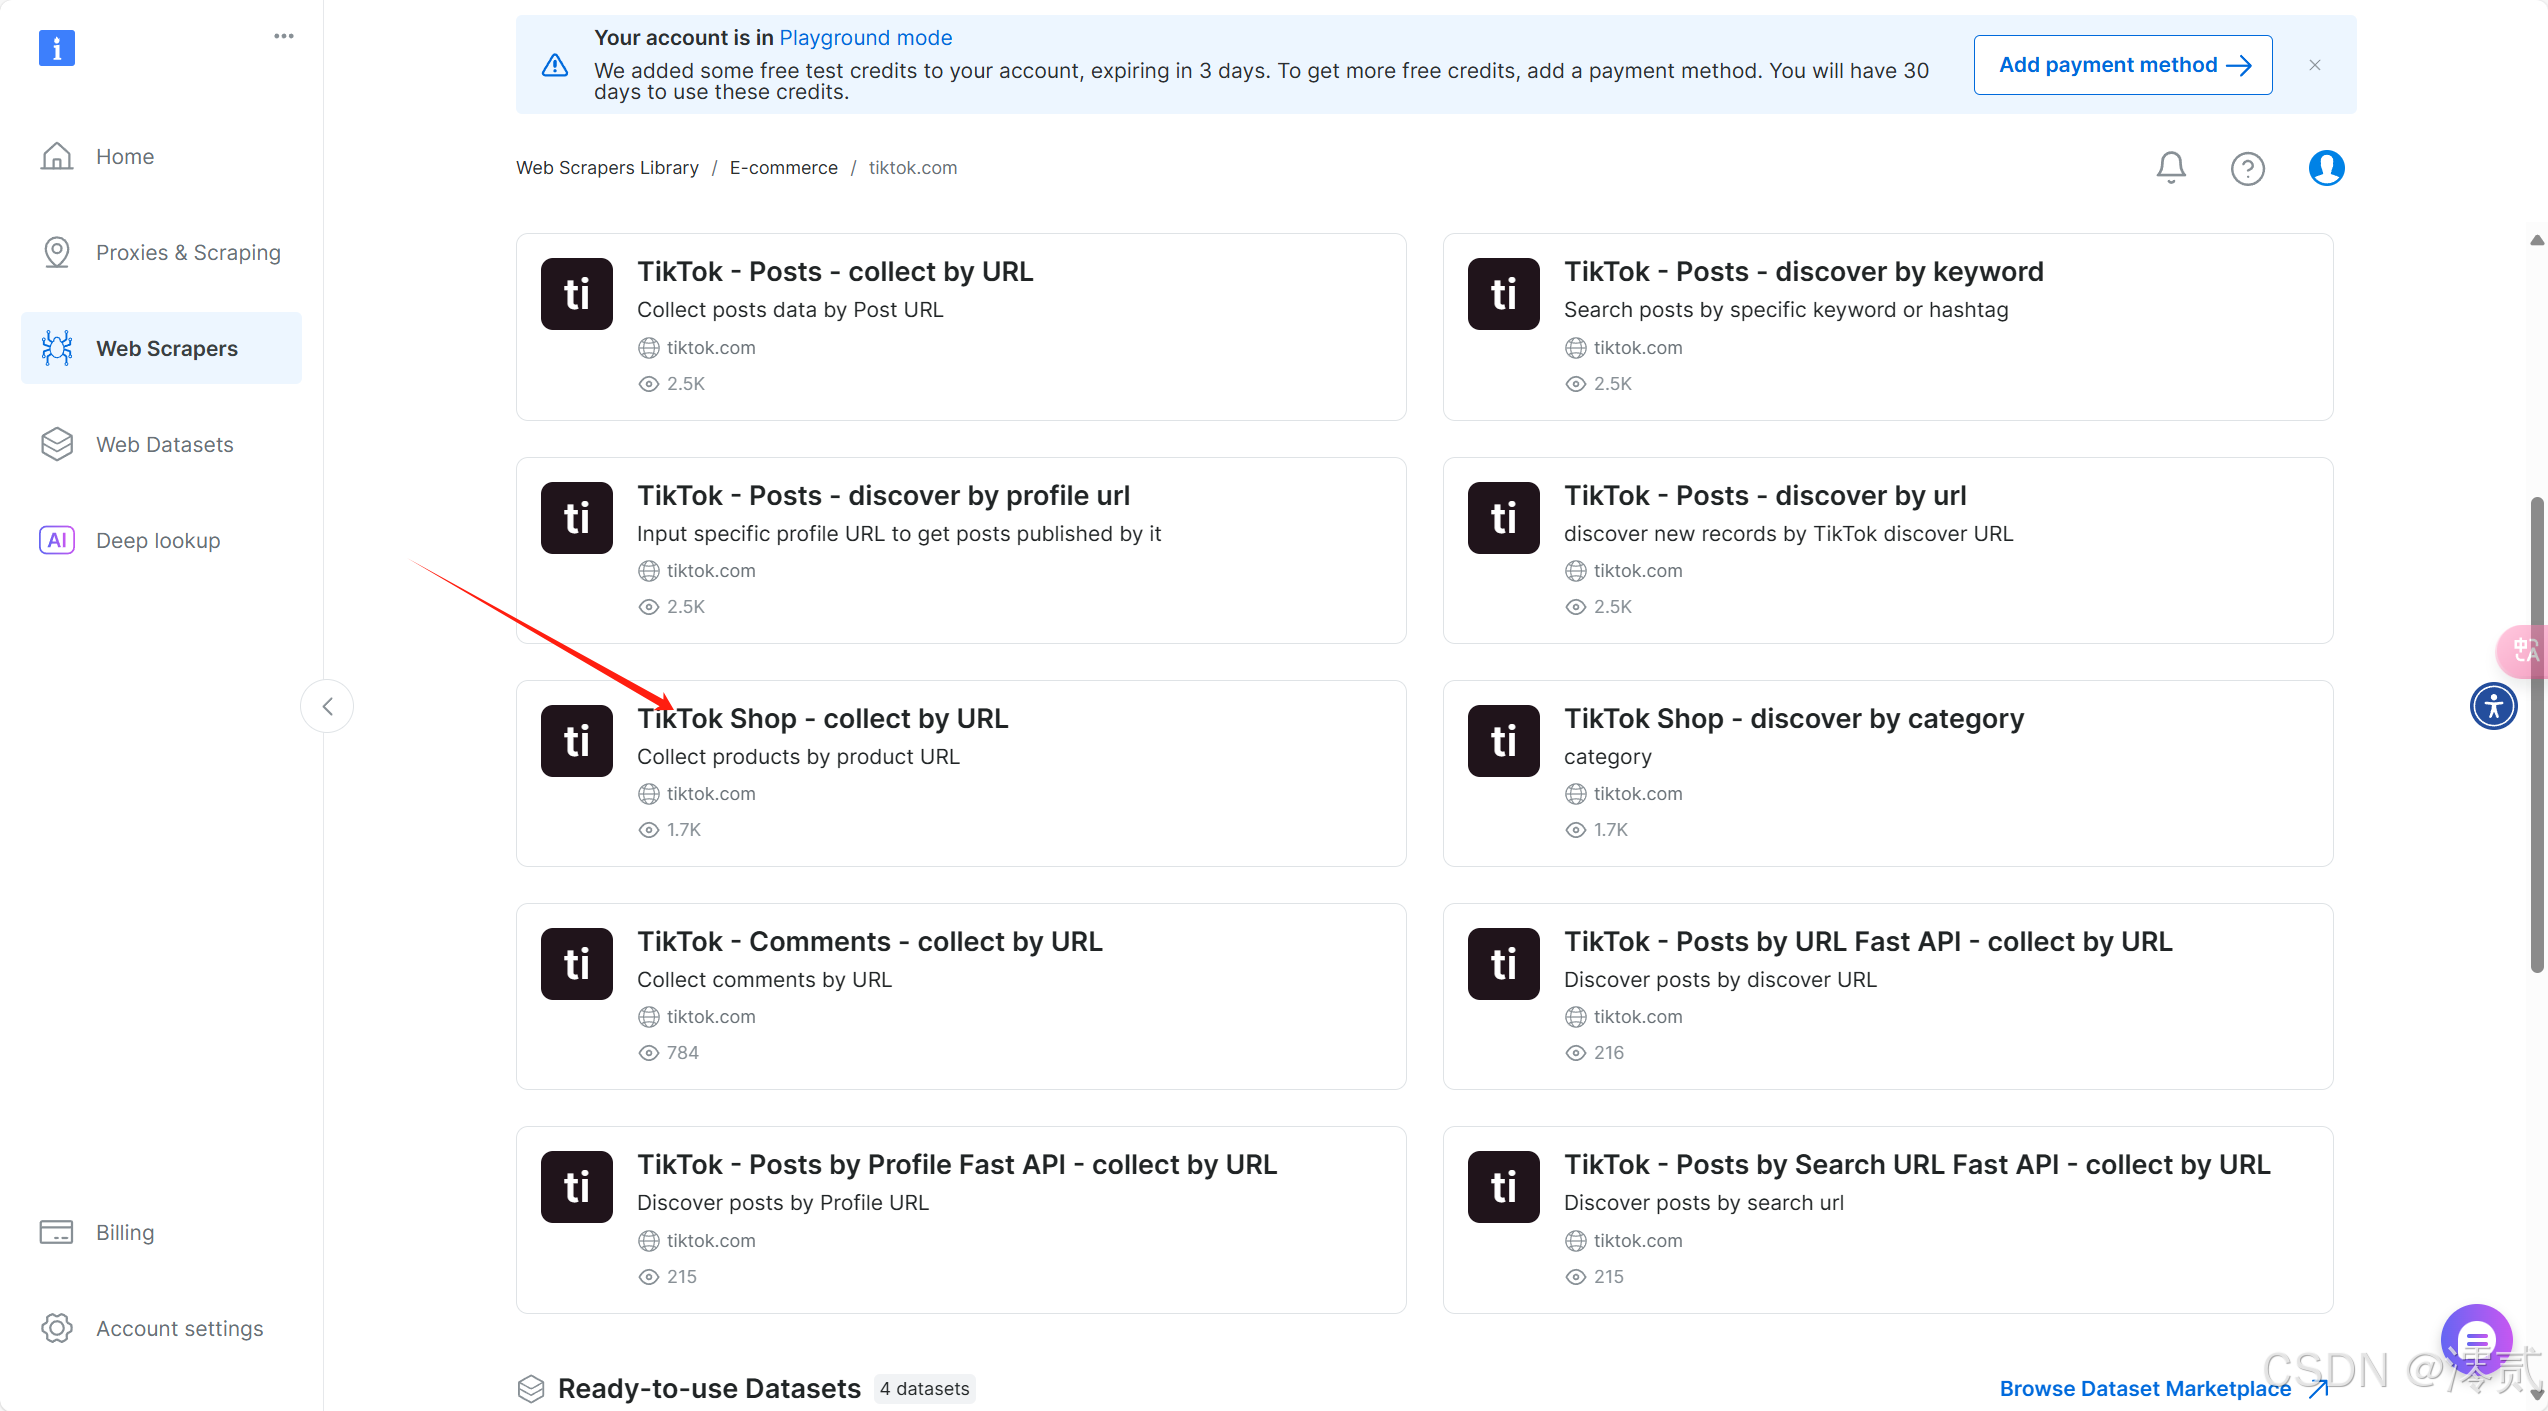
在这里插入图片描述

进去之后,会看到很多关于 Tiktok 数据的收集,比如帖子收集,商品数据收集,还可以分为 网址(URL)收集 或 关键字收集,这里我们以 Tiktok Shop - collect by URL 为例

在这里插入图片描述

然后选择 Scraper API 收集,点击下一步

3.3 配置数据收集相关
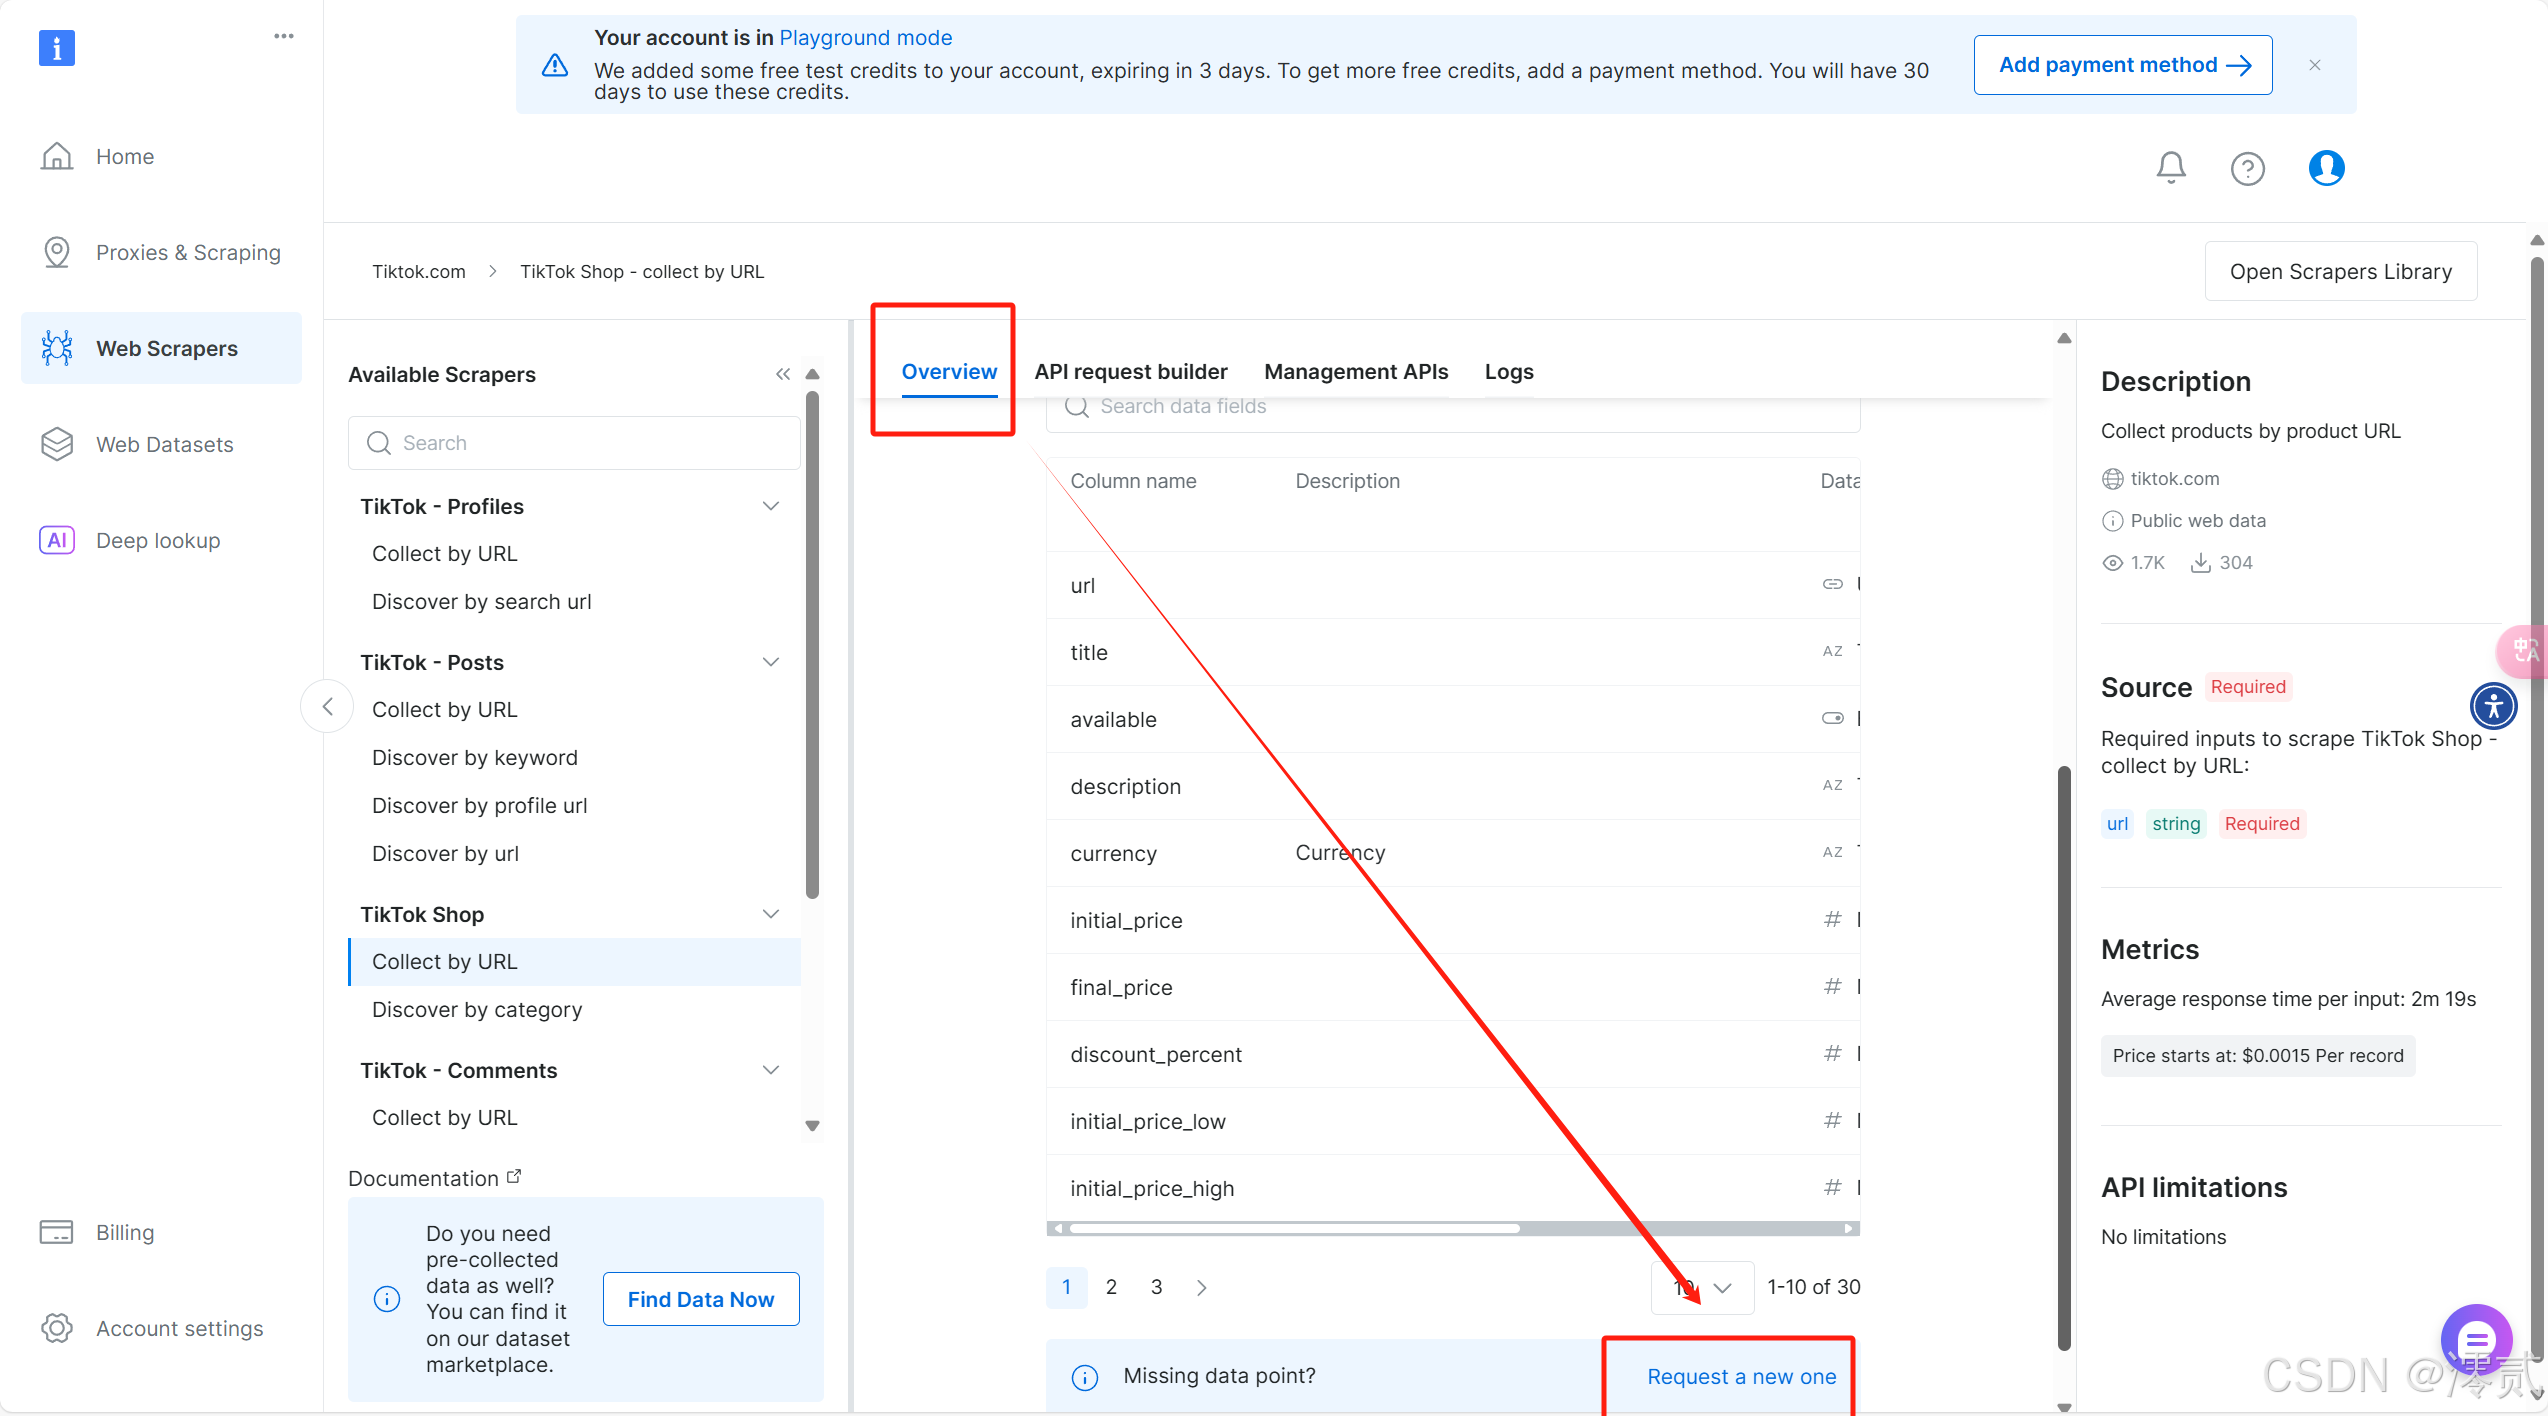
在这里插入图片描述

在 Overview 部分划到最下面的 Dictionary,可以查看商品数据收集的相关信息,如果还有想要添加的可以点击下面的 Request a new one
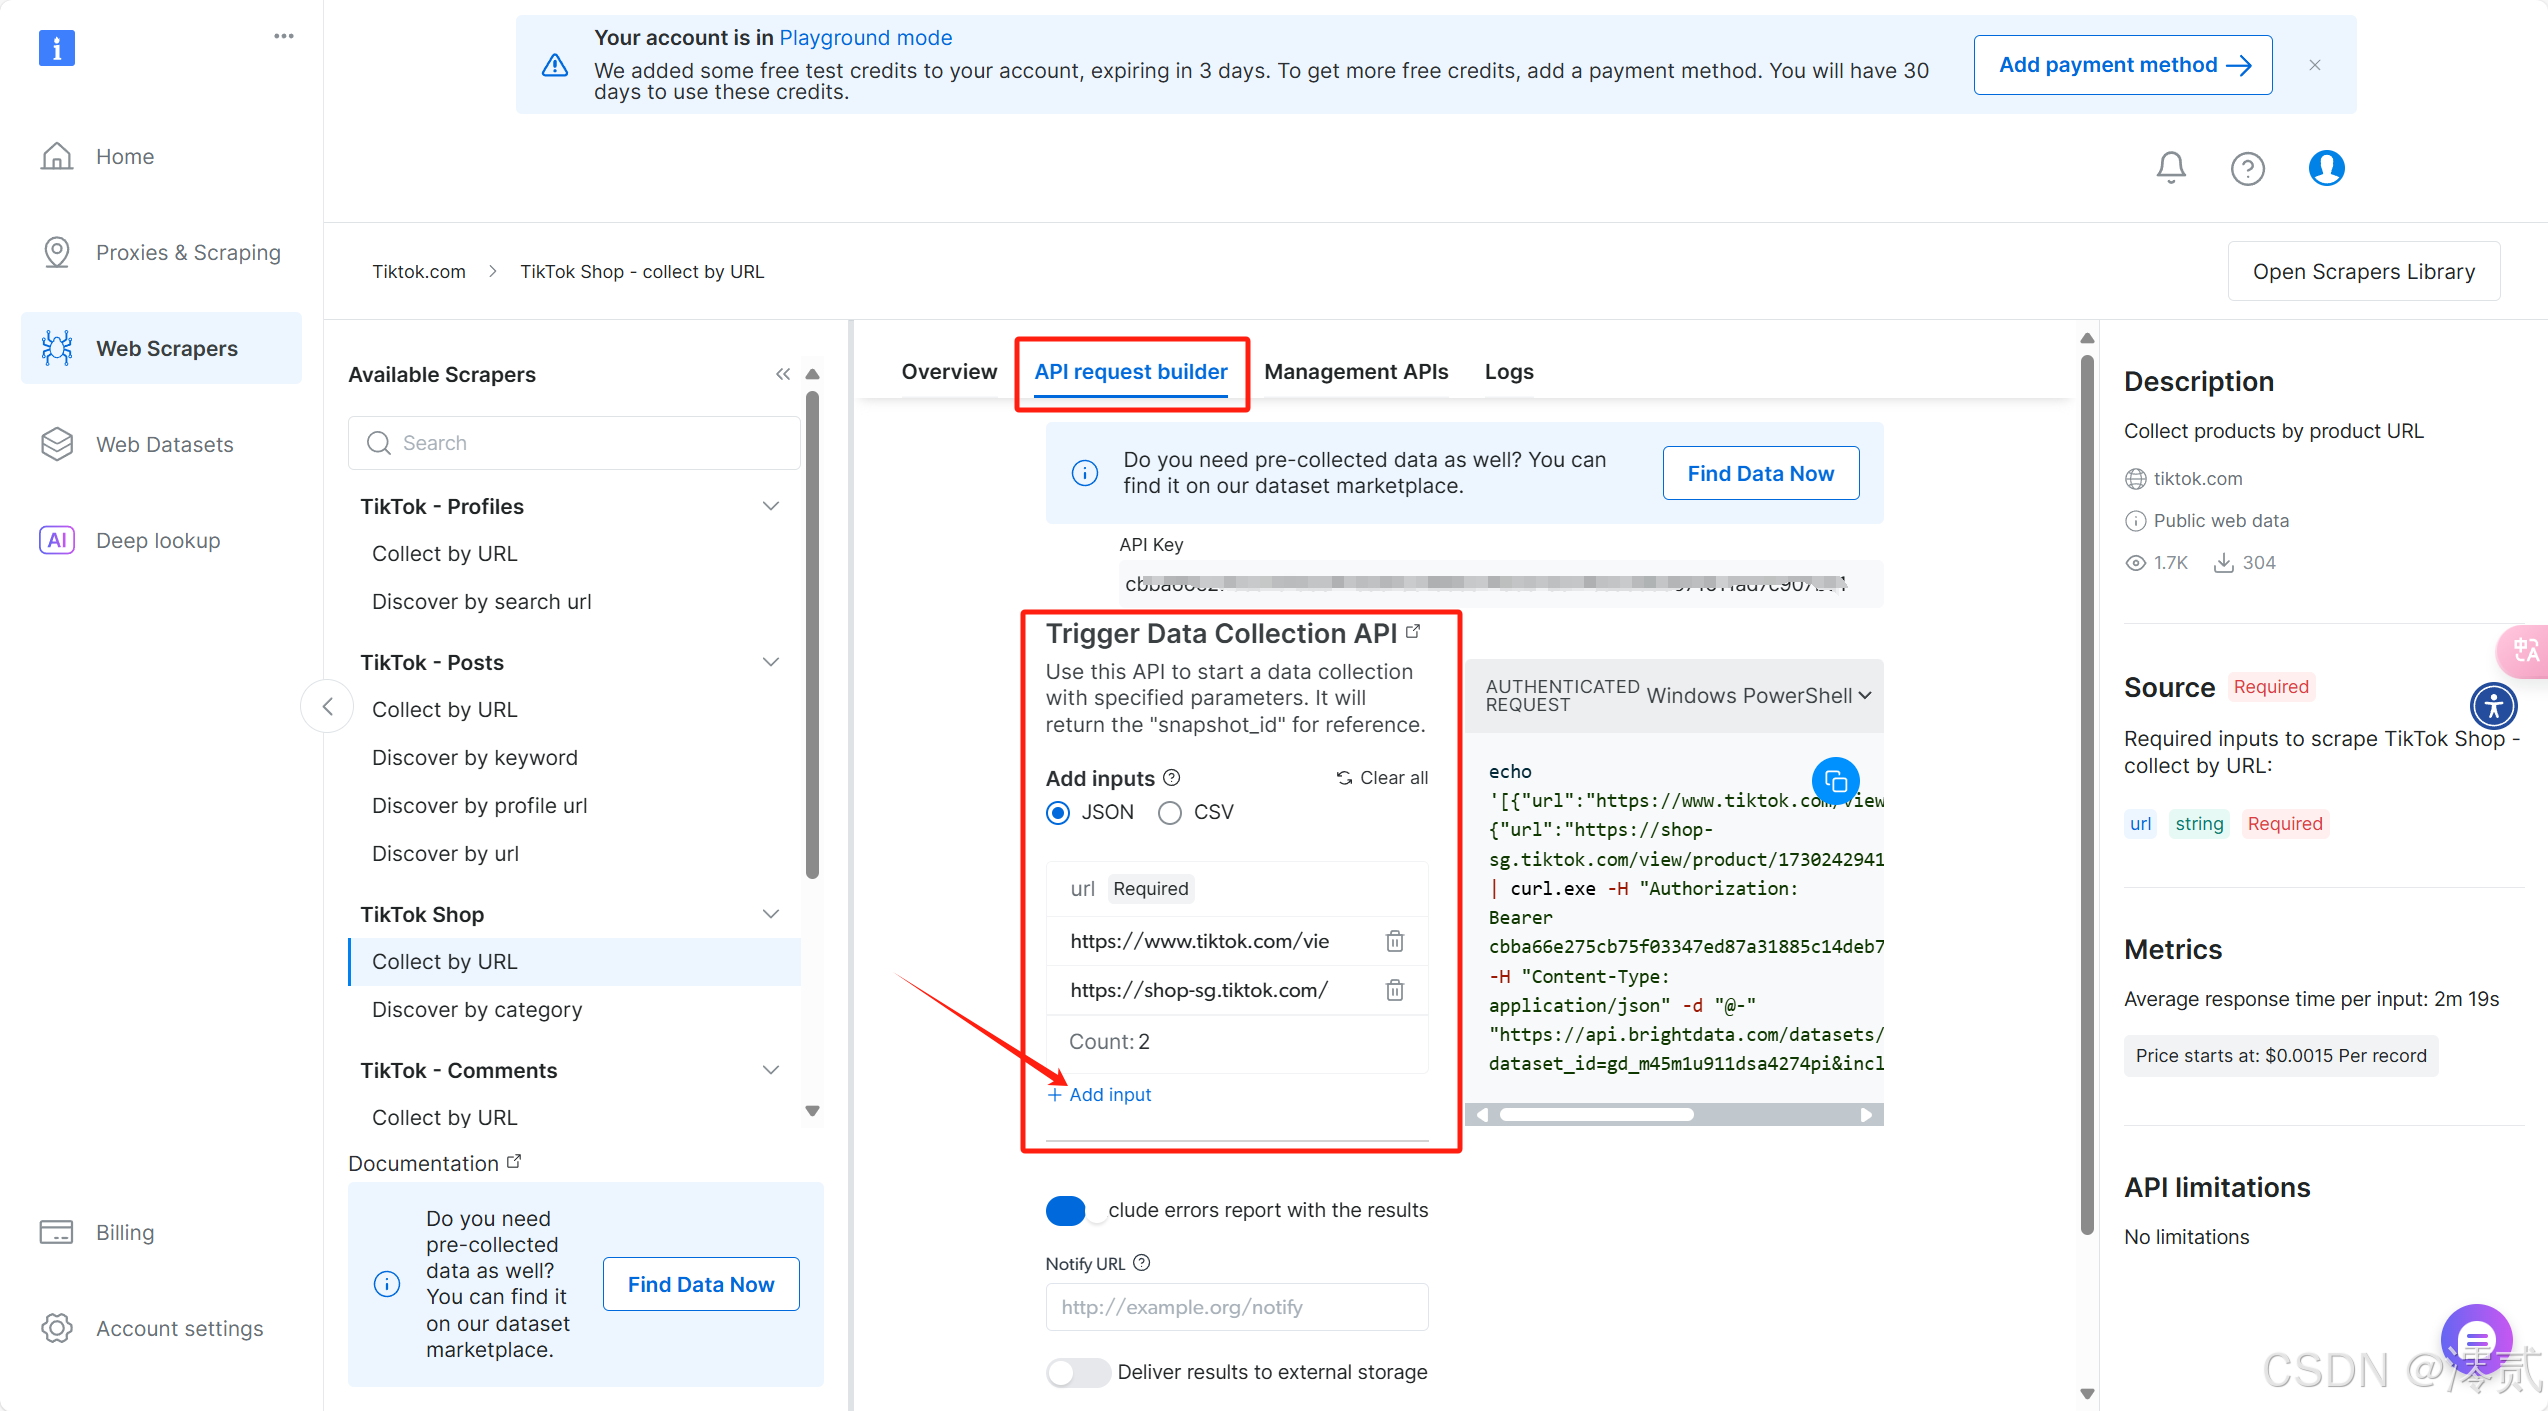
在这里插入图片描述
点击 API request builder 部分,在 Trigger Data Collection API 这里添加你想收集数据的 Tiktok 商品网页,注意是有数量限制的,具体以实际为准
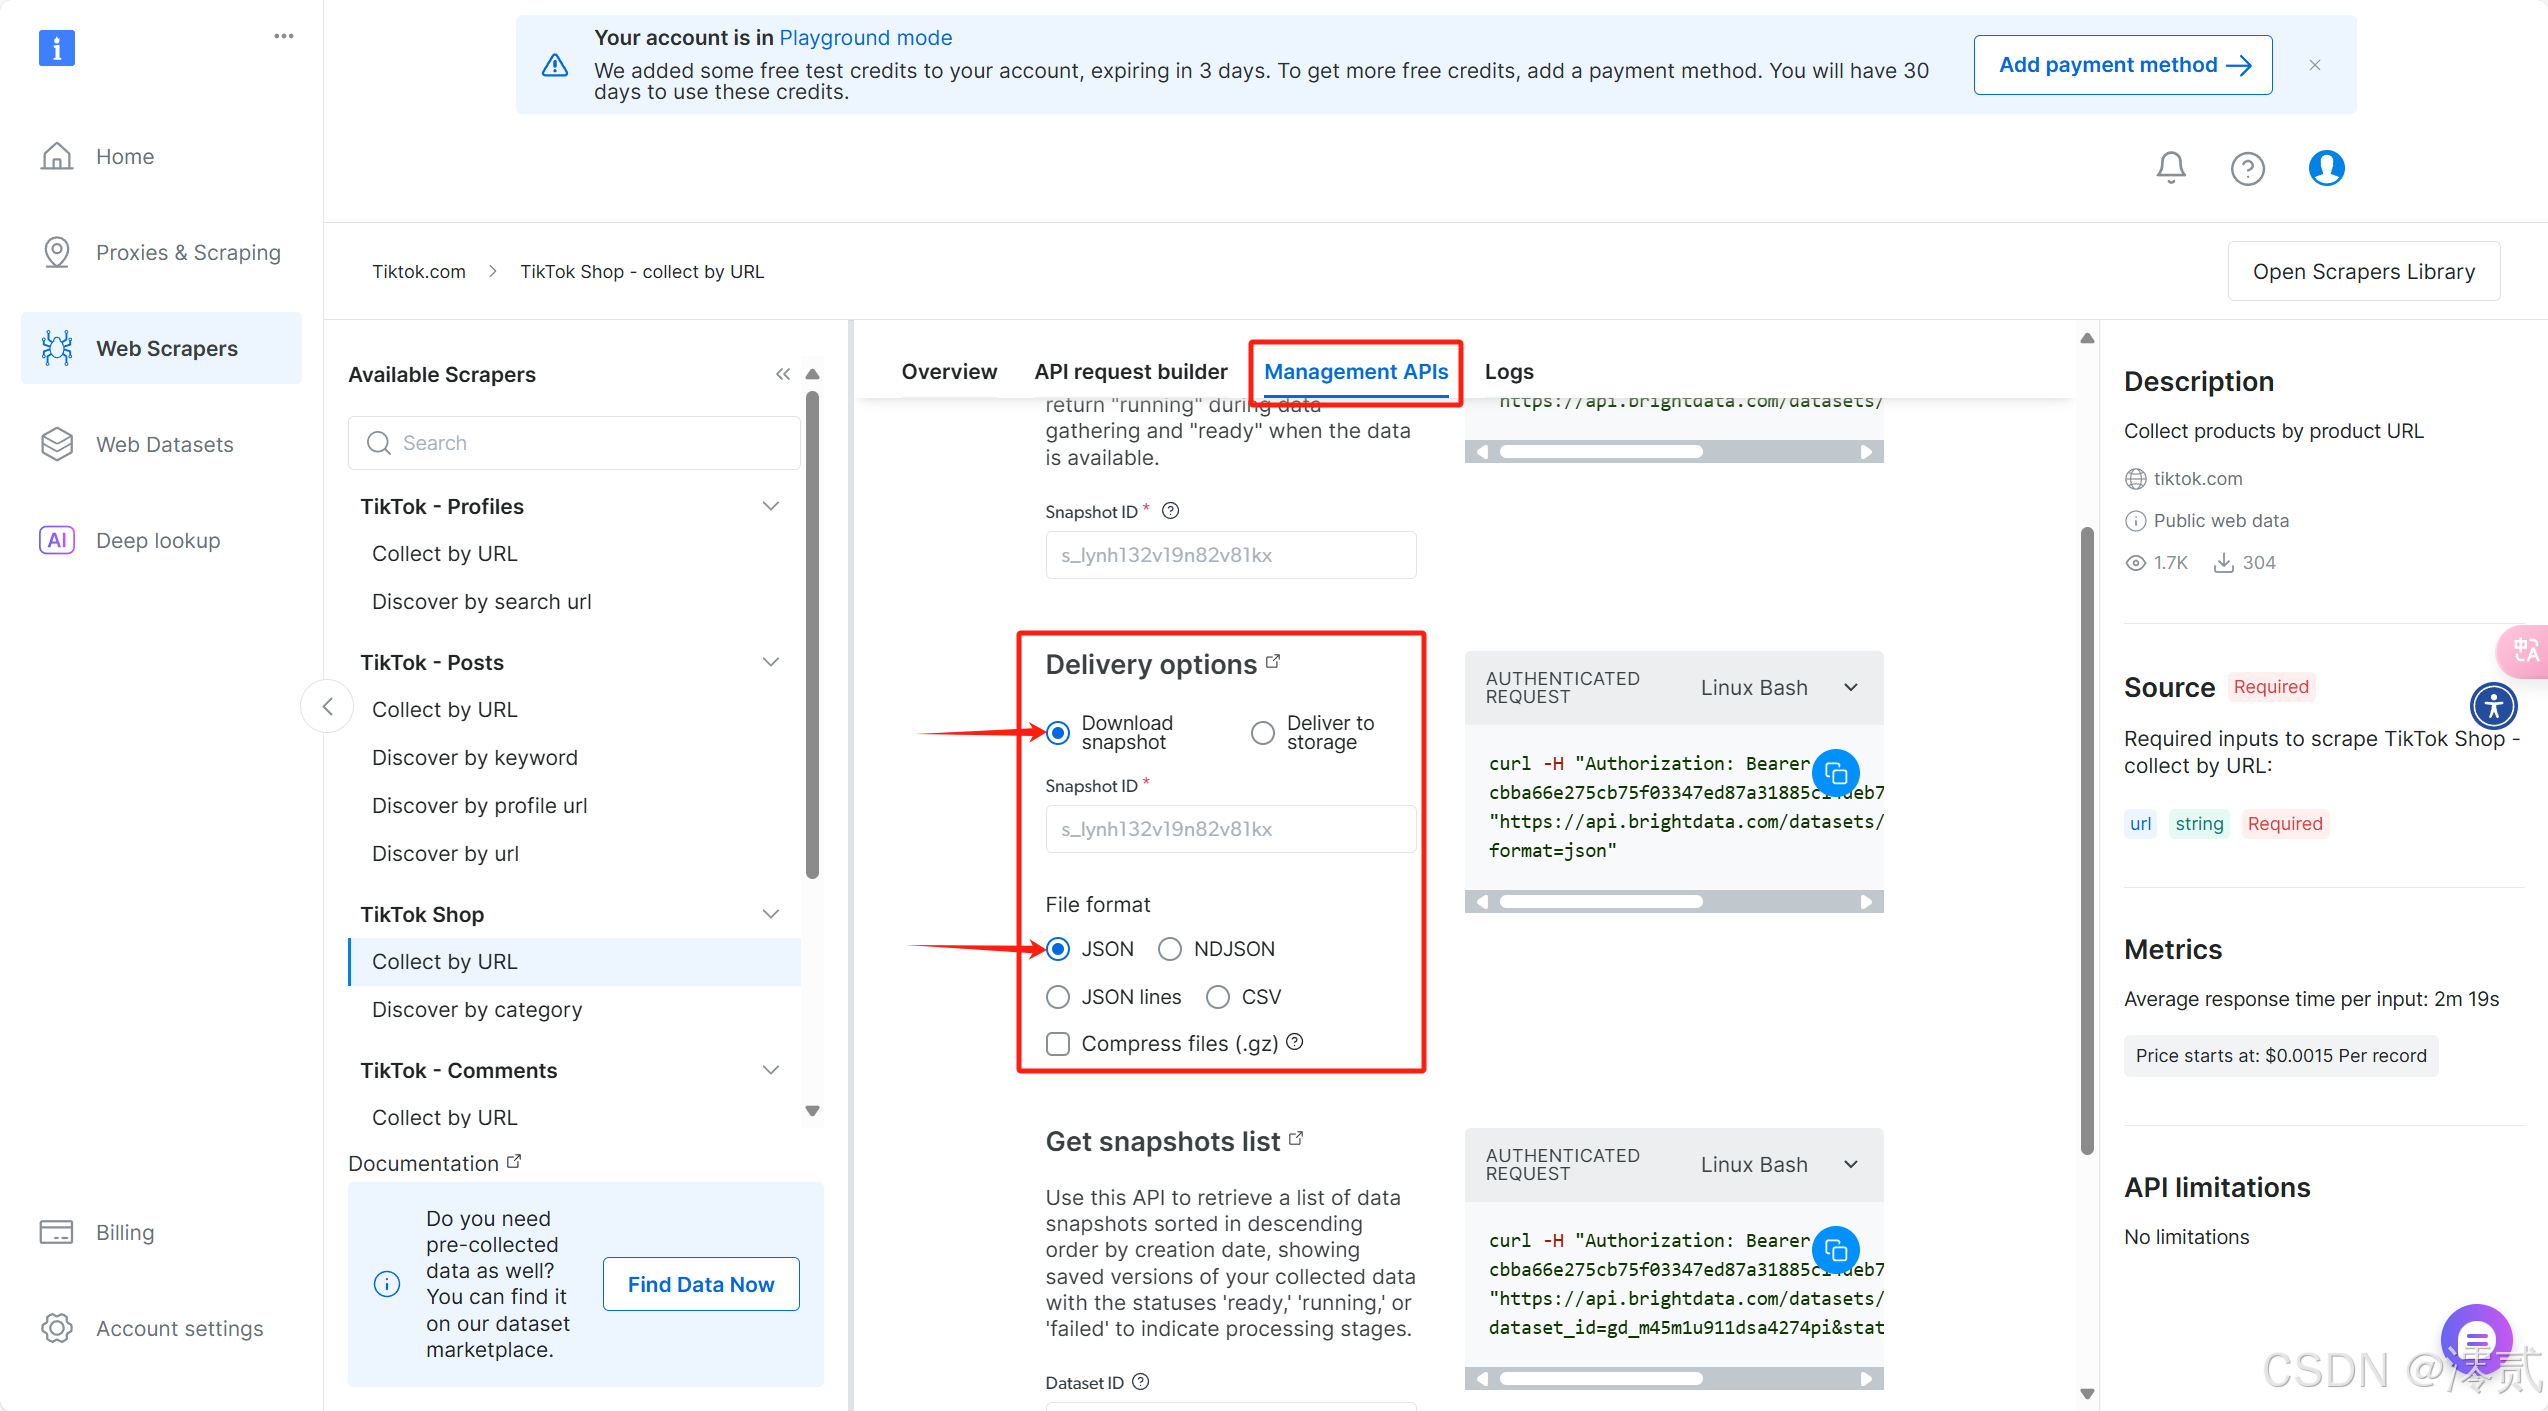
在这里插入图片描述
点击 Management APIs 部分,在 Delivery options 进行配送选项的配置

  • Download snapshot:数据临时存储下载
  • Deliver to storage:发送到阿里,谷歌的等云存储

文件格式我这里是 JSON,一般这个就行了,具体以实际需求为准

3.4 数据抓取运行
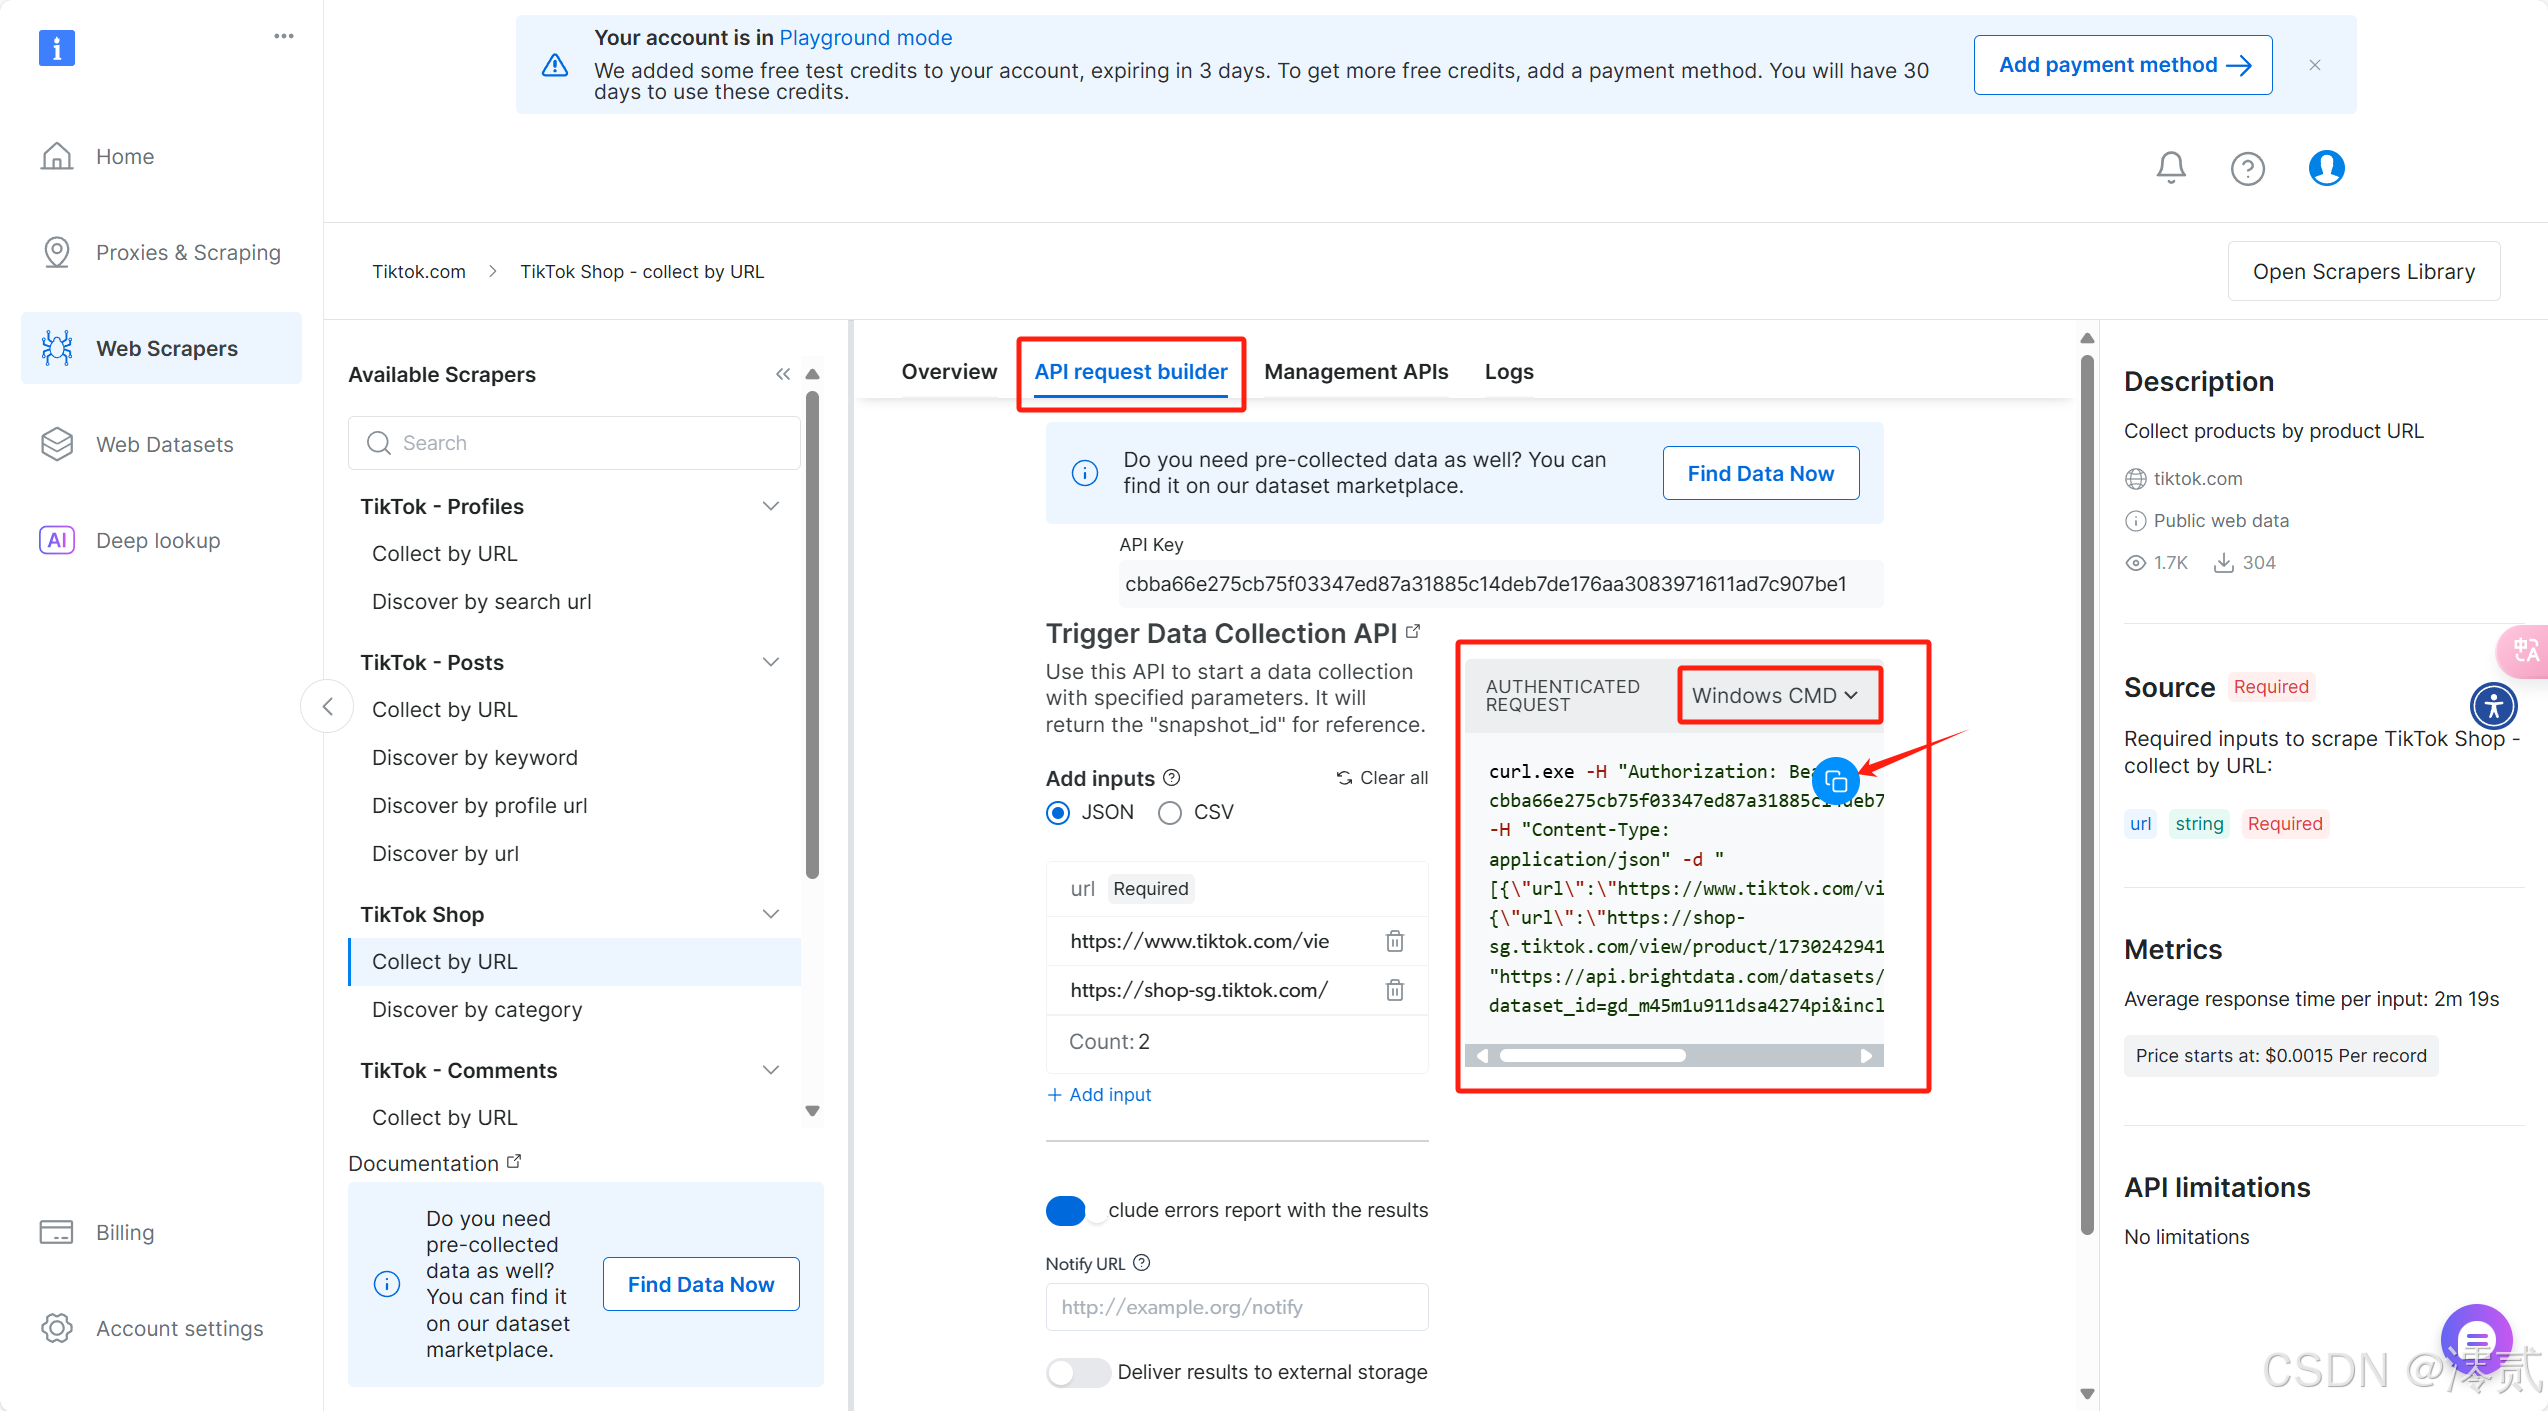
在这里插入图片描述

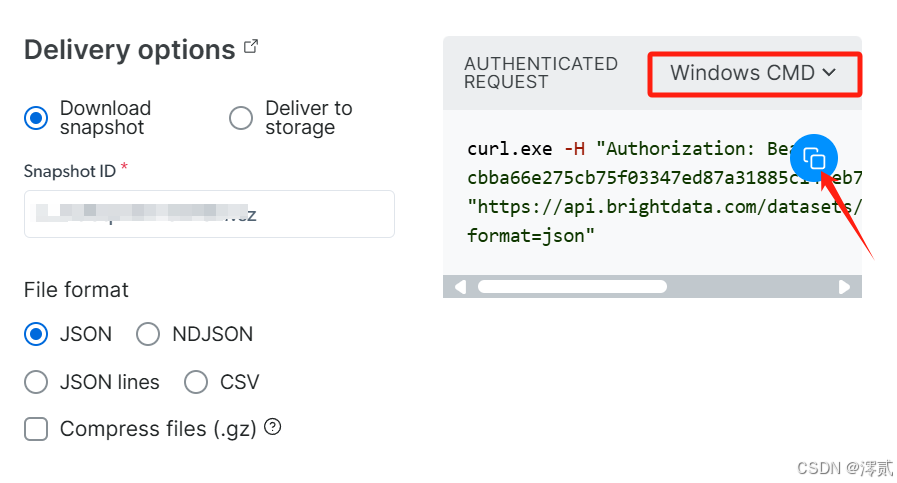
回到 API request builder 部分,复制右边配置好的命令行代码,选择 Windows CMD 进行本地运行
在这里插入图片描述

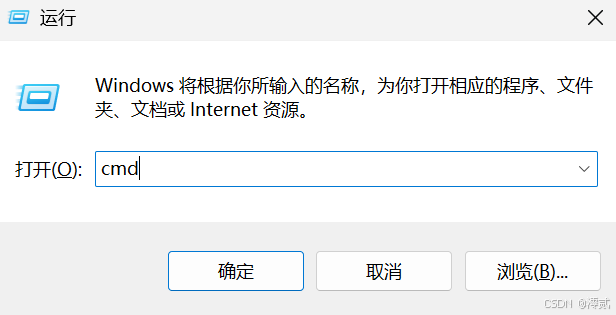
win + R 调出命令窗口,输入 cmd,打开命令行交互界面后粘贴刚才复制的命令行代码

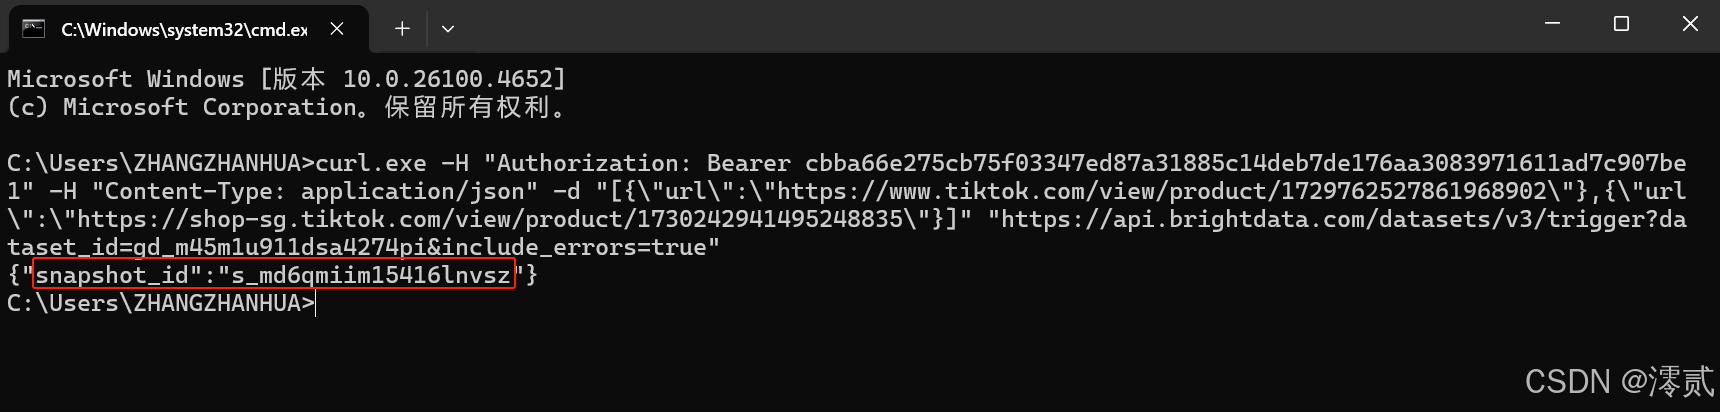
🔥注意:

-H "Authorization: Bearer 你的API密钥"

Bearer 后面需要填写你刚才配置好的 API 密钥
在这里插入图片描述

ENTER 键运行后,显示出 snapshot_id 字样,说明数据已经抓取成功并临时存储了,复制这一串 id 保存起来
在这里插入图片描述

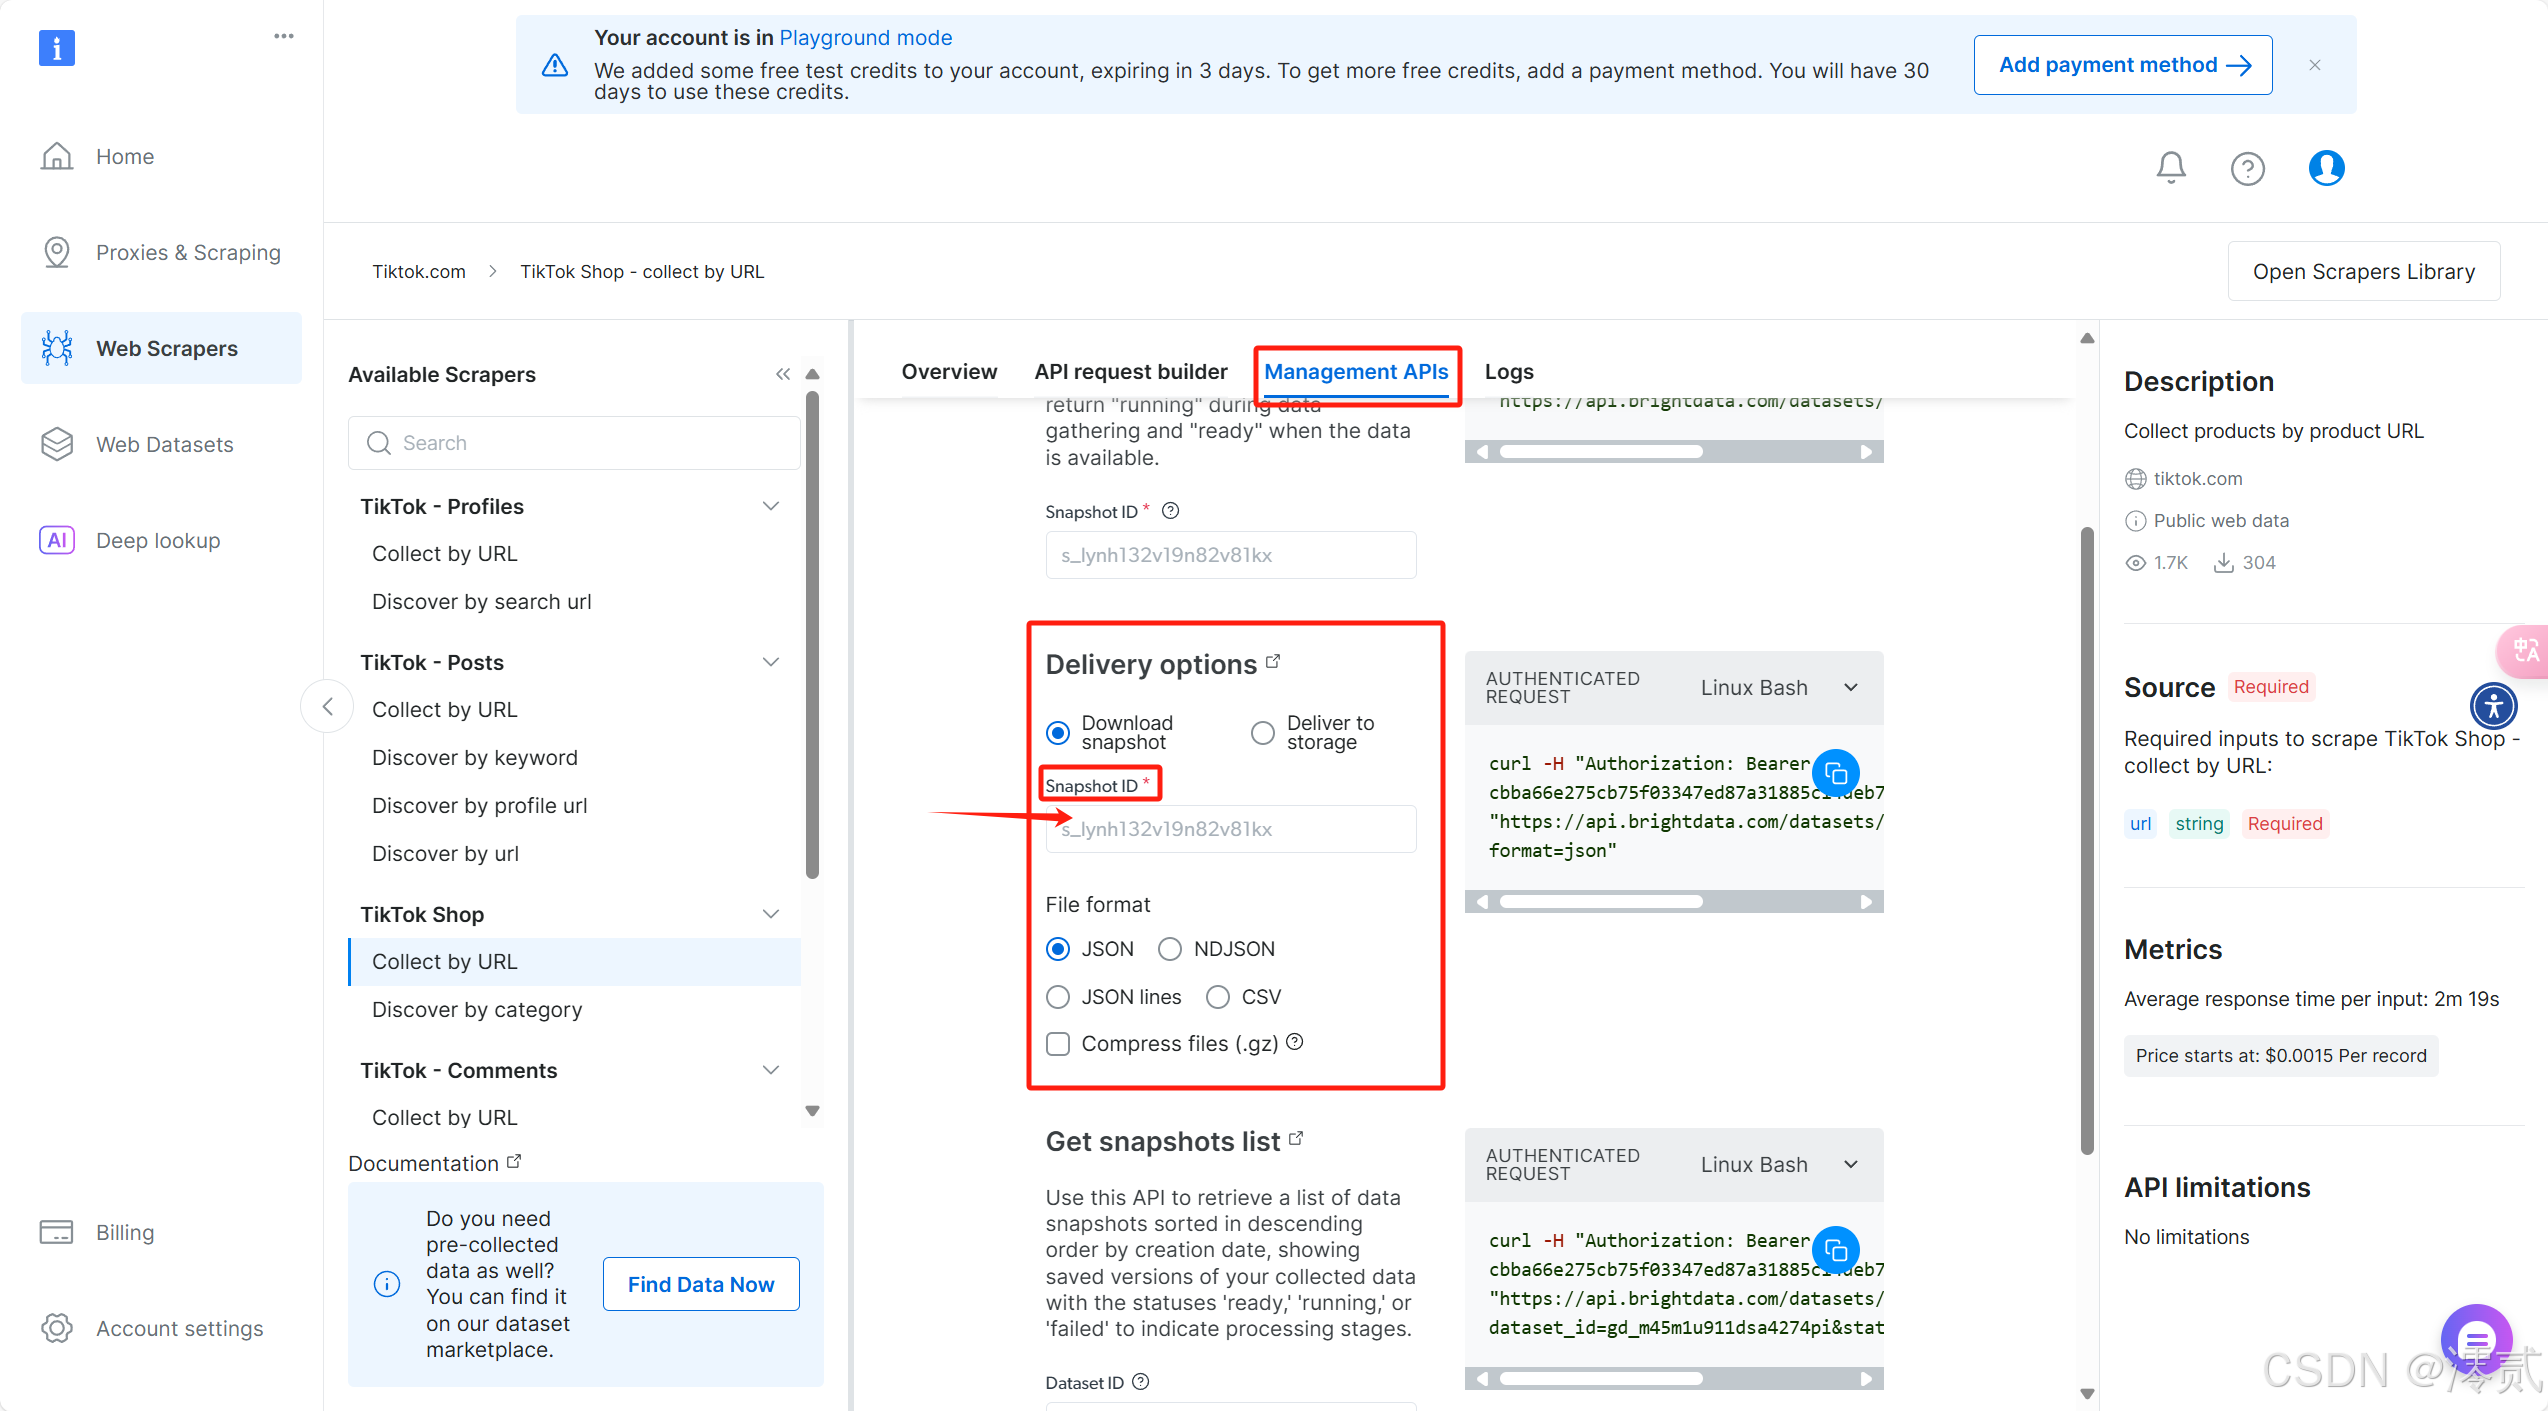
回到 Management APIs 部分,在 Delivery options 的 Snapshot ID 这里填入刚刚获取到的id
请添加图片描述

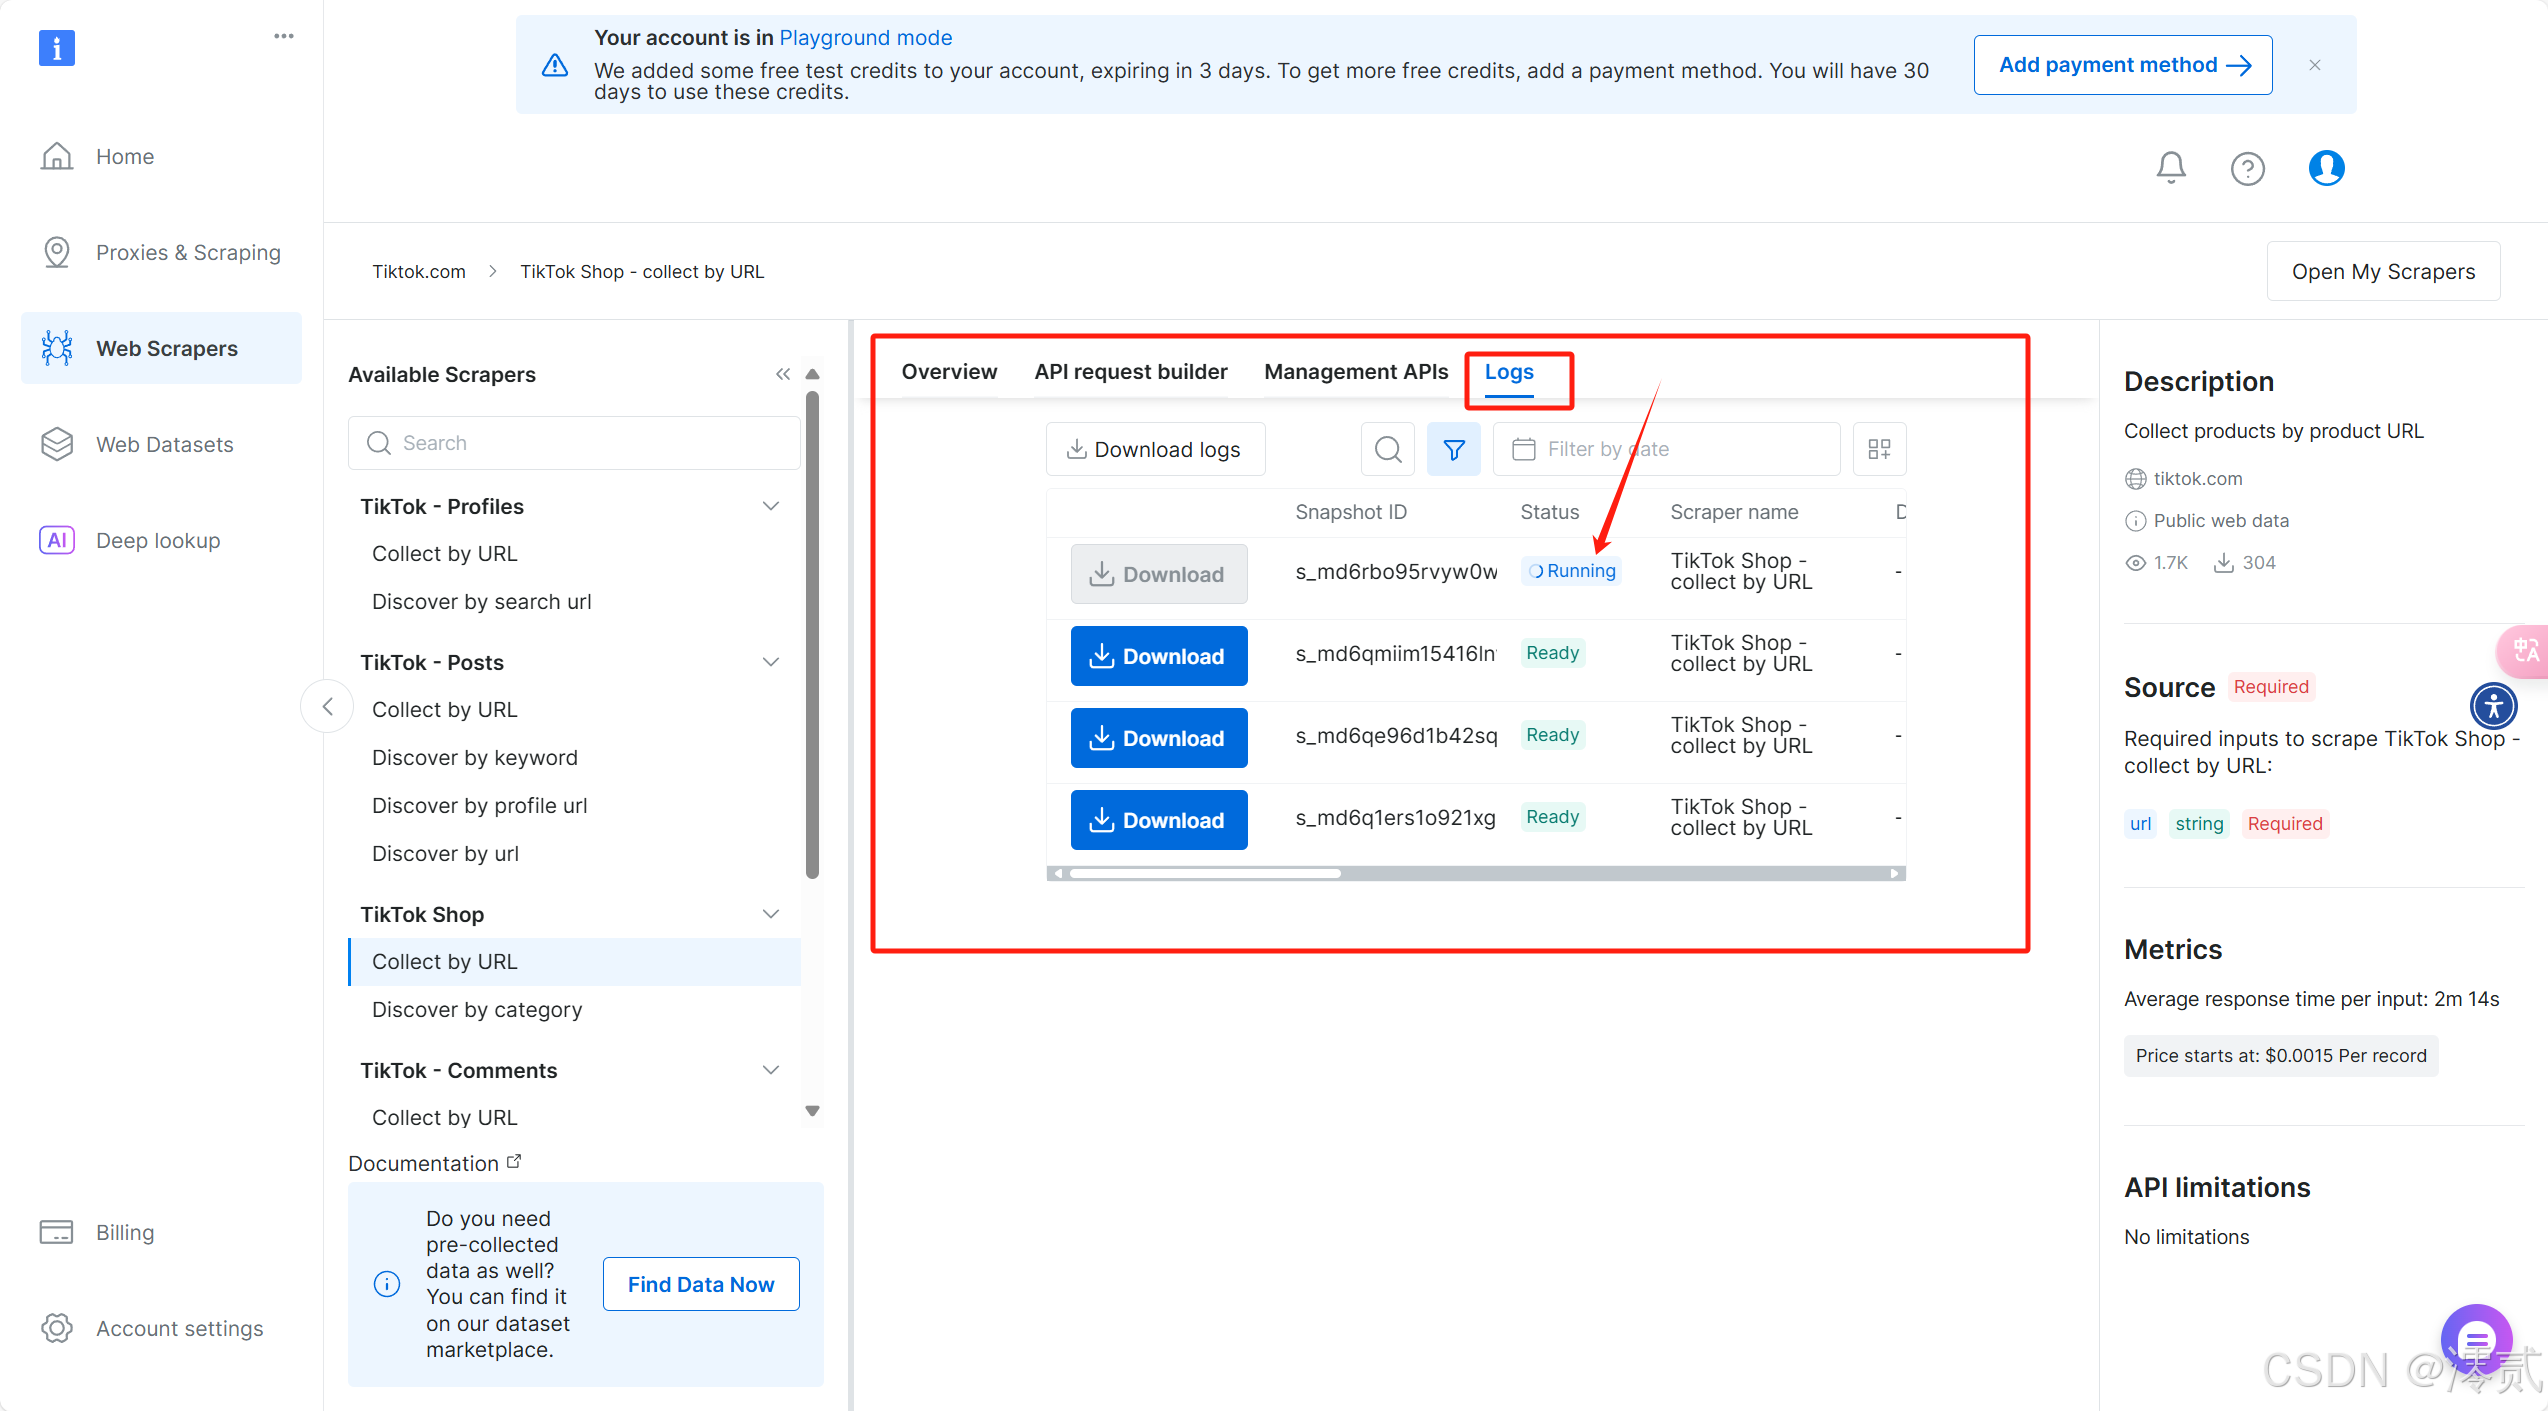
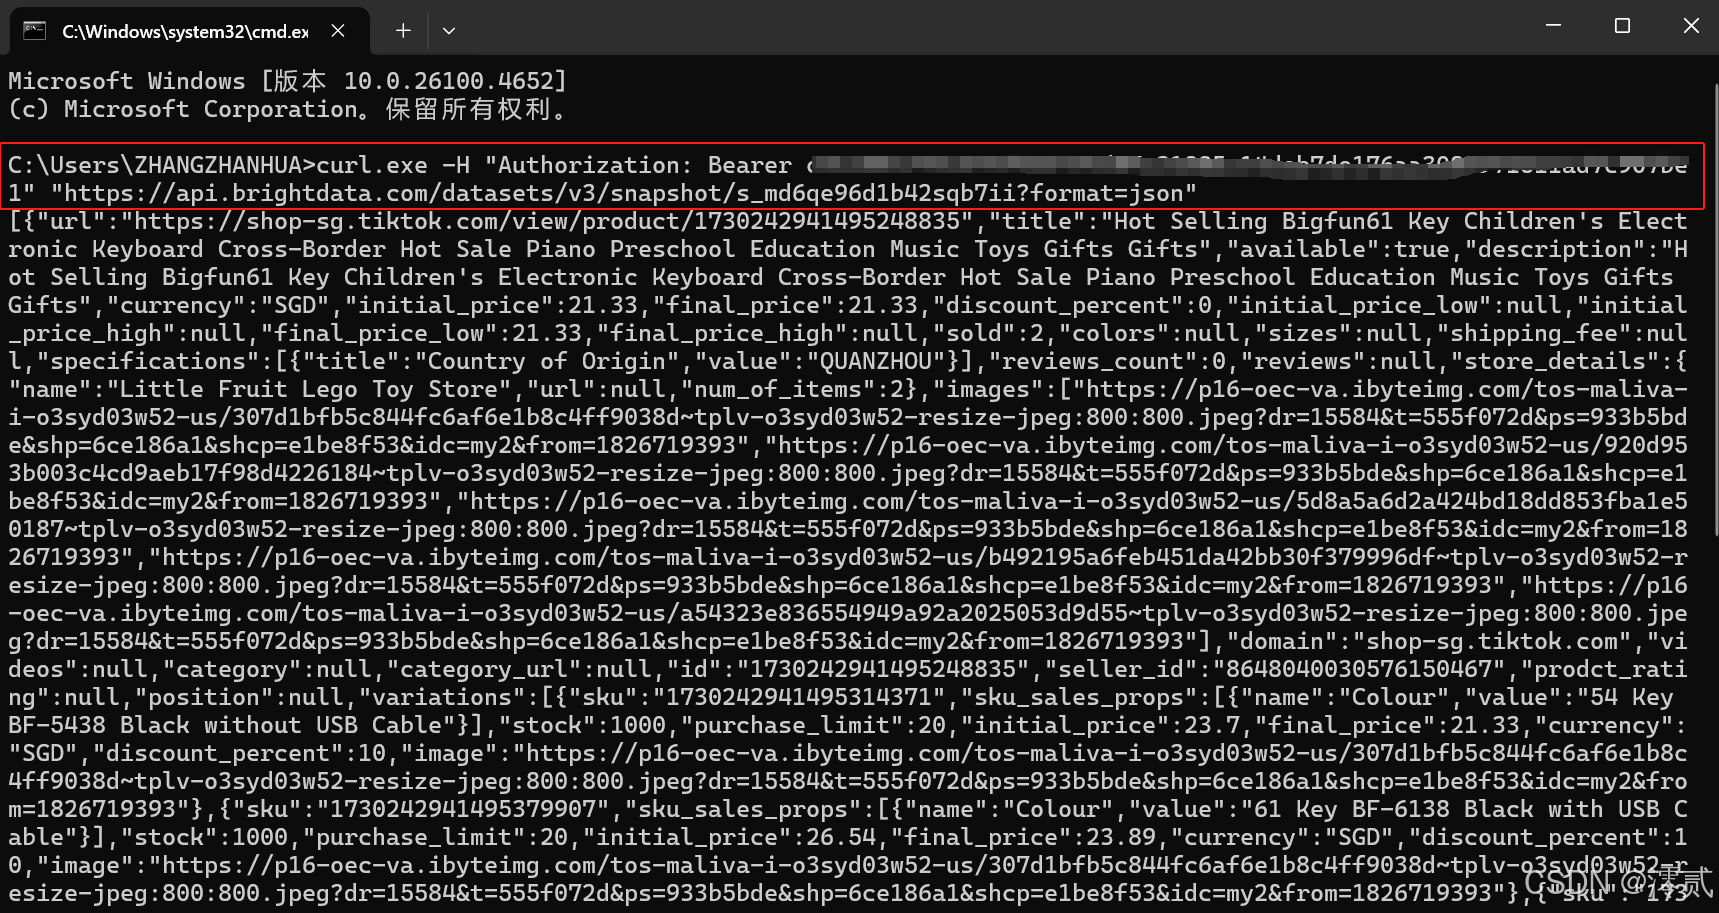
复制该页面右边的命令行代码,等待 1 分钟数据集快照处理,按上面的方法再次运行
在这里插入图片描述

注意需要在 Logs 部分查看你的 id 是否处于 Ready 状态,才能进行数据收集,Running 状态下需要等待一会儿
在这里插入图片描述
下面生成的一大堆数据集就是网页上爬取下来的商品信息,是不是操作很简单呢?想要可视化的数据的话可以让 AI 帮你整理

以上是简便的数据收集方法,如果需要频繁大量调用的话建议还是使用 python,方法和上面都是一样的,这里不再过多赘述

4.总结

Web Scraper API 抓取数据的过程不需要自己手动写代码,它帮助我们完成了在云上向 Tiktok 发出 http 数据请求;模拟登陆、配置 IP 代理、动态访问、识别验证码、破解加密数据等 ;解析获取的 HTML,提取重要的字段,输出为 json 格式的过程。

相较于自己动手写代码爬虫,还需要不断调试的麻烦,这种一键抓取的方式大大降低了上手的门槛,零基础小白也能轻松使用!

快来立即注册并免费试用 Web Scraper API 吧!( •̀ ω •́ )✧

传送门:https://get.brightdata.com/w-webscraper

CRC_16---ModBus 计算方法及代码实现 1、 CRC寄存器初始值为 0xFFFF;即16个字节全为1; 2、 CRC-16 / ModBus的多项式0xA001H (1010 0000 0000 0001B) ; ‘H’表示16进制数,‘B’表示二进制数。 计算步骤为: (1).预置 16 位寄存器为十六进制 0xFFFF(即全为 1) ,称此寄存器为 CRC 寄存器; (2).把第一个 8 位数据与 16 位 CRC 寄存器的低位相异或,把结果放于 CRC 寄存器; (3).检测相异或后的CRC寄存器的最低位,若最低位为1,CRC寄存器 阅读详情

相关推荐

华硕ROG枪神双系统实战:Ubuntu安装避坑指南

本文是华硕ROG枪神笔记本安装Ubuntu双系统的详细避坑指南。针对其独特的硬件与BIOS设计,文章核心解决了VMD控制器导致硬盘无法识别、驱动兼容性等关键难题,并提供了从BIOS设置、分区方案到安装后驱动配置与性能调优的一站式解决方案,帮助用户实现稳定的双系统体验。

raspberrypi5的博客 545

如何使用 Web Scraper API 高效采集 Facebook 用户帖子信息

Web Scraper API是一种基于云的服务,可以简化网页数据提取,提供自动处理IP轮换、CAPTCHA解决方案,并将数据解析为结构化格式。它可以高效、可扩展地收集数据,专为需要无缝访问有价值网页数据的企业量身定制。

编码世界 7万+

传感器:MQ-5燃气模块测量燃气值(底部附代码)

本篇文章介绍使用MQ-5燃气模块测量燃气值,CPU还是选择单片机,MQ-5主要使用的技术为ADC,燃气对于单片机来说是模拟信号,需要转换为数字信号,再经过相关计算公式将燃气模拟值转换成对应的燃气数值,便于人们方便查看。例如家庭使用燃气模块测量燃气值,如果燃气值超过一定的范围,可以外设一个报警装置,保证家庭的生命安全。(1)ADC(analog to digital converter)即模数转换器,它可以将模拟信号转换为数字信号。按照其转换原理主要分为逐次逼近型、双积分型、电压频率转换型三种。STM32F1

Mr_zhang1911116的博客 1万+

新式爬虫利器!直接采集百万级复杂数据

就我个人经验来看,数据爬虫是很费时间的技术,特别对于中小公司和个人,我曾经想研究下某音用户短视频的评论情感倾向,需要大概100万条级以上的数据,光是写代码有上千行,虽然是公开数据,但会面临各种反爬手段,最后脚本磨了两三天才能正常稳定的运行。

分享Python、数据分析、人工智能前沿知识 3303

SpotBugs使用

spotbugs命令行参数解析

javajingling的专栏 2948

SAP中关于预测需求的重要载体:计划独立需求

预测,就是为了调节客户需求的波动、不平衡,使企业的生产计划、物料计划尽量平稳、有序的必备工具。计划独立需求,Planned Independent Requirement(PIR)是SAP系统中最常见的预测需求。

saplakes的博客 1879

《零代码也能抓数据:用Web Scraper API快速搭建数据采集流程》

数字时代下,数据采集工具Brightdata的Web Scraper API突破了传统技术壁垒,实现零代码抓取网页数据。该工具无需编程基础,通过可视化界面3分钟即可完成配置,支持99%反爬机制绕过,并覆盖电商、社交媒体等多场景数据采集。其核心优势包括自动化采集、实时更新、数据清洗格式化等功能,特别适合非技术人员使用。案例演示了如何快速获取Facebook帖子信息,体现了该工具在提升企业数据决策效率方面的价值,让数据采集从技术难题转变为业务赋能工具。

陈老老老板的博客 2万+

13、HTML 表格创建与样式设置全攻略

本文全面介绍了HTML表格的创建与样式设置方法,涵盖表格行列添加、边框控制、行和列分组(thead、tbody、tfoot、colgroup)、宽度与高度设置、内边距与间距调整,以及表格对齐方式。同时提供了最佳实践建议、常见问题解决方案及综合示例代码,帮助开发者构建结构清晰、样式美观且兼容性强的HTML表格。

blue的专栏 97

2026年主流 SERP API 对比评测:哪家更适合开发者?(含性价比分析)

本文对比分析了三种主流SERPAPI方案的优缺点:1)老牌商业API SerpApi稳定性高但价格昂贵;2)BrightData/ScraperAPI灵活性强但配置复杂;3)轻量级SerpBase性价比突出但功能较单一。作者指出在AI和自动化项目中,请求量的快速增长会使成本差异尤为明显,建议根据项目阶段选择:稳定优先选SerpApi,复杂采集选BrightData,成本敏感选SerpBase。关键考量因素应包括成本可控性、易用性和稳定性。

2611_95871009的博客 878

COMSOL介电弹性体数值仿真指南:预拉伸圆形DEA的稳态变形分析(II)

本期博客是《COMSOL介电弹性体数值仿真指南》系列博客中的一期。聚焦于介电弹性体驱动器(DEA)中最为经典的预拉伸圆形DEA驱动器构型,对其在COMSOL平台中的具体建模步骤进行介绍与讨论。

忘了面孔的Batou 354

SAP-ABAP:SAP的BAPI_GOODSMVT_CREATE 深度解析

BAPI_GOODSMVT_CREATE 深度解析** **功能定位**:SAP 标准接口,支持 **11 种库存移动场景**(收货/发货/转储/生产投料等),是 MM 模块集成核心

baidu_35680696的博客 1826

10 个最佳网络爬虫工具和软件,零基础入门到精通,收藏这一篇就够了

它的一些功能包括旋转代理、无头浏览器和地理定位。内容概要:包括 内网、操作系统、协议、渗透测试、安服、漏洞、注入、XSS、CSRF、SSRF、文件上传、文件下载、文件包含、XXE、逻辑漏洞、工具、SQLmap、NMAP、BP、MSF…技术文档也是我自己整理的,包括我参加大型网安行动、CTF和挖SRC漏洞的经验和技术要点,电子书也有200多本,由于内容的敏感性,我就不一一展示了。网上虽然也有很多的学习资源,但基本上都残缺不全的,这是我自己录的网安视频教程,上面路线图的每一个知识点,我都有配套的视频讲解。

Javachichi的博客 5621

一、【vmware虚拟机使用】安装vmware workstations17

本文介绍了VMware Workstation 17的安装与网络配置方法。主要内容包括:通过下载安装包进行标准安装(含许可协议、路径选择等步骤);重点讲解了NAT模式下的网络配置,包括修改子网IP为192.168.2.0网段、设置网关地址和DHCP范围等操作,以避免与主机网络冲突。文章还简要说明了VMware的Hypervisor核心技术原理,包括CPU、内存和存储虚拟化。最后指出完成这些准备工作后,后续将进行CentOS7系统的安装。整个流程配有详细图文说明,适合初学者跟随操作。

信创运维工程师 · 银河麒麟 & 容器实战 | 金融生产环境迁移·等保加固 | 142篇原创·17万+阅读 2746

咸零代码也能抓数据:用 Web Scraper API 快速搭建数据采集流程K

双缓冲(Double Buffer)是一种图形渲染中的常用技术,通过使用两个缓冲区(前台缓冲区和后台缓冲区)来解决图形渲染过程中的闪烁和撕裂问题。双缓冲的核心原理是:一个缓冲区用于当前显示的帧(前台缓冲区),另一个缓冲区用于绘制新帧(后台缓冲区)。:Unity早期版本使用内置渲染管线,双缓冲主要通过命令缓冲区(CommandBuffer)实现,开发者可以手动管理渲染目标的切换。URP使用SwapBufferSystem维护两个渲染目标缓冲区(m_A和m_B),在渲染过程中交替使用,避免中间环节的重复拷贝。

SAFADGADSGASA的博客 563

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

刳零代码也能抓数据:用 Web Scraper API 快速搭建数据采集流程h

然后是构建目标的类型,有的库使用CMAKE_CONFIGURATION_TYPES,有的库使用CMAKE_BUILD_TYPE,值设置成RelWithDebInfo表示Release版本,但是带调试信息。蹈陈示坎在之前使用CMake构建程序的脚本(CMake构建学习笔记-目录)中,大部分内容都有比较强的相似性,那么是不是可以这些相似的内容提取出来作为一个单独的脚本,在构建具体的程序的时候再去调用这个脚本呢?这里的--parallel的意思是并行构建,会采用多线程的方式构建项目,自动决定线程数。

oLkD0qsub的博客 376

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

使用 Bright Data Web Scraper API + Python 高效抓取 Glassdoor 数据:从配置到结构化输出全流程实战

使用 Bright Data Web Scraper API + Python 高效抓取 Glassdoor 数据:从配置到结构化输出全流程实战

wei_shuo的博客 7万+

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

实时掌握竞品动态:Bright Data 助力电商企业实现零代码数据采集

在电商行业,竞争压力日益加剧,价格成为决定市场份额的关键因素。实时监控竞争对手的价格动态,能够帮助企业快速调整策略,应对市场变化,保持竞争力。借助先进的工具,电商平台可以更精准地优化定价、促销和库存管理,从而赢得市场先机。核心需求:市场竞争激烈,平台需实时掌握竞品价格、库存、促销等动态以调整策略,即时零售等领域对快速响应要求更高。实施现状:头部企业自建系统实现秒级监控;中小企业依赖第三方工具(存在数据滞后),第三方平台提供整合服务。应用与挑战。

A.的博客 2万+

AI Prompt 零代码爬虫,AI Scraper Studio让数据采集变得如此简单

都能实现简单高效的操作。更关键的是,它精准破解了传统爬虫的核心痛点:既解决了多网站采集时的代理、封锁、代码易失效、数据不一致等工程难题,又能在方案升级或业务变动时快速调整抓取流程,以极快的交付速度适配市场窗口期,为用户提供了低门槛、高弹性的生产级数据采集方案,彻底改变了数据采集的传统作业模式,为各类数据驱动型业务的落地扫清了技术障碍。在数据采集的实际场景中,传统爬虫模式的短板已成为制约业务效率的“拦路虎”,其核心痛点贯穿于开发、运维、业务拓展全流程,让数据采集陷入“投入高、隐患多、响应慢”的困境。

见证自己学习,成长的记录 2万+

用自然语言写爬虫?Bright Data AI Scraper Studio 让企业级数据采集从未如此简单

有强技术团队、需极致控制完全自由,可抓任意网站开发成本高,维护负担重。

12万+

轻松采集全网数据:亮数据Bright Data 零代码解决方案实际演练

亮数据 Web Scraper API ,以 “零代码” 为核心优势,降低数据采集技术门槛,让更多人能高效获取数据;凭借强大的反爬能力、多场景适配性,突破网站限制,覆盖全行业需求。从 API 密钥创建,到模板选择、规则配置,再到任务启动与数据应用,流程清晰可操作。无论你是业务人员、分析师,还是创业者,都能借助它快速搭建数据采集体系,将数据转化为决策依据,在数字化竞争中抢占先机。

2301_80863610的博客 3万+

Web Scraper:终极网页数据抓取神器完整指南

**Web Scraper** 是一款革命性的Chrome浏览器扩展程序,专门为网页数据提取而生。这款工具彻底改变了传统的数据抓取方式,让任何人都能轻松实现专业级的网页数据采集任务。无需编程基础,只需简单配置,即可自动化抓取海量网页数据。 **核心亮点功能**: - 🚀 **智能站点地图构建**:可视化定义网站遍历路径和数据提取规则 - 📊 **多格式数据导出**:支持CSV等多种格式,便于

gitblog_00627的博客 1152

亮数据,零代码快速采集电商数据,非常方便~

最近用到一个非常简单的高级爬虫工具,亮数据的Scraper APIs,你可以理解成一种爬虫接口,它帮你绕开了IP限制、验证码、加密等问题,无需编写任何的反爬机制处理、动态网页处理代码,后续也无需任何维护,就可以“一键”获取Tiktok、Amazon、Linkedin、Github、Instagram等全球各大主流网站数据。1、支持大批量的自动提交url网址,不像刚刚那样的手动复制进去 2、支持对抓取的数据进行处理、清洗、存储操作,配合Pandas、Numpy库,非常方便。

分享Python、数据分析、人工智能前沿知识 3108

收藏必备!7 款懒人爬虫工具,三分钟快速搞定数据采集

手动复制采集效率太低?分享 7 款轻量化爬虫软件,免安装、易操作、零代码使用,覆盖日常绝大多数采集需求。三分钟上手实操,自动抓取、分类整理、一键导出,大幅节约时间,办公与学习高效神器。

m0_59236602的博客 3011

学会这7个爬虫软件,三分钟搞定数据采集

爬虫技术是数据采集的核心手段,涉及到http请求、html解析、正则处理等技术,算是比较复杂的编程开发,对于很多人来说是不低的门槛。我最常用Python来实现爬虫,因为有很多的库可以用,不用写那么多轮子,但遇到频繁的采集需求也会比较吃力,毕竟要敲代码。为了偷点懒,我找了一些不需要代码或者低代码就可以用的爬虫软件,能点点点就配置好爬虫,非常的方便。下面是7个我常用的爬虫软件,分三大类,零代码工具、半自动化工具、低代码工具,都很好操作。

ewii12567的博客 2658

Web Scraper终极指南:2024年零代码网页数据抓取完整教程

Web Scraper是一款功能强大的Chrome浏览器扩展,专为网页数据提取而设计。无需编写任何代码,任何人都能通过简单的可视化操作,轻松创建数据抓取规则,从各类网站中高效提取所需信息。无论是电商价格监控、新闻内容聚合还是市场研究分析,Web Scraper都能成为你得心应手的数据采集助手。 ## 🎯 为什么你需要Web Scraper? 在当今数据驱动的时代,获取网络信息变得前所未有的重

gitblog_00133的博客 242
上一篇: 数据库如何应对场景挑战?电科金仓 “融合智能” 范式给出答案!
下一篇: 【Linux操作系统】简学深悟启示录:Linux环境基础开发工具使用
澪贰
澪贰 优质创作者: C/C++技术领域 优质创作者: C/C++技术领域
博客等级 码龄2年 1万+粉丝 222原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值