Python+gensim-文本相似度分析(小白进)

详解利用基于gensim的TF-IDF算法实现基于文本相似度的推荐算法 基于TF-IDF的文本相似度推荐算法简介开发环境TF-IDF的基本原理微型图书推荐案例欢迎使用Markdown编辑器新的改变功能快捷键合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章U... 阅读详情

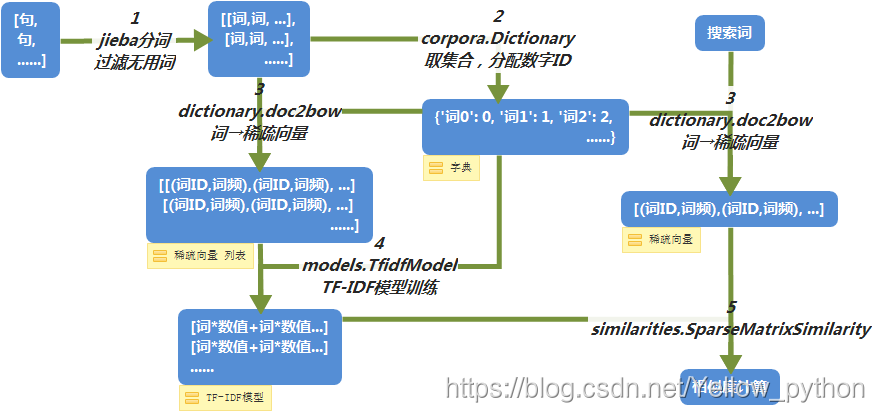
1、gensim使用流程

在这里插入图片描述

2、代码实现

from jieba import lcut
from gensim.similarities import SparseMatrixSimilarity
from gensim.corpora import Dictionary
from gensim.models import TfidfModel
# 文本集和搜索词
texts = ['吃鸡这里所谓的吃鸡并不是真的吃鸡,也不是谐音词刺激的意思',
         '而是出自策略射击游戏《绝地求生:大逃杀》里的台词',
         '我吃鸡翅,你吃鸡腿']
keyword = '玩过吃鸡?今晚一起吃鸡'
# 1、将【文本集】生成【分词列表】
texts = [lcut(text) for text in texts]
# 2、基于文本集建立【词典】,并获得词典特征数
dictionary = Dictionary(texts)
num_features = len(dictionary.token2id)
# 3.1、基于词典,将【分词列表集】转换成【稀疏向量集】,称作【语料库】
corpus = [dictionary.doc2bow(text) for text in texts]
# 3.2、同理,用【词典】把【搜索词】也转换为【稀疏向量】
kw_vector = dictionary.doc2bow(lcut(keyword))
# 4、创建【TF-IDF模型】,传入【语料库】来训练
tfidf = TfidfModel(corpus)
# 5、用训练好的【TF-IDF模型】处理【被检索文本】和【搜索词】
tf_texts = tfidf[corpus]  # 此处将【语料库】用作【被检索文本】
tf_kw = tfidf[kw_vector]
# 6、相似度计算
sparse_matrix = SparseMatrixSimilarity(tf_texts, num_features)
similarities = sparse_matrix.get_similarities(tf_kw)
for e, s in enumerate(similarities, 1):
    print('kw 与 text%d 相似度为:%.2f' % (e, s))
打印结果
keyword 与 text1 相似度为:0.65
keyword 与 text2 相似度为:0.00
keyword 与 text3 相似度为:0.12

3、过程拆解

3.1、生成分词列表

对文本集中的文本进行 中文分词,返回 分词列表,格式如下:
[‘word1’, ‘word2’, ‘word3’, …]
import jieba
text = '七月七日长生殿,夜半无人私语时。'
words = jieba.lcut(text)
print(words)
[‘七月’, ‘七日’, ‘长生殿’, ‘,’, ‘夜半’, ‘无人’, ‘私语’, ‘时’, ‘。’]

3.2、基于文本集建立词典,获取特征数

  • corpora.Dictionary:建立词典
  • len(dictionary.token2id):词典中词的个数
from gensim import corpora
import jieba
# 文本集
text1 = '坚果果实'
text2 = '坚果实在好吃'
texts = [text1, text2]
# 将文本集生成分词列表
texts = [jieba.lcut(text) for text in texts]
print('文本集:', texts)
# 基于文本集建立词典
dictionary = corpora.Dictionary(texts)
print('词典:', dictionary)
# 提取词典特征数
feature_cnt = len(dictionary.token2id)
print('词典特征数:%d' % feature_cnt)
打印结果
文本集: [[‘坚果’, ‘果实’], [‘坚果’, ‘实在’, ‘好吃’]]
词典: Dictionary(4 unique tokens: [‘坚果’, ‘果实’, ‘好吃’, ‘实在’])
词典特征数:4

3.3、基于词典建立语料库

语料库即存放稀疏向量的列表

from gensim import corpora
import jieba
text1 = '来东京吃东京菜'
text2 = '东京啊东京啊东京'
texts = [text1, text2]
texts = [jieba.lcut(text) for text in texts]
dictionary = corpora.Dictionary(texts)
print('词典(字典):', dictionary.token2id)
# 基于词典建立新的【语料库】
corpus = [dictionary.doc2bow(text) for text in texts]
print('语料库:', corpus)
打印结果
词典(字典): {‘东京’: 0, ‘吃’: 1, ‘来’: 2, ‘菜’: 3, ‘啊’: 4}
语料库: [[(0, 2), (1, 1), (2, 1), (3, 1)], [(0, 3), (4, 2)]]

3.3.1、doc2bow函数

1、将所有单词取【集合】,并对每个单词分配一个ID号
以 ['东京', '啊', '东京', '啊', '东京']为例
对单词分配ID: 东京→ 0; 啊→ 4
变成: [0, 4, 0, 4, 0]
2、转换成 稀疏向量
0有 3个,即表示为( 0, 3)
4有 2个,即表示为( 4, 2)
最终结果:[( 0, 3), ( 4, 2)]

3.3.2、搜索词也转成稀疏向量

from gensim import corpora
import jieba
text1 = '南方医院无痛人流'
text2 = '北方人流落南方'
texts = [text1, text2]
texts = [jieba.lcut(text) for text in texts]
dictionary = corpora.Dictionary(texts)
# 用【词典】把【搜索词】也转换为【稀疏向量】
keyword = '无痛人流'
kw_vector = dictionary.doc2bow(jieba.lcut(keyword))
print(kw_vector)
[(0, 1), (3, 1)]

3.4、用语料库训练TF-IDF模型

  • TF-IDF是一种统计方法,用以评估一字词对于一个文件集或一个语料库中的其中一份文件的重要程度
from gensim import corpora, models, similarities
import jieba
text1 = '南方医院无痛人流'
text2 = '北方人流浪到南方'
texts = [text1, text2]
texts = [jieba.lcut(text) for text in texts]
dictionary = corpora.Dictionary(texts)
feature_cnt = len(dictionary.token2id.keys())
corpus = [dictionary.doc2bow(text) for text in texts]
# 用语料库来训练TF-IDF模型
tfidf = models.TfidfModel(corpus)
print(tfidf)
TfidfModel(num_docs=2, num_nnz=9)

3.5、相似度计算

from gensim import corpora, models, similarities
import jieba
text1 = '无痛人流并非无痛'
text2 = '北方人流浪到南方'
texts = [text1, text2]
keyword = '无痛人流'
texts = [jieba.lcut(text) for text in texts]
dictionary = corpora.Dictionary(texts)
num_features = len(dictionary.token2id)
corpus = [dictionary.doc2bow(text) for text in texts]
tfidf = models.TfidfModel(corpus)
new_vec = dictionary.doc2bow(jieba.lcut(keyword))
# 相似度计算
index = similarities.SparseMatrixSimilarity(tfidf[corpus], num_features)
print('\nTF-IDF模型的稀疏向量集:')
for i in tfidf[corpus]:
    print(i)
print('\nTF-IDF模型的keyword稀疏向量:')
print(tfidf[new_vec])
print('\n相似度计算:')
sim = index[tfidf[new_vec]]
for i in range(len(sim)):
    print('第', i+1, '句话的相似度为:', sim[i])

4、附录

EnCn
corpusn. 文集;[计]语料库(复数:corpora)
sparseadj. 稀疏的
vectorn. 矢量
Sparse Matrix Similarity稀疏矩阵相似性
word2vecword to vector
doc2bowdocument to bag of words(词袋)
使用gensim计算文本相似度 使用gensim计算文本相似度 计算文本相似度步骤逻辑 1、将文本数据,通过jieba分词进行处理,形成一个二维数组 2、将二维数组生成词典 3、将二维数组通过doc2bow稀疏向量,形成语料库 4、使用TF模型算法,将语料库计算出Tfidf值 5、获取词典token2id的特征数 6、计算稀疏矩阵相似度,建立一个索引 7、测试数据jieba分词处理 8、通过doc2bow计算测试数据的稀疏向量 ... 阅读详情

相关推荐

Python实现文本相似度比较分析

创建文档摘要向量之后,可通过比较两个文档摘要向量的距离的方法来判断两个文档的相似度。

Zhangguohao666的博客 1万+

python使用gensim进行文本相似度计算

前提知识: 阮一峰:TF-IDF与余弦相似性的应用(一):自动提取关键词               TF-IDF与余弦相似性的应用(二):找出相似文章 本文章根据 在路上吗 翻译官方教程,使用tfidf计算文本相似度 翻译教程地址:http://blog.youkuaiyun.com/questionfish/article/category/5610303

yibo492387的专栏 5543

gensim similarity计算文档相似度

向量空间模型计算文档集合相似性。 将原始输入的词转换为ID,词的id表示法简单易用,但是无法预测未登记词,难以挖掘词关系;词汇鸿沟[1]:任意两个词之间是独立的,无法通过词的ID来判断词语之间的关系,无法通过词的id判断词语之间的关系[2]使用gensim包的models,corpora,similarities,对文档进行相似度计算,结果比较其他lda、doc2vec方法稳定。 主要步骤: 1

楚门的世界 1万+

使用python进行文本相似度分析

然后,定义一个preprocess_text函数来对输入文本进行预处理,包括将文本转换为小写、分词和去除停用词。然后,使用TfidfVectorizer类创建了一个TF-IDF向量化器,并使用它来计算两个文本的TF-IDF向量。最后,使用cosine_similarity函数计算了两个文本之间的余弦相似度得分,并输出了结果。这个代码会输出一个相似度矩阵,其中的每个元素都表示对应的两个文本之间的相似度。接下来,使用cosine_similarity函数计算两个向量之间的余弦相似度,并将结果打印出来。

m0_51066361的博客 2229

Python文本相似度实战——基于gensim和nltk库

任务内容: 给定一个文本库,比如说新闻文本(无标注的)等等,现在有一些已经做好标注的文本,如何在文本库中找到与做好标注的文本相似的文章。 所用工具: python , gensim , nltk gensim提供了很多算法来实现文本相似度的比较,比如TF-IDF,topic model,以及LDA等等。 nltk则是自然语言处理领域非常知名的库,包含很多处理文本内容的方法

kelvinLLL的博客 9957

利用python及jieba分词和gensim模块计算文本相似度

由于工作需要,接触自然语言处理,写一些笔记,请大家指教。功能:实现把文本库中和输入文本相似的文本输出。工具:Spyder,python3.6,codecs,jieba,gensim等模块。(需要自己安装相关模块,我使用的是pip安装)程序:# -*- coding: utf-8 -*-"""Spyder EditorThis is a temporary script file."""import...

lunseqing5357的博客 7397

Python Gensim文本分析——从文本预处理到TFIDF、LDA建模分析

本文以中文文本数据作为分析对象,针对中文文本存在的特征进行文本预处理,并调用Gensim工具包实现对文本的TFIDF建模已经LDA建模,从文本中抽取出的特征进行表征文本信息,可用于后续文本相似度、个性化推荐等研究。

Lyric1的博客 6109

python实现文本检索-文本相似度算法

目的 给定一个或多个搜索词,如“高血压 患者”,从已有的若干篇文本中找出最相关的(n篇)文本。 理论知识 文本检索(text retrieve)的常用策略是:用一个ranking function根据搜索词对所有文本进行排序,选取前n个,就像百度搜索一样。 算法:模型选择 1、基于word2vec的词语相似度计算模型 2、python的实现用到了gensim库 3...

heima201907的博客 5216

Python+gensim-文本相似度分析

代码实现 #相似度的计算 from gensim import corpora, models, similarities import jieba text1 = '技术侦察措施只能在立案后采取' text2 = '未立案不可以进行技术侦察' texts = [text1, text2] keyword = '未立案可以进行技术侦察' # 1、将【文本集】生成【分词列表】 texts = [jieba.lcut(text) for text in texts] # 2、基于文本集建立【词典】,并获得词

caoyongsheng的博客 1533

python进行简单的文本相似度分析

python进行简单的文本相似度分析 本文利用gensim包、jieba包和TF-IDF模型进行简单的文本相似度分析。从而能够让我们确定,哪句话和哪句话相似程度是多少。文本相似度分析是自然语言处理中常用的一种分析方法,也是一个重要的分析方法。 TF-IDFM模型 1.模型的原理:是一个语料另一种表示;是一种语料的词权重表示,是词的一种加重技术;是一套自定义的计算模型方法。 2.直观的核心思想是:字...

iseeyounow2017的博客 1157

[Python人工智能] 九.gensim词向量Word2Vec安装及《庆余年》中文短文本相似度计算

从本专栏开始,作者正式开始研究Python深度学习、神经网络及人工智能相关知识。前一篇详细讲解了卷积神经网络CNN原理,并通过TensorFlow编写CNN实现了MNIST分类学习案例。本篇文章将分享gensim词向量Word2Vec安装、基础用法,并实现《庆余年》中文短文本相似度计算及多个案例。本专栏主要结合作者之前的博客、AI经验和相关文章及论文介绍,后面随着深入会讲解更多的Python人工智能案例及应用。基础性文章,希望对您有所帮助~

杨秀璋的专栏 1万+

Python 文本挖掘:使用gensim进行文本相似度计算

在文本处理中,比如商品评论挖掘,有时需要了解每个评论分别和商品的描述之间的相似度,以此衡量评论的客观性。 评论和商品描述的相似度越高,说明评论的用语比较官方,不带太多感情色彩,比较注重描述商品的属性和特性,角度更客观。 那么Python 里面有计算文本相似度的程序包吗,恭喜你,不仅有,而且很好很强大。 这是从52nlp大神的博客里面发现的,其实具体的处理流程和程序和他的基本一致,

Thinking 5万+

实测有效!YOLOv8融合EMA注意力机制后,在无人机航拍目标检测中的性能提升对比

本文详细介绍了YOLOv8融合EMA注意力机制在无人机航拍目标检测中的性能提升效果。通过多尺度特征融合和通道-空间双重注意力机制,EMA模块显著提升了小目标检测的准确率,mAP@0.5平均提升4.2%,同时保持推理速度基本不变。文章还提供了模型定制、训练技巧和实际部署优化的全流程指南。

weixin_33704234的博客 392

python jieba 文本相似度_文本相似度分析(基于jieba和gensim)

##基础概念本文在进行文本相似度分析过程分为以下几个部分进行,文本分词语料库制作算法训练结果预测分析过程主要用两个包来实现jieba,gensimjieba:主要实现分词过程gensim:进行语料库制作和算法训练##结巴(jieba)分词在自然语言处理领域中,分词和提取关键词都是对文本处理时通常要进行的步骤。用Python语言对英文文本进行预处理时可选择NLTK库,中文文本预处理可选择jieba库...

weixin_39648430的博客 2751

0x12B 蓝屏怎么查:内存单比特翻转与硬件排查记录

Windows 蓝屏停止代码是内核检测到不可继续运行的异常时触发的保护机制,0x12B(FAULTY_HARDWARE_CORRUPTED_PAGE)更指向内存页校验失败与单比特翻转。其原理是内存管理子系统发现页面内容与校验值不一致后,为避免坏数据扩散而停机。通过 WinDbg 分析 dump、事件日志对齐时间戳,再结合 MemTest86、TestMem5、逐条单插与关闭 XMP 做交叉验证,可把内存、显存、存储链路和第三方内核模块依次排除。对编译、游戏、Hyper-V 虚拟化等高负载场景,这套记录与验证

weixin_30899023的博客 344

Rijndael密码算法

一 什么是Rijndael Rijndael是由比利时密码学家设计的分组密码算法,于2000年被选为新一代的标准密码算法——AES。今后会有越来越多的密码软件支持这种算法。 Rijndael的分组长度和密钥长度可以分别以32比特为单位在128比特和256比特的范围内进行选择。不过在AES的规格中,分组长度固定为128比特,密钥长度只有128、192和256比特三种。 二 Rijndael的加...

实践求真知 1万+

Python编程:使用gensim对中文文本进行相似度计算

gensim文档: https://radimrehurek.com/gensim/tutorial.html 安装 pip install gensim 代码示例 # -*- coding: utf-8 -*- import logging import jieba from gensim import corpora, models, similarities logging.bas...

彭世瑜的博客 6864

Hive数据迁移

【迁移背景】 本次需要将老集群的hive数据(共30多张表)迁移至新集群中。 老集群版本为CDH5.13,未启用kerberos; 新集群版本为CDH5.14,启用了kerberos。 由于cloudera官方文档说明,在5.x的版本不支持从未启用kerberos的集群与启用了kerberos的集群之间的数据复制。因此无法通过bdr方式进行数据同步。于是采用手工方式进行测试验证。 第一步...

wangkuangood3200的专栏 470

python-文本相似度计算库-gensim

1、功能说明 1、对各个文档数据先生成总量的词袋, 2、根据总量的词袋,各个文档数据构造各自的词向量 3、根据总量的词袋,生成待查找数据的向量, 3、通过TF-IDF模型,生成各个文档数据与待查找数据的相似度 4、通过LSI模型,生成各个文档数据与待查找数据的相似度 2、安装所需要的python库 2.1、分词库 pip3 installjieba 2.2、生成总词袋,词袋向量,TF-IDF模型,LSI模型库 pip3 insta...

pengwupeng2008的专栏 2130

Unity引擎开发:复杂动作系统_动作捕捉数据的应用与整合

通过以上步骤,我们可以在Unity中有效地应用和整合动作捕捉数据,以实现更加真实和流畅的动画效果。从导入文件格式的选择,到预处理和优化,再到实时应用和调试验证,每一步都至关重要。希望本文能帮助你在Unity项目中更好地利用动作捕捉数据,提升动画质量和性能。

chenlz2007的博客 960

Unity中语法糖带来的GC问题 ——那些看起来优雅、实际上在背后偷偷生垃圾的代码

*语法糖(Syntactic Sugar)**指的是编程语言中为了让代码更简洁、易读而提供的简便写法。比如C#中的foreachlambda表达式LINQ自动属性等。语法糖本身不是坏事,但在Unity等对GC敏感的环境下,要警惕语法糖带来的隐式内存分配。合理使用语法糖,关键场合用更“丑陋”但高效的写法,才能保证游戏流畅运行。下面我将更深入地分析Unity中语法糖导致GC的原理、具体场景、检测与优化技巧,并补充一些容易忽视的细节。

本博客聚焦游戏开发技巧、创业实战心得及大学热门课程干货。这里既有技术深度,也有思维广度,无论你是开发者、创业者还是高校学子,都能在这里找到适合自己的成长之路! 520

python文本相似度代码_Python实现简单的文本相似度分析操作详解

本文实例讲述了Python实现简单的文本相似度分析操作。分享给大家供大家参考,具体如下:学习目标:1.利用gensim包分析文档相似度2.使用jieba进行中文分词3.了解TF-IDF模型环境:Python 3.6.0 |Anaconda 4.3.1 (64-bit)工具:jupyter notebook注:为了简化问题,本文没有剔除停用词“stop-word”。实际应用中应该要剔除停用词。首先引...

weixin_39940755的博客 1795

基于STFT和卷积神经网络的时序数据分类

我们提供了相应的代码和数据,读者可以直接运行并尝试在自己的数据集上进行分类实验。在本文中,我们将介绍一种基于短时傅里叶变换(STFT)和卷积神经网络(CNN)的时序数据分类方法。我们将提供可直接运行的代码和数据,以帮助读者理解和实现这一方法。STFT可以提取信号的频谱信息,有助于捕捉时序数据中的关键特征。在这个例子中,我们将使用一个简化的手势识别数据集作为示例。在这段代码中,我们使用Adam优化器和稀疏分类交叉熵损失函数进行模型的编译。然后,我们使用训练集进行模型的训练,同时使用测试集进行模型性能的验证。

CodeWOW的博客 694

python 文本相似度_python 用gensim进行文本相似度分析

1、文本相似度计算的需求始于搜索引擎。搜索引擎需要计算“用户查询”和爬下来的众多”网页“之间的相似度,从而把最相似的排在最前返回给用户。2、主要使用的算法是tf-idftf:term frequency 词频idf:inverse document frequency 倒文档频率主要思想是:如果某个词或短语在一篇文章中出现的频率高,并且在其他文章中很少出现,则认为此词或者短语具有很好的类别区分能力...

weixin_39872893的博客 469

【Frida Android】实战篇8:客户端证书认证绕过 Hook 教程

通过重写类的方法,自定义证书校验逻辑;利用配置文件,从系统层面管理证书信任策略;以及通过 OkHttp 框架提供的方法,实现证书的强绑定校验。这些内容主要围绕客户端如何验证服务端证书的合法性展开。客户端证书认证。当 APK 预置了客户端证书,并且服务端会对客户端证书进行校验时,传统的中间人攻击方式将面临新的挑战。我们将深入分析这种场景的工作原理,并详细介绍如何通过技术手段获取客户端证书、配置中间人工具,最终成功实现抓包分析。

水滴石穿 1429

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

上一篇: Python筛选列表中指定的值,返回新列表
下一篇: Python【相关矩阵】和【协方差矩阵】
小基基o_O
博客等级 码龄9年 4414粉丝 467原创
评论 52
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

小基基o_O

您的鼓励是我创作的巨大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
