


架构
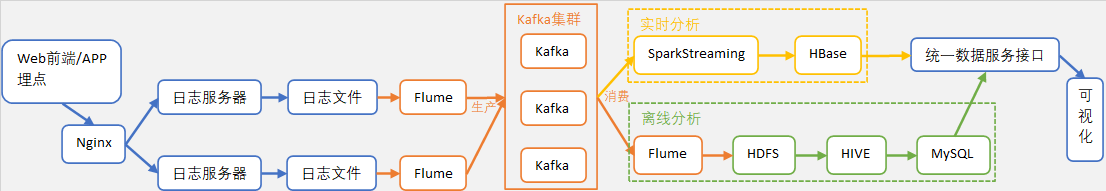
- 埋点(event tracking):用于网站分析的数据采集方法
- Nginx(engine x):高性能的HTTP和反向代理web服务器
埋点数据设计
| 数据类别 | 记录内容 | 内容示例 | 示例指标 | 字段 |
|---|---|---|---|---|
| 页面 | 页面ID、上页ID 页面类型 | 商品A页、文章B页 首页、搜索页、商品页 | pv、uv、页面跳转路径、页面跳转率 | page |
| 事件 | 操作类型 操作对象 | 输入、滑动、点击 搜索栏、商品列表、商品 | actions | |
| 曝光 | 曝光对象 曝光位置 | 商品、直播 页眉、页脚 | 商品曝光量、直播点击率 | displays |
| 启动 | 启动方式 | 点击APP图标、外源跳入 | 启动方式统计 | start |
| 错误 | 错误信息 | error | ||
| … |
{
	"timestamp": 1585744376001,
	"start": true,
	"basic_information": {
		"mobile_id": "手机ID",
		"os": "操作系统",
		"version": "APP版本号",
		"uid": "账户ID",
		"first_use": "是否首次使用"
	},
	"page": {
		"page_id": "页面ID",
		"last_page_id": "上个页面ID",
		"page_type": "商品页"
	},
	"actions": [{
		"action_id": "动作id",
		"item_id": "目标ID",
		"timestamp": 1585744376605
	}],
	"displays": [{
		"item_id": "曝光对象ID",
		"position": "曝光位置"
	}],
	"error": {
		"code": "错误码",
		"info": "错误信息"
	},
}
| 常见结构 | 示例内容 |
|---|---|
| 设备基础信息 | 设备ID 手机型号 操作系统 操作系统版本 屏幕高度和宽度… |
| 埋点基础信息 | 埋点类型:PC浏览器、手机APP、小程序 软件版本 … |
| 环境基础信息 | 时间戳 IP地址 网络类型 地区 是否首次触发事件 用户标识 … |
技术
分析指标
| 指标类别 | 示例 |
|---|---|
| 离线指标 | DAU、MAU、WAU、每日/周/月 pv、页面跳转率… |
| 实时指标 | 每小时/分钟的 pv/uv … |
离线计算demo
Python造数据写到Kafka
from time import sleep, localtime, time, strftime
from numpy.random import choice, randn
from kafka import KafkaProducer
from json import dumps

HOUR_SLEEP_PROBABILITY = {
    1: 21600, 2: 18000, 3: 14400, 4: 10800, 5: 9600, 6: 7200,
    7: 3600, 8: 3600, 9: 1800, 10: 1800, 11: 900, 12: 120,
    13: 7200, 14: 7200, 15: 7200, 16: 7200, 17: 4800, 18: 2400,
    19: 900, 20: 180, 21: 30, 22: 60, 23: 480, 0: 2400,
}
# 页面,单页最大概率=2/(n+1)
PAGES = [f'p{s}' for s in ''.join(str(i) * i for i in range(1, 9))]
# Kafka
BOOTSTRAP_SERVERS = ['localhost:9092']
TOPIC = 'EC'
KEY = b'PV'

def hour_sleep():
    """根据目前时间进行程序休眠"""
    hour = localtime().tm_hour
    sleep(HOUR_SLEEP_PROBABILITY[hour])

def get_user(frequency=100):
    return 'u%d' % int(abs(randn() * frequency))

def generate():
    while True:
        yield {
            'user_id': get_user(),
            'page_id': choice(PAGES),
            'timestamp': int(time() * 1000),
            'hms': strftime('%Y-%m-%d %H:%M:%S'),
        }
        hour_sleep()

def produce():
    # 创建生产者
    producer = KafkaProducer(
        bootstrap_servers=BOOTSTRAP_SERVERS,
        value_serializer=lambda x: dumps(x).encode())
    # 生产数据
    for dt in generate():
        producer.send(
            topic=TOPIC,
            value=dt,
            key=KEY,
            headers=[('timestamp', str(dt['timestamp']).encode())],
            partition=0)

if __name__ == '__main__':
    produce()
检验数据写到Kafka情况
kafka-console-consumer.sh \
--bootstrap-server localhost:9092 \
--topic EC \
--from-beginning
HDFS创建文件夹
# Kafka --Flume--> HDFS
hadoop fs -mkdir /user/hive/warehouse/kafka
# 库
hadoop fs -mkdir /user/hive/warehouse/ec.db
hadoop fs -mkdir /user/hive/warehouse/ec.db/ods
hadoop fs -mkdir /user/hive/warehouse/ec.db/dwd
hadoop fs -mkdir /user/hive/warehouse/ec.db/dim
hadoop fs -mkdir /user/hive/warehouse/ec.db/dws
hadoop fs -mkdir /user/hive/warehouse/ec.db/ads
Kafka数据传输到HDFS
vim kafka2hdfs.conf
# 定义agent、channel、source、sink名称,并关联
a2.sources = r2
a2.channels = c2
a2.sinks = k2
a2.sources.r2.channels = c2
a2.sinks.k2.channel = c2

# source
a2.sources.r2.type = org.apache.flume.source.kafka.KafkaSource
# kafka服务地址
a2.sources.r2.kafka.bootstrap.servers = hadoop105:9092
# 主题
a2.sources.r2.kafka.topics = EC
# 消费者组
a2.sources.r2.kafka.consumer.group.id = g3
# 消费者组第一个消费topic的数据的时候从哪里开始消费
a2.sources.r2.kafka.consumer.auto.offset.reset = earliest
# source从Kafka拉消息的批次大小
a2.sources.r2.batchSize = 50

# channel
a2.channels = c2
# channel类型:内存(断电可能会丢失数据)
a2.channels.c2.type = memory

# sink
a2.sinks.k2.type = hdfs
# 指定数据存储目录
a2.sinks.k2.hdfs.path = /user/hive/warehouse/kafka/%Y-%m-%d
# 指定滚动生成文件的时间间隔
a2.sinks.k2.hdfs.rollInterval = 3600
# 指定滚动生成文件的大小(133169152=127*1024*1024<128M)
a2.sinks.k2.hdfs.rollSize = 133169152
# 写入多少个event之后滚动生成新文件,通常选0,表示禁用
a2.sinks.k2.hdfs.rollCount = 0
# 文件写入格式:SequenceFile-序列化文件、DataStream-文本文件、CompressedStream-压缩文件
a2.sinks.k2.hdfs.fileType = CompressedStream
# 压缩方式
a2.sinks.k2.hdfs.codeC = gzip
执行Flume
flume-ng agent -n a2 -c $FLUME_HOME/conf/ -f kafka2hdfs.conf -Dflume.root.logger=INFO,console
HIVE建表
-- 建库
CREATE DATABASE `ec` COMMENT '电商'
LOCATION 'hdfs://hadoop105:8020/user/hive/warehouse/ec.db';
USE `ec`;

-- ODS层
DROP TABLE IF EXISTS `ods_pv`;
CREATE EXTERNAL TABLE `ods_pv`(
    `user_id`      STRING  COMMENT '用户ID',
    `page_id`      STRING  COMMENT '页面ID',
    `timestamp`    BIGINT  COMMENT '毫秒数',
    `hms`          TIMESTAMP  COMMENT '年月日时分秒',
    `user`         STRING  COMMENT '用户',
    `page`         STRING  COMMENT '页面'
) COMMENT '页面浏览'
PARTITIONED BY (`ymd` STRING)
ROW FORMAT SERDE 'org.apache.hadoop.hive.serde2.JsonSerDe';

-- DWD层
DROP TABLE IF EXISTS `dwd_pv`;
CREATE EXTERNAL TABLE `dwd_pv`(
    `user_id`  STRING  COMMENT '用户ID',
    `page_id`  STRING  COMMENT '页面ID'
) COMMENT '页面浏览'
PARTITIONED BY (`ymd` STRING)
STORED AS ORC
TBLPROPERTIES('orc.compress'='snappy');

-- DWS层
DROP TABLE IF EXISTS `dws_pv`;
CREATE EXTERNAL TABLE `dws_pv`(
    `user_id`  STRING  COMMENT '用户ID',
    `page_id`  STRING  COMMENT '页面ID',
    `cnt`      BIGINT  COMMENT '计数'
) COMMENT '页面浏览'
PARTITIONED BY (`ymd` STRING)
STORED AS ORC
TBLPROPERTIES('orc.compress'='snappy');

-- DWT层
DROP TABLE IF EXISTS `dwt_pv`;
CREATE EXTERNAL TABLE `dwt_pv`(
  `page_id`  STRING  COMMENT '页面ID',
  `pv_1d`    BIGINT  COMMENT 'page view',
  `pv_3d`    BIGINT  COMMENT '近3天PV',
  `pv_7d`    BIGINT  COMMENT '近7天PV',
  `uv_1d`    BIGINT  COMMENT 'unique visitor',
  `uv_3d`    BIGINT  COMMENT '近3天UV',
  `uv_7d`    BIGINT  COMMENT '近7天UV'
) COMMENT '页面浏览'
PARTITIONED BY (`ymd` STRING)
STORED AS ORC
TBLPROPERTIES('orc.compress'='snappy');
ODS=>DWD=>DWS(首次)
-- 数据装载
LOAD DATA INPATH '/user/hive/warehouse/kafka/2022-03-10' INTO TABLE ec.ods_pv
PARTITION(ymd='2022-03-10');

-- 设置动态分区
SET hive.exec.dynamic.partition=true;
SET hive.exec.dynamic.partition.mode=nonstrict;

-- ODS=>DWD
INSERT OVERWRITE TABLE dwd_pv PARTITION(ymd)
SELECT
    user_id,
    page_id,
    ymd
FROM ods_pv
WHERE hms IS NOT NULL;

-- DWD=>DWS
INSERT OVERWRITE TABLE dws_pv PARTITION(ymd)
SELECT
    user_id,
    page_id,
    COUNT(1) AS cnt,
    ymd
FROM dwd_pv
GROUP BY user_id,page_id,ymd;
ODS=>DWD=>DWS=>DWT(每日)
-- LOAD
LOAD DATA INPATH '/user/hive/warehouse/kafka/{ymd}' INTO TABLE ec.ods_pv PARTITION(ymd='{ymd}');

-- ODS=>DWD
INSERT OVERWRITE TABLE dwd_pv PARTITION(ymd='{ymd}')
SELECT user_id,page_id FROM ods_pv
WHERE ymd='{ymd}' AND hms IS NOT NULL;

-- DWD=>DWS
INSERT OVERWRITE TABLE dws_pv PARTITION(ymd='{ymd}')
SELECT
    user_id,
    page_id,
    COUNT(1) AS cnt
FROM dwd_pv
WHERE ymd='{ymd}'
GROUP BY user_id,page_id;

-- DWS=>DWT
INSERT OVERWRITE TABLE dwt_pv PARTITION(ymd='{ymd}')
-- 各页面流量(page view)
(
    SELECT
        page_id,
        SUM(if(ymd='{ymd}',cnt,0))                                 AS pv_1d,  -- 最近1天PV
        SUM(if(ymd>=DATE_ADD('{ymd}',-2),cnt,0))                   AS pv_3d,  -- 最近3天PV
        SUM(cnt)                                                   AS pv_7d,  -- 最近7天PV
        COUNT(DISTINCT(if(ymd='{ymd}',user_id,NULL)))              AS uv_1d,  -- 最近1天UV
        COUNT(DISTINCT if(ymd>=DATE_ADD('{ymd}',-2),user_id,NULL)) AS uv_3d,  -- 最近3天UV
        COUNT(DISTINCT user_id)                                    AS uv_7d   -- 最近7天UV
    FROM dws_pv
    WHERE ymd>=DATE_ADD('{ymd}',-6) AND ymd<='{ymd}'
    GROUP BY page_id
)UNION ALL(
-- 总流量(total view)
    SELECT
        '总' AS page_id,
        SUM(if(ymd='{ymd}',cnt,0))                                 AS pv_1d,  -- 最近1天PV
        SUM(if(ymd>=DATE_ADD('{ymd}',-2),cnt,0))                   AS pv_3d,  -- 最近3天PV
        SUM(cnt)                                                   AS pv_7d,  -- 最近7天PV
        COUNT(DISTINCT(if(ymd='{ymd}',user_id,NULL)))              AS uv_1d,  -- 最近1天UV
        COUNT(DISTINCT if(ymd>=DATE_ADD('{ymd}',-2),user_id,NULL)) AS uv_3d,  -- 最近3天UV
        COUNT(DISTINCT user_id)                                    AS uv_7d   -- 最近7天UV
    FROM dws_pv
    WHERE ymd>=DATE_ADD('{ymd}',-6) AND ymd<='{ymd}'
)
Python2脚本
# coding:utf-8
from sys import argv
from datetime import date, timedelta
from subprocess import check_output


class HIVE:
    def __init__(self, **kwargs):
        # 从命令行获取参数:https://blog.youkuaiyun.com/Yellow_python/article/details/122088401
        self.parameters = kwargs
        for a in argv[1:]:
            k, v = a.split('=', 1)
            self.parameters[k.strip()] = v.strip()

    @property
    def yesterday(self):
        yesterday = date.today() - timedelta(days=1)
        return yesterday.strftime('%Y-%m-%d')

    @property
    def ymd(self):
        """获取日期,格式YYYY-MM-DD,默认昨天"""
        return self.parameters.get('ymd', self.yesterday)

    def e(self, sql):
        sql = sql.format(ymd=self.ymd).replace("'", '"')
        db = self.parameters['database']  # 库名
        cmd = "hive --database '{}' -e '{}'".format(db, sql)
        print(cmd)
        return check_output(cmd, shell=True).strip()


h = HIVE(database='ec')
h.e('''
此处放入每日SQL
''')
其它补充
-- 各页面UV和PV时间序列分析
SELECT
    page_id,
    SUM(cnt) AS pv,
    COUNT(1) AS uv,
    ymd
FROM dws_pv
GROUP BY page_id,ymd
ORDER BY page_id,ymd;
-- 总UV和PV时间序列分析
SELECT
    SUM(cnt) AS pv,
    COUNT(DISTINCT user_id) AS uv,
    ymd
FROM dws_pv
GROUP BY ymd
ORDER BY ymd;

 746


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


