大数据(5e)Spark之Scala读写HBase之Phoenix表

spark通过phoenix读写hbase(Java版) pom.xml <!-- https://mvnrepository.com/artifact/org.apache.spark/spark-sql --> <dependency> <groupId>org.apache.spark</groupId> <artifactId>spar... 阅读详情

Phoenix建表

使用Phoenix对HBase建表,用于统计每小时用户数

create table uv_hour (
uid varchar,
ymdh varchar
constraint primary_key primary key (uid,ymdh)
);

依赖

<properties>
    <spark.version>3.0.3</spark.version>
</properties>

<dependencies>
    <dependency>
        <groupId>org.apache.spark</groupId>
        <artifactId>spark-core_2.12</artifactId>
        <version>${spark.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.spark</groupId>
        <artifactId>spark-sql_2.12</artifactId>
        <version>${spark.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.spark</groupId>
        <artifactId>spark-streaming_2.12</artifactId>
        <version>${spark.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.phoenix</groupId>
        <artifactId>phoenix-spark</artifactId>
        <version>5.0.0-HBase-2.0</version>
        <exclusions>
            <exclusion>
                <groupId>org.glassfish</groupId>
                <artifactId>javax.el</artifactId>
            </exclusion>
        </exclusions>
    </dependency>
</dependencies>

写

import org.apache.spark.{SparkConf, SparkContext}
import org.apache.hadoop.hbase.HBaseConfiguration // HBase配置
import org.apache.phoenix.spark._ // 隐式转换支持:saveToPhoenix
// 创建SparkContext对象
val conf = new SparkConf().setAppName("A0").setMaster("local[2]")
val sc = new SparkContext(conf)
// 创建RDD
val rdd = sc.makeRDD(Seq(
  ("u1", "2021-08-08 09"),
  ("u2", "2021-08-08 09"),
  ("u1", "2021-08-08 10"),
))
// 存HBase之Phoenix表
rdd.saveToPhoenix(
  "UV_HOUR", // 表名
  Seq("UID", "YMDH"), // 字段名
  HBaseConfiguration.create(), // HBase配置
  Some("hadoop102:2181") // ZooKeeper的URL
)

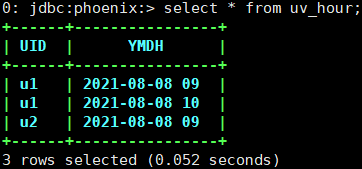
sqlline.py查看测试结果
源码截取:HBaseConfiguration.create

使用create方法创建HBase配置

public staticConfiguration create() {
  Configuration conf = new Configuration();
  // In case HBaseConfiguration is loaded from a different classloader than
  // Configuration, conf needs to be set with appropriate class loader to resolve
  // HBase resources.
  conf.setClassLoader(HBaseConfiguration.class.getClassLoader());
  return addHbaseResources(conf);
}

自动获取hbase-default.xml和hbase-site.xml配置文件信息

public static Configuration addHbaseResources(Configuration conf) {
  conf.addResource("hbase-default.xml");
  conf.addResource("hbase-site.xml");

  checkDefaultsVersion(conf);
  return conf;
}

读

import org.apache.spark.sql.SparkSession
import org.apache.phoenix.spark.toSparkSqlContextFunctions
val spark = SparkSession
  .builder()
  .appName("phoenix-test")
  .master("local[2]")
  .getOrCreate()
// 读HBase之Phoenix表
spark.sqlContext.phoenixTableAsDataFrame(
  table = "UV_HOUR",
  columns = Seq("UID", "YMDH"),
  predicate = Some("UID='u1'"),
  zkUrl = Some("hadoop102:2181"),
).show()

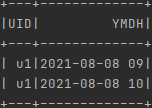
打印结果
源码截取:phoenixTableAsDataFrame

import org.apache.hadoop.conf.Configuration
import org.apache.spark.sql.{DataFrame, SQLContext}

class SparkSqlContextFunctions(@transient val sqlContext: SQLContext) extends Serializable {

  /*
  This will return a Spark DataFrame, with Phoenix types converted Spark SQL catalyst types

  'table' is the corresponding Phoenix table
  'columns' is a sequence of of columns to query
  'predicate' is a set of statements to go after a WHERE clause, e.g. "TID = 123"
  'zkUrl' is an optional Zookeeper URL to use to connect to Phoenix
  'conf' is a Hadoop Configuration object. If zkUrl is not set, the "hbase.zookeeper.quorum"
    property will be used
 */
  def phoenixTableAsDataFrame(table: String, columns: Seq[String],
                               predicate: Option[String] = None,
                               zkUrl: Option[String] = None,
                               tenantId: Option[String] = None,
                               conf: Configuration = new Configuration): DataFrame = {

    // Create the PhoenixRDD and convert it to a DataFrame
    new PhoenixRDD(sqlContext.sparkContext, table, columns, predicate, zkUrl, conf, tenantId = tenantId)
      .toDataFrame(sqlContext)
  }
}
【Spark 实战系列】Phoenix 整合 spark 进行查询分析 Phoenix 是一个开源的 HBASE SQL 层。它不仅可以使用标准的 JDBC API 替代 HBASE client API 创建表,插入和查询 HBASE,也支持二级索引、事物以及多种 SQL 层优化。 阅读详情

相关推荐

【Hbase 06】spark读写Hbase数据库以及Hbase util工具常用方法类封装(java和scala版本)

Spark处理的数据有很多是存放在HBase数据库中的,所以,我们需要学会如何读写HBase数据库。版本依赖支持关系请看博主的上一篇文章,Hbase的版本很重要,别整差了。

Alex的博客 1326

Spark读写Phoenix

Phoenix是使用Java编写的一个开源项目,基于在HBase之上的一个SQL层,能让我们通过标准的JDBC API读写HBase,而不用Scan或者get的方式,其实底层是将SQL编译成原生的HBase scans进行查询。 本文将通过Spark的方式来读写Phoenix,基于以下版本开发测试。 scala-version:2.11.8 spark-version:2.2.0 ...

weixin_44695980的博客 3800

大数据all_in环境搭建

大数据环境搭建环境介绍免密登陆jdk安装安装zookeeper安装mysqlhadoop安装安装hive安装kafkaflink安装hbase安装其他配置注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入 环境介绍 使用阿里云ecs环境,2核8G。 jdk版本 jdk-8u211-linux-x64.tar.gz zookeeper版本 apache-zookeeper-3.5.7-bin.tar.gz kafka版本 kafka_2.

m0_37556124的博客 444

Phoenix实现用SQL查询HBase

博客已转移,请借一步说话,http://www.daniubiji.cn/archives/111 HBase,一个NoSQL数据库,可存储大量非关系型数据。 HBase,可以用HBase shell进行操作,也可以用HBase Java api进行操作。HBase虽然是一个数据库,但是它的查询语句,很不太好用。要是能像使用Mysql等关系型数据库一样用sql语句操作HBase,那...

weixin_30337157的博客 593

基于Spark的共享单车数据分析毕设项目:从CSV到HBase再到前后端完整实战

在大数据时代,分布式计算框架Spark与列式存储HBase的结合,为海量数据处理提供了高效解决方案。Spark凭借内存计算和弹性分布式数据集,能并行完成数据清洗、转换与聚合;HBase则支持海量数据的实时读写与范围扫描。这种技术组合在共享单车数据分析中价值显著,可处理单日数十万条骑行记录,实现高峰时段统计、热门站点TopN等分析。典型应用场景包括毕业设计、课程大作业及大数据入门项目。本文以一份98分毕设为例,详细拆解从CSV导入HBase、Spark分析到前后端展示的完整链路,并分享环境配置、代码实现与避坑

aofan9566的博客 146

Lora无线温湿度传感器方案

综上所述,Lora无线温湿度传感器以其长距离传输、低功耗、高稳定性、精准测量、无线传输以及广泛的应用场景等特点,在环境监测领域展现出了强大的竞争力和广泛的应用前景。Lora无线温湿度传感器广泛应用于各种需要远程监控和数据采集的场景,如仓储、农业、机房、楼宇、交通、工业、矿产、电力等领域。Lora无线温湿度传感器是一种采用Lora无线通信技术进行数据传输的温湿度监测设备。四、产品参数(以某款工业级Lora温湿度传感器为例)

weixin_46632654的博客 760

大数据软件安装配置教程[Linux, JDK, MySQL, Hadoop, ZooKeeper, Hive, Flume, Kafka, HBase-Phoenix, Scala, Spark等等]

    声明: 1. 本文为我的个人复习总结, 并非那种从零基础开始普及知识 内容详细全面, 言辞官方的文章               2. 由于是个人总结, 所以用最精简的话语来写文章            

hellosrc的博客 3667

LVGL在STM32H743IIT6上的性能优化技巧:如何提升图形界面刷新速度

本文详细介绍了在STM32H743IIT6高性能MCU上优化LVGL图形界面刷新速度的实战技巧。通过利用芯片的DMA2D硬件加速模块替代低效的软件画点,将绘制缓冲区放入SDRAM并启用双缓冲机制,以及合理配置CPU缓存与MPU,有效解决了界面卡顿问题。文章还涵盖了LVGL引擎调优、内存架构优化等关键步骤,帮助开发者充分发挥STM32H743的硬件潜力,实现流畅的图形界面体验。

vscode6remote的博客 308

大数据框架安装及配置

所有脚本和配置文件内容查看请点击 0.JDK 1.解压文件 1.1可以写一个分发脚本xsync.sh方便分发配置文件和项目框架 1.2配置SSH免密,方便文件的传输 2.在/etc/profile.d/my_env.sh 文件中编写环境变量(如果没有,就创建) 3.使环境变量生效source /etc/profile 1.Hadoop 1.解压Hadoop压缩包到/opt/module目录下 2.配置环境变量,分发环境变量 3.编写配置文件hdfs-site.xml,core-site.xml,ya

m0_52725114的博客 3840

Versal ACAP NoC实战:像理解计算机网络一样配置AXI NoC,打通PS与PL数据通路

本文深入探讨了Versal ACAP NoC的配置与优化,通过计算机网络类比解析NoC架构,详细介绍了在VD100开发板上配置AXI NoC实现PS与PL数据交互的实战步骤。文章涵盖NoC组件功能、Vivado配置技巧、性能优化方法及常见问题解决方案,帮助开发者高效打通Versal芯片的数据通路。

weixin_42665255的博客 294

FunASR语音识别服务在Win11上的Docker部署避坑指南:模型配置与热词优化

本文详细介绍了在Windows 11系统上通过Docker部署FunASR语音识别服务的完整流程,包括环境准备、模型配置、热词优化及常见问题解决方案。特别针对Win11环境下的特殊配置和性能调优提供了实用指南,帮助开发者高效搭建高性能语音识别服务。

e3f4g5的博客 223

hbase集群搭建,含基于centos7的docker完整环境下载地址(hadoop、hbase、zookeeper、scala、spark、phoenix)

hadoop2.8.4+hbase2.1.0+zookeeper3.4.12集群配置,按流程配置保证能用 要点 1、 hbase和hadoop要选择能够支持的匹配版本,否则会有很多坑。可到官网查看,目前选择hadoop2.8.4、hbase2.1.0(jdk1.8+)、zookeeper3.4.12。 2、 关闭防火墙,否则也是无尽的坑,iptables千万不要yum –y remove...

bingge1022的博客 1019

基于STM32L4XX的环境光传感器(VCNL4040M3OE)应用程序设计

• 集成模块:红外发射器(IRED)、环境光传感器(ALS)、接近传感器(PS)及信号调理IC。#define VCNL4040_I2C_ADDR (0x60 << 1) // 7位地址左移一位。// 组合成16位值。// I2C总线句柄。// 设置参数:ALS集成时间160ms,中断禁止,ALS功能开启。// 设置参数:PS工作频率80Hz,开红外二极管,PS功能开启。// 初始化I2C外设。• 输出类型:I2C总线(ALS/PS)// 2. 配置环境光传感器 (ALS) 并启动。

myron6688的博客 144

07-尚硅谷大数据技术之Spark源码

spark on yarn 2.组建通信 在Spark中,组件之间的通信主要通过Spark的分布式计算框架来实现。Spark采用分布式数据集(Resilient Distributed Dataset,简称RDD)作为其核心抽象数据结构,它是分布式内存中的数据集合,可以在集群中进行并行计算和操作。组件通信的主要方式如下:RDD转换操作:Spark提供了一系列的转换操作(如map、filter、reduce、join等),通过这些转换操作,不同的组件可以对RDD进行处理和转换。例如,一个组件可以将一个RDD进

Wzideng@qq.com 1237

100天精通Python(进阶篇)——第43天:批量将PDF转Word文档(附上脚本代码)

100天精通Python(进阶篇)——第43天:批量将PDF转Word文档(附上脚本代码)

努力让自己发光,对的人才能迎着光而来 9万+

【面试系列】数据工程师高频面试题及详细解答

本文针对数据工程师岗位,提供了详尽的面试题库和解答,分为初级、中级和高级三个层次。初级面试题主要涉及基本的数据处理和ETL工具的使用,如SQL查询、数据清洗和基本的数据建模。中级面试题重点考察数据管道设计、数据库优化和大数据平台的应用。高级面试题则深入探讨高级数据处理技术、分布式系统架构和数据湖的实现。通过这些问题和解答,候选人可以全面了解数据工程师岗位所需的技能,帮助其更好地准备面试。常考知识点总结部分则系统归纳了数据工程师岗位的关键技能领域。

在路上的专栏 2376

Kafka:无丢失将kafka的值读取到hbase

目录1、需求2、代码1、需求功能:将kafka数据读取到HBASE中 步鄹: 1、提取topicName在zookeeper中的offset 2、循环读取topicName中的offset且对比zookeeper中的offset 3、将提取的数据转为DF 4、存储到Hbase中备注:博文中使用到了Zookeeper的使用,请查考下面博

辉哥大数据 5931

2025年全国青少年信息素养大赛复赛真题(算法创意实践挑战赛C++初中组试卷1:带解析)(7月6日试卷)

2025年全国青少年信息素养大赛复赛真题(算法创意实践挑战赛C++初中组试卷1:带解析)(7月6日试卷)

王老师青少年编程 1963

WSL2-Ubuntu18.04 Linux环境下部署大数据开发测试环境

目录hadoop3.2.1+Hive3.1.2+HBase2.2.4+Phoenix5.0.0+Zookeeper3.6.1+Kylin3.0.2+Kafka2.5.0+Scala2.12+Spark3.0.0+Flink1.10.1+Tez0.10.1 ...Windows子系统WSL 2 部署与应用系统设置初始化部分Mysql 安装部署配置部分WSL 下初始化服务安装部署JavaHadoop 3.2.1Hive 3.1.2HBase 2.2.4Phoenix 5.0.0Zookeeper 3.6.1Ky

你的世界是你创造的结果 1万+

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

盘点最受欢迎的十个开源大数据技术

大数据已然成为当今最热门的技术之一,正呈爆炸式增长。每天来自全球的新项目如雨后春笋般涌现。幸运地是,开源让越来越多的项目可以直接采用大数据技术,下面就来盘点最受欢迎的十大开源的大数据技术。 1.Hadoop——高效、可靠、可伸缩,能够为你的数据存储项目提供所需的YARN、HDFS和基础架构,并且运行主要的大数据服务和应用程序。 2.Spark——使用...

weixin_34418883的博客 85

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

统一环境配置 - CentOS6大数据套件HA安装(1)

  软件版本 jdk-8u172-linux-x64.rpm   scala-2.12.5.tgz zookeeper.tar.gz hadoop-2.7.6.tar.gz spark-2.2.1-bin-hadoop2.7.tgz hbase-1.2.6-bin.tar.gz apache-phoenix-4.13.1-HBase-1.2-bin.tar.gz 服务器规划 ...

xbing的博客 321

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

数据学习路

第一阶段JavaSE + MySql + Linux Java基础 → OOP编程 →Java集合→ IO/NIO → Eclipse → Intellij IDEA → Socket网络技术 → Mysql 数据库 → JDBC Api → JVM内存结构 → 阶段项目实战 → Linux(VMware、CentOS、目录结构、Linux命令) 第二阶段Hadoop 与 生态系统 Hado...

bighacker的博客 1338

phoenix+hbase+Spark整合,Spark处理数据操作phoenix入hbase,Spring Cloud整合phoenix

1 版本要求 Spark版本:spark-2.3.0-bin-hadoop2.7 Phoenix版本:apache-phoenix-4.14.1-HBase-1.4-bin HBASE版本:hbase-1.4.2 上面的版本必须是对应的,否则会报错 2 Phoenix + HBase + Spark整合 A:安装HBASE,这里略,默认都会 B:Phoenix + HBASE整合,参考:ht...

涂作权的博客 8092

spark-整合Phoenix将数据写入Hbase

文章目录一 环境准备1.1 pom文件1.2 config配置:1.3 properties解析工具类1.4 HbaseUtil工具类1.5 kafkaUtil根据指定的topic返回对应的Dstream1.6 jedisUtils从连接池中获取Jedis连接实例1.7 样例类二 Spark直接将数据写入Hbase三 Spark整合Phoenix将数据写入hbase四遇到的问题问题1 :Phoen...

Master_chaoAndQi的博客 3081

spark sql hbase java_Spark 读写 HBase 的两种方式(RDD、DataFrame)

使用 saveAsHadoopDataset 写入数据import org.apache.hadoop.hbase.{HBaseConfiguration, HTableDescriptor, TableName}import org.apache.hadoop.hbase.client.{HBaseAdmin, Put, Result}import org.apache.hadoop.hbase...

weixin_34178408的博客 463

客户端,Scala:Spark查询Phoenix

客户端,Scala:Spark查询Phoenix1.pom.xml2.配置文件2.1config.properties2.2MyConfig3.entity实体(与phoenix中的table互相对应)4.Util5.scala,客户端查询Phoenix中的数据5.1 method15.2 method2 IDEA中,使用spark操作Phoenix中的数据,scala语言编写。 首先附上pom....

爱是与世界平行 1279
上一篇: 大数据(4h)Kafka经验小结(不定更)
下一篇: 大数据(0d)埋点日志分析
小基基o_O
博客等级 码龄9年 4414粉丝 467原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

小基基o_O

您的鼓励是我创作的巨大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值