大数据(5a)HBase入门:安装、读写、架构、数据视图、数据模型

大数据之HBase Apache HBase摘要 Apache HBase是一个基于HDFS的分布式、可扩展NoSQL数据库,采用稀疏多维排序映射的数据模型。其核心特点包括: 数据模型: 采用行键(Byte数组)、列族和时间戳的多维映射 支持动态列和稀疏存储 数据按RowKey字典序排序 架构组成: Master:负责元数据管理和Region分配 RegionServer:处理数据读写请求 依赖Zookeeper进行协调 底层存储使用HDFS 部署要求: 需要预先安装Zookeeper和Hadoop 支持分布式集群部署 数据默 阅读详情

Hbase简介

  • HBase是一种分布式、可扩展、支持海量数据存储的NoSQL数据库
  • 数据存储在HDFS
  • 物理存储结构【Key-Value】型,就像一个多维Map
  • 特性:
    延时低(冷热数据思想)
    Key-Value可以映射为二维表,可作为巨型单表作为查询
    提供 数据多版本溯源 功能
  • 使用场景:
    存储海量实时计算结果数据
    字段会变更的场景
  • 官网:http://hbase.apache.org/

HBase集群部署

名称下载地址本文版本
HBasehttps://mirrors.bfsu.edu.cn/apache/hbase/2.4.2
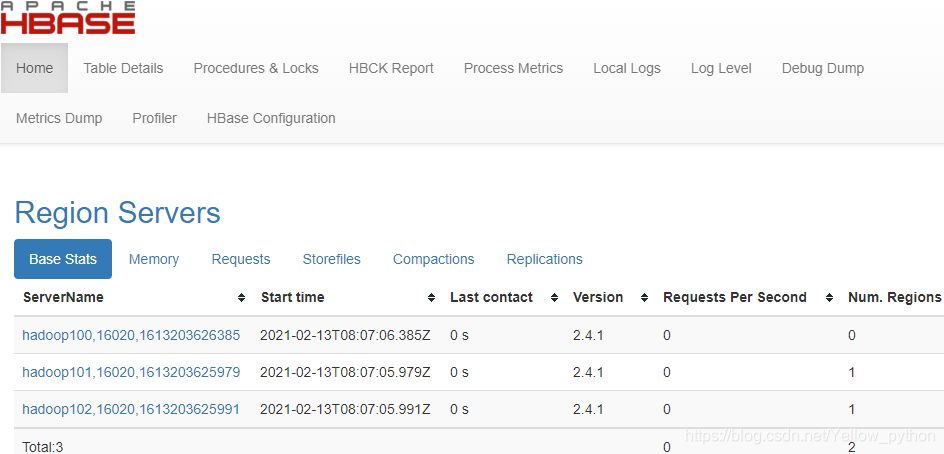
集群规划服务名hadoop100hadoop101hadoop102
HBaseHMaster11
HBaseHRegionServer111

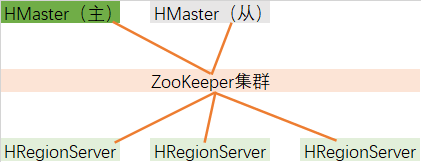
HMaster借助ZooKeeper来管理HRegionServer

1、依赖

  1. 预装Hadoop、ZooKeeper集群并启动
  2. 集群环境变量添加HBASE_HOME

2、上传HBase、解压、改名

tar -zxf hbase-2.4.2-bin.tar.gz -C /opt/
cd /opt
mv hbase-2.4.2 hbase

3、配置文件

cd $HBASE_HOME/conf/

3.1、hbase-env.sh

vi hbase-env.sh

在vim可以用:/HBASE_MANAGES_ZK查找

export HBASE_MANAGES_ZK=false

不启用HBase自带ZooKeeper,而使用自己装的ZooKeeper

3.2、hbase-site.xml

vi hbase-site.xml

加入到configuration里面

<!-- 数据存储到HDFS的哪里 -->
<property>
    <name>hbase.rootdir</name>
    <value>hdfs://hadoop100:8020/hbase</value>
</property>
<!-- 是否启用分布式集群:false是单机模式,true是分布式模式 -->
<property>
    <name>hbase.cluster.distributed</name>
    <value>true</value>
</property>
<!-- ZooKeeper集群地址 -->
<property>
    <name>hbase.zookeeper.quorum</name>
    <value>hadoop100,hadoop101,hadoop102</value>
</property>
<!-- 是否开启安全性检查,此处关闭 -->
<property>
    <name>hbase.unsafe.stream.capability.enforce</name>
    <value>false</value>
</property>

重要补充:如果Hadoop是高可用的,那么就要用Hadoop的高可用集群名称

<property>
    <name>hbase.rootdir</name>
    <value>hdfs://myha/hbase</value>
</property>

3.3、regionservers

echo hadoop100 > regionservers
echo hadoop101 >> regionservers
echo hadoop102 >> regionservers
cat regionservers

或

cat $HADOOP_HOME/etc/hadoop/workers > regionservers
cat regionservers

3.4、backup-masters【高可用】

echo hadoop101 > backup-masters

4、解决日志冲突

cd $HBASE_HOME/lib/client-facing-thirdparty/
mv slf4j-log4j12-1.7.30.jar slf4j-log4j12-1.7.30.jar.backup

5、文件分发

rsync -a $HBASE_HOME/ hadoop101:$HBASE_HOME/
rsync -a $HBASE_HOME/ hadoop102:$HBASE_HOME/

6、启停命令

启动前请确保ZooKeeper和Hadoop服务正在运行

start-hbase.sh
stop-hbase.sh

7、浏览器访问

端口16010

常用命令

进入客户端

hbase shell
常用命令说明
create_namespace创建命名空间(类似MySQL建库)
list_namespace查看有哪些命名空间
create创建(类似MySQL建表)
scan扫描(查数据)
put写数据
get读数据(查数据)
disable禁用
delete删除
drop终止
quit退出

操作

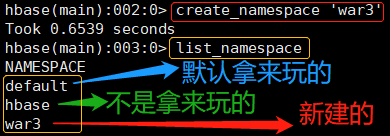
# 1、创建命名空间(相当于MySQL建库);查看有哪些命名空间
create_namespace 'war3'
list_namespace

# 2、创建表;查看表信息
create 'war3.hero','base_info','extra_info'
describe 'war3.hero'

# 3、插入数据到表
put 'war3.hero','I001','base_info:name','剑圣'
put 'war3.hero','I002','base_info:name','KOG'
put 'war3.hero','I002','extra_info:halo','荆棘'
put 'war3.hero','I003','base_info:name','守望者'
put 'war3.hero','I003','base_info:gender','女'
put 'war3.hero','I003','extra_info:weapon','丝袜'

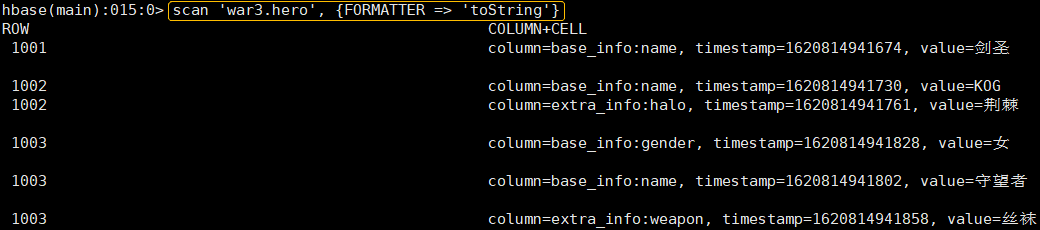
# 4、扫描查看表数据(FORMATTER => 'toString'用来显示中文)
scan 'war3.hero',{FORMATTER => 'toString'}
scan 'war3.hero',{STARTROW => '1001', STOPROW  => '1003', FORMATTER => 'toString'}

# 5、查看【某个表】的【指定行】和【指定列】
get 'war3.hero','1002','base_info:name'

# 6、统计表数据行数
count 'war3.hero'

# 7、删除数据
## 7.1、删除某rowkey的全部数据:
deleteall 'war3.hero','1002'
## 7.2、删除某rowkey的某列数据:
delete 'war3.hero','1003','base_info:gender'

# 8、清空表数据
truncate 'war3.hero'

# 9、删除表
## 9.1、首先需要先让该表为disable状态:
disable 'war3.hero'
## 9.2、然后才能drop这个表:
drop 'war3.hero'

## 10、退出
quit

创建命名空间(建库);查看有哪些命名空间
全表扫描
逻辑视图 & 物理视图
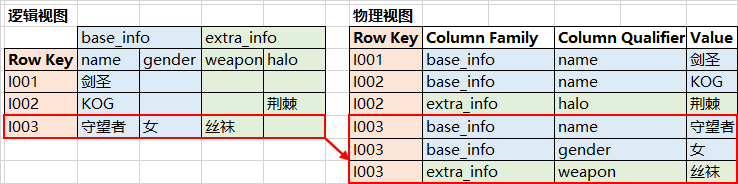
原理补充

架构简图
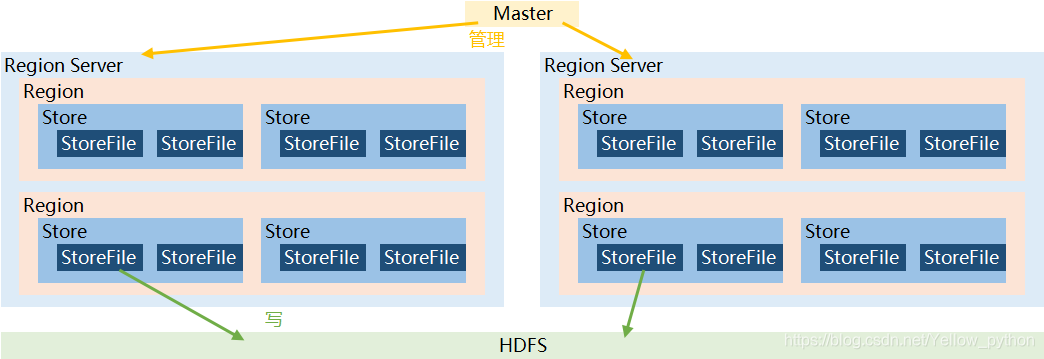
Master是Region Server的管理者
实现类:HMaster
对于表的操作:create、delete、alter

Region Server是Region的管理者
实现类:HRegionServer
对于数据的操作:get、put、delete
对Region操作,例如:Region切分…

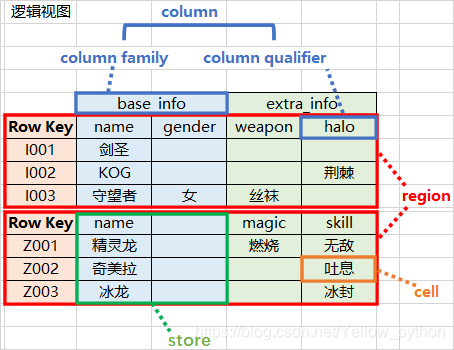
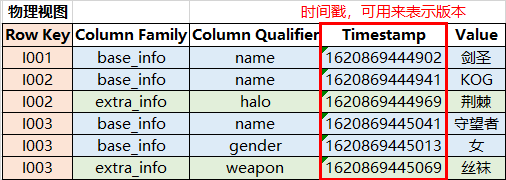
概念视图(Conceptual View)、物理视图(Physical View)

概念视图(Conceptual View)
物理视图(Physical View)
store
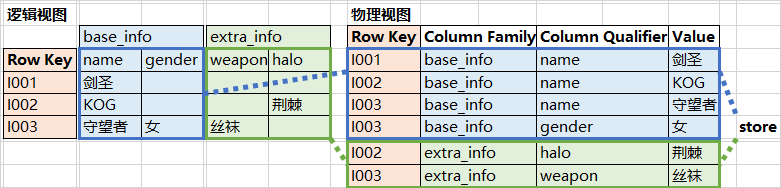
数据模型(Data Model)

数据模型说明补充说明
NameSpace命名空间;每个namespace下面有多个table
table由多个row组成
rowA row in HBase consists of a row key and one or more columns with values associated with themrow储存按row key的字母顺序排列
column由 1个column family 和 1个column qualifier 组成用冒号:分隔
cellrow、column family和column qualifier3者联合确定包含 1个value 和 1个timestamp
timestamp伴随value写入,可作为版本的标识符默认是RegionServer的时间,也可指定
Column Family
Column families physically colocate a set of columns and their values, often for performance reasons. Each column family has a set of storage properties, such as whether its values should be cached in memory, how its data is compressed or its row keys are encoded, and others. Each row in a table has the same column families, though a given row might not store anything in a given column family.
Column Qualifier
A column qualifier is added to a column family to provide the index for a given piece of data. Given a column family content, a column qualifier might be content:html, and another might be content:pdf. Though column families are fixed at table creation, column qualifiers are mutable and may differ greatly between rows.

Appendix

en🔉cn
quorumˈkwɔːrəmn. 法定人数
thirdpartythird partyn. 第三者,第三方
conceptualkənˈseptʃuəladj. 概念上的
familyˈfæməlin. 家庭;[化]族;adj. 家庭的;家族的
qualifierˈkwɑːlɪfaɪərn. [语] 修饰语;限定符;修饰符;资格赛;取得资格的人
mutableˈmjuːtəbladj. 可变的;易变的
compactionkəmˈpækʃənn. 压紧;精简;密封;凝结
大数据原理与技术(五):分布式数据库HBase HBase是基于谷歌Bigtable开发的开源分布式数据库,具有高可靠、高性能、面向列、可伸缩等特点。HBase一般运行在HDFS上,主要用来存储非结构化和半结构化数据。HBase通过水平扩展的方式实现大表数据(表的规模可以达到数十亿行以及数百万列)的存储,对大表数据的读、写访问达到实时级别。 文章目录一、HBase概述1.HBase简介2.HBase与传统关系型数据库的区别3.HBase的应用场景二、HBase的相关概念1.数据模型概述2.HBase的数据模型3.数据坐标4.概念视图5.物理视图6.行存储 阅读详情

相关推荐

大数据学习指南从入门到精通

利用框架的力量,看懂游戏规则,才是入行的前提大多数人不懂,不会,不做,才是你的机会,你得行动,不能畏首畏尾选择才是拉差距关键,风向,比你流的汗水重要一万倍,逆风划船要累死人的为什么选择学习大数据开发,不选择Java开发?借棋弈做比喻,智商高的不要选择五子琪,要选择围棋,它能长久地吸引你。不都是在棋盘上一颗黑子一颗白子地下吗?因为围棋更复杂,能够掌握如此复杂的技艺、产生稳定输出的棋手、让我们更佩服。选择学习大数据开发也如此,能让你的职业生涯走得更远,少走弯路。

Lansonli(蓝深李)的博客 2万+

【大数据】Hive DDL 操作与视图讲解

Hive是建立在Hadoop上的数据仓库工具,它允许用户通过类SQL的语法来查询和管理数据。在Hive中,DDL(数据定义语言)和视图操作是非常常见的。用语句来查看视图定义。总之,Hive中的DDL操作和视图操作可以帮助用户定义和管理表、视图等数据结构,从而更加灵活和高效地管理和查询数据。用户可以根据实际需求选择使用哪种操作方式,以达到更好的数据管理和操作效果。

匠人精神,持之以恒! 1100

大数据全景版图

大数据行业的全景版图,看看你的定位在哪里 包含大数据平台、架构、大数据细分领域的应用 所有的厂商

大数据开发之Hive篇8-Hive视图

备注: Hive 版本 2.1.1 文章目录一.Hive视图介绍二.视图案例2.1 视图能够简化用户内的操作2.2 视图使用户能以多种角度看待同一数据2.3 视图对重构数据库提供了一定程度的逻辑独立性 前言: 视图是从一个或几个基本表导出的表。视图本身不独立存储在数据库中,是一个虚表。 即数据库中只存放视图的定义而不存放视图对应的数据,这些数据仍存放在导出视图的基本表中。 视图在概念上与基本表等同,用户可以如同基本表那样使用视图,可以在视图上再定义视图。 引进VIEW的优点有: (1)视图能够简化用户内的操

只是甲的博客 2487

黏菌算法(Slime Mould Algorithm,SMA)

这是一篇关于黏菌算法的总结博客,包含算法思想,算法步骤,求函数最值(Python实现),算法改进等,持续更新ing

weixin_46838605的博客 1万+

Duplicate Cleaner Pro 5.16 保姆级教程:如何用哈希值精准清理重复文件(附音频/视频模式详解)

本文详细介绍了Duplicate Cleaner Pro 5.16如何利用哈希值技术精准清理重复文件,特别针对音频、视频和图片等多媒体文件提供了专业解决方案。通过哈希算法比对和多媒体特征识别,帮助用户高效管理存储空间,提升文件整理效率。

weixin_27032989的博客 569

Oracle视图

视图:从表中抽出的逻辑上相关的数据集合。 序列:提供有规律的数值。 索引:提高查询的效率 视图是一种虚表。 视图建立在已有表的基础上, 视图赖以建立的这些表称为基表。 向视图提供数据内容的语句为SELECT 语句, 存可以将视图理解为存储起来的SELECT 语句. 视图向用户提供基表数据的另一种表现形式 使用视图的原因 控制数据访问 简化查询 避免重复访问相同的数据 创建视图 1.在CREATE...

墨香书生的博客 283

DFX从芯片到系统:可制造性、可测试性与可靠性设计实战指南

DFX(Design for eXcellence)是一套面向产品全生命周期的设计方法论,涵盖可制造性(DFM)、可测试性(DFT)、可靠性(DFR)等维度。其核心原理是将制造、测试、维护等环节的约束前置到设计阶段,从而降低流片与量产风险。在芯片与系统硬件领域,DFX不仅是提升良率与测试效率的关键手段,更是保障车规、工控等严苛场景下长期稳定运行的基础。从芯片物理实现到PCB布局,再到系统级散热与维护设计,DFX的落地需要工具链、流程闸门与跨部门协作的体系化支撑。本文基于实际项目经验,分享DFX从设计决策到工

weixin_32349093的博客 351

大数据——MySQL触发器、视图、函数和存储过程

MySQL触发器、视图、函数和存储过程触发器什么是MySQL的触发器定义触发器多个触发语句MySQL查看触发器MySQL触发器中的新旧记录MySQL视图什么是视图视图的作用作用1:提高重用性作用2:对外接口稳定作用3:提高安全性作用4:目的更明确,数据更清晰视图的创建与使用存储过程与UDF函数存储过程的定义UDF自定义函数的定义 触发器 什么是MySQL的触发器 触发器用来在某些操作时,“自动”执行一些操作。 当insert delete update设置触发器之后,执行insert delete upda

蜂蜜柚子加苦茶 497

学习记录——SIMPACK生成轨道谱文件的方法

生成轨道谱文件的方法,可以用于实测轨道谱导入和自制轨道谱导入仿真

weixin_51965897的博客 7805

Ubuntu桌面消失?可能是lightdm配置在捣鬼:详细解析/etc/lightdm.conf的优先级机制与实战修复

本文详细解析了Ubuntu系统因lightdm显示管理器配置错误导致桌面消失的问题。通过分析/etc/lightdm.conf的优先级加载机制,提供了从systemctl诊断、调试模式运行到实战修复配置语法错误(如缺失[Seat:*]组)的完整方案。文章还探讨了在系统无法启动时使用chroot或恢复模式进行高级救援,并对比了lightdm与gdm3在NVIDIA驱动环境下的不同表现,帮助用户高效恢复图形界面。

weixin_29313547的博客 420

数据库的视图详解

数据库的视图是一个虚拟表,它是通过执行存储的查询语句来生成的,而不是实际存储数据的表。增强数据一致性:通过视图,可以确保多个用户或应用程序访问相同的数据视图,从而提高了数据的一致性和可靠性。重用查询逻辑:通过创建视图,可以将常用的查询逻辑封装在一个可重用的视图中,从而减少了重复编写相同查询的工作量。重用查询逻辑:通过创建视图,可以将常用的查询逻辑封装在一个可重用的视图中,从而减少重复编写相同查询的工作量。数据一致性:通过视图,可以确保多个用户或应用程序访问相同的数据视图,从而提高数据的一致性和可靠性。

一个专注于技术研究创新的程序员 716

使用R语言绘制Logistic回归模型的亚组分析森林图

亚组分析是一种常用的统计方法,用于探索不同亚组之间的差异,并确定是否存在某些变量对结果的调节作用。在本文中,我们将使用R语言来绘制Logistic回归模型的亚组分析森林图。在该图中,每个亚组都用一个点表示,点的位置表示亚组的均值,而线段表示亚组的置信区间。垂直参考线用于表示效应值为0的点,帮助我们判断亚组之间的差异。希望本文对你有所帮助,让你能够使用R语言绘制Logistic回归模型的亚组分析森林图。是一个二分类的变量,我们希望在亚组分析中探索它与响应变量之间的关系。函数来计算每个亚组的均值,并使用。

PixelNinja的博客 2006

【大数据存储与管理】分布式数据库HBase:03 HBase数据模型

本文讲解HBase数据模型。HBase是稀疏多维映射表,按列族存储数据,借鉴列式存储格式,支持多版本数据存储,适用于查询密集型系统。

Morse_Chen的博客 1378

华为OD机试真题 新系统 - 8位LED控制器 (Java/Py/C/C++/Js/Go)

本文整理华为 OD 机试新系统机考真题库,涵盖高频考点精析与完整题目内容,提供 C 语言、Java、C++、Python、Go、JavaScript 多语言源码实现,搭配详细解题思路讲解,并支持在线 OJ 刷题练习,助力高效备考华为 OD 机试新系统。

算法大师! 1978

学Simulink——基于Simulink的输入-输出线性化精确转矩控制

本文详细介绍了基于Simulink的永磁同步电机(PMSM)输入-输出线性化(IOL)精确转矩控制方法。针对传统解耦控制在非线性转矩特性下的局限性,提出通过精确反馈线性化实现转矩指令与实际转矩的严格线性关系。文章系统阐述了IOL原理、PMSM控制器推导过程,并提供了完整的Simulink建模步骤,包括电机模型搭建、IOL控制器实现和闭环系统构建。通过仿真对比验证了IOL方法在转矩跟踪精度、动态响应和参数鲁棒性方面的显著优势,最后讨论了工程实现要点和扩展应用方向。该方法为高性能伺服系统开发提供了有效解决方案。

amy_mhd的博客 61

Springboot整合HBase——大数据技术之HBase2.x

Apache HBase 是以hdfs为数据存储的,一种分布式、可扩展的noSql数据库。是一个高可靠性、高性能、面向列、可伸缩的分布式存储系统,利用HBase技术可在廉价PC Server上搭建起大规模结构化存储集群。HBase使用与BigTable(BigTable是一个稀疏的、分布式的、持久化的多维排序map)非常相似的数据模型。用户将数据行存储在带标签的表中。数据行具有可排序的键和任意数量的列。该表存储稀疏,因此如果用户喜欢,同一表中的行可以具有疯狂变化的列。

qq_43842093的博客 4829

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

大数据技术之HBase

大数据技术之HBase

我从不打没有准备的仗! 1万+

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

hbase原理架构总结

什么是Hbase Hbase是一个高可靠、高性能、面向列、可伸缩的分布式存储系统,利用Hbase技术可在廉价的PC Server上搭建大规模结构化存储集群。 利用Hadoop HDFS作为其文件存储系统,利用Hadoop MapReduce来处理 Hbase中的海量数据,利用Zookeeper作为其分布式协同服务 主要用来存储非结构化和半结构化的松散数据(列存NoSQL数据库) Hbase是Google BigTable的开源实现,与Google BigTable利用GFS作为其文件存储系统类似,H

qq_44671288的博客 2890

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

【非关系型分布式数据库】HBase从入门到深入学习总结

非关系型分布式数据库 —— HBase内容学习整理,如有错误,欢迎评论区交流指出。

不积跬步,无以至千里 1349

大数据之HBase入门到精通

Hadoop Database,是一个高可靠性、高性能、面向列、可伸缩、实时读写的分布式数据库。利用Hadoop HDFS作为其文件存储系统,利用Zookeeper作为其分布式协同服务主要用来存储非结构化和半结构化的松散数据(列存 NoSQL 数据库,通过键值对的形式进行查询key-value)。

每日小新 1735

Hbase史上最详细原理总结

什么是Hbase Hbase是一个高可靠、高性能、面向列、可伸缩的分布式存储系统,利用Hbase技术可在廉价的PC Server上搭建大规模结构化存储集群。 利用Hadoop HDFS作为其文件存储系统,利用Hadoop MapReduce来处理 Hbase中的海量数据,利用Zookeeper作为其分布式协同服务 主要用来存储非结构化和半结构化的松散数据(列存NoSQL数据库) Hbase...

二十同学 7万+

HBase(一): HBase 表结构及数据模型和架构的理解

大数据领域常用存储介绍对比: HDFS: NOSQL Hive:有SQL 慢 HBase: NoSQL 快 (Phoenix + HBase) Kudu: Impala + Kudu 组合 CASSAndra HBase 表概念: 一个HBase表由一个或者多个列祖(CF)组成,一个列族又包含很多列(限定符,CQ),没列存储相对应的值,和传统的关系型数据库不一样HBase是稀疏表,一些列...

Java大数据 1662

Hbase特点、架构、数据模型

1. Hbase是什么 HBase 是一个开源的、分布式的、版本化的非关系型数据库,它利用 Hadoop 分布式文件系统(Hadoop Distributed File System,HDFS)提供分布式数据存储。 HBase 是非关系型数据库,它不具备关系型数据库的一些特点,例如,它不支持 SQL 的跨行事务,也不要求数据之间有严格的关系,同时它允许在同一列的不同行中存储不同类型的数据。 尽管已经有许多数据存储和访问的策略和实现方法,但事实上大多数解决方案,特别是一些关系类型的,在构建时并没有考虑超大规模

weixin_43557605的博客 1109

Hbas简介:数据模型和概念、物理视图

HBase 是谷歌 BigTable 的开源实现,是一个高可靠、高性能、面向列、可伸缩的分布式非关系型数据库,主要用来存储非结构化和半结构化的松散数据,并提供高吞吐量和低延迟的数据访问能力。HBase的架构是基于Hadoop生态系统的,它使用HDFS作为底层存储系统;并利用 Hadoop MapReduce来处理 HBase 中的海量数据,实现高性能计算;利用 ZooKeeper 作为协同服务,实现稳定服务和失败恢复。

缘友一世的博客 2229

大数据技术原理与应用之【HBase】习题

1.试述在Hadoop体系架构中HBase与其他组成部分的相互关系 答: HBase利用Hadoop MapReduce来处理HBase中的海量数据,实现高性能计算;利用Zookeeper作为协同服务,实现稳定服务和失败恢复;使用HDFS作为高可靠的底层存储,利用廉价集群提供海量数据存储能力; Sqoop为HBase的底层数据导入功能,Pig和Hive为HBase提供了高层语言支持,HBase是B...

大数据梦想家 1万+
上一篇: 大数据(8x)机器学习库SparkML
下一篇: 大数据(8l)运费分摊
小基基o_O
博客等级 码龄9年 4414粉丝 467原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

小基基o_O

您的鼓励是我创作的巨大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值