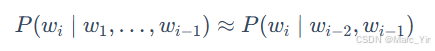HelloAgents学习:PartⅠChapterⅡ语言模型&架构

从零开始学习使用 AI 欢迎踏入ClaudeCode未来世界,开启与AI协作的全新旅程。无论你是零基础新手、开发者,还是非程序员,都能通过实战项目快速掌握智能体协作技能——不再只是提问,而是指挥AI完成复杂任务。你将化身主角,在16个级别、200+实践中成长为高效创造者。真正的优势不再是会用工具,而是懂得如何让智能体为你工作。取代你的不是AI,而是会用AI的人。现在,故事从你开始👇 阅读详情

语言模型&Transformer架构

从N-gram到RNN

语言模型Language Model是自然余元处理的核心,根本任务是计算一个词序列(也就是句子)出现的概率。一个好的语言模型能够告诉我们什么样的句子是通顺的、自然的。在多智能体系统中,语言模型是智能体理解人类指令、生成回应的基础。

统计语言模型&N-gram思想

深度学习兴起之前,统计方法是语言模型的主流。

核心思想:一个句子出现概率=该句子中每个词出现的条件概率的连乘。

对于由词w1,w2,⋯,wm构成的句子S,出现的概率P(S)可以表示为:
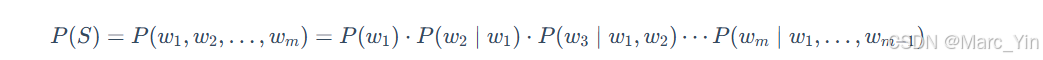
该公式被称为概率的链式法则。然而,直接计算这个公式几乎是不可能的,因为像:

这样的条件概率难以从语料库中及进行估计
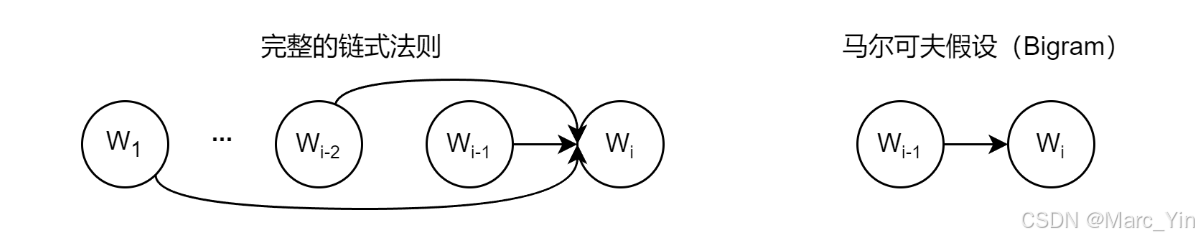
为了解决上述计算难题,研究者引入了马尔可夫假设。

核心思想:不必回溯一个词的全部历史。我们可以近似认为一个词出现的概率只和前面的有限的n-1个词相关。

基于上述假设建立的语言模型称为N-gram模型。

这里的N代表我们考虑的上下文窗口大小。

  • Bigram(N=2):最简单情况,认为当前词出现只和前面的一个词有关。链式法则中复杂的条件概率变为更容易计算形式:
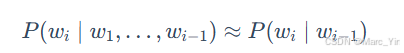
  • Trigram(N=3):假设一个词出现只和前面两个词相关:

那么这些概率本身该如何计算呢?

通过在大型语料库中进行 最大似然估计Maximum Likelihood Estimation 进行计算。

本质思想:最可能出现的就是我们在数据中看到最多的。

N-gram模型虽然简单有效,但是存在两个致命缺陷:

  1. 数据稀疏性:若一个词序本身没有在语料库中出现的话,概率估计就是0,这显然是不合理的。

  2. 泛化能力差:模型无法理解词与词之间的语义相似性。即使语料库中出现了很多次的agent learns但是它也无法将其泛化到类似的词上。当我们计算robot learns 若robot这个词本身没有出现过,或者这个组合没有出现过,模型计算的概率也会是0。模型无法理解agent和robot之间语义的相似性。

神经网络语言模型&词嵌入

N-gram模型根本缺陷在于它将词视为孤立、离散的符号。新思想:使用连续的向量表示词。

前馈神经网络语言模型Feedforward Neural Network Language Model是这领域的里程碑。

核心思想分为两步:

  1. 构建一个语义空间:创建一个高维的连续向量空间,然后将词汇表中的每个词都映射为该空间的一个点。这个点——即向量,被称为词嵌入(Word Embedding)/词向量。这个空间上,语义相近的词,空间中位置也相近。

  2. 学习从上下文到下一个词的映射:利用神经网络强大的拟合能力,学习一个函数。这个函数的输入是前n-1个词的词向量,输出是词汇表中每个词在当前上下文后出现的概率分布。
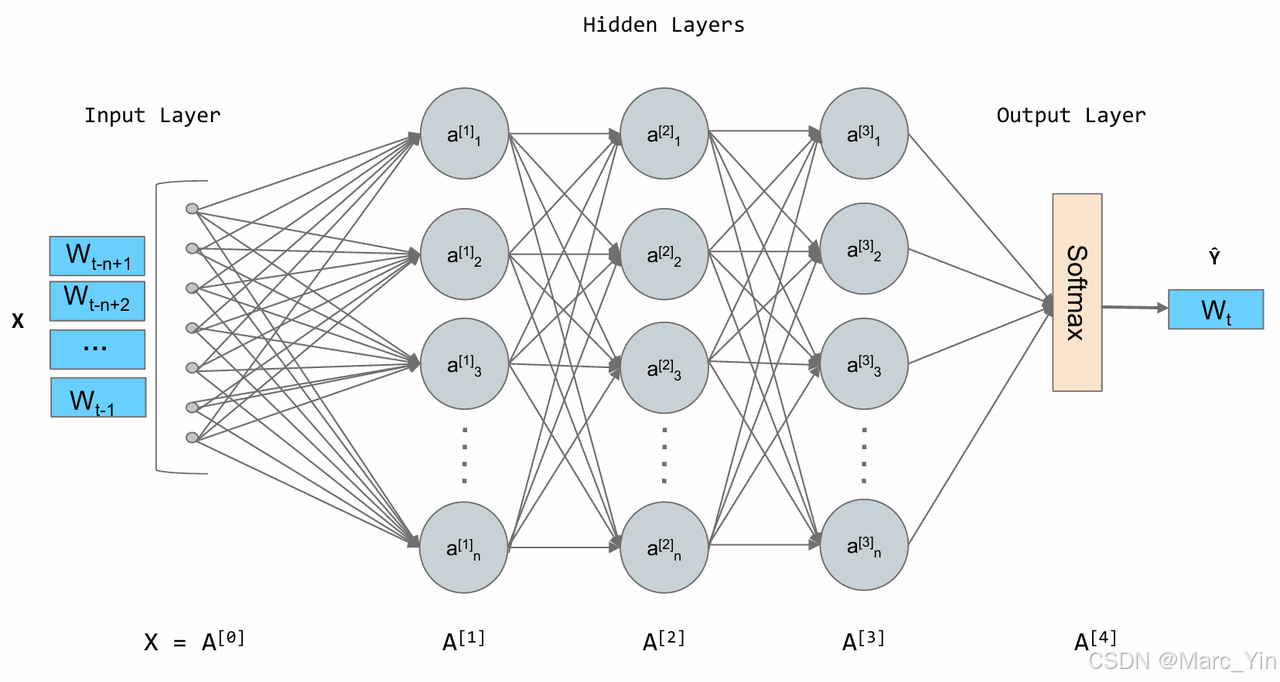
如上图所示,在这个架构中,词嵌入是在模型想你连过程中自动学习到的。模型为了完成“预测下一个词”这个任务,会不断调整每个词的向量位置,最终让这些向量能够蕴含丰富的语义信息。一旦我们将词转换为想i昂,我们就可以用数学工具度量他们之间的关系。

最常用方法:余弦相似度Cosine Similarity

通过计算两向量间夹角的余弦值衡量他们的相似性。
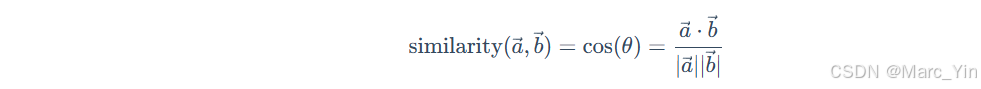
公式含义:

  • 如果两个向量方向完全相同,夹角为0°,余弦值为1,表示完全相关。

  • 如果两个向量方向正交,夹角为90°,余弦值为0,表示毫无关系。

  • 如果两个向量方向完全相反,夹角为180°,余弦值为-1,表示完全负相关。

通过上述计算,不仅能够捕捉到“同义词”这类简单关系,还能捕捉到更加复杂的相似关系、反义关系。

甚至:

vector('King') - vector('Man') + vector('Woman')

和

vector('Queen')

两者在向量空间中的位置惊人的接近。

证明词向量学习到了“性别”“皇室”等概念。

神经网络语言模型通过词嵌入,成功解决了N-gram模型泛化能力差的问题。然而,它仍然有一个类似N-gram的限制:上下文窗口固定。只能考虑固定数量的上下文,这为能处理任意长序列的循环神经网络埋下伏笔。

循环神经网络RNN&长短时记忆网络LSTM

神经网络语言虽然解决了泛化问题,但是和N-gram模型一样,上下文窗口大小是固定的。为了预测下一个词,只能看到n-1个词,再早期的历史就被丢弃了,显然不符合人类理解语言的方式。

为了打破固定窗口限制,循环神经网络Recurrent Nerual Network出现了

核心思想:为网络增加记忆能力

RNN引入了一个隐藏状态hidden state 向量,我们可以将其理解为网络的短期记忆。处理序列的每一步,网络都会读取当前的书如此,并集合上一刻的短期记忆(上一个时间的隐藏状态)生成一个新的记忆(当前时刻隐藏状态)传递给下一时刻。这个循环往复的过程是的信息可以在序列中不断向后传递。
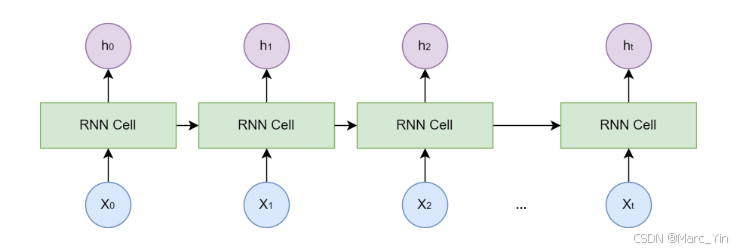
然而,标准的RNN在时间过程当中存在严重的一个问题——长期依赖问题 Long-term Dependency Problem。

训练过程中,模型需要使用反向传播算法根据输出端误差调整网络深处权重。

可以理解为:

  • 最后一步预测出错了

  • 错误一层层往回传递

  • 使用梯度指导调整前面的的参数

存在的问题:

每往前传递一层,梯度(反向传播用)都会被乘一次

进而导致两种极端情况:

  1. 梯度消失:每次乘的数都小于1,梯度越来越接近0,前面的层几乎收不到训练信号,导致模型学习不到早期信息

  2. 梯度爆炸:每次乘的数都大于1,梯度越来越大,参数更新失控,训练不稳定甚至崩溃

最终导致模型难以学习序列中远距离信息依赖。信息传递越远,越容易导致信息被淡化失真,表现为“忘记前面的重要信息”

为了解决长期依赖问题,长短时记忆网络 Long Short Term Memory / LSTM 被设计出来。LSTM是一种特殊的RNN,核心在于引入细胞状态 Cell State和一套精密的门控机制Gating Mechanism

细胞状态:

一条贯穿整个序列的“主干信息通道”,专门负责保存长期记忆。

门控机制:

信息开关系统,通过“门”控制信息流入、保留、流出

  1. 遗忘门:决定旧信息保留多少

  2. 输入门:决定新信息写入多少

  3. 输出门:决定当前信息输出多少

Tranformer架构解析

RNN&LSTM通过循环结构处理序列数据。这种循环的计算方式带有瓶颈:

必须按照顺序处理数据。意味着RNN无法进行大规模的并行计算,处理长序列时效率低下,限制了模型的规模以及训练速度的提升。

Transformer架构使用注意力机制,完全抛弃循环结构,来捕捉序列内的依赖关系并实现了并行计算。

Encoder-Decoder整体结构

宏观上遵循了经典的编码器-解码器架构(因为最初Transformer模型是为了端到端机器翻译设计的)
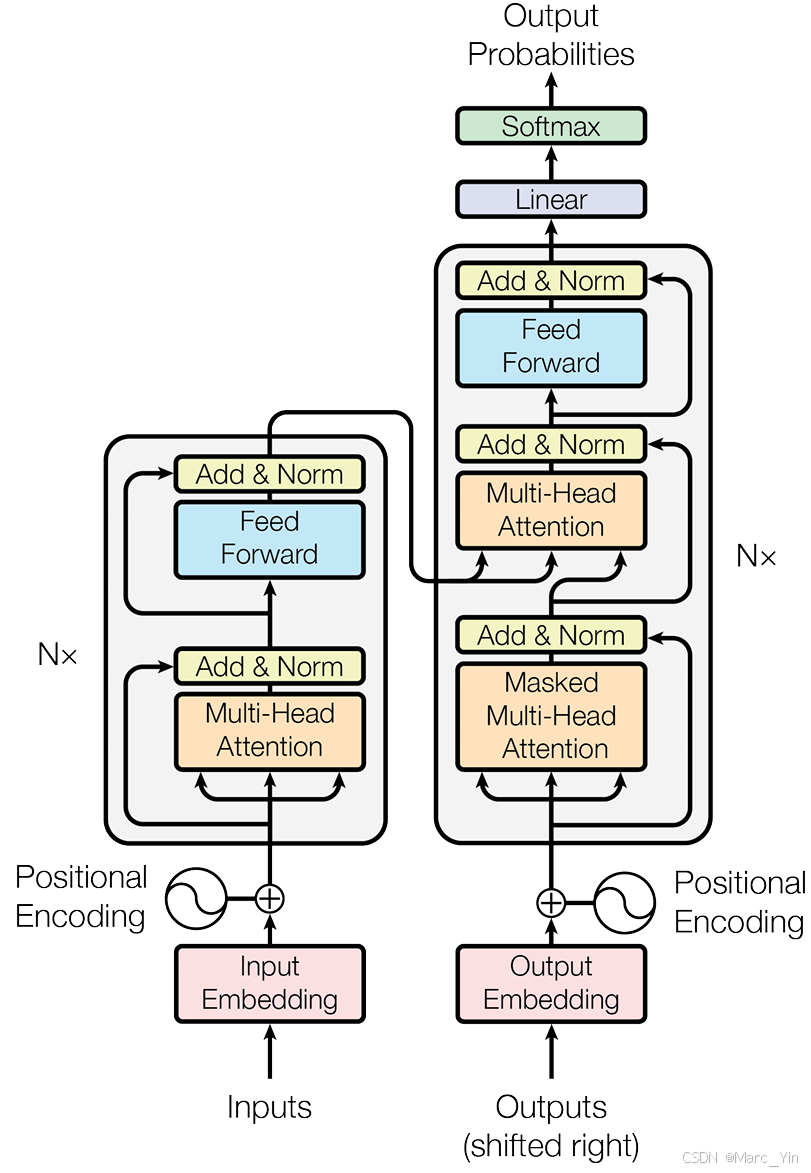
我们可以将整个架构理解为一个分工明确的团队:

  1. 编码器Encoder:

    1. 任务:理解输入的整个句子

    2. 读取所有输入的词元(token),最终为每个词元生成一个富含上下文的向量表示

  2. 解码器Decoder:

    1. 任务:生成目标句子

    2. 参考自己已经生成的前文,并咨询编码器的理解结局,生成下一个词

自注意力到多注意力

当人类理解“The agent learns because it is intelligent”。当我们读到it时候,我们会想“it是谁?”,之后我们大脑将更多注意力集中到agent这个词上。自注意力机制就是对这种现象的数学建模,允许模型在处理序列中某个词时,都能兼顾句子中其他词,并为每个词分配不同的注意力权重。权重越高的词,代表其与当前词关联性越强,信息也在当前词的表示中占据更大比重。

但是仅进行一次注意力计算(单头),模型可能只会学会关注一种类型的关联。EX:

处理it时,可能只学习到了关注主语。但是我们都知道,语言是复杂的,我们希望模型同时能够关注多种关系。多头注意力机制应运而生,思想:一次做完变成分成几组、分开执做之后合并。

类似让n个不同的的专家从其领域审视一句句子,每个专家从其领域捕捉到一种不同的特征关系,最后将这n个专家的意见(输出向量)拼接起来并进行整合,得到最终输出。

这种设计让模型能够管制来自不同位置、不同表示的自空间的信息,极大增强了模型的表达能力。

前馈神经网络Feed-Forward Network

每个Encoder/Decoder层中,多头注意力子层之后都跟着一个逐位置前馈神经网络。

意味着这个前馈神经网络会独立作用于序列中每个词元向量

注意力层负责“找信息”,而FFN负责“加工信息”

FNN是对每个词的单独处理,但是使用同一套参数。

可以这样理解:

输入是一个序列,每个词都有一个向量表示,FFN会一个词一个词的处理但是使用同一个“小网络”;——使用统一的加工机器对每个词轮流进行精加工。

FNN对词进行加工较为特殊,会先将数据维度放大(通常为4倍)之后缩小为原来大小。

为什么“先放大再缩小”?

  👉理解:

  放大(升维)

  • 将信息投影到更高维空间

  • 当于“打开更多表达空间”

  👉类似:将简单的话展开为更加丰富的表达

  缩小(降维)

  • 提取重要信息

  • 压缩回原来的表示空间

  👉类似:复杂表达中提炼精华

FFN解决“每个词内部如何变成更强的表达”

残差连接&归一化

Transformer每个encoder/decoder中,所有子模块(EX:多头注意力/前馈神经网络)都被一个Add&Norm操作包裹。这个组合是为了保障Transformer能够稳定训练。

操作由两部分组成:

  • 残差连接Add:该操作及那个子模块的输入x直接加到该子模块的输出Sublayer(x)上。这个结构解决了深度神经网络的梯度消失问题。反向传播时,梯度可以绕过子模块直接向前传播,从而保障即使网络层数很深,模型也能够得到有效训练。

  • 层归一化Norm:该操作对单个样本的所有特征进行归一化。这解决了模型训练过程中的内部协变量偏移问题,使每层输入分布保持稳定,从而加速模型收敛并提高训练稳定性。

内部协变量偏移

定义:训练过程当中,由于参数不断更新,导致后续曾输入数据的分布持续发生变化。

加速模型收敛

模型训练过程中,更快达到较低损失或者较优解

本质含义:

  • 需要的训练步数更少

  • 参数更快接近最优值

  • 优化过程更稳定

位置编码

Transformer的核心是自注意力机制,通过计算序列中的任意两个词元间关系捕捉依赖。然而,这种计算方式有个固有问题:

计算方式本身并不包含任何关于词元顺序或者位置信息。

对于自注意力而言:“agent learns”和“learns agent”这两个序列是完全等价的,即使语义上相差十万八千里。

为了解决这个问题,Transformer架构引入的位置编码Postional Coding。

核心思想:为输入序列中的每个词元嵌入向量都额外加上一个能够代表其绝对位置和相对位置信息的“位置向量”。这个位置向量并不是通过学习得到的,而是通过固定公式直接计算。

这样,即使两个词元(EX:都是“agent”的词元)自身的向量相同,但是由于位置不同,最终输入到Transformer中的向量因为位置编码而不同。

Decoder-Only架构

Transformer架构用于构建一个与人对话、创作、作为智能体大脑的通用模型的话过于复杂。

Tranformer设计哲学:“先理解,再生成”

编码器负责深入理解输入的整个句子,形成一个包含全局信息的上下文记忆,然后解码器基于这份记忆生成翻译。

OpenAI在开发GPT时,提出更加简单思想:预测下一个最有可能出现的词。

无论是回答问题、编写故事还是生成代码,本质上都是在一个已有的文本序列后面一个词一个词地添加最为合理的内容。

基于这个思想,GPT进行了一个大胆的简化:抛弃编码器,仅保留解码器部分。

Decoder-Only工作模式被称为“自回归”,整体过程:

  1. 给模型一个起始文本

  2. 模型预测下一个最有可能出现的此

  3. 模型将自己生成的词添加到输入文本的末尾,形成新的输入

  4. 模型基于新输入,再次预测下一个词

  5. 不断重复这个过程直到生成完整句子或者达到停止条件。

掩码自注意力

而上述架构存在一定问题:“偷看未来的词”

训练时,Decoder-Only架构的模型通常采用Teach-Forcing:一次性输入整句

而自注意力默认是全连接的。每个位置都可以关注序列中的所有位置。

如果不进行限制,预测第t个的时候会直接看到t+1、t+2……的真实词。这就造成了信息泄漏,污染了训练。

  • 训练阶段:能够看到未来词

  • 推理阶段:仅能够看到已经生成的文本,一个一个词生成

👉问题就在于:训练时需要人为限制信息流,否则训练&推理并不一致

Decoder-Only架构中通过掩码自注意力机制进行解决:

本质:计算注意力分数时,对未来位置进行屏蔽(通过对未来位置加上极大的负数,使其权重接近0)强制模型只能关注已有信息,实现自回归。

第28篇 sw放样特征矩形-圆-矩形学习笔记 本例演示三轮廓放样:先画中心对齐的100×100矩形草图,再在偏移100的基准面上绘制圆,最后在另一基准面画矩形。通过依次选择三个轮廓并正确设置连接点,实现矩形→圆→矩形的平滑过渡,注意连接点位置避免扭曲。 阅读详情

相关推荐

OpenSSL玩转证书链:从Windows CA根证书到签发多域名/IP的服务器证书全攻略

本文详细介绍了如何使用OpenSSL在Windows环境下构建私有CA体系,从创建CA根证书到签发支持多域名/IP的服务器证书的全流程。通过实战指南,读者可以掌握零成本证书管理技术,灵活配置SAN扩展,并了解在Nginx、Apache等主流服务器中的证书部署方法,适用于企业内网、IoT设备等HTTPS加密场景。

weixin_28731223的博客 440

MySQL建库建表操作学习笔记

SQL(Structured Query Language,结构化查询语言)是用于在关系型数据库上执行数据操作、数据检索以及数据维护的标准语言。:用于定义对数据库对象(库、表、列、索引)的操作,如 CREATE、DROP、ALTER、RENAME、TRUNCATE 等。保存可变长度的字符串(可包含字母、数字以及特殊字 符)。:用于定义对数据库记录的操作,如 INSERT、DELETE、UPDATE、SELECT 等。:用于定义对数据库、表、字段、用户的访问权限和安全级别,如 GRANT、REVOKE 等。

Eternitycai的博客 217

06-esp32-idf开发调试方法(内置JTAG,OpenOCD调试)

使用VS Code和ESP-IDF进行ESP32开发和调试 在我们搭建 **IDF** 框架后,**OpenOCD** 已经自动下载好了, 我们通过 **JTAG** 接口连接使用 **OpenOCD** 进行调试。而**ESP32**芯片中内置 了**JTAG** 电路,无需额外芯片即可调试,更加方便,所以这里我们讲解使用模块自带的usb-jtag接口进行调试。

宁子希的博客 1万+

2026.11.7 AI学习总结

110 你 14b 模型权重本身就要约 8.8GB,默认上下文(Ollama 在 16GB 卡上可能给到 4K)加上 KV Cache 就爆了。比如设成 2048,你输入了 500 个 token 的问题,那模型最多还能生成 1500 个 token 的回答。超出部分会被截断,模型就"看不见"了。4 如果 14b 跑起来后发现它"忘事",再逐步往上加,比如先试 4096。,根据注意力头的重要性动态分配缓存资源,重要的留显存,不重要的下沉。,单位是 token,表示模型这一次推理最多能同时"看到"多少内容。

qq_41181702的博客 350

ClaudeCode 通过 CC Switch 配置 Ollama 本地大模型

本文介绍了如何让Claude Code使用本地免费模型qwen3.5:9b而无需Anthropic API Key的方法。主要内容包括:1)安装Claude Code、CC Switch代理工具和Ollama本地模型运行时;2)配置环境变量和设置文件将请求转发到本地服务;3)详细说明了系统架构和工作原理,展示请求如何从Claude Code经CC Switch代理到Ollama本地模型。该方案通过代理拦截和转发机制,实现了使用免费开源模型替代官方API的功能。

稚枭天卓 3220

Windows系统离线搭建PyTorch深度学习环境全攻略(CUDA+cudnn实战)

本文提供了一份在Windows系统下离线搭建PyTorch深度学习环境的完整实战指南。文章详细讲解了如何在没有网络连接的情况下,正确安装和配置CUDA、cudnn以及PyTorch,并构建独立的Python虚拟环境。重点强调了版本依赖关系的重要性,并提供了从驱动准备到环境验证的每一步操作,旨在帮助用户高效、稳定地部署可复用的GPU深度学习开发环境。

table的专栏 578

【FreeRTOS源码学习笔记】任务创建

【FreeRTOS源码学习笔记】任务创建

2502_90565057的博客 447

xilinx 暑期学校项目(二) 通过HLS实现二维傅里叶变换(2Dfft)及图像数据读入读出方法

要进行维纳滤波,首先就是要将图像矩阵通过二维fft变换到频域。 但是hls_fft.h中只有一维fft的函数,因此我们采用对行逐行进行一维fft,再对列逐行进行一维fft来实现二维fft的效果。 文章目录自带的fft例程二维fft的实现数据的读入和读出读入读出维纳滤波操作 自带的fft例程 自带的fft例程中包括有如下四个函数 void dummy_proc_fe( bool direction, config_t* config, cmpxData in[FFT_LENGTH],

战斗果冻的训练中心 2328

Flink 学习日志 03:自定义一个SourceFunction,完成对Redis中数据的读取

本文介绍了在Flink中自定义SourceFunction读取Redis数据的完整流程:通过Jedis客户端连接WSL2中的Redis服务,编写RedisSource实现循环读取所有Key-value并逐条输出,结合Thread.sleep()实现每秒一条的流式效果。关键步骤包括环境准备、添加Jedis依赖、配置IDEA运行时加载provided依赖,并注意生产环境中应避免使用阻塞的keys *,改用scan命令。最终实现动态读取、实时打印,验证了Flink与Redis的数据集成能力。

木木的学习笔记 398

大模型在心律失常预测及治疗方案制定中的应用研究报告

目录一、引言1.1 研究背景与意义1.2 研究目的与方法1.3 研究创新点二、大模型技术概述2.1 大模型基本原理2.2 常见大模型类型及特点2.3 大模型在医疗领域的应用现状三、心律失常的术前预测与准备3.1 术前心律失常预测的重要性3.2 大模型在术前预测中的应用案例3.3 基于预测结果的术前准备方案四、术中监测与实时调整4.1 术中监测心律失常的方法与技术4.2 大模型辅助术中决策的机制4.3 实时调整手术方案的策略与实践五、术后恢复与并发症风险预测5.1 术后心律失常的监测与评估5.2 大模型预测术

嵌入式毕设/课设资料清单(速查手册·文档模板·题库,持续更新)→ 见最新文章 1595

基于Simulink的占空比调制DTC降低转矩脉动

修改传统SVPWM模块,输入占空比d和有效矢量索引,计算Ton​=d∗Tc​、Toff​=(1−d)∗Tc​,生成对称PWM波形(替代开关表直接输出)。:低速时(n<500rpm)减小dmax​=0.6(避免磁链畸变),高速时(n>2000rpm)增大dmax​=0.8(提升动态响应);kT​/kψ​:转矩/磁链误差增益(需整定,如kT​=0.02/(N⋅m),kψ​=0.1/Wb);(θ为电压矢量与磁链夹角)。② SVM-DTC(占空比计算模块启用,d0​=0.5,kT​=0.02,kψ​=0.1)。

amy_mhd的博客 87

邓明 Agent 系统面试-意图识别学习笔记

不要只是做意图识别而不做测评,就好像要评估 RAG 准确性,在接口服务要测试响应时延,超时控制等等,这里也要关注意图识别准确率,如果面试官认为项目指标太高是在吹牛,关键就是回答因为 Agent 解决的是特定领域的意图识别,识别场景单一,另外就是因为用户输入相对简单。意图识别影响 prompt/spec 的加载,意图识别影响上下文组织,意图识别影响工具选择,意图识别影响 prompt 建议,意图识别得到的意图不是让模型随机生成而是候选类别里去做选择。2.意图识别的原因,以及意图识别得到的是什么?

m0_57222081的博客 207

以阿克曼转向车为例对URDF和XACRO文件进行解读

   最近我在古月学院购买了在Gazebo中实现阿克曼转向车的仿真课程,课程资料的阿克曼小车的XACRO文件在Gazebo里加载的时候报了三个错误,在这之前,我没接触过URDF或XACRO文件,本篇文章就以这个阿克曼小车的XACRO文件为例,对URDF或XACRO文件的格式和内容进行解读,期望经过解读和学习,找到错误原因及所在,并解决这三个错误    先来放一下上面右图所示的模型的完整的XACRO文件: &lt;?xml version="1.0"?&gt; &lt;!-- racecar.urdf.x

慕羽★的博客 3699

CMake学习

CMake如何编译成库?1. 为什么要有库?库就是预先写好,编译好的代码集合。存在的意义,1)避免重复造轮子和重复编译,库是,你的代码在编译时直接链接它,不需要把库的源码重新编译一遍,大大节省了编译时间。;2):编译成库让别人可以直接调用我的函数,但看不到cpp源码,看不到里面的逻辑。3):大项目可以拆分给不同的团队开发不同的库,最后拼在一起。静态库:就是在程序编译和链接阶段,把库里被用到的代码部分,像打包裹一样,直接复制粘贴到最终的可执行文件(如.exe或 Linux 下的无后缀文件)里面。

m0_56487684的博客 63

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

商业经济学学习资料

商业经济学学习资料

weixin_29403917的博客 278

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

将物理先验嵌入机器人学习:从经典力学到 VLA 与 WAM

本文综述了将物理先验嵌入机器人学习的三条路径:数据与表示、模型架构、训练损失,强调其位置决定约束效力。通过夹取软物体案例,阐明运动学、动力学、接触与材料特性在任务中的分层作用。指出物理先验非万能,需匹配实际条件;强约束可加速学习,但误用会引入偏差。提出“有效刚度”等概念,强调主动探测与参数辨识的重要性,并警示仅靠单一方法无法保障安全执行,需结合在线验证与控制闭环。

lovely_yoshino的博客 641

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

【学习笔记】51单片机 模块化编程

模块化编程:把各个模块的代码放在不同的c文件里,在.h文件里提供外部可调用函数的声明,在其他.c文件想使用其中的代码时,只需要#include"xxx.h"文件即可。传统方式编程:所有的函数均放在main.c中,若使用的模块比较多,则一个文件内会有很多的代码,不利于代码组织和管理,而且很影响编程者的思路。使用LCD602液晶屏作为调试窗口,提供类似printf函数的功能,可实时观察单片机内部数据的变换情况,便于调试和演示。使用到的.h文件必须要放在编译器可寻找到的地方(工程文件夹根目录,安全目录,自定义)

2601_96469072的博客 213

ENSP学习记录(1)

本文分享了在ENSP环境中学习通信、网络通信与数据通信网络的区分心得。通过类比“传话”“用网络传话”“设备系统传话”,厘清三者层级关系;以寄快递比喻封装过程,理解报文结构;反思“报文必有尾部”“网关是设备”等误区,强调概念本质理解的重要性。核心观点:能否举出反例,是检验是否真正掌握的关键。

W20070611的博客 214

Linux网络学习【深入理解多路转接epoll】

本文围绕 Linux 多路转接 epoll 展开,以“设计动机—核心机制—触发模式—代码实践”为主线,对比 select、poll 的监听管理与就绪检查方式,解析关注集合、就绪列表及核心接口,重点讲解水平触发与边缘触发的行为差异,以及边缘触发配合非阻塞读写的处理要点。结合多连接服务器实践,梳理事件注册、连接接收、部分收发、可写事件按需监听及断开清理流程,厘清就绪通知与操作完成的区别,分析常见错误与性能影响因素,帮助读者建立从事件循环到连接管理的完整认识,为高并发服务器与事件驱动框架开发打下基础。

承于所学,探技术之渊;以代码求政,寻成长之道。 1万+

正则表达式学习笔记 02:基础语法

正则表达式是描述字符匹配规则的迷你语言,由普通字符和元字符组成。普通字符直接匹配自身,而元字符如.、*、+、^、$等具有特殊含义,用于控制匹配模式。常见功能包括任意字符匹配、字符类、预定义类(如\d)、量词、位置锚点、分组与捕获、环视断言及反向引用。需注意,若要匹配元字符本身,必须使用转义符\。例如,\.可匹配字面点号。

菜鸟的专栏 146

为什么学习 GUI 程序设计:从 Swing 入门桌面界面开发

学习GUI程序设计能让程序从“能用”走向“好用”,提升用户体验与开发能力。选择Java Swing作为入门,因其随JDK自带、跨平台一致、组件完整且学习曲线平缓。通过掌握容器、组件、布局与事件四大核心概念,结合最小示例实践,可快速构建交互界面。建议循序渐进:运行示例→熟悉组件→理解事件→组合布局→完成小项目(如待办清单),夯实桌面应用开发基础。

xyouyuweizhu的博客 107

ES6:Iterator与Generator函数学习及Generator函数和async实现异步编程理解

几个概念:可迭代对象是指具有迭代器接口的对象: 实现类数组使用 for of 循环 对象无法使用数组的迭代器。 generator 函数类似遍历器函数,返回一个迭代器对象; 该对象调用 方法时,会把 后面的表达式作为值 ,并执行当前指针与下一步指针之间的程序。 generator 实现迭代器函数 后面跟的内容为 得到的 值。流程:循环 会调用 generator 函数,返回一个 iterator 对象, 方法由 generator 内部的 决定。 Gene

2403_87566238的博客 212

echarts学习手记

本文介绍ECharts的引入与基本使用:通过npm安装并按需引入核心模块、图表类型及组件,注册后初始化图表实例。结合resize事件实现响应式布局,通过dispose()销毁实例避免内存泄漏,并支持自定义主题与seriesLayoutBy配置调整数据映射方式,提升图表灵活性与性能。

qq_43592674的博客 38

秋招学习笔记 day109

在三次握手阶段,首先初始状态下,是 close 的服务端进入 listen 状态,然后客户端是发送一个序号以及 SYN 标志,然后进入 SYN_SENT 阶段,服务端收到之后发送一个 ACK,它 ACK 是客户端发的序号加一,然后发送 ACK 标志,以及自己的 SYN 标志。SYN 进入 SYN_RECEIVE 阶段之后,客户端收到服务端的确认之后,返回最后的确认和 SYN,这时候可以写数据,这时候客户端进入 ESTABLISHED 的状态,然后服务端收到确认后也是一样的。但是事实上,不知道就是不知道。

m0_57222081的博客 163

GPT学习RTdetr

模型结构(神经网络由哪些模块组成),模型权重(训练得到的参数数值)训练配置(训练轮数,输入尺寸,学习率设置)最后一轮权重(指训练结束时保存的权重,最佳权重,指验证指标达到最佳标准时保存的权重。(控制数据条件:固定数据集版本,数据划分,类别映射和标注质量)控制训练条件(记录训练轮数,输入尺寸,批次大小,学习率,预训练权重和数据增强)控制评价条件(相同的指标相同的测试集和一致的评估规则)使用相同的类别定义和标注,使用一致的评价指标,统一输入分辨率和训练预算等,记录硬件,推理精度预处理方式和及时方法。

boxiansheng163的博客 141

秋招学习笔记 day105

我们虽然很多人基本上都知道 fork,但是 fork 之后,它不会影响到 Mutex 会被复制,然后所以说它是不可能锁住两个进程的,所以说它的力度就应该是线程级别的,这种就可能是很多人不会想的。关于红黑树的特点,首先根节点是黑色的,其次是空的叶子节点是黑色的,还有就是红节点不能和红节点挨着,然后一条路径上的黑色节点的数量相同,还有就是只有红黑两种颜色。关于文件上传这个问题一般涉及大文件的都是采取这种分治的思想,比如说对文件的内容进行排序、进行去重,都是首先哈希分成多个小文件,再逐个的去统计,然后去重。

m0_57222081的博客 54
上一篇: HelloAgents学习:PartⅠChapterⅠ初识智能体
Marc_Yin
博客等级 码龄2年 69粉丝 34原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值