集成学习概述:三个臭皮匠顶个诸葛亮

Adaboost——三个臭皮匠赛过诸葛亮 古人云“三个臭皮匠赛过诸葛亮”,以adaboost为代表的集成学习正是体现了古人的这个智慧,也就是说,对于弱学习器(性能比较差的学习器),通过某种算法把它们结合起来,使它们能够有缺互补,那么它们就能赛过诸葛亮(强学习器)。 阅读详情
点击上方“AI派”,选择“设为星标”
最新分享,第一时间送达! 640?wx_fmt=gif

本文是《机器学习宝典》第 16篇,读完本文你能够对集成学习有一个简单的认识和理解。

上一篇介绍了面试常考的一个问题:回归决策树,这一篇我们来介绍下集成学习。在生活中,你是不是也会遇到这样的场景:当你对一件事情的判断没有把握的时候,通常会再咨询几个人,听听他们的观点,最后再做出决策。其实这反映出了一个思想:群体决策通常比个体决策更优,用句俗语来说就是:三个臭皮匠顶个诸葛亮。将这个思想应用于机器学习中就是集成学习(ensemble learning)。

为什么集成学习能够提升效果呢

为什么集成学习能够比单模型的效果更好呢?我们从以下几个角度考虑下:

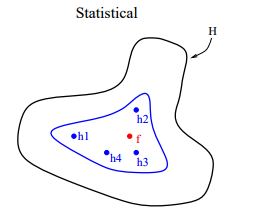
从统计的角度来看,机器学习的任务可用认为是寻找一个最佳的假设空间。在没有充足的数据情况下,学习任务可以找到多个性能差不多的假设空间。如果融合多个模型的预测及过,可以降低预测错误的风险。外面的曲线表示假设空间,内部的曲线表示在训练集上具有不错性能的假设,点 640?wx_fmt=png 表示真实的假设 。我们看到,通过平均这些性能不错的假设,可以得到一个逼近 640?wx_fmt=png 的优化假设 。

640?wx_fmt=png

从计算的角度来看,很多优化算法采用局部搜索的方式来寻找最佳参数,这样很容易陷入局部最优解。融合多个模型可以看做是同一个训练集、从不同的起始点进行局部搜索,然后进行结合。这样可以降低陷入局部最优解的风向。
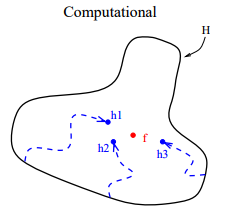
640?wx_fmt=png

从表示的角度来看,理论上,如果给出足够的训练数据,很多算法可以表示所有的情况,例如神经网络和决策树。但是在很多实际应用中,能够用于训练的数据是有限的。有些学习任务的真实假设可能不在当前学习算法所考虑的假设空间中,此时如果使用单模型肯定无效 。模型融合可以使假设空间扩大,从而使得这些学习任务可能得到正确的表示。
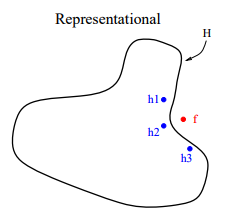
640?wx_fmt=png

在集成学习中,参与融合的模型叫做基模型,想要使得集成学习的效果好,基模型应该”好而不同“。也就是说,基模型的准确率不能太低,同时基模型之间的多样性(差异性)。

如何增加模型多样性

我们已经知道,增加基模型的多样性能够提高集成学习的效果。一般增加基模型多样性的思路是在学习过程中引入随机性。常见的做法是对数据样本、输入特征、输出结果、算法参数进行扰动。

数据样本扰动

从初始的数据集中产生不同的数据子集,然后利用数据子集训练出不同的基模型。数据样本扰动通常是基于采样法。这种做法简单高效,使用最广。对于不稳定的基学习器(决策树、神经网路等)很有效果,对于一些稳定基学习器(线性学习器、支持向量机、朴素贝叶斯、k近邻算法等)效果不佳。

输入特征扰动

训练样本通常由 一组特征描述 , 不同的"子空间"提供了观察数据的不同视角 。如果数据包含大量冗余特征, 使用特征扰动会有好处(节省时间 、 多样性提升等);但是若样本数据特征较少或冗余特征很少,则输入特征扰动不适宜使用 。

输出表示扰动

此类做法的基本思路是对输出表示进行操作以增强多样性。如将多分类任务转换为多个二分类任务来训练基模型;“输出调制法”将分类输出转换为回归输出来训练基模型。

算法参数扰动

模型训练一般都需要进行参数调整,比如神经网络的隐藏层结点数、决策树的树深等。这些参数被赋予不同的值可以生成不同的基模型。

其实,我们可以同时采样多种方式来增强模型多样性,比如随机森林同时使用了数据样本扰动和输入特征扰动两种方式。

结合策略

当获得了多个基模型之后,如何将他们组合到一起呢?组合策略主要关注的就是将多个基模型通过某种方式融合后能够提升最后的效果。

假设有 640?wx_fmt=png 个基模型 640?wx_fmt=png,组合后的结果为 640?wx_fmt=png,对于回归任务,常见的有两种基础集成策略:简单平均和加权平均。

简单平均是将所有基模型的结果平均后作为集成后的结果:
640?wx_fmt=png
加权平均是说每个基模型的结果权重可以不同,这些权重可以人工制定,也可以从训练数据中学习得到。例如估计出个体学习器的误差,之后令权重大小与误差大小成反比。
640?wx_fmt=png
不过由于现实生活中训练样本通常不充分或者存在噪音,这使得学习到的权重不完全可靠。因此,加权平均的效果未必一定优于简单平均效果。一般而言,在个体学习器性能相差较大时宜使用加权平均,而在个体学习器性能相近时宜使用简单平均。

对于分类任务,由于预测的结果可以是类别,也可以是类别概率,对应的可以分为硬投票和软投票。硬投票是采用投票法来融合输出为类别的基模型,软投票则是融合输出为类别概率的基模型。对于硬投票来说,常见的有:绝对多数投票法、 相对多数投票法、加权投票法。对于软投票来说,融合的方式与回归任务中类似,所以这里就主要介绍硬投票相关的融合方式。

绝对投票法是将超过半数基模型预测的类别作为最终的结果,如果有的样本没有那个类别的票数超过了一半,这时候就拒绝预测。

640?wx_fmt=png

其中640?wx_fmt=png表示基模型640?wx_fmt=png在类别 c 上的输出,结果为 1 或 0 。

绝对投票法中会出现“拒绝预测”的情况,如果必须要求提供预测结果,可以考虑使用相对多数投票法。相对多数投票法会将基模型投票次数最多的类别作为最后的输出结果,所以不存在拒绝预测。
640?wx_fmt=png
如果基模型的性能差异较大,从直观上来看,让性能更好的模型掌握更多的投票权更合理一些,因此出现了加权投票法。也就是不同的基模型可以有不同的投票权重。

640?wx_fmt=png

当数据量比较大时,可以通过“学习法”来组合模型,常用的一种叫做 Stacking。Stacking 基于原始数据训练多个基模型,将基模型的输出和原始数据中的目标分别作为新训练集的特征和目标,在新训练集上训练二级模型,将二级模型的输出作为 Stacking 的输出。见下图:

640?wx_fmt=jpeg

集成算法

除了前面介绍的模型集合策略外,这里介绍两个集成算法:Bagging 和 Boosting 。集成算法更关注的是将基模型经过集成算法来提高模型的泛化能力。

Bagging

Bagging 是的思想是从训练集从进行子抽样组成每个基模型所需要的子训练集,对所有基模型预测的结果进行综合产生最终的预测结果,见下图:

640?wx_fmt=jpeg

可以看到,需要说明的是,Bagging 采用自助采样法(Bootstrap sampling)进行采样,即对于m个样本的原始训练集,我们每次先随机采集一个样本放入采样集,接着把该样本放回,也就是说下次采样时该样本仍有可能被采集到,这样采集m次,最终可以得到m个样本的采样集。

如果 Bagging 中基学习器都是决策树的话,这时候就属于随机森林算法了,这个之后文章再介绍。

Boosting

与 Bagging 不同的是,Boosting 训练过程为阶梯状,基模型按次序一一进行训练,基模型的训练集按照某种策略每次都进行一定的转化。对所有基模型预测的结果进行线性综合产生最终的预测结果,见下图:

640?wx_fmt=jpeg

常见的 Boosting 模型有 AdaBoost(Adaptive boosting)算法以及 Gradient Boosting 算法。

Bagging 和 Boosting 的区别

Bagging 可以认为是并行的集成方式,它能够并行的生成相对独立的基模型,Bagging 集成后模型的偏差与基模型近似,但是由于存在多个相对独立的基模型,所以集成后的模型方差会比单个基模型降低。也就是说,Bagging 通过降低方差,提高了模型的泛化能力。

Boosting 可以认为是串行的集成方式,它生成的基模型依赖于前一个基模型,Bagging 集成后模型的方差与基模型近似,但是由于每个基模型都在“纠正”前一个基模型的结果,所以集成后的模型偏差会比单个基模型降低。也就是说,Boosting 通过降低偏差,提高了模型的泛化能力。

参考:

  1. 集成学习(ensemble learning)应如何入门?(https://www.zhihu.com/question/29036379/answer/111637662)

  2. 独家 |从基础到实现:集成学习综合教程(https://zhuanlan.zhihu.com/p/40485758)

  3. 美团机器学习实战

??扫码查看《机器学习宝典》历史内容

640?wx_fmt=png


(完)


我开通了知识星球,在星球里会分享我个人在数据分析/机器学习/深度学习/推荐系统方面的所学和所得。当前正在星球里分享我录制的机器学习视频课,如果想快速入门和提高自己,可以加入我的星球来交流(加入方式:扫描下方二维码或者点击“阅读原文”)。


640?wx_fmt=png 640

人人都是数据分析师,人人都能玩转Pandas | Numpy 精品系列教程汇总 | 我是如何入门机器学习的呢 | 谷歌机器学习43条黄金法则


640

640?wx_fmt=png


长按,识别二维码,加关注


决策树系列4:随机森林 (三个臭皮匠顶个诸葛亮) 引言 想了解一个人的人品一般询问多个熟悉他的人,而不是只问一个人,毕竟一个人的评价难免有失偏颇。对于决策树也是一样,单一的决策树有时候会过拟合,有时候效果不太理想。而随机森林就是利用多棵决策树共同做决策。毕竟三个臭皮匠顶个诸葛亮嘛。 随机森林 随机森林主要利用了 bagging 的思想,也就是多个学习器并行学习,共同预测结果。 随机森林有多棵决策树,每棵决策树并行独立训练。预测时每个决策树都预测... 阅读详情

相关推荐

从临床试验到互联网AB测试:边缘结构模型(MSM)如何解决‘时依性混杂’这个老大难问题

本文探讨边缘结构模型(MSM)如何解决时依性混杂问题,适用于临床试验和互联网AB测试。通过逆概率加权(IPTW)等方法,MSM能有效剥离混杂效应,准确评估长期干预效果。文章结合跨领域案例,详细解析MSM的核心原理、实施步骤及在推荐算法效果评估中的实战应用,帮助读者掌握这一先进因果推断工具。

weixin_28725949的博客 207

学习人工智能第三周:集成学习之三个臭皮匠

首先:我们学模型要先学他的思想,从宏观角度出发 一.随机森林:m个模型一起学习,减少抖动 随机森林到底在干什么?减少抖动 例子:预测一个人得重病的概率,真实是0.3 通过模型预测是0.2,0.4(增加保费,别人不买)都会使赔的可能性大 二.adaboost:m个模型串行学习每一轮样本的权重不一样,每个模型增加权重(对学不会的着重学,其他少学) 三.m个模型串行学习,每一轮学上一轮的残差,各个分类器求和(学学不会的) 例子: 语文60,数学70,英语80 GBDT:学语文40,数学30,英文20,不会的部分

m0_56852878的博客 187

基于STM32的PID恒温恒湿控制系统 | 保姆式教程 开源可复刻

本项目基于STM32F103C8T6核心控制器,完整实现了基于双路PID算法的恒温恒湿闭环控制系统,覆盖高精度温湿度采集、双模式控制、参数在线配置、异常安全保护、掉电记忆等全功能,全程采用无跳步保姆式教学,从硬件选型、接线、CubeMX配置、代码开发、调试排坑全流程拆解,跟着步骤一步步操作,就能顺利完成项目复刻

ZhongWeiXiang9的博客 346

【机器学习算法】集成学习-2 三个臭皮匠顶一个诸葛亮,弱学习器的机器学习元算法

我们发现即使是弱分类器组合的模型,即使是组合投票的结果模型,居然可以胜过我们多个强学习器的融合学习。

qq1021091799qq的博客 1610

Android Profiler 帧率优化实战与性能调优

本文详细介绍了使用Android Profiler进行帧率优化与性能调优的实战方法。通过分析主线程状态、FPS曲线和渲染阶段耗时,精准定位卡顿根源,并提供减少过度绘制、优化绘制命令及改善资源使用的具体策略。文章结合电商、游戏等真实案例,帮助开发者有效解决卡顿问题,提升应用流畅度。

palm99的专栏 536

CentOS 7 安装 Python 3.10

我这里已经软链接了,正常未链接之前是python->python2.7而不是python3.10。python2.7默认安装是在 /usr/bin目录中,切换到/usr/bin/更改yum配置,因为其要用到python2才能执行,否则会导致yum不能正常使用。2. 安装 Python 3.10 必需的 openssl >= 1.1.1。默认的centos7是没有安装pip,先添加epel扩展源。/usr/bin/python 修改为如下。添加软链接,将原来的链接备份。添加python3的软链接。

bensonyang888的博客 2905

机器学习---集成学习(三个臭皮匠顶个诸葛亮)

基本思路 群体智慧:如果能从所有的科学家中选择一群科学家组成一个团队,并且团队中的每个科学家都略强于随机选择的一个科学家,那么有理由相信这个科学家团队能比单个科学家做出更好的决定。 这样的群体智慧用到机器学习的学习器上也成立,集合多个个体学习器的方法称为集成学习。 目前集成学习的流派主要有两种: bagging boosting bagging 有放回的随机抽样:自主采样法(bootstap ...

weixin_40662209的博客 742

InVEST模型 | HAbitat quality模块计算生境质量

 本文详细介绍使用InVEST模型中HAbitat quality模块计算生境质量,包含各个参数的含义、所需数据、数据处理以及需要各个参数注意的地方等过程。

地理空间科学的博客 1万+

集成学习----“三个臭皮匠,赛过诸葛亮”

集成学习(Ensemble Learning)通过使用一些方法改变原始训练样本的分布,来构建多个不同的学习器,再结合这多个学习器来完成学习任务,常可获得比单一学习器显著优越的泛化性能。该过程中多个不同的分类器,叫做个体学习器或者基学习器。个体分类器之间要具备一定的差异性和准确性,即尽可能“好而不同”,个体分类器的准确度要大于0.5。集成学习的研究核心有二个内容:一者是如何构建具备一定差异性和准确率...

leetcodecl 684

ADS基础教程22 - 有限元电磁仿真(FEM)

一、引言二、FEM操作过程1.新建Layout1.新建Layout2.EM设置3.设置Frequency plan4.设置Output plan5.设置Options6.设置网格频率7.仿真结果三、总结介绍了在ADS中如何进行FEM仿真过程。END!}}END!

XZ_ZC的博客 2580

Q3D提取PCB走线RLCG参数

介绍一种提取PCB走线寄生电容和寄生电感的方法

sinat_15150363的博客 2917

人工智能基础课13机器学习-三个臭皮匠,赛过诸葛亮:集成学习

这些未使用的数据没有参与个体学习器的训练,但可以作为验证数据集,用于对学习器的泛化性能做出包外估计,包外估计得到的泛化误差已被证明是真实值的无偏估计。以Boosting方法为代表的序列化方法使用了全体训练数据,并根据每次训练的效果不断迭代以使损失函数最小化,因而可以降低平均意义上的偏差,能够基于泛化能力较弱的学习器构建出较强的集成。如果每个个体学习器的分类精度都不高,在集成时错误的分类结果就可能占据多数,导致集成学习的效果甚至会劣于原始的个体学习器,正如俗语所言“和臭棋手下棋,越下越臭”。

fegus的博客 440

全新YOLOv11一文弄懂 | YOLOv11网络结构解读 、yolov11.yaml配置文件详细解读与说明、模型训练参数详细解析 | 通俗易懂!入门必看系列!

本文全面介绍了YOLOv11目标检测算法,包含网络结构解析、yaml配置文件详解及训练教程。YOLOv11通过改进的C3k2f模块、SPPF和C2PSA注意力机制等创新设计,在COCO数据集上实现了比YOLOv8更优的性能。文章详细解读了yolov11.yaml配置文件的参数设置、主干网络(backbone)和头部网络(head)结构,并提供了完整的训练代码示例和参数说明。训练部分涵盖了模型选择、参数设置及优化技巧,包括epochs、batch size、学习率等关键参数的调整建议。最后总结了YOLOv11

Ai缝合怪、助力小伙伴高效发论文 3万+

进阶篇-机器学习篇-11--集成学习:随机森林、AdaBoost、GBDT(三个臭皮匠顶个诸葛亮)

Bagging =(自助采样聚合)步骤从原始数据集中有放回地随机抽取多个子集(Bootstrap样本)在每个子集上训练一个基模型(通常是决策树)预测时,所有模型投票(分类)或取平均(回归)关键点:每个模型训练数据不同,但相互独立,可以并行计算。100个医生独立看病,最后少数服从多数,比单个医生更靠谱。随机森林:用「随机」打败「过拟合」,用「投票」提升「稳定性」。AdaBoost:谁错得多,就盯着谁练;谁学得好,就让谁说了算。GBDT:不直接猜答案,而是一点点修正误差,越修越准。精度高。

weisian的博客 9715

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

机器学习集成学习全面解析:从理论到实战

本文全面解析机器学习中的集成学习方法,分为Bagging和Boosting两大类。主要内容包括: 集成学习概念:通过组合多个基学习器构建更强大的模型,核心思想是"三个臭皮匠顶个诸葛亮"。 Bagging方法: 并行训练多个独立模型,通过投票/平均组合结果 重点介绍随机森林(Random Forest)及其API使用 包含波士顿房价预测实战案例和OOB评估方法 Boosting方法: 串行训练模型,每个新模型专注于纠正前一个的错误 详细解析AdaBoost算法原理和数学公式 提供AdaBoost分类器和回归器

m0_73593563的博客 2923

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

随机森林 (Random Forest):三个臭皮匠,顶个诸葛亮

随机森林 (Random Forest):三个臭皮匠,顶个诸葛亮

core815的专栏 874

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

机器学习中的三个臭皮匠顶个诸葛亮

结合这个学期学过的算法,请问怎么实现三个臭皮匠顶一个诸葛亮结合这个学期学过的算法,请问怎么实现三个臭皮匠顶一个诸葛亮比如针对鱼分类这个案例,你会怎么做?针对“三个臭皮匠顶个诸葛亮”,在本学期所学算法中,核心对应的是思想。针对鱼分类案例,最简单的实现方式是。

ck的博客 82

集成学习:三个臭皮匠抵一个诸葛亮

通过组合多个弱学习器合成成一个强学习器。数据有重复,原因:要让结果有意义(bootstrap)后一个关注前一个训练器不足的地方进行训练。为什么不用同一份数据:无意义,结果一致。集成学习:通过构建并结合多个模型来完成学习任务,获得更好的泛化性能。Boosting:串行训练(模型逐步改进,加权计算结果)高方差模型(决策树)拿所有的数据(默认)分类:bagging思想 Boosting思想。ok,核心概念说完了现在做一个补充()bagging:并行训练(平权投票)bagging:相互独立。

weixin_60150720的博客 456

随机森林:三分钟让你懂“三个臭皮匠,顶个诸葛亮”的AI版

本文介绍了随机森林算法及其应用。随机森林是一种集成学习方法,通过构建多棵决策树并综合投票结果进行分类或回归。其优点包括抗过拟合、抗噪能力强、适合高维数据处理等,但存在参数复杂、计算速度慢等缺点。文章详细阐述了随机森林的生成规则和影响因素,并以加州房价预测为例展示了代码实现过程,包括数据准备、模型训练、性能评估和特征重要性可视化。结果表明随机森林在回归任务中表现良好,同时可通过调参进一步优化。该算法因其高准确率和鲁棒性成为机器学习领域的主流方法。

2501_93907382的博客 918

MoE模型大火,源2.0-M32诠释“三个臭皮匠,顶个诸葛亮”!

“源2.0-M32”剑指模算效率,浪潮信息是如何把MoE大模型推向大众市场的?

sinat_32970179的博客 1065

三个臭皮匠顶个诸葛亮的随机森林算法!

随机森林一个已被证明了的成功的集成分类器,特别是用在多维分类问题上更是体现出其强大之处。一个随机森林是一个决策树的集合,可以看作是一个分类器包括很多不同的决策树。整个算法包括三部...

春有百花秋有月,夏有凉风冬有雪! 272

大话机器学习之STACKing,一个让诸葛亮都吃瘪的神技

首先 感谢蓝蓝的原文,大话的基础是建立在朋友的原始stacking技术分享之上的。 stakcing常常在各大数据挖掘竞赛中被广泛使用,号称“大杀器”。是数据挖掘竞赛高端玩家必备技能,本篇文章就以大话机器学习的角度来阐述,stacking究竟是一个什么样的神技,竟然让牛B哄哄的诸葛亮也能吃瘪。 首先,stacking严格说来并不是一种算法。有的时候数据挖掘比赛就会有这样的情况,一个非常

大顺粑粑的博客 1万+

三个臭皮匠顶过诸葛亮的adaboost算法

菜鸟最近开始学习machine learning。发现adaboost 挺有趣,就把自己的一些思考写下来。 主要参考了http://stblog.baidu-tech.com/?p=19,其实说抄也不为过,但是我添加了一些我认为有意思的东西,所以我还是把它贴出来了,呵呵。 一 Boosting 算法的起源 boost 算法系列的起源来自于PAC Learnabilit

tinyh的博客 787

构建AI智能体:六十八、集成学习:从三个臭皮匠到AI集体智慧的深度解析

集成学习不是简单的"模型堆砌",而是有深刻理论支撑的系统性方法。理解其核心思想:集体智慧,多个不完美的个体可以组成一个强大的集体,误差分解,通过降低方差或偏差来提升性能,多样性驱动,模型间的差异是集成效果的关键,分层学习,从数据学习到学习如何学习。集成学习代表了机器学习中的一个重要哲学:通过协作和组合,我们可以创造出超越任何单个组件能力的系统。这正是"三个臭皮匠,顶个诸葛亮"在人工智能时代的具体实践。

minhuan的专栏 1421

集成学习

集成学习通过构建并结合多个学习器来完成学习任务。基于一种“三个臭皮匠顶个诸葛亮”的思想。

菜菜鸟的博客 129

【集成学习解惑】模型之间的多样性在集成学习中起什么作用?

模型之间的多样性在集成学习中起什么作用?

人工智能(AI)技术,大模型技术,深度学习,机器学习,计算机视觉,AI工具实践应用等分享 2012
上一篇: 两本值得一看的机器学习与面试的好书
下一篇: 主流CTR预估模型的演化及对比
Wang_AI
博客等级 码龄12年 991粉丝 162原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值