机器学习实战之良/恶性乳腺癌肿瘤数据分析

机器学习(十)-逻辑回归实践篇之乳腺癌肿瘤预测 注: 本篇博客为《Python机器学习及实践:从零通往Kaggle竞赛之路》一书逻辑回归案例的笔记,欢迎与我交流数据挖掘、机器学习相关话题。 1 项目描述 “良/恶性乳腺癌肿瘤预测”的问题属于二分类任务。 待预测的类别分别是良性乳腺癌肿瘤和恶性乳腺癌肿瘤。 通常使用离散的整数来代表类别, 0代表良性,1代表恶性。 数据信息及含义如下图所示: ... 阅读详情

良/恶性乳腺癌肿瘤数据预处理

#导入numpy和pandas包
import pandas as pd
import numpy as np

#创建特征列表
column_names = ['Sample code number','Clump Thickness','Uniformity of Cell Size','Uniformity of Cell Shape','Marginal Adhesion',
           'Single Epithelial Cell Size','Bare Nuclei','Bland Chromatin','Normal Nucleoli','Mitoses','Class']

#使用pd.read_csv从互联网读取指定数据
data = pd.read_csv('https://archive.ics.uci.edu/ml/machine-learning-databases/breast-cancer-wisconsin/breast-cancer-wisconsin.data', names = column_names)

#将?替换为标准缺失值表示
data = data.replace(to_replace='?',value=np.nan)

#丢期待有缺失值的数据(只要有一个维度有缺失)
data=data.dropna(how='any')

#输出data的数据量和维度
data.shape

(683, 11)

准备良/恶性乳腺癌肿瘤训练,测试数据

#分割数据
from sklearn.model_selection import train_test_split

#随机采样25%数据用于测试,剩下用于构建训练集合
x_train,x_test,y_train,y_test = train_test_split(data[column_names[1:10]],data[column_names[10]],test_size=0.25,random_state=33)

#查询训练样本的数量和类别分布
y_train.value_counts()

2 344
4 168
Name: Class, dtype: int64

#查询测试样本的数量和类别分布
y_test.value_counts()

2 100
4 71
Name: Class, dtype: int64

使用线性分类模型从事良/恶性乳腺癌肿瘤预测任务

from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.linear_model import SGDClassifier

#标准化数据,使得每个维度的特征数据方差为1,均值为0。使得预测结果不会被某些维度过大的特征值而主导
ss = StandardScaler()
x_train = ss.fit_transform(x_train)
x_test = ss.transform(x_test)

#初始化LogisticRegression和SGDClassifier
lr = LogisticRegression()
sgdc = SGDClassifier()

#调用fit函数/模块用来训练模型参数
lr.fit(x_train,y_train)

LogisticRegression(C=1.0, class_weight=None, dual=False, fit_intercept=True,
intercept_scaling=1, max_iter=100, multi_class=‘warn’,
n_jobs=None, penalty=‘l2’, random_state=None, solver=‘warn’,
tol=0.0001, verbose=0, warm_start=False)

#使用训练好的模型lr对x_test进行预测
lr_y_predict = lr.predict(x_test)

sgdc.fit(x_train,y_train)

SGDClassifier(alpha=0.0001, average=False, class_weight=None,
early_stopping=False, epsilon=0.1, eta0=0.0, fit_intercept=True,
l1_ratio=0.15, learning_rate=‘optimal’, loss=‘hinge’, max_iter=None,
n_iter=None, n_iter_no_change=5, n_jobs=None, penalty=‘l2’,
power_t=0.5, random_state=None, shuffle=True, tol=None,
validation_fraction=0.1, verbose=0, warm_start=False)

sgdc_y_predict = sgdc.predict(x_test)

使用线性分类模型从事良/恶性乳腺癌肿瘤预测任务的性能分析

from sklearn.metrics import classification_report

#使用逻辑斯蒂回归模型自带的评分函数score获得模型在测试集上的准确性结果
print('Accuracy of LR Classifier:',lr.score(x_test,y_test))

Accuracy of LR Classifier: 0.9883040935672515

#使用classification_repor模块获得LogisticRegression其他三个指标的结果
print(classification_report(y_test,lr_y_predict,target_names = ['Benign','Malignant']))
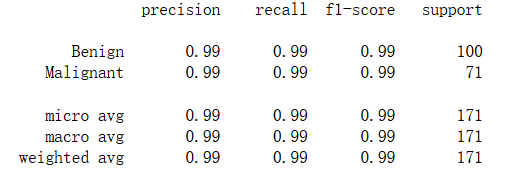
在这里插入图片描述

print('Accuarcy of SGD Classifier:',sgdc.score(x_test,y_test))

Accuarcy of SGD Classifier: 0.8304093567251462

print(classification_report(y_test,sgdc_y_predict,target_names=['Benign','Malignant']))
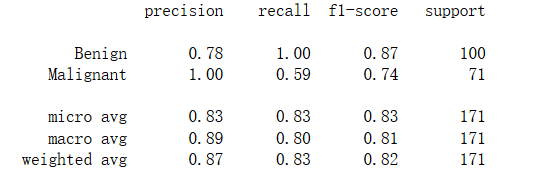
在这里插入图片描述

机器学习之乳腺癌预测 机器学习之乳腺癌预测(一).导入数据1.问题背景2.问题分析3. 认识数据集4.导入数据A.数据概述查看数据维度数据统计描述数据分布情况B.缺失处理 (一).导入数据 1.问题背景 乳腺癌是女性最常见的恶性肿瘤,占美国女性确诊癌症的近三分之一,是女性癌症死亡的第二大原因。 乳腺癌是乳房组织细胞异常生长的结果,通常称为肿瘤。 肿瘤并不意味着癌症——肿瘤可以是良性(非癌性)、恶性前(癌前)或恶性(癌性)。 MRI、乳房X光检查、超声波和活组织检查等测试通常用于诊断所进行的乳腺癌。 2.问题分析 原理:乳房细针抽 阅读详情

相关推荐

朴素贝叶斯模型实战:从原理到肿瘤分类(Python实现)

本文通过一个生动的医疗诊断案例,深入浅出地讲解了朴素贝叶斯模型的原理、核心假设及其三种常见变体。重点演示了如何使用Python的scikit-learn库,基于高斯朴素贝叶斯模型对威斯康星乳腺癌数据集进行肿瘤良恶性分类的完整实战流程,包括数据加载、模型训练、评估与可视化,并总结了该模型的优缺点及适用场景。

gold的博客 669

Python实现经典机器学习案例——良/恶性性乳腺癌肿瘤完整数据预测

Python实现经典机器学习案例 良/恶性性乳腺癌肿瘤完整数据预测 首先我们介绍一个概念,监督学习。 监督学习 “机器学习中监督学习模型的任务是根据已有经验知识对未知样本的目标/标签进行预测。根据目标预测变量的类型不同,我们把监督学习任务大体分为分类和回归两类。” 所谓分类就是预测目标是离散取值的变量,所谓回归就是预测目标是连续取值的变量。 下图为监督学习任务的基本流程:首先准备训练数据,可以是文本、图像、音频等;然后提取所需要的特征,形成特征向量(Feature Vectors);接着,把这些特征向量连同

qq_39594033的博客 1万+

机器学习:逻辑回归模型算法原理(附案例实战)

逻辑回归模型虽然名字中有回归两字,其本质却是分类模型。 分类模型与回归模型的区别在于其预测的变量不是连续的,而是离散的一些类别,以最常见的二分类模型为例,分类模型可以预测一个人是否会违约、客户是否会流失、肿瘤是属于良性肿瘤还是恶性肿瘤等

阿极的博客 3611

实验三:乳腺癌良恶性预测

一、问题描述 利用机器学习算法实现乳腺癌数据集的二分类问题,良恶性乳腺癌肿瘤预测。 二、数据集分析 乳腺癌数据集下载地址为:https://archive.ics.uci.edu/ml/machine-learning-databases/breast-cancer-wisconsin/ 乳腺癌数据集中一共有699个样本,共11列数据,每个样本有10个特征和1个对应的标签 包含16个缺失值,用”?“标出 Sample code number 索引ID Clump Thickness

1万+

14、乳腺癌检测与分类的机器学习框架

本文介绍了一个基于支持向量机(SVM)的乳腺癌检测与分类的机器学习框架。通过对威斯康星乳腺癌数据集的探索性数据分析,了解特征分布并选择关键特征,随后进行数据预处理和特征标准化。构建SVM分类模型,并通过交叉验证、超参数调优等方法优化模型性能。最终模型在测试集上表现出较高的准确率,为乳腺癌的早期诊断提供了有效的技术支持。

q1w3e5r7t9y的博客 70

基于机器学习的乳腺癌检测

本文提出一种结合图像处理与机器学习的乳腺癌检测方法,使用MIAS数据集进行实验。通过预处理、分割和特征提取后,采用SVM、逻辑回归等算法进行分类比较。结果表明,SVM准确率达90%,性能最优,适合用于乳腺癌早期预测。

zzz56的博客 1067

机器学习初篇:良/恶性乳腺癌肿瘤预测

#打开训练样本和测试样本 import pandas as pd df_train=pd.read_csv('learn/breast-cancer-train.csv') df_test=pd.read_csv('learn/breast-cancer-test.csv') #良性肿瘤,恶性肿瘤 df_test_negative=df_test.loc[df_test['Class']==2]...

Liubingzhe 1116

威斯康星州乳腺癌预测分析实战:Jupyter Notebook项目

本文还有配套的精品资源,点击获取 简介:本项目以威斯康星州乳腺癌数据集为基础,通过Jupyter Notebook进行交互式分析和模型构建,旨在预测乳腺癌患者的病情。项目覆盖了数据预处理、模型选择、性能评估及特征工程等关键步骤。所使用的算法包括逻辑回归、决策树、随机森林、支持向量机和神经网络。通过优化模型超参数和采用集成学习方法,提升了模型的预测准确性和泛化能力。整体而言,...

weixin_32836713的博客 1921

肿瘤分析数据挖掘及信息解读

肿瘤基础 特点: 疾病,无线增殖 基因相关 细胞进化过程中发展异常,突变积累 概念: germline mutation: 生殖细胞突变 somatic mutation: 体细胞突变,不可遗传 driver mutation 关键突变 passenger mutation 无关紧要 二次打击学说: 生殖细胞和体细胞突变双重打击引发,体细胞积累起关键。所以后续主要是以体细胞突变研究为主。 癌症基因组研究趋势: 小样本WES——大样本m

leroylee7的博客 777

python机器学习良恶性肿瘤数据集

  结论:通过比较,逻辑斯蒂模型比随机梯度下降模型在测试集上表现有更高的准确性,因为逻辑斯蒂采用解析的方式精确计算模型参数,而随机梯度下降采用估计值   特点分析:逻辑斯蒂对参数的计算采用精确解析的方法,计算时间长但是模型性能高,随机梯度下降采用随机梯度上升算法估计模型参数,计算时间短但产出的模型性能略低,一般而言,对于训练数据规模在10万量级以上的数据,考虑到时间的耗用,推荐使用随机梯度算法

【Docker】如何让docker容器正常使用nvidia显卡

描述了如何在docker容器中使用英伟达显卡的过程和问题解决方法。

NameLoadingFailed的博客 8372

以“良/恶性乳腺癌肿瘤预测”为例学习二分类问题

二分类问题即判断是非,从两个类别中选择一个作为预测结果。这里以“良/恶性乳腺癌肿瘤预测”数据为例进行实践。 数据地址:http://archive.ics.uci.edu/ml/machine-learning-databases/breast-cancer-wisconsin/breast-cancer-wisconsin.data 数据共有699条样本,每条样本有11列不同的数值,1列用于

yrnrcigc552197的博客 2399

【逆强化学习-1】学徒学习(Apprenticeship Learning)

逆强化学习算法1:学徒学习。算法原理+算法步骤+代码+仿真:一个基于gym的小车上山的仿真。附赠学徒学习+Q-Table及学徒学习+DQN的全套代码。

体会编程语言独到的美 7495

机器学习高斯贝叶斯算法实战:判断肿瘤是良性还是恶性

我们使用威斯康星乳腺肿瘤数据集,来构建一个机器学习模型,用来判断患者的肿瘤是良性还是恶性。

未来已来,AI时代,学AI编程,做AI量化,就来大鹏AI教育。 959

OpenMV识别颜色源码

【代码】OpenMV识别颜色源码。

dxt258013的博客 403

Gromacs GPU加速版安装全攻略:从依赖配置到性能优化

本文提供了Gromacs GPU加速版的完整安装与性能优化指南。详细介绍了从编译器、OpenMPI、FFTW到CUDA等关键依赖的配置,手把手指导编译支持CUDA的Gromacs,并深入解析了如何通过调整.mdp参数及平衡MPI与OpenMP线程分配,最大化GPU利用率,从而让分子动力学模拟效率获得数十倍提升。

y9z0a1b的博客 1153

sklearn 内置数据集-威斯康星州乳腺癌数据集

威斯康星州乳腺癌数据集是scikit-learn(sklearn)库中一个常用的内置数据集,用于分类任务。该数据集包含了从乳腺癌患者收集的肿瘤特征的测量值,以及相应的良性(benign)或恶性(malignant)标签。数据集名称:威斯康星州乳腺癌数据集(Breast Cancer Wisconsin Dataset)数据集来源:数据集最初由威斯康星州医院的Dr. William H. Wolberg收集。

m0_51542629的博客 2万+

从ADRV9002到ADRV9003:手把手教你移植FPGA驱动,避开那些官方没说的坑

本文详细介绍了从ADRV9002到ADRV9003的FPGA驱动移植实战指南,重点解析了两者在硬件架构上的关键差异,如通道配置和DPD功能的移除。通过提供完整的移植步骤、调试技巧和性能优化建议,帮助工程师避开官方文档未提及的常见陷阱,实现高效驱动开发。

weixin_28738397的博客 177

Python实战:用朴素贝叶斯模型预测肿瘤良恶性(附完整数据集)

本文详细介绍了如何使用Python和朴素贝叶斯模型进行医疗数据分析,实现肿瘤良恶性的预测。通过威斯康星州乳腺癌诊断数据集,从数据预处理、特征工程到模型构建与评估,提供了完整的代码示例和实战技巧,帮助开发者在医疗健康领域应用机器学习技术。

weixin_30275415的博客 288

YOLOv12改进策略【Neck】| 使用CARAFE轻量级通用上采样算子

CARAFE内容感知的特征重新组合。

Limiiiing的博客 664

化工设计软件:PDMS二次开发_(7).数据导入与导出技术

在某些复杂场景下,PDMS提供的标准API接口可能无法满足需求。此时,可以通过自定义API接口来实现特定的数据导入与导出功能。自定义设备导入API接口可以处理更复杂的设备数据格式。# 导入必要的库import pdms_api # 假设有一个PDMS API库# 定义自定义设备数据# 自定义设备导入API接口# 调用自定义设备导入API接口# 输出导入成功的消息print("自定义设备数据导入成功")在PDMS二次开发中,数据的导入与导出是关键的技术环节。

kkchenjj的博客 1487

乳腺癌数据集-机器学习应用:助力疾病诊断与治疗优化

乳腺癌数据集-机器学习应用:助力疾病诊断与治疗优化 【下载地址】乳腺癌数据集-机器学习应用 乳腺癌数据集为机器学习研究提供了丰富的医疗数据,涵盖患者年龄、肿瘤大小、形状等关键特征,并标注了良性与恶性标签。该数据集专为乳腺癌早期诊断、疾病风险评估及治疗方案优化等场景设计,助力开发者构建高效诊断模型。使用前需具备机器学习基础...

gitblog_06768的博客 1053

PyCharm 2024最新版图文安装教程(python环境搭建+PyCharm安装+运行测试+汉化+背景图设置)

PyCharm 2024新版图文安装教程(python环境搭建+PyCharm安装+运行测试+汉化+背景图设置)

Code_流苏:在代码中寻诗意,在实践中觅真知 4万+

机器学习实战(1)——线性分类器+Logistic回归解决良/恶性乳腺癌肿瘤预测问题

线性分类器+Logistic回归解决良/恶性乳腺癌肿瘤预测问题理论分析线性分类器Logistic回归数据分析代码分析导入数据分割数据完整代码 理论分析 线性分类器 Logistic回归 数据分析 代码分析 导入数据 分割数据 完整代码 ...

MrBamboo2000的博客 2106

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

引领未来医疗:乳腺癌预测开源项目深度解析

引领未来医疗:乳腺癌预测开源项目深度解析 在医疗科技的浪潮中,有一颗璀璨之星正致力于改变乳腺癌诊断的方式——《乳腺癌预测》项目。该项目不仅利用最前沿的机器学习和深度学习技术来区分乳腺癌的良恶性,更为医生们提供了一个直观易用的界面,减少女性不必要的手术痛苦,迈向更精准的医疗时代。 项目概览 《乳腺癌预测》是基于Wisconsin乳腺癌数据集的一个开源项目,旨在通过AI的力量预测癌症的性质,帮助临床决...

gitblog_00612的博客 608

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

sklearn机器学习实战——基于AdaBoost完成乳腺癌分类(附完整代码和结果图)

在这篇博文中,我们将探讨如何使用机器学习中的集成学习算法——AdaBoost来构建一个分类模型,应用于乳腺癌数据集。我们将介绍从数据预处理到模型评估的各个步骤。AdaBoost(Adaptive Boosting)是一种基于Boosting思想的集成学习算法。Boosting通过将多个弱分类器(比如决策树桩)结合起来,形成一个强大的分类器。每个分类器在数据上进行训练时,关注那些之前被误分类的数据点。其核心思想是通过调整样本权重来增强模型的学习能力。

m0_59197405的博客 2742

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

上一篇: nlp系列-jieba安装
下一篇: 使用支持向量机分类处理器处理Scikit-learn内部集成的手写体数字图片数据集
XB_please
博客等级 码龄8年 80粉丝 121原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
