Spark设置日志打印级别

Spark 通过 spark-submit 设置日志级别 Spark有多种方式设置日志级别,这次主要记录一下如何在spark-submit设置Spark的日志级别。1、如果在自己的测试集群上,直接修改$SPARK_HOME/conf下的log4j.properties即可2、如果在Eclipse里,将log4j.properties放在项目的src/main/resources即可3、如果在生产环境的集群,又不允许修改配置文件的话,用上面讲的spark-submit --conf 即可。... 阅读详情

一、修改Spark-core包默认的日志级别

spark中提供了log4j的方式记录日志。可以在$SPARK_HOME/conf/下,将 log4j.properties.template 文件copy为 log4j.properties 来启用log4j配置。但这个配置为全局配置,不能单独配置某个job的运行日志。Spark-core包设置默认的日志级别为info。将文件中的log4j.rootCategory=INFO, console修改为log4j.rootCategory=ERROR, console即可,如下图所示:
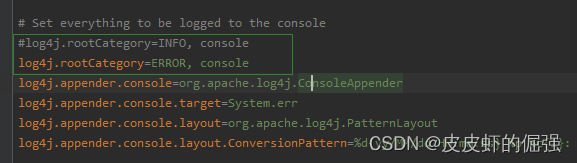
在这里插入图片描述
此时,在控制台调试spark程序就没有了INFO信息。
在这里插入图片描述

二、在Spark程序中设置日志打印级别:

        JavaSparkContext sc = new JavaSparkContext(conf);
        //设置日志输出级别
		sc.setLogLevel("ERROR");
		JavaRDD<String> lines = sc.textFile("input.txt");

三、 在maven项目中设置Spark程序的日志打印级别:

  1. 引入logger4j和slf4j的依赖
        <dependency>
            <groupId>log4j</groupId>
            <artifactId>log4j</artifactId>
            <version>1.2.17</version>
        </dependency>
        <dependency>
            <groupId>org.slf4j</groupId>
            <artifactId>slf4j-api</artifactId>
            <version>1.7.21</version>
        </dependency>
  1. 在代码中加入
        Logger.getLogger("org").setLevel(Level.ERROR);
Spark3调整日志级别实现大数据分析 默认情况下,Spark的日志级别为INFO,这意味着除了DEBUG级别的日志信息外,其他所有级别的日志都会被打印输出。在实际场景中,我们经常需要调整Spark的日志输出级别,以便更好地控制日志信息的显示。需要注意的是,上述代码在示例中设置了两个Logger对象的日志级别,分别是"org"和"akka"。总结起来,通过设置Spark的日志输出级别,我们可以更好地控制日志信息的显示,提高大数据处理过程中的开发效率和调试能力。这样一来,除了ERROR和FATAL级别的日志信息外,其他级别的日志都不会被输出。 阅读详情

相关推荐

Spark 3 设置日志级别详解

在上面的示例中,我们将根日志级别设置为 INFO,这意味着只会输出 INFO 级别及以上的日志信息。例如,我们将 Apache Spark 包的日志级别设置为 DEBUG,这意味着会输出 DEBUG 级别及以上的日志信息。通过适当设置日志级别,我们可以控制 Spark 应用程序输出的日志信息的详细程度。通过以上两种方法之一,我们可以在 Spark 3 中设置日志级别。请注意,以上示例是使用 Scala 编程语言编写的,但类似的方法也适用于其他支持 Spark 的编程语言,如 Java 和 Python。

ByteHackerX的博客 832

Spark设置日志级别的三种方式, Spark-sumbit设置日志级别,修改Spark本地conf设置日志级别, IDEA中设置日志级别 17

1. Spark设置日志级别 前言 Spark有多种方式设置日志级别,这次主要记录一下如何在Spark-submit设置Spark日志级别,本文介绍三种方式 需求 因为Spark的日志级别默认为INFO(log4j.rootCategory=INFO, console),这样在运行程序的时候有很多我不需要的日志信息都打印出来了,看起来比较乱,比较烦,抓不住重点,而我只想把warn和error打印...

啊策策大数据社区 1万+

[Spark--编码]--如何设置日志的打印级别

[Spark--编码]--如何设置日志的打印级别

欢迎来到我的博客,一起探索代码里的世界! 1万+

【spark】控制日志输出的方法

【spark】控制日志输出的方法

hyj 8091

如何在两台电脑间,实现zotero文件和数据两种类型的双向同步

在完成本文配置后,可以在两台不同的电脑间,通过两步简单操作实现zotero数据和文件的双向同步,并且全程免费首先,打开zotero->编辑->首选项->高级->文件与文件夹,配置链接附件根目录以及数据存储位置,前者将pdf文件通过相对地址形式存于zotero中(而非真正的pdf文件),后者则是设置用户本地数据的地址建议设置在数据盘D盘,可以避免后续对盘名的修改(因为基本每个电脑都存在C盘和D盘)然后,同一页面下,打开同步,配置数据以及文件同步方式。数据同步保持默认即可,文件同步选择WebDav,然后去坚果云

weixin_43008154的博客 1万+

winget安装提示:执行此命令时发生意外错误: InternetOpenUrl() failed. 0x80072efd

当我们使用Winget包管理器安装应用,提示错误:执行此命令时发生意外错误: InternetOpenUrl() failed. 0x80072efd 该怎么处理呢?请听我娓娓道来。

Linux I Tell U 8136

设置Spark程序设置日志打印级别

在maven项目中设置Spark程序的日志打印级别: 引入logger4j和slf4j的依赖 <dependency> <groupId>log4j</groupId> <artifactId>log4j</artifactId> <version>1.2.17</version> </dep...

再难也要坚持的博客 1011

父子Agent架构:解决AI系统上下文污染的技术方案

在AI系统设计中,上下文管理是核心挑战之一。传统单Agent架构在处理复杂任务时,常面临上下文无限膨胀导致的信息淹没和性能下降问题。父子Agent架构通过职责分离和上下文隔离机制,采用分而治之的思想,将大任务拆解为多个子任务由专门子Agent处理。该架构中父Agent负责任务规划和结果汇总,子Agent执行具体任务后立即销毁中间状态,通过精炼摘要进行通信。这种设计不仅能有效控制上下文长度,还能提升系统稳定性和执行效率,特别适用于编程辅助、自动化测试等需要多步骤处理的场景。父子Agent架构体现了计算机科学中

weixin_42531710的博客 352

在IDEA工具中设置Spark程序设置日志打印级别

引入logger4j和slf4j的依赖 <dependency> <groupId>log4j</groupId> <artifactId>log4j</artifactId> <version>1.2.17</version> </dependency&gt...

zhaoguowei的博客 2571

Kettle下载与安装教程【保姆版】

Kettle简介 Kettle最早是一个开源的ETL工具,全称为KDE Extraction, Transportation, Transformation and Loading Environment。后来Kettle重命名为Pentaho Data Integration 。 它由Java开发,支持跨平台运行,其特性包括:支持100%无编码、拖拽方式开发ETL数据管道;可对接包括传统数据库、文件、大数据平台、接口、流数据等数据源;支持ETL数据管道加入机器学习算法。 主要功能 Pentaho D

weixin_43407520的博客 12万+

复古与新生:老毛子Padavan固件在旧设备上的现代化应用之旅

本文探讨了如何通过刷入Padavan固件,让小米路由器3G(R3G)等老旧设备重获新生,实现现代化应用。详细介绍了从硬件潜力分析、智能家居中枢搭建,到轻量级服务器部署和网络功能扩展的全过程,为技术爱好者提供了一条低成本、高性能的设备改造之路。

k8s6orchestrator的博客 1061

JAVA代码如何设置SPARK的日志打印级别

问题场景:在使用spark sql 增加where条件过滤时,会出现打印很多的被过滤掉的记录(几十万条),导致跑spark sql 特别慢! var df2 = sqc.sql("SELECT * FROM T_COMMISIONRATEDEF WHERE T_INSURANCETYPE = '630' ORDER BY T_INSURANCETYPE DESC " ) 执行时,打印截

wumiqing1的博客 3141

告别屏幕闪烁:手把手教你用示波器抓取并分析MIPI DSI信号(以RK平台为例)

本文详细介绍了如何利用示波器抓取并分析MIPI DSI信号,以解决LCD屏幕闪烁、花屏等问题。以RK平台为例,从工具准备、示波器参数配置到信号捕获与波形解读,提供了一套完整的调试方案,帮助硬件工程师快速定位和解决显示接口信号完整性问题。

weixin_33704591的博客 654

spark代码中添加logger_JAVA代码如何设置SPARK的日志打印级别

问题场景:在使用spark sql 增加where条件过滤时,会出现打印很多的被过滤掉的记录(几十万条),导致跑spark sql 特别慢!var df2 = sqc.sql("SELECT * FROM T_COMMISIONRATEDEF WHERE T_INSURANCETYPE = '630' ORDER BY T_INSURANCETYPE DESC " )执行时,打印截图:解决方法:设...

weixin_39998521的博客 545

岭回归的MATLAB步骤

MATLAB 实现框架,它涵盖了从数据导入到岭回归的步骤,包括计算共线性、使用 MAE、MSE、R²、MAPE 进行评价,以及绘制相应的可视化图表。

subject625Ruben的博客 1089

基于投影法实现扫描文件的光学字符分割——Matlab实现

投影法是指将原图像沿着某个特定的方向进行投影,得到投影线上的像素点的个数或像素值总和,从而可以得到该方向上物体的轮廓信息。对于字符分割,我们可以将图像进行水平和垂直两个方向的投影,从而得到字符之间的分割线。在OCR技术中,字符分割是非常重要的一步骤,因为字符之间的分割对字符识别的准确性有很大的影响。通过对投影值的判断,可以求出字符之间的分割线,这里我们根据垂直方向上的投影值进行判断,选取一个阈值进行筛选即可。使用sum()函数分别计算出水平和垂直方向上的投影值,得到每一行和每一列的投影值。

TechGlide的博客 581

Spark on Yarn 自定义日志打印及级别

Spark on Yarn自定义日志输出及级别spark 自定义日志打印及级别日志打印定义 spark 自定义日志打印及级别 在处理spark任务的时候,我们需要经常查看日志,那么日志的级别对我们来说就很重要。但有时候,我们还需要输出一些业务日志,那它就会被spark的大量日志给覆盖掉,但调日志级别,又会使查找问题变的比较困难,今天,我们来解决下这个问题。 日志打印定义 我们首先需要日志配置文件,并在任务提交的脚本中设置成我们自定义的日志文件。这里将分别对两种日志进行配置对比,分别是java自带日志和spa

T_Janey 3308

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

Spark 去除控控制台打印info日志

方法一 在Spark-Shell运行如下命令: import org.apache.log4j.Logger import org.apache.log4j.Level Logger.getLogger("org").setLevel(Level.OFF) Logger.getLogger("akka").setLevel(Level.OFF) 方法二 修改log4j配置文件(conf/log4j.properties): log4j.rootCategory=OFF, console ...

cai_and_luo的博客 1291

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

Spark-shell中停止打印INFO日志

Spark-shell中停止打印INFO日志spark设置info不显示 spark设置info不显示 spark-shell在运行时常常输出一堆红色文字日志,影响代码体验,那么如何设置使得info不输出呢? 可在代码中如下设置(亲测有效): ...

l491899327的博客 630

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

spark代码中添加logger_如何在Spark中关闭INFO日志记录?

我使用AWS EC2指南安装了Spark,并且可以使用bin/pyspark脚本很好地启动该程序以到达Spark 提示,并且还可以成功执行快速入门Quide。但是,我无法终生解决如何INFO在每个命令后停止所有冗长的日志记录。我在下面的代码(注释掉,设置为OFF)中的几乎所有可能的情况下都尝试了该log4j.properties文件,该conf文件位于我从中以及在每个节点上启动应用程序的文件夹中,...

weixin_42507297的博客 491

spark中用println输出一些控制信息

部分代码如下: def main(args: Array[String]): Unit = { Logger.getLogger(&quot;org&quot;).setLevel(Level.OFF) Logger.getLogger(&quot;akka&quot;).setLevel(Level.OFF) Logger.getRootLogger().setLevel(Level.ERROR) //这里是...

微电子学与固体电子学-俞驰 3768

Spark学习笔记(27)详解Spark Streaming的运行日志

本期内容: 1. Spark Streaming日志 2. Spark Streaming在IDE中的日志分析  WordCountLine 15秒钟的时间间隔 日志中ForeachDStream先打印。 SocketInputDStream storage level false,false,false,false,1 但StorageLevel: remembe

Jason的专栏 2433

Maven工程中隐藏控制台的日志输出

Maven工程中隐藏控制台的日志输出 在src/main/resources中添加一个file :log4j.properties 内容如下 log4j.rootCategory=ERROR, console log4j.appender.console=org.apache.log4j.ConsoleAppender log4j.appender.console.target=System.err log4j.appender.console.layout=org.apache.log4j.Pattern

qq_54021998的博客 1082

Spark-HDFS

package org.example import org.apache.log4j.{Level, Logger} import org.apache.spark.{SparkConf, SparkContext} object Spark_Hdfs { def main(args: Array[String]): Unit = { Logger.getLogger("org.apache.spark").setLevel(Level.OFF) Logger.getLogger

cai_and_luo的博客 302

MyBatis和log4j 零碎笔记

尚硅谷SparkStreaming项目中要用到的知识点。配置规则namespace:必须和接口的全类名一致​ sql 的id: 必须和对应的方法名一致占位符:#{}内的参数要和pojo的属性名完全一致,才能获得set、get方法。sql.xml要在主xml中的mapper标签中声明。①程序需要打印日志,必须先声明一个Logger。 ②调用Logger,使用不同的级别打印日志。 FATAL: 打印致命错误信息 ERROR: 打印错误信息 WARN: 打印警告信息...

林子茗的博客 212
上一篇: Maven项目安装和引用本地jar包
下一篇: 搭建Scala的IntelliJ IDEA开发环境
皮皮虾的倔强
博客等级 码龄8年 425粉丝 17原创
评论 1
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
