批标准化(Batch Normalization)

批归一化(Batch Normalization)详解 批归一化(Batch Normalization)详解 文章目录批归一化(Batch Normalization)详解前言一、数据归一化二、BN解决的问题:Internal Covariate Shift三、BN如何做的数据归一化四、BN的本质总结 前言 批归一化简称BN,是由Google于2015年提出,这是一个深度神经网络训练的技巧,它不仅可以加快了模型的收敛速度,而且更重要的是在一定程度缓解了深层网络中“梯度弥散(特征分布较散)”的问题,从而使得训练深层网络模型更加容易和稳定。所以目前BN已经成为几 阅读详情

论文地址:Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift

BN是2015年提出的,现在已经被广泛地应用在神经网络当中。其实关于BN的方方面面在维基上有着很详细的阐述,想深入研究的同学可以看一看。

以下我只稍微讲讲我觉得比较重要的部分。

为什么要进行BN?

简单一句话,就是为了训练参数更好更有效地向前传播。

而为什么参数会出现不好传播的情况呢?主要原因是激活函数的使用。为了增加模型的非线性表达能力,在层与层之间常常加上一层激活函数。而这层激活函数的存在会使得数据分布产生变化,大部分激活函数都会有一个敏感区间,而非敏感区间的数据有可能就在多层的参数传递后丢失了。尤其是在层数特别深的情况下,未经过标准化的数据起到的作用相当有限。

这个情况有一个名词,叫内部协变量偏移( internal covariate shift),即在训练过程中每一层网络的数据分布上参数的初始化与变化(层层叠加),将会影响整个网络的学习率。BN最初提出就是为了解决这个问题,但BN与covariate shift之间的关系实际上是未经实验严格证明的。

所以,BN层的作用是把一个mini-batch内的所有数据,从不规范的分布拉到正态分布。这样做的好处是使得数据能够分布在激活函数的梯度较大的区域,因此也提高了泛化能力,可以在一定程度上解决梯度消失的问题,同时可以减少dropout的使用。

当参数更好地向前传播后,梯度的下降会更加稳定,可以使用更大的学习率来加快学习。对数据分布的不断调整也减轻了对参数初始化的依赖,利于整体调参。

如何进行BN(BN的正向传播过程)?

BN其实就是将batch内的数据实现均值为0,方差为1的正态分布。BN一般放在激活函数之前。

如下图,步骤很简单:
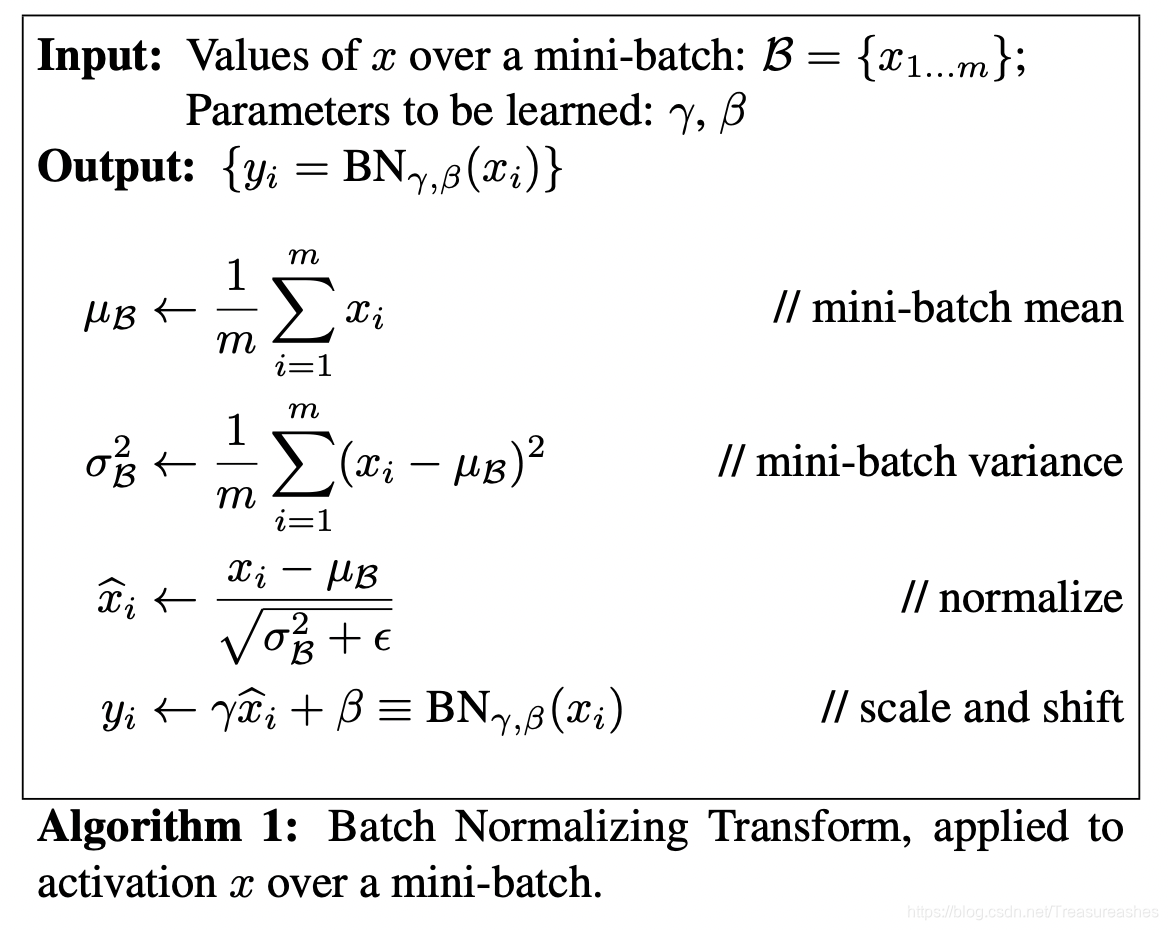
  1. 计算mini-batch中的均值(mini-batch mean)
  2. 计算mini-batch内的方差(mini-batch variance)
  3. 对每一个元素进行归一化(normalize)。我们知道正态分布的表达式是y=\frac{x-\mu}{\sigma},其中\epsilon是为了mini-batch的数值稳定性而加到方差中的一个常数。如果忽略它,每一个mini-batch的元素都是采样于同一个数据分布的值。
  4. 进行尺度缩放与偏移操作(scale and shift):其中偏移\beta(对应于均值)和尺度\gamma(对应于方差)为参数,通过训练来学习的。目的是为了补偿网络的非线性表达能力。

为什么是mini-batch?

主要是由于目前主流的梯度更新方式是mini-batch gradient decent,小批的梯度下降,这种方法把数据分为若干个批,按批来更新参数,这样,一个批中的一组数据共同决定了本次梯度的方向,下降起来就不容易跑偏,减少了随机性。另一方面因为批的样本数与整个数据集相比小了很多,计算量也不是很大。

当mini-batch中只有一条数据,如何确定1.2.中的均值与方差?

可以采用训练收敛最后几批mini batch的 𝜇和𝜎的期望,作为预测阶段的𝜇和𝜎。

为什么?一开始我们就想用所有数据的均值和方差,但是对于模型训练迭代是不现实的,所以用了mini-batch的均值和方差。现在训练收敛最后几批的数据分布,可以看作是全局的数据分布,其均值和方差可以直接用当然更好。

BN的训练过程?
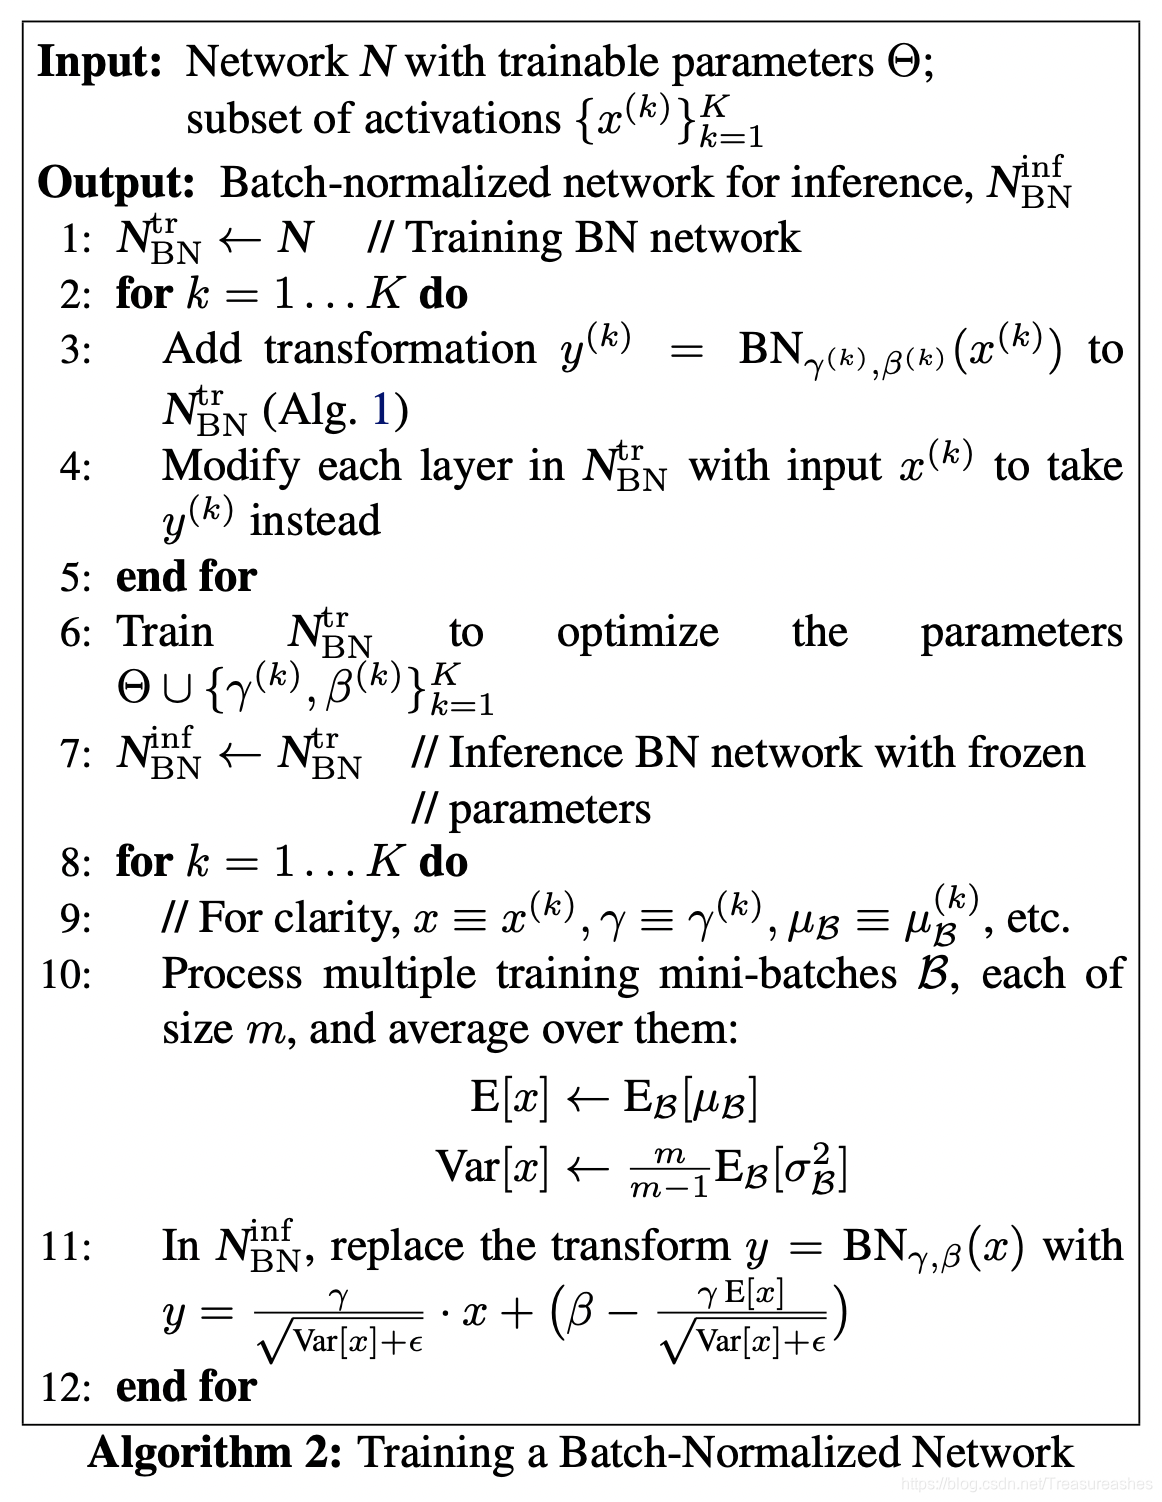
整个训练过程没有什么特别的,只是加上了BN层进行计算而已。但当训练结束后,每一层的BN就不是很必要了,因为它的两个参数\gamma和\beta已经固定,inference时BN可以用一个线性变换来替换(11行)。

 BN的反向传播?

其实这就是用传播图与链式法则求导而来,原文中没有过多解释。我试了试,推的过程不是很难,就是要注意函数之间的复合情况,画一个计算图更不容易漏掉。
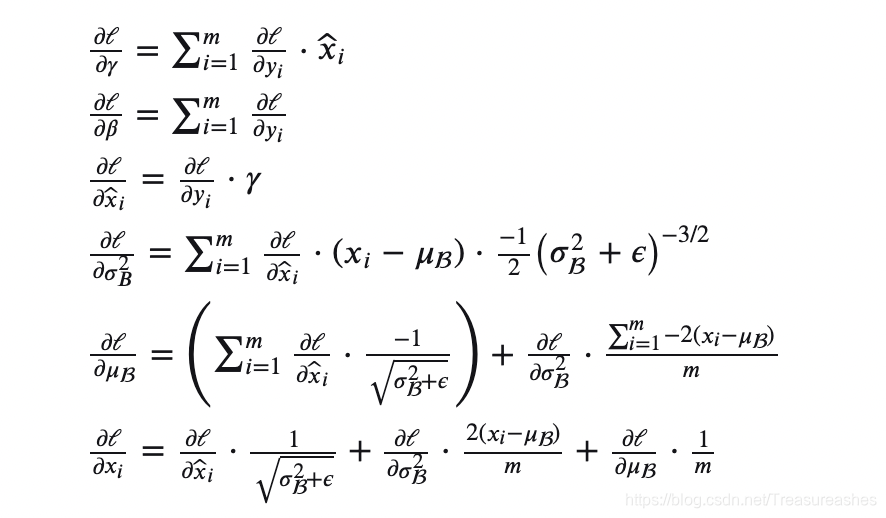
卷积层如何使用BN?

一个卷积核产生1个feature map, 一个feature map 就会有1对参数\gamma和\beta。为了在卷积层上保持BN的性质,不仅要在mini-batch之间进行BN,也要在不同的位置的feature map之间进行BN。对于卷积层来说,不是在每个激活元之间共享参数,而是跨mini-batch的feature map 要共享一对参数。

所以此时,在算法中的\mathcal{B}从一个mini-batch(size m)的所有值集合变成了跨mini-batch的feature map(size m p q)的所有值集合。参数对的个数也从p*q*c(channel)变成了c。

如果还不是很理解,可以看这个答案:Batch Normalization in Convolutional Neural Network

Batch Normalization 批量归一化 【全方位解释】 批量归一化(Batch Normalization),由Google于2015年提出,是近年来深度学习(DL)领域最重要的进步之一。该方法依靠两次连续的线性变换,希望转化后的数值满足一定的特性(分布),不仅可以加快了模型的收敛速度,也一定程度缓解了特征分布较散的问题,使深度神经网络(DNN)训练更快、更稳定。 阅读详情

相关推荐

【标准化方法】(1) Batch Normalization 原理解析、代码复现,附Pytorch完整代码

神经网络层数的增加会增加模型计算负担,同时也会导致模型变得难以训练。随着网络层数的增加,数据的分布方式也会随着层与层之间的变化而变化,这种现象被称为内部协变量偏移 ICS。通常解决 ICS 问题的方法是使用较小的学习率,后来为更好的解决该问题,Sergey等提出批处理标准化算法(Batch Normalization)

博观而约取,厚积而薄发 3627

BatchNormalization

本文仅介绍BatchNormalization的理解,对于原理部分,网上博客资料很详细. 在做图像的神经网络训练时,我们往往每次给神经网络喂食一个batch的数据,当然这些数据指的是一个个的image或者feature map.比如我们batch_size=32,即每次处理32张image或者 feature map.而这一个batch的数据的不能反映出该batch的分布情况,需要将其映射到某个区间上,以反映样本集的分布,这时候就需要使用normalization对数据进行处理.可以参考下面图片理解.使用了

森宝的博客 5593

【Pytorch教程】:批标准化 (Batch Normalization)

Pytorch教程目录 Torch and Numpy 变量 (Variable) 激励函数 关系拟合(回归) 区分类型 (分类) 快速搭建法 批训练 加速神经网络训练 Optimizer优化器 卷积神经网络 CNN 卷积神经网络(RNN、LSTM) RNN 循环神经网络 (分类) RNN 循环神经网络 (回归) 自编码 (Autoencoder) DQN 强化学习 生成对抗网络 (GAN) 为什么 Torch 是动态的 GPU 加速运算 过拟合 (Overfitting) 批标准化 (Batch Norm

nanke_4869的博客 5702

整理学习之Batch Normalization(批标准化)

整理学习Batch Normalization

你好 2万+

批标准化(Batch Normalization, BN)

批标准化(Batch Normalization, BN)   在BP算法中,根据公式(3)(4),我们知道偏导数中存在激活函数发f(⋅)f(·)f(⋅)的导数,如果激活函数是logistic-sigmoid或者tanh函数,它们的导数值域均在[0,1]之间,所以随着层数的增多,反向传播会持续缩小残差δ\deltaδ的值,造成远离输出层的权值与偏差的梯度不断的缩小(根据公式(1)(2)),所以这些...

Leon_winter的博客 3939

深度学习基础(六)—— 批标准化 (Batch Normalization)

特征数据的标准化 针对每一类型做标准化而不是整个数据 令数据统一跨度加速数据处理 两种标准化的方法: Batch Normalization 将分散数据统一的一种方法,神经网络训练过程中,网络越深信息损失会严重...

qq_38622495的博客 2272

什么是批标准化 (Batch Normalization)

什么是批标准化 (Batch Normalization) 每层都做标准化 你再也不用去理会过拟合中drop out、L2正则项参数的选择问题,采用BN算法后,你可以移除这两项了参数,或者可以选择更小的L2正则约束参数了,因为BN具有提高网络泛化能力的特性;再也不需要使用使用局部响应归一化层了(局部响应归一化是Alexnet网络用到的方法,搞视觉的估计比较熟悉),因为BN本身就是一个归一化网络层。 BN概述 就像激活函数层、卷积层、全连接层、池化层一样,BN(Batch Normalization)也属于网

weixin_53002252的博客 1034

批标准化(Batch Normalization)总结

文章目录一. Batch & mini-batch二. 为什么要使用 Batch Nomalization三. 如何进行 normalization四. normalization 的好处与缺点优点:缺点:参考 Batch Normalization是基于mini-batch进行的,所以在下文中我们首先复习一下mini-batch是怎么一回事,然后说明为什么需要进行Batch Normalizat...

Konata的博客 3599

Batch Normalization--批标准化

批标准化介绍: 机器学习领域有个很重要的假设:IID独立同分布假设,就是假设训练数据和测试数据是满足相同分布的,这是通过训练数据获得的模型能够在测试集获得好的效果的一个基本保障。而BatchNorm是干啥的呢?BatchNorm就是在深度神经网络训练过程中使得每一层神经网络的输入保持相同分布的。 一、数据分布对训练会产生影响??? 答案是肯定的。 比如某个神经元 x 的值为1, 某个 Weights 的初始值为 0.1, 这样后一层神经元计算结果就是 Wx = 0.1; 又或者 x = 20, 这样 Wx

qq_42182596的博客 339

TensorFlow批标准化(Batch Normalization)

 本篇博客主要介绍深度学习中批标准化(batch normalization),是将分散的数据统一的一种方法, batch normalization被添加在全连接层和激活函数之间 经过和未经过batch normalization的数据经过激活函数的输入输出区别 batch normalization不仅正向对数据进行了标准化,还对数据进行反向标准化,可以让神经网络知道批标...

cchangcs 1769

关于Nuttx操作系统

NuttX是一个成熟的实时操作系统

qq_28576837的博客 4092

(Batch Normalization)批标准化算法理解

批标准化 1.概念 2.方法 3.优缺点 4.示例 批标准化 1.概念 batch normalization,就是“批规范化”,即为了克服神经网络层数加深,收敛速度变慢,常常导致梯度消失(vanishing gradient problem)或梯度爆炸(gradient explore),通过引入批标准化来规范某些层或者所有层的输入,从而固定每层输入信号的均值与方差。 ...

鲲鹏望舒 7416

NVIDIA NCCL 安装和测试实战教程

ibrary)是用于深度学习应用的高性能通信库,可加速多GPU通信和同步。它能够在多个GPU之间进行高效的数据传输和集体操作,显著提高了分布式GPU系统上深度学习训练和推理的性能。NVIDIA NCCL是加速多GPU系统上深度学习应用的必不可少的工具。其高效的通信原语和集体操作显著提高了分布式训练和推理的性能,使其成为现代深度学习基础架构的关键组成部分。

weixin_39818775的博客 4430

5.6 高阶内容-Batch Normalization 批标准化

1.写在前面 批标准化通俗来说就是对每一层神经网络进行标准化 (normalize) 处理, 我们知道对输入数据进行标准化能让机器学习有效率地学习. 如果把每一层后看成这种接受输入数据的模式, 那我们何不 “批标准化” 所有的层呢? 那我们就看看下面的两个动图, 这就是在每层神经网络有无 batch normalization 的区别啦. 2.做点数...

敲代码的乔帮主 597

28-基于STM32单片机的便携式健康监测系统设计与实现(程序+原理图+元件清单)

本文详细介绍了基于STM32单片机的便携式健康监测系统设计与实现,该系统集成MAX30102光电传感器和MSP20压力传感器,实时监测心率、血氧和血压等关键生理指标。通过STM32F103C8T6主控芯片和HC-05蓝牙模块,实现数据采集、处理及无线传输,具有便携性高、操作简便等特点,适用于家庭健康监护和户外运动场景。

weixin_29191669的博客 420

手把手教你学Simulink——基于核能发电系统的场景实例:核电站汽轮机与发电机协调控制仿真

在核电机组中,汽轮机-发电机系统是将核能最终转化为电能的关键环节。与火电机组不同,核反应堆的热惯性大、功率调节慢,因此汽轮机的控制策略需与反应堆特性相匹配,实现安全、稳定、高效的能量转换。维持发电机输出功率/频率稳定(响应电网调度)调节汽轮机进汽压力(匹配一回路蒸汽供应)实现“堆-机协调控制”保障机组在启停、变负荷、甩负荷等工况下的安全性本教程将带你使用构建一个核电站汽轮机与发电机协调控制系统汽轮机调速系统(调门控制)建模发电机与电网接口建模(同步机)

MHD0815的博客 212

深入理解Batch Normalization批标准化

深入理解Batch Normalization批标准化

夜阑卧听风吹雨,铁马是你,冰河也是你。 225

GPFS扩展技术原理(十一)-FMDN广播与EID加解密

GFPS扩展技术原理(十一)FMDN广播及EID加解密

十多年蓝牙协议软件开发,擅长蓝牙协议分析 935

Python和PyTorch对比实现批标准化Batch Normalization函数及反向传播

相关 原理及详细解释, 请参考 : BrightLamp. Batch Normalization函数详解及反向传播中的梯度求导[EB/OL]. https://blog.youkuaiyun.com/oBrightLamp/article/details/84332455. 正文 import torch import numpy as np class BatchNorm1d: def __...

BrightLamp的博客 1945

STM32(HAL库)驱动OLED

通过STM32F103C8T6单片机采用HAL库方式对0.96寸OLED(IIC通讯)屏幕进行驱动。

weixin_44597885的博客 8802

PCB高速信号换层孔新技术:VECS(Vertical Conductive Structure Technology)解析

摘要:垂直导电结构(VeCS)是一种新型PCB互连技术,由平板信号走线和椭圆形接地层构成半同轴结构,相比传统过孔具有显著优势。通过全波仿真和实测验证,VeCS展现出更好的阻抗连续性、更低的插入损耗和回波损耗,以及优异的串扰抑制能力。其椭圆形接地结构能有效隔离电磁干扰,在相同布线密度下远端串扰比传统过孔降低约50%。VeCS制备工艺与传统PCB工艺兼容,无需新增设备,且能实现更高密度互连。测试结果显示,2.5英寸带状线通道中VeCS结构的信号完整性表现明显优于传统过孔,为高速数字系统提供了更可靠的垂直互连解决

小孟同学的博客 201

学习笔记——Batch Normalization批标准化

Batch Normalization批标准化 由于深度网络会出现训练速度变慢,梯度消失的问题,BN的作者分析是因为神经元的输入在Sigmoid函数的平缓段。输入值(WX+B)距离0太远,非线性激活函数的结果太接近-1或者1,从而导致训练时出现梯度消失的问题。 BN的操作是根据训练集分布,计算样本均值和方差,将原问题转换成0均值,1方差的标准正态分布。 但是正态分布如果太接近0,太接近线性,会使深...

Andyooper的博客 300

基于深度学习的电力系统暂态稳定评估与预防控制复现

本文复现了基于深度学习的电力系统暂态稳定评估与预防控制方法。主要内容包括:(1)数据预处理环节,对IEEE 39节点系统的电压幅值、相角等特征数据进行归一化处理;(2)ACNGAT模型实现,该模型结合时间卷积网络(TCN)和图注意力网络(GAT)提取时空特征;(3)采用改进的帝企鹅优化算法进行预防控制。关键技术点包括:融合时空信息的特征提取、改进的邻接矩阵构建方法(λ_ij = E_i * E_j * B_ij)以及时空注意力机制。代码实现采用Python和PyTorch框架。

huanghm88的专栏 336

批标准化(batch normalization)

一.概述 1.为什么需要BN 我们知道网络一旦train起来,那么参数就要发生更新,除了输入层的数据外(因为输入层数据,我们已经人为的为每个样本归一化),后面网络每一层的输入数据分布是一直在发生变化的,因为在训练的时候,前面层训练参数的更新将导致后面层输入数据分布的变化。以网络第二层为例:网络的第二层输入,是由第一层的参数和input计算得到的,而第一层的参数在整个训练过程中一直在变化,因此必...

bestrivern的博客 8816

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

深度学习笔记-011批标准化(Batch Normalization)

什么是标准化 传统机器学习中标准化也叫归一化 一般是将数据映射到指定的范围中,用于去除不同维度数据的量纲以及量纲单位,使得模型鲁棒性更好 数据标准化可以让机器学习模型看到的不同样本彼此之间更加相似,这有助于模型的学习与对新数据的泛化 常见的数据标准化形式 标准化和归一化 归一化:将数据变为0-1之间。在pytorch中使用toTensor方法进行归一化操作。 标准化:将数据减去其平均值使其中心为0,然后将数据除以其标准差使其标准差为1。 什么是批标准化 batch normalization 和普

tuanzi2809的博客 1101

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

上一篇: Column-and-row Generation 列和行生成算法(一)
下一篇: Column-and-row Generation 列和行生成算法(二)
普通网友
博客等级 码龄11年 177粉丝 82原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值