跳表

Redis-跳表 跳表(skiplist)是一种有序数据结构,它通过在每个节点维持多个指向其他节点的指针来达到快速访问的目的。Redis使用跳表作为有序表的底层实现。 阅读详情

跳表

结合链表和二分法的特点,将链表进行加工,创造一个二者的结合体:

  1. 链表从头节点到尾节点是有序的
  2. 可以进行跳跃查找(形如二分法),降低时间复杂度

跳表其实也是一种通过“空间来换取时间”的一个算法,通过在每个节点中增加了向前的指针,从而提升查找的效率。

跳表的性质
(1) 由很多层结构组成,level是通过一定的概率随机产生的
(2) 每一层都是一个有序的链表,默认是升序
(3) 最底层(Level 1)的链表包含所有元素
(4) 如果一个元素出现在Level i 的链表中,则它在Level i 之下的链表也都会出现
(5) 每个节点包含两个指针,一个指向同一链表中的下一个元素,一个指向下面一层的元素

next数组
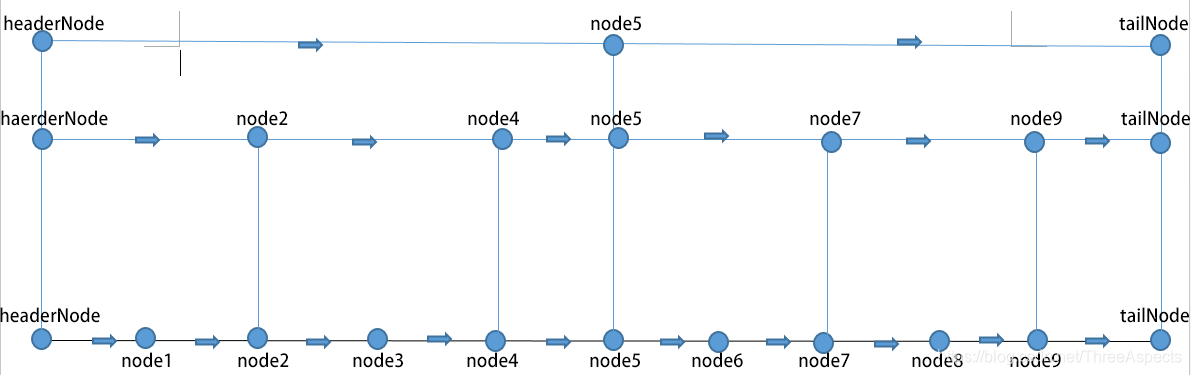
  一个有序的链表,选取它的一半的节点用来建索引,这样如果插入一个节点,比较的次数就减少了一半。这种做法,虽然增加了50%的空间,但是性能提高了一倍。
在这里插入图片描述
  通常会定义跳表的级数,即层数-1(最下面一级是0级)。所以这张图表示的跳表的级数是(0, 1, 2)。而在第2级的节点(比如node5),它的next数组大小就是(2 + 1) == 3, 在第1级的节点(比如node4),它的next数组的大小就是(1 + 1) == 2, 在第0级的节点(比如node3),它的next数组大小是1。对于第2级的node5来说:

node5->next[2] == tailNode;
node5->next[1] == node7;
node5->next[0] == node6;

对于第1级的node2来说:

node2->next[1] == node4;
node2->next[0] == node3;

查找
在这里插入图片描述
  headerNode和tailNode是人为添加的两端节点,很像存在头节点和尾节点的链表,它们不存储需要保存的有用的数据,仅仅是用来判断是否是头和尾。当跳表为空时,级数为0,headerNode->next[0] == tailNode。比较的时候的三种情况,以targetNode->next[i]->element和theElement为例:

1.小于:令targetNode = targetNode->next[i]; //第i级链表的下一个
2.大于:向下降级,i- - //不改变targetNode
3.等于:向下降级,i- - //不改变targetNode

最后,再次比较targetNode->next[0]和theElement,判断是否找到。所以整个运算下来,targetNode是要查找的节点前面那个节点。查找的时间复杂度为 O(logn)。

插入
  当有2级索引时,新的节点先和2级索引比较,再和1级索引比较,最后和原链表比较,最终插到原链表中。当节点很多时,比较次数是原来的四分之一。
  当节点足够多的时候,还可以继续加索引,保证每一层索引数是低级索引的一半。当这一层只剩两个节点时,就没有必要再建索引了,因为一个节点没有比较的意义。
  当很多节点插入时,上层索引节点已经不够用,需要在新节点中选取一部分节点提到上一层,跳表的设计者用“抛硬币”的方法选取节点是否提拔,也就是随机的方式,每个节点有50%概率会提拔。这样虽然不会让索引绝对均匀分布,但也会大体上是均匀的。综上,插入的步骤:

  1. 新节点和各层索引节点逐一比较,确定原链表的插入位置。O(logN)
  2. 把索引插入到原链表。O(1)
  3. 利用抛硬币的随机方式,决定新节点是否提升为上一级索引。结果为“正”则提升并继续抛硬币,结果为“负”则停止。O(logN)

总体上,跳表插入操作的时间复杂度是O(logN),而这种数据结构所占空间是2N,既空间复杂度是 O(N)。

删除

  1. 自上而下,查找第一次出现节点的索引,并逐层找到每一层对应的节点。O(logN)
  2. 删除每一层查找到的节点,如果该层只剩下1个节点,删除整个一层(原链表除外)。O(logN)

总体上,跳表删除操作的时间复杂度是O(logN)。

跳表高效地动态插入和删除

  在跳表中,查找的时间复杂度为 O(logn),因此,动态插入数据的时间复杂度也就是 O(logn)了。从链表中删除结点的时候,如果结点在索引中也有出现,那么除了要删除原始链表中的结点,还要删除索引中的。
  当不停地往跳表中插入数据的时候,如果不更新索引,就有可能出现某两个结点之间数据非常多的情况。极端情况下,跳表还会退化为单链表。因此,需要某种手段来维护索引与原始链表大小之间的平衡,也就是说,如果链表结点变多了,索引值就相应地增加一些。
  当往跳表中插入数据的时候,可以选择同时也将这个数据插入到部分索引层中。而插入到哪些索引层中,则由一个随机函数生成一个随机数字来决定。如果这个数字为 K,那就将数据插入到第一级到第 K 级索引中。

Redis用跳表来实现有序集合而不是红黑树?

  Redis 中的有序集合支持的核心操作主要有:插入一个数据;删除一个数据;查找一个数据;按照区间查找数据;迭代输出有序序列。
  其中,插入、删除、查找以及迭代输出有序序列这几个操作,而红黑树的插入很可能会涉及多个结点的旋转、变色操作。而SkipList底层是用链表实现的,只需要修改相邻节点的指针,操作简单又快速。
  范围查找:skiplist和各种平衡树(如AVL、红黑树等)的元素是有序排列的,而哈希表不是有序的。因此,在哈希表上只能做单个key的查找,不适宜做范围查找。跳表可以在 O(logn)时间复杂度定位区间的起点,然后在原始链表中顺序向后查询就可以。在做范围查找的时候,平衡树比skiplist操作要复杂(红黑树的效率没有跳表高)。在平衡树上,找到指定范围的小值之后,还需要以中序遍历的顺序继续寻找其它不超过大值的节点。

LTO编译器优化介绍以及开启方法 LTO优化的详细介绍 阅读详情

相关推荐

Playwright Java环境配置避坑指南:浏览器路径、类加载与离线部署

Playwright作为现代端到端测试框架,其Java SDK突破了传统Selenium的Driver管理模式,将Chromium/Firefox/WebKit内核视为可编程运行时资源。其核心原理在于SDK与浏览器二进制分离——Maven仅管理Java字节码,而浏览器需独立下载、校验与沙箱加载。这一设计带来显著技术价值:跨平台一致性、进程隔离安全性及多浏览器并行能力;典型应用场景涵盖Spring Boot集成测试、金融级离线CI/CD、Kubernetes容器化部署及Air-Gapped封闭环境。然而,因J

weixin_32956805的博客 679

Skip List(跳跃表)原理详解

为什么选择跳跃表 目前经常使用的平衡数据结构有:B树,红黑树,AVL树,Splay Tree, Treep等。想象一下,给你一张草稿纸,一只笔,一个编辑器,你能立即实现一颗红黑树,或者AVL树出来吗? 很难吧,这需要时间,要考虑很多细节,要参考一堆算法与数据结构之类的树,还要参考网上的代码,相当麻烦。用跳表吧,跳表是一种随机化的数据结构,目前开源软件 Redis 和 LevelDB 都有用到它,它...

qq_18219755的博客 372

深入解析DisplayPort(DP)接口:从主链路到辅助通道的全方位技术剖析

本文深入解析DisplayPort(DP)接口的核心技术架构,重点剖析了其三大功能模块:承载视频/音频数据洪流的Main-Link主链路、负责链路训练与设备控制的AUX CH辅助通道,以及实现智能交互的HPD热插拔检测。文章详细阐述了主链路的可伸缩Lane配置、嵌入式时钟与数据成帧机制,以及辅助通道在设备发现、动态优化信号质量(链路训练)中的关键作用,揭示了DP接口实现高效率与灵活性的设计哲学。

weixin_29267307的博客 489

数据结构之跳表

数据结构之跳表 跳表可以说是B+树的一种拓展 1. 什么是跳表 在介绍跳表的定义之前,我们先来了解一下链表,对于一个单链表来说,即便链表中存储的数据是有序的,如果我们要想在七种查找某个数据,只能从头到尾遍历链表,查找的效率很低,查找的时间复杂度为 O(n); 由于单链表的查找效率太慢,我们想,可以通过什么方式能够提高链表的查找效率呢? 我们试着对链表中建立索引,使用索引来标记和记录数据的位置。如下图 如上图所示,我们给单链表建立了一个索引层,当我们想查找某个数据(16)时,我们可以先在索引层遍历,当遍历

weixin_45683550的博客 950

单细胞测序避坑指南:为什么你的免疫组库数据总出问题?5‘转录组7个关键细节

本文深度解析了5'端单细胞测序技术在免疫组库研究中的应用与常见问题。文章从5'端建库的分子机制入手,重点剖析了其在捕获TCR/BCR序列上的独特优势,并系统梳理了从样本处理、文库构建到数据质控全流程中7个最易出错的细节,为研究者提供了一份实用的避坑指南,旨在帮助提升免疫组库数据的质量和可靠性。

weixin_29208327的博客 482

科研绘图(二):R 语言实现小鼠脑图谱 3D 渲染,附完整代码与数据获取指南

在生物医学科研中,脑区的 3D 可视化是呈现实验结果、解析脑结构功能的重要手段。R 语言凭借rgl和Rvcg等工具包,可高效实现小鼠全脑及特定脑区(如 CA1 区)的立体渲染,且代码可复用性强。本文将从环境搭建、数据准备、代码实现到结果导出,手把手带你完成小鼠脑图谱 3D 绘图,小白也能快速上手!

good_rrrrr的博客 2024

SkipList 跳表

为什么选择跳表 目前经常使用的平衡数据结构有:B树,红黑树,AVL树,Splay Tree, Treep等。   想象一下,给你一张草稿纸,一只笔,一个编辑器,你能立即实现一颗红黑树,或者AVL树 出来吗? 很难吧,这需要时间,要考虑很多细节,要参考一堆算法与数据结构之类的树, 还要参考网上的代码,相当麻烦。   用跳表吧,跳表是一种随机化的数据结构,目前开源软件 Redis 和 L...

The time is passing 1485

【汽车故障诊断2】从标准到实战:解码DTC格式背后的诊断逻辑

本文深入解析汽车诊断故障码(DTC)的格式与逻辑,对比了OBD-II标准(如ISO 15031-6)的5字符格式与UDS协议(ISO 14229-1)下更丰富的3字节格式。文章从国际标准出发,结合实战案例,阐述了DTC如何作为汽车电子系统的“体检报告”,帮助工程师和维修技师精准定位故障,并详细解读了UDS 19服务如何读取和管理DTC状态。

berry的博客 713

聊聊二分查找与跳表

二分查找(Binary Search) 二分查找也称折半查找, 是一种效率较高的查找方法,但是使用的条件比较苛刻。下面以一个猜数字游戏为例学习二分查找的过程。 游戏的规则:1到10的数字中, A选一个数字,B去猜,B猜数字的时候,A会回答小啦、大啦或者猜对啦, B怎么做才能在最少次数里猜对呢。 用二分查找法,B最多需要4次即可猜对啦,下面用个图来展示一下过程: B每次猜的时候是取中间的数字,...

weixin_34220834的博客 1156

使用基于物质点法(MPM)的Anura3D模拟沙柱坍塌

本博客使用开源软件Anura3D软件模拟了一个沙柱坍塌的过程,这个软件是基于基于物质点法(MPM)设计的

weixin_59902634的博客 4045

<IBM DB2>《DB2 官方监控脚本 2022版本》

DB2 监控脚本

Else 的博客 672

跳表(skiplist)的理解

听到跳表(skiplist)这个名字,既然是list,那么应该跟链表有关。 跳表是有序链表,但是我们知道,即使对于排过序的链表,我们对于查找还是需要进行通过链表的指针进行遍历的,时间复杂度很高依然是O(n),这个显然是不能接受的。是否可以像数组那样,通过二分法进行查找呢,但是由于在内存中的存储的不确定性,不能这做。 但是我们可以结合二分法的思想,没错,跳表就是链表与二分法的结合。 1.链表...

DEMI的博客 3万+

virtuoso:layout如何做flat修drc

有些drc在virtuoso layout中修更节省时间,比如遇到一些via array需要做删改时,发现工具把via array做成了一个cell,如图。去改cell可能会影响很多via,所以最好的办法是做flat,去调整cut,比如删除。我正在「拾陆楼」和朋友们讨论有趣的话题,你⼀起来吧?

m0_61544122的博客 342

Redis中的跳表是怎么回事

引子 早些年笔者一次真实的美团面试经历。 面试官:请问Redis有哪些数据结构? 我:string、hash、list、set、zset、 bitmaps、hyperloglogs、geospatial、布隆过滤器。 面试官:zset主要用什么应用场景? 我:zset主要是一种有权重的set集合,因为每一个元素都可以有一个“分数”,redis提供了根据这个分数操作的api,比如取分数前几的啊,所以我们可以用作一些类似于排行榜的东西,比如点赞次数前几名的啦,,叭叭叭。 面试官:嗯,,,那它的底层的数据结构

程序员大航子 4757

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

什么是跳表

储存数据时,数组容量有限且有序数组增加元素时效率比较低,所以存储数据时常选用链表。但是链表的查询效率O(n)。 有没有可以提高链表查找效率的方式呢?跳表就是这样一种结构。利用空间换时间的方式,提高查询效率。

每天进步一点 1万+

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

什么是跳表,Java如何实现跳表?

如图:每个链表存在一个指向下一节点的指针,如果我们要对其任一节点进行增删改,都需要先使用迭代器进行查询,找到指定节点进行修改,复杂度较高。

benaso的大学学习历程 1667

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

跳表skiplist

跳表可以说是平衡树的一种替代品。它也是为了解决的的问题。那这个问题,hash 表解决的很好,插入和查找都是 O(1) 的时间复杂度。但若呢?这个时候 hash 表就不行了,二叉查找树可以解决这个问题。但是由于二叉查找树在按大小顺序进行插入的时候,就会退化为链表。所以又出现了平衡二叉树,而根据算法不同,又分为AVL树、B-Tree、B+Tree、红黑树等。(先不用管这些数据结构的实现,其是复杂的)。而跳表的出现就是为了解决平衡二叉树复杂的问题,它以一种。

m0_57408211的博客 979

【数据结构】一文解析跳表

跳表是一种 的数据结构,随机性体现在跳表的层数是不固定的。跳表基于有序链表,可以在原始链表基础上创建多层索引架构,采用这种随机技术,跳表中的搜索、插入、删除操作的时间均为 。 上面就是跳表的图示,注意 h 节点是头结点,n 节点是尾结点,从图片来看本质就是一个链表加了 n 层来进行索引,跳表的查询流程等后面会逐步介绍的。大家在看到上面图片的时候也能想象,如果去掉 、、,其实跳表也就是一个链表,或者说是一个数组,但是加上之后,在做增删改查的时候就可以从上往下逐层查询查询,性能大大提高,所以查询性能才比较高

Jwasx的博客 1712

跳表——C++

skiplist本质上也是一种查找结构,用于解决算法中的查找问题,跟平衡搜索树和哈希表的价值是一样的,可以作为key或者key/value的查找模型。那么相比而言它的优势是什么的呢?那么等我们学习完它的细节实现,我们再来对比。skiplist是由William Pugh发明的,最早出现于他在1990年发表的论文《Skip Lists: A Probabilistic Alternative to Balanced Trees》。对细节感兴趣的同学可以下载论文原文来阅读。

sqm_C的博客 1409

Redis 跳表

文章目录基本概念动态查找的数据结构数组结构链表平衡树跳表的雏形跳跃链表的实现原理简单索引多级索引索引层数和索引节点密度跳表的复杂度分析时间复杂度分析跳表的空间存储跳表在 Redis 中的应用跳表随机层数的实现原理Redis 关于跳表的源码参考 基本概念 允许快速查询一个有序连续元素的数据链表。跳跃列表的平均查找和插入时间复杂度都是O(log n),优于普通队列的O(n)。 动态查找的数据结构 可以作为查找数据结构的包括: 线性结构:数组、链表 非线性结构:平衡树 数组结构 缺点: 移动和删除时需要整体移

Powerstot的博客 3871

跳表的理解以及使用

跳表(SkipList),是一种随机化的数据结构,可以看作是一种可以进行二分查找的有序链表。跳表通过增加多级索引(即“跳跃”的层)来优化链表的查找、插入和删除操作,使得这些操作的时间复杂度降低到O(logn)。跳表在Redis和LevelDB等系统中都有应用,其实现和维护相对简单,但性能上却与红黑树、AVL树等平衡树不相上下。

zhangdonghuirjdd的博客 1259

从链表到跳表——跳表是什么?

跳表是一个面试和笔试中虽然不会考到,但会经常被提到的一个数据结构,其最典型的应用就是在Redis中。那么跳表是怎么提出的呢,它又解决了什么问题呢?本文试图从数组到链表再到跳表,分析现有数据结构的局限性,从而引出跳表的定义,并对跳表进行了一个全面的基本介绍

zhuiyisinian的博客 1276

跳表 SkipList

考虑到数据结构的可扩展性,结点的 Key 与 Value 均定义为泛型。其中 T key 继承Comparable接口,保证 key 可以用于比较排序,E Value 则用于存储结点的值。每个结点包含一个 forward 数组来存储索引中下一个索引结点的引用。该数组在初始化时,大小被设定为该结点的索引层数,以减少空间浪费。

SolitudeCoding的博客 1373

跳表的插入

跳表的插入

做一个善良的人,做好自己的事,如果愿意,再发一份光。 1106

跳表 (图解)

疯狂创客圈 经典图书 : 《Netty Zookeeper Redis 高并发实战》 面试必备 + 面试必备 + 面试必备 【博客园总入口 】 疯狂创客圈 经典图书 : 《SpringCloud、Nginx高并发核心编程》 大厂必备 + 大厂必备 + 大厂必备 【博客园总入口 】 入大厂+涨工资必备: 高并发【 亿级流量IM实战】 实战系列 【 SpringCloud Nginx秒杀】 实战系列 【博客园总入口 】 1.1 跳表图解 跳表,是基..

架构师尼恩 2614
上一篇: 热备份和冷备份
下一篇: Kafka网络模型
K. Bob
博客等级 码龄8年 82粉丝 294原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值