常见数据结构-TrieTree/线段树/TreeSet

【软考】数据结构与算法基础 - TreeSet入门介绍 TreeSet是Java集合框架中的一种有序集合,它基于数据结构实现。TreeSet是一种按照排序顺序存储元素的集合。它使用实现,可以高效地插入、删除和检索元素。 阅读详情

TrieTree/线段树/TreeSet

线段树

  线段树是一种非常灵活的数据结构,它可以用于解决多种范围查询问题,比如在对数时间内从数组中找到最小值、最大值、总和、最大公约数、最小公倍数等。
在这里插入图片描述
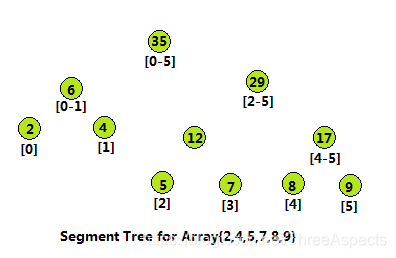
数组A[0,1,…,n−1 ] 的线段树是一个二叉树,其中每个节点都包含数组的一个子范围[i…j] 上的聚合信息(最小值、最大值、总和等),其左、右子节点分别包含范围[i,(i+j)/2] 和[(i+j)/2+1,j] 上的信息。
  线段树既可以用数组也可以用树来实现。对于数组实现,如果索引 ii 处的元素不是一个叶节点,那么其左子节点和右子节点分别存储在索引为2i和2i+1 的元素处。在上图所给出的示例中,每个叶节点都包含初始的数组元素 {2,4,5,7,8,9}。内部节点包含范围内相应元素的总和11是从索引 0 到索引 2 的元素之和。而根节点 (35) 是它的两个子节点 (6) 和 (29) 的和,也是整个数组的和。
线段树可以分为以下三个步骤:
【1】从给定数组构建线段树的预处理步骤。
【2】修改元素时更新线段树。
【3】使用线段树进行区域和检索。

【构建线段树】
  这里使用一种非常有效的自下而上的方法来构建线段树。从上图示可知,如果某个节点 p包含范围[i…j] 的和,那么其左、右子节点分别包含范围[i,(i+j)/2] 和[(i+j)/2+1,j] 上的和。因此,想要找到节点 p 的和,需要提前计算其左、右子节点的和。从叶节点开始,用输入数组的元素a[0,1,…,n−1] 初始化它们。然后逐步向上移动到更高一层来计算父节点的和,直到最后到达线段树的根节点。

int[] tree;
int n;
public NumArray(int[] nums) {
    if (nums.length > 0) {
        n = nums.length;
        tree = new int[n * 2];
        buildTree(nums);
    }
}
private void buildTree(int[] nums) {
    for (int i = n, j = 0;  i < 2 * n; i++,  j++)
        tree[i] = nums[j];
    for (int i = n - 1; i > 0; --i)
        tree[i] = tree[i * 2] + tree[i * 2 + 1];
}

【更新线段树】
  当更新数组中某个索引i处的元素时,需要重建线段树,因为一些树节点上的和值也会随之产生变化。将再次使用自下而上的方法。首先更新存储a[i] 元素的叶节点。从那里将一路向上,直到根节点,并用其子节点值的总和来更新每个父节点的值。

void update(int pos, int val) {
    pos += n;
    tree[pos] = val;
    while (pos > 0) {
        int left = pos;
        int right = pos;
        if (pos % 2 == 0) {
            right = pos + 1;
        } else {
            left = pos - 1;
        }
        // parent is updated after child is updated
        tree[pos / 2] = tree[left] + tree[right];
        pos /= 2;
    }
}

【区域和检索】
  通过以下方式使用线段树进行区域和检索 [L,R]:算法保持循环不变,l≤r 以及已经算出[L…l] 和 [r…R] 的总和,其中l 和r 分别是计算总和时的左边界和右边界。每次迭代的范围 [l,r]都会缩小,直到在算法的大约 log n次迭代后两个边界相遇为止。

public int sumRange(int l, int r) {
    // get leaf with value 'l'
    l += n;
    // get leaf with value 'r'
    r += n;
    int sum = 0;
    while (l <= r) {
        if ((l % 2) == 1) {
           sum += tree[l];
           l++;
        }
        if ((r % 2) == 0) {
           sum += tree[r];
           r--;
        }
        l /= 2;
        r /= 2;
    }
    return sum;
}

TreeSet

  TreeSet是一个有序的集合,它的作用是提供有序的Set集合。它继承了AbstractSet抽象类,实现了NavigableSet< E >,Cloneable,Serializable接口。TreeSet是基于TreeMap实现的,TreeSet的元素支持2种排序方式:自然排序或者根据提供的Comparator进行排序。
在这里插入图片描述
TreeSet常用方法:

public boolean add(E e)
如果指定的元素尚不存在,则将其添加到此集合中。更正式地说,e如果集合中不包含任何元素,则将指定的元素添加到此集合e2中 Objects.equals(e, e2)。如果此set已包含该元素,则调用将保持set不变并返回false。

public boolean isEmpty()
true如果此set不包含任何元素,则返回

public E ceiling​(E e)
返回此set中大于或等于给定元素的最小元素,或者null如果没有这样的元素。

public E floor(E e)
返回此set中小于或等于给定元素的最大元素,或者null如果没有这样的元素。

public E lower​(E e)
返回此集合中的最大元素严格小于给定元素,或者null如果没有这样的元素。

public boolean contains(Object o)
true如果此set包含指定的元素,则返回。更正式地说,返回true当且仅当此set包含的元素e,使得 Objects.equals(o, e)。

TrieTree

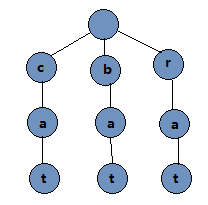
  一个线性表的顺序查找的时间复杂度为O(n),二分搜索树的查找为O(log n),均与数据结构中的元素个数相关。Trie字典树(主要用于存储字符串)查找速度主要和它的元素(字符串)的长度相关[O(w)]。Trie字典树主要用于存储字符串,Trie 的每个 Node 保存一个字符。用链表来描述的话,就是一个字符串就是一个链表。每个Node都保存了它的所有子节点。例如我们往字典树中插入"cat", “bat”, "rat"三个单词,Trie字典树如下所示:
在这里插入图片描述

class Solution {
    public String replaceWords(List<String> dict, String sentence) {
        Trie trie=new Trie();
        String[] sentences=sentence.split(" ");
        for(String s:dict){
            trie.add(s);
        }
        StringBuffer sb=new StringBuffer();
        for(String s:sentences){
            sb.append(func(s,trie));
            sb.append(" ");
        }
        return sb.substring(0,sb.length()-1);
    }
    public String func(String s,Trie trie){
        StringBuffer sb=new StringBuffer();
        Node cur = trie.root;
        for(int i=0;i<s.length();i++){
            sb.append(s.charAt(i));
            if(cur.map.containsKey(s.charAt(i))){
                cur=cur.map.get(s.charAt(i));
                if(cur.isWord) return sb.toString();
            }else{
                return s;
            }
        }
        return s;
    }
}
class Node{
    boolean isWord;
    Map<Character,Node> map;
    public Node(){
        isWord=false;
        map=new HashMap<>();
    }
}
class Trie{
    Node root;
    public Trie(){
        root=new Node();
    }
    public void add(String str){
        Node cur=root;
        for(int i=0;i<str.length();i++){
            if(!cur.map.containsKey(str.charAt(i))){
                cur.map.put(str.charAt(i),new Node());
            }
            cur=cur.map.get(str.charAt(i));
        }
        cur.isWord=true;
    }
    public boolean contains(String str){
        Node cur=root;
        for(int i=0;i<str.length();i++){
            if(cur.map.containsKey(str.charAt(i))){
                cur=cur.map.get(str.charAt(i));
            }else{
                return false;
            }
        }
        return cur.isWord;
    }
}

AD936x Evaluation Software 实战配置指南:从寄存器设置到滤波器优化 本文提供AD936x Evaluation Software的实战配置指南,详细解析从工程创建、RF向导与时钟模块配置,到数字滤波器优化、数字接口设置及增益控制的完整流程。重点分享寄存器设置、滤波器系数权衡及PLL稳定技巧等核心要点,帮助开发者高效配置AD9361/AD9363射频芯片,快速应用于SDR、基站等场景。 阅读详情

相关推荐

使用sklearn学习多项式回归(三)

1,什么是线性 我们无数次提到”线性“这个名词。在支持向量机中,我们也曾经提到最初的支持向量机只能够分割线性可分的数据,然后引入了”核函数“来帮助我们分类那些非线性可分的数据。我们也曾经说起过,比如说决策树,支持向量机是”非线性“模型。所有的这些概念,让我们对”线性“这个词非常熟悉,却又非常陌生——因为我们并不知道它的真实含义。接下来我们看看线性回归模型改进的核心之一:帮助线性回归解决非线性问题。 1.1,变量之间的线性关系 ”线性“这个词用于描述不同事物时有着不同的含义。我们最常使用的线性是指“变量

理科男同学 5100

TreeSet介绍

一、TreeSet介绍 TreeSet的数据结构可以理解为是二叉树数据结构,我们可以使用TreeSet实现排序功能,TreeSet通过定义一个比较容器Comparator来完成集合对象中的排序。 二、TreeSet代码示例 public class Student{ //属性 private String name; private int age; //写操作 public void setName(String name){ this.name=name; } //读操作 publi

m0_46301469的博客 1052

解决 python2.7中 ImportError: No module named Crypto.Signature

我的解决办法,先查看有没有安装 pip,直接执行pip 回车 没有出现null什么的就安装了,如果没有安装去其他博客哪里看一下,正常情况是默认就有的,然后使用。发现我自己也不会啊,就百度看看,想着网上的解决方法一大片,但是都是废话,能用的没有几个,而且能安装的没有几个。这个里面的python2、3就是系统里面的python版本,直接跟我这样就可以了除非版本不一样,也就是没有这个版本。就可以使用了,第一个应该是卸载之前的,然后重新安装,我的就是这样解决的。就比如我的,我现在使用的 python2.7。

记录一下 1610

二叉树--TreeSet数据结构

TreeSet:底层数据结构是二叉树。 保证元素唯一性的依据,compareTo方法return  0。 判断元素和remove删除元素都是依据的compareTo返回的数值。 排序方式:让元素自身具备比较线,让元素实现Comparable接口,覆盖compareTo方法。 顺序是从小(-1)到大(1)排序得。 二叉树只认比较返回的是-1,0,1。-1往左边放,1往右边

baidu_37278726的博客 1663

Altium Designer许可证冲突?手把手教你用Windows防火墙彻底禁止AD联网(附详细截图)

本文详细介绍了如何通过Windows防火墙精准管控Altium Designer的网络权限,解决许可证冲突问题。通过配置入站和出站规则,彻底阻断AD的联网行为,提升软件运行效率。适用于需要稳定使用Altium Designer的工程师,附有详细截图和高级验证方法。

weixin_38170137的博客 423

Ruoyi-Cloud集成Seata2.0实现分布式事务

在网络上,关于Spring Cloud和Ruoyi-Cloud整合Seata的教程有很多,针对不同版本的 Seata 也有不少相关教程。事实上,无论是 Spring Cloud 还是 Ruoyi-Cloud,其整合 Seata 的原理基本相同。这篇博文将详细介绍如何在本地开发环境下,在中实现Seata 2.0的整合,希望能为大家在分布式项目中实现 Seata 的整合提供实用的帮助,提供一个清晰的操作思路。

SR003的博客 2246

Java集合详解——TreeSet集合的介绍及其排序

放到TreeS儿童集合中的元素:无序不可重复,但可以按照元素的大小顺序自动排序。 放到TreeSet或者TreeMap集合key部分中的元素要想做到排序,包括两种方式: 第一种:放在集合中的元素实现java.lang.Comparable接口。 第二种:在构造TreeSet或者TreeMap集合的时候给它传一个比较器对象。 Comparator的设计符合OCP原则。。...

Best_Basic的博客 9352

如何使用apifox打包测试用例生成测试套件自动化执行

使用apifox打包测试用例生成测试套件自动化执行

weixin_55613512的博客 2886

Java-数据结构-(TreeMap & TreeSet)

本篇文章讲解了"TreeMap & TreeSet",希望能帮助到你。

爱是小小的癌的博客 1741

链路状态路由协议 OSPF (一)

本章将会学习链路状态路由协议OSPF,理解OSPF的基本概念,工作原理,掌握OSPF配置基本命令。本章重点,OSPF的基本概念,OSPF配置。

yj11290301的博客 3475

Open3D (C++) 使用点云创建数字高程模型DEM

Open3D (C++) 使用点云创建数字高程模型DEM

点云侠的博客 1391

TreeSet

TreeSet 能够对元素按照某种规则进行排序。同时也保证元素的唯一。 两种排序方式: 自然排序 比较器排序 TreeSet集合特点:排序和唯一。 #

元气满满晨 3636

linux 内核OOM问题定位-SLAB_DEBUG

首先看slabinfo按的size排序查看 slub object,可以查看 space 总占用大小,及objects个数判断泄漏点 为kmalloc-128。那个泄露多看/sys/kernel/debug的slab/kmalloc*-的alloc-traces和free-traces。SLAB或者SLUB有一个用就可以,改menuconfig没有clean会覆盖之前的更改,现在看一下编译的过程。或者配置defconfig,配置完之后需要clean后再编译。1,配置menuconfig。

陌上花开缓缓归以的博客 899

TreeSet 的底层原理

自然排序• 元素必须实现Comparable接口(如IntegerString),通过方法定义排序规则。• 未实现Comparable的自定义类会抛出。自定义 Comparator• 通过构造方法传入比较器,覆盖自然排序规则。• 示例:按字符串长度排序:TreeSet<String> set = new TreeSet<>((s1, s2) -> s1.length() - s2.length());TreeSet 通过红黑树实现了高效的有序集合管理,核心优势在于元素自动排序和唯一性保障。

FAQEW的博客 1304

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

Java数据结构--TreeMap和TreeSet

要想知道TreeMap和TreeSet就要知道Map和Set是什么原理的数据结构,以前常见的 搜索方式有: 1. 直接遍历,时间复杂度为O(N),元素如果比较多效率会非常慢 (后面讲)2. 二分查找,时间复杂度为O(logN),但搜索前必须要求序列是有序的这里所说的搜索效率与器具体的实例化子类就是我们本章博客要讲的TreeMap和TreeSet这两个数据结构.要想了解TreeMap和TreeSet这两个数据结构,就要知道他们两个的底层结构是什么?

2401_86698066的博客 795

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

数据结构-线段树

数据结构-线段树 转载声明 本文大量内容系转载自以下文章,有删改,并参考其他文档资料加入了一些内容: leetcode-线段树 作者: leetcode 【数据结构】线段树(Segment Tree) 作者: 正月点灯笼 1 概述 线段树是一种非常灵活的数据结构,它可以用于解决多种范围查询问题,比如在对数时间logN内从数组中找到最小值、最大值、总和、最大公约数、最小公倍数等。 在上图所给出的示例中,每个叶节点都包含初始的数组元素 {1,3,5,7,9,11}。内部节点包含范围内相应元素的总和 :

迷路剑客个人博客 645

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

【数据结构】TreeMap及TreeSet

欢迎浏览高耳机的博客希望我们彼此都有更好的收获。

高耳机的博客 1039

LeetCode解析------307.区域和检索 - 数组可修改-线段树

题目: 给定一个整数数组 nums,求出数组从索引 i 到 j (i ≤ j) 范围内元素的总和,包含 i, j 两点。 update(i, val) 函数可以通过将下标为 i 的数值更新为 val,从而对数列进行修改。 示例: Given nums = [1, 3, 5] sumRange(0, 2) -> 9 update(1, 2) sumRange(0, 2) -> 8 说明: 数组仅可以在 update 函数下进行修改。 你可以假设 update 函数与 sumRange 函

weixin_44337475的博客 204

java基础之TreeSet类

本文主要是java中TreeMap相关知识

weixin_50691399的博客 1634

Java集合框架之TreeSet

1.背景介绍 1. 背景介绍 TreeSet 是 Java 集合框架中的一个有序集合类,它实现了 SortedSet 接口。TreeSet 使用红黑树(Red-Black Tree)作为底层数据结构,以实现元素的自然排序和快速查找。TreeSet 可以存储唯一的元素,即不允许重复的元素。 TreeSet 的主要特点包括: 元素有序:TreeSet 中的元素按照自然顺序排列,即使用 Com...

AI天才研究院 1807

Java 【数据结构】 TreeSet&TreeMap(二叉搜索树详解)【神装】

每个节点都有一个键(Key)和两个指向其他节点的指针(左子指针和右子指针)。任意节点的左子树中的所有键都小于该节点的键。任意节点的右子树中的所有键都大于该节点的键。左右子树也都是二叉搜索树。不存在键值相等的节点。int val;Node left;Node right;// 构造函数、插入方法、查找方法、删除方法等...TreeSet是Java集合框架中的一种有序集合,它实现了Set接口,因此具有不允许重复元素的特性。

2302_79806056的博客 6692

数据结构之二叉搜索树(TreeSet&&TreeMap)

本章主要讲解二叉搜索树的实现,以及如何使用java中的TreeMap和TreeSet

zhyhgx的博客 1364

图解TreeSet数据结构设计与应用案例

`TreeSet` 是 Java 中一个基于红黑树实现的有序集合,它继承自 `AbstractSet` 并实现了 `NavigableSet` 接口。`TreeSet` 中的元素按照自然顺序或通过提供的 `Comparator` 进行排序,确保元素处于排序状态。它支持快速的插入、删除、查找和范围查询操作,具有对数时间复杂度。`TreeSet` 是非线程安全的,适用于需要有序集合的场景,如需要排序的数据集、范围查询和有序迭代。

肖哥弹架构博客 746

java集合类深入分析之TreeMap/TreeSet篇

简介     TreeMap和TreeSet算是java集合类里面比较有难度的数据结构。和普通的HashMap不一样,普通的HashMap元素存取的时间复杂度一般是O(1)的范围。而TreeMap内部对元素的操作复杂度为O(logn)。虽然在元素的存取方面TreeMap并不占优,但是它内部的元素都是排序的,当需要查找某些元素以及顺序输出元素的时候它能够带来比较理想的结果。可以说,TreeMa...

点缀星辰 1117

数据结构之树以及TreeSet,HashSet底层原理讲解

详解Java中的数据结构树,以及Set集合的实现类HashSet与TreeSet的底层原理。

weixin_45432729的博客 778

二叉搜索树的基本操作 || TreeMap和TreeSet介绍

现在很多地方都需要去查找某个数据,那么查找的效率就显得尤为重要了。二叉搜索树是一颗左孩子比父亲小,右孩子比父亲大的一棵树。那么在这个基础上查找某个数据,一次比较就可以排除一半数据,效率是相当高的。TreeMap的底层是一颗红黑树,红黑树是建立在二叉搜索树结构上的。由于搜索树在极端情况下它的单分支会很长,这样就会增加查找的效率。在这个基础上提出的AVL树,将它的单分支进行旋转。由于可能旋转的次数会很多,又在这个基础上提出了红黑树。

小小太空人的博客 1334
上一篇: Hive的Map/Reduce数目如何确定
下一篇: Hive数据倾斜
K. Bob
博客等级 码龄8年 82粉丝 294原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值