Spark共享变量(广播变量、累加器)

大数据开发-Spark-共享变量之累加器和广播变量 Spark 累加器与广播变量 一、简介 在 Spark 中,提供了两种类型的共享变量:累加器 (accumulator) 与广播变量 (broadcast variable): 累加器:用来对信息进行聚合,主要用于累计计数等场景; 广播变量:主要用于在节点间高效分发大对象。 二、累加器 这里先看一个具体的场景,对于正常的累计求和,如果在集群模式中使用下面的代码进行计算,会发现执行结果并非预期: var counter = 0 val data = Array(1, 2, 3, 4, 5) sc.pa 阅读详情

  Spark两种共享变量:广播变量与累加器。广播变量可以在Driver程序中写入,在Executor端读取。累加器在Executor中写入,而在Driver端读取。
  共享变量出现的原因:通常,当在远程集群节点上执行传递给Spark操作的函数时,它将在函数中使用的所有变量的单独副本上工作。这些变量将复制到每台计算机,而且远程机器上的变量的更新不会同步给Driver端。这种情况下,跨任务读写共享变量效率低下。Spark使用共享变量(广播变量和累加器)来解决问题。

广播变量

  为什么要将变量定义成广播变量?如果要在分布式计算里面分发大对象,例如:字典,集合等,这个都会由Driver端进行分发。一般来讲,如果这个变量不是广播变量,那么每个task就会分发一份,这在task数目十分多的情况下Driver的带宽会成为系统的瓶颈,而且会大量消耗task服务器上的资源,如果将这个变量声明为广播变量,那么只是每个executor拥有一份,这个executor启动的task会共享这个变量,节省了通信的成本和服务器的资源。

注意:
1、能不能将一个RDD使用广播变量广播出去?
不能,广播变量的值必须是本地的可序列化的值,而不是RDD或其他分布式数据结构。

2、 广播变量只能在Driver端定义,不能在Executor端定义
3、 在Driver端可以修改广播变量的值,在Executor端无法修改广播变量的值

Broadcast的实现
在这里插入图片描述
在SparkContext上调用broadcast来创建广播变量:

val a = 3
val broadcast = sc.broadcast(a)

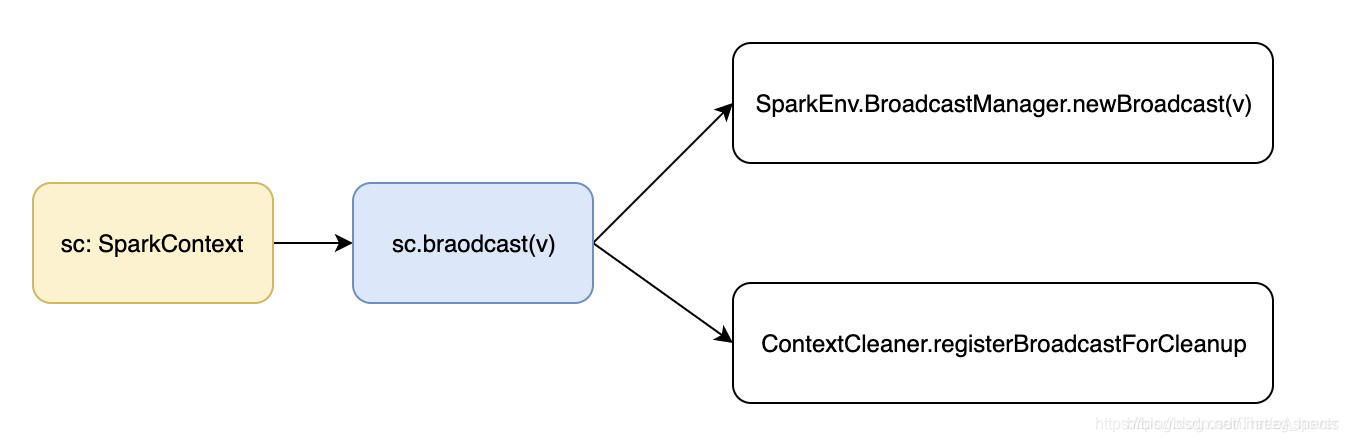
  Spark context初始化的时候, sparkEnv中初始化了一个broadcastManager,初始化方法里面默认使用的 TorrentBroadcastFactory, 调用 sc.broadcast 方法, 就会使用工厂模式创建一个TorrentBroadcast。这时候就会调用写操作,把数据分成小块写到 BlockManager 中,broadcast只是一个TorrentBroadcast 类型的实例, 并没有数组数据, 这个实例只维护了数据的元信息, 即一组BlockId 信息。这个实例被序列化被传到 executor上,在 executor 上调用这个实例的 value 方法,才会触发去 BlockManager 上读真正的数据。

  TorrentBroadcastFactory工厂类实现了一个类似于BitTorrent的协议,通过该协议把广播数据分发到各个executor中。这些操作其实是在类TorrentBroadcast中实现。该类实现了以下的机制:

  • TorrentBroadcast 底层使用的是 BlockManager, 下载每个数据块先要去 master 去获取 Block 所在的位置
  • 在把大变量写到广播变量的时候,通过ChunkedByteBufferOutputStream把输入的数据分成多个小块,zipWithIndex中,为每个小块加一个唯一标识作为BlockId, 存储在 BlockManager 中,而且对每个小的数据块加上一个校验码
  • BlockManagerMaster 作为 tracker 维护所有 Block块的元信息, 知道每个数据块所在的 executor和存储级别。 Broadcast 变量中维护属于自己的所有小块的 BlockId
  • 通过 value 方法读取 Boradcast 变量的时候, 取出所有小块的 BlockId, 对于每个 BlockId, 通过BlockManagerMaster 获取了该BlockId的位置的集合, 随机化,位置集合被打乱,优先找同主机的地址,然后从随机的地址集合按顺序取地址一个一个尝试去获取数据,因为随机化了地址,那么executor不只会从Driver去获取数据。分散了driver 上的压力
  • 取到 Block piece 后, 使用校验码进行校验,看看数据块有没有损坏, 如果没有损坏, 然后按照顺序拼在一起。

广播变量的回收
  在调用 sc.Broadcast 方法中, 会去 ContextCleaner 中注册一下,cleaner.foreach(_.registerBroadcastForCleanup(bc)) 。当广播变量引用为null的时候, 在context cleaner 里面会回调 broadcastManager.unbroadcast 方法, 会把 Broadcast 变量从 BlockManager 存储中干掉。

累加器

  为什么要将一个变量定义为一个累加器?在Spark应用程序中,经常会有这样的需求,如异常监控,调试,记录符合某特性的数据的数目,这种需求都需要用到计数器,如果一个变量不被声明为一个累加器,那么它将在被改变时不会在Driver端进行全局汇总,即在分布式运行时每个task运行的只是原始变量的一个副本,并不能改变原始变量的值,但是当这个变量被声明为累加器后,该变量就会有分布式计数的功能。
定义一个累加器:

val a = sc.accumulator(0)

注意:累加器在Driver端定义赋初始值,累加器只能在Driver端读取最后的值,在Excutor端更新。

VisionMaster SDK C#二次开发核心技术指南 以下是基于**VisionMaster SDK C#二次开发核心技术指南**,结合实战案例与关键代码解析,帮助开发者快速掌握工业视觉应用集成。 阅读详情

相关推荐

用RK3588 NPU加速人脸识别:从本地测试到服务器部署的完整流程(含ONNX模型)

本文详细介绍了如何利用RK3588 NPU加速人脸识别系统,从模型优化到高并发服务部署的全流程。通过RetinaFace和FaceNet模型的协同推理,结合ONNX模型转换和NPU特有优化技巧,显著提升识别效率。文章还涵盖了gRPC通信架构设计、性能压测及实际部署经验,为开发者提供了一套完整的解决方案。

weixin_29058331的博客 464

spark中的广播变量

一、使用广播变量的好处 1、Driver每次分发任务的时候会把task和计算逻辑的变量发送给Executor。不使用广播变量,在每个Executor中有多少个task就有多少个Driver端变量副本。这样会导致消耗大量的内存导致严重的后果。 2、使用广播变量的好处,不需要每个task带上一份变量副本,而是变成每个节点的executor才一份副本。这样的话, 就可以让变量产生的副本大大减少; 二、广播变量的原理 广播变量,初始的时候,就在Drvier上有一份副本。task在运行的时候,想要使用广播变量

hyj 2036

ads设计Doherty功放(1)

Doherty功放的设计

qq_40995480的博客 2万+

Spark共享变量-广播变量和累加器的区别

1. 广播变量用来高效的分发较大的对象,而累加器用来对信息进行聚合。 2. 累加器在Driver端定义赋初始值,累加器只能在Driver端读取最后的值,在Executor端 更新。 3. 广播变量只能在Driver端定义,可以在Driver端絛改广播变量的值,不能在Executor端 定义,无法修改值。 4. 如果在Executor端用到了Driver的变量,使用广播变量,每个Executor只有一份Driver 端的副本,不使用广播变量,在Executor中有多少个task就有多少个Driver副本。 .

coffeeCub的博客 606

ArcGIS小白必看:5分钟搞定shp矢量文件分割(附常见错误排查)

本文为ArcGIS新手详细解析了分割shp矢量文件的四种核心方法:裁剪工具、分割工具、按属性选择导出及ArcPy脚本自动化。重点强调了投影匹配等关键步骤,并提供了常见错误排查指南,帮助用户快速掌握矢量数据分割技巧,提升GIS数据处理效率。

h9j8k7l6m5n的博客 798

Zabbix安装与部署 系统环境:centos7.0

Zabbix安装与部署 系统环境:centos7.0

weixin_42485027的博客 2600

Spark广播变量

Spark广播变量 1. 什么是广播变量? 广播变量(Boardcast)是Spark中应对shuffle造成的性能变慢的有效克制手段,它是一种分发机制,一次性封装目标数据结构,以Excutor为粒度做数据分发。数据分发数=Excutor数 1.1 如何理解广播变量 需求: WordCount升级版,统计所有文件里,指定单词的数量。 WordCount V1.0 val dict = List("spark","java","scala","python") val words = spark.spar

dinl_vin的博客 1787

C语言—for循环打印矩形,正三角形,倒三角形,九九乘法,等腰三角形,倒着的等腰三角形(简易版代码)(重点考察for循环嵌套)

本章节教大家如何利用for循环打印正三角形,倒三角形,九九乘法表及等腰三角形(简易版代码)说明:1、循环语句的循环体内又包含另一个完整的循环结构,称为循环结构的嵌套。内嵌的循环语句中还可以再嵌套循环结构,这样就形成多重循环结构的嵌套。2、for 语句、while 语句和 do-while 语句都允许嵌套。三种循环语句可以相互嵌套。3、内层的循环语句必须完全被包含在外层的循环体中,不能发生交叉。

m0_63501145的博客 1695

为什么不能在 Spark 中定义全局变量?

估计有细心的同学可能发现了一个小问题,那就是,当我在用「全局变量」时,这个变量的定义,是在类中的。而在定义「累加器」时,是在 main 函数中的。你可能好奇,如果我把第1个程序中,「全局变量」定义的位置,也给挪到 main 函数中,是不是就能识别了呢?其实这个我也实测了,一样不能,原因还是那句话:driver 端的(普通)对象,executor 端直接识别不了。这,就是为什么要用到「累加器」的原因。为什么不能在 Spark 中定义全局变量?

SmartSi 455

从数据到图片:手把手构建FMCW雷达人体行为识别数据集(行走、跌倒、喝水等6类动作)

本文详细解析了如何利用FMCW雷达构建人体行为识别数据集,涵盖行走、跌倒、喝水等6类动作。通过多普勒特征可视化、图像标准化处理和自动化流水线设计,将原始雷达信号转化为高质量时频图像数据集,为智能家居和健康监护等应用提供可靠数据支持。

weixin_30706691的博客 384

分离与合体题解(区间DP)

题目: 经过在机房里数日的切磁,LYD从社神牛那里学会了分离与合体,出关前,杜神牛给了他一个测试 杜神牛造了个区域,它们紧邻着排成了一行,编号1-n。在这經个区域里都放着一把OI界 的金钥匙,每一把都有一定的价值,LYD当然想得到它们了。然而杜神牛规定LYD不可以一下子 把它们全部拿走,而是每次只可以拿一把。为了尽快地拿到所有的金钥匙,LYD自然就用上了刚学的分离与合体特技。 开始LYD可以选择从1~n-11~n-11~n-1的任何一个区域(记为K)进入,进入后LYD会在K区域发 生分离,从而分离为两个小L

cqbz_lipengcheng的博客 370

Spark 共享变量、广播变量、累加器

专栏原创出处:github-源笔记文件 ,github-源码 ,欢迎 Star,转载请附上原文出处链接和本声明。 文章目录1. 什么是共享变量2. 广播变量2.1.什么是广播变量2.2.如何使用广播变量3. 累加器3.1.什么是累加器3.2.如何使用累加器 1. 什么是共享变量 默认情况下,在一个对 RDD 操作的算子中如果使用到了外部 Driver 端定义的变量,这些变量将会被发送到每一个...

2.wa 774

ZYNQ RFSoC 的DAC如何做到从 0到Fs频段 信号输出

之前一直没太了解 RFSoC 的DAC如何输出在 Fs/2 到 Fs 频率范围内的信号,例如 ZCU216中的 ZU49DR,其RF-DAC最大采样率是 9.85GSPS,如果想输出的信号中心频率在5.8G,它是如何有效输出在第二奈奎斯特区域范围的信号的。

weixin_44630490的博客 1551

Spark共享变量——广播变量和累加器

什么是共享变量 通常情况下,当向Spark操作(如map,reduce)传递一个函数时,它会在一个远程集群节点上执行,它会使用函数中所有变量的副本。这些变量被复制到所有的机器上,远程机器上并没有被更新的变量向驱动程序回传。在任务之间使用通用的,支持读写的共享变量是低效的。所以Spark提供了两种有限类型的共享变量,广播变量和累加器。 广播变量 广播变量原理图: 广播变量的运用: v...

我是一名程序猿 1770

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Spark 共享变量:广播变量与累加器解析

在 Spark 大数据处理框架中,共享变量是一个非常重要的概念。当我们处理一些涉及到不同计算节点(Executor)需要访问相同数据的场景时,共享变量就发挥了关键作用。本文将深入探讨 Spark 中的广播变量和累加器,包括它们的使用场景、原理以及如何在实际代码中应用。

天冬忘忧的博客 1699

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

Spark的共享变量(广播变量和累加器)

https://blog.csdn.net/happyAnger6/article/details/46576831 https://www.cnblogs.com/xlturing/p/6652945.html 共享变量: 我们知道Spark是多机器集群部署的,分为Driver/Master/Worker,Master负责资源调度,Worker是不同的运算节点,由Master统一调度,而Driver是我们提交Spark程序的节点,并且所有的reduce类型的操作都会汇总到Driver节点进行整合。节点之间

一碗竹叶青的博客 525

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Spark 的共享变量之累加器和广播变量

前言 本期将介绍下 Spark 编程中两种类型的共享变量:累加器和广播变量。 简单说,累加器是用来对信息进行聚合的,而广播变量则是用来高效分发较大对象的。 学习目标 闭包的概念 累加器的原理 广播变量的原理 1. 闭包的概念 在讲共享变量之前,我们先了解下啥是闭包,代码如下。 var n = 1 val func = (i:Int) => i + n 函数 func 中有两个变量 n 和 i ,其中 i 为该函数的形式参数,也就是入参,在 func 函数被调用时, i 会被赋予一.

weixin_43958974的博客 771

Spark编程-共享变量(广播变量和累加器)

主要编写了共享变量的使用,spark有两个抽象一个是rdd,一个是共享变量,共享变量包括广播变量和累加器,同时讲了他们使用范围及累加器使用注意对象。

Matrix70的博客 594

Spark共享变量之广播变量和自定义累加器的介绍及使用

Shared Variables(共享变量) 在 Spark 程序中,当一个传递给 Spark 操作 (例如 map 和 reduce) 的函数在远程节点上面运行时,Spark 实际上操作的是这个函数所用变量的一个独立副本。这些在Driver端声明的变量会被复制到每个Executor进程所在的执行机器上,并且这些变量在远程机器上的所有更新都不会传递回驱动程序。通常跨任务的读写变量是低效的,但是,...

程序猿丶HLK 1302

从0开始学习spark(6)Spark共享变量之累加器和广播变量的使用!!!

Spark零基础入门第六课1. spark共享变量(Shared Variables)1.1 简介:1.2 为什么要定义广播变量 :1.3 、如何定义和还原一个广播变量 :2. Accumulators(累加器)2.1 为什么要定义累加器 :2.2 如果定义和还原一个累加器3. 自定义累加器: 每日福利来一个。 没有看前面的同学可以回顾一下: 5.RDD常用算子用法训练(附习题答案)(aggregateByKey与combineByKey)!!! 4.Spark Rdd常用算子和RDD必备知识 3.sp

蛋蛋淡淡定的庄园 515

java的变量累加_Spark共享变量(广播变量、累加器)

1.Spark两种共享变量:广播变量(broadcast variable)与累加器(accumulator)累加器用来对信息进行聚合,而广播变量用来高效分发较大的对象。共享变量出现的原因:通常在向 Spark 传递函数时,比如使用 map() 函数或者用 filter() 传条件时,可以使用驱动器程序中定义的变量,但是集群中运行的每个任务都会得到这些变量的一份新的副本,更新这些副本的值也不会影响...

weixin_39848097的博客 196

Spark编程指南之八:共享变量、广播变量、累加器

Spark编程指南之三:共享变量 问题:怎样统计到底有多少行 i=i+1 line,line.size 并未返回到driver端。 可以用来统计性能

砥砺前行的博客 485

(转)Spark共享变量(广播变量、累加器)

【转载原文:https://blog.csdn.net/Android_xue/article/details/79780463】 版权声明:本文为博主原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接和本声明。 本文链接:https://blog.csdn.net/Android_xue/article/details/79780463 Spark两种共享变量...

小蚯蚓的博客 343
上一篇: Hive的内置函数parse_url_tuple/lateral view/explode
下一篇: Spark HA
K. Bob
博客等级 码龄8年 82粉丝 294原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值