crewai的进一步工具扩展

用Google Serper进行Web搜索的全面指南 Google Serper为开发者提供了灵活的API接口,能够满足不同的搜索需求。通过本文介绍的示例和技术,您可以更好地利用这一工具进行高效的信息检索。Serper API文档Langchain文档。 阅读详情

crewai的进一步工具扩展

SerperDevTool

前置环境

今天来测试一下关于网页访问的一些tools的调用,首先就是SerperDevTool,这是一个crewai框架提供的内置搜索工具之一,底层调用的是serper.dev 提供的 Google 搜索 API(SERP API),主要功能:让 AI Agent 能够实时上网搜索,获取最新的网页搜索结果

这个工具的调用方法是使用serper.dev 服务的 API Key。

os.environ[“SERPER_API_KEY”] = “Your Key” 是什么?从哪里获得?

这是 serper.dev 服务的 API Key。

  • Serper.dev 是一个专门提供 Google 搜索结果的第三方 API 服务
  • 价格很便宜(号称是 SerpAPI 等竞品的 1/5 ~ 1/10 价格)
  • 有免费额度(通常注册送 2500 次查询,够测试和轻度使用)

获取方式(2026 年最新流程基本没变):

  1. 打开官网:https://serper.dev/
  2. 用邮箱注册账号(Sign up),不需要信用卡
  3. 注册/登录后,进入 dashboard(控制台)
  4. 在左侧菜单或主页明显位置找到 API Key 或 Get API Key
  5. 复制那一串很长的密钥(类似 sk-abc123…)
  6. 粘贴到代码里替换 “Your Key”:
os.environ["SERPER_API_KEY"] = "你的真实密钥写在这里"

此外还要先下载crewai - tools,方便后面的调用

install crewai crewai-tools

调用方式

import os
from dotenv import load_dotenv  # 需安装:pip install python-dotenv

# 加载.env文件中的环境变量(优先读取系统环境变量,本地开发用.env)
load_dotenv()

# 从环境变量读取SERPER API密钥,移除硬编码
os.environ["SERPER_API_KEY"] = os.getenv("SERPER_API_KEY", "your-serper-api-key-here")

from crewai import Agent, Task, Crew, LLM
from crewai_tools import SerperDevTool

LLM_API_KEY = os.getenv("LLM_API_KEY", "your-llm-api-key-here") 
LLM_BASE_URL = os.getenv("LLM_BASE_URL", "https://your-llm-base-url-here/api/v1") 
LLM_MODEL = os.getenv("LLM_MODEL", "your-llm-model-name-here") 

os.environ["OPENAI_API_KEY"] = LLM_API_KEY
os.environ["OPENAI_API_BASE"] = LLM_BASE_URL

my_llm = LLM(
    model=f"openai/{LLM_MODEL}",
    base_url=LLM_BASE_URL,
    api_key=LLM_API_KEY
)

research_agent = Agent(
  role='研究员',
  goal='查找并总结最新的人工智能新闻',
  backstory="""您是一家大公司的研究员。
  您负责分析数据并为业务提供见解。""",
  llm=my_llm,
  verbose=True
)

search_tool = SerperDevTool()

task = Task(
  description='查找并总结最新的人工智能新闻',
  expected_output='对前 5条最重要的人工智能新闻进行项目符号列表总结',
  agent=research_agent,
  tools=[search_tool]
)

crew = Crew(
    agents=[research_agent],
    tasks=[task],
    verbose=True
)

result = crew.kickoff()
print(result)

结果反馈

但是我们发现这里我们调用的api训练数据是比较老的,他默认当前最新的信息是23年,所以如果我们想去查询实时消息的话,我们需要对时间进行一个定义
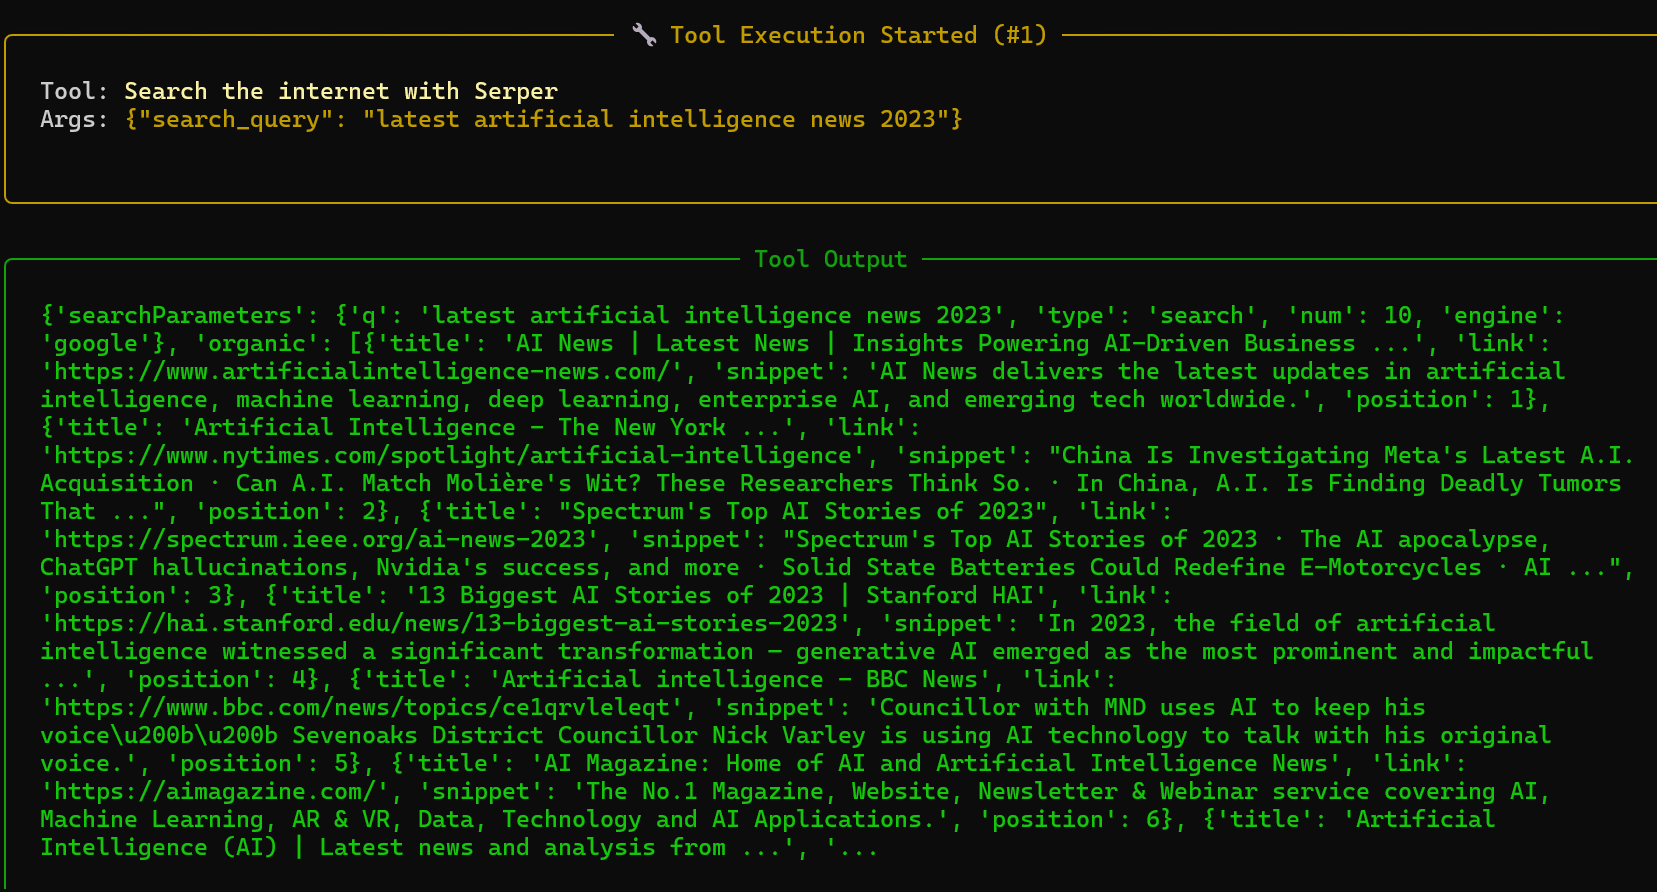
image-20260122163449170
from datetime import datetime
#重新定义时间
    description=f'查找并总结 {datetime.now().year} 年最新的 AI 新闻',

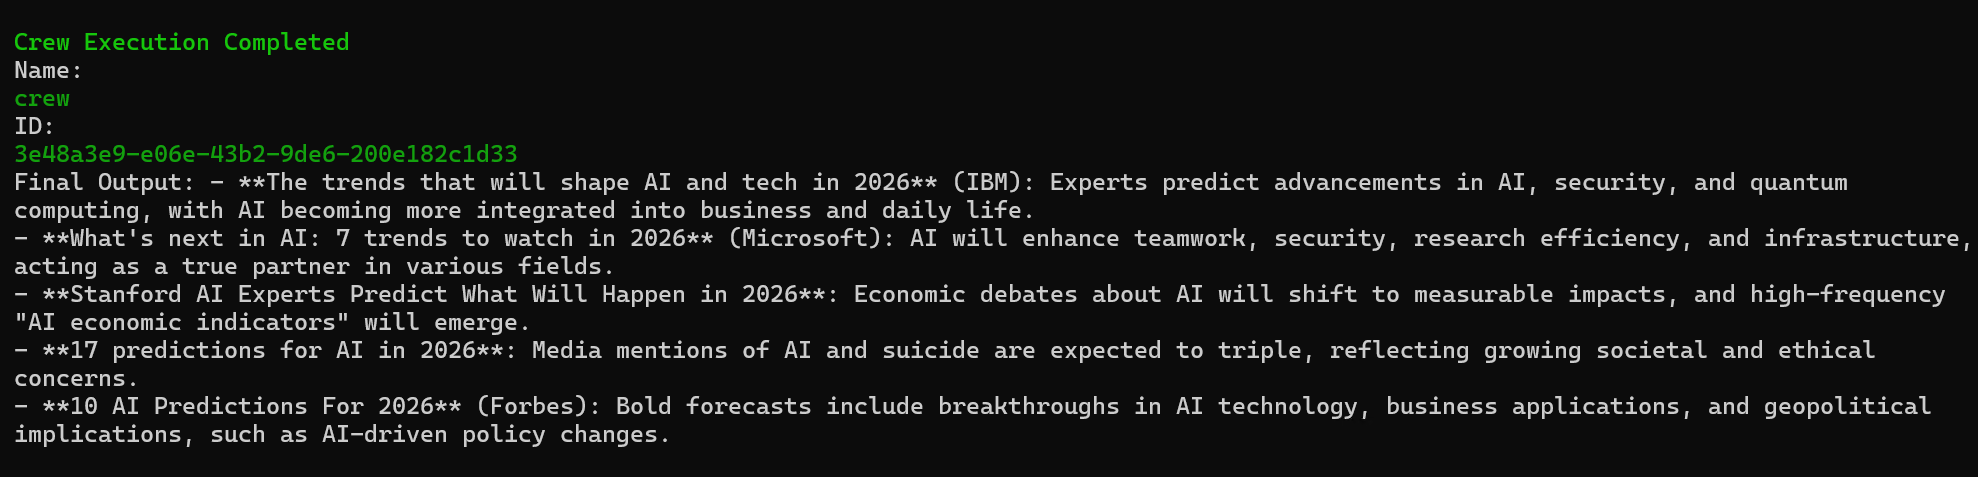
定义玩之后,我们获取的数据就正常了image-20260122164419078
DuckDuckGoSearchRun

前置环境

首先是前置准备,这里我们全部写到requirements.txt里面去,以便于一键安装前置环境

unstructured
          
langchain
          
Jinja2>=3.1.2
          
click>=7.0

langchain-community
          
duckduckgo-search
pip install requirements.txt

这样我们的前置工作就准备好了,工具的调用和之前的是差不多了,也是直接从库里import出来

from crewai import Agent, Task, Crew, Process, LLM
from crewai.tools import BaseTool
import os
from langchain_community.tools import DuckDuckGoSearchRun

这样我们的ai就具有了去搜查相应网站的实时数据的能力

调用方式

from crewai import Agent, Task, Crew, Process, LLM
from crewai.tools import BaseTool
import os
from dotenv import load_dotenv  # 需安装:pip install python-dotenv
from langchain_community.tools import DuckDuckGoSearchRun

# 加载.env文件中的环境变量(优先读取系统环境变量)
load_dotenv()

llm = LLM(
    model=os.getenv("LLM_MODEL", "openai/deepseek-v3"),  
    api_key=os.getenv("LLM_API_KEY", "your-llm-api-key-here"),  
    base_url=os.getenv("LLM_BASE_URL", "https://your-llm-base-url-here/api/v1")  
)

class SearchTool(BaseTool):
    name: str = "DuckDuckGo Search"
    description: str = "Search the web for information using DuckDuckGo"

    def _run(self, query: str) -> str:
        return DuckDuckGoSearchRun().run(query)

search_tool = SearchTool()

researcher = Agent(
    role='Researcher',
    goal='Research methods to grow this channel 毕导THU on Bilibili and get more subscribers',
    backstory='You are an AI research assistant specializing in Bilibili content ecosystem',
    tools=[search_tool],
    verbose=True,
    llm=llm,
    allow_delegation=False
)

writer = Agent(
    role='Writer',
    goal='Write compelling and engaging reasons as to why someone should join 毕导THU Bilibili channel',
    backstory='You are an AI master mind capable of growing any Bilibili channel',
    verbose=True,
    llm=llm,
    allow_delegation=False
)

task1 = Task(
    description='Investigate 毕导THU Bilibili channel', 
    agent=researcher,
    expected_output='A detailed report about the channel performance, content style, and current subscriber base.'
)

task2 = Task(
    description='Investigate sure fire ways to grow a Bilibili channel', 
    agent=researcher,
    expected_output='A comprehensive list of proven strategies to grow a Bilibili channel including content optimization and engagement techniques.'
)

task3 = Task(
    description='Write a list of tasks 毕导THU must do to grow his channel', 
    agent=writer,
    expected_output='A actionable checklist of tasks for the channel owner to implement immediately.'
)

crew = Crew(
    agents=[researcher, writer],
    tasks=[task1, task2, task3],
    verbose=True,
    process=Process.sequential
)

result = crew.kickoff()
print(result)

结果反馈

这里我们做了两组实验,第一个用了deep seekv3去调查国内视频平台的以为up主,第二个使用了deep seekr1去调查了了国外视频平台的一位up主。其中发现了一些问题。

1. v3模型——bilibili毕导

首先我们记录一下第一组测试。由于v3是通用文本处理,所以它在工具调用的频率以及深度上是不及于r1的,这里我们从报告的详细度以及丰富度可以看出来。但是因为视频平台是国内的,所以它搜索统计的速度也相对快很多,一共是进行了六次工具的调用。
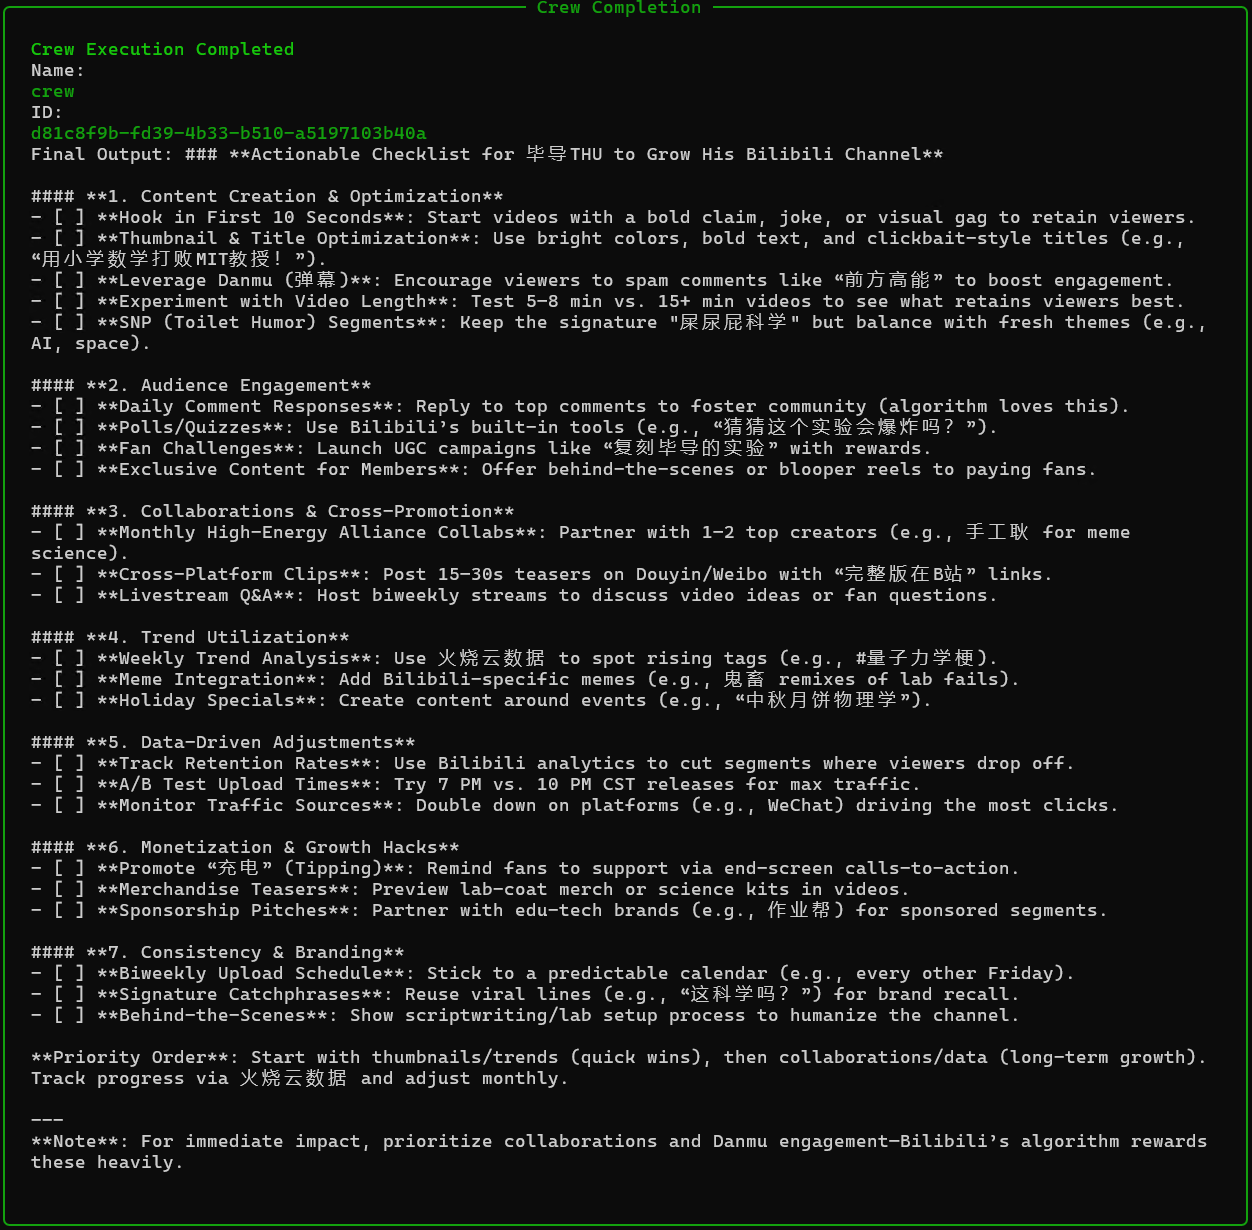
image-20260119150344164
2. r1模型——YouTube高达烈

其次是r1大模型对国外博主推理结果,因为其是开放式推理,所以处理速度相对要慢很多,当然数据的收集以及统筹就相对详细了,但是由于YouTube是外网的视频平台,国内的api接口在具体访问油管平台进行粉丝数量调查的时候会出现链接超时或者报错的情况。一共调用了19次工具,其中超时失败了4次
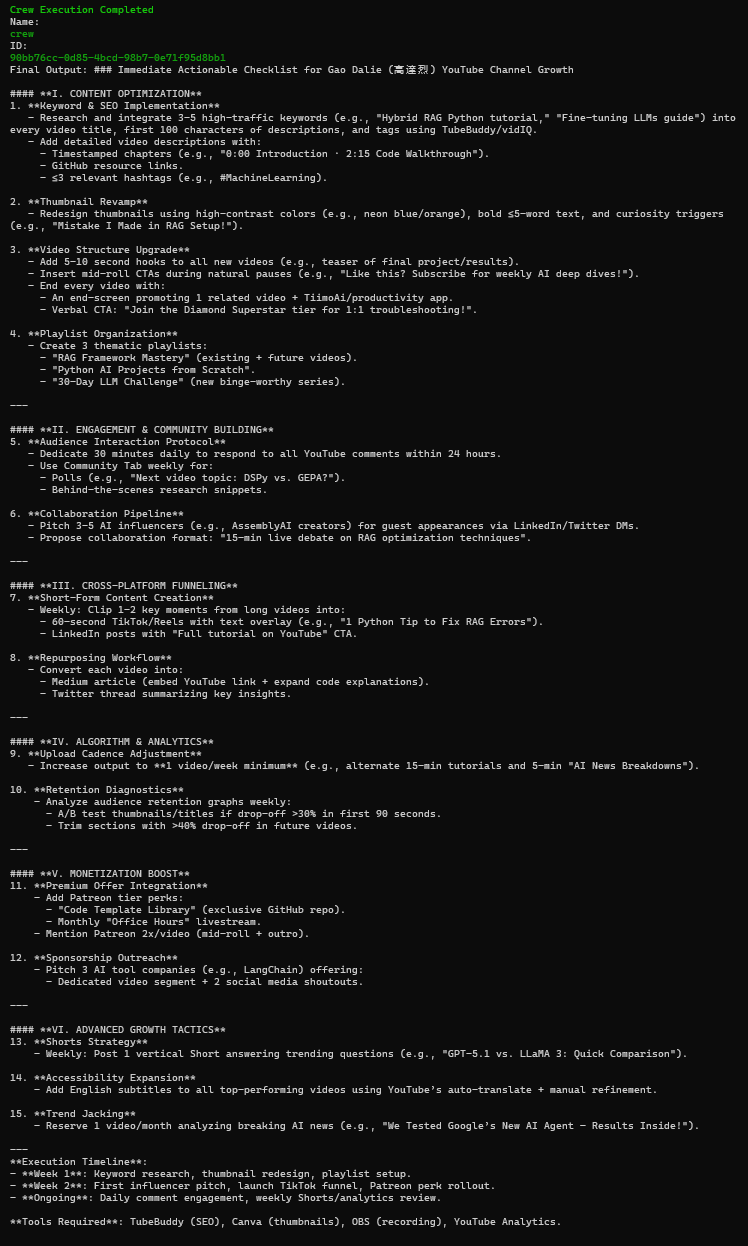
image-20260119150737128

共性问题

讲一下两个模型在测试的时候会遇到的共性问题

  1. 首先是因为deepseek属于基于openai协议的大模型,与crewai本土支持的gpt在内容输出上还是有一定的差异性,所以两者在调用工具的时候,会时不时出现调用工具内容出错的问题
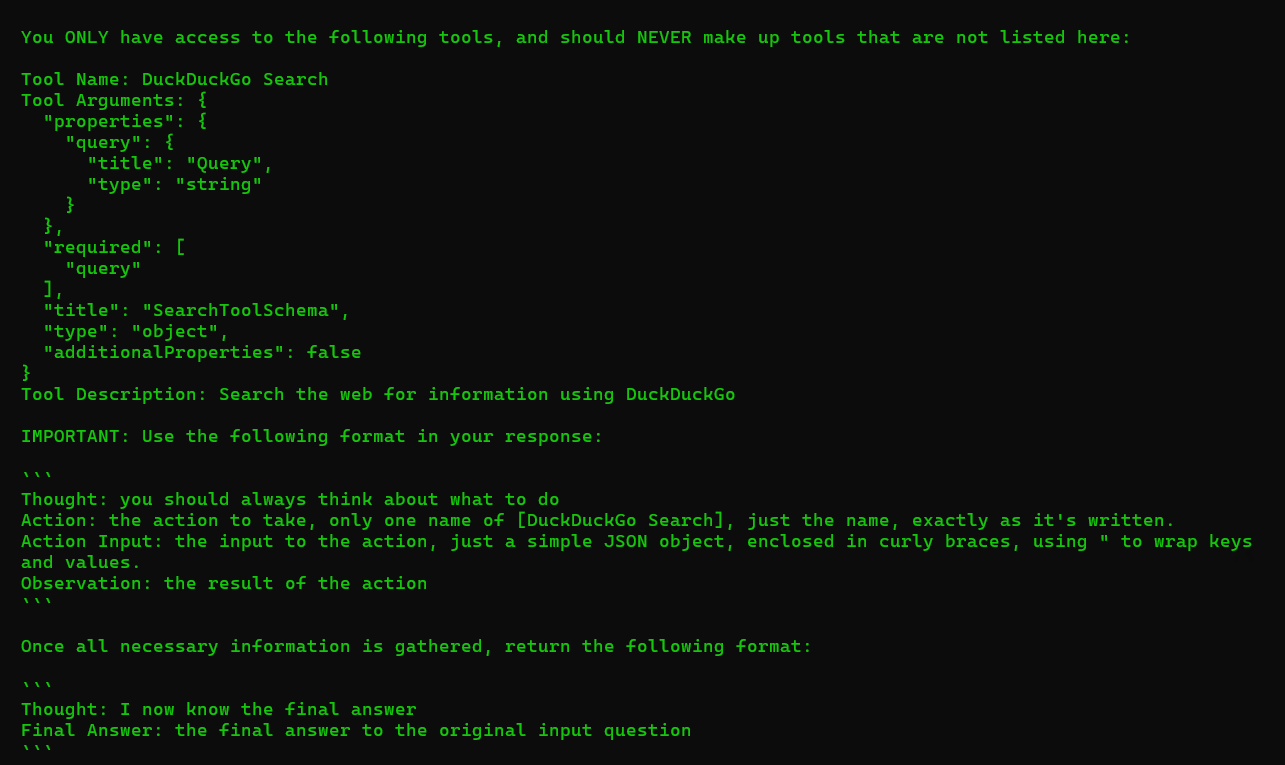
  2. 其次是可能是由于工具的问题,这个进行调查总结的效率并不高,进程执行的比较缓慢

探索Serper:强大的Google搜索API在LangChain中的应用 Serper API提供了一种灵活的方式将Google搜索结果集成到应用中。通过LangChain的包装器和工具集成,开发者可以轻松实现复杂的搜索和问答功能。想深入了解?Serper官方文档LangChain文档。 阅读详情

相关推荐

深入探索LangChain中的Serper Google搜索API的强大功能

Serper Google搜索API在LangChain中的集成使得应用拥有了更强大的信息检索能力。通过本文介绍的方式,开发者可以轻松集成和扩展搜索功能。Google Serper API官方文档LangChain官方文档。

nseejrukjhad的博客 616

挖到宝了!7个能直接“白嫖”的AI Agents搜索API,代码都给你写好了,快收藏!

AI Agent 的效能取决于其获取最新、可靠信息的能力。许多AI代理在后台利用网页搜索工具来获取最新上下文,确保输出内容始终保持相关性。然而,并非所有搜索API都能无缝融入您的技术栈或工作流程,且性能表现各有不同。

m0_56255097的博客 2198

如何使用 CrewAI 构建协作型 AI Agents

语言模型在翻译、总结和推理方面表现出色。但它们的潜力远不止于此。让大语言模型 (LLM) 具备代理性是充分挖掘其推理潜力的一种方法。AI 智能体就是被赋予适当工具和指令的 LLM,能够自动完成网页浏览、网络抓取、执行 SQL 查询、文件操作等任务。利用 LLM 的推理能力,这些智能体能够根据当前需求选择合适的工具。而且,我们还可以将多个智能体组合起来,共同完成更复杂的任务。当我们谈论如何构建 AI Agents时,首先想到的工具就是 LangChain。

FrenzyTechAI的博客 6732

7个最稳定的SERP API(99%+可用性实测)

2026年14天实测数据显示,主流SERP API服务商的成功率均超过98%,其中SerpApi以99.7%居首,DataForSEO(99.5%)和SerpBase(99.4%)紧随其后。关键发现:前三名差异在统计误差范围内,但SerpBase以0.4-0.5美元/千次的低价实现顶级可靠性,成本仅为竞品的1/10-1/100。可靠性阈值99%是分水岭,低于该值需频繁重试。测试方法建议通过24小时循环请求验证,生产环境需7-14天监测稳定性。结论表明当前技术下,高性价比的SerpBase是大多数团队的最优解

2611_95871009的博客 531

Multi-Agent架构-CrewAI详解

CrewAI作为一种先进的Multi-Agent协作框架,为构建高效协作的智能体团队提供了有力支持。通过其模块化的架构和丰富的组件库,开发者可以轻松地构建出具有高级协作能力的智能体系统,并在多个领域实现创新应用

llm_way的博客 2297

CrewAI智能体开发:EXA 搜索网页加载器

EXASearchTool 旨在对互联网上文本内容的指定查询执行语义搜索。

王国平的博客 312

DBeaver 插件扩展完整指南:从判断需求到排障的 4 个动作

查询结果导不成 Excel?要连的库不在 DBeaver 默认名单里?这两个卡点正是 DBeaver 插件扩展要解决的:它把连库、功能增强、外部工具对接拆成一个个可装卸的模块,本文带你走完判断需求到排障的闭环。 [![DBeaver 社区版启动页,插件扩展模块示意](https://raw.gitcode.com/GitHub_Trending/db/dbeaver/raw/f00c884041

gitblog_00476的博客 784

CrewAI 技术总结笔记

代理是 CrewAI 的基本构建单元。每个代理都代表一个具备特定角色和能力的虚拟个体,通过背景故事赋予代理鲜明的个性化特征。代理能够执行任务、使用工具、与其他代理协作并在必要时进行任务委派。任务是代理需要完成的具体工作单元。每个任务都包含清晰的描述和预期输出,并由指定的代理执行。团队是由多个代理组成的协作单元,负责执行一组互相关联的任务。团队可灵活配置执行流程,以便在复杂任务中实现最大化效率。流程定义了任务在团队内的执行方式。

形上得其象,形下合于数;阴阳自济,玄理自明。 1492

Arcade MCP工具链集成:如何在LangChain、CrewAI等框架中使用MCP工具

Arcade MCP是一个强大的工具开发框架,能够帮助开发者构建自定义能力并集成到智能代理中。本文将详细介绍如何将Arcade MCP工具链与LangChain、CrewAI等流行的AI框架无缝集成,让你轻松扩展AI应用的功能边界。 ## 为什么选择Arcade MCP工具链? Arcade MCP提供了一种标准化的方式来定义和实现工具,使其能够在不同的AI框架中复用。相比传统的工具集成方式,

gitblog_00312的博客 1051

CrewAI智能体开发:CrewAI 运行自动化工具

使 CrewAI 代理能够在您的工作流中调用 CrewAI 平台自动化并利用外部团队服务。

王国平的博客 502

CrewAI智能体开发:安装CrewAI

CrewAI安装、配置并构建您的第一个 AI 团队。

王国平的博客 1076

多Agent协作工具CrewAI使用指南——核心概念

代理Agent是一个自主单元,被编程用于:执行任务执行任务做出决策与其他代理进行通信将代理看作团队的一员,具有特定的技能和特定的工作任务。代理可以担任不同的角色,如“研究员”、“作家”或“客户支持”,每个角色都为团队的整体目标做出贡献。在 crewAI 框架中,任务是由代理完成的具体任务。它们提供执行所需的所有必要细节,如描述、负责代理、所需工具等,有助于促进各种行动复杂性。crewAI 中的任务可以是协作的,需要多个代理共同工作。

数智笔记 1万+

Android System Slice应用加载分析,及启用Slice后,锁屏日期第一次开机正常显示,但后面锁屏不显示问题分析

最近发现Android P上锁屏界面,日期不显示,发现从P开始后,出现了Slice来允许应用以模块化,可交互的方式,插入多个使用场景。Android P的system UI 也使用到了这一特性,表现为锁屏时间,日期,勿扰图标,闹钟等。 如何使用Slice 以System UI中KeyguardSliceView.java来说明它的使用方法 首先,我们打开System UI 的mk 文件,可以看到以...

qq_33595823的博客 3035

Loop:免费开源的 macOS 径向菜单窗口管理工具,30 秒摆好你的第一个窗口

想象一下这个画面:你正在 Mac 上写代码,编辑器、浏览器、终端各开着一个窗口。这时 IDE 弹出一个构建报错,你又切回去看了个文档,桌面上又多出一扇窗口。按传统方式,你要么伸手把标题栏拖到屏幕左半边再微调边角,要么凭记忆敲一串修饰键组合。动作本身不难,难的是它在打断思路。Loop 就是为这类时刻做的:它用「按住一个触发键 + 朝方向移动鼠标」的径向菜单交互,把窗口的移动、缩放和排布压缩成一次不到

gitblog_00934的博客 972

SIwave仿真手册——电源完整性仿真之PDN阻抗的提取(四)

(想不到我这个弱鸡的博主有一天也有被催更的时候,看到后台被催的消息,我慌了,赶紧写一篇把。) 文章目录3.1 PDN阻抗的提取3.1.1手动完成PDN阻抗的提取1、创建pin group2、创建端口3、数据文件的清理和检查(参考1.3.4&1.3.5)4、添加电容模型(参考2.2.1)(==这一步很重要==)5、开始仿真6、查看仿真结果3.1.2利用向导工具完成PDN阻抗的提取1、点击图标![在这里插入图片描述](https://img-blog.csdnimg.cn/36d974339ea5449

luohuo9844的博客 1万+

MySQL等保三级合规实践:如何安全配置root账户的本地与受信主机登录策略

本文详细介绍了MySQL在等保三级合规框架下如何安全配置root账户的本地与受信主机登录策略。通过分析root账户的特殊保护需求,提供三种安全加固方案,包括限制访问范围、限定登录IP和完全禁止远程登录,并指导创建安全的远程管理账户。文章还涵盖了密码策略强化、日志审计配置和网络层防护等关键合规要求,帮助用户实现MySQL的等保三级全面合规。

weixin_42522964的博客 260

CrewAI工具集成终极指南:扩展AI代理能力的完整方案

CrewAI是一个强大的多AI代理协调框架,通过外部工具集成能够显著提升AI代理的能力和实用性。本文将为您详细介绍如何在CrewAI项目中集成和使用外部工具,让您的AI代理获得更强大的功能和更广泛的应用场景。 ## 🚀 为什么需要工具集成? CrewAI工具集成能够让AI代理访问外部资源、执行特定操作,并与现实世界进行交互。通过工具集成,您的AI代理可以: - 访问网络搜索和信息检索功能

gitblog_00842的博客 1126

基于STM32的智能火灾报警系统设计:多传感器融合与远程控制实现

本文详细介绍基于STM32单片机的智能火灾报警系统设计,采用多传感器融合技术(烟雾、温度、火焰检测)实现高精度火灾识别。系统集成远程控制与手机APP监控,通过加权决策算法降低误报率,提供多级响应策略,确保火灾预警的准确性与可靠性。

u5v6w7的博客 1103

CrewAI工具链深度解析:如何通过自定义工具扩展Agent能力边界

本文深入解析CrewAI工具链,重点介绍如何通过自定义工具扩展Multi Agent系统的能力边界。从基础架构到高级开发技巧,涵盖医疗数据清洗、金融风控等专业领域工具实现,并提供性能优化与多工具协同的最佳实践,帮助开发者构建更强大的智能体协作系统。

bb456的博客 632

EPLAN中3D宏文件的创建与优化技巧(以开关电源为例)

本文以开关电源为例,详细讲解了在EPLAN中创建和优化3D宏文件(.ema)的全流程。从搭建宏项目、导入模型,到精确定义安装面、调整视野方向,再到定义3D连接点并关联部件库,旨在帮助电气工程师在设计阶段实现精准布局、避免安装冲突,从而提升设计效率与质量。

weixin_29219539的博客 547

海康VisionMaster与西门子PLC1200进行S7通信

通信是连通算法平台和外部设备的重要渠道,在海康VisionMaster算法平台中既支持外部数据的读入也支持数据的写出,当通信构建起来以后既可以把软件处理结果发送给外界,又可以通过外界发送字符来触发相机拍照或者软件运行。 本文以西门子PLC1200作为外部设备为例,讲解海康VisionMaster与西门子PLC1200进行S7通信。......

haier123888的博客 1万+

CrewAI部署指南

咩咩咩咩咩咩咩咩

T_Fire_of_Square的博客 1371

手把手教你学simulink(24.4)--Simulink在机器人视觉场景下的应用——基于视觉的物体跟踪与抓取

该系统集成了图像处理、目标检测、运动估计、路径规划、抓取控制和视觉反馈等多个功能模块,能够实现实时处理视觉数据、检测并跟踪移动物体、规划最优路径并控制机械臂进行精确抓取。本项目的目标是使用Simulink和MATLAB设计一个基于视觉的物体跟踪与抓取系统,该系统能够实时处理图像数据,检测并跟踪移动物体,规划最优的抓取路径,并控制机械臂进行精确抓取。为了验证系统的性能,我们在Simulink中搭建了基于视觉的物体跟踪与抓取系统的仿真模型。

MHD0815的博客 257

基于 CrewAI 构建 Multi Agent 系统(一)CrewAI 核心概念详解

Agent是 CrewAI 中的自主单元,具备执行任务、做出决策和与其他代理通信的能力。它们如同团队中的成员,各自承担特定角色,如研究员、作家或客户支持等,共同为实现团队目标贡献力量。在 CrewAI 框架中,任务是代理需要完成的具体工作,包含执行所需的各种细节,如清晰的描述、负责执行的代理、所需工具等。任务可以是协作性的,通过属性管理和流程编排,实现多个代理的协同工作,提升团队合作效率。

m0_56255097的博客 4854

微信小程序 - 实现人脸识别对比+人脸相似度数据,用户从相册选择或拍照上传两张图片进行人脸对比得到人脸相似度及判断是否是同一个人,微信小程序检测人脸相似度(免费纯前端方案+调用第三方API接口方案)

微信小程序实现人脸识别对比,微信小程序人脸对比 人脸对比识别 人脸对比相似度,实现获取手机摄像头权限,调用相机拍照实现人脸识别相似度对比,小程序人脸相似度对比,快速识别两张照片的相似程度(用百分比)图片相似度对比在线测试,图片相似度对比,微信小程序人脸相似度对比分析,计算两张人脸的相似度,从而判断是否同一个人,并给出相似度评分。小程序如何实现人脸相似度比对,小程序纯前端怎么对比两张图片的相似度,计算两幅图像的相似度,图像相似度对比方法,调用百度AI的人脸识别,微信小程序中实现人脸识别认证,实现人脸检测、人脸

🏆 前端领域优质创作者 4863

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

【亲测免费】 crewAI 工具箱指南

crewAI 工具箱是专为crewAI框架设计的一个扩展库,它赋予了AI代理强大的工具集合,从而增强了AI解决方案的定制性和功能性。此项目旨在指导开发者如何设置并利用这些高级工具,使得AI代理能够执行从网络搜索、数据分析到协作和任务委派等多种功能。通过这个框架,你可以轻松集成或自定义工具,以适应特定的应用场景,确保你的智能代理具备更广泛的操作能力。 ## 快速启动 要迅速着手于使用crewAI...

gitblog_00109的博客 948

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

上一篇: CrewAI部署指南
下一篇: crewai进一步功能的实现
T_Fire_of_Square
博客等级 码龄3年 110粉丝 29原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值