Tensorflow 获取model中的变量列表,用于模型加载等

Tensorflow 获取model中的变量列表 1、动态获取 + 朴素获取法 + 朴素获取可训练变量:t_vars = tf.trainable_variables() + 朴素获取全部变量,包含声明training=False变量:all_vars = tf.global_variables() + 使用tensorflow.contrib.slim + 获取常规变量(是slim里面与model变量对应的一个类型):regular_variables = slim.get_variable... 阅读详情

目录

前言

1. 用tensorflow自带的工具

2. 用tensorflow.contrib.slim。

3. 从保存的model中提取var_list

4. 其他


前言

在加载预训练的网络模型时,有时仅需要利用保存的网络模型中的部分变量,因此我们需要提取这些变量的变量列表,用于变量加载。如以下示例所示,当用tensorflow.train.Saver(var_list)加载模型参数时,需要传入的var_list需要一种特定的数据格式,而直接使用str组成的变量名列表是无效的。

var_list = saver._var_list
print(type(var_list[0]))
#output : <class 'tensorflow.python.ops.variables.RefVariable'>
print(var_list[0])
#output : <tf.Variable 'g_b1:0' shape=(32768,) dtype=float32_ref>

那么,如何获取指定格式的变量列表呢?主要有以下方式:

1. 用tensorflow自带的工具

  • (1) 获取图(graph)中所有变量,包括可训练的与不可训练(training=False)的变量
all_vars = tf.global_variables()
  •  (2)获取图中可训练的变量。
train_vars = tf.trainable_variables()
  • (3)根据变量名在已有变量列表中筛选变量。在(1)或(2)中获取的变量列表中进行筛选
# 从all_vars列表中筛选以”generator“开头的变量,组成一个新的变量列表。
g_vars =[var for var in all_vars for var.name.startswith("generator")]

# 从all_vars列表中筛选name中包含”batch_normalization“的变量
bn_var_list = [v for v in all_vars if "batch_normalization" in v.name ] 
  • (4)提取某个特定变量空间中的变量列表
# 提取variable_scope或name_scope ”generator“下的所有变量的变量列表。
g_vars = tf.get_collection(tf.GraphKeys.GLOBAL_VARIABLES,scope="generator")

# 提取variable_scope或name_scope ”generator“下的所有可训练变量的变量列表。
g_vars = tf.get_collection(tf.GraphKeys.TRAINABLE_VARIABLES,scope="generator")

2. 用tensorflow.contrib.slim。

tensorflow.contrib.slim是一个强大的工具,也可以用来方便的构建变量列表

  • (1)返回常规变量,应该是返回所有变量(没测试)
import tensorflow.contrib.slim as slim
#下面这行代码返回常规变量
#常规变量是slim里面与model变量对应的一个类型
regular_variables = slim.get_variables()
#你也可以直接
vars = slim.get_variables_to_restore()
     
  • (2)根据条件,筛选变量,构建变量列表
#通过name或前缀筛选
variables = slim.get_variables_by_name("d_")

#通过name后缀筛选
variables = slim.get_variables_by_suffix("_b")

#通过namespace筛选
variables = slim.get_variables(scope="layer1")

#通过include和exclude特定字符串筛选
variables_to_restore = slim.get_variables_to_restore(include=["d_"])
variables_to_restore = slim.get_variables_to_restore(exclude=["_w"])

3. 从保存的model中提取var_list

方法,将离线文件载入当前环境(加载保存的model的图结构),然后使用以上的方法。

注意:在加载model中的图时,要先清空现有的图,否则,import_meta_graph会把原model里面的数据追加到现有的model中,导致一片混乱

# 清空图  
tf.reset_default_graph()
     
with tf.Session(graph=tf.get_default_graph()) as sess:

    # 从model.meta文件中加载保存的图结构
    new_saver = tf.train.import_meta_graph('./model.meta')

    # 从model中加载保存的变量数据
    new_saver.restore(sess, './model')

    # 然后从加载得到的图中获取变量列表,如
    var_list=tf.global_variables()
    print(var_list)

下面是一个从保存的模型中加载图结构,加载变量数值,并打印特定变量的变量值的示例。

import tensorflow as tf

model_path = "/media/***/model.ckpt-18000"

tf.reset_default_graph() # 清空图,防止图上存在干扰节点
with tf.Session(graph=tf.get_default_graph()) as sess:
	saver = tf.train.import_meta_graph(model_path+".meta")# 从model.meta文件中加载保存的图结构
	saver.restore(sess, model_path)# 从model中加载保存的变量数据
	
	var_list = tf.global_variables() # 获取图上的所有变量
	bn_var_list = [v for v in var_list if "batch_normalization" in v.name ] # 筛选与BatchNormalization相关的变量
	for v in bn_var_list: 
		print(v,sess.run(v)[1]) # 打印变量名,与对应的变量值。为了便于观察,打印变量张量的第一个数值


4. 其他

  • (1)用pywrap_tensorflow 直接读取离线文件中的变量信息,但是,这种方法获取到的var_list与要求的格式不一样。

 我还不知道怎么转换成saver要求的类型,等一个有缘人相告!

    import tensorflow as tf
    from tensorflow.python import pywrap_tensorflow
     
    #文件夹地址改成自己的
    model_dir="./model"
     
    ckpt = tf.train.get_checkpoint_state(model_dir)
    reader = pywrap_tensorflow.NewCheckpointReader(ckpt.model_checkpoint_path)
     
    #返回一个dict= {'name':[shape] }
    #例如 'd_w2/Adam':[4, 4, 32, 64]
    var_to_shape_map = reader.get_variable_to_shape_map()
     
    #我们可以用遍历的方式,取出字典里所有的key
    for key in var_to_shape_map:
        print(key)        #key是str类型的
        #再用key去找这个tensor的值
        a=reader.get_tensor(key)
        print(type(a))    #输出: <class 'numpy.ndarray'>
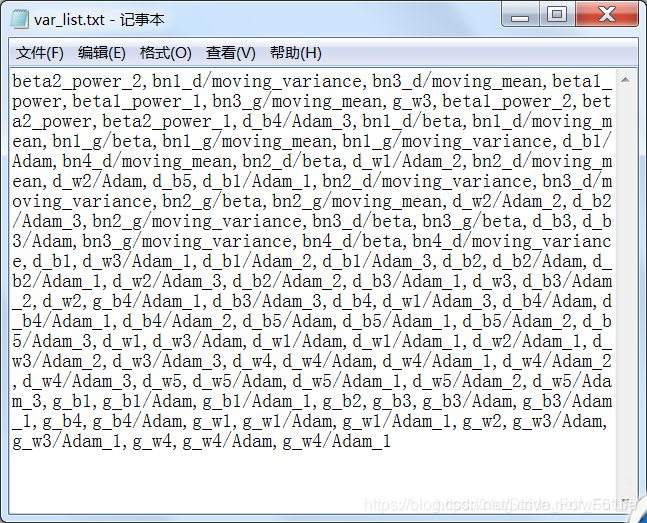
  • (2)把获得的list输出到一个外部txt文件中,以后使用只需要读取txt即可

          PS:目前这种方法只支持str类型保存变量name!不支持saver!

代码示例:

 with open("var_list.txt","w") as f:
     f.write( ','.join(str(var_list)))   #write只能打印str类型,需要强制转换

效果如图:
要使用的时候,只需要按如下代码读取

 with open("var_list.txt","r") as f:
     str1 = f.readlines()[0]
     var_list=str1.split(',')
     print(var_list)

 

tensorflow模型的save与restore,以及checkpoint中读取变量     创建一个NNimport tensorflow as tf import numpy as np#fake data x = np.linspace(-1, 1, 100)[:, np.newaxis] #shape(100,1) noise = np.random.normal(0, 0.1, size=x.shape) y = np.power(x, 2) + noise ... 阅读详情

相关推荐

tensorflow模型保存(三)——tensorflow1.x版本的savedmodel格式的模型保存与加载

前言:前面的两篇文章已经分别介绍了高层API与低层API关于各种模型的保存,比如在tensorflow2.x中如何保存checkpoint与savedmodel,在tensorflow1.x中如何保存checkpoint,本文着重介绍在tensorflow1.x版本中怎么保存savedmodel。 要想恢复模型并能够正确的加载,最核心的就在于要给模型的输入与输出起一...

MIss-Y的博客 1万+

tensorflow 查看模型中的参数列表及对应的值

tensorflow的checkpoint文件存储模型使用的变量对象,其是一个二进制文件,将变量名映射到对用的tensor值,因此可通过该文件查看参数对应的值 #使用NewCheckpointReader来读取ckpt里的变量 from tensorflow.python import pywrap_tensorflow # 以下XXX为模型保存chechpoint文件的相对路径,如"model/bestParMTCR_gateBehavior.ckpt" checkpoint_path = "XXX".

beginerToBetter的博客 4135

TensorFlow SavedModel保存和加载模型

声明: 参考TensorFlow官方文档 SavedModel 如果你想保存或恢复模型,我们推荐使用SaveModel. SaveModel是一种与语言无关,可恢复的密封式序列化格式。TensorFlow提供了多种与SavedModel交互的机制,如tf.saved_model API、Estimator API和CLI。 PS: 本文只介绍tf.saved_model API ...

hustqb的博客 2万+

tensorflow学习笔记(五):TensorFlow变量共享和数据读取

1、变量共享   前面已经说过如何进行变量的生成和初始化内容,也用到了命名空间的概念,这里说一下什么是变量共享。当我们有一个非常庞大的模型的时候免不了需要进行大量的变量共享,而且有时候还希望能够在一个地方初始化所有的变量,这就需要tf.variable_scope() 和 tf.get_variable()。   当只有两层的卷积的时候,前面的程序都是定义了两个卷积变量W1和W2(忽略b),而

woaidapaopao的博客 1万+

tensorflow_serving通过model_config_file进行模型部署以及更新部署

tensorflow_serving通过model_config_file进行模型部署以及更新部署TF Serving模型部署docker方式第一种方式第二种方式,通过model_config_file进行部署(推荐) TF Serving TF Serving架构具体包括:servables、loaders、sources、managers和core,具体内容参照tensorflow servi...

CaiBaCai 5961

Tensorflow 模型持久化 Model Persistence

Methods of tf model persistence 如果我们的神经网络比较复杂,训练数据比较多,那么我们的模型训练就会耗时很长,如果在训练过程中出现某些不可预计的错误,导致我们的训练意外终止,那么我们将会前功尽弃。为了避免这个问题,我们就可以通过模型持久化(保存为CKPT格式)来暂存我们训练过程中的临时数据。 如果我们训练的模型需要提供给用户做离线的预测,那么我们只需要前向传播的过程

Identify && Analyze && Solve Problems 1748

TensorFlow变量管理、保存和读取(持久化)

TensorFlow(tf)中可用tf.variable_scope函数生产上下文管理器,在该上下文管理器的命名空间内定义的变量名称都会带上这个命名空间名作为前缀,例如 with tf.variable_scope("s1"): 下定义的变量变量名前缀都是"s1/". 从外,tf.train.Saver类可以用于保存指定session下的变量计算图和变量值.可参考以下示例程序: impor

qq_32464407的博客 706

Tensorflow中的模型持久化

众所周知Tensorflow解决问题都是去构建不同类型的神经网络,但是神经网络结构变化万千,当神经网络的结构变得更加复杂、参数更多时,程序的可读性会变得非常差,而且这样也会导致程序的结构中有大量的冗余代码,降低编程效率,那么变量管理也就变大尤为重要,前面已经对如何管理tensorflow的变量进行了介绍tensorflow变量管理。  在我们训练模型的过程中,如果不小心由于某些原因退出,如果没有一个

Winter_FDd的博客 2045

CppFlow源码深度解析:model类如何封装TensorFlow C API实现模型加载与推理

CppFlow是一个强大的C++库,它让开发者能够在C++环境中轻松运行TensorFlow模型,无需安装完整的TensorFlow框架或使用Bazel构建系统。这个开源项目的核心优势在于它巧妙封装了TensorFlow C API,为C++开发者提供了简洁易用的接口。本文将深入解析CppFlow中model类的实现机制,揭示其如何封装TensorFlow C API来完成模型加载与推理功能。

gitblog_00280的博客 757

tensorflow笔记(二十六)——tf.estimator模型文件保存和加载

1.模型的4个文件 之前一次测试的时候,发现预测概率全部在0.5左右,最后发现是模型加载没有成功,预测结果其实是随机初始化的模型预测结果,所以概率都是0.5。怎么发现是模型没有加载成功呢?我把模型路径下的文件清空了之后预测,没有报错且预测概率就是0.5附近。然后为什么没有加载成功呢,是因为我的模型从平台存储空间上拷贝到测试机上时,只拷贝了model.ckpt-30000.data-00000-of-00001文件,这是不完整的。整个模型其实包含4个文件: model.ckpt-30000.data-000

蚂蚁搬家 3869

【tensorflow】加载pretrained model出现的大量adam变量丢失

最近在调试tensorflow的fine-tune时,出现大量adam变量丢失,如下代码块 WARNING:tensorflow:Variable resnet_v1_50/conv1/weights/Adam missing in checkpoint ./pretrain_model/resnet_v1_50.ckpt WARNING:tensorflow:Variable resnet_v1...

Shwan_ma的博客 2979

TensorFlow模型的保存和加载

  将训练好的模型参数保存起来,以便以后进行验证或测试,这是我们经常要做的事情。tf里面提供模型保存的函数是tf.train.Saver模块。模型保存先要创建一个Saver对象: saver = tf.train.Saver() 在创建Saver对象的时候,有一个参数经常会用到,就是max_to_keep,这个是用来设置保存模型的个数,默认为5,保存最近的5个模型。如果你想每训练一次(epoch)就想保存一次模型,则可以将max_to_keep设置为None或者0: saver = tf.train.Sa

健身房 1839

笔记本摄像头模拟监控推送RTSP流

FFmpeg软件:选择Windows builds by BtbN一个完整的跨平台解决方案,用于录制、转换和流式传输音频和视频。选择Windows版本EasyDarwin开源流媒体服务器 支持Windows、Linux、macOS平台;支持RTSP推流分发(推模式转发);支持RTSP拉流分发(拉模式转发);VLC Media Player软件:选择Windows64bit支持众多与及文件格式,并支持DVD影音光盘,VCD影音光盘及各类协议。

IT_LittleBaby的博客 3873

Tensorflow2.x中的模型保存和加载

Tensorflow2.x中的模型保存和加载 模型保存和读取 在tensorflow2.x中我们经常需要将训练后的模型保存下来以之后进行使用。这里我们将模型保存进行简单的总结。 1、测试环境 系统 显卡 处理器 Cuda版本 Tensorflow版本 Windows10 Pro Nvidia RTX2070Super Intel core i5 9600KF 10.1 Tensorflow-GPU 2.3 2、基于网络模式模型保存和读取 这里我们简单定义一个5层全连接网络 # 定义一个5

sxdcfb的博客 2176

2、TCGA数据处理(差异分析前处理)

注意:1、是R语言中用于读取文本文件并创建数据框的函数。它可以从文本文件中读取数据并将其存储为数据框的形式,每一列代表一个变量,每一行代表一个观察值。2、括号要成对,不能少了;3、file = 'TCGA-LIHC.htseq_counts.tsv'引号可以是单或双引号,建议单;4、逗号主要中英文,都是用英文模式才没错;5、.tsv文件类型必须要有,不能删除,否则读不进来;6、上面代码将TCGA-LIHC.htseq_counts.tsv文件读入并赋值给count1。

PLW_12的博客 2667

学习Ultralytics (下载)

Ultralytics由创立,最初是为了简化目标检测模型的开发和应用,专注于构建高效、易用、性能卓越的深度学习框架。其主要产品之一是 YOLO 系列模型,尤其是最新的YOLOv5和YOLOv8,因其在精度、速度和可扩展性方面的出色表现而广受欢迎。

2301_76846375的博客 2864

TensorFlow 在 BentoML 中的模型保存、加载与推理服务 API 参考

本文是 BentoML 官方文档中 `bentoml.tensorflow` 模块的 API 参考,面向已通过 [BentoML TensorFlow 指南](https://link.gitcode.com/i/0bf2801aa5966957b7003c4c7ee023ad)(`docs/source/frameworks/tensorflow.rst`)了解过基本用法的开发者,系统梳理 `s

gitblog_00964的博客 322

EDSR图像超分辨程序复现(踩坑及解决记录)

EDSR图像超分辨程序复现(踩坑及解决记录)

Sunny_Coder的博客 3642

tensorflow模型保存和加载

方式一ckpt 使用saver:如果要看,请直接看这个方法的最后两个,前面讲的是官网的坑。 用tf.train.Saver()创建一个saver,然后保存。 # 建立网络创建变量,建图 v1 = tf.Variable(..., name="v1") v2 = tf.Variable(..., name="v2") ... # 建立saver对象,后面保存的时候要用 saver = tf.train.Saver() with tf.Session() as sess: sess.run(..

qq_20849045的博客 755

TI AWR1642实战指南:CCS调试mmWave Demo Visualizer全流程解析

本文详细解析了TI AWR1642开发板的CCS调试流程,重点介绍了mmWave Demo Visualizer的使用方法。从环境准备、版本确认到bin文件烧录、CCS工程配置,再到调试启动与结果验证,提供了全流程的实战指南,帮助开发者快速掌握AWR1642的调试技巧,避免常见错误。

weixin_30790841的博客 111

可视化大屏系列(5):设备状态面板与数据分析仪表盘

在这篇文章中,我们将重点讨论如何通过智能化手段提升工地设备的管理效率与维护质量。随着智能工地系统的不断发展,设备监控与维护管理变得尤为重要。本篇将从 设备状态实时监控、自动化维护提醒、设备管理与维修记录 三个方面入手,展示如何通过 Vue3 和 ECharts 构建一个智能化的设备管理平台,实时采集和展示设备运行状态、及时生成维护提醒并记录维修历史,以提高设备的使用效率与安全性。我们还将结合实际代码示例,详细讲解如何实现这些功能,帮助你在智能工地项目中实现设备管理的智能化、数字化和自动化。

一名热衷于技术的全栈开发者,专注于前端与后端的全面技术探索。在这里,我将分享我在技术领域的学习与成长,助力更多开发者的进步。 3364

tensorflow2之模型加载恢复(h5)

使用new_model = tf.keras.models.load_model('my_model.h5') 创建一个与 my_model相同的模型并加载权重测试。 创建model_hand_h5_load.py #encoding=utf-8 # 手动创建和加载 *.h5 模型和权重值 from __future__ import absolute_import, division...

v7xyy的博客 9599

openclaw通俗入门系列6——记忆系统

记忆 = 智能体的笔记本,分长期(MEMORY.md)和每日(memory/日期.md)。只有写到文件里的才能记住!支持语义搜索(理解意思)+ 关键词搜索,还能自动在压缩前保存重要内容。

m0_60605453的博客 403

tensorflow保存、加载模型并预测数据

保存模型(ckpt) 仅需两行即可保存模型 saver = tf.train.Saver(tf.global_variables(), max_to_keep= 5) #第二个参数填任意数字(用于区别各个保存的模型) path = saver.save(sess, '../model/textCNN/model/my-model',global_step = currentStep) 注...

Jaykie 3646

【100%通过率】2023华为od机试C卷【螺旋数组矩阵】C++ 实现

给出数字个数n和行数m(1 < n,m < 999),从左上角的1开始,按照顺时针螺旋向内写方式,依次写出2,3...n,最终形成个一m行矩阵。疫情期间,小明隔离在家,百无聊赖,在纸上写数字玩。输入一行,两个整数,空格隔开,依次表示n、m。4.数字不够时,使用单个*号占位。3.填充数字时优先填充外部。1:模拟整个过程打印即可。1.每行数字的个数一样多。小明对这个矩阵有些要求。2.列的数量尽可能少。

MISAYAONE的博客 1247

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

上一篇: 深度学习PyTorch,TensorFlow中GPU利用率较低,使用率周期性变化的问题
下一篇: tensorflow 获取checkpoint中的变量列表
wzg2016
博客等级 码龄10年 539粉丝 493原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值