【BLIP】VLP任务的新框架

多模态 CLIP/BLIP/BLIP-2论文理论知识总结 CLIP是BLIP的前身,或者说是一个很高水平的基础, 视频听下来最深的印象就是论文团队对于这个大模型的训练用了从网上爬下来的4亿个图像文本对,真是钞能力啊~CLIP通过4亿的数据来学习图像和文本之间的对应关系,实现了扩模态的语义理解,适用于很多扩模态的任务,就比如文生图、利用图像反推其文本tag等,更详细的知识点看视频,我这里就自己总结一下,给自己留个可以快速review的地方。论文的篇幅页数很多,但重要的内容主要就在前面15页左右,再往后都是很多实验的分析啥的。,使用对比损失函数来训练; 阅读详情


✨✨ 欢迎大家来访Srlua的博文(づ ̄3 ̄)づ╭❤~✨✨

🌟🌟 欢迎各位亲爱的读者,感谢你们抽出宝贵的时间来阅读我的文章。

我是Srlua小谢,在这里我会分享我的知识和经验。🎥

希望在这里,我们能一起探索IT世界的奥妙,提升我们的技能。🔮

记得先点赞👍后阅读哦~ 👏👏

📘📚 所属专栏:传知代码论文复现

欢迎访问我的主页:Srlua小谢 获取更多信息和资源。✨✨🌙🌙

​​

​​

目录

概述

模型结构

预训练目标函数

CapFilt

演示效果

核心逻辑

部署方式

参考文献


 本文所有资源均可在该地址处获取。

概述

  视觉语言预训练(VLP)提高了许多视觉语言任务的性能。然而,大多数现有的预训练任务只擅长基于理解的任务或者基于生成的任务。此外,同时使用Web收集的有噪声的图像-文本对来扩展数据集虽然在很大程度上提高了性能,但这是一个次优的监督来源。
  BLIP是一个新的VLP框架,它可以灵活的转移到视觉语言理解和生成任务。BLIP通过引导字幕有效地利用了有噪声的网络数据,其中字幕生成器生成合成字幕,滤波器去除有噪声的字幕。

模型结构
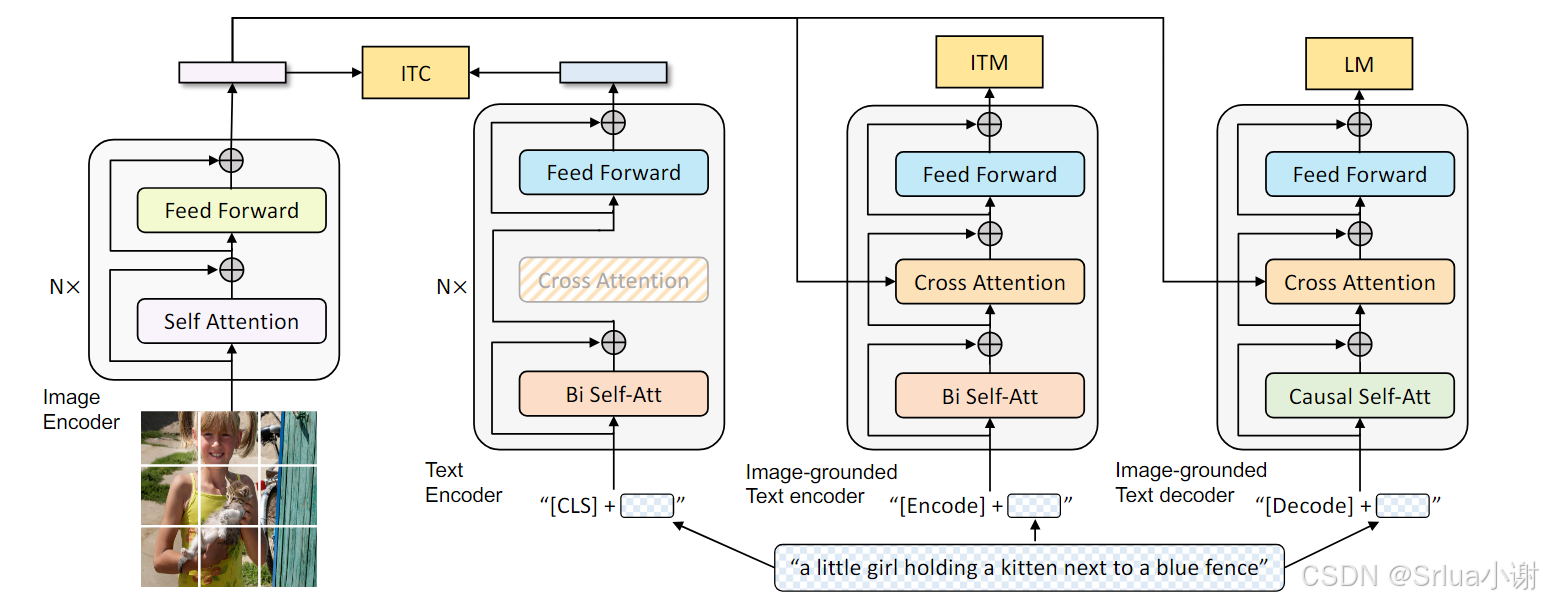

         图中颜色一样的结构参数共享
  BLIP使用ViT模型作为图像编码器,ViT将输入图像划分为补丁块,并将其编码为嵌入序列,使用额外的[cls]标记来表示全局图像特征。为了预训练具有理解和生成能力的统一模型,BLIP提出了编码器-解码器的多模式混合(MED),这是一种可以在一下三种功能之一运行的多任务模型:

单峰编码器
单峰式编码器分别对图像和文本进行编码,文本编码器与BERT相同,其中[CLS]标记被附加到文本输入的开头,以总结句子。BLIP使用图像-文本对比(ITC)损失的训练单峰编码器,以对齐视觉和语言表示。

基于图像的文本编码器
基于图像的文本编码器,同时在文本编码器的每个transformer块的自注意力层SA和前馈网络FFN之间插入一个额外的交叉注意力层CA来注入视觉信息。特定于任务的[Encode]标记附加到文本中,[Encode]的输出嵌入用于图像-文本对的多模态表示。基于图像的文本编码器使用图像-文本匹配(ITM)损失进行训练,以区分匹配和不匹配的图像-文本对。

基于图像的文本解码器
基于图像的文本解码器以因果自注意力层取代双向自注意力层,一个[Decode]标记用于表示序列的开始,一个序列结束标记用于表示序列的结束。基于图像的文本解码器使用语言建模(LM)损失进行训练,以生成给定图像的标题。

预训练目标函数
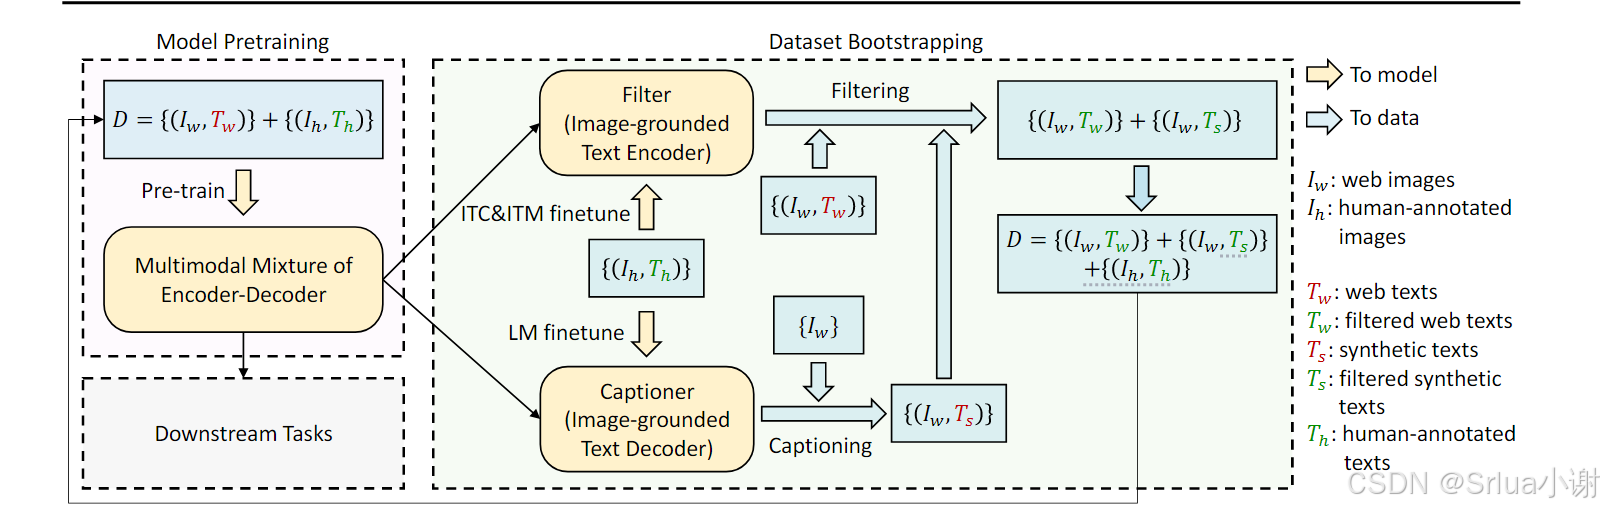
  BLIP在预训练中共同优化了三个目标函数,两个基于理解的目标函数和一个基于生成的目标函数。每个图像-文本对只需要通过计算量较大的ViT进行一次前向传递,并通过文本转换器进行三次前向传递,用以激活不同的功能以计算如下所述的三种损失。

  • 图像-文本对比损失(ITC)
    图像-文本对比损失激活单峰编码器,它的目的是通过鼓励匹配的图像-文本对具有相似的表示,不匹配的图像-文本对具有差异较大的表示来对齐视觉转换器和文本转换器的特征空间。

  • 图像-文本匹配损失(ITM)
    图像-文本匹配损失激活基于图像的文本编码器,它旨在学习图像-文本多模态表示,以捕获视觉和语言之间的细粒度对齐。ITM是一个二元分类任务,模型使用ITM头部(线性层)来预测给定图像-文本对的多模态特征是匹配的,还是负的不匹配的。

  • 语言建模损失(LM)
    语言建模损失激活基于图像的文本解码器,其目的是生成给定图像的文本描述。该损失训练模型以自回归的方式最大化文本的可能性,优化了交叉熵损失

  为了在利用多任务学习的同时执行有效的预训练,文本编码器和文本解码器共享除了自注意力层之外的所有参数,因为编码和解码任务之间的差异最好由自注意力层捕获。编码和解码任务之间的嵌入层,自注意力层和全连接前馈网络层的作用相似,因此,共享这些层可以提高训练效率,同时受益于多任务学习。

CapFilt
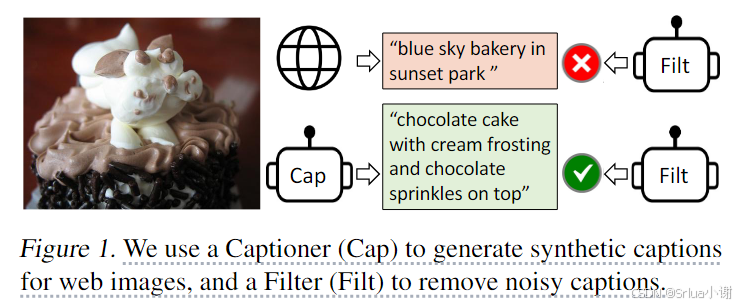

  由于标注成本过高,高质量的人工标注图像-文本对的数量有限{(Ih,Th)}{(Ih​,Th​)},最近的工作使用了大量从网络上搜取的图像和替代文本对{(Iw,Tw)}{(Iw​,Tw​)}。然而,替代文本通常不能准确的描述图像的视觉内容,使他们成为一个嘈杂的信号,对于学习视觉对齐来说是次优的。

  BLIP提出了Captioning 和Filtering(CapFilt),这是一种提高文本语料库质量的新方法,它引入了两个模块,一个用于生成给定web图像的标题的captioner,以及一个用于去除图像-文本对噪声的filter。captioner和filter都是从相同的预训练的MED模型初始化的,并在COCO数据集上分别进行微调,调优是一个轻量级的过程。

  具体来说,captioner是一个基于图像的文本解码器,它使用LM目标函数进行微调,以解码给定图像的文本。给定web图像IwIw​,captioner生成合成的标题TsTs​。filter是一个基于图像的文本编码器,它使用ITC和ITM目标函数进行微调,以确定文本是否与图像匹配。如果标题预测文本与图像不匹配,则认为文本有噪声,过滤器去除原始网络文本和合成文本中的噪声文本。最后,BLIP将过滤后的图像文本对于人工注释的图像文本对结合起来形成一个新的数据集,使用它来训练一个新的模型。

演示效果

BLIP对整个图像的关注程度可视化
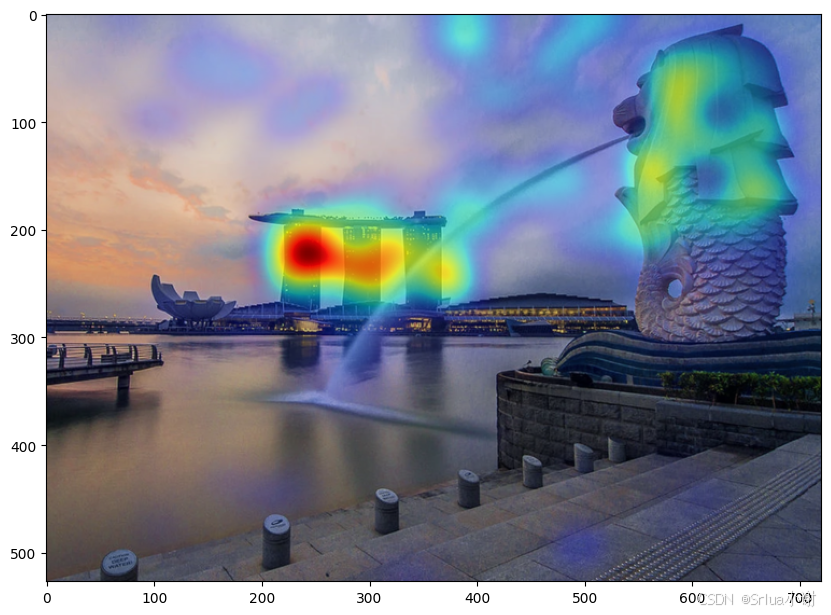

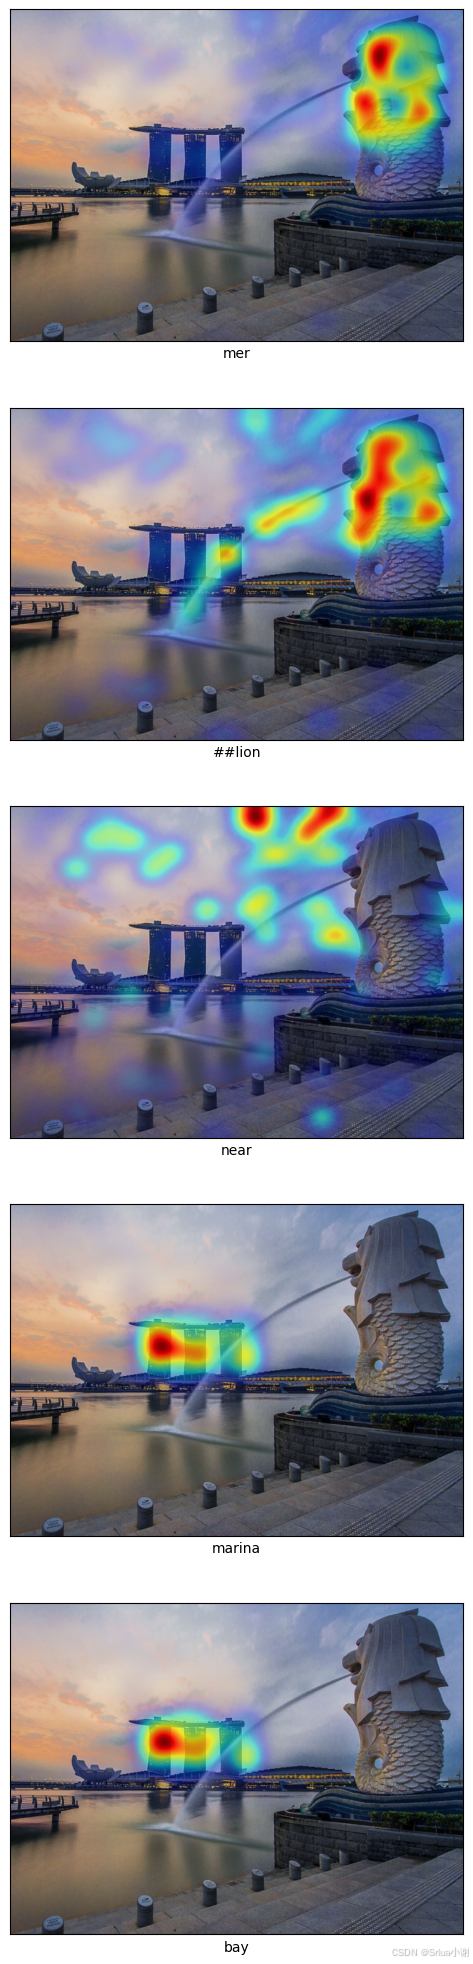
BLIP对局部分词的关注程度

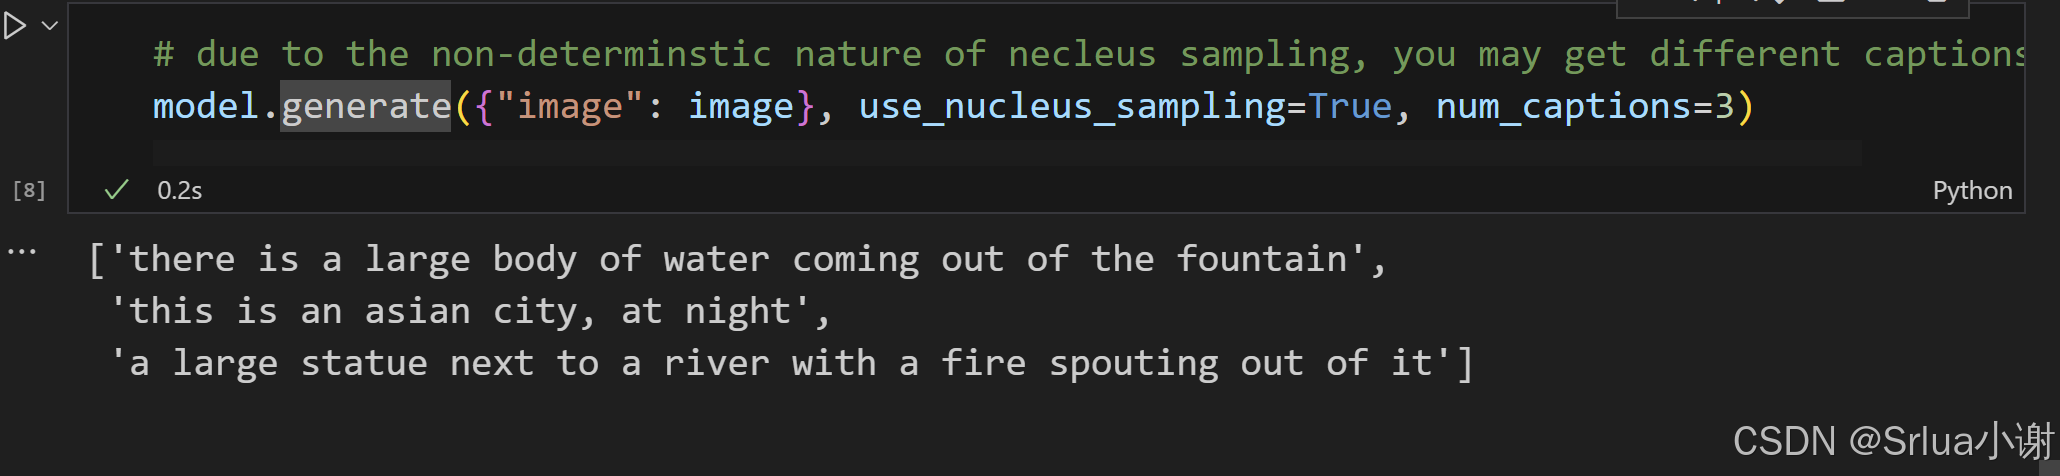
BLIP生成多个标题
核心逻辑

在这里可以粘贴您的核心代码逻辑:
BLIP生成标题

# 加载预训练好的模型
model, vis_processors, _ = load_model_and_preprocess(
    name="blip_caption", model_type="large_coco", is_eval=True, device=device
)
# 以下是其他可以使用的模型
# model, vis_processors, _ = load_model_and_preprocess(
#     name="blip_caption", model_type="base_coco", is_eval=True, device=device
# )

# 对图像进行预处理操作
image = vis_processors["eval"](raw_image).unsqueeze(0).to(device)

# 采用核函数采样生成多个标题
model.generate({"image": image}, use_nucleus_sampling=True, num_captions=3)

BLIP可视化

# 加载预训练模型
# model, vis_processors, text_processors = load_model_and_preprocess("blip_image_text_matching", "base", device=device, is_eval=True)
model, vis_processors, text_processors = load_model_and_preprocess("blip_image_text_matching", "large", device=device, is_eval=True)

# 准备操作
from matplotlib import pyplot as plt
from lavis.common.gradcam import getAttMap
from lavis.models.blip_models.blip_image_text_matching import compute_gradcam
import numpy as np

dst_w = 720
w, h = raw_image.size
scaling_factor = dst_w / w

resized_img = raw_image.resize((int(w * scaling_factor), int(h * scaling_factor)))
norm_img = np.float32(resized_img) / 255

# 分别处理图像和文本
img = vis_processors["eval"](raw_image).unsqueeze(0).to(device)
txt = text_processors["eval"](caption)

# 计算梯度
txt_tokens = model.tokenizer(txt, return_tensors="pt").to(device)
gradcam, _ = compute_gradcam(model, img, txt, txt_tokens, block_num=7)

# 计算整个图像的梯度并且可视化
avg_gradcam = getAttMap(norm_img, gradcam[0][1].numpy(), blur=True)
# fig, ax = plt.subplots(num_image, 1, figsize=(15,5*num_image))
fig, ax = plt.subplots(1, 1, figsize=(10, 10))
ax.imshow(avg_gradcam)

# 计算每一个token的梯度并且可视化
num_image = len(txt_tokens.input_ids[0]) - 2
fig, ax = plt.subplots(num_image, 1, figsize=(15, 5 * num_image))

gradcam_iter = iter(gradcam[0][2:-1].numpy())
token_id_iter = iter(txt_tokens.input_ids[0][1:-1])

for i, (gradcam, token_id) in enumerate(zip(gradcam_iter, token_id_iter)):
    word = model.tokenizer.decode([token_id])
    gradcam_image = getAttMap(norm_img, gradcam, blur=True)
    ax[i].imshow(gradcam_image)
    ax[i].set_yticks([])
    ax[i].set_xticks([])
    ax[i].set_xlabel(word)
    

部署方式

# 创建环境
conda create -n lavis python=3.8
conda activate lavis
pip install salesforce-lavis
# 进阶版包含源码
git clone https://github.com/salesforce/LAVIS.git
cd LAVIS
pip install -e .

参考文献

论文地址
github地址

​​

BLIP:统一视觉语言理解与生成的预训练模型 BLIP:统一视觉语言理解与生成的预训练模型 Blip: Bootstrapping language-image pre-training for unified vision-language understanding and generation 阅读详情

相关推荐

BLIP 系列论文(BLIP、BLIP-2、InstructBLIP)

多模态经典论文 BLIP 系列文章

weixin_47089544的博客 1544

BLIP:Bootstrapping Language-Image复现

BLIP复现过程

qq_40905284的博客 1245

大模型面经 | 介绍一下CLIP和BLIP

大模型面经 | 介绍一下CLIP和BLIP

皮先生的博客 1347

BLIP原理解读和使用

以往的预训练模型仅在基于理解的任务或者基于生成的任务方面表现出色,很少有可以兼顾的模型。比如,基于编码器的模型,像 CLIP,ALBEF 不能直接转移到文本生成任务 (比如图像字幕),而基于编码器-解码器的模型,像 SimVLM 不能直接用于图像文本检索任务。图像文本的对比学习:下图前两列。最左边的是图像编码器,将输入图像分割成一个个的 Patch 并将它们编码为一系列 Image Embedding。

JimmyGoong的博客 3802

大模型-BLIP 详细介绍

知识蒸馏是一种模型压缩技术,通过从一个大型的“教师”模型中提取知识来训练一个小型的“学生”模型。教师模型通常具有更高的性能,但计算成本较高,而学生模型则更轻量级,适合部署在资源受限的环境中。

晓的博客 1635

多模态大模型系列论文(ALBEF、BLIP、BLIP-2)

1)当前 视觉-语言 预训练(VLP)推动了 视觉语言预训练任务的性能,然而大多数现有的预训练模型或者擅长基于理解的任务(分类)或者基于生成的任务之一。利用动量蒸馏的方式,模型将不在惩罚模型合理的输出,即使这个输出与网络标签不一致,提升从网络噪声数据中学习的能力。2)训练多模模型,利用到了互联网上爬取的数据,这些数据中往往存在大量噪声,传统的图文特征融合训练模式(如 MLM, masked language modeling) 可能过拟合到噪声文本上,从而影响模型的泛化性能。

Yafee的专栏 3696

⌈ 传知代码 ⌋ 【BLIP】VLP任务的新框架

视觉语言预训练(VLP)提高了许多视觉语言任务的性能。然而,大多数现有的预训练任务只擅长基于理解的任务或者基于生成的任务。此外,同时使用Web收集的有噪声的图像-文本对来扩展数据集虽然在很大程度上提高了性能,但这是一个次优的监督来源。BLIP是一个新的VLP框架,它可以灵活的转移到视觉语言理解和生成任务。BLIP通过引导字幕有效地利用了有噪声的网络数据,其中字幕生成器生成合成字幕,滤波器去除有噪声的字幕。模型结构。

Dream_Y.ocean的博客 993

clip和blip的区别

CLIP侧重于学习视觉-语言对齐,适用于图像分类、检索等任务。BLIP在CLIP的基础上,增强了生成能力,能够生成高质量图像描述,应用范围更广。BLIP通过CapFilt模块降低了训练数据噪声,提高了数据质量。新的BLIP-2模型进一步降低了训练成本,通过复用CLIP视觉编码器和大型语言模型实现了强大的视觉-语言理解和生成能力。

具身机器人和通用AI 4165

【传知代码】BLIP - VLP任务的新框架(论文复现)

视觉语言预训练(VLP)显著提升了众多视觉语言任务的执行效果。其中,对图像和文本进行分类是一种重要的预训练任务。尽管如此,目前大部分的预训练任务主要集中在基于理解或基于生成的任务上。这些预训练方法都没有考虑到用户对输入的反馈和交互。尽管利用Web收集的带有噪声的图像-文本对来扩充数据集在很大程度上增强了其性能,但这种方法仍然是一个不太理想的监控来源。BLIP代表了一种创新的VLP架构,它能够灵活地应用于视觉语言的理解和生成任务中,在视频解码系统中,字幕的处理非常重要。

ztK63LrD的博客 1197

VLM 系列——BLIP——论文解读

BLIP是一个多模态视觉-文本大语言模型,隶属BLIP系列第一篇,可以完成:图像描述、视觉问答、图像检索。由于没有接入LLM,所以虽然可以做生成任务,但是没有很强的对话能力以及世界知识。主要是模型和数据两方面创新:模型方面:把模型设计成了一个unified 框架,可以同时满足:图文检索和图像描述任务。主要有三部分构成:视觉编码器、文本编码器和多模态编码器。数据方面:提出了一个Captioner和Filter 模块,Captioner对一张图生成描述(也就是图文对的文)、filter过滤噪声图文对。用这种数据

TigerZ*的博客 967

ADI DSP开发环境(CCES)下的程序烧录问题(以ADSP-SC589为例)

在CCES环境下将程序烧录到flash主要有两种方式。首先在对项目编译产生文件的属性设置为Release。 在编译完成后,找到每个CORE单独生成的DXE文件: 文件通常位于项目目录下每个core的Release文件中。安装SC589评估板的驱动(ADSP-SC5xx_EZ-KIT_Lite-Rel2.0.0.exe)后,在安装目录下可以找到SPI FLASH芯片的驱动程序(sc589_w25q128fv_dpia_Core1.dxe): 把文件copy到CCES 的目录下由于SC58x处理器的特殊性

daijingxin的博客 3731

【论文阅读笔记】BLIP: Bootstrapping Language-Image Pre-training for Unified Vision-Language Understanding...

BLIP是一种基于VLP的新框架,统一并灵活地应用于视觉-语言理解任务和生成任务。BLIP通过引导生成图像描述来有效利用噪声网络数据,从而在多个下游任务上取得了最先进的性能。

qq_40432278的博客 1075

格(Lattice)基础(一)

有关格的基础概念,和相关的格难题

Amire0x的小乐园 5709

BLIP和BLIP2 论文讲解

通过将Q-Former的输出连接到一个冻结的LLM来执行视觉到语言的生成学习,并训练Q-Former,使其输出的视觉表示可以被LLM解释。ITM是一个二元分类任务,其中模型使用ITM头(线性层)来预测给定图像-文本对的多模态特征是正的(匹配的)还是负的(不匹配的)。它的目的是通过鼓励positive的图像-文本具有相似的表示 (相反,使得negtive的图像文本队具有不同的表示) 来。它们作为软视觉提示(,我们将QFormer (包括冻结图像编码器) 连接到冻结的LLM,以获取LLM的生成语言能力。

zyw2002的博客 3560

从零到一:用MSC Nastran Patran搞定悬臂翼颤振分析(附完整模型文件)

本文详细介绍了使用MSC Nastran和Patran进行悬臂翼颤振分析的完整流程,从几何建模、网格划分到模态分析和颤振求解。通过具体案例讲解关键参数设置和操作技巧,帮助工程师掌握气动弹性分析的核心方法,并附赠完整模型文件供实践参考。

weixin_42563415的博客 448

Windows Server2012 R2 无法安装.NET Framework 3.5的解决方法,导致Sql server 2012 和2008 数据库无法正常安装*

Windows Server2012 R2 无法安装.NET Framework 3.5的解决方法,导致Sql server 2012 和2008 数据库无法正常安装 Windows server 2012R2系统自带.net4.0/4.5,想安装Sql 2012和2008,则必须安装.net 3.5/2.0版本,现无法安装数据库问题如下问题: 如果上诉图片提示安装依然失败如下所示: 解决方案(win 2012 R2 系统无法安装.net3.5) 下载服务器系统(Win 2012R2 镜像文

d37162358的博客 3379

【多模态】5、BLIP | 统一理解与生成任务 为图像生成更高质量的文本描述

本文主要介绍 BLIP 模型

呆呆的猫的博客 3280

国科大《人工智能原理与算法》2021年期末试题+2024经验(2025指南)

2021年期末试题+24年复习指南

MatsumotoChrikk 2933

BLIP3

BLIP 作为一种新的 VLP 框架可以灵活地在视觉理解任务上和生成任务上面迁移,并且提出了一种高效率利用噪声网络数据的方法。BLIP 是一种多模态 Transformer 模型,主要针对以往的视觉语言训练 (Vision-Language Pre-training, VLP) 框架的两个常见问题:大多数现有的预训练模型仅在基于理解的任务或者基于生成的任务方面表现出色,很少有可以兼顾的模型。大多数现有的预训练模型为了提高性能,使用从网络收集的嘈杂图像-文本对扩展数据集。 whaosoft aiot htt

whaosoft143ai的博客 1083

Docker安装并运行AnythingLLM的详细教程

通过本文的介绍,你已经掌握了如何在 CentOS 系统上使用 Docker 安装并运行 AnythingLLM。AnythingLLM 提供了强大的功能,支持本地知识库搭建和多模态输入,非常适合个人和企业使用。希望本文能帮助你快速上手并搭建自己的 AI 知识库。

加入“Super Entity”,与全能开发团队共探AI智能体与数字人项目,开启前沿技术之旅。 5866

使用R语言实战:构建Logistic回归模型

Logistic回归是一种基于概率的分类算法,它用于预测离散的结果变量(也称为响应变量或因变量)。与线性回归不同,Logistic回归的输出是一个概率值,通常在0和1之间。这使得它非常适合处理二分类问题。市场营销:预测客户是否会购买某个产品。医学研究:预测疾病的发生与否。信用风险评估:预测个人申请贷款的违约风险。社会科学:预测个人对某个政策的态度。

2301_79331230的博客 1141

BLIP和BLIP2解析

BLIP与BLIP-2是多模态视觉语言预训练模型,旨在解决视觉与语言对齐问题。BLIP通过统一编码器-解码器架构实现图文理解与生成,但存在端到端训练成本高的问题。BLIP-2引入轻量级Q-Former作为桥梁,采用两阶段训练策略:第一阶段通过对比学习、匹配任务和文本生成任务训练Q-Former提取关键视觉特征;第二阶段将Q-Former输出适配到冻结的大型语言模型(LLM),实现高效的多模态推理。该方案显著降低了训练成本,同时保持优异性能,支持多种LLM架构适配。核心创新在于Q-Former的设计,能有效对

A1233242的博客 1204

界面材料知识

界面材料(TIM)用于芯片和散热器之间的导热作用,将低导热系数的空气(空气的导热系数(0.026 W /M·K))排除,换成高导热系数,低热阻导热系数的材料。具体的:TIM1为芯片DIE和芯片保护壳之间的界面材料,一般是直接焊接的方式,比如使用铟片,有很高的导热系数;芯片厂工程师主要找的是TIM1界面材料。TIM1.5为芯片Die和散热器之间的界面材料,比较少见;TIM2为我们所常见的界面材料,用于芯片外壳和散热器之间。(图片来源网上)

YY_Share的博客 1854

BLIP论文笔记

视觉-语言预训练(VLP)已经提升了许多视觉-语言任务的性能。然而,大多数现有的预训练模型只在理解类任务或生成类任务中表现出色。此外,性能提升主要通过扩大从网络收集的噪声图像-文本对数据集来实现,这是一个次优的监督来源。在本文中,我们提出了BLIP,一个新的VLP框架,可以灵活地迁移到视觉-语言理解和生成任务。BLIP通过自举标题的方式有效利用噪声网络数据,其中标题生成器生成合成标题,过滤器移除噪声标题。

qq_73553710的博客 1136

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

贝叶斯统计 [韦来生编]

贝叶斯(Bayes)统计是近几十年来迅速发展起来的数理统计的一个重要分支。贝叶斯方法与经典统计方法的主要不同之处是进行统计推断时除了利用样本信息外,还要利用参数的先验信息,因此可以提高统计推断或统计决策的效果。它在经济、金融、生物、医学、自然科学和社会科学等许多领域具有广泛的应用。贝叶斯方法的研究已渗透到了统计学的几乎所有领域。作者在给中国科学技术大学概率论与数理统计专业本科生开设的“数理统计”课程中有一章专门讲授“贝叶斯方法和统计决策理论”,近十年来也给中国科学技术大学概率统计专业研究生开设过几次“贝叶斯分析”课。本书是在对过去讲稿的内容作了适当的增减和调整的基础上完成的。  本书共分六章。第1章是绪论,介绍了贝叶斯统计的若干基本概念,同时对必要的数理统计的基础知识有重点地作了回顾。第二章介绍了确定先验分布的若干可供选择的方法。第三章介绍了几类常见统计模型参数的后验分布的主要结果和计算方法。第四章和第五章分别介绍了“贝叶斯统计推断”和“贝叶斯统计决策”的内容。第六章介绍了贝叶斯统计计算的若干方法,包括蒙特卡洛方法和马尔可夫链蒙特卡洛(MCMC)方法以及相关统计软件的简介。本书的每一章附右大量的例题和习题,书末附有常用的几个表格和部分习题解答供读者查用。  大约可在54学时内讲授本书的第1章至第六章的主要内容,教师可根据学时需要选讲本书第1章至第六章的部分内容。书中标“*”号的章节可略去不讲,留给读者作为阅读材料。第六章例题中的R代码和部分例题的数据文件等可从作者个人主页下载。  作者在编写本书的过程中参考了J.O.Berger教授的《统计决策论及贝叶斯分析》和茆诗松教授编写的《贝叶斯统计》等书中的一些内容,以及《贝叶斯分析》一书中由张伟平博士编写的有关贝叶斯统计计算的一些内容。在此表示衷心感谢。  本书编写准备过程中,中国科学技术大学统计与金融系的几个研究生帮助完成了本书部分中文的录入和排版,作者对他们的辛勤工作表示真诚的感谢。高等教育出版社为本书的出版给予了大力支持。在此一并致谢。

BLIP和BLIP2

文章主要是对BLIP2 (使用冻结图像编码器和大型语言模型的Bootstrapping语言图像预训练)论文的阅读笔记,也对BLIP(用于统一视觉语言理解和生成的Bootstrapping语言图像预训练)算法进行了简单的介绍。

pan的博客 5882

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

BLIP-2小结

引用量:376(截止2023-09)

weixin_40779727的博客 1837
上一篇: 无监督目标检测最新CVPR解读
下一篇: 基于曲率的图重新布线
Srlua小谢
Srlua小谢 优质创作者: 编程框架技术领域 优质创作者: 编程框架技术领域
博客等级 码龄4年 8963粉丝 332原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
