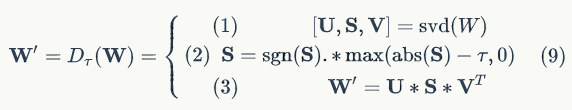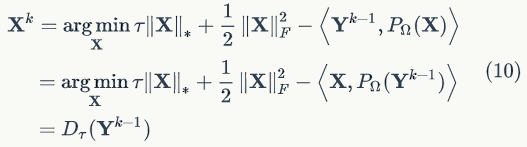矩阵完备和张量完备

图像恢复之低秩矩阵 最近在研读图像恢复相关论文中,对于利用图像低秩特性进行噪声信息建模进行了学习,以下是一些总结 低秩矩阵恢复原理及意义概述1.背景知识秩低秩矩阵2.低秩(Low-rank)的意义 概述 低秩矩阵恢复(LRMR)广泛用于图像处理中的图像恢复,比如去噪、去模糊等。一幅清晰的自然图像其数据矩阵往往是低秩或者近似低秩的,这是因为其中的图像信息就有很大的相关性,但如果图像中引入噪声,那么存在随机幅值任意大但是... 阅读详情

斜风细雨作小寒,淡烟疏柳媚晴滩。入淮清洛渐漫漫。
雪沫乳花浮午盏,蓼茸蒿笋试春盘。人间有味是清欢。
---- 苏轼

低秩矩阵恢复是稀疏向量恢复的拓展,二者具有很多可以类比的性质。首先,稀疏是相对于向量而言,稀疏性体现在待恢复向量中非零元素的数量远小于向量长度;而低秩是相对于矩阵而言,低秩体现在矩阵的秩远小于矩阵的实际尺寸。其次,稀疏向量恢复问题可以转化为基于 ℓ1范数是 ℓu 的最佳凸包络;而矩阵的核范数在一定条件下也是矩阵秩的最佳凸近似,因此,也可以利用这一性质将低秩矩阵恢复问题松弛为一个凸问题来求解。本文重点介绍低秩矩阵恢复的一些常用算法,并给出了奇异值阈值(STV)算法用于低秩矩阵恢复的仿真分析。

1. 低秩矩阵恢复问题背景


随着5G技术和物联网 (loT) 技术的发展,作为5G三大应用场景之一的大规模机器类通信 (MTC) 将使“万物互联”成为现实。大规模机器类通信的部署势必导致海量数据的产生,而实时、精确地处理这些大规模数据对传统的信息处理技术带来了挑战。由于数据维度的上升,在信号处理、图像处理、计算机视觉、机器学习和数据挖掘等领域,所需处理的数据量呈几何级数增长,面对海量的数据,很多传统的信号处理技术已不堪重负,无法适应于未来爆炸式增长的数据环境,因此急需开发更加先进的信号处理技术。

随着数据维度的增加,高维数据之间往往存在较多的相关性和冗余度,而且数据本身信息量的增长比数据维度的增长通常要慢得多。例如,视频信号的可压缩空间比单幅图像的可压缩空间大得多。一幅自然图片经过小波变换之后,只有少量的系数在数值大小上是相对显著的。如果将一幅图片当成一个像素矩阵,对其进行奇异值分解后,其前10%奇异值包含的信息量往往占了整幅图像的90%。这些实例都说明在高维数据中,往往存在不同程度的相关性,利用这些相关性可以大幅减小数据的存储空间和处理复杂度。

此外,现实生活中的大规模数据常常会有部分数据缺失、数据误差、损坏等问题,这将进一步加大数据处理和分析难度。这种现在在实际生活中很常见,例如在人脸识别中,训练集中的或是待识别的人脸图像往往含有阴影、高光、遮挡、变形等;在运动恢复结构(Structure from motion,SFM)问题中,进行特征提取和特征匹配时往往存在大的匹配误差. 这些因素的存在使得很多传统的分析和处理方式失效, 需要新的理论和实用的算法为相关的应用提供理论支撑和有力的求解工具.正确并高效地从不完整的、带有损毁的数据中 恢复和利用它们, 对现代大规模数据的分析与处理至关重要。

假定原始数据矩阵是低秩的,但是矩阵中含有很多未知的元素。从一个不完整的矩阵中恢复出一个完整的低秩阵,便是低秩矩阵填充问题。例如,著名的Netflix问题便是一个典型的低秩矩阵填充问题。Netflix是美国的一家影片租赁公司,其推荐系统(recommendation system)要从用户仅有的对少数的电影打分中为用户推荐影片,如果这种推荐越符合用户的喜好,也就越能提高该公司租赁电影的业务,为此,该公司设立了百万美元的奖金用于悬赏能够最好地提高该公司推荐系统质量的解决方法。这个问题可以用矩阵填充来进行建假设矩阵的每一行分别代表同一用户对不同电影的打分, 每一列代表不同用户对同一电影的打分,用户数量巨大, 电影数目巨大,因此这个矩阵的维度十分大。由于用户所打分的电影有限,这个矩阵中只有很小一部分的元素值已知,而且可能含有噪声或误差,那么Netflix问题就是如何从这个不完整的矩阵中推测其中未知元素的值。矩阵填充的越准确,为用户推荐的电影也就越符合用户的喜好。

2. 低秩矩阵补全
 

矩阵补全是推荐系统、计算机视觉、图像处理等领域经常遇到的问题,具有很高的研究价值。矩阵补全问题旨在通过真实未知矩阵 \large M的部分观测 \large M_{ij}, (i,j)\epsilon \Omega  来估计\large M中未观测到的其他元素。如果不加其他约束,这样的问题是完全不可解的。但是,如果数据矩阵具有一些特殊的性质,这些特殊的性质将使得矩阵补全问题成为可能。低秩性就是这样的性质。如果事先知道矩阵 \large M 是低秩的,那么矩阵补全问题可以形式为为如下优化问题:

其中\large M 为观测样本下标的集合,\large X为优化变量,\large M 为真实的未知矩阵。定义投影算子 \large P_{\Omega } :
KaTeX parse error: Unknown column alignment: * at position 73: …{\begin{array}{*̲{20}{c}} {{{…

从而(1)式可以简洁地表述为:

显然,上述问题是一个NP-hard问题,且其复杂度随矩阵维度的增城呈平方倍指数关系增长。为了求解问题(1),有学者对其进行凸松弛,转化为一个凸优化问题:

文献[2]中指出:问题(4)的解在满足强非相干性条件下,很大概率等价于问题(1)的解。在某种意义上,这是NP-难秩最小化问题的紧凸松弛。因为核范数球是谱范数为1的rank one矩阵集合的凸包。具体定理及证明参见文献[1]。
对于(4)中的优化问题,当采样点数满足\large m\geqslant Cn^{6/5}rlog n 时,\large M 能以很大概率求得精确解,其中 \large r 为矩阵 \large M 的秩,\large C为一个正常数。

求解(4)式可以使用一些凸松弛方法,比如半定规划法,然而半定规划法通常使用内点法来求解,其求解上述问题的算法复杂度为\large O(p(m+n)^{3}+p^{2}(m+n)^{2}+p^{3})可以通过matlab软件包CVX等来求解。

 3. 奇异值阈值算法(SVT)

 2009年,Cai Jian-feng 和 Candes(e上面有个四声符号)等人提出了求解核范数最小化问题的奇异值阈值算法(Singular Value Thresholding, SVT)。该算法可以类比为求解向量 ℓ0范数最小化的软阈值迭代算法。 SVT算法先将最优化问题(4)正则化,即有:


 其中,\large \tau > 0。当 $\tau \to + \infty $ 时,上述最优化问题的最优解收敛到(4)式的最优解。构造最优化问题(5)的拉格朗日函数:
 

其中,拉格朗日乘子 Y\in \mathbb{R}^{m\times n}。如果 \large (X^{\ast },Y^{\ast })为优化问题(4)的原-对偶问题的最优解,则有:

 SVT算法使用交替迭代方法求解优化问题(4),其迭代格式可以简单表述如下:
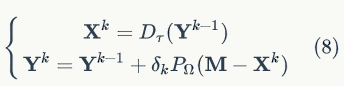
 其中 D_{\tau }(W)为奇异值阈值软阈值操作类似,不过这里的对象是矩阵。可以具体描述为:

其中(8)式中的第一步是这样来的,初始化Y^{0}=0,当Y^{k-1} 固定时:

 (8)式中的第(2)式,当 X^{k}给定时,用梯度下降来更新 Y。

4. 仿真

SVT算法的matlab代码如下:

function [ X,iterations ] = SVT(M,P,T,delta,itermax,tol)
%Single value thresholding algorithm,SVT
% function:solve the following optimization problem
%                  min  ||X||*
%               s.t. P(X-M) = 0
% X: recovered matrix
% M: observed matrix
% T: single value threshold
% delta: step size
% output:X,iterations

% initialization
Y = zeros(size(M));
iterations = 0;

if nargin < 3
    T =  sqrt(n1*n2);
end
if nargin < 4
    delta = 1;
end
if nargin < 5
    itermax = 200 ;
end
if nargin < 6
    tol = 1e-7;
end

for ii = 1:itermax
    % singular value threshold operation
    [U, S, V] = svd(Y, 'econ') ;
    S = sign(S) .* max(abs(S) - T, 0) ;
    X = U*S*V' ;
    % update auxiliary matrix Y
    Y = Y + delta* P.* (M-X);
    Y = P.*Y ;
    % computer error
    error= norm( P.* (M-X),'fro' )/norm( P.* M,'fro' );
    if error<tol
        break;
    end
    % update iterations
    iterations = ii ;
end
end
数值验证代码为如下:
% Numerical verification for SVT algorithm
clear
clc

r = 2 ; % rank(M) = 2 ;
n1 = 200 ; % row length of M
n2 = 300 ; % column length of M
sample_rate = 0.5 ; 
% real
% M = rand(n1,r)*rand(r,n2) ;
% complex
M = (rand(n1,r)+1i*rand(n1,r))*(rand(r,n2)+1i*rand(r,n2))/2 ;

% construct index matrix
P = zeros(n1*n2,1) ;  
MM = reshape(M,n1*n2,1) ;
pos = sort(randperm(n1*n2,n1*n2*sample_rate))' ;
P(pos) = MM(pos) ;
index1 = find(P) ;
P(index1) = 1 ;
P = reshape(P,n1,n2) ;

% set threshold & step size
T = sqrt(n1*n2); 
delta = 2 ;

[ X,iterations ] = SVT(M,P,T,delta) ;

% norm(P.*(X-M),'fro')
norm(P.*(X-M),'fro')/norm(P.*M,'fro')

% norm(X-M,'fro')
% norm(X-M,'fro')/norm(M,'fro')


(最优化理论与方法)第一章最优化简介-第二节:最优化典型实例之稀疏优化和低秩矩阵恢复 稀疏优化:原始信号中绝大多数元素为0,在某种线性约束条件下,求一个使决策变量使其非零元素个数达到最小,其基本数学模型如下min∣∣x∣∣0,s.t.Ax=bmin∣∣x∣∣0​,s.t.Ax=b这类技术常常应用于通过部分信息恢复全部信息。例如下图假设读者评分仅与题材有关,那么就可以利用部分信息恢复全表。 阅读详情

相关推荐

张量入门(Tensor for Beginners)(二)

1.2 张量是什么 1.2.1 张量的数组“定义”         张量=多维数组。         在初学向量的时,很容易进入这样的误区: s 正方体(假装有个cube) 标量 向量(矢量) 矩阵 三阶张量 rank 0 rank 1 rank 2 rank3           这个定义的意思是:标...

形式化验证学习者的博客 1601

matlab最小二乘-分类、矩阵完备、图像恢复

前言 为 西电数模培训《机器学习》-最小二乘法作业 1. warm start 固定了θ\thetaθ,研究γ\gammaγ取值变化时等值线的变化规律 可以看出,对应θ\thetaθ同号的点附近的取值更接近,在图1,2,3中,(1,1)和(1,-1)对应θ\thetaθ同号,另外两个同号,则等高线明显分成左右两部分,在图4,5,6中,则明显分成上下两部分。且随着γ\gammaγ增大,等高线越向取定的四个点靠近。 代码如下: x=[1,1;1,-1;-1,1;-1,-1]' X=-2:0.1:2 Y=X

hetuiya的博客 1229

深入理解张量 第一章 张量理论基础

标量作为张量体系的基础构件,在物理学中定义为不随坐标系选择而改变其本质数值的量。在深度学习的语境下,这种坐标独立性转化为框架无关性——无论使用PyTorch、TensorFlow还是JAX,一个损失值或评估指标应当保持其数学语义的一致性。标量场将标量值赋予时空中的每一点,形成从流形到实数的光滑映射。在神经网络的训练过程中,损失函数构成定义在参数空间上的标量场,其梯度向量场指向函数值增长最快的方向。

VectorShift的博客 65

低秩矩阵恢复重新解读和随机SVD算法

随机SVD 给定矩阵A∈Rm×nA \in R^{m \times n}A∈Rm×n,求最大的前p个奇异值和对应的左右奇异向量。\ 1:执行下面两个算法中的任意一个(如果执行两个就视为加分项)。\ ∙\bullet∙在参考文献Petros Drineas, Ravi Kannan, and MichaelW. Mahoney, Fast Monte Carlo Algorithms for Matrices II: Computing a Low-Rank Approximation to a Matrix

forrestguang的博客 2686

低秩矩阵恢复算法综述

低秩矩阵恢复算法综述,内容比较易懂,用于图像修复,推荐算法等

别再对着数据手册发愁了!用HFSS 2023 R2搞定ESP32-C3板载天线的阻抗匹配

本文详细介绍了如何利用HFSS 2023 R2进行ESP32-C3板载天线的阻抗匹配优化,解决实际PCB设计中常见的性能偏差问题。通过智能模型导入、科学参数扫描和量化优化流程,显著提升天线性能,适用于WIFI和蓝牙应用场景。

weixin_42523543的博客 448

张量学习(二)

https://en.wikipedia.org/wiki/Kronecker_product https://en.wikipedia.org/wiki/Outer_product https://en.wikipedia.org/wiki/Tensor_product https://wuli.wiki/online 疑问:operator,mapping,function的区别? 疑问:space,field的区别? 函数:将集合中的元素映射到数字集合上的映射 当线性映射的目标是一维空间时,映射称

my blogs include programming, math, physics.回首过去,放眼未来。 leslielee.blog.youkuaiyun.com 2175

用Python实现一个猜密码的程序

我们用Python实现猜密码

sk6584631_sz的博客 1261

高维磁流张量层析与框架流遍历性:从理论到工程实践

在复杂系统状态重构领域,病态反演问题与信息完备性是两个核心挑战。从原理上看,病态性源于测量信息不足或模型不适定,导致解不稳定;而信息完备性则与系统的可观性密切相关,决定了数据是否蕴含重建所需全部信息。其技术价值在于,通过引入物理约束正则化(如散度约束、对称性约束)处理病态性,并结合可观性格拉姆矩阵分析框架流遍历性,能够显著提升高维动态系统状态估计的精度与鲁棒性。这些方法在核聚变等离子体诊断、生物磁成像等磁流体应用场景中尤为重要,直接关系到张量层析这类高维逆问题的求解可行性。本文聚焦于高维磁流研究,深入探讨了

weixin_34005090的博客 262

安装Quartus-II 13 和Modelsim

目录一、Quartus-II安装1.Quartus-II 13下载2.Quartus-II 13安装3.Quartus-II 13注册二、Modelsim安装 实验目的:安装Quartus-II 13 和Modelsim 实验环境:Windows10 参考资料:Quartus-II安装及使用 一、Quartus-II安装 1.Quartus-II 13下载 正点原子官方资料下载 百度网盘下载链接: https://pan.baidu.com/s/1a9d-bq9RZmWrRV542X4IEA 提取码:

qqq080的博客 8627

审稿人看了直呼内行:多组学整合分析——科研小白进阶之路

多组学,多平台分析解决方案

pysonger的博客 3944

[量子计算与量子信息] 2.1 线性代数

量子计算所需线性代数基础知识总结

天道酬勤,厚积薄发 3614

【制作100个unity实战之2】实现一款简单的FPS游戏

你将学到: fps武器脚本 基础瞄准功能 僵尸敌人AI 巡逻范围 攻击间 搜寻半径 追击 枪声吸引周围的僵尸 击中僵直效果

向宇的博客,专注php/web全栈 unity游戏开发,欢迎大家评论纠错 3552

量子笔记:张量、张量的阶数与向量的维数、外积、张量积

量子计算、量子信息、量子编程自学笔记系列。 用自己能看懂的方式来表述对于量子计算基础知识的理解。 不求体系完备和逻辑严谨、但求通俗易懂。或能顺便给路过的小伙伴一些参考和启发那是纯属巧合概不认账^-^。当然,这里仅限于轮廓的勾勒和要点的连接,对细节感兴趣的话还是要正儿八经地啃正经的参考书。 本节介绍张量以及张量积,为下一节介绍多量子系统的状态表示、量子纠缠和作用于两个或多个量子比特的门做一些数学准备。

chenxy_bwave的专栏 1万+

2025年12月GESP真题及题解(C++一级): 小杨的爱心快递

2025年12月GESP真题及题解(C++一级): 小杨的爱心快递

王老师青少年编程 1648

让openclaw接入web端的deepseek或着qwen,使用无限token

🪟 Windows: 提供原生的 PowerShell 一键安装支持!配置过程和官方版本是相同的,唯一的区别就是再选则model时要选择带Browser字样的deepseek或者qwen。安装之前需要先清理官方版本的安装痕迹,否则openclaw版本跳转不到这个中文版本。因为此版本与官方版本存在代差,在配置飞书时可能会出现无法安装飞书的情况。剩下的配置保持和官方版本一致操作即可。选中之后需要进行一次网页端的登录。登录后会出现可选择的model。安装完成后会跳到这个中文界面。涉及到接入飞书机器人的操作。

z1872385的博客 302

l2空间的完备性_群论(Group Theory)终极速成 / 群表示论下的正交性与完备性

序言从这里开始就要采取上下重复指标求和约定来运算了, 如果你本来就很懂指标运算, 那即使与我的记号有一定出入也不会影响阅读. 不过我可能老会说一些类似于"用分量代表张量""张量这个张量那个"之类的黑话, 这些听不懂应该不影响啥, 如果真的好奇我这边的约定或不懂指标运算或者好奇张量是啥的可以看下文: 文章很长, 懒得看也没关系, 可以只看文中第三章第一节直接给出的符号系统操作手册. 東雲正樹:物理人...

weixin_35750953的博客 2236

060、模型蒸馏:把扩散模型压进单步的魔法

《端侧文生图模型蒸馏实战:从32步到1步的优化之道》摘要:针对边缘设备部署难题,本文分享了扩散模型蒸馏的核心经验。通过重构损失函数(感知损失+对抗训练+KL散度)、优化采样轨迹截取策略和改造学生模型架构,成功将Stable Diffusion压缩至单步推理。关键发现包括:小批量训练更有效、标签平滑保障生成多样性、双模型策略平衡质量与速度。在Cortex-A53芯片上实现300ms内生成,内存占用控制在200MB以下。特别强调工业部署需权衡压缩率与稳定性,建议保留迭代模式开关以适配不同场景需求。

2601_95651806的博客 150

论文浅尝 | TuckER:基于张量分解的知识图谱补全

笔记整理:孙泽群,南京大学计算机科学与技术系,博士研究生。论文链接:https://arxiv.org/abs/1901.09590背景知识图谱是图结构的数据库,以三...

开放知识图谱 7042

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

泡利矩阵(一)

幺正矩阵在量子力学和数学物理等领域中具有重要的应用。在量子力学中,幺正矩阵用于描述量子系统的幺正演化,它保持向量的内积和模长不变,从而保持量子态的归一性和相对相位关系。幺正矩阵也用于描述量子门操作,即量子计算中的基本逻辑门,如Hadamard门、CNOT门等

luyoung0001@gmail.com的博客 9135

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

基于张量网络的机器学习(三)

本次将继续学习张量分解的有关内容。 一.TURCKER分解 二.非负矩阵分解 三.奇异值分解和高阶张量的奇异值分解 (一般)矩阵的奇异值分解(SVD) 高阶张量的奇异值分解(HOSVD) 四.其他矩阵分解 1.LU分解 2.正交分解(QR) 3.Cholesky分解 五.张量分解的特性总结 ...

1408

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

pytorch_lesson2 张量的索引+torch.index_select+torch.view+张量的分片函数+张量的合并操作+张量的维度变换

文章目录前言一、张量的符号索引1、一维张量索引2、二维张量索引3、三维张量索引二、张量的函数索引torch.index_select()方法三、tensor.view()方法四、张量的分片函数1、分块:chunk函数2、拆分:split函数四、张量的合并操作1、cat2、stack堆叠六、张量维度变换1、squeeze函数:删除不必要的维度2、unsqueeze函数:手动升维 前言 张量作为有序的序列,也是具备数值索引的功能,并且基本索引方法和Python原生的列表、NumPy中的数组基本一致,当然,所有

weixin_51589123的博客 1667

【转】图解张量_Tensor(数学不行还学AI-第4话)

看了很多tensor的介绍文章,感觉这篇是最通俗易懂的。 转载:https://zhuanlan.zhihu.com/p/25268020 原文:Learning AI if You Suck at Math — P4 — Tensors Illustrated (with Cats!) 在线运行代码版:数学不行还学AI-第4话-图解张量(内有恶猫) - 集智专栏 作者:Daniel J...

Weixin20210210 1345

稀疏表达:向量、矩阵与张量

然后是类似的图像inpainting 然后是图像去模糊,左上为输入模糊图像,右下为输出清晰图像及估计的相机运动(其实是PSF),中间均为迭代过程: 再然后是物体检测(自行车),左侧输入图像,中间为位置概率图,右侧为检测结果 当然我个人还推荐Yi Ma的sparse face,这个在对抗噪声的效果上很棒,比如下图中左侧的那张噪声图像(你能辨认是哪位不?这方法可以

todayq的专栏 3069

pytorch中的一维、二维、三维张量的符号索引

## 张量的索引、分片、合并以及维度调整 张量作为有序的序列,也是具备数值索引的功能,并且基本的索引方法和Python原生的列表、numpy中的数组基本一致。也有不同的,其是**pytorch中还定义了一种采用函数来进行索引的方式**。 而作为PyTorch中基本数据类型,**张量即具备了列表、数组的基本功能**,同时还充当着向量、矩阵、甚至是数据框等重要数据结构,因此PyTorch中也设置了非常完备的**张量合并与变换的操作**。

qq_43061415的博客 5277
上一篇: 图卷积神经网络(GCN)
下一篇: GRU与LSTM总结
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值