hadoop之HDFS及yarn(一)

HDFS、YARN、MapReduce概述及三者之间的关系(图解) HDFS(Hadoop Distributed File System) 是一种分布式文件系统,用于处理在商业硬件上运行的大型数据集。它用于将单个 Apache Hadoop 集群扩展到数百 (甚至数千)个节点。HDFS 是的主要组件之一,其他组件包括MapReduce和 YARN。HDFS的使用场景:适合一次写入,多次读出的场景。一个文件经过创建、写入和关闭之后就不需要改变。MapReduce是一种分布式计算框架。 阅读详情

hdfs

hdfs三台服务器节点配置:

在这里插入图片描述

各节点说明:
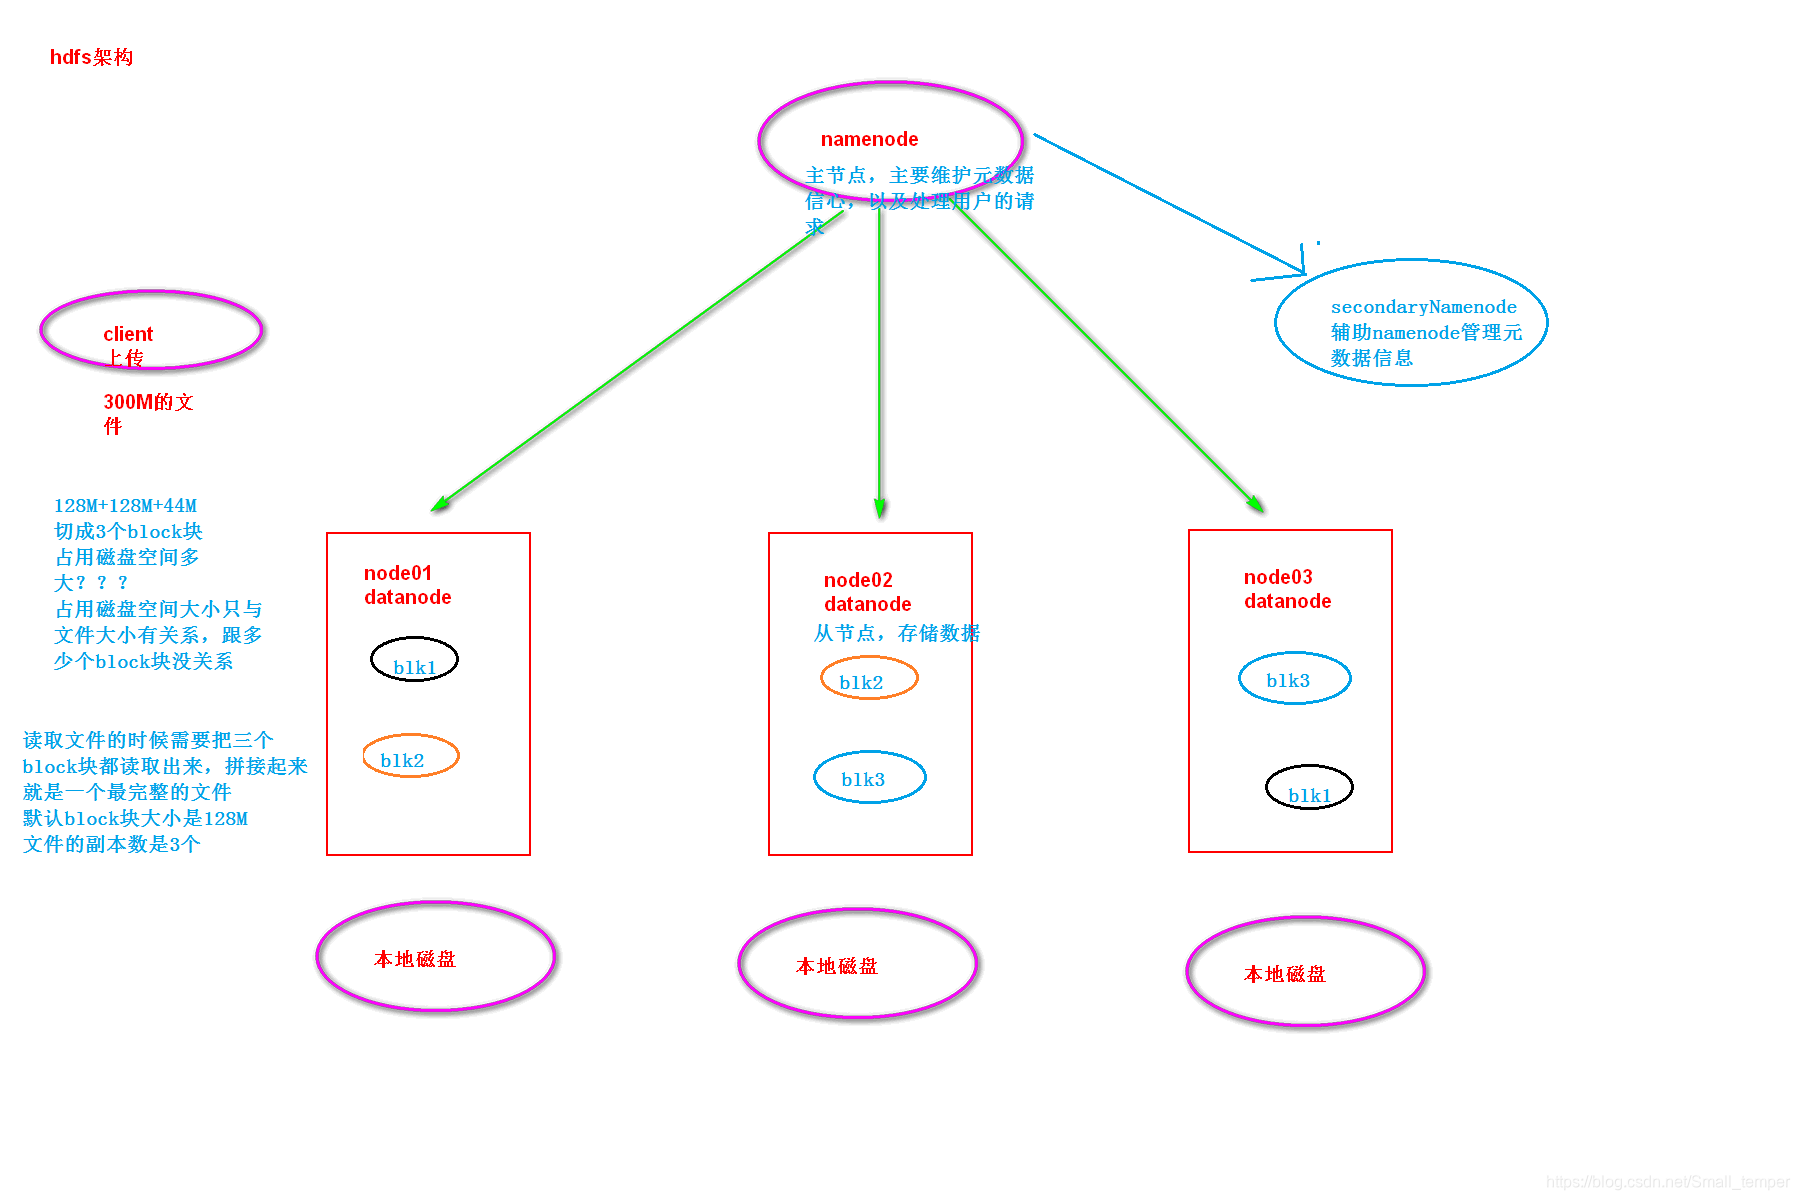
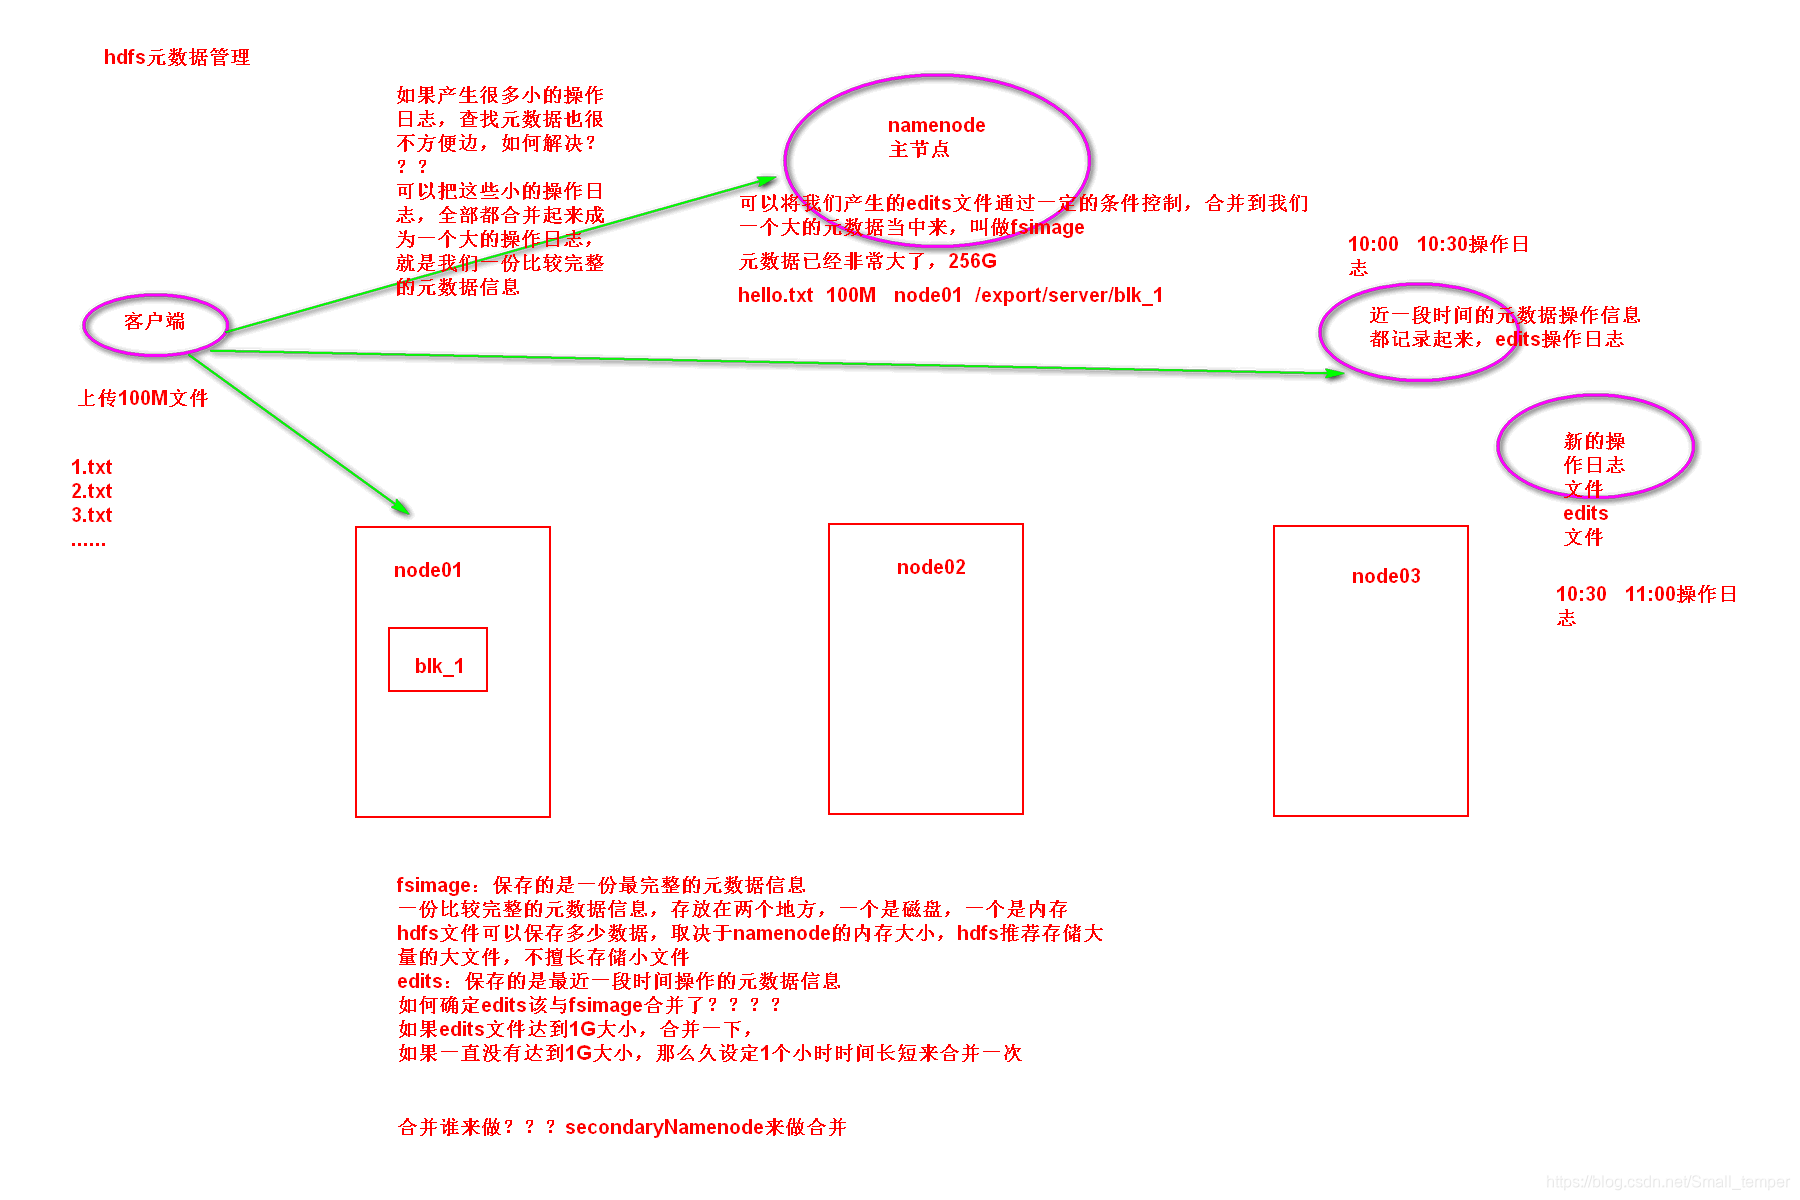
  • namenode :HDFS的守护进程,负责维护整个文件系统,存储着整个文件系统的元数据信息,有image+edit log ,namenode不会持久化存储这些数据,而是在启动时重建这些数据。

  • datanode:是具体文件系统的工作节点,当我们需要某个数据,namenode告诉我们去哪里找,就直接和那个DataNode对应的服务器的后台进程进行通信,由DataNode进行数据的检索,然后进行具体的读/写操作

  • secondarynamenode :一个冗余的守护进程,相当于一个namenode的元数据的备份机制,定期的更新,和namenode进行通信,将namenode上的image和edits进行合并,可以作为namenode的备份使用

如果namenode是高可用,那么就没有secondaryNamenode了,多了journalnode,并且journalnode最好是奇数个
journalNode:同步元数据信息,保证两个namenode里面的元数据是一模一样的,不然就会出现脑裂
zkfc:zkFailoverController 守护进程,与我们的namenode启动在同一台机器,监听namenode的健康状况

  • 元数据信息:描述数据的数据 文件的名称,文件的位置,文件的大小,创建时间,修改时间,权限控制
  • datanode数据存储:出磁盘,用于存储我们的文件数据
  • 一次写入,多次读取:hdfs文件系统,适用于频繁读取的情况,不适用与频繁写入的情况 改变文件,涉及到元数据的改变
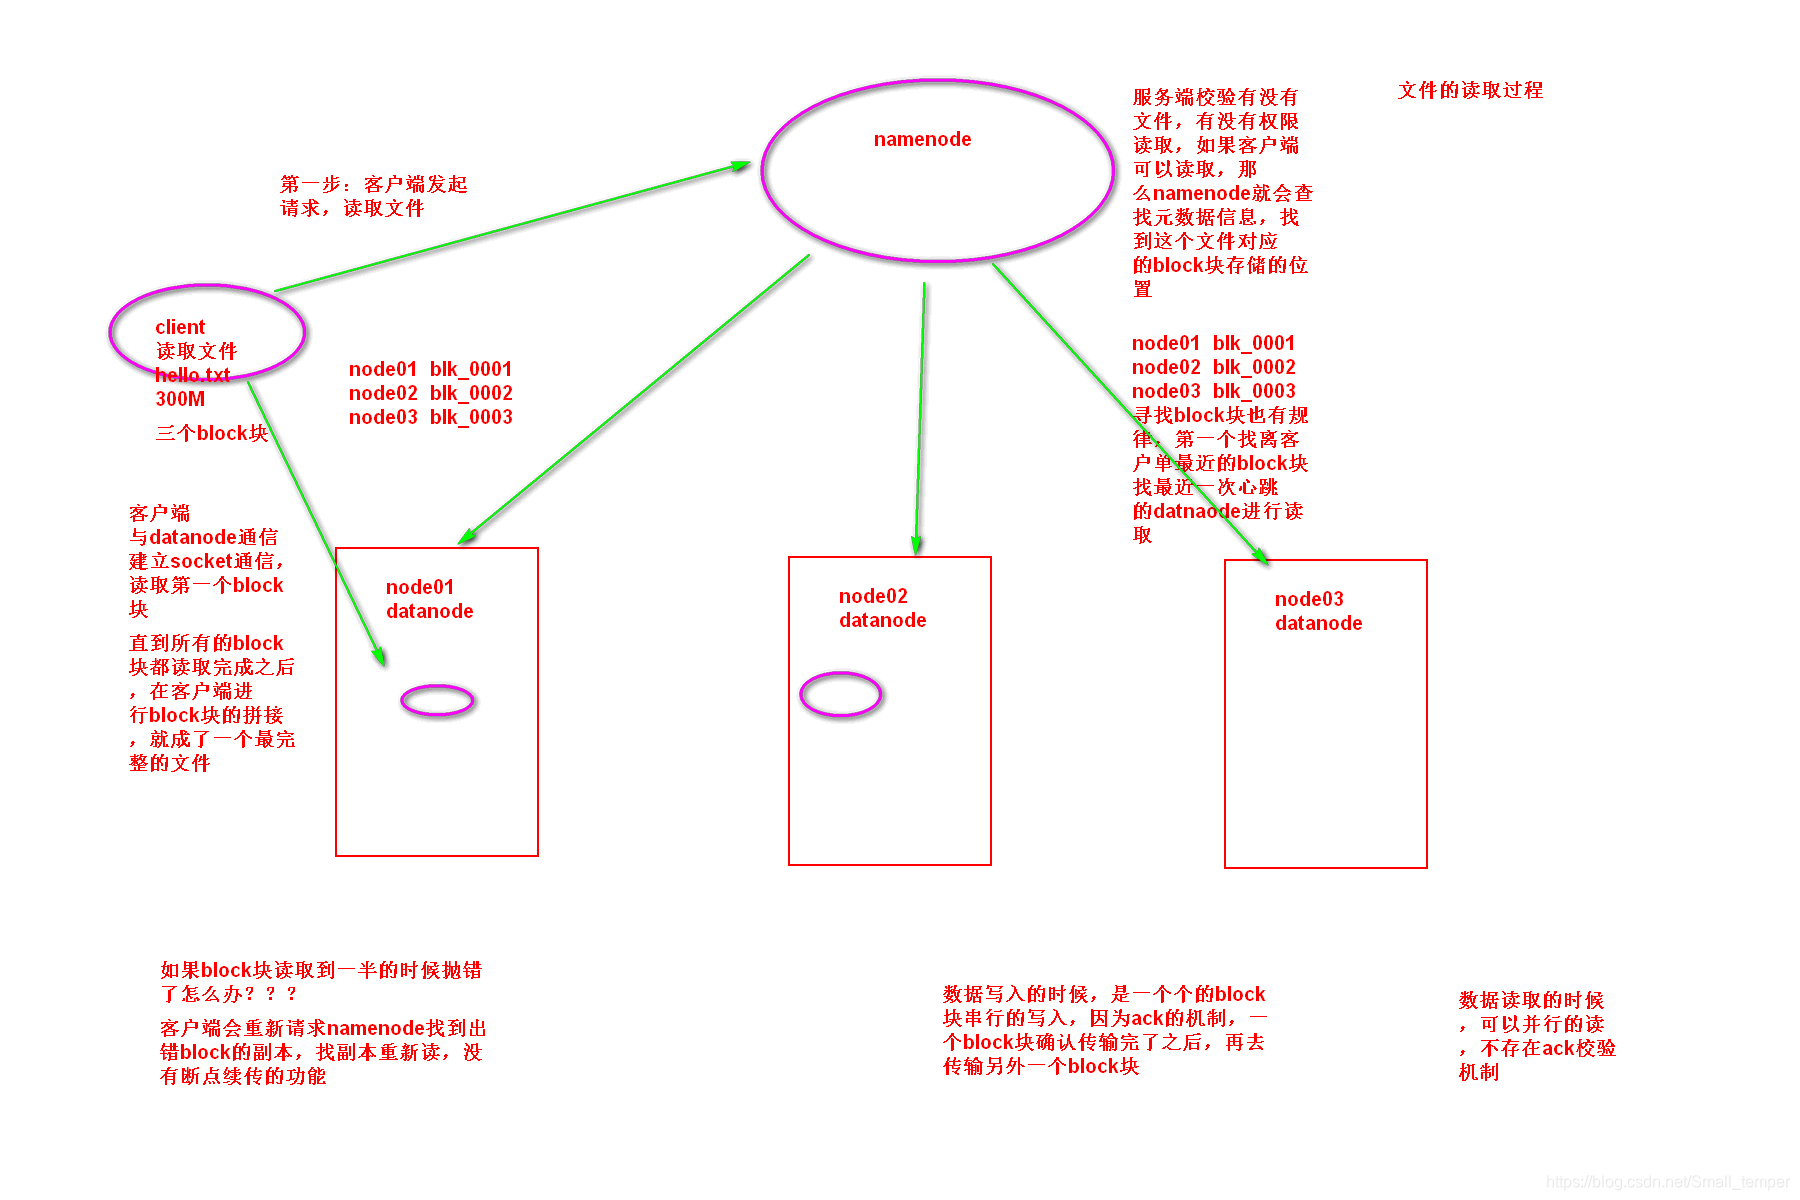
hdfs文件的读取过程:
  1. 客户端请求namenode读取数据
  2. namenode校验权限,文件是否存在等等
  3. namenode返回给客户端一个block块的列表
  4. 客户端读取block块
  5. 客户端拼接block块

在这里插入图片描述

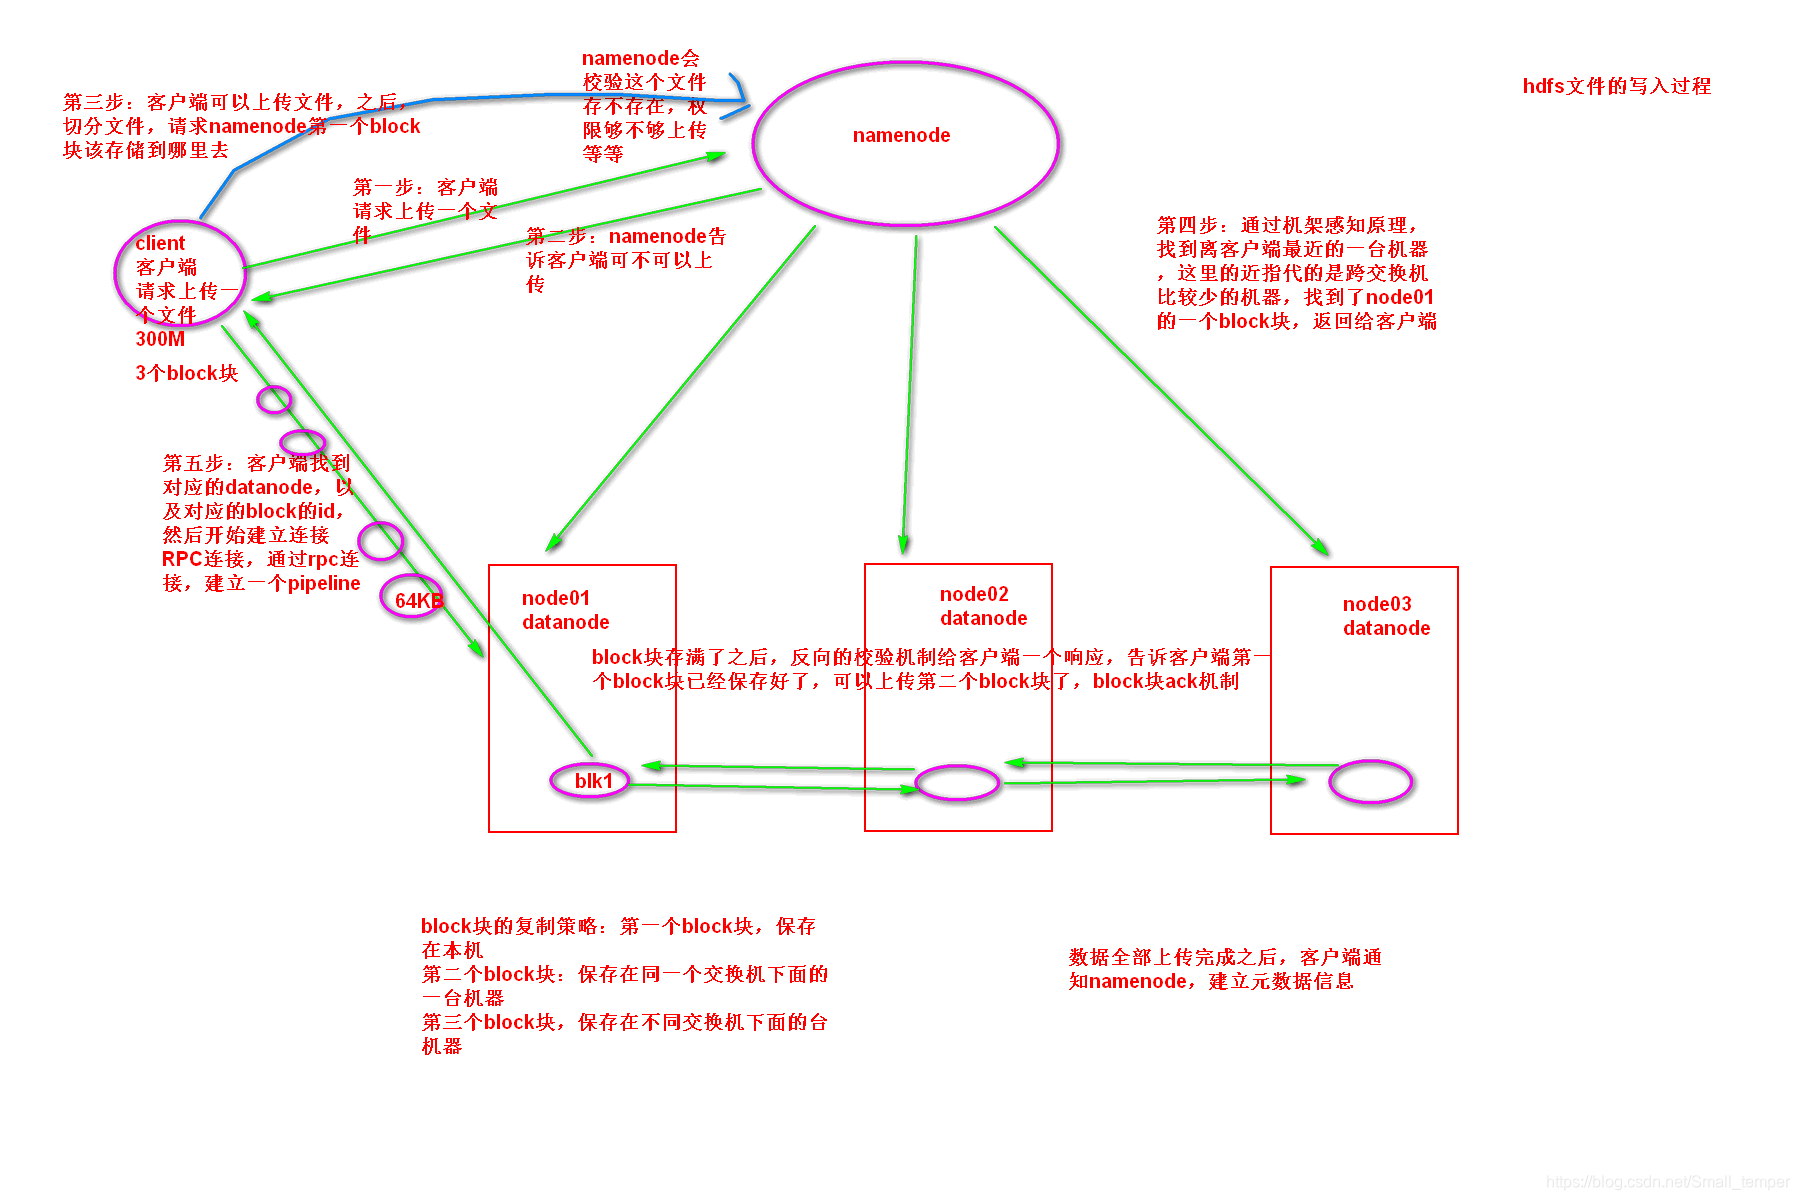
hdfs的文件的写入过程
  1. 客户端请求namenode上传数据
  2. namneode校验有没有权限,数据是否存在
  3. 客户端请求namenode第一个block块的位置
  4. 客户单与对应的datanode进行通信,建立pipeline管道 ,发送数据包 64KB ,反向的datanode需要校验block块是否上传成功
在这里插入图片描述

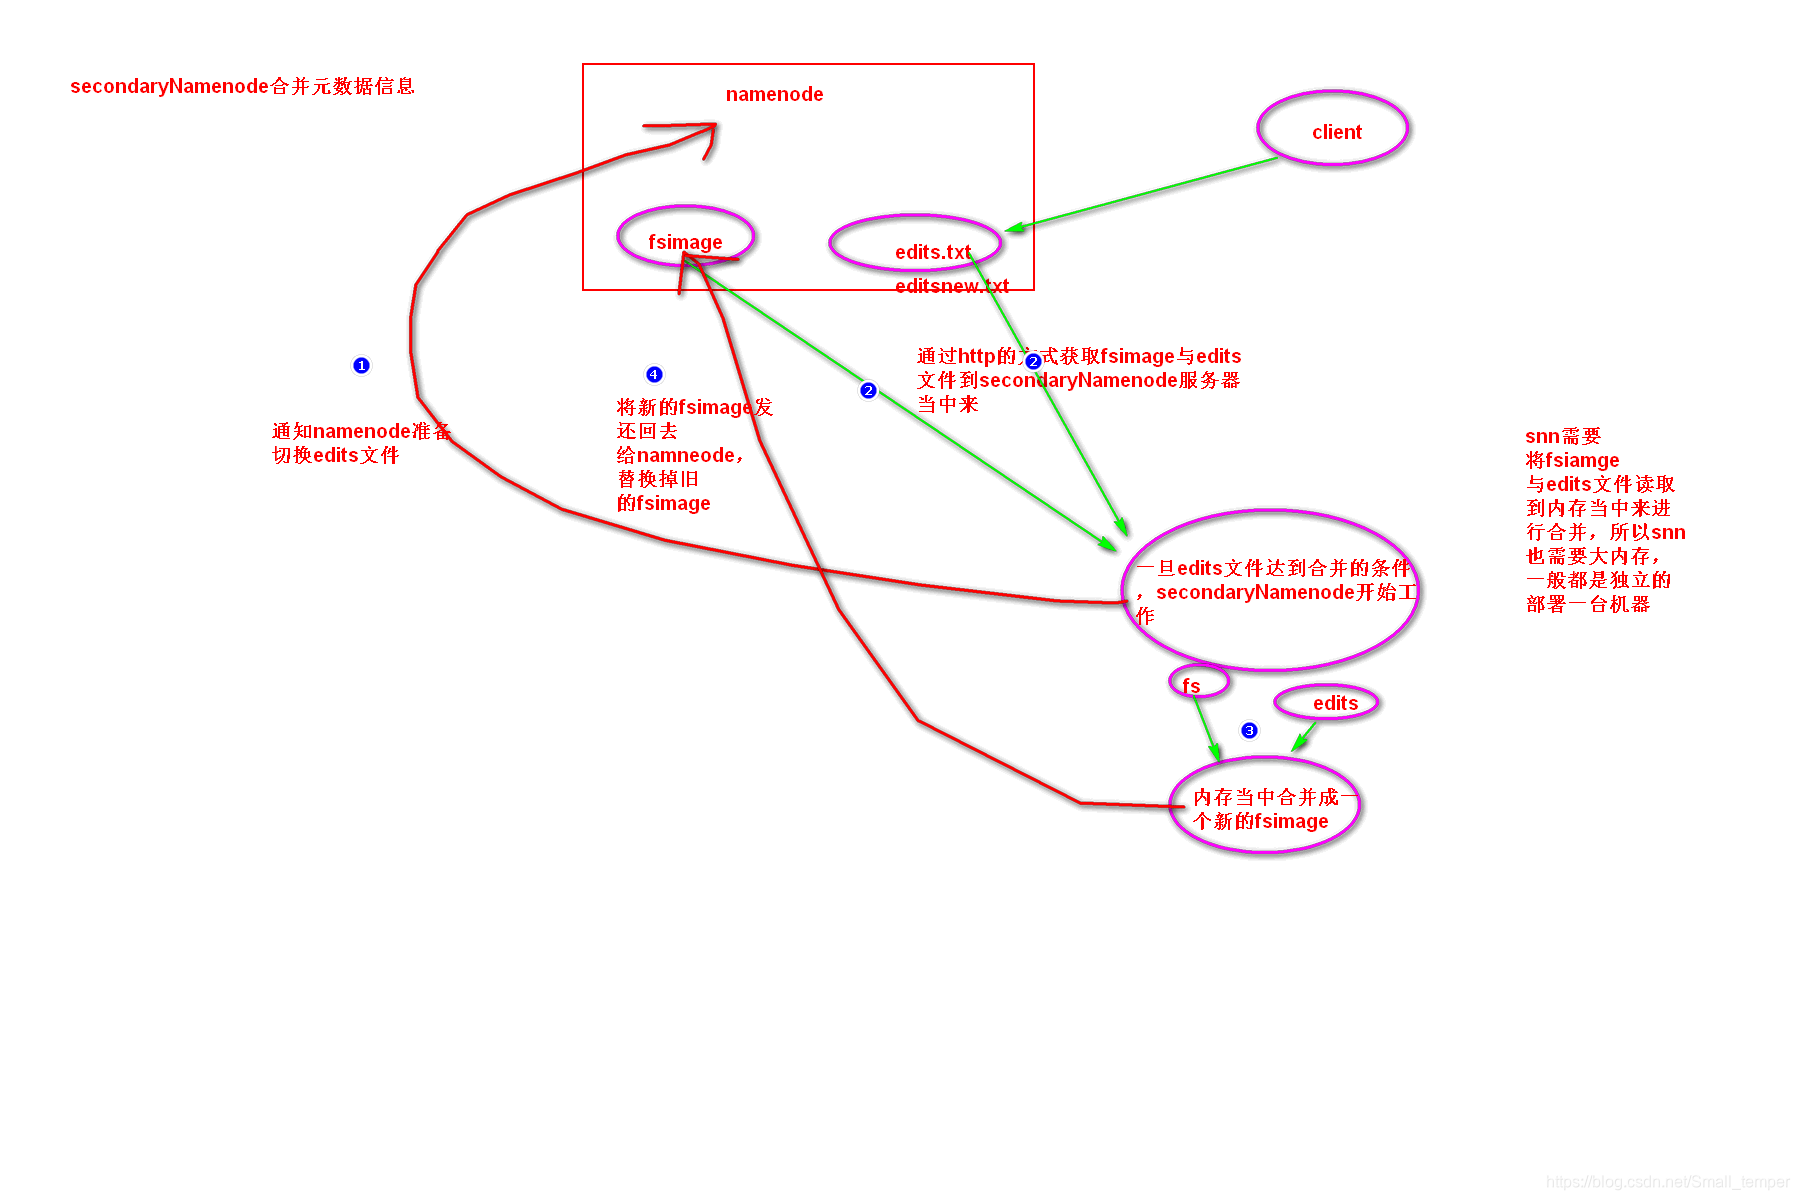
snn如何 合并fsimag与edits
  1. 通知namenode切换edits文件
  2. 通过http的方式获取fsimage与edits文件
  3. 将fsimage与edits文件加载到内存当中合并 snn需要大内存
  4. 将最新的fsimage发还给namenode,替换掉旧的fsimage

在这里插入图片描述

hdfs的架构图

在这里插入图片描述

hdfs元数据管理

在这里插入图片描述

YARN

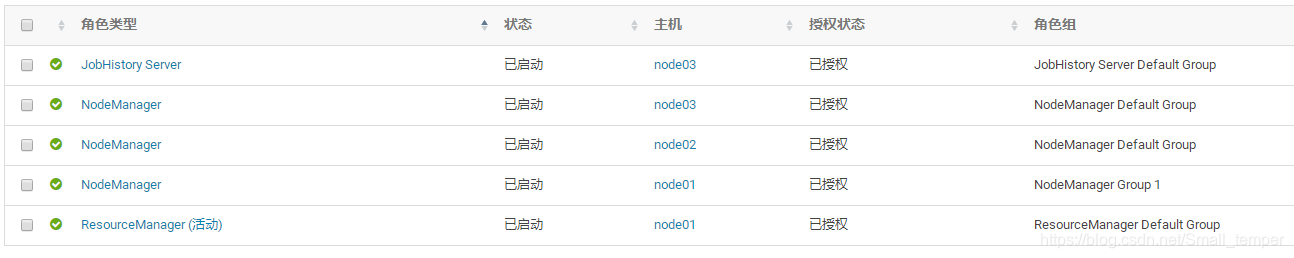
yarn三台服务器节点配置:

在这里插入图片描述

各节点说明:
  • resourcemanager:是yarn平台的守护进程,负责所有资源的分配与调度,client的请求由此负责,监控nodemanager
  • nodemanager :是单个节点的资源管理,执行来自resourcemanager的具体任务和命令
hadoop 的六个配置文件的作用
  • core-site.xml:核心配置文件,主要定义了我们的集群是分布式,还是本机运行
  • hdfs-site.xml: 分布式文件系统的核心配置 决定了我们数据存放在哪个路径,数据的副本,数据的block块大小等等
  • hadoop-env.sh 配置我们jdk的home路径
  • mapred-site.xml 定义了我们关于mapreduce运行的一些参数
  • yarn-site.xml 定义我们的yarn集群
  • slaves 定义了我们的从节点是哪些机器 datanode nodemanager运行在哪些机器上
  • hadoop 的格式化:只在集群初次启动的时候执行一次
namenode与resourceManager的高可用
  • hadoop 2.0版本引入namenode高可用机制
  • resourcemanager 2.4.0版本引用高可用机制
hdfs的安全模式:
  • 在我们集群刚刚启动的时候,集群是出于安全模式的,对外不提供任何服务,专门干一件事情,集群的自检
  • 如果集群自检没有什么问题,那么过三十秒钟,自动脱离安全模式,可以对外提供服务
hadoop的基准测试:
  • 集群启动成功之后,第一件事就是做基准测试,说白了就是压测,测试我们的网络带宽,测试我们的文件读取和写入速度等等
  • 真实的服务器性能,写入速度大概在20-30M每秒的样子:

真实服务读取速度测试:50-100M左右的样子
实际线上环境该如何压测: 写入10G 100G文件 500G文件 1T文件

MR

mapreduce编程可控的八个步骤
天龙八部:

map阶段两个步骤
1、第一步:读取文件,解析成key,value对,这里是我们的K1  V1
2、第二步:接收我们的k1  v1,自定义我们的map逻辑,然后转换成新的key2  value2  进行输出            往下发送  这里发送出去的是我们k2  v2

shuffle阶段四个步骤
3、第三步:分区    相同key的value发送到同一个reduce里面去,key合并,value形成一个集合
4、第四步:排序    默认按照字段顺序进行排序
5、第五步:规约  
6、第六步:分组  

reduce阶段两个步骤
7、接收我们的k2  v2  自定义我们的reduce逻辑,转换成新的k3 v3 进行输出
8、将我们的K3  v3 进行输出

单词统计,现在要统计,每一个单词在文本当中出现了多少次
hello world
hadoop hive
sqoop hive
hadoop hive

第一步:读取文件,解析成key,value对  key是我们的行偏移量  value是我们行文本内容
下一行是上一行的行偏移量
key1  value1
0  hello world
11  hadoop  hive
22 sqoop  hive

第二步:自定义map逻辑,接收我们的key1,value2 转换成新的key2  value2进行输出
获取我们的value1 ,按照空格进行切割  [hello,world] [hadoop ,hive]  [sqoop,hive]  
hello   world
hadoop  hive
sqoop  hive

转换成新的key2   value2 往下发送
key2    value2

hello   1
world   1
hadoop  1
hive    1
sqoop   1
hive    1

第三步:分区  相同key的value发送到同一个reduce当中去,key进行合并,value形成一个集合
hive  [1,1]
第四步:排序
第五步:规约
第六步:分组  


第七步:reduce阶段,接收我们的key2   value2   转换成新的key3   value3进行输出
接收  key2     value2
		hive    1
		hive    1
		key2     value2已经变成了一个集合
		hive   [1,1]
		
		
转换成新的key3   value3
          hive    1+1 = 2
		  
		  
第八步:输出我们的key3  value3
hive  2
sqoop  1
hello   1
world   1
hadoop  1

解析Hadoop三大核心组件:HDFS、MapReduce和YARN 在大数据时代,Hadoop作为一种开源的分布式计算框架,已经成为处理大规模数据的首选工具。它采用了分布式存储和计算的方式,能够高效地处理海量数据。Hadoop的核心由三大组件组成:HDFS、MapReduce和YARN。本文将为您逐一介绍这三个组件。 阅读详情

相关推荐

Hadoop的HDFS以及YARN简介

Hadoop的HDFS以及YARN简介 Hadoop分布式系统简介 Hadoop是分布式的系统架构,是Apache基金会顶级金牌项目 来源:三大论文GFS、MapReduce、 Bigtable 创始人:Doug cutting Hadoop分布式系统重要部分 HDFS YARN MapReduce Zookeeper Hive Hbase … HDFS(分布式存储系统) 用...

Infinity_TP的博客 988

HDFS、YARN、Mapreduce简介

一、 HDFS介绍: Hadoop2介绍 HDFS概述 HDFS读写流程 1. Hadoop2介绍 Hadoop是Apache软件基金会旗下的一个分布式系统基础架构。Hadoop2的框架最核心的设计就是HDFS、MapReduce和YARN,为海量的数据提供了存储和计算。 HDFS主要是Hadoop的存储,用于海量数据的存储; MapReduce主要运用于分...

weixin_34417814的博客 686

Flink随笔(一) 野生使用Hadoop yarn,hdfs

组内搭建一个小集群, 10+个节点,因为SRE 权限没给到,想在上边跑一些自己的任务,找了一台能连接到Master 的机器

xiaoliu_1的博客 765

hadoop的三大核心组件之HDFS和YARN

Hadoop的三大核心组件之HDFS和YARN Hadoop集群具体来说包含两个集群:HDFS集群和YARN集群,两者逻辑上分离,但物理上常在一起。 (1)HDFS集群:负责海量数据的存储,集群中的角色主要有NameNode/DataNode/SecondaryNameNode。 (2)YARN集群:负责海量数据运算时的资源调度,集群中的角色主要有ResourceManager...

微电子学与固体电子学-俞驰 3271

简单HDFS使用Journalnode HA部署

基于之前hadoop集群,实验Journal共享实现namenode的高可用,本篇只配置Hadoop的HDFS,其他Yarn,zookeeper,等均不关系. 节点hadoop,hadoop1,hadoop2,之前的集群namenode为hadoop,这里设置hadoop1,和hadoop2为Active和Standby NN,并使用JournalNode实现共享 在集群基础上改变一下内容

gao634209276的博客 6938

Hadoop HA高可用 学习笔记(一) HDFS-HA 手动、自动模式 | YARN-HA 自动模式 | 模拟宕机故障 | HA-基于Zookeeper

HA 概述 HA,即High Availablity,高可用,指的是集群能7 * 24 小时不中断服务。 实现高可用最关键的策略是消除单点故障。HA严格来说应该分成各个组件的HA机制:HDFS的HA和YARN的HA。 NameNode主要在以下两个方面影响HDFS集群: NameNode机器发生以外,如宕机,集群将无法使用,直到管理员重启 NameNode机器需要升级,包括软件、硬件升级,此时集群也将无法使用 HDFS HA 功能通过配置多个NameNodes(Activity / Standby)实现

希望每天都能进步一点点 1550

一张图连通Hadoop三大组件运行机制(HDFS、MapReduce、Yarn)

原来Yarn是这样贯通Hadoop的。

smallUmbralla的博客 1001

hadoop启动报错:Attempting to operate on hdfs namenode as root

写在最前注意: 1、master,slave都需要修改start-dfs.sh,stop-dfs.sh,start-yarn.sh,stop-yarn.sh四个文件 2、如果你的Hadoop是另外启用其它用户来启动,记得将root改为对应用户 HDFS格式化后启动dfs出现以下错误: [root@master sbin]# ./start-dfs.sh Starting namenodes on [master] ERROR: Attempting to operate on hdfs namenod

hzp666的博客 1万+

Apache Hadoop集群离线安装部署(一)——Hadoop(HDFS、YARN、MR)安装

虽然我已经装了个Cloudera的CDH集群(教程详见:http://www.cnblogs.com/pojishou/p/6267616.html),但实在太吃内存了,而且给定的组件版本是不可选的,如果只是为了研究研究技术,而且是单机,内存较小的情况下,还是建议安装Apache的原生的集群拿来玩,生产上自然是Cloudera的集群,除非有十分强大的运维。 我这次配了3台虚拟机节点。各给了4G,...

weixin_30687051的博客 226

Android 集成 Google 与 Facebook 第三方登录实战详解(2024版)

本文详细介绍了2024年Android应用集成Google与Facebook第三方登录的完整实战指南。通过分步教程和代码示例,帮助开发者快速实现一键登录功能,提升用户体验和注册转化率,同时涵盖隐私合规和常见错误处理的最佳实践。

blue的专栏 822

CMIP6数据处理及在气候变化、水文、生态等领域中的应用

CMIP6、Biome-BGC、生态、气候变化、气象、水文、气候模式、植被、生态模式、遥感、极端气候、降水、WRF模式、动力降尺度、RCM、大气环流模型、贝叶斯模型、、降尺度

PhyliciaFelicia的博客 1546

互联网大数据框架介绍(一)Hadoop,HDFS,yarn,Mapreduce

互联网大数据框架介绍(一)Hadoop,HDFS,yarn,Mapreduce如下图,这是现在流行的大数据技术线路图,也是最近才学习大数据的课程,所以对以下几个方面,hadoop,HDFS,yarn,Hbase,Mapreduce,Spark,Spark Streaming,Hive,Sqoop,这几个方面从数据存储到ETL这些核心部分进行介绍,。第一部分:hadoop首先,什么是hadoop:

blackmmu的博客 1330

华为eNSP实战:手把手教你配置DHCP全局地址池(含AP固定IP分配)

本文通过华为eNSP模拟器,详细演示了如何配置DHCP全局地址池,为不同业务VLAN动态分配IP地址,并重点讲解了如何通过MAC地址绑定为接入点(AP)分配固定IP。文章涵盖了从拓扑设计、基础网络搭建到地址池精细配置、验证测试及常见故障排查的全流程,是网络工程师掌握企业级DHCP部署与AP管理的实用指南。

weixin_29235923的博客 599

《Hadoop集群部署【一】HDFS详细介绍以及HDFS集群环境部署》(YARN以及MapReduce的部署点击文章结尾链接跳转Hadoop集群部署【二】)(笔记,十分详细)

HDFS是Hadoop三大组件(HDFS、MapReduce、YARN)之一 全称是:Hadoop Distributed File System(Hadoop分布式文件系统);是Hadoop技术栈内提供的分布式数据存储解决方案 可以在多台服务器上构建存储集群,存储海量的数据。HDFS系统的主角色,是一个独立的进程 负责管理HDFS整个文件系统 负责管理DataNode。workers: 配置从节点(DataNode)有哪些。

qq_65231448的博客 2447

从门禁到支付:Uniapp+NFC开发避坑指南(支持Mifare Classic)

本文详细介绍了Uniapp结合NFC技术开发门禁与支付系统的实战指南,特别针对Mifare Classic卡片进行深度优化。内容涵盖环境配置、设备兼容性处理、卡片安全机制解析以及高性能读写优化策略,帮助开发者快速实现跨平台的智能硬件交互解决方案。

t1u2v的博客 750

学好超几何分布的核心公式,破解双色球!

彩票本质是概率游戏,不存在"必中公式"科学投注的核心是风险收益比管理长期投注的期望值始终为负(理论回报率约47%-63%)数学维度:运用概率工具优化策略经济维度:控制投注成本在可承受范围人文维度:将彩票视为社会公益的参与方式通过本文构建的数学模型,彩民可以在概率框架内实现更理性的投注决策。但最终能否收获幸运,仍取决于那个永恒的未知数——概率女神的眷顾。一、超几何分布的核心公式。

weixin_44904675的博客 1万+

在虚拟机或Docker中搭建大数据伪分布式集群(一):hadoop基础功能——hdfs 与 yarn

环境 操作系统: CentOS 864位 - CentOS Linux release 8.1.1911 (Core) 拉去Centos镜像 docker pull centos:latest 使用docker images查看下载的镜像 创建容器 按照集群的架构,创建容器时需要设置固定IP,所以先要在docker使用如下命令创建固定IP的子网 network create --subnet=172.19.0.0/16 hadoop-group docker的子网创建...

道语星航 1472

⑩电子产品拆解分析-家用无线遥控开关433Mhz

①免布线随意贴,装上就能使用解决单线开关烦恼;②遥控配对简单,无线通讯距离长,信号可穿墙;

a6662580的博客 4693

大数据技术之Hadoop学习心得(HDFS)

文件系统是一种存储和组织数据的方法,实现了数据的存储、分级组织、访问和获取等操作,使得用户对文件访问和查找变得容易;文件系统使用树形目录的抽象逻辑概念代替了硬盘等物理设备使用数据块的概念,用户不必关心数据底层存在硬盘哪里,只需要记住这个文件的所属目录和文件名即可;比如windows操作系统数据:指存储的内容本身,比如文件、视频、图片等元数据:又称之为解释性数据,记录数据的数据;一般指文件大小、最后修改时间、底层存储位置、属性、所属用户、权限等信息。Hadoop分布式文件系统。

2301_80681643的博客 926

C# 量子级跨平台开发:用Uno Platform实现Windows、iOS、Android的“量子纠缠”UI同步

墨瑾轩推出编程学习平台,通过XAML的“量子纠缠”技术,实现跨平台开发的高效与一致性。传统方案中,多平台代码重复率高,UI差异大,而量子级方案则通过一套代码构建全平台应用,UI原子化同步,开发效率提升5倍。Uno Platform的“量子纠缠”架构解决了代码碎片化、性能瓶颈和调试难题,实现UI原子化同步、性能提升300%和跨平台数据无缝同步。核心架构包括XAML的跨平台渲染、MVVM的量子叠加态架构、平台差异的量子退相干处理以及性能优化的量子隧穿效应,为开发者提供高效、一致的跨平台开发体验。

java专栏 1165

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

Hadoop核心技术详解

主从(Master-Slave)架构Hadoop的架构采用了经典的主从模式,其中Master节点负责管理和调度,而Slave节点则负责具体的存储和计算任务。这种架构不仅提高了系统的可扩展性,还确保了数据的高可用性和容错性。核心组件介绍:作为Hadoop的分布式文件系统,HDFS具有高容错性和高可靠性,能够存储PB级别的数据。它通过将数据切分成多个数据块并冗余存储在不同的节点上,确保了数据的持久性和安全性。MapReduce。

2301_81226895的博客 1183

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

老程序员告诉你大数据Hadoop入门需要填的坑

Hadoop是一个由Apache基金会所开发的分布式系统集成架构,用户可以在不了解分布式底层细节情况下,开发分布式程序,充分利用集群的威力来进行高速运算与存储,具有可靠、高效、可伸缩的特点。 1、Hadoop生态概况 HADOOP是一个由Apache基金会所开发的分布式系统集成架构,用户可以在不了解分布式底层细节情况下,开发分布式程序,充分利用集群的威力来进行高速运算与存储,具有可靠、高效、可...

IT时代周刊 468

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

Hadoop(一)——hadoop框架简介

摘要(参考资料来源网络) hadoop的网络上有很多相关的资料,这里简单介绍一下 一、什么是hadoop Hadoop是一个由Apache基金会所开发的分布式系统基础架构 主要解决,海量数据的__存储__和海量数据的__分析计算__问题。 广义上来说,HADOOP通常是指一个更广泛的概念——...

chouniti9651的博客 851

大数据随记 —— Hadoop 概述

Hadoop 是 Apache 基金会所开发的分布式系统基础架构,可以让用户在不了解分布式底层细节的情况下,开发分布式程序。Hadoop 的思想来源于三篇关于 GFS、MapReduce、 BigTable 的论文,后来就演变成了 Hadoop 中的 HDFS、MapReduce、HBase,分别对应着 大数据存储、大数据分析计算、列式非关系型数据库。Hadoop 中主要包含三大组件:HDFS、MapReduce、YARN。Hadoop 目前主要有三个发行版本:Apache Hadoop、Cloudera

繁依Fanyi的博客 1604

Hadoop/Yarn的日志清理

Hadoop/Yarn的日志清理可以分为两个子话题讨论: Hadoop/Yarn的本地日志(非Yarn Container生成的日志) Yarn的Container生成的日志 我们这里讨论的日志清理并不是通过定时的日志删除命令去实现,这一做法显然优雅, 具体的做法下面会分别进行讨论。 1. Hadoop/Yarn本地日志的清理 Hadoop/Yarn使用log4j进行日志输出,所以对于它们本地日志的清理,最好的方式是通过修改log4j的配置配置文件,以rolling的方式写入日志。Hadoop/Yarn

Laurence的技术博客 8628
上一篇: zookeeper的介绍(一)
下一篇: count(*) 和 count(1)和count(列名)区别
Small_temper
博客等级 码龄7年 12粉丝 36原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值