科幻成真!AI只凭音频生成逼真语音;用Python生成LaTeX数学公式;正则表达式提效宝库;NeurIPS教程;前沿论文 | ShowMeAI资讯日报

【论文笔记】Universal Guidance for Diffusion Models 所以加油哦,伦也君,要让我成为令众人羡慕的幸福女主角哦!——《路人女主的养成方法》加藤惠 阅读详情

👀日报合辑 | 📆电子月刊 | 🔔公众号下载资料 | 🍩@韩信子

📢 只听音频!就可以生成逼真的语音和钢琴音乐

https://ai.googleblog.com/2022/10/audiolm-language-modeling-approach-to.html

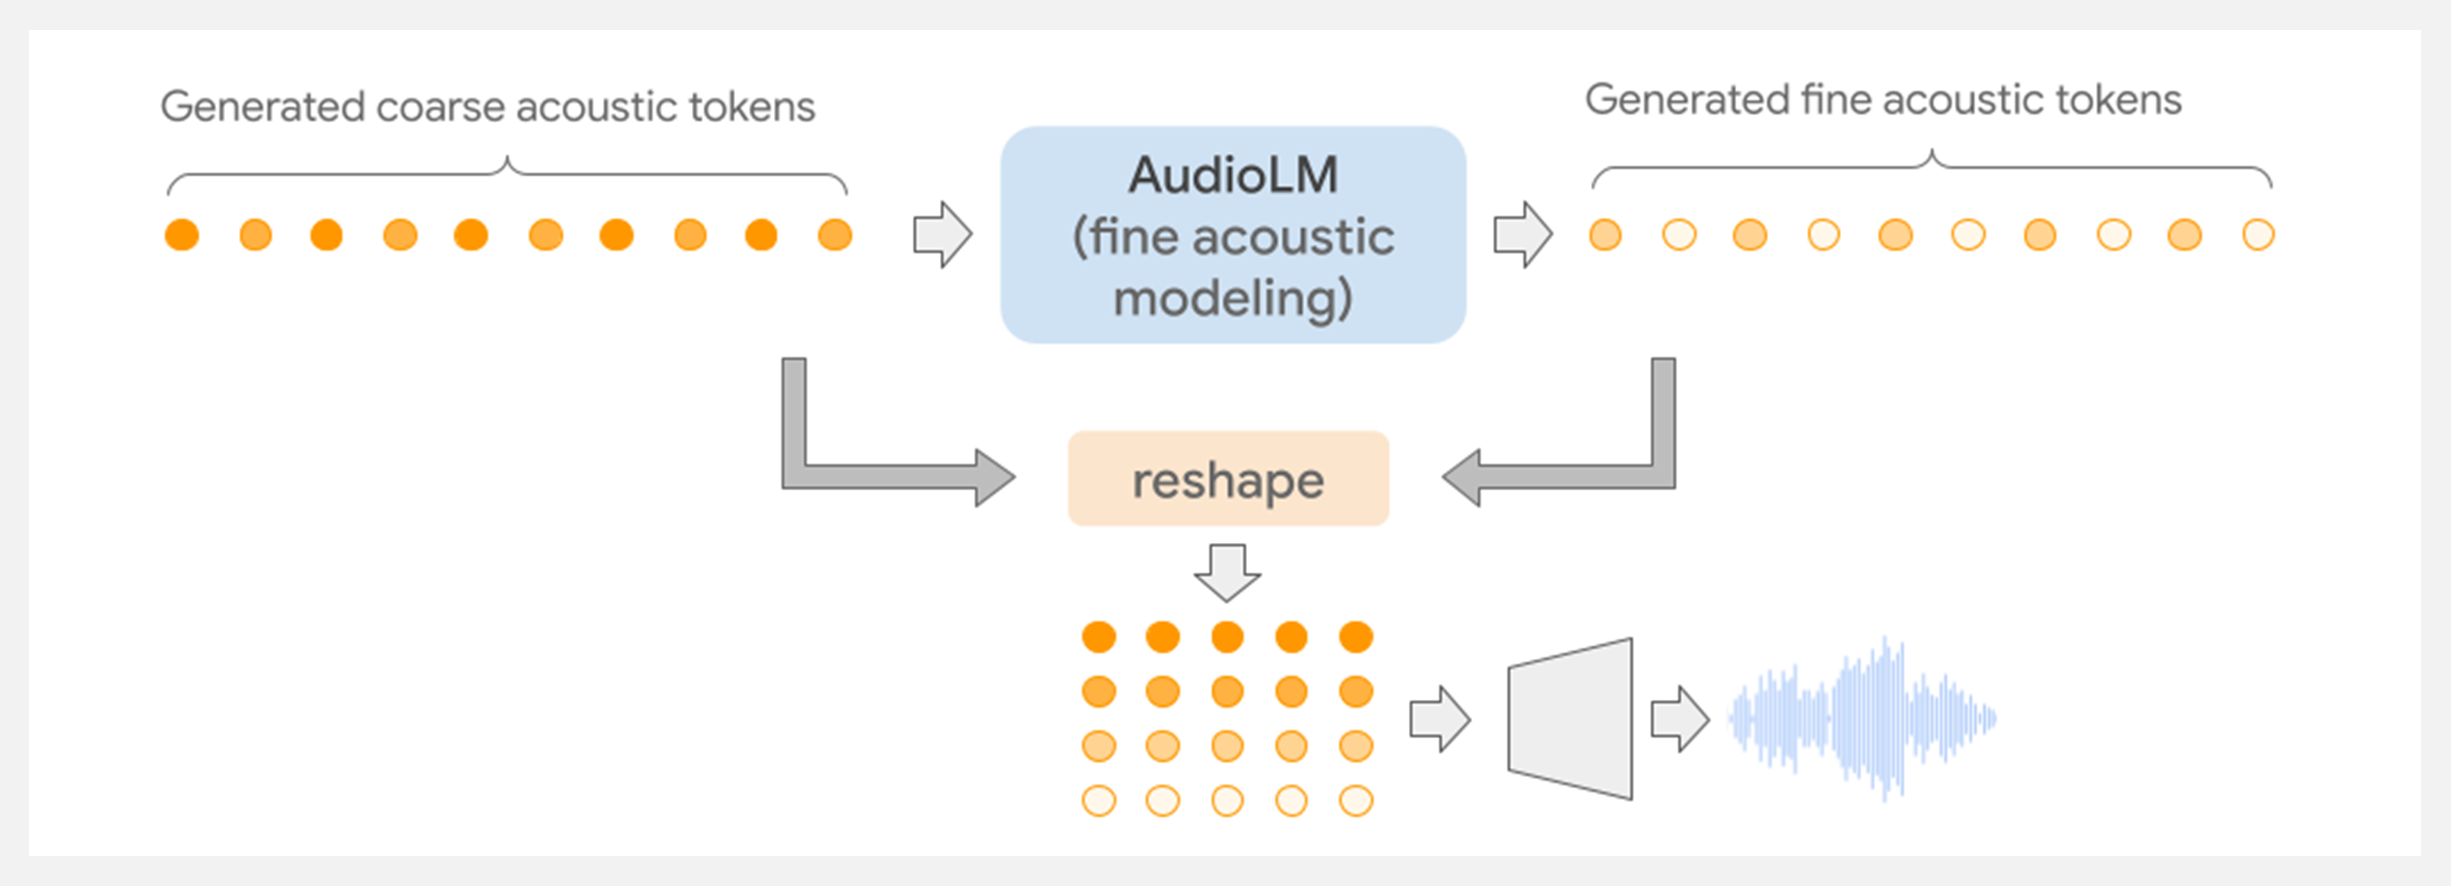
作者在『AudioLM: a Language Modeling Approach to Audio Generation』提出了一种新的音频生成框架,通过只听音频来学习生成逼真的语音和钢琴音乐。本文则介绍了 AudioLM 这种用于音频生成的语言建模方法,以提供长期连贯性和高音频质量。
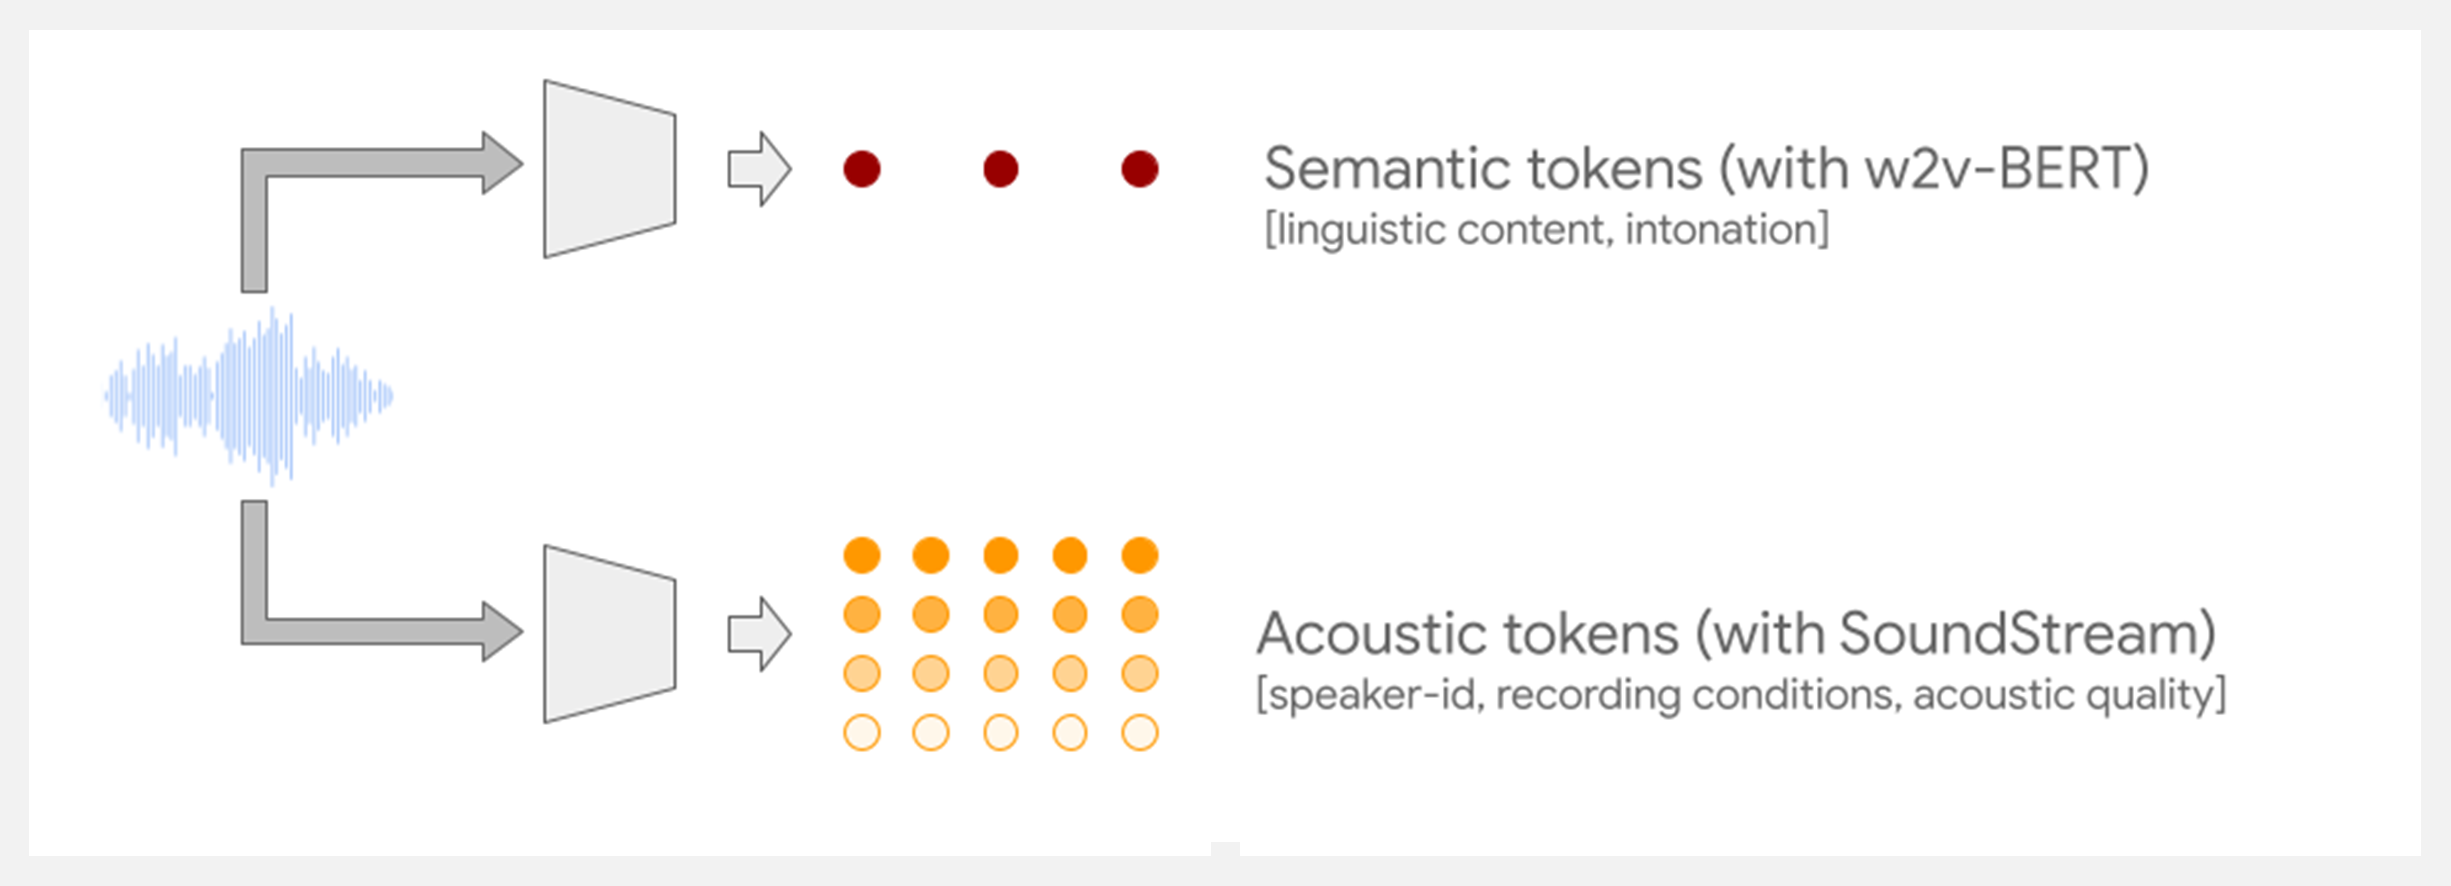
语音生成实验表明,AudioLM 不仅可以在没有任何文本的情况下生成句法和语义上连贯的语音,而且该模型产生的延续几乎与人类的真实语音无法区分。此外,AudioLM 远远超出了语音范围,可以对钢琴音乐等任意音频信号进行建模。这鼓励未来扩展到其他类型的音频(例如多语言语音、和弦音乐和音频事件),以及将 AudioLM 集成到编码器-解码器框架中,以执行条件任务(例如文本到语音或语音到语音翻译)。
工具&框架

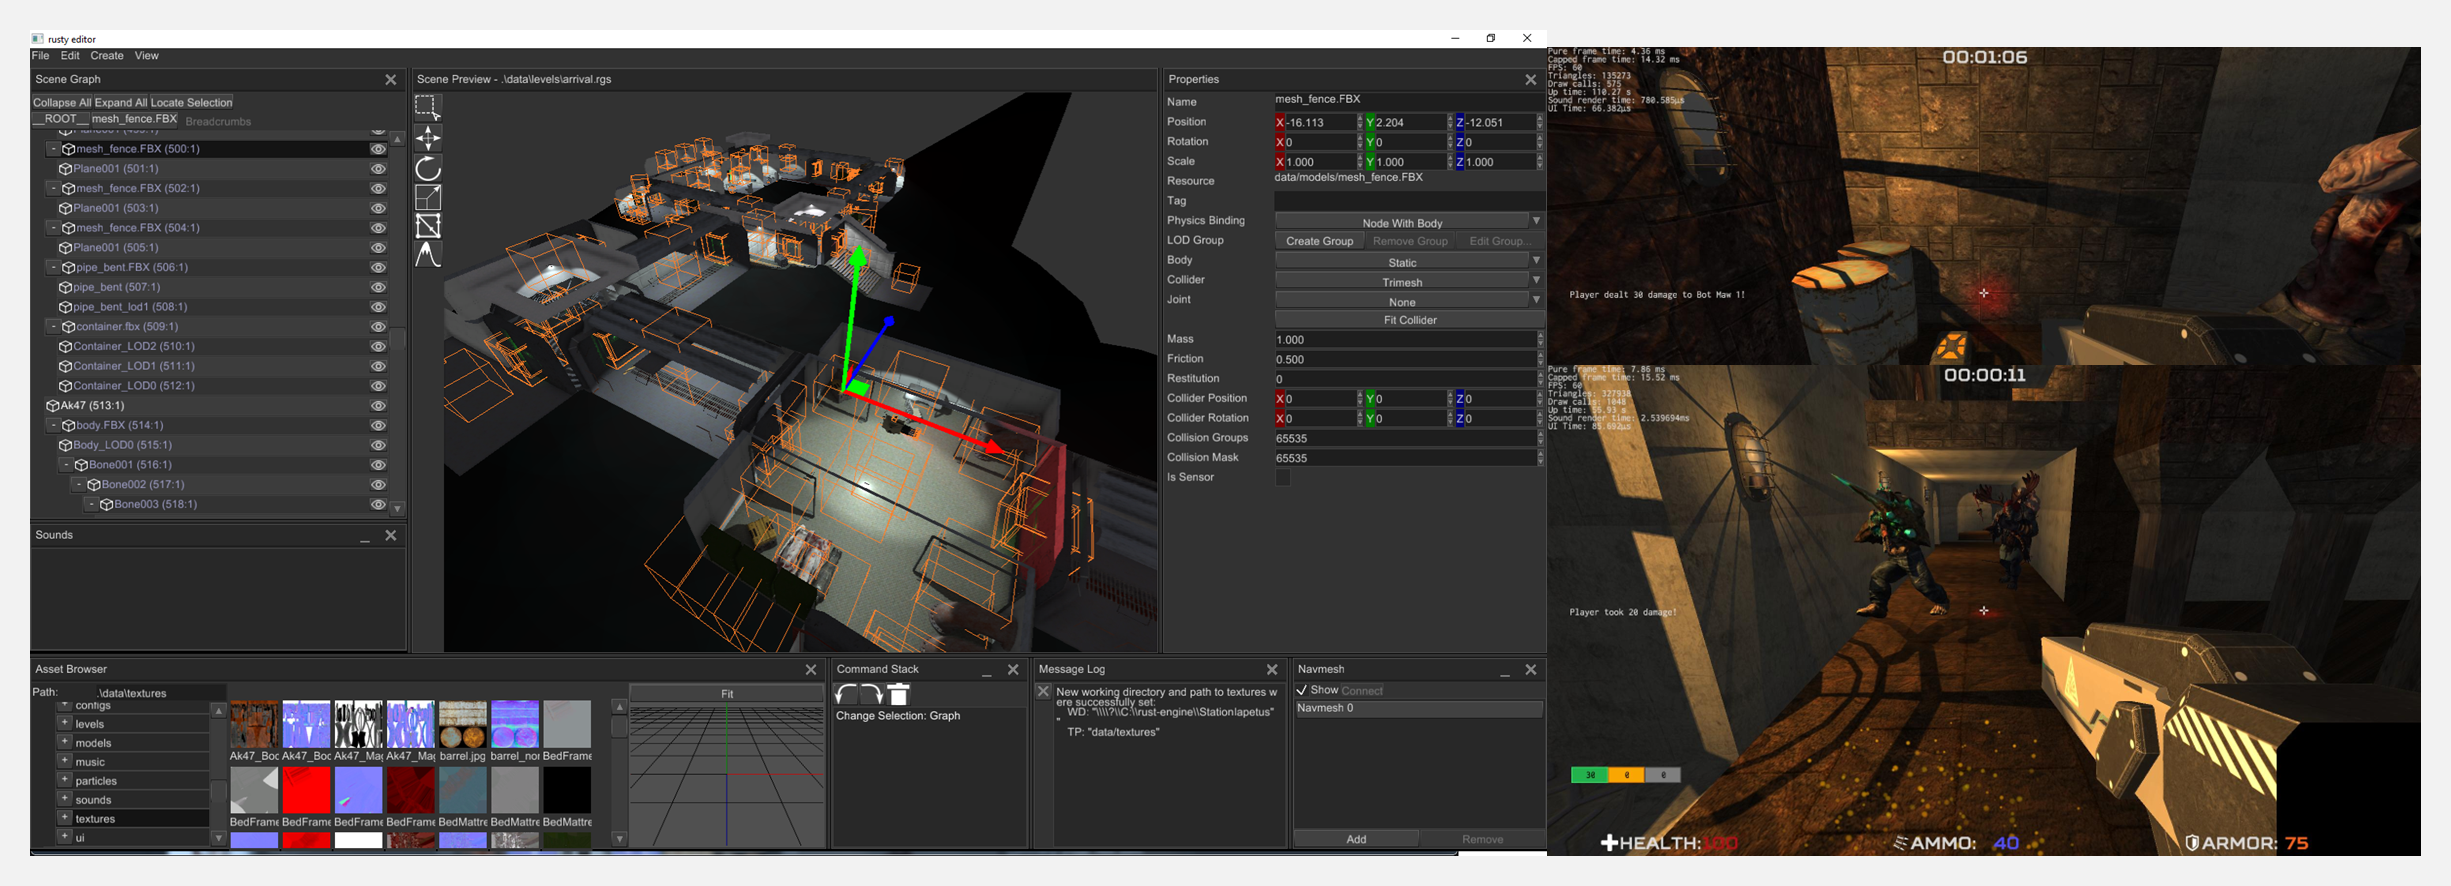
🚧 『Fyrox』Rust写的3D/2D游戏引擎

https://github.com/FyroxEngine/Fyrox

Fyrox是一个功能丰富、可生产的、通用的2D/3D游戏引擎,用Rust编写,带有场景编辑器,它的前身为 rg3d。
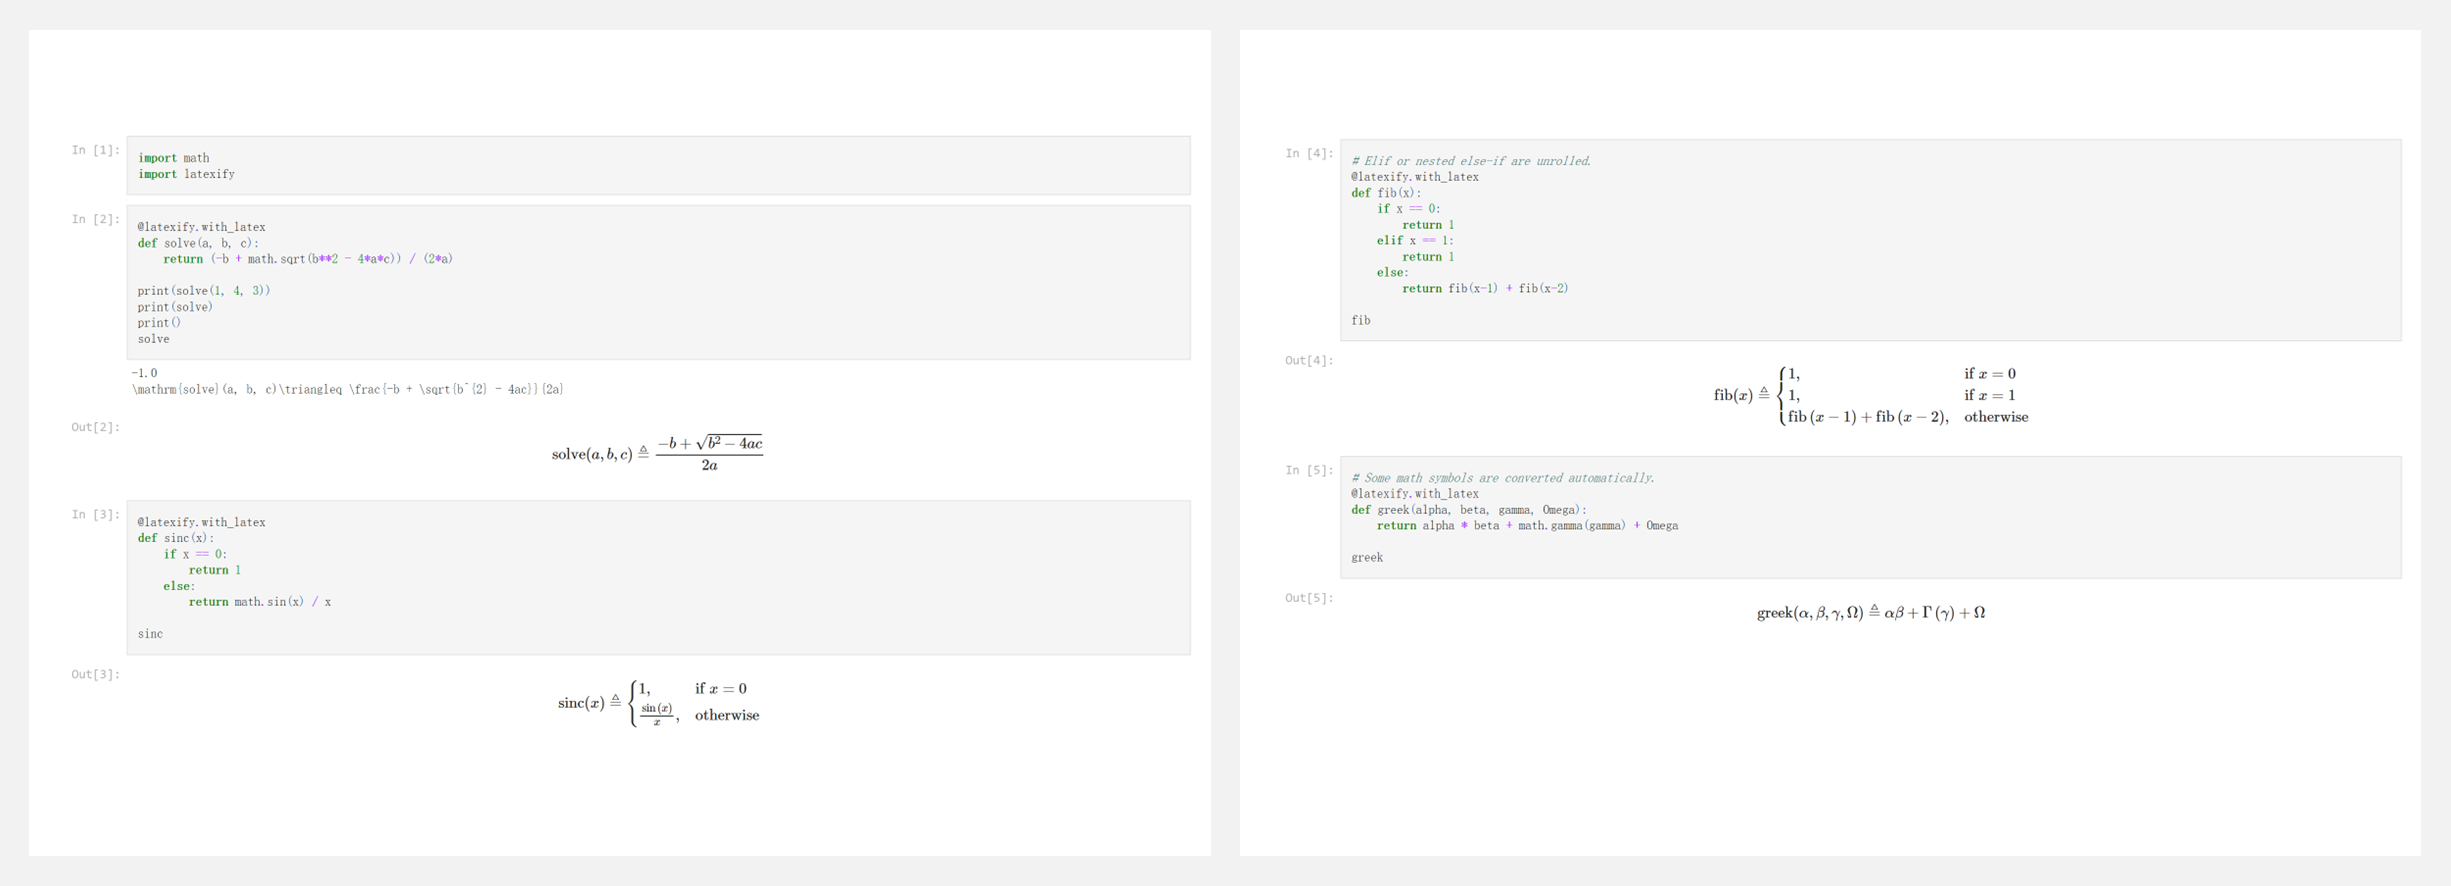
🚧 『latexify_py』用Python生成LaTeX数学公式(基于规则)

https://github.com/google/latexify_py

latexify_py 是一个Python工具库,用于生成LaTeX数学公式,它是基于规则实现的。
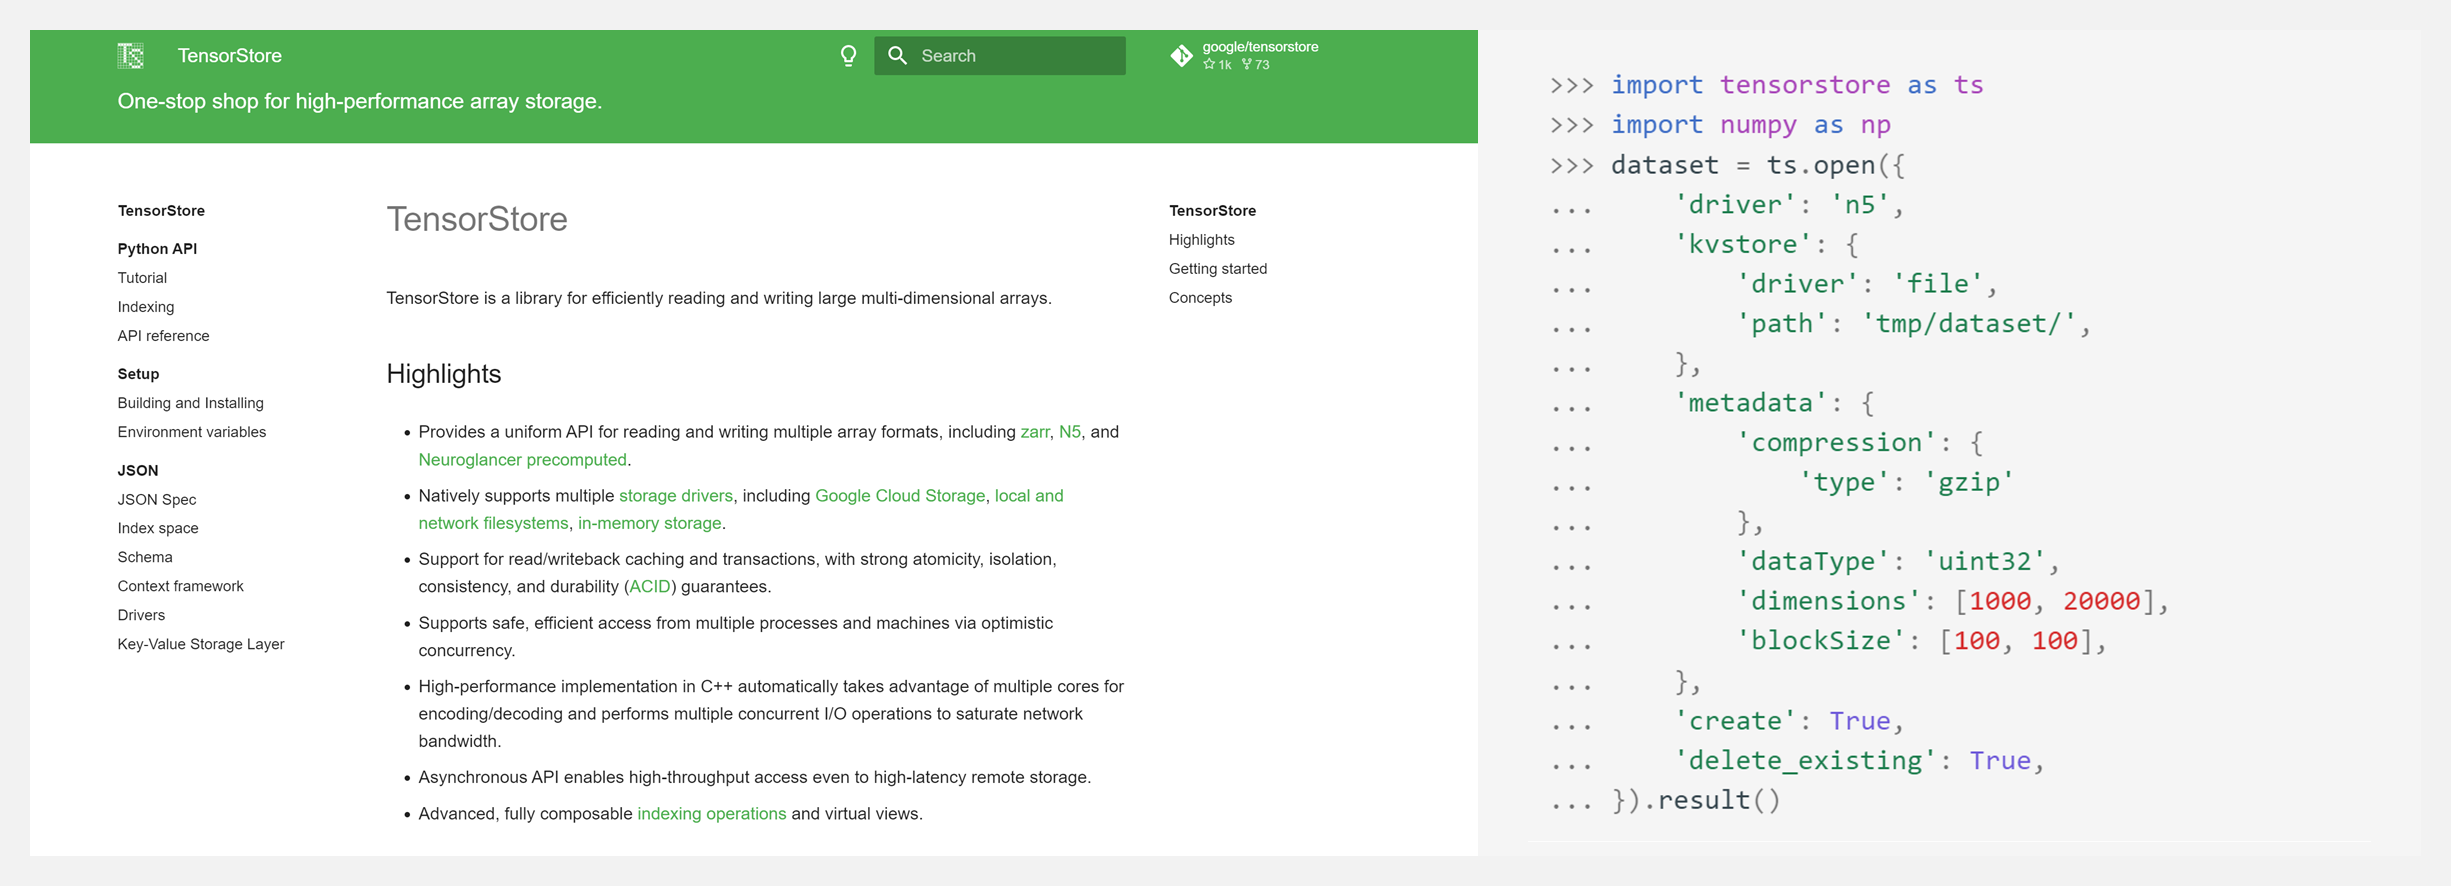
🚧 『TensorStore』大型多维数组读写库

https://github.com/google/tensorstore

https://google.github.io/tensorstore/

TensorStore 是 Google 开放的一个用于有效读写大型多维数组的库,可以为读写多种阵列格式提供统一的API(包括zarr、N5和Neuroglancer),支持多种存储驱动,支持高并发。
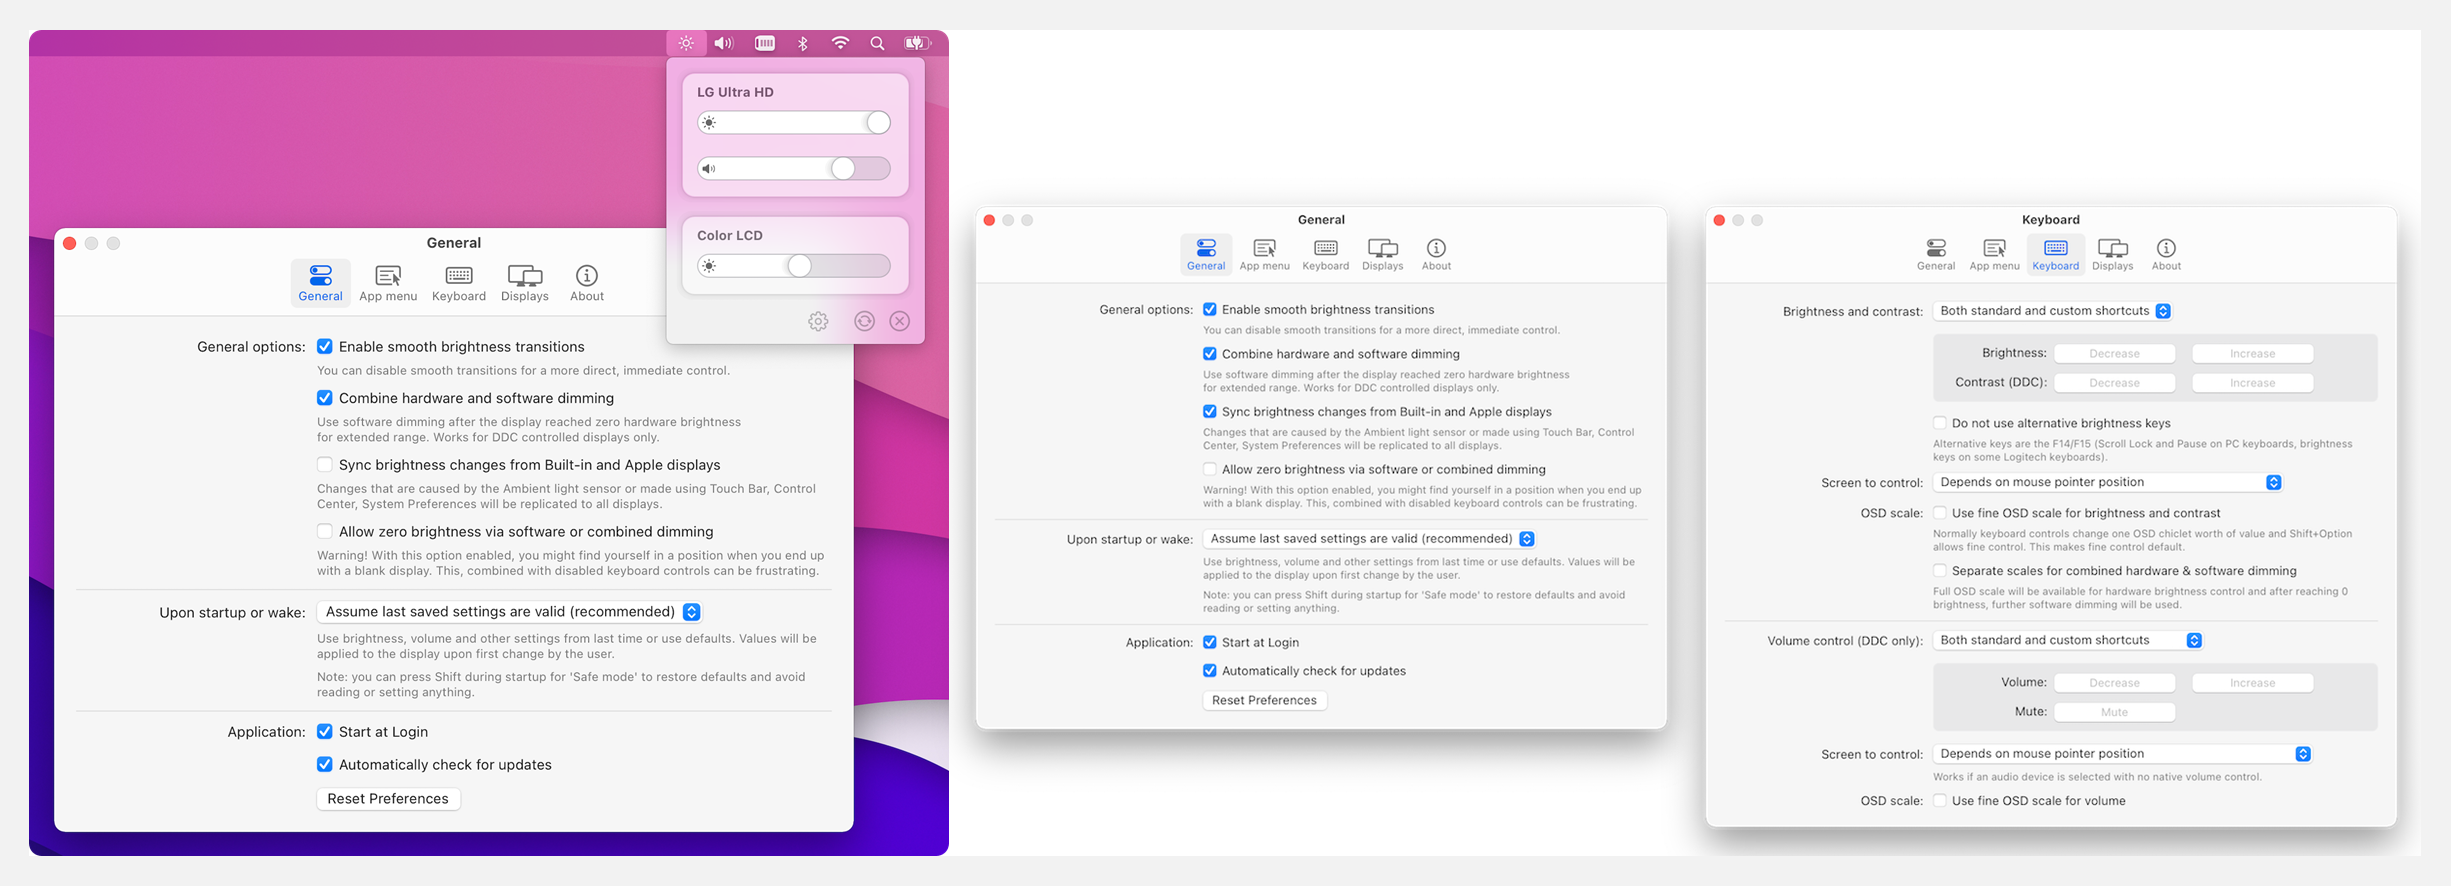
🚧 『MonitorControl』 Mac外显亮度控制器

https://github.com/MonitorControl/MonitorControl

MonitorControl 是一个 Mac 外显亮度控制器,可以调整显示器的亮度、音量和对比度,支持自定义键盘快捷键,拥有简单、不显眼的用户界面,完全免费、支持自动更新,提供无忧无虑的体验等。
🚧 『Cozy Auto Texture』用Stable Diffusion自动生成纹理的Blender扩展

https://github.com/torrinworx/Cozy-Auto-Texture

Cozy Auto Texture 将 Stable Diffusion AI 的复杂性与 Blender 的简单 GUI 连接起来,是在 Blender 中开始创建AI绘图/纹理的最简单和最直接的方法。Cozy Auto Texture 插件设置简单,开放源代码,下载过程简单,用户界面简单而直观。
博文&分享

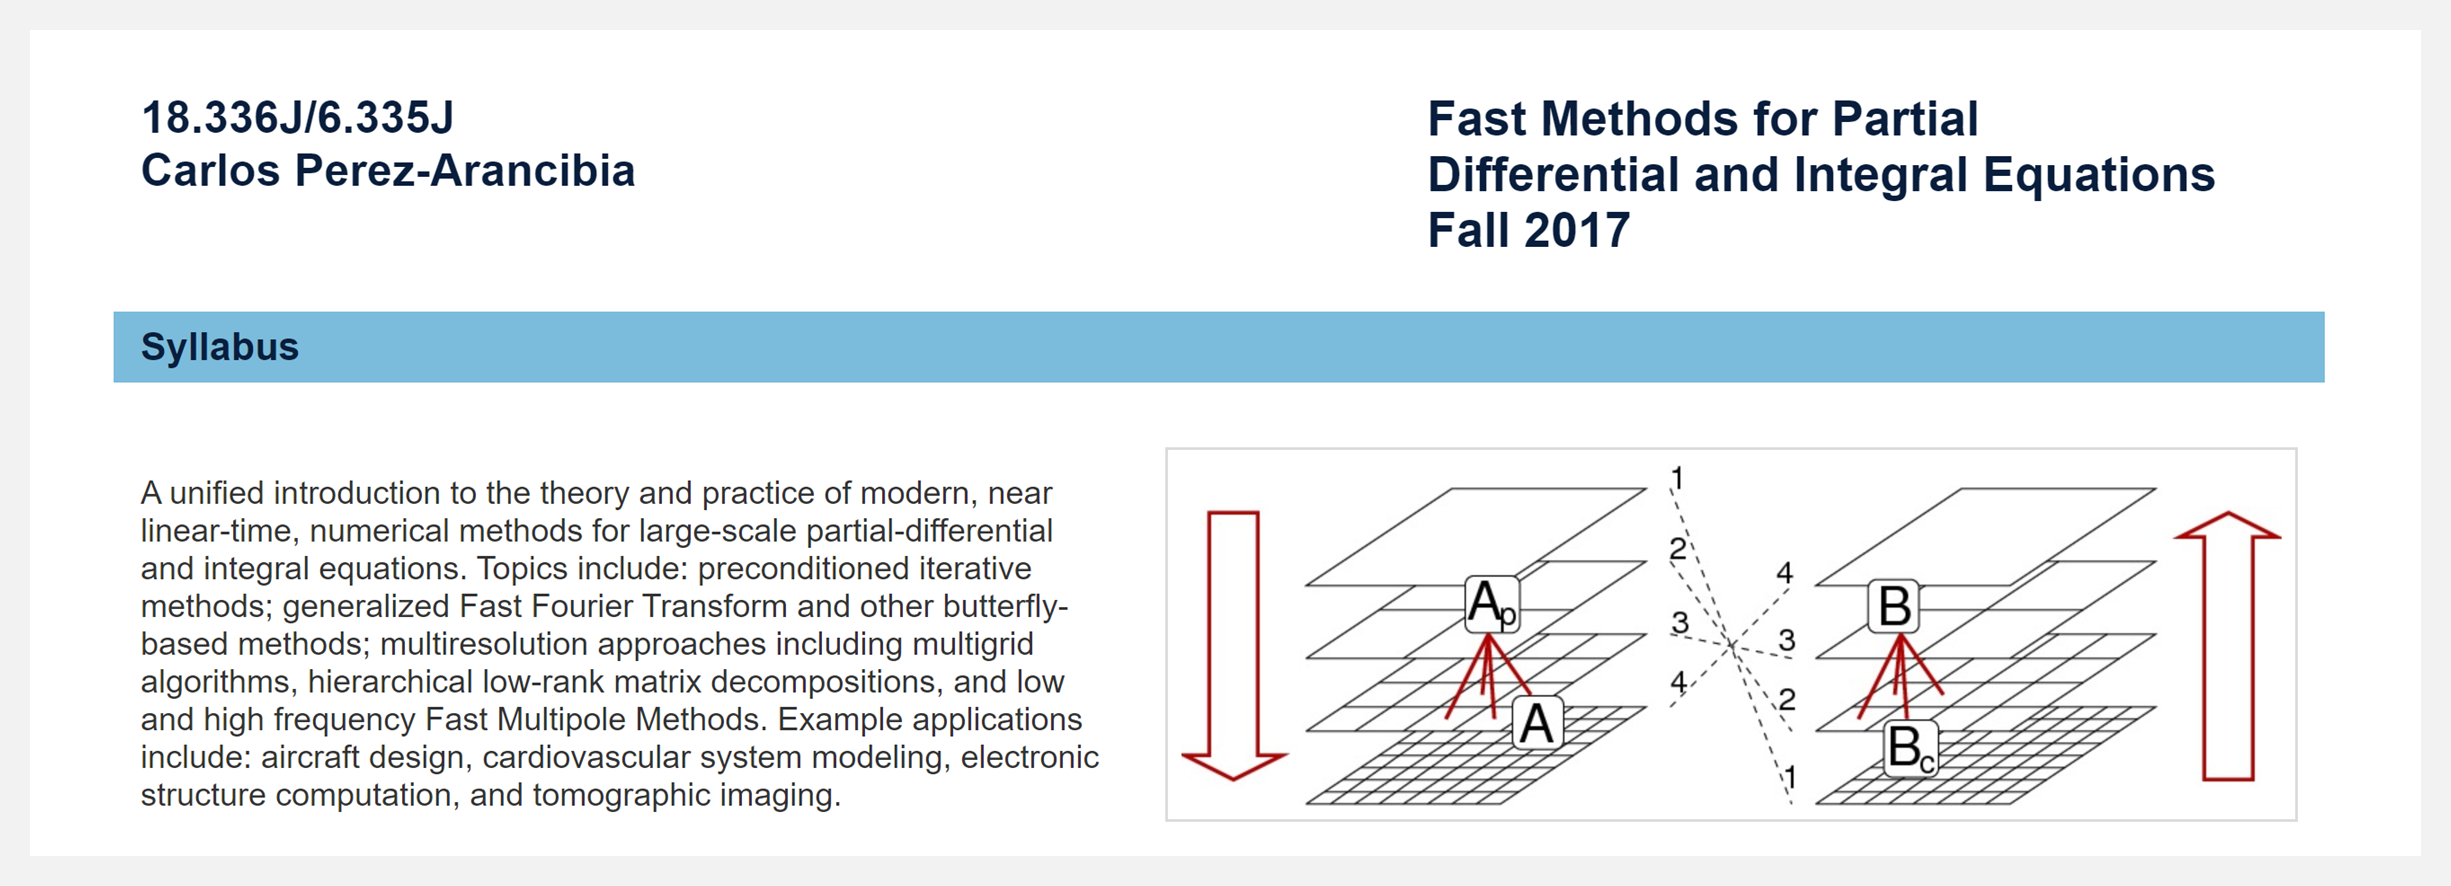
👍 『Fast Methods for Partial Differential and Integral Equations』 MIT 18.336J · 偏微分方程和积分方程的快速方法课程

https://github.com/mitmath/18336

https://math.mit.edu/~cperezar/18.336.html

本课程广泛涵盖了求解大规模偏微分和积分方程的现代数值方法。本学期的课程重点是傅里叶和现代多项式谱方法、边界积分方程以及流体动力学和电磁学的应用。
  • Introduction to fast methods, PDEs, IEs(快速方法、PDE、IE简介)
  • Fast Fourier transforms(快速傅里叶变换)
  • PDE discretization and preconditioning(PDE离散化和预处理)
  • Finite differences and fast Poisson solvers in 1D(一维有限差分和快速泊松求解器)
  • Fast finite difference solvers in multiple dimensions(多维快速有限差分求解器)
  • Domain decomposition methods(领域分解方法)
  • Introduction to spectral methods(光谱法简介)
  • Fourier spectral methods(傅里叶光谱法)
  • Polynomial interpolation(多项式插值)
  • Chebyshev collocation methods(切比雪夫搭配方法)
  • Dense Chebyshev spectral methods(密集切比雪夫谱法)
  • Sparse Chebyshev spectral methods(稀疏切比雪夫谱法)
  • Multidimensional sparse methods(多维稀疏方法)
  • Sparse methods for curvilinear domains(曲线域的稀疏方法)
  • Introduction to low-rank methods(低秩方法介绍)
  • Approximating low-rank interactions(近似低秩交互)
  • Fast multipole methods and boundary integral equations(快速多极方法和边界积分方程)
  • Discretizing boundary integral equations(离散边界积分方程)
  • Advanced boundary integral equations(高级边界积分方程)
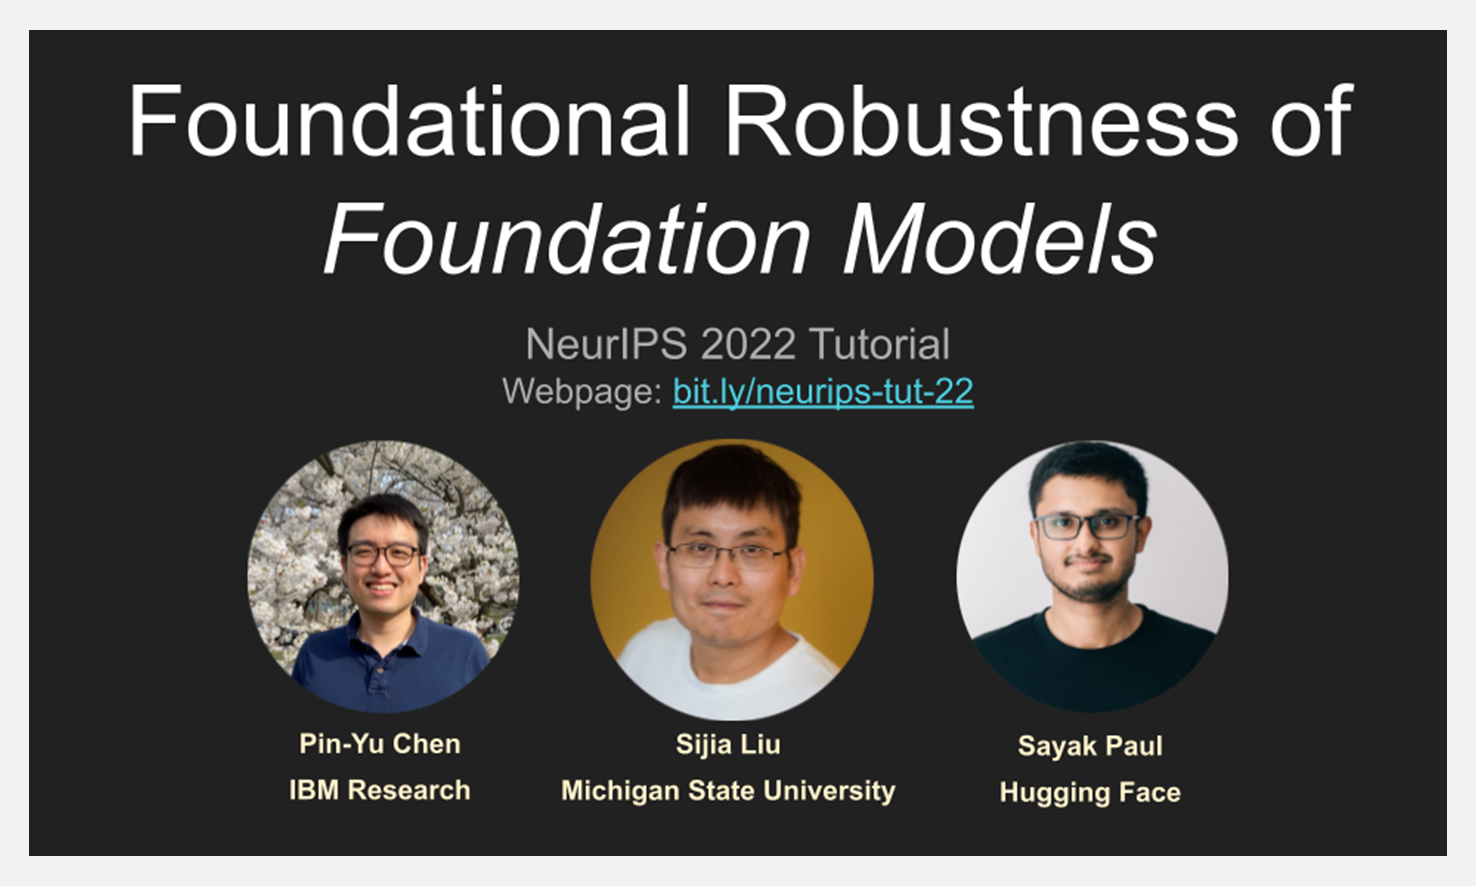
👍 『Foundational Robustness of Foundation Models』基础模型的基础鲁棒性 (NeurIPS 2022 tutorial)

https://github.com/sayakpaul/robustness-foundation-models

https://sites.google.com/view/neurips2022-frfm-turotial/

基础模型采用深度学习方法,对大规模未标记数据进行预训练,并通过特定任务监督进行微调,正在成为机器学习的主流技术。尽管在学习通用表示、小样本/零样本泛化方面表现优异,但由于使用了过多的数据,基础模型在鲁棒性和隐私方面面临着前所未有的挑战和。
本教程提供了一个类似于 Coursera 的在线教程,包含综合讲座、交互式 Jupyter/Colab 实时编码演示,以及关于基础模型可信度的小组讨论。

  • Basics in foundation models and robustness(基础模型和鲁棒性基础)
  • Deep dive on foundation models for computer vision(深入了解计算机视觉的基础模型)
  • Deep dive on foundation models for code(深入了解代码的基础模型)
  • Hands-on code walkthrough(动手代码演练)

数据&资源

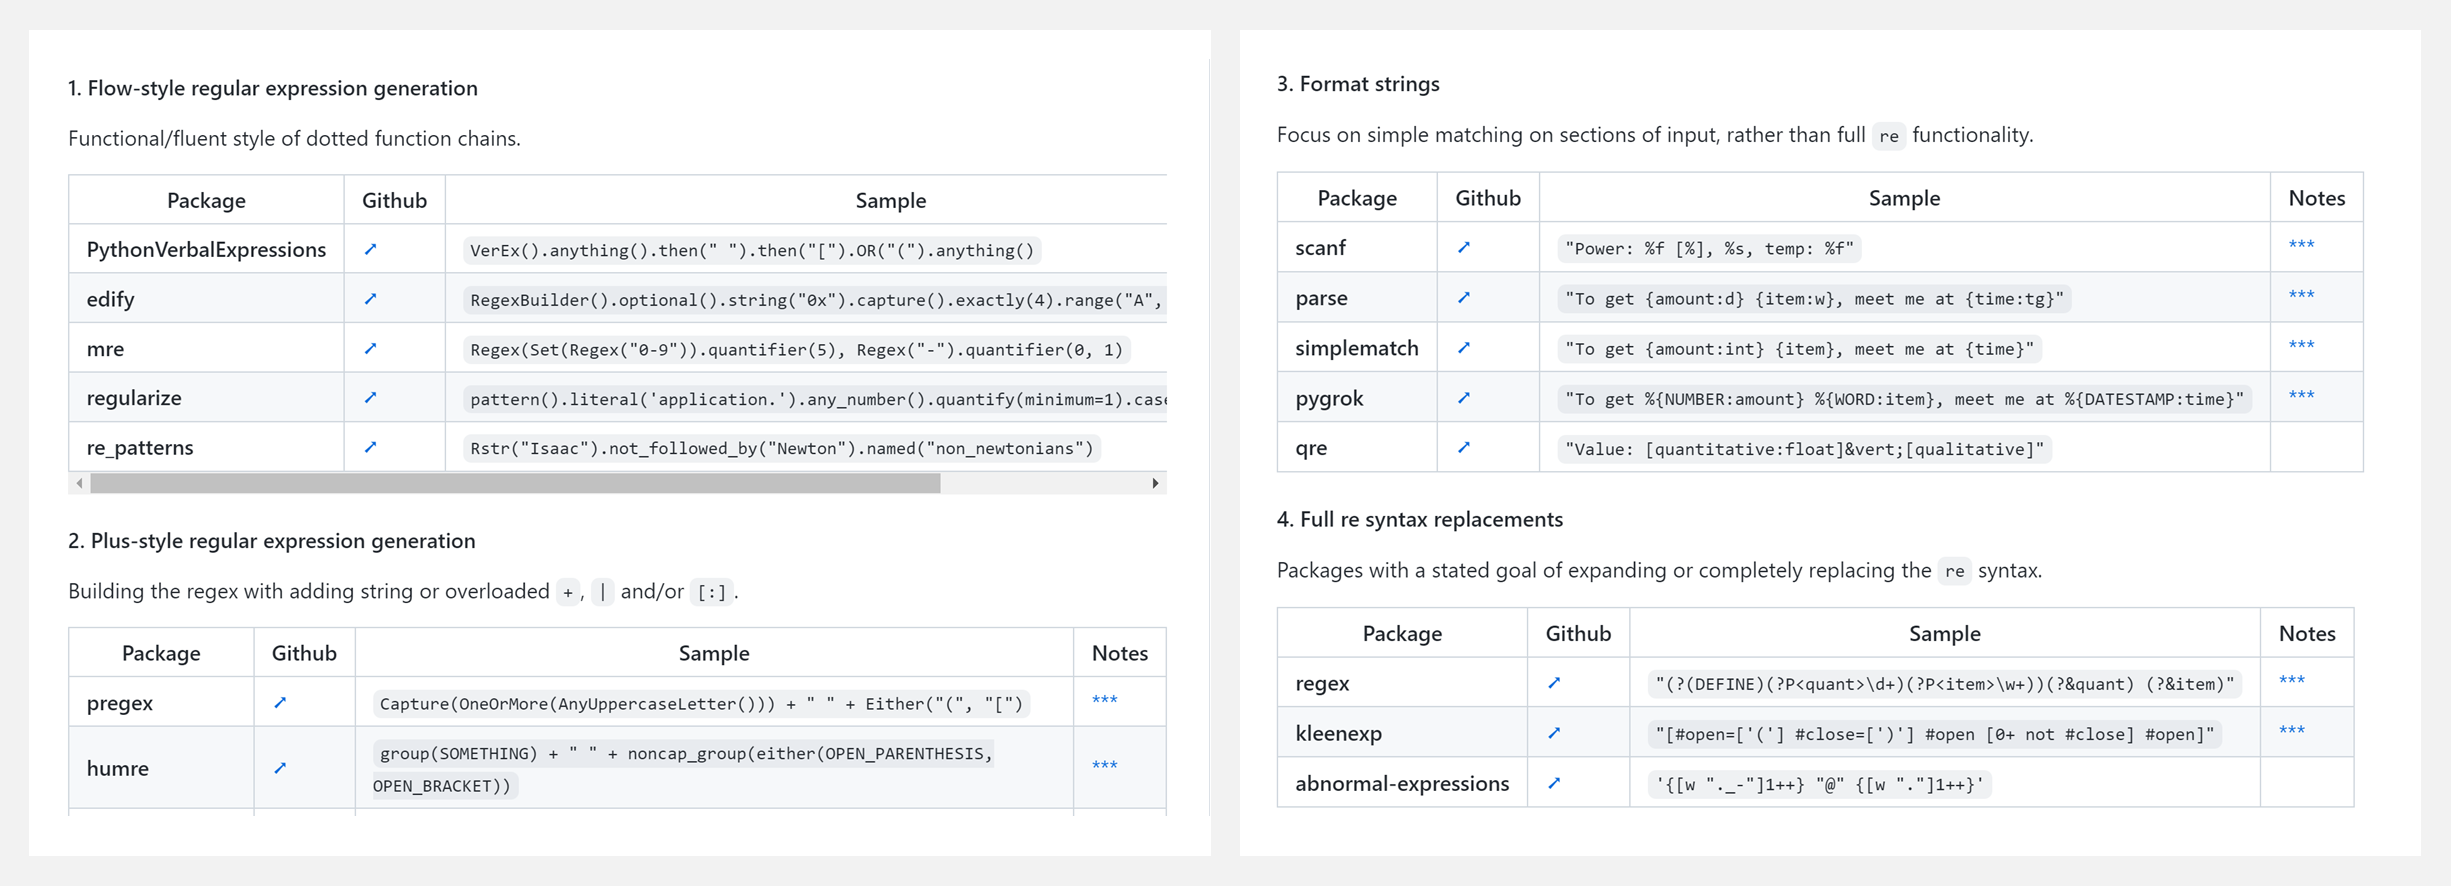
🔥 『re for humans』让 Python 正则表达式更人性化的资源列表

https://github.com/mikaelho/python-human-regex

re是 Python 标准库中一个强大的字符串匹配工具。但是正则表达式的使用有点麻烦,以至于使用频率受到限制。作者翻阅了大量 GitHub 上正则表达式的优化项目,整理成为当前的 Lis,辅助学习和写正则表达式,或者快速生成正则表达式。
研究&论文

可以点击 这里 回复关键字 日报,免费获取整理好的论文合辑。

科研进展

  • 2022.09.22 『去模糊化』 Diffusion Posterior Sampling for General Noisy Inverse Problems
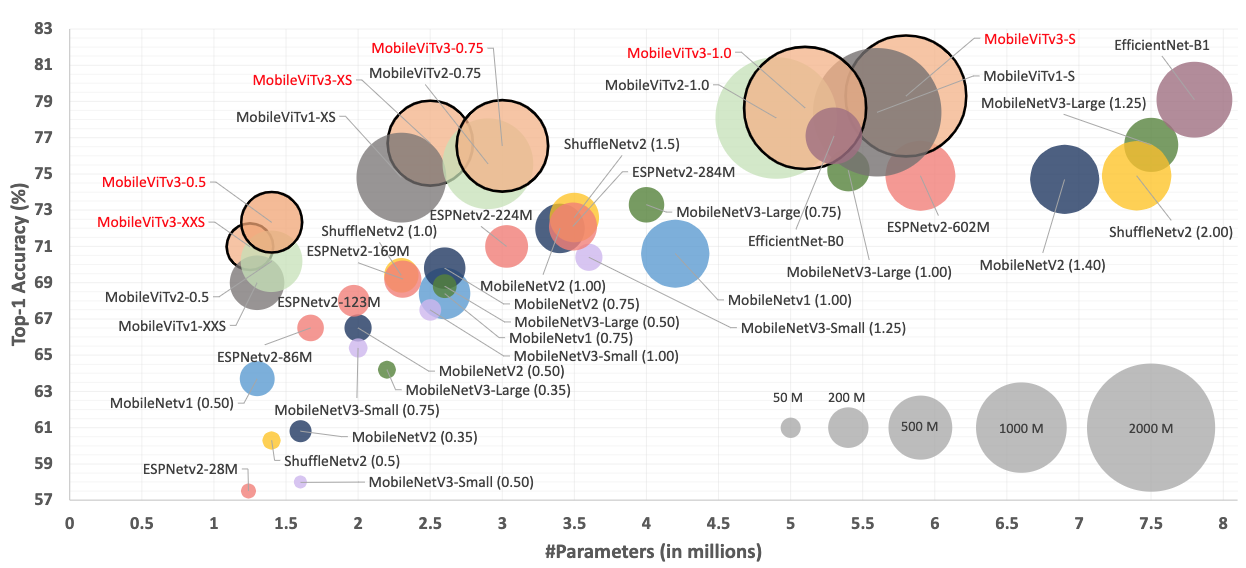
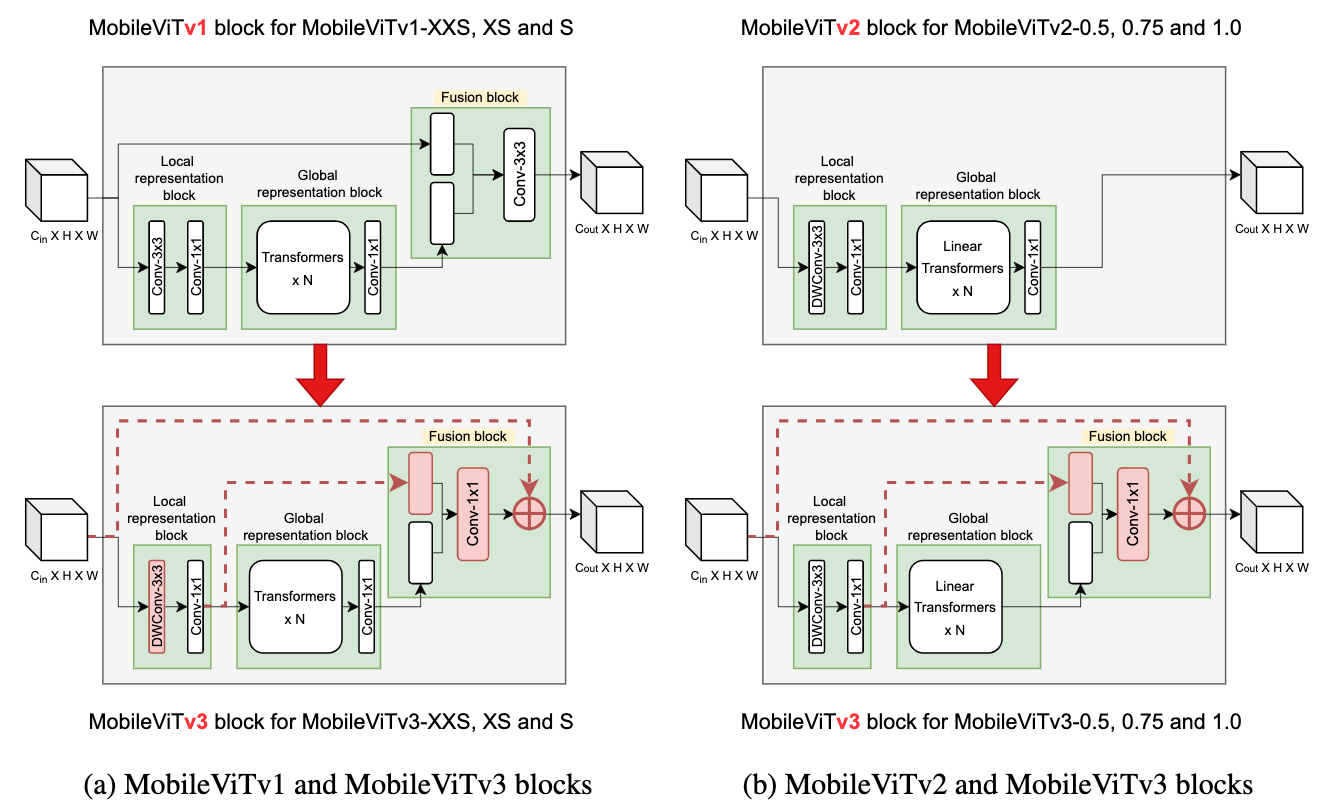
  • 2022.09.30 『计算机视觉』 MobileViTv3: Mobile-Friendly Vision Transformer with Simple and Effective Fusion of Local, Global and Input Features
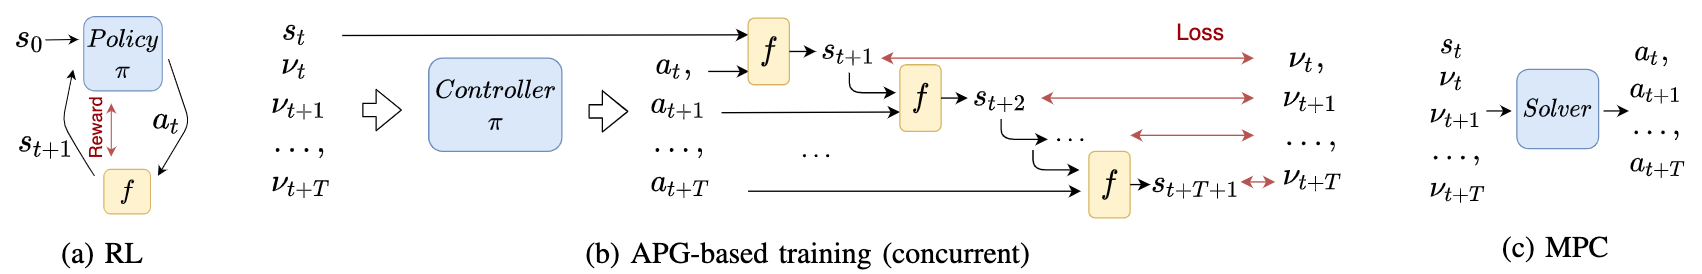
  • 2022.09.26 『强化学习』 Training Efficient Controllers via Analytic Policy Gradient

⚡ 论文:Diffusion Posterior Sampling for General Noisy Inverse Problems

论文时间:29 Sep 2022

领域任务:Deblurring,去模糊化

论文地址:https://arxiv.org/abs/2209.14687

代码实现:https://github.com/dps2022/diffusion-posterior-sampling

论文作者:Hyungjin Chung, Jeongsol Kim, Michael T. McCann, Marc L. Klasky, Jong Chul Ye

论文简介:Diffusion models have been recently studied as powerful generative inverse problem solvers, owing to their high quality reconstructions and the ease of combining existing iterative solvers./扩散模型最近被研究为强大的生成性逆向问题求解器,因为它们的高质量重建和易于结合现有的迭代求解器。

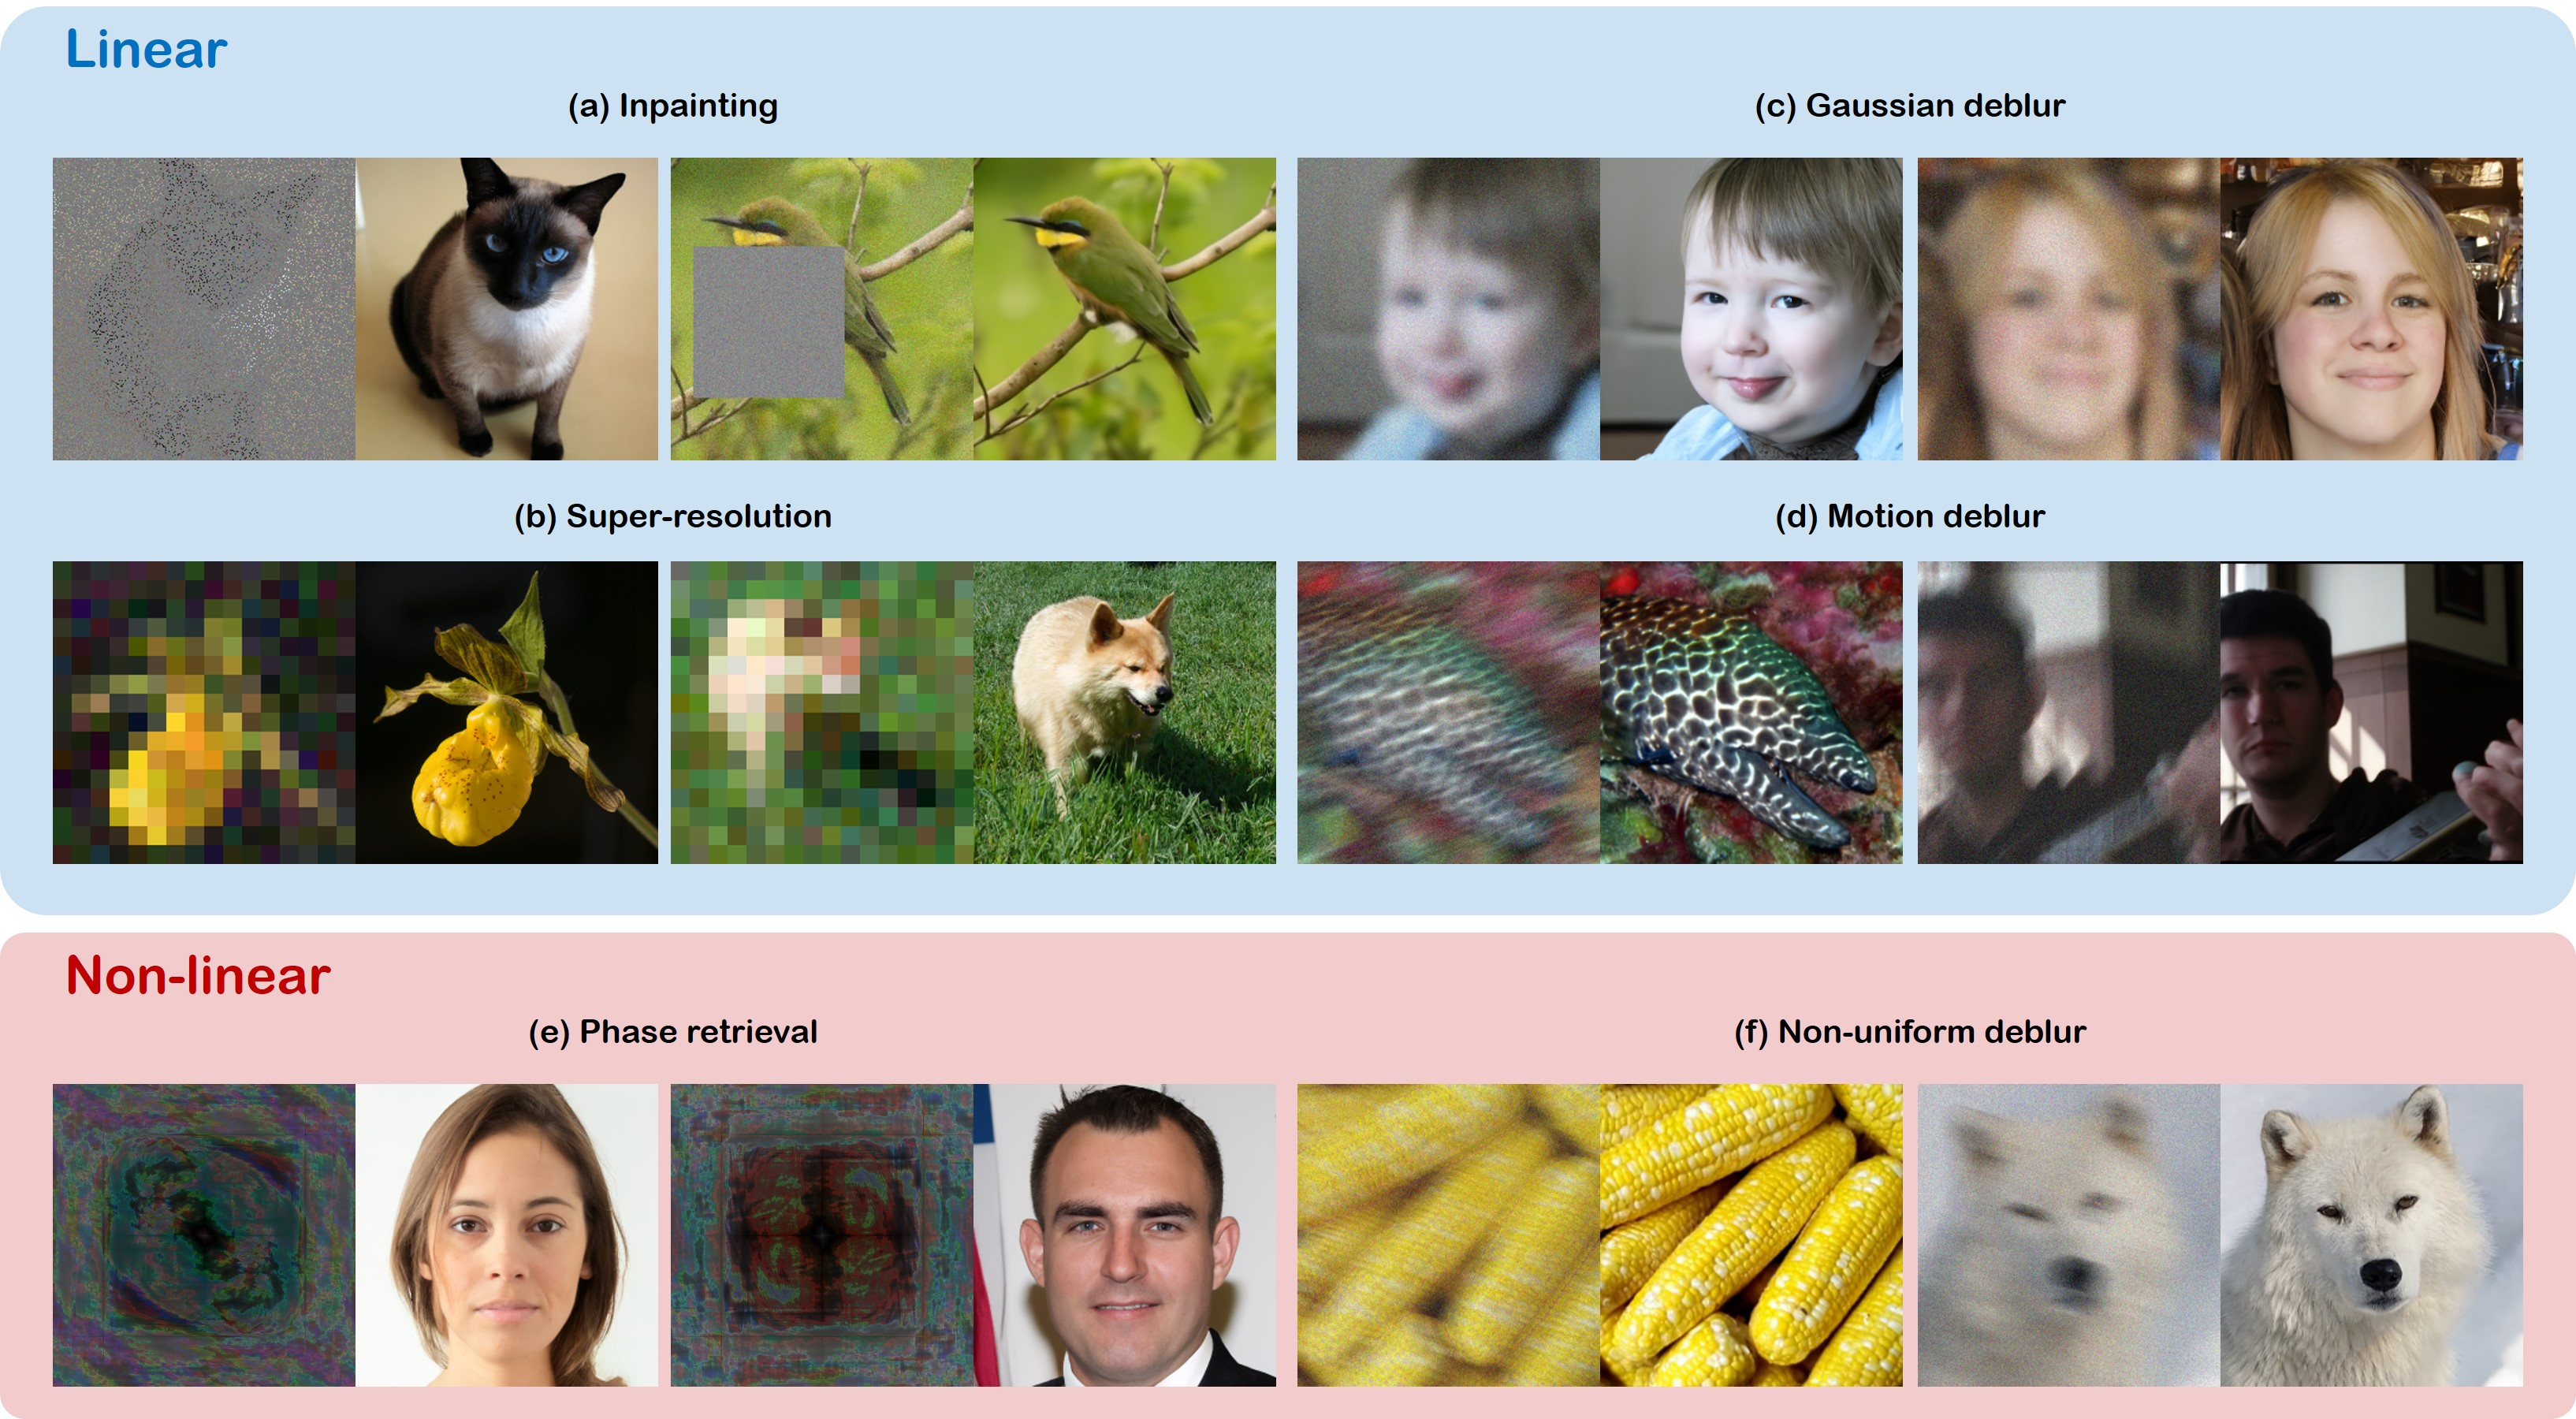
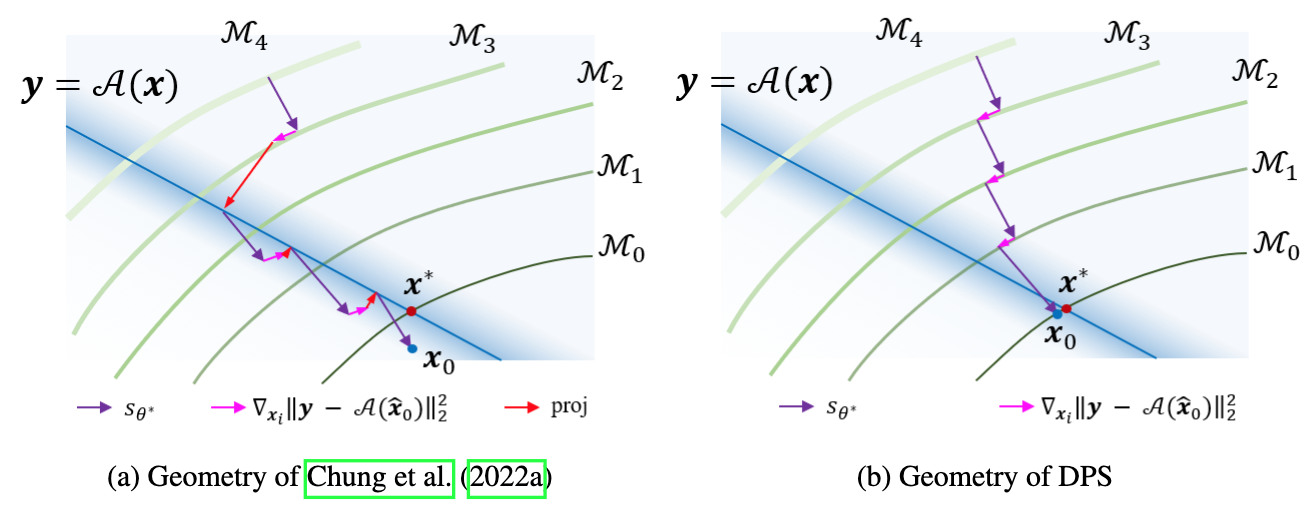
论文摘要:最近,人们将扩散模型作为强大的生成式反问题求解器来研究,这是因为它们具有高质量的重建和易于结合现有的迭代求解器。然而,大多数工作集中在解决无噪音环境下的简单线性逆向问题,这大大低于现实世界问题的复杂性。在这项工作中,我们通过后验采样的拉普拉斯近似,扩展了扩散求解器以有效地处理一般的噪声(非)线性逆问题。有趣的是,由此产生的后验采样方案是扩散采样的混合版本,具有流形约束梯度,没有严格的测量一致性投影步骤,与以前的研究相比,在噪声环境下产生了更理想的生成路径。我们的方法表明,扩散模型可以纳入各种测量噪声统计,如高斯和泊松,也可以有效地处理嘈杂的非线性反问题,如傅里叶相位检索和非均匀去模糊。
⚡ 论文:MobileViTv3: Mobile-Friendly Vision Transformer with Simple and Effective Fusion of Local, Global and Input Features

论文时间:30 Sep 2022

领域任务:计算机视觉

论文地址:https://arxiv.org/abs/2209.15159

代码实现:https://github.com/microndla/mobilevitv3

论文作者:Shakti N. Wadekar, Abhishek Chaurasia

论文简介:We propose changes to the fusion block that are simple and effective to create MobileViTv3-block, which addresses the scaling and simplifies the learning task./我们对融合块提出了简单有效的改变,以创建MobileViTv3-块,解决了缩放问题,简化了学习任务。

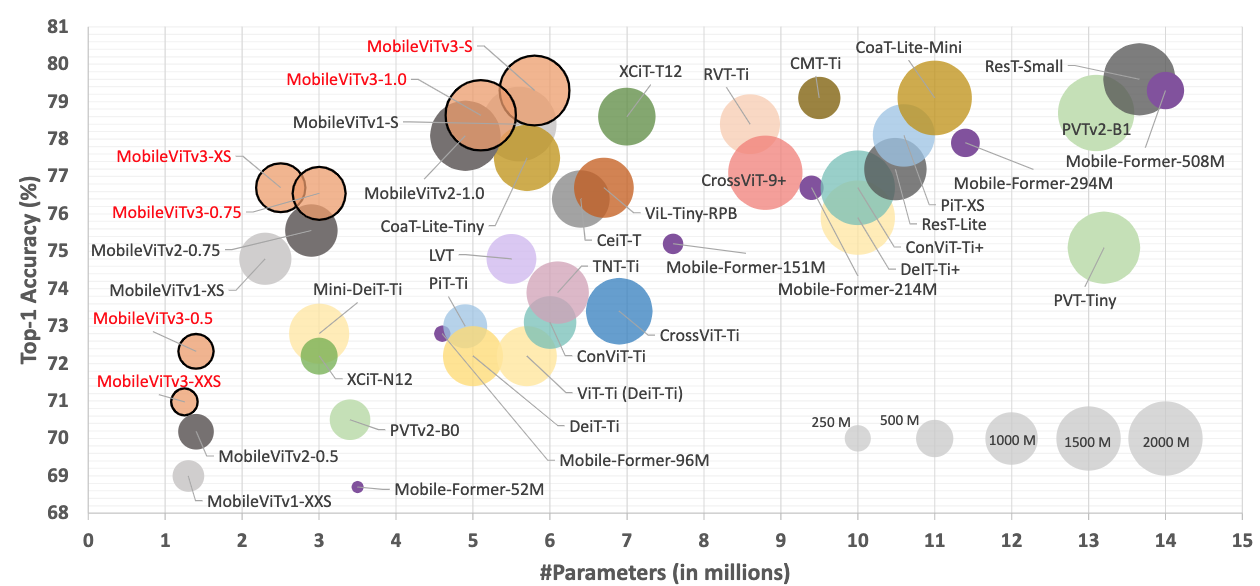
论文摘要:MobileViT(MobileViTv1)结合了卷积神经网络(CNN)和视觉transformers(ViT),为移动视觉任务创建轻量级模型。尽管主要的MobileViTv1-block有助于实现具有竞争力的最先进的结果,但MobileViTv1-block内部的融合块却带来了扩展上的挑战,并有一个复杂的学习任务。我们对融合块提出了简单而有效的修改,以创建MobileViTv3-block,它解决了扩展问题并简化了学习任务。我们提出的MobileViTv3-block用于创建MobileViTv3-XXS、XS和S模型,在ImageNet-1k、ADE20K、COCO和PascalVOC2012数据集上表现优于MobileViTv1。在ImageNet-1K上,MobileViTv3-XXS和MobileViTv3-XS分别比MobileViTv1-XXS和MobileViTv1-XS高出2%和1.9%。最近发表的MobileViTv2架构去掉了融合块,使用线性复杂度变换器,表现比MobileViTv1更好。 我们将我们提出的融合块添加到MobileViTv2中,创建MobileViTv3-0.5、0.75和1.0模型。与MobileViTv2相比,这些新模型在ImageNet-1k、ADE20K、COCO和PascalVOC2012数据集上给出了更好的准确性。MobileViTv3-0.5和MobileViTv3-0.75在ImageNet-1K数据集上比MobileViTv2-0.5和MobileViTv2-0.75分别高出2.1%和1.0%。对于分割任务,与MobileViTv2-1.0相比,MobileViTv3-1.0在ADE20K数据集和PascalVOC2012数据集上分别取得了2.07%和1.1%的mIOU。我们的代码和训练好的模型可以在以下网站上找到:https://github.com/micronDLA/MobileViTv3
⚡ 论文:Training Efficient Controllers via Analytic Policy Gradient

论文时间:26 Sep 2022

领域任务:强化学习,机器人

论文地址:https://arxiv.org/abs/2209.13052

代码实现:https://github.com/lis-epfl/apg_trajectory_tracking

论文作者:Nina Wiedemann, Valentin Wüest, Antonio Loquercio, Matthias Müller, Dario Floreano, Davide Scaramuzza

论文简介:Conversely, learning-based offline optimization approaches, such as Reinforcement Learning (RL), allow fast and efficient execution on the robot but hardly match the accuracy of MPC in trajectory tracking tasks./相反,基于学习的离线优化方法,如强化学习(RL),允许在机器人上快速有效地执行,但在轨迹跟踪任务中很难与MPC的准确性相匹配。

论文摘要:机器人系统的控制设计很复杂,经常需要解决一个优化问题来准确地跟踪轨迹。像模型预测控制(MPC)这样的在线优化方法已被证明可以实现很好的跟踪性能,但需要很高的计算能力。相反,基于学习的离线优化方法,如强化学习(RL),允许在机器人上快速有效地执行,但在轨迹跟踪任务中很难达到MPC的精度。在计算能力有限的系统中,如航空器,一个在执行时高效的精确控制器是必不可少的。我们提出了一种分析性策略梯度(APG)方法来解决这个问题。APG通过对跟踪误差进行梯度下降的离线训练,利用了可微调模拟器的可用性。我们通过课程学习来解决APG经常出现的训练不稳定问题,并在一个广泛使用的控制基准–CartPole,以及两个常见的空中机器人–四旋翼和固定翼无人机上进行实验。我们提出的方法在跟踪误差方面优于基于模型和无模型的RL方法。同时,它实现了与MPC相似的性能,而所需的计算时间却少了一个数量级以上。我们的工作提供了关于APG作为一种有前途的机器人控制方法的潜力的见解。为了促进对APG的探索,我们开源了我们的代码,并将其放在 https://github.com/lis-epfl/apg_trajectory_tracking
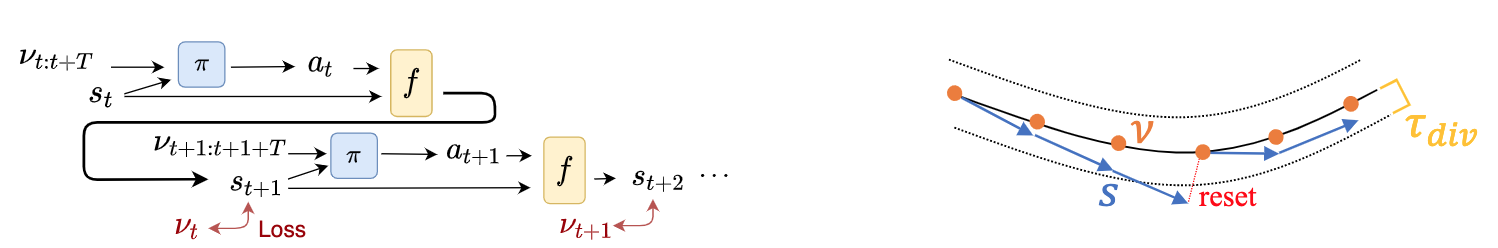
我们是 ShowMeAI,致力于传播AI优质内容,分享行业解决方案,用知识加速每一次技术成长!

◉ 点击 日报合辑,在公众号内订阅话题 #ShowMeAI资讯日报,可接收每日最新推送。

◉ 点击 电子月刊,快速浏览月度合辑。

◉ 点击 这里 ,回复关键字 日报 免费获取AI电子月刊与论文 / 电子书等资料包。
音效设计师必备:AIGC音频生成工具大盘点 本文旨在为音效设计师、游戏开发者、影视制作人和音乐创作者提供一份全面的AIGC音频生成工具指南。我们将覆盖从基础语音合成到复杂音乐创作的各类AI音频工具,分析它们的技术原理、使用方法和实际应用场景。本文将首先介绍AIGC音频技术的基本概念,然后分类盘点当前主流工具,深入分析其技术原理,提供实际应用案例,最后展望未来发展趋势。AIGC:人工智能生成内容(Artificial Intelligence Generated Content),指由AI算法自动生成的各种形式的内容TTS。 阅读详情

相关推荐

音频生成(Audio Generation) 原理与代码实例讲解

音频生成(Audio Generation) - 原理与代码实例讲解 作者:禅与计算机程序设计艺术 / Zen and the Art of Computer Programming 1. 背景介绍 1.1 问题的

AGI×大数据,开启智能时代的认知跃迁;解码AGI,赋能数据驱动的智能革命。 363

DIFFUSION POSTERIOR SAMPLING FOR GENERALNOISY INVERSE PROBLEMS (Paper reading)

大多数工作都集中在在无噪声环境中解决简单的线性逆问题,这显著低估了真实世界问题的复杂性。在这项工作中,通过近似后验采样来扩展扩散求解器,有效的处理了一般的有噪声(非)线性逆问题。有趣的是,得到的后验采样方案是扩散采样与流形约束梯度的混合版本,而没有严格的测量一致性投影步骤,在有噪声环境中相比于之前的研究产生了更理想的生成路径。我们的方法展示了扩散模型可以结合各种测量噪声统计,如高斯和泊松,并且也能有效地处理有噪声非线性逆问题,如傅里叶相位恢复和非均匀去模糊。

qq_43800752的博客 1334

“MobileViTv3系列:基于Transformer的轻量化视觉转换器,有效融合本地全局和输入特征,提高计算机视觉效率“。

此外,MobileViTv3还引入了全局上下文编码器(GCE)和输入特征编码器(IFE),以有效融合本地全局和输入特征,从而提高计算机视觉的效率和准确率。一项名为MobileViTv3的新技术,成功地将Transformer技术应用到计算机视觉中。这项技术使用了轻量化的Transformer视觉转换器,并通过融合本地全局和输入特征,成功提高了计算机视觉的效率。MobileViTv3的成功应用为计算机视觉领域带来了新的可能性,相信未来在这个领域还会催生更多的潜力技术,我们将持续关注和报道。

YjmnDatabase的博客 768

DIFFUSION POSTERIOR SAMPLING FOR GENERAL NOISY INVERSE PROBLEMS

在最近的研究中,扩散模型被作为强大的生成逆问题求解器,因其高质量的重建和结合现有迭代求解器的便利性。然而,大多数研究侧重于在无噪声设置中解决简单的线性逆问题,这在很大程度上低估了真实世界问题的复杂性。在这项工作中,我们通过后验采样的逼近,将扩散求解器有效地扩展到处理一般的带噪声(非)线性逆问题。有趣的是,所得到的后验采样方案是扩散采样与流形约束梯度的混合版本,而无需严格的测量一致性投影步骤,在噪声环境中相比先前的研究具有更理想的生成路径。

qq_42208244的博客 2657

芯片设计数字后仿与SDF文件:原理、流程与实战调试指南

在数字芯片设计流程中,时序验证是确保芯片功能正确与性能达标的核心环节。其原理在于通过精确的物理延迟模型,模拟信号在真实硅片上的传播行为,从而暴露理想仿真中无法发现的时序问题。这项技术的核心价值在于它是连接前端逻辑设计与后端物理实现的桥梁,能有效发现建立时间/保持时间违例、时钟偏斜、竞争冒险等关键风险,是保障芯片一次流片成功的关键步骤。其典型应用场景包括高性能计算单元、复杂SoC以及低功耗设计中的状态切换验证。本文聚焦于数字后仿真的具体实施,深入解析SDF文件的结构与反标机制,并提供从环境搭建、波形分析到与静

weixin_34279184的博客 382

从编解码芯片看Tesla T4的隐藏实力:双NVDEC如何实现70路1080P解码?

本文深入剖析了英伟达Tesla T4显卡的隐藏实力,重点解读其独特的双NVDEC硬件解码器设计如何突破性能瓶颈。通过分析Turing架构、对比HEVC/H.264解码差异,并结合驱动与SDK优化,揭示了实现高达70路1080P视频流并发解码的原理与实战配置,为云游戏、直播转码等高并发场景提供高效解决方案。

weixin_29209801的博客 489

(2023|ICLR,Diffusion & 逆问题 & 后验近似)用于一般噪声反演问题的扩散后验采样

扩散模型是强大的生成逆问题求解器,但大多数工作都专注于在无噪条件下解决简单的线性逆问题,这大大低估了现实世界问题的复杂性。本文扩展了扩散求解器,通过后验采样的近似来有效地处理一般的噪声(非线性)线性逆问题。

qq_44681809的博客 3150

ESP32-BLE学习1-建立简单的server

start 学习之前,我想尝试使用ESP32的demo建立一个简单的server与手机接进行最基本的数据通信。 这里有BLE的简单讲解BLE资料 因为BLE的连接是具有主从机特性的,就像SPI,USB一些请求只能由主机端发起,连接也需要主机端发起。所以手机要想连上ESP32,就得将ESP32设置为从机模式。 从资料上可以看到,从机端通过Notify通知主机,所以从机就是GATT Server。 在进行ESP32 的demo学习之前,得大体看下ESP32的蓝牙组成,ESP32支持经典蓝牙和低功耗蓝牙4.2,

Spark的博客 1845

Parallel Diffusion Models of Operator and Image for Blind Inverse Problems (Paper reading)

基于扩散模型的逆问题求解器在前向算子已知(即非盲)的情况下表现出了最先进的性能。然而,该方法在盲逆问题中的适用性尚未探究。在这项工作中,作者通过为前向算子构建另一个扩散先验,展示了可以通过并行反向扩散来解决一类盲逆问题。具体来说,由中间阶段梯度引导的并行反向扩散使前向算子参数和图像的联合优化成为可能,使得两者都在并行反向扩散过程结束时被联合估计。作者展示了该方法在两个代表性任务——盲去模糊和湍流成像——上的有效性,并表明该方法具有最先进的性能,同时也具有灵活性,可以应用于一般盲逆问题。

qq_43800752的博客 584

二阶高通滤波器硬件设计:5种RC到有源方案对比与选型

在传感器前端和音频信号调理中,二阶高通滤波器是抑制直流偏移与低频干扰的关键模块。其设计核心围绕截止频率、品质因数Q、增益与噪声四个指标展开,其中Q值决定滤波器在转折频率附近的响应形状,如Butterworth最大平坦响应需Q=0.707。从纯无源RC电路到引入运放的有源拓扑,演变逻辑在于解决负载效应、提供增益并借助反馈提升Q值。实际工程中,RC级联、VCVS(Sallen-Key)、状态变量及回转器模拟电感等方案各有适用场景:RC电路简单但Q值受限,Sallen-Key单运放即可实现高Q,状态变量适合Q值独

weixin_32770423的博客 105

尚硅谷Redis 7学习笔记

尚硅谷Redis 7学习笔记

不更了,主打一个陪伴 2万+

【亲测免费】 Cozy-Auto-Texture 项目教程

Cozy-Auto-Texture 项目教程 1. 项目的目录结构及介绍 Cozy-Auto-Texture 是一个用于 Blender 的插件,用于生成基于 Stable Diffusion AI 的纹理。以下是项目的目录结构及各部分的简要介绍: Cozy-Auto-Texture/ ├── src/ │ ├── __init__.py │ └── ... ├── tests/ │ ...

gitblog_00430的博客 580

无线通信技术及其在机器人中的应用

本文系统阐述了无线通信技术在机器人领域的应用框架与技术选型。首先构建了无线通信的三层理论架构:物理层解决信号传输问题,链路层处理接入控制,网络层实现组网管理。随后详细分析了主流无线技术的特性与适用场景:BLE适用于低功耗传感器节点,Wi-Fi适合高带宽视频传输,5G专网满足工业AGV的广域覆盖需求,星闪技术凭借20μs超低时延和4096台并发连接能力,为高端机器人应用提供突破性解决方案。通过鄂尔多斯隆基5G专网等典型案例,验证了5G在工业AGV规模化部署中的优势,并展望了通感算智融合、星闪+5G协同等未来发

weiyvyy的博客 1117

Diffusion Posterior Sampling(扩散后验采样)理论讲解

本文围绕DPS(Diffusion Posterioe Sampling)展开,简要回顾了扩散模型以及贝叶斯方法,并对DPS的理论推导思路作了一个大致的讲解

m0_74120856的博客 5661

【教程4>第6章>第15节】 基于I+jQ复数信号的LS信道估计和均衡实现1——matlab仿真分析,QPSK为例

在基于QPSK调制的通信系统中,LS信道估计和均衡是用于补偿信道失真、提高信号传输质量的重要技术。以下将详细介绍基于I+jQ复数信号的 LS 信道估计和均衡的实现原理与过程。可以看到,通过线性插值之后,QPSK信号的星座图可以模糊的看到四个星座点(图2),通过非线性插值之后,可以清晰的看到QPSK的四个星座点(图3)。可以看到,信道均衡显著提高了通信系统的可靠性和有效性。

FPGA/MATLAB学习教程/源码/项目合作开发 657

YOLOv8 智能交通流量监测完整解决方案

YOLOv8智能交通流量监测系统基于先进的目标检测技术,提供实时车辆识别与统计分析功能。该系统通过虚拟检测线实现多方向车流量统计,支持多种车辆类型分类,并具备数据可视化、异常事件预警等核心功能。完整解决方案包含模型训练、实时检测、批量处理、结果分析等模块,并提供Flask API和Docker两种部署方案。系统采用YOLOv8算法实现高效检测,支持GPU加速,可通过量化、剪枝等技术进一步优化性能,为智能交通管理提供可靠的数据支持和技术保障。

u010117029的博客 119

探索纹理创作新境界:Cozy Auto Texture 开源项目推荐

探索纹理创作新境界:Cozy Auto Texture 开源项目推荐 在这个数字艺术与游戏开发的黄金时代,纹理制作一直是创意过程中不可或缺的一环。今天,我们有幸向您推荐一款革命性的工具——Cozy Auto Texture,它将Blender的强大功能与Stable Diffusion的人工智能技术完美融合,开启了一种全新的自动纹理创建方式。 项目介绍 Cozy Auto Texture,作为由L...

gitblog_00938的博客 1157

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

你需要了解的6大AI音频生成工具

深入了解风靡整个行业的前 6 名 AI 音频生成工具。从语音合成器到音乐作曲家,发现这些工具令人印象深刻的功能,并通过音频制作的未来释放您的创造力。在这篇综合博客文章中了解更多信息。

qq_61813593的博客 1万+

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

爬虫小工具——正则表达式

最近,在上爱可可的python爬虫课,有一些好的小工具可以分享。 1.在线正则表达式 RegExr: Learn, Build, & Test RegEx 块1:RegExr的整体功能概览,可用的是cheatsheet,这是指正则常用的几种方法,就可以看着cheatsheet,写最基础的正则表达式 块2:正则表达式,在这里输入test pattern,进行调试,需要对\与空格需要注意,空格\s,\\进行转义 块3:需要匹配的正文 块4:list 可以看到结果,replace就进行.

weixin_40713373的博客 750

Python正则表达式在线练习(网页版)和离线练习(本地版)

Python正则表达式的使用,包括离线版(本地版)和在线版(网页版),都是开源免费的工具哦!

北极熊在南极_whl的博客 3630

使用 大模型快速生成-jsToJava 的正则表达式离线版本的简单html页面

/ 在Java中,正则表达式通常被双引号包围,并且可能需要用Pattern.compile来编译。// 转义单引号(如果原始JS正则表达式包含)// 转义双引号(如果原始JS正则表达式包含)// 处理可能需要在Java中转义的字符。// 输出转换后的Java正则表达式。

优快云博客专家、华为云享专家、Java领域新星创作者 946

正则表达式——7种免费测试工具

在本文中,我们将概述创建和测试正则表达式的免费工具。即使一个人熟练地创建正则表达式,如果它们很复杂或者你不经常这样做,最好有一个可用的工具来测试不同文本上的正则表达式并验证它们是否正常工作。

寒冰屋的专栏 1万+

李宏毅DLHLP.13.Speech Synthesis.1/2.Tacotron

文章目录介绍TTS before End-to-endConcatenative ApproachParametric ApproachDeep VoiceTacotron:End-to-end TTSEncoder 类似 Grapheme-to-phonemeAttention类似Modeling DurationDecoder :Audio Synthesis 介绍 本门课程是2020年李宏毅老师新课:Deep Learning for Human Language Processing(深度学习与人类

老毛的博客 955

从公式到语音:如何用 AI 把 LaTeX 数学试卷变成自然语言讲稿?

通过这次探索,我发现无论是 AI 还是规则转换,都有各自的优势。AI 的灵活性和强大的语言生成能力让它在处理复杂的文本时更具优势,而规则转换的精准性和可控性则让它在处理数学公式等细节时更加出色。有任何问题,欢迎大家留言交流。

wxaiway的博客 1580

音频合成与音频生成的关系与研究

1.背景介绍 音频合成和音频生成是计算机音频处理领域中的两个重要概念。音频合成通常指的是将不同音频信号(如音频剪辑、MIDI信号等)组合成一个新的音频信号,以创建新的音乐作品或者增强现有的音频内容。音频生成则更广泛地指的是通过算法、模型或者其他方法直接生成音频信号,而不依赖于现实世界中的任何音频信号。 在过去的几年里,随着深度学习和人工智能技术的发展,音频合成和音频生成的研究取得了显著的进展。...

AI天才研究院 1414
上一篇: 全球名校AI课程库(31)| MIT麻省理工 · 深度学习导论课程『Introduction to Deep Learning』
下一篇: 全球名校AI课程库(30)| MIT麻省理工 · 深度学习与无人驾驶课程『Deep Learning for Self-Driving Cars』
ShowMeAI
博客等级 码龄5年 6514粉丝 672原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

ShowMeAI

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值