


- 作者:韩信子@ShowMeAI
- 教程地址:https://www.showmeai.tech/tutorials/35
- 本文地址:https://www.showmeai.tech/article-detail/225
- 声明:版权所有,转载请联系平台与作者并注明出处
- 收藏ShowMeAI查看更多精彩内容
本系列为吴恩达老师《深度学习专项课程(Deep Learning Specialization)》学习与总结整理所得,对应的课程视频可以在这里查看。
引言
在ShowMeAI前一篇文章 CNN应用:人脸识别和神经风格转换 中我们对以下内容进行了介绍:
- 人脸识别
- Siamese网络
- 三元组损失Triplet loss
- 人脸验证
- CNN表征
- 神经网络风格迁移
- 1D与3D卷积
本篇内容开始我们将对吴恩达老师的第5门课《Recurrent Neural Networks》进行总结梳理。这门课主要介绍循环神经网络(RNN)的基本概念、模型结构细节和具体应用。
自然语言(文本)和音频都是时序前后相互关联的数据,对于这些序列数据我们会使用特殊的神经网络:循环神经网络(Recurrent Neural Network,RNN)来进行处理。使用RNN实现的应用包括下图中所示:
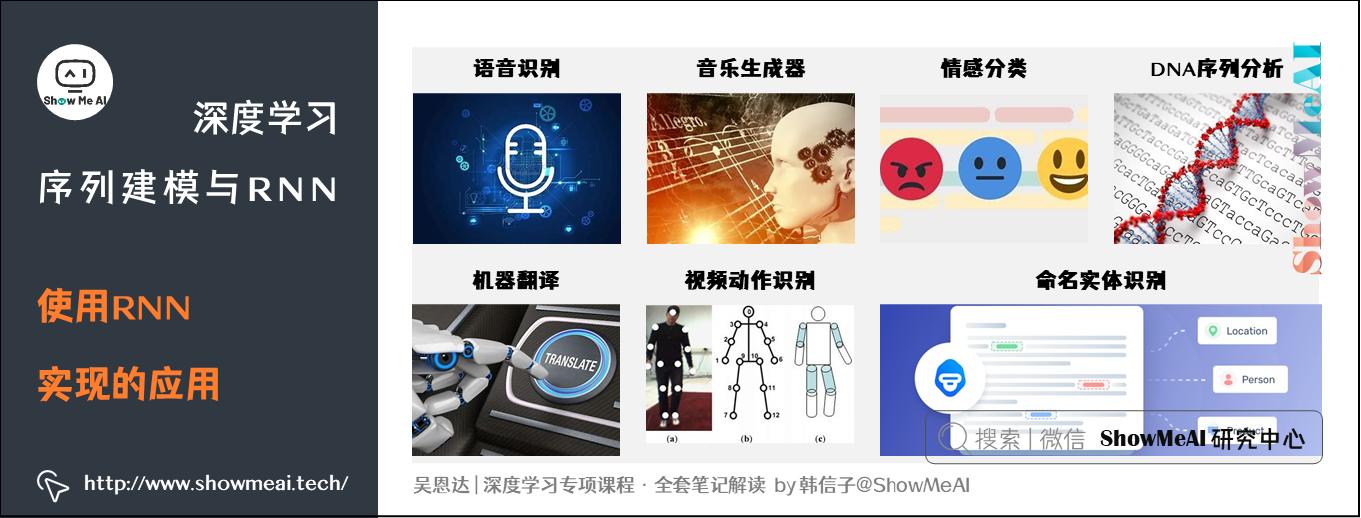
- 语音识别
- 音乐发生器
- 情感分类
- DNA序列分析
- 机器翻译
- 视频动作识别
- 命名实体识别
1.数学符号
我们来看一个自然语言处理中「命名实体识别」的例子,了解一下序列模型的数学符号命名规则。
示例语句为:王刚和李明去上班了
该句话包含9个字,简单地表示 y y y即为 1 × 9 1 \times 9 1×9向量,每位对应字是否为人名的一部分, 1 1 1表示是, 0 0 0表示否。很明显,该句话中「王」,「刚」,「李」,「明」均是人名成分,所以,对应的输出 y y y可表示为:
y = [ 1 1 0 1 1 0 0 0 0 ] y = \begin{bmatrix} 1\\ 1\\ 0\\ 1\\ 1\\ 0\\ 0\\ 0\\ 0 \end{bmatrix} y=⎣ ⎡110110000⎦ ⎤
用 y ⟨ t ⟩ y^{\left \langle t \right \rangle} y⟨t⟩表示序列对应位置的输出,使用 T y T_y Ty表示输出序列长度,我们有 1 ≤ t ≤ T y 1\leq t\leq T_y 1≤t≤Ty。
我们把输入 x x x表示为:
x = [ x ⟨ 1 ⟩ x ⟨ 2 ⟩ x ⟨ 3 ⟩ x ⟨ 4 ⟩ x ⟨ 5 ⟩ x ⟨ 6 ⟩ x ⟨ 7 ⟩ x ⟨ 8 ⟩ x ⟨ 9 ⟩ ] x = \begin{bmatrix} x^{\left \langle 1 \right \rangle}\\ x^{\left \langle 2 \right \rangle}\\ x^{\left \langle 3 \right \rangle}\\ x^{\left \langle 4 \right \rangle}\\ x^{\left \langle 5 \right \rangle}\\ x^{\left \langle 6 \right \rangle}\\ x^{\left \langle 7 \right \rangle}\\ x^{\left \langle 8 \right \rangle}\\ x^{\left \langle 9 \right \rangle} \end{bmatrix} x=⎣ ⎡x⟨1⟩x⟨2⟩x⟨3⟩x⟨4⟩x⟨5⟩x⟨6⟩x⟨7⟩x⟨8⟩x⟨9⟩⎦ ⎤
其中, x ⟨ t ⟩ x^{\left \langle t \right \rangle} x⟨t⟩表示序列对应位置的输入, T x T_x Tx表示输入序列长度。注意,在当前序列标注示例汇总, T x = T y T_x=T_y Tx=Ty,其他序列问题也存在 T x ≠ T y T_x\neq T_y Tx=Ty的情况。
我们用什么样的方式来表示 x ⟨ t ⟩ x^{\left \langle t \right \rangle} x⟨t⟩呢,在机器学习场景下我们依旧希望是向量化的表征,一种方法是我们会构建一个囊括大部分出现的字的词汇库vocabulary。例如一个包含10000个字的词汇库为:
[ 我 你 ⋅ ⋅ ⋅ 王 ⋅ ⋅ ⋅ 刚 ⋅ ⋅ ⋅ 置 ] \left[ \begin{matrix} 我 \\ 你 \\ \cdot \\ \cdot \\ \cdot \\ 王 \\ \cdot \\ \cdot \\ \cdot \\ 刚 \\ \cdot \\ \cdot \\ \cdot \\ 置 \end{matrix} \right] ⎣ ⎡我你⋅⋅⋅王⋅⋅⋅刚⋅⋅⋅置⎦ ⎤
该词汇库可看成是 10000 × 1 10000 \times 1 10000×1的向量。注意,在自然语言处理中,针对不同的问题,我们构建的词汇库的基础元素是不一样的,命名实体识别场景下会用字,有些场景下会用词(中文有分词操作),有些大型任务下的词汇库可达百万级别的词汇量。
构建了词汇库之后,可以基于one-hot编码,把居中每个 x ⟨ t ⟩ x^{\left \langle t \right \rangle} x⟨t⟩都表示成 10000 × 1 10000 \times 1 10000×1的向量,词汇表中与 x ⟨ t ⟩ x^{\left \langle t \right \rangle} x⟨t⟩对应的位置为1,其它位置为0。有时候会出现词汇表之外的单词,可以使用UNK或其他字符串来占位表示。
多样本的情况,以上序列模型对应的命名规则可表示为: X ( i ) ⟨ t ⟩ X^{(i){\left \langle t \right \rangle}} X(i)⟨t⟩, y ( i ) ⟨ t ⟩ y^{(i){\left \langle t \right \rangle}} y(i)⟨t⟩, T x ( i ) T_x^{(i)} Tx(i), T y ( i ) T_y^{(i)} Ty(i)。其中, i i i表示第 i i i个样本。不同样本的 T x ( i ) T_x^{(i)} Tx(i)或 T y ( i ) T_y^{(i)} Ty(i)都有可能不同。
2.循环神经网络模型
对于序列模型,如果使用标准的神经网络,其模型结构如下:
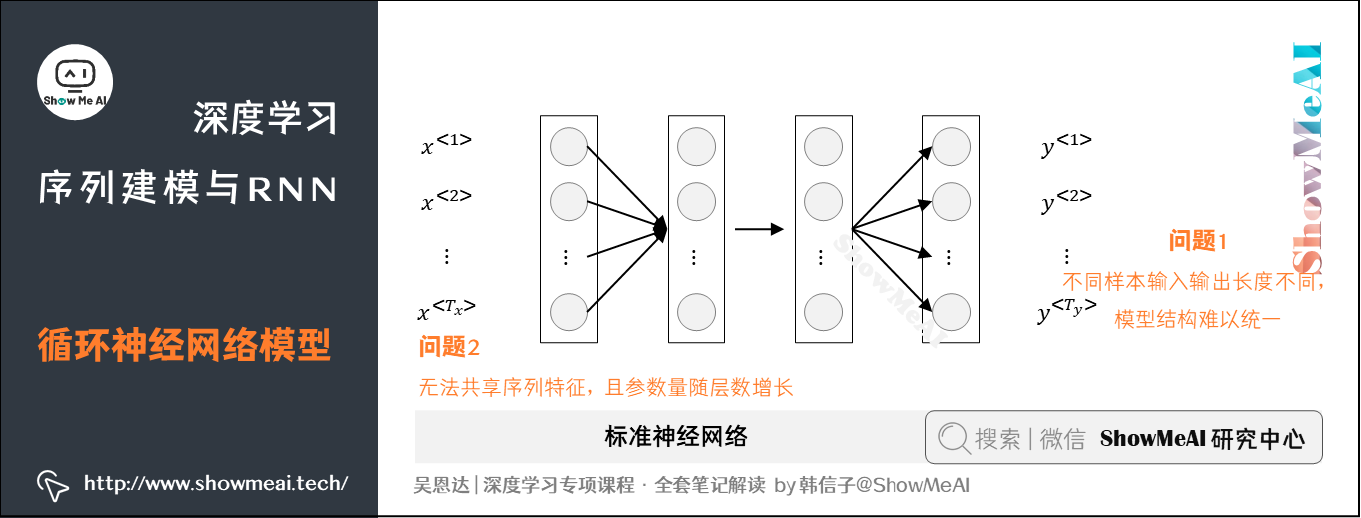
使用标准的神经网络模型存在两个问题:
① 不同样本的输入序列长度或输出序列长度不同,即 T x ( i ) ≠ T x ( j ) T_x^{(i)}\neq T_x^{(j)} Tx(i)=Tx(j), T y ( i ) ≠ T y ( j ) T_y^{(i)}\neq T_y^{(j)} Ty(i)=Ty(j),造成模型难以统一。
- 解决办法之一是设定一个最大序列长度,对每个输入和输出序列补零并统一到最大长度。但是这种做法实际效果并不理想。
② 标准神经网络结构无法共享序列不同 x ⟨ t ⟩ x^{\left \langle t \right \rangle} x⟨t⟩之间的特征。
-
例如,如果某个 x ⟨ t ⟩ x^{\left \langle t \right \rangle} x⟨t⟩即「王」是人名成分,那么句子其它位置出现了「王」,也很可能也是人名。这是共享特征的结果,如同CNN网络特点一样。但是,上图所示的网络不具备共享特征的能力。
-
共享特征还有助于减少神经网络中的参数数量,一定程度上减小了模型的计算复杂度。例如上图所示的标准神经网络,假设每个 x ⟨ t ⟩ x^{\left \langle t \right \rangle} x⟨t⟩扩展到最大序列长度为100,且词汇表长度为10000,则输入层就已经包含了 100 × 10000 100 \times 10000 100×10000个神经元了,权重参数很多,运算量将是庞大的。
综上,我们了解到标准神经网络和CNN都不适合解决序列建模问题,而有一类神经网络:循环神经网络(Recurrent Neural Network,RNN)非常擅长处理序列建模问题的。它的典型结构如下:
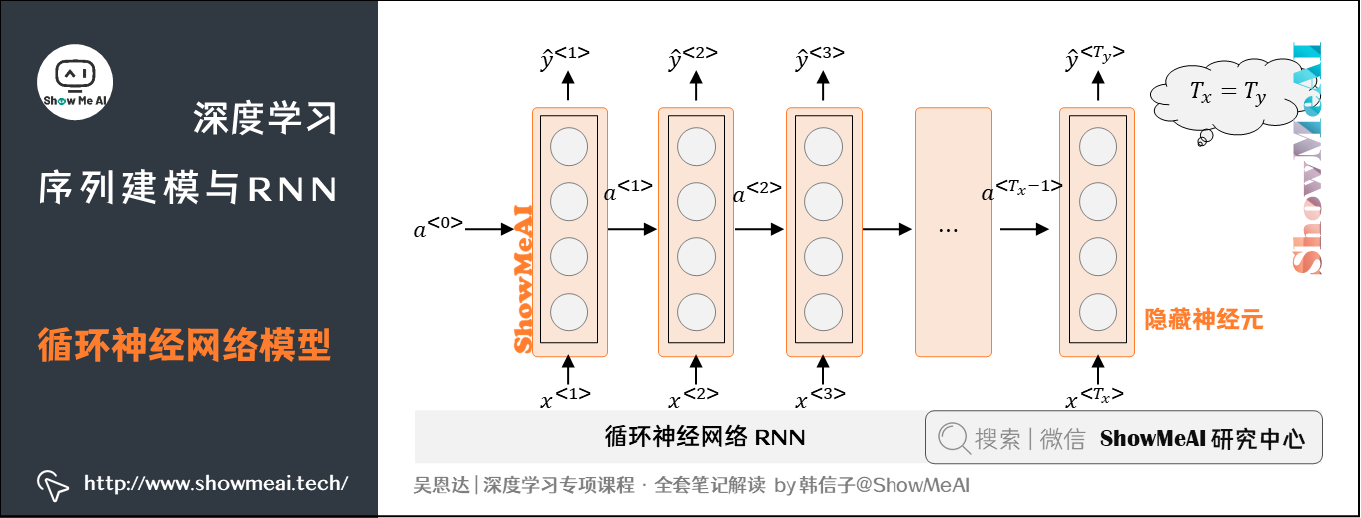
这是一个沿着序列从左到右依次传递(展开)的模型。上面的例子中,输入输出长度直接有 T x = T y T_x=T_y Tx=Ty的关系。模型里 x ⟨ t ⟩ x^{\left \langle t \right \rangle} x⟨t⟩与 y ^ ⟨ t ⟩ \hat{y}^{\left \langle t \right \rangle} y^⟨t⟩之间是隐藏神经元。 a ⟨ t ⟩ a^{\left \langle t \right \rangle} a⟨t⟩会传入到第 t + 1 t+1 t+1个元素中,作为输入。初始的 a ⟨ t ⟩ a^{{\left \langle t \right \rangle}} a⟨t⟩一般为零向量。
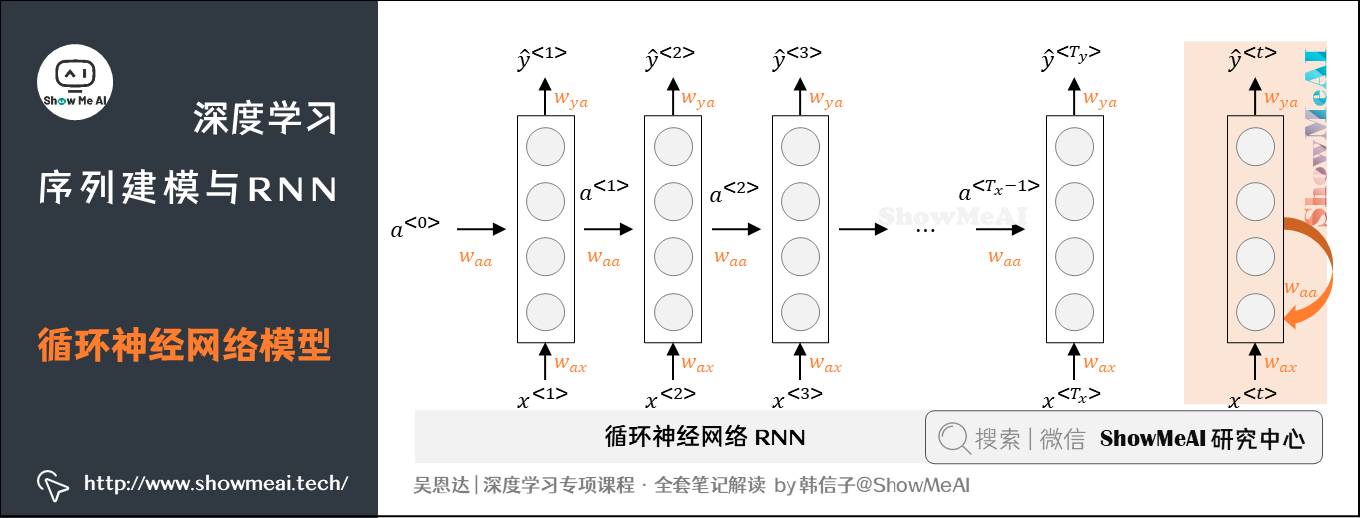
RNN包含三类权重系数 W y a , W a a , W a x W_{ya},W_{aa},W_{ax} Wya,Waa,Wax且每个时间步是共享这3组权重的。如下图所示:
2.1 前向传播(Forward Propagation)
我们来展开看看RNN,下图是每个时间步的神经元展开的内部结构:
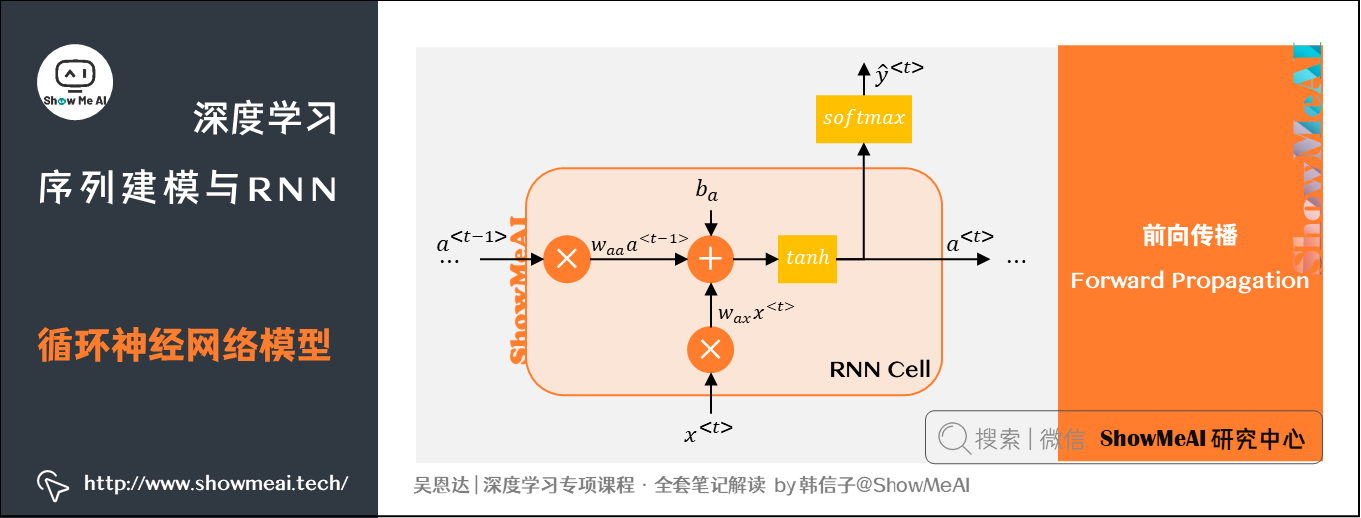
前向传播过程的计算公式如下:
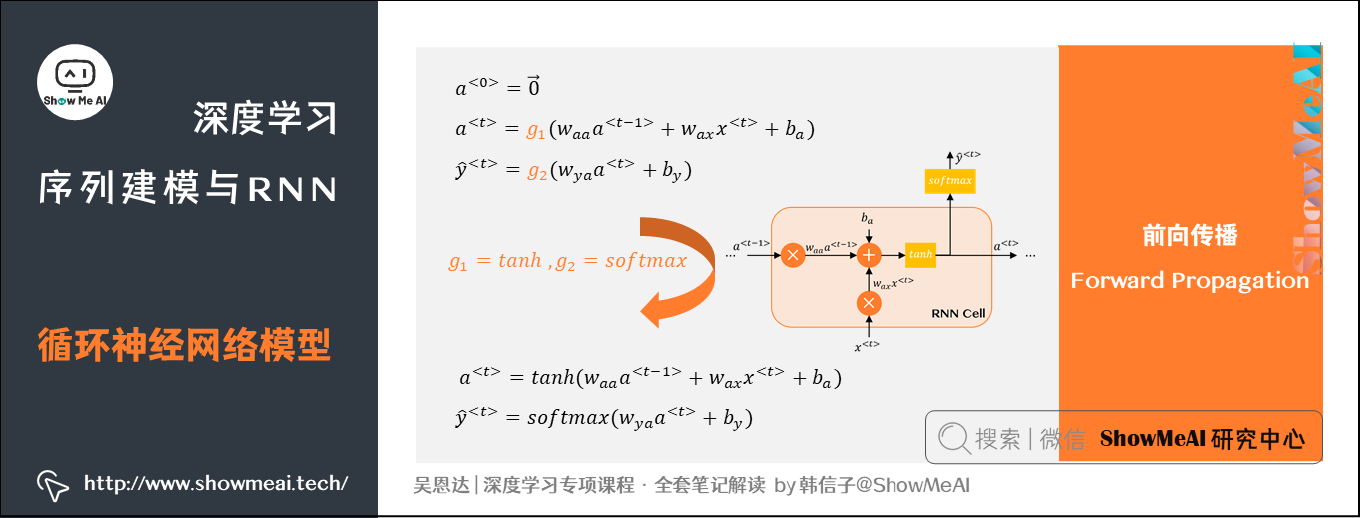
公式中:
- g 1 g_1 g1是激活函数,通常选择 t a n h tanh tanh,有时也用ReLU。
- g 2 g_2 g2可选sigmoid或Softmax,取决于解决的问题和需要的输出类型。
- 图示中RNN Cell的函数,是上方公式的一个特例,是最常用的原始形态RNN。
我们简化一下公式,把 W a a W_{aa} Waa、 W a x W_{ax} Wax水平并列为一个矩阵 W a W_a Wa,同时 a ⟨ t − 1 ⟩ a^{\left \langle t-1 \right \rangle} a⟨t−1⟩和$ x^{\left \langle t \right \rangle}$堆叠成一个矩阵。可以得到如下的简化版前向传播计算公式:
W a = [ W a a , W a x ] W_a = [W_{aa}, W_{ax}] Wa=[Waa,Wax]
a ⟨ t ⟩ = g 1 ( W a [ a ⟨ t − 1 ⟩ ; x ⟨ t ⟩ ] + b a ) a^{\left \langle t \right \rangle} = g_1(W_a [a^{\left \langle t-1 \right \rangle}; x^{\left \langle t \right \rangle}] + b_a) a⟨t⟩=g1(Wa[a⟨t−1⟩;x⟨t⟩]+ba)
y ^ ⟨ t ⟩ = g 2 ( W y a a ⟨ t ⟩ + b y ) \hat{y}^{\left \langle t \right \rangle} = g_2(W_{ya}a^{\left \langle t \right \rangle} + b_y) y^⟨t⟩=g2(Wyaa⟨t⟩+by)
我们上面介绍到的RNN为单向RNN,按照时间步从左到右单向依次运算得到结果, y ^ ⟨ t ⟩ \hat{y}^{\left \langle t \right \rangle} y^⟨t⟩只与前序的元素有关。但有些情况下 y ^ ⟨ t ⟩ \hat {y}^{\left \langle t \right \rangle} y^⟨t⟩也与后续元素有关。如下例,单凭前面的字,无法确定「王」是否为人名的一部分,而添加后续(右侧)的信息可以有效辅助判断。
- 他说,「王刚已经离开学校了」
- 他说,「王府内已经没有差事可做了」
依赖两侧信息的RNN叫做「双向RNN」,简称为**BRNN(Bidirectional RNN)**后面的内容部分会再介绍到。
2.2 反向传播(Backpropagation)
我们先为RNN场景定义一个损失函数。假如我们的问题是判断序列当前输入的字是否是人名的一部分,这是典型的二分类问题,我们采用交叉熵损失函数,计算公式如下所示:
L ⟨ t ⟩ ( y ^ ⟨ t ⟩ , y ⟨ t ⟩ ) = − y ⟨ t ⟩ l o g y ^ ⟨ t ⟩ − ( 1 − y ⟨ t ⟩ ) l o g ( 1 − y ^ ⟨ t ⟩ ) L^{\left \langle t \right \rangle}(\hat {y}^{\left \langle t \right \rangle}, y^{\left \langle t \right \rangle}) = -y^{\left \langle t \right \rangle}log\hat {y}^{\left \langle t \right \rangle} - (1 - y^{\left \langle t \right \rangle})log(1-\hat {y}^{\left \langle t \right \rangle}) L⟨t⟩(y^⟨t⟩,y⟨t⟩)=−y⟨t⟩logy^⟨t⟩−(1−y⟨t⟩)log(1−y^⟨t⟩)
我们沿着序列把每个位置的损失函数相加,得到整个序列的成本函数如下:
J = L ( y ^ , y ) = ∑ t = 1 T x L ⟨ t ⟩ ( y ^ ⟨ t ⟩ , y ⟨ t ⟩ ) J = L(\hat {y}, y) = \sum^{T_x}_{t=1} L^{\left \langle t \right \rangle}(\hat {y}^{\left \langle t \right \rangle}, y^{\left \langle t \right \rangle}) J=L(y^,y)=t=1∑TxL⟨t⟩(y^⟨t⟩,y⟨t⟩)
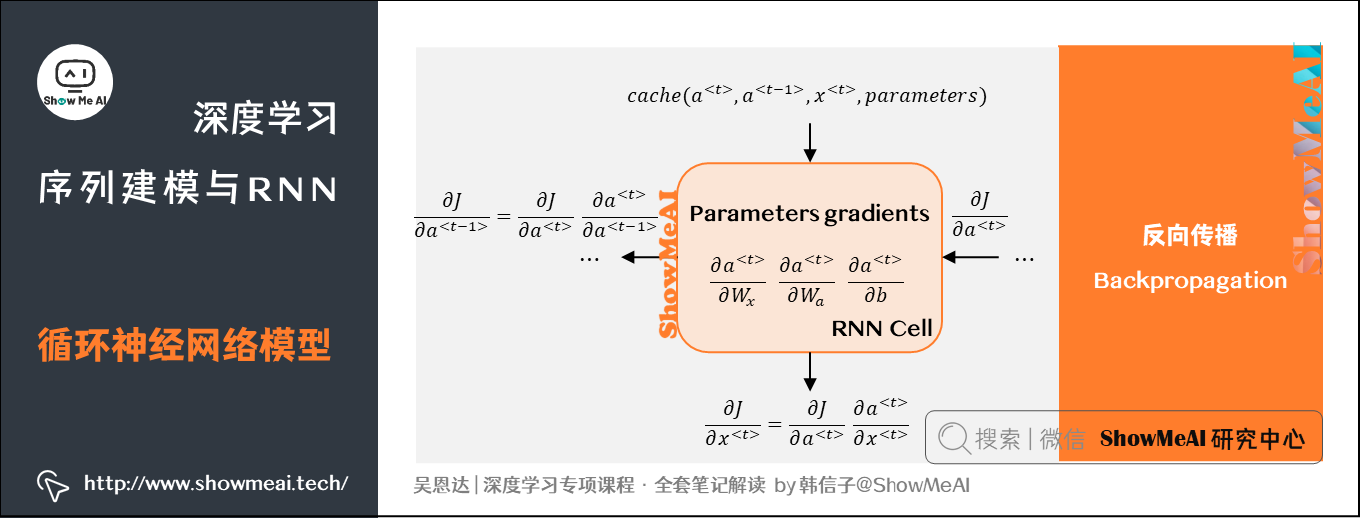
因为损失函数本身计算依赖时序上每个时间点,RNN的反向传播也被称为沿着时间的反向传播(Backpropagation through time),这里的反向传播从右向左计算的过程就像是沿着时间倒推。
详细的计算公式如下所示:
a ⟨ t ⟩ = tanh ( W a x x ⟨ t ⟩ + W a a a ⟨ t − 1 ⟩ + b ) a^{\left \langle t \right \rangle}=\tanh \left(W_{a x} x^{\left \langle t \right \rangle}+W_{a a} a^{\left \langle t-1 \right \rangle}+b\right) a⟨t⟩=tanh(Waxx⟨t⟩+Waaa⟨t−1⟩+b)
∂ tanh ( x ) ∂ x = 1 − tanh ( x ) 2 \frac{\partial \tanh (x)}{\partial x}=1-\tanh (x)^{2} ∂x∂tanh(x)=1−tanh(x)2
∂ a ⟨ t ⟩ ∂ W a x = ( 1 − tanh ( W a x x ⟨ t ⟩ + W a a a ⟨ t − 1 ⟩ + b ) 2 ) x T \frac{\partial a^{\left \langle t \right \rangle}}{\partial W_{a x}}=\left(1-\tanh \left(W_{a x} x^{\left \langle t \right \rangle}+W_{a a} a^{\left \langle t-1 \right \rangle}+b\right)^{2}\right) x^{ T} ∂Wax∂a⟨t⟩=(1−tanh(Waxx⟨t⟩+Waaa⟨t−1⟩+b)2)xT
∂ a ⟨ t ⟩ ∂ W a a = ( 1 − tanh ( W a x x ⟨ t ⟩ + W a a a ⟨ t − 1 ⟩ + b ) 2 ) a T \frac{\partial a^{\left \langle t \right \rangle}}{\partial W_{a a}}=\left(1-\tanh \left(W_{a x} x^{\left \langle t \right \rangle}+W_{a a} a^{\left \langle t-1 \right \rangle}+b\right)^{2}\right) a^{T} ∂Waa∂a⟨t⟩=(1−tanh(Waxx⟨t⟩+Waaa⟨t−1⟩+b)2)aT
∂ a ⟨ t ⟩ ∂ b = ∑ b a t c h ( 1 − tanh ( W a x x ⟨ t ⟩ + W a a a ⟨ t − 1 ⟩ + b ) 2 ) \frac{\partial a^{\left \langle t \right \rangle}}{\partial b}=\sum_{b a t c h}\left(1-\tanh \left(W_{a x} x^{\left \langle t \right \rangle}+W_{a a} a^{\left \langle t-1 \right \rangle}+b\right)^{2}\right) ∂b∂a⟨t⟩=batch∑(1−tanh(Waxx⟨t⟩+Waaa⟨t−1⟩+b)2)
∂ a ⟨ t ⟩ ∂ x ⟨ t ⟩ = W a x T ⋅ ( 1 − tanh ( W a x x ⟨ t ⟩ + W a a a ⟨ t − 1 ⟩ + b ) 2 ) \frac{\partial a^{\left \langle t \right \rangle}}{\partial x^{\left \langle t \right \rangle}}=W_{a x}{ }^{T} \cdot\left(1-\tanh \left(W_{a x} x^{\left \langle t \right \rangle}+W_{a a} a^{\left \langle t-1 \right \rangle}+b\right)^{2}\right) ∂x⟨t⟩∂a⟨t⟩=WaxT⋅(1−tanh(Waxx⟨t⟩+Waaa⟨t−1⟩+b)2)
∂ a ⟨ t ⟩ ∂ a ⟨ t − 1 ⟩ = W a a T ⋅ ( 1 − tanh ( W a x x ⟨ t − 1 ⟩ + W a a a ( t − 1 ⟩ + b ) 2 ) \frac{\partial a^{\left \langle t \right \rangle}}{\partial a^{\left \langle t-1 \right \rangle}}=W_{a a}{ }^{T} \cdot\left(1-\tanh \left(W_{a x} x^{\left \langle t-1 \right \rangle}+W_{a a} a^{(t-1\rangle}+b\right)^{2}\right) ∂a⟨t−1⟩∂a⟨t⟩=WaaT⋅(1−tanh(Waxx⟨t−1⟩+Waaa(t−1⟩+b)2)
2.3 RNN不同结构
前面我们提到的RNN,都是满足输入输出长度一致的,即 T x = T y T_x=T_y Tx=Ty,但实际有很多类型的RNN输入长度和输出长度不一致。根据输入及输出长度关系,RNN可以分为以下结构:
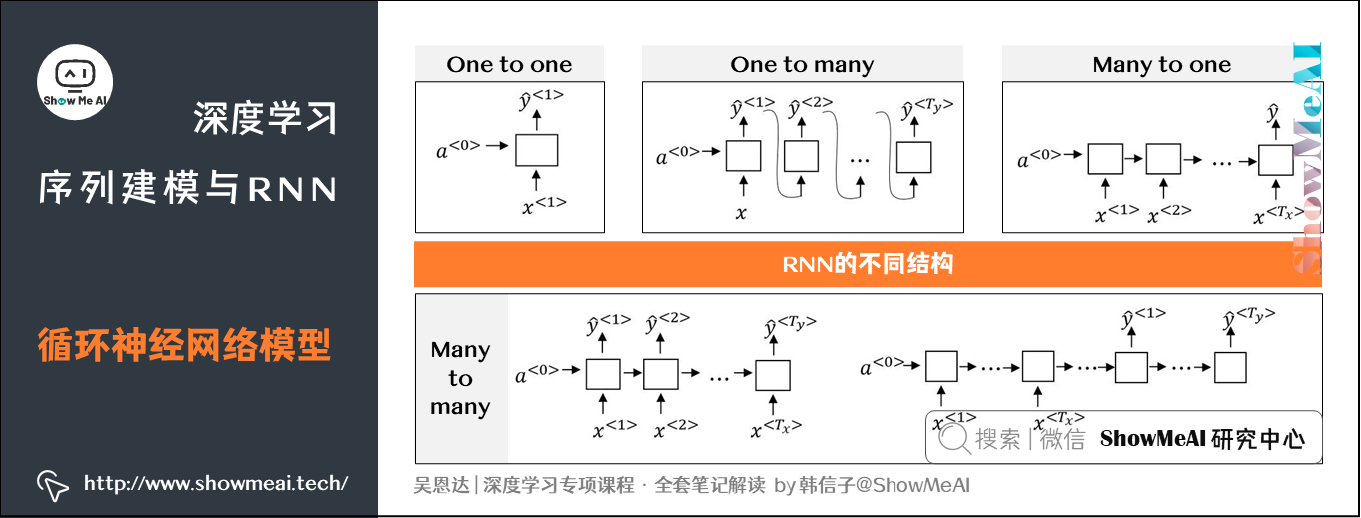
- 一对一(One to one): T x = 1 , T y = 1 T_x=1,T_y=1 Tx=1,Ty=1
- 一对多(One to many): T x = 1 , T y > 1 T_x=1,T_y>1 Tx=1,Ty>1
- 多对一(Many to one): T x > 1 , T y = 1 T_x>1,T_y=1 Tx>1,Ty=1
- 多对多(Many to many): T x = T y T_x=T_y Tx=Ty
- 多对多(Many to many): T x ≠ T y T_x\neq T_y Tx=Ty
3.语言模型
语言模型(Language Model)是自然语言处理(NLP)中最基本和最重要的任务之一。即使到今天大家看到很多新型神经网络模型训练使用的基础任务之一都还是语言模型。RNN模型能比较好地建立语言模型。
我们以一个例子来解释一下什么是语言模型。我们用算法进行语音识别时,一句语音有两种识别结果:
- 历史总是不断重演
- 力使总事不断虫眼
我们都能判断,第二句话更有可能是正确的识别结果。语言模型是一个可以计算出这两句话各自的出现概率的模型。比如预估第一句话概率为 1 0 − 13 10^{-13} 10−13,第二句话概率为 1 0 − 10 10^{-10} 10−10。
在语音识别的场景下,我们就可以利用语言模型得到各自语句的概率,选择概率最大的语句作为正确的识别结果。概率计算的表达式为:
P ( y ⟨ 1 ⟩ , y ⟨ 2 ⟩ , ⋯ , y ⟨ T y ⟩ ) P(y^{\left \langle 1 \right \rangle},y^{\left \langle 2 \right \rangle},\cdots,y^{\left \langle T_y \right \rangle}) P(y⟨1⟩,y⟨2⟩,⋯,y⟨Ty⟩)
那么这个有用的语言模型如何构建呢,又和我们这里提到的RNN有什么关系呢,我们会按照如下步骤来操作:
- ① 采集数据构建一个足够大的训练集(当前很多大模型都是以千万和亿为数据量级的),训练集由大量的语句语料库(corpus)构成。
- ② 对语料库的句子进行切分词(tokenize)。对英文可以做单词归一化和切分单词,中文按照字或者词做切分(词用得更多)。
- ③ 基于分词过后的句库,建立vocabulary,对每个字/词进行one-hot编码。
例如下面这句话:
我爱吃油泼辣子彪彪面,味道非常好。
我们会给每句话结束末尾,加上< EOS >作为语句结束符。如果语句中遇到词汇表中没有的单词,用< UNK >表示。假设单词「彪」不在词汇表中,则上面这句话可表示为:
我爱吃油泼辣子 < UNK > < UNK >面,味道非常好。< EOS >
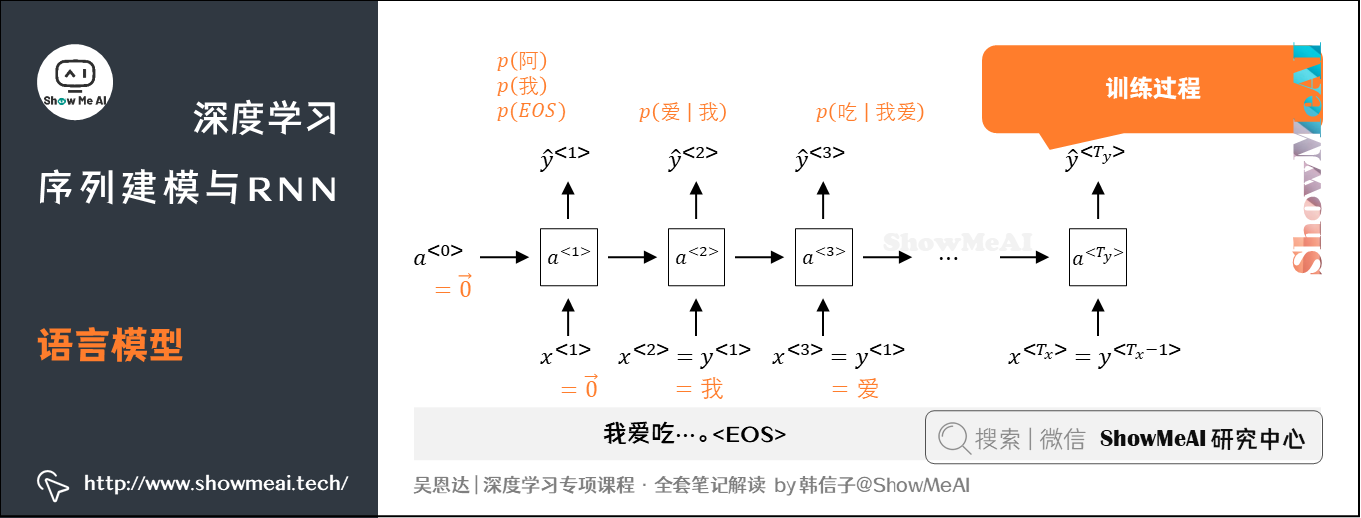
将标志化后的训练集用于训练RNN,过程如下图所示:
训练过程解析:
① 第1个时间步中,输入的 a ⟨ 0 ⟩ a^{\left \langle 0 \right \rangle} a⟨0⟩和 x ⟨ 1 ⟩ x^{\left \langle 1 \right \rangle} x⟨1⟩都是零向量, y ^ ⟨ 1 ⟩ \hat {y}^{\left \langle 1 \right \rangle} y^⟨1⟩是通过Softmax预测出的字典中每个词作为第一个词出现的概率;
② 第2个时间步中,输入的 x ⟨ 2 ⟩ x^{\left \langle 2 \right \rangle} x⟨2⟩是训练样本的标签中的第一个单词 y ⟨ 1 ⟩ y^{\left \langle 1 \right \rangle} y⟨1⟩(即「我」)和上一层的激活项 a ⟨ 1 ⟩ a^{\left \langle 1 \right \rangle} a⟨1⟩,输出的 y ⟨ 2 ⟩ y^{\left \langle 2 \right \rangle} y⟨2⟩表示的是通过Softmax预测出的、词语「我」后面出现字典中的其他每个词的条件概率。
③ 以此类推,最后就可以得到整个句子出现的概率。
定义损失函数为:
L
(
y
^
⟨
t
⟩
,
y
⟨
t
⟩
)
=
−
∑
t
y
i
⟨
t
⟩
l
o
g
y
^
⟨
t
⟩
L(\hat {y}^{\left \langle t \right \rangle}, y^{\left \langle t \right \rangle}) = -\sum_t y_i^{\left \langle t \right \rangle} log \hat {y}^{\left \langle t \right \rangle}
L(y^⟨t⟩,y⟨t⟩)=−t∑yi⟨t⟩logy^⟨t⟩
则成本函数为:
J
=
∑
t
L
⟨
t
⟩
(
y
^
⟨
t
⟩
,
y
⟨
t
⟩
)
J = \sum_t L^{\left \langle t \right \rangle}(\hat {y}^{\left \langle t \right \rangle}, y^{\left \langle t \right \rangle})
J=t∑L⟨t⟩(y^⟨t⟩,y⟨t⟩)
4.采样-序列生成
对于训练好的语言模型,可以通过采样(Sample)构建新的序列(对应上例就是产出新的句子),也可以进而了解这个模型学习到了一些什么。
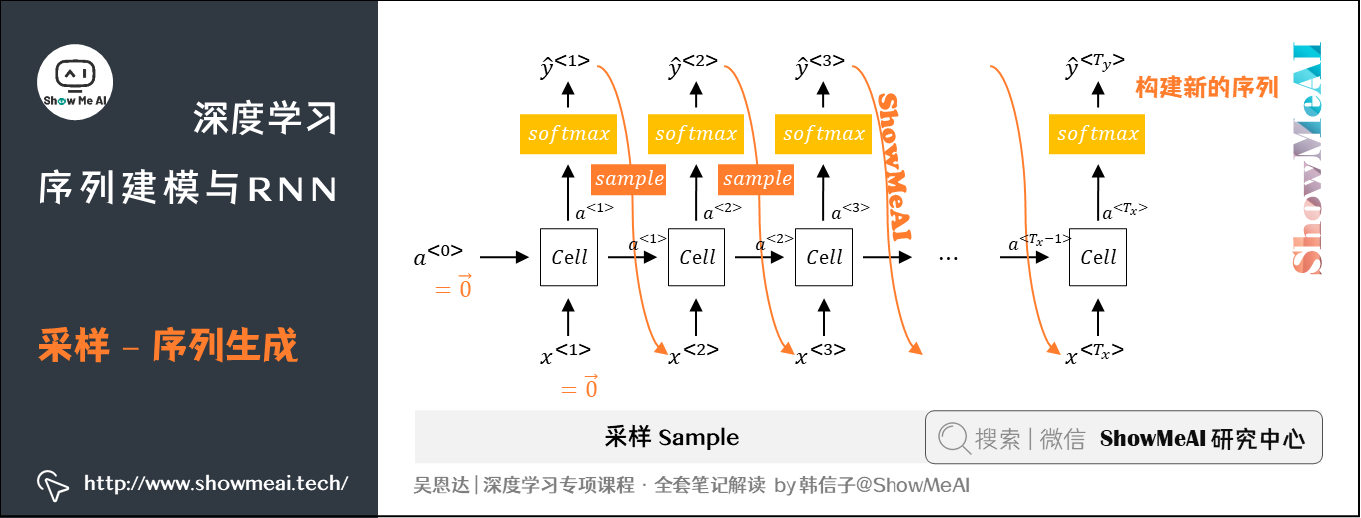
具体过程如下:
① 第1个时间步输入
a
⟨
0
⟩
a^{\left \langle 0 \right \rangle}
a⟨0⟩和
x
⟨
1
⟩
x^{\left \langle 1 \right \rangle}
x⟨1⟩为零向量,输出预测出的字典中每个词作为第一个词出现的概率,根据Softmax的分布进行随机采样(np.random.choice)
② 将上一步采样得到的 y ^ ⟨ 1 ⟩ \hat {y}^{\left \langle 1 \right \rangle} y^⟨1⟩作为第二个时间步的输入 x ⟨ 2 ⟩ x^{\left \langle 2 \right \rangle} x⟨2⟩。
③ 以此类推,直到采样到EOS,至此基于语言模型生成的一个完整句子序列生成完毕。
我们可以通过模型生成的句子,理解模型通过语料库学习到的知识(词语组合与分布)。
以中文为例,上面构建语言模型,很多时候会基于「词」来构建,但因为中文词汇非常多,难免会出现未知标识(UNK)。
一种处理方式是可以基于「字」粒度建模,因为字总体数量有限得多,出现位置标识的可能性也更小。但这种方法也有缺点:得到的序列过多过长,且训练成本更高。
总体来说,大家看到基于词汇构建的语言模型更为常用。
5.RNN 梯度消失与梯度爆炸
梯度消失与梯度爆炸是深度神经网络中很重要的问题,对于RNN而言,序列较长也容易有对应的问题,我们来对这两个问题做一点展开讲解。
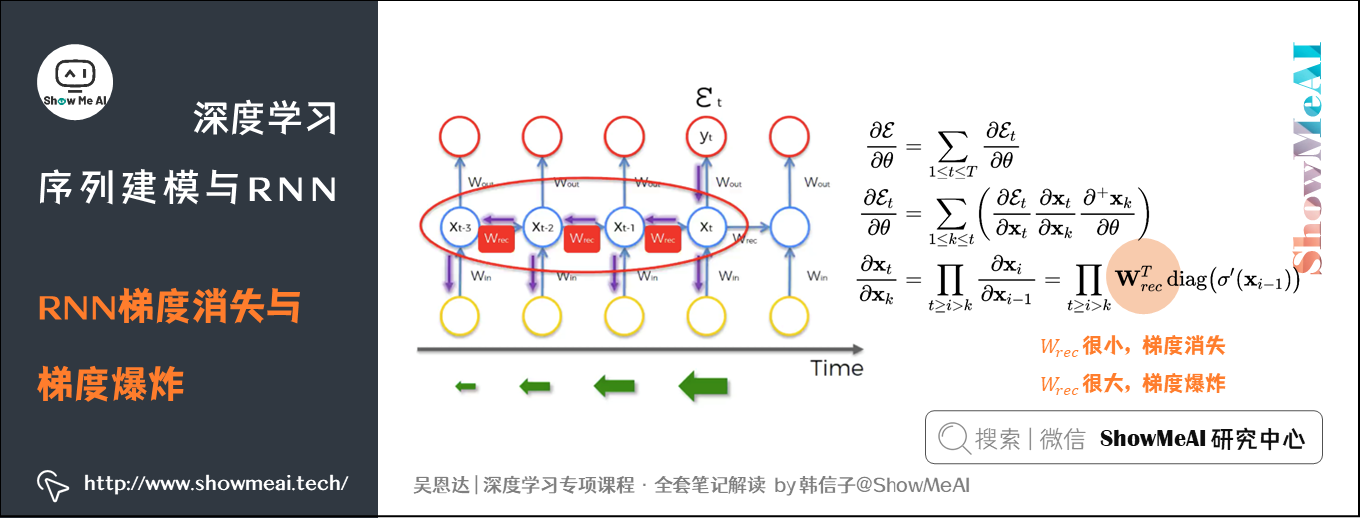
5.1 梯度消失
序列数据的特点是:可能存在距离上跨度很大的依赖关系,在我们前面提到的语言模型例子中,体现的就是某个词对与其相距较远的一个词有强依赖。如下有2句英文句子:
The cat, which already ate a bunch of food, was full.
The cats, which already ate a bunch of food, were full.
很显然两句话里,主语数量级和对应的be动词是相互对应的:was受cat影响;were受cats影响。而它们之间都相隔了很多单词。而一般的RNN模型每个元素受其周围附近的影响较大,不擅长捕获这种长期依赖关系。上面两句话的这种依赖关系,由于跨度很大,普通的RNN网络容易出现梯度消失,捕捉不到它们之间的依赖,造成语法错误。
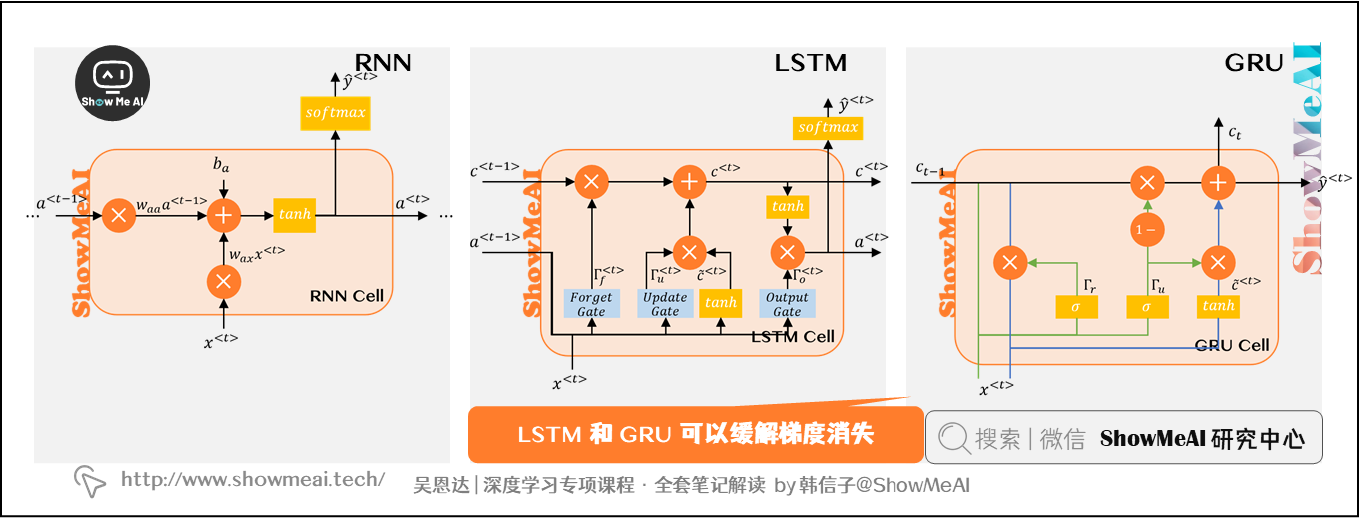
普通RNN里的梯度消失问题比较难解决,可以使用调整结构的GRU和LSTM (下文会介绍到)作为缓解梯度消失问题的方案。
5.2 梯度爆炸
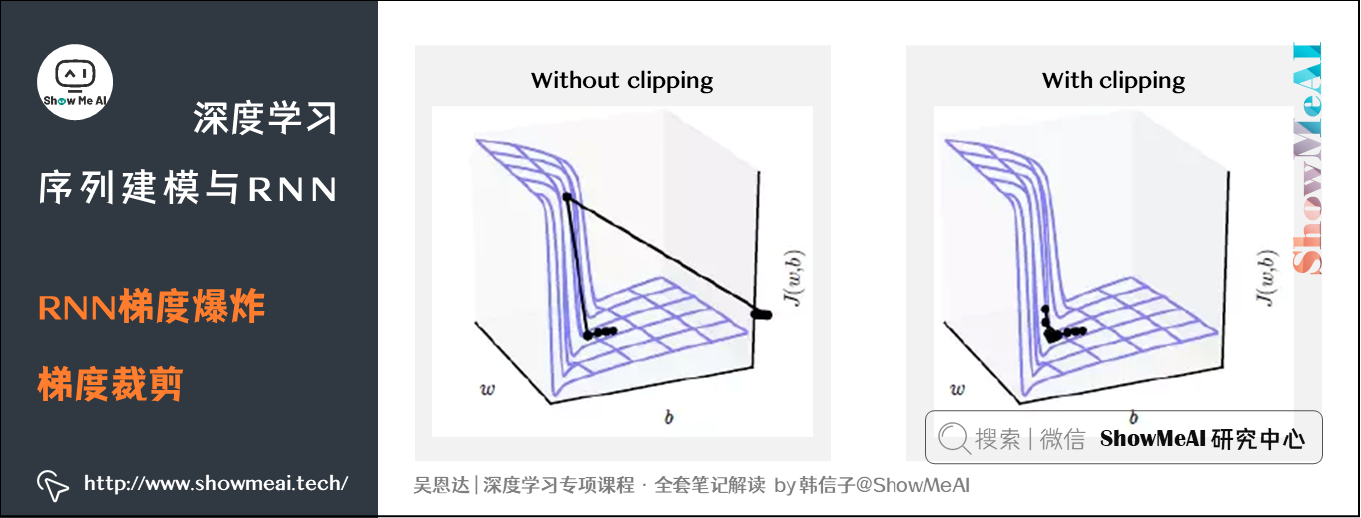
在反向传播时,随着层数的增多,梯度不仅可能指数型下降,也有可能指数型上升,即梯度爆炸。不过梯度爆炸比较容易发现,因为参数会急剧膨胀到数值溢出(可能显示为 NaN)。
对于梯度爆炸,常用的处理办法是采用梯度修剪(Gradient Clipping):观察梯度向量,如果它大于某个阈值,则缩放梯度向量以保证其不会太大。
6.GRU(门控循环单元)
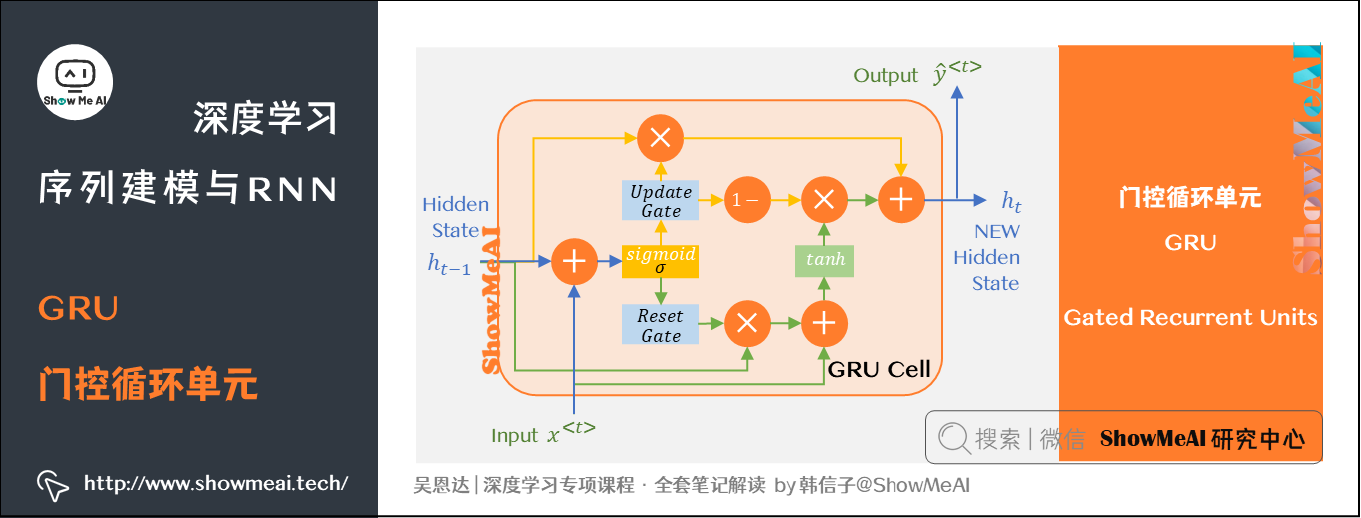
GRU(Gated Recurrent Units, 门控循环单元)改善了RNN的隐藏层,使其可以更好地捕捉深层连接,并改善了梯度消失问题。
依旧以前面提到的这个句子为例:
The cat, which already ate a bunch of food, was full.
模仿人类从左到右读上面这个句子的方式:
-
GRU单元有一个新的变量称为 c c c,代表记忆细胞(Memory Cell),其作用是提供记忆的能力,记住例如前文主语是单数还是复数等信息。在时间 t t t,记忆细胞的值 c ⟨ t ⟩ c^{\left \langle t \right \rangle} c⟨t⟩等于输出的激活值 a ⟨ t ⟩ a^{\left \langle t \right \rangle} a⟨t⟩; c ~ ⟨ t ⟩ \tilde{c}^{\left \langle t \right \rangle} c~⟨t⟩代表下一个 c c c的候选值。
-
Γ r \Gamma_r Γr代表相关门(Relevance Gate),表示 c ~ ⟨ t ⟩ \tilde{c}^{\left \langle t \right \rangle} c~⟨t⟩和 c ⟨ t ⟩ c^{\left \langle t \right \rangle} c⟨t⟩的相关性。
-
$ \Gamma_u$代表更新门(Update Gate),用于决定什么时候更新记忆细胞的值。
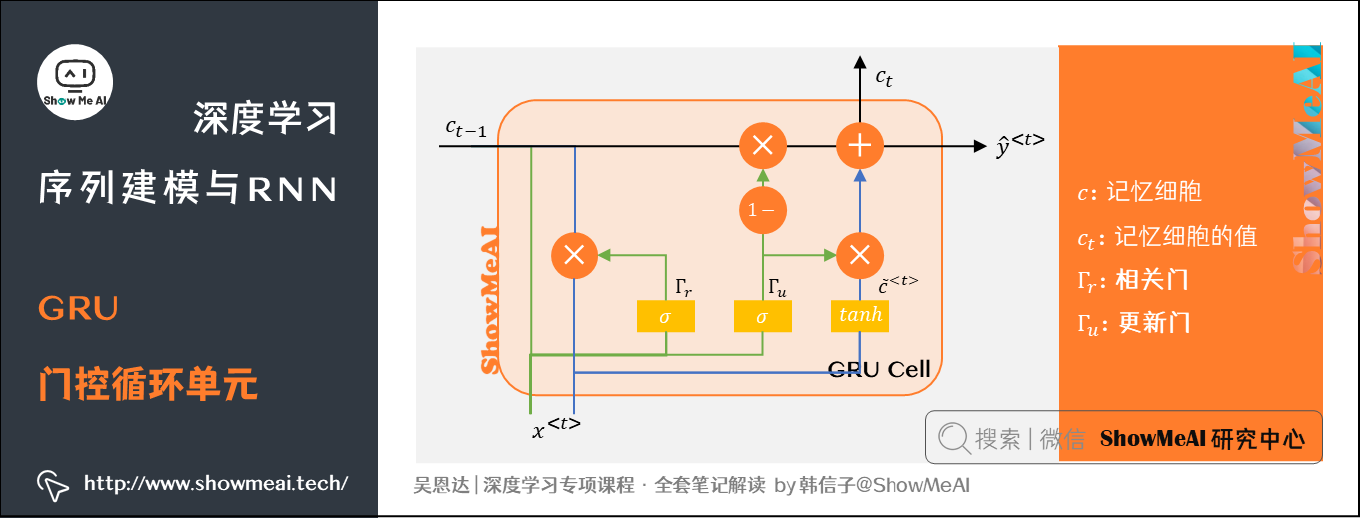
以上结构的具体公式为:
Γ r = σ ( W r [ c ⟨ t − 1 ⟩ , x ⟨ t ⟩ ] + b r ) \Gamma _r = \sigma(W_r[c^{\left \langle t-1 \right \rangle}, x^{\left \langle t \right \rangle}] + b_r) Γr=σ(Wr[c⟨t−1⟩,x⟨t⟩]+br)
Γ u = σ ( W u [ c ⟨ t − 1 ⟩ , x ⟨ t ⟩ ] + b u ) \Gamma _u = \sigma(W_u[c^{\left \langle t-1 \right \rangle}, x^{\left \langle t \right \rangle}] + b_u) Γu=σ(Wu[c⟨t−1⟩,x⟨t⟩]+bu)
c ~ ⟨ t ⟩ = t a n h ( W c [ Γ r ∗ c ⟨ t − 1 ⟩ , x ⟨ t ⟩ ] + b c ) \tilde{c}^{\left \langle t \right \rangle} = tanh(W_c[\Gamma _r \ast c^{\left \langle t-1 \right \rangle}, x^{\left \langle t \right \rangle}] + b_c) c~⟨t⟩=tanh(Wc[Γr∗c⟨t−1⟩,x⟨t⟩]+bc)
c ⟨ t ⟩ = ( 1 − Γ u ) × c ⟨ t − 1 ⟩ + Γ u × c ~ ⟨ t ⟩ c^{\left \langle t \right \rangle} = (1 - \Gamma _u) \times c^{\left \langle t-1 \right \rangle} + \Gamma _u \times \tilde{c}^{\left \langle t \right \rangle} c⟨t⟩=(1−Γu)×c⟨t−1⟩+Γu×c~⟨t⟩
a ⟨ t ⟩ = c ⟨ t ⟩ a^{\left \langle t \right \rangle} = c^{\left \langle t \right \rangle} a⟨t⟩=c⟨t⟩
当使用sigmoid作为激活函数 σ \sigma σ来得到 Γ u \Gamma_u Γu时, Γ u \Gamma_u Γu的值在0到1的范围内,且大多数时间非常接近于0或1。当 Γ u = 1 \Gamma _u = 1 Γu=1时, c ⟨ t ⟩ c^{\left \langle t \right \rangle} c⟨t⟩被更新为 c ~ ⟨ t ⟩ \tilde{c}^{\left \langle t \right \rangle} c~⟨t⟩,否则保持为 c ⟨ t − 1 ⟩ c^{\left \langle t-1 \right \rangle} c⟨t−1⟩。因为 Γ u \Gamma_u Γu可以很接近0,因此 c ⟨ t ⟩ c^{\left \langle t \right \rangle} c⟨t⟩几乎就等于 c ⟨ t − 1 ⟩ c^{\left \langle t-1 \right \rangle} c⟨t−1⟩。在经过很长的序列后, c c c的值依然被维持,从而实现「记忆」的功能。
相关论文:
Cho et al., 2014. On the properties of neural machine translation: Encoder-decoder approaches
Chung et al., 2014. Empirical Evaluation of Gated Recurrent Neural Networks on Sequence Modeling
7.LSTM(长短期记忆)
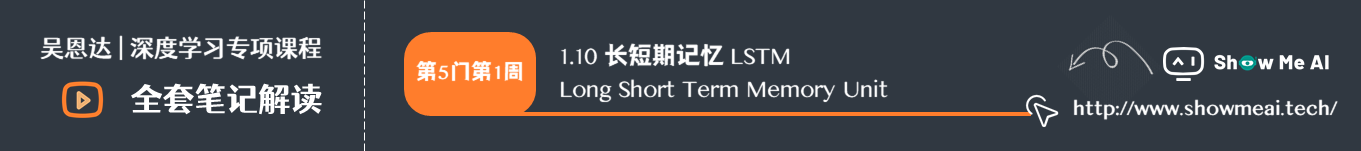
LSTM(Long Short Term Memory,长短期记忆)网络比GRU更加灵活和强大,它额外引入了遗忘门(Forget Gate) Γ f \Gamma _f Γf和输出门(Output Gate) Γ o \Gamma_o Γo。其结构图和公式如下:
Γ u = σ ( W u [ a ⟨ t − 1 ⟩ , x ⟨ t ⟩ ] + b u ) \Gamma _u = \sigma(W_u[a^{\left \langle t-1 \right \rangle}, x^{\left \langle t \right \rangle}] + b_u) Γu=σ(Wu[a⟨t−1⟩,x⟨t⟩]+bu)
Γ f = σ ( W f [ a ⟨ t − 1 ⟩ , x ⟨ t ⟩ ] + b f ) \Gamma _f = \sigma(W_f[a^{\left \langle t-1 \right \rangle}, x^{\left \langle t \right \rangle}] + b_f) Γf=σ(Wf[a⟨t−1⟩,x⟨t⟩]+bf)
c ~ ⟨ t ⟩ = t a n h ( W c [ a ⟨ t − 1 ⟩ , x ⟨ t ⟩ ] + b c ) \tilde{c}^{\left \langle t \right \rangle} = tanh(W_c[a^{\left \langle t-1 \right \rangle}, x^{\left \langle t \right \rangle}] + b_c) c~⟨t⟩=tanh(Wc[a⟨t−1⟩,x⟨t⟩]+bc)
c ⟨ t ⟩ = Γ u ⟨ t ⟩ × c ~ ⟨ t ⟩ + Γ f ⟨ t ⟩ × c ⟨ t − 1 ⟩ c^{\left \langle t \right \rangle} = \Gamma^{\left \langle t \right \rangle}_u \times \tilde{c}^{\left \langle t \right \rangle} + \Gamma^{\left \langle t \right \rangle}_f \times {c}^{\left \langle t-1 \right \rangle} c⟨t⟩=Γu⟨t⟩×c~⟨t⟩+Γf⟨t⟩×c⟨t−1⟩
Γ o = σ ( W o [ a ⟨ t − 1 ⟩ , x ⟨ t ⟩ ] + b o ) \Gamma_o = \sigma(W_o[a^{\left \langle t-1 \right \rangle}, x^{\left \langle t \right \rangle}] + b_o) Γo=σ(Wo[a⟨t−1⟩,x⟨t⟩]+bo)
a ⟨ t ⟩ = Γ o ⟨ t ⟩ × t a n h ( c ⟨ t ⟩ ) a^{\left \langle t \right \rangle} = \Gamma _o^{\left \langle t \right \rangle} \times tanh(c^{\left \langle t \right \rangle}) a⟨t⟩=Γo⟨t⟩×tanh(c⟨t⟩)
以上为1个LSTM单元的结构,多个LSTM单元按时间次序连接起来,就得到LSTM网络。
上面讲到的是简化版的LSTM。在更为常用的版本中,几个门值不仅取决于 a ⟨ t − 1 ⟩ a^{\left \langle t-1 \right \rangle} a⟨t−1⟩和 x ⟨ t ⟩ x^{\left \langle t \right \rangle} x⟨t⟩,有时也可以关联上一个记忆细胞输入的值 c ⟨ t − 1 ⟩ c^{\left \langle t-1 \right \rangle} c⟨t−1⟩,这被称为窥视孔连接(Peephole Connection)。这时,和GRU不同, c ⟨ t − 1 ⟩ c^{\left \langle t-1 \right \rangle} c⟨t−1⟩和门值是一对一的。
c 0 c^{0} c0常被初始化为零向量。
8.双向循环神经网络(BRNN)
我们前面提到了,单向的RNN在某一时间步只能使用之前输入的序列信息。双向循环神经网络(Bidirectional RNN,BRNN)可以在序列的任意位置使用之前和之后的数据。其工作原理是增加一个反向循环层,结构如下图所示:
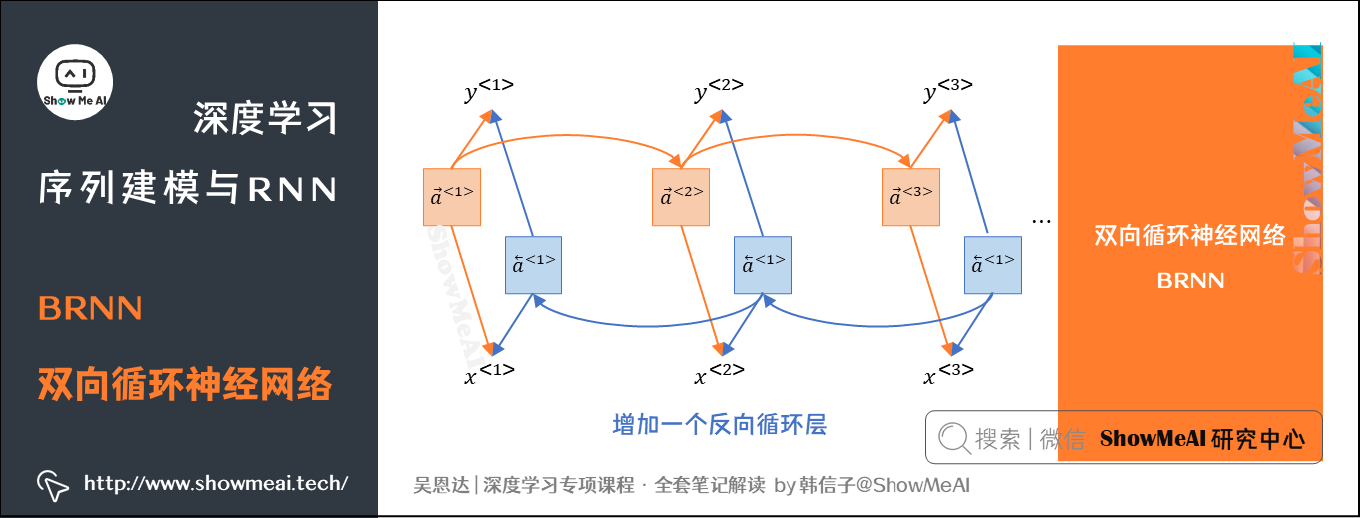
因此,有 y ^ ⟨ t ⟩ = g ( W y [ a → ⟨ t ⟩ , a ← ⟨ t ⟩ ] + b y ) \hat{y}^{\left \langle t \right \rangle}= g(W_y[\overrightarrow{a}^{\left \langle t \right \rangle}, \overleftarrow{a}^{\left \langle t \right \rangle}] + b_y) y^⟨t⟩=g(Wy[a⟨t⟩,a⟨t⟩]+by)
这个改进的方法不仅能用于基本的RNN,也可以用于GRU或LSTM。缺点是需要完整的序列数据,才能预测任意位置的结果。例如构建语音识别系统,需要等待用户说完并获取整个语音表达,才能处理这段语音并进一步做语音识别。因此,实际应用会有更加复杂的模块。
9.深度循环神经网络(DRNN)
为了进一步提升模型的学习能力,我们可以在RNN的每个时间步上,也增加隐层数量,构建深度循环神经网络(Deep RNN)。结构如下图所示:
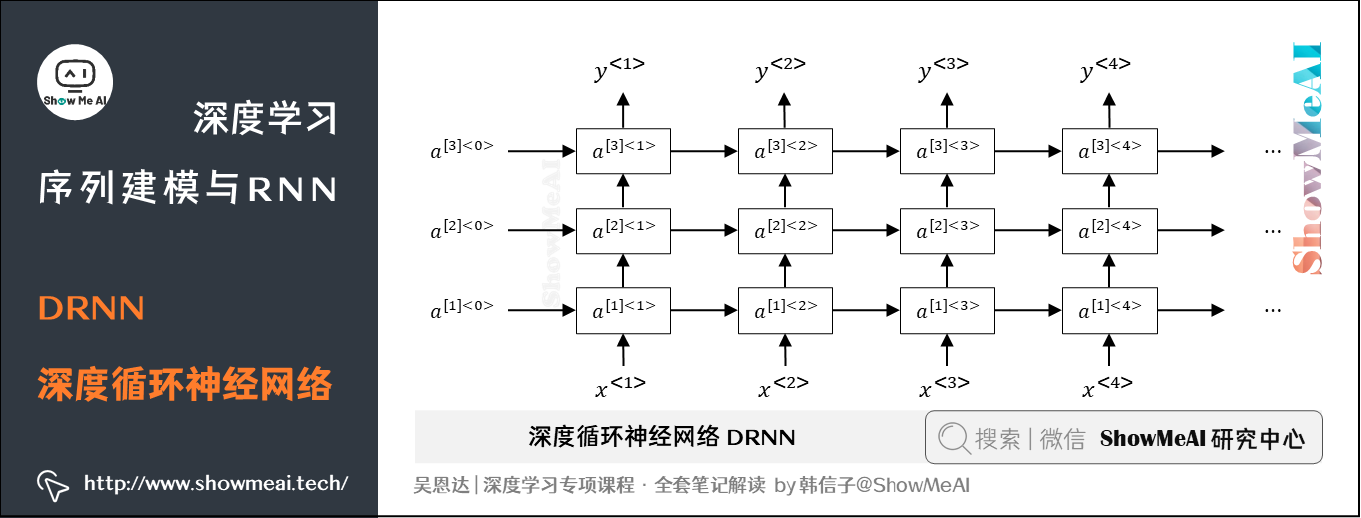
以 a [ 2 ] ⟨ 3 ⟩ a^{[2]\left \langle 3 \right \rangle} a[2]⟨3⟩为例,有 a [ 2 ] ⟨ 3 ⟩ = g ( W a [ 2 ] [ a [ 2 ] ⟨ 2 ⟩ , a [ 1 ] ⟨ 3 ⟩ ] + b a [ 2 ] ) a^{[2]\left \langle 3 \right \rangle} = g(W_a^{[2]}[a^{[2]\left \langle 2 \right \rangle}, a^{[1]\left \langle 3 \right \rangle}] + b_a^{[2]}) a[2]⟨3⟩=g(Wa[2][a[2]⟨2⟩,a[1]⟨3⟩]+ba[2])。
参考资料
- Cho et al., 2014. On the properties of neural machine translation: Encoder-decoder approaches
- Chung et al., 2014. Empirical Evaluation of Gated Recurrent Neural Networks on Sequence Modeling
- Hochreiter & Schmidhuber 1997. Long short-term memory
ShowMeAI系列教程推荐
- 大厂技术实现:推荐与广告计算解决方案
- 大厂技术实现:计算机视觉解决方案
- 大厂技术实现:自然语言处理行业解决方案
- 图解Python编程:从入门到精通系列教程
- 图解数据分析:从入门到精通系列教程
- 图解AI数学基础:从入门到精通系列教程
- 图解大数据技术:从入门到精通系列教程
- 图解机器学习算法:从入门到精通系列教程
- 机器学习实战:手把手教你玩转机器学习系列
- 深度学习教程:吴恩达专项课程 · 全套笔记解读
- 自然语言处理教程:斯坦福CS224n课程 · 课程带学与全套笔记解读
- 深度学习与计算机视觉教程:斯坦福CS231n · 全套笔记解读
推荐文章
- ShowMeAI 深度学习教程(1) | 深度学习概论
- ShowMeAI 深度学习教程(2) | 神经网络基础
- ShowMeAI 深度学习教程(3) | 浅层神经网络
- ShowMeAI 深度学习教程(4) | 深层神经网络
- ShowMeAI 深度学习教程(5) | 深度学习的实用层面
- ShowMeAI 深度学习教程(6) | 神经网络优化算法
- ShowMeAI 深度学习教程(7) | 网络优化:超参数调优、正则化、批归一化和程序框架
- ShowMeAI 深度学习教程(8) | AI应用实践策略(上)
- ShowMeAI 深度学习教程(9) | AI应用实践策略(下)
- ShowMeAI 深度学习教程(10) | 卷积神经网络解读
- ShowMeAI 深度学习教程(11) | 经典CNN网络实例详解
- ShowMeAI 深度学习教程(12) | CNN应用:目标检测
- ShowMeAI 深度学习教程(13) | CNN应用:人脸识别和神经风格转换
- ShowMeAI 深度学习教程(14) | 序列模型与RNN网络
- ShowMeAI 深度学习教程(15) | 自然语言处理与词嵌入
- ShowMeAI 深度学习教程(16) | Seq2seq序列模型和注意力机制


 2852


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


