【机器学习】朴素贝叶斯 Naive Bayes Classifiers 算法 整理

基于朴素贝叶斯算法的分类应用 基于朴素贝叶斯算法的分类应用包括文本分类、垃圾邮件过滤和情感分析等。它通过计算给定特征的条件概率,结合贝叶斯定理,从而进行分类预测。虽然朴素贝叶斯在处理高维数据和文本数据方面表现良好,但它在处理特征间相关性较强的数据上可能表现不佳。 阅读详情

贝叶斯(Bayes)分类算法是一类利用概率统计知识进行分类的算法,如朴素贝叶斯(Naive Bayes)算法。这些算法主要利用Bayes定理来预测一个未知类别的样本属于各个类别的可能性,选择其中可能性最大的一个类别作为该样本的最终类别。由于贝叶斯定理的成立本身需要一个很强的条件独立性假设前提,而此假设在实际情况中经常是不成立的,因而其分类准确性就会下降。为此就出现了许多降低独立性假设的贝叶斯分类算法,如TAN(Tree Augmented Na?ve Bayes)算法,它是在贝叶斯网络结构的基础上增加属性对之间的关联来实现的。

通常,事件A在事件B的条件下的概率,与事件B在事件A的条件下的概率是不一样的;然而,这两者是有确定的关系,贝叶斯定理就是这种关系的陈述。

贝叶斯定理是指概率统计中的应用所观察到的现象对有关概率分布的主观判断(即先验概率)进行修正的标准方法。当分析样本大到接近总体数时,样本中事件发生的概率将接近于总体中事件发生的概率。

作为一个规范的原理,贝叶斯法则对于所有概率的解释是有效的;然而,频率主义者和贝叶斯主义者对于在应用中概率如何被赋值有着不同的看法:频率主义者根据随机事件发生的频率,或者总体样本里面的个数来赋值概率;贝叶斯主义者要根据未知的命题来赋值概率。

贝叶斯统计中的两个基本概念是先验分布和后验分布:

先验分布。总体分布参数θ的一个概率分布。贝叶斯学派的根本观点,是认为在关于总体分布参数θ的任何统计推断问题中,除了使用样本所提供的信息外,还必须规定一个先验分布,它是在进行统计推断时不可缺少的一个要素。他们认为先验分布不必有客观的依据,可以部分地或完全地基于主观信念。

后验分布。根据样本分布和未知参数的先验分布,用概率论中求条件概率分布的方法,求出的在样本已知下,未知参数的条件分布。因为这个分布是在抽样以后才得到的,故称为后验分布。贝叶斯推断方法的关键是任何推断都必须且只须根据后验分布,而不能再涉及样本分布。

贝叶斯公式为

P(A∩B)=P(A)*P(B|A)=P(B)*P(A|B)

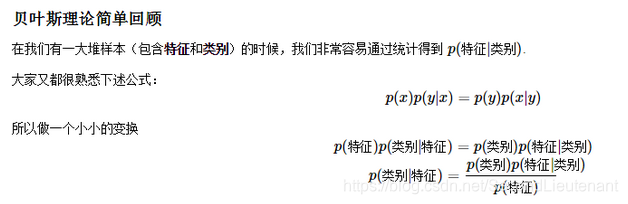
P(A|B)=P(B|A)*P(A)/P(B)

其中:

1、P(A)是A的先验概率或边缘概率,称作"先验"是因为它不考虑B因素。

2、P(A|B)是已知B发生后A的条件概率,也称作A的后验概率。

3、P(B|A)是已知A发生后B的条件概率,也称作B的后验概率,这里称作似然度。

4、P(B)是B的先验概率或边缘概率,这里称作标准化常量。

5、P(B|A)/P(B)称作标准似然度。

贝叶斯法则又可表述为:

后验概率=(似然度*先验概率)/标准化常量=标准似然度*先验概率

P(A|B)随着P(A)和P(B|A)的增长而增长,随着P(B)的增长而减少,即如果B独立于A时被观察到的可能性越大,那么B对A的支持度越小。

贝叶斯公式为利用搜集到的信息对原有判断进行修正提供了有效手段。在采样之前,经济主体对各种假设有一个判断(先验概率),关于先验概率的分布,通常可根据经济主体的经验判断确定(当无任何信息时,一般假设各先验概率相同),较复杂精确的可利用包括最大熵技术或边际分布密度以及相互信息原理等方法来确定先验概率分布。

全概率公式、贝叶斯公式推导过程

(1)条件概率公式

        设A,B是两个事件,且P(B)>0,则在事件B发生的条件下,事件A发生的条件概率(conditional probability)为:

                     P(A|B)=P(AB)/P(B)

(2)乘法公式

         1.由条件概率公式得:

                       P(AB)=P(A|B)P(B)=P(B|A)P(A)    //即为乘法公式;

         2.乘法公式的推广:对于任何正整数n≥2,当P(A1A2...An-1) > 0 时,有:

                 P(A1A2...An-1An)=P(A1)P(A2|A1)P(A3|A1A2)...P(An|A1A2...An-1)

  (3)全概率公式

        1. 如果事件组B1,B2,.... 满足

               1.B1,B2....两两互斥,即 Bi ∩ Bj = ∅ ,i≠j , i,j=1,2,....,且P(Bi)>0,i=1,2,....;

               2.B1∪B2∪....=Ω ,则称事件组 B1,B2,...是样本空间Ω的一个划分

          设 B1,B2,...是样本空间Ω的一个划分,A为任一事件,则:
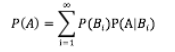
// 即为全概率公式(formula of total probability)

       2.全概率公式的意义在于,当直接计算P(A)较为困难,而P(Bi),P(A|Bi)  (i=1,2,...)的计算较为简单时,可以利用全概率公式计算P(A)。思想就是,将事件A分解成几个小事件,通过求小事件的概率,然后相加从而求得事件A的概率,而将事件A进行分割的时候,不是直接对A进行分割,而是先找到样本空间Ω的一个个划分B1,B2,...Bn,这样事件A就被事件AB1,AB2,...ABn分解成了n部分,即A=AB1+AB2+...+ABn, 每一Bi发生都可能导致A发生相应的概率是P(A|Bi),由加法公式得

         P(A)=P(AB1)+P(AB2)+....+P(ABn) = P(A|B1)P(B1)+P(A|B2)P(B2)+...+P(A|Bn)P(PBn)

        3.实例:某车间用甲、乙、丙三台机床进行生产,各台机床次品率分别为5%,4%,2%,它们各自的产品分别占总量的25%,35%,40%,将它们的产品混在一起,求任取一个产品是次品的概率。

                解:设.....     P(A)=25%*5%+4%*35%+2%*40%=0.0345

    (4)贝叶斯公式

      1.与全概率公式解决的问题相反,贝叶斯公式是建立在条件概率的基础上寻找事件发生的原因(即大事件A已经发生的条件下,分割中的小事件Bi的概率),设B1,B2,...是样本空间Ω的一个划分,则对任一事件A(P(A)>0),有
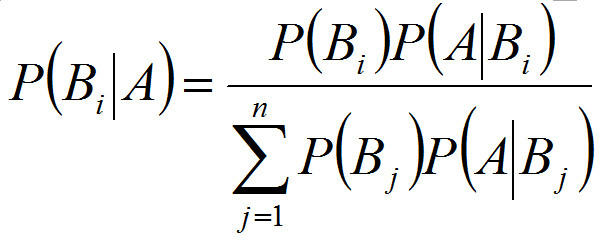
               

         上式即为贝叶斯公式(Bayes formula),Bi 常被视为导致试验结果A发生的”原因“,P(Bi)(i=1,2,...)表示各种原因发生的可能性大小,故称先验概率;P(Bi|A)(i=1,2...)则反映当试验产生了结果A之后,再对各种原因概率的新认识,故称后验概率。

      2.实例:发报台分别以概率0.6和0.4发出信号“∪”和“—”。由于通信系统受到干扰,当发出信号“∪”时,收报台分别以概率0.8和0.2受到信号“∪”和“—”;又当发出信号“—”时,收报台分别以概率0.9和0.1收到信号“—”和“∪”。求当收报台收到信号“∪”时,发报台确系发出“∪”的概率。

         解:设...., P(B1|A)= (0.6*0.8)/(0.6*0.8+0.4*0.1)=0.923


贝叶斯分类器实例

贝叶斯分类器是各种分类器中分类错误概率最小或者在预先给定代价的情况下平均风险最小的分类器。它的设计方法是一种最基本的统计分类方法。其分类原理是通过某对象的先验概率,利用贝叶斯公式计算出其后验概率,即该对象属于某一类的概率,选择具有最大后验概率的类作为该对象所属的类。摘自贝叶斯分类器百度百科

一、从阮一峰网络日志的例子,可以快速理解贝叶斯分类器。

某个医院早上收了六个门诊病人,如下表。

  症状  职业   疾病

  打喷嚏 护士   感冒 
  打喷嚏 农夫   过敏 
  头痛  建筑工人 脑震荡 
  头痛  建筑工人 感冒 
  打喷嚏 教师   感冒 
  头痛  教师   脑震荡

现在又来了第七个病人,是一个打喷嚏的建筑工人。请问他患上感冒的概率有多大?

根据贝叶斯定理:

 P(A|B) = P(B|A) P(A) / P(B)

可得

   P(感冒|打喷嚏x建筑工人)  =  P(打喷嚏x建筑工人|感冒) x P(感冒) / P(打喷嚏x建筑工人)

假定"打喷嚏"和"建筑工人"这两个特征是独立的,因此,上面的等式就变成了

   P(感冒|打喷嚏x建筑工人)  = P(打喷嚏|感冒) x P(建筑工人|感冒) x P(感冒)  /  P(打喷嚏) x P(建筑工人)

这是可以计算的。

  P(感冒|打喷嚏x建筑工人) = 0.66 x 0.33 x 0.5 / 0.5 x 0.33 = 0.66

因此,这个打喷嚏的建筑工人,有66%的概率是得了感冒。同理,可以计算这个病人患上过敏或脑震荡的概率。比较这几个概率,就可以知道他最可能得什么病。

这就是贝叶斯分类器的基本方法:在统计资料的基础上,依据某些特征,计算各个类别的概率,从而实现分类。

二、朴素贝叶斯分类器的公式

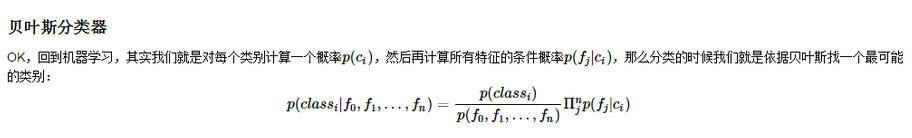
假设某个体有n项特征(Feature),分别为F1、F2、...、Fn。现有m个类别(Category),分别为C1、C2、...、Cm。贝叶斯分类器就是计算出概率最大的那个分类,也就是求下面这个算式的最大值:

 P(C|F1F2...Fn) = P(F1F2...Fn|C)P(C) / P(F1F2...Fn)

由于 P(F1F2...Fn) 对于所有的类别都是相同的,可以省略,问题就变成了求

 P(F1F2...Fn|C)P(C)

的最大值。

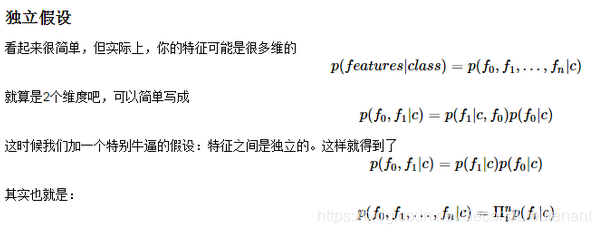
朴素贝叶斯分类器则是更进一步,假设所有特征都彼此独立,因此

 P(F1F2...Fn|C)P(C)  = P(F1|C)P(F2|C) ... P(Fn|C)P(C)

上式等号右边的每一项,都可以从统计资料中得到,由此就可以计算出每个类别对应的概率,从而找出最大概率的那个类。

虽然"所有特征彼此独立"这个假设,在现实中不太可能成立,但是它可以大大简化计算,而且有研究表明对分类结果的准确性影响不大。

下面再通过两个例子,来看如何使用朴素贝叶斯分类器。

三、账号分类的例子

摘自张洋的《算法杂货铺----分类算法之朴素贝叶斯分类》。

根据某社区网站的抽样统计,该站10000个账号中有89%为真实账号(设为C0),11%为虚假账号(设为C1)。

  C0 = 0.89

  C1 = 0.11

接下来,就要用统计资料判断一个账号的真实性。假定某一个账号有以下三个特征:

    F1: 日志数量/注册天数 
    F2: 好友数量/注册天数 
    F3: 是否使用真实头像(真实头像为1,非真实头像为0)

    F1 = 0.1 
    F2 = 0.2 
    F3 = 0

请问该账号是真实账号还是虚假账号?

方法是使用朴素贝叶斯分类器,计算下面这个计算式的值。

    P(F1|C)P(F2|C)P(F3|C)P(C)

虽然上面这些值可以从统计资料得到,但是这里有一个问题:F1和F2是连续变量,不适宜按照某个特定值计算概率。

一个技巧是将连续值变为离散值,计算区间的概率。比如将F1分解成[0, 0.05]、(0.05, 0.2)、[0.2, +∞]三个区间,然后计算每个区间的概率。在我们这个例子中,F1等于0.1,落在第二个区间,所以计算的时候,就使用第二个区间的发生概率。

根据统计资料,可得:

  P(F1|C0) = 0.5, P(F1|C1) = 0.1 
  P(F2|C0) = 0.7, P(F2|C1) = 0.2 
  P(F3|C0) = 0.2, P(F3|C1) = 0.9

因此,

  P(F1|C0) P(F2|C0) P(F3|C0) P(C0) 
    = 0.5 x 0.7 x 0.2 x 0.89 
    = 0.0623

  P(F1|C1) P(F2|C1) P(F3|C1) P(C1) 
    = 0.1 x 0.2 x 0.9 x 0.11 
    = 0.00198

可以看到,虽然这个用户没有使用真实头像,但是他是真实账号的概率,比虚假账号高出30多倍,因此判断这个账号为真。

四、性别分类的例子

本例摘自维基百科,关于处理连续变量的另一种方法。

下面是一组人类身体特征的统计资料。

  性别  身高(英尺) 体重(磅)  脚掌(英寸)

  男    6       180     12 
  男    5.92     190     11 
  男    5.58     170     12 
  男    5.92     165     10 
  女    5       100     6 
  女    5.5      150     8 
  女    5.42     130     7 
  女    5.75     150     9

已知某人身高6英尺、体重130磅,脚掌8英寸,请问该人是男是女?

根据朴素贝叶斯分类器,计算下面这个式子的值。

P(身高|性别) x P(体重|性别) x P(脚掌|性别) x P(性别)

这里的困难在于,由于身高、体重、脚掌都是连续变量,不能采用离散变量的方法计算概率。而且由于样本太少,所以也无法分成区间计算。怎么办?

这时,可以假设男性和女性的身高、体重、脚掌都是正态分布,通过样本计算出均值和方差,也就是得到正态分布的密度函数。有了密度函数,就可以把值代入,算出某一点的密度函数的值。

比如,男性的身高是均值5.855、方差0.035的正态分布。所以,男性的身高为6英尺的概率的相对值等于1.5789(大于1并没有关系,因为这里是密度函数的值,只用来反映各个值的相对可能性)。

有了这些数据以后,就可以计算性别的分类了。

  P(身高=6|男) x P(体重=130|男) x P(脚掌=8|男) x P(男) 
    = 6.1984 x e-9

  P(身高=6|女) x P(体重=130|女) x P(脚掌=8|女) x P(女) 
    = 5.3778 x e-4

可以看到,女性的概率比男性要高出将近10000倍,所以判断该人为女性。

---------------------------------------------------------------------------------------------------------------------------------


关于朴素贝叶斯分类器(Naïve Bayes Classifiers)的理解以及其在scikit-learn当中的实现 A brief overview of Naïve Bayes Classifiers. Examples are from the lecture slides of professors in CUHK, and codes are mostly from Introduction to Machine Learning with Python, by Andreas C. Muller & Sarah Guido. 阅读详情

相关推荐

贝叶斯分类器算法及案例详解

作者:vicky 致谢: 本文是对贝叶斯分类器(包括朴素贝叶斯分类器,半朴素贝叶斯分类器及贝叶斯网络)算法的演算及案例的详细分析。建议先阅读“理解贝叶斯分类器原理及关系”后再阅读本文,会对上述几种贝叶斯分类器有更深入的理解。本文只是在学习后进行了总结并加入了自己的理解,如有不妥之处,还望海涵,也希望大家多多指教,一起学习! 一、 朴素贝叶斯分类器 特点:假设输入的变量的特征属性之间具有很强的独立...

Spyderman 1万+

贝叶斯分类器讲解+实例

贝叶斯定理 贝叶斯定理是18世纪英国数学家托马斯·贝叶斯(Thomas Bayes)提出得重要概率论理论。 所谓的贝叶斯定理源于他生前为解决一个“逆概”问题写的一篇文章,而这篇文章是在他死后才由他的一位朋友发表出来的。在贝叶斯写这篇文章之前,人们已经能够计算“正向概率”,如“假设袋子里面有 N 个白球,M 个黑球,你伸手进去摸一把,摸出黑球的概率是多大”。而一个自然而然的问题是反过来:“如果我们事...

GUET_DM_LQ的博客 6302

贝叶斯分类器的matlab实现及案例

以狼来了为例,使用贝叶斯分类器对小孩三次说谎后的可信度的一个计算,并介绍了二分类问题的matlab实现

机器学习之朴素贝叶斯分类器原理详解、公式推导(手推)、面试问题、简单实例(python实现,sklearn调包)

主要内容分为理论推导和代码实现以及面试宝典三个部分。 理论推导主要是贝叶斯的推导以及朴素贝叶斯计算实例。 代码实现包括手动实现朴素贝叶斯和sklearn调用,实例有3个,分别对应离散型诗句和连续型数据两种情况。 面试宝典是一部分《机器学习》中的课后习题和一些面试题。

如果没有躺赢的命,那就站起来奔跑,你的努力一定会对得起这一路的颠沛流离。 2万+

QDMA工程搭建/windows驱动编译与性能测试

请注意,根据您的目标操作系统,您可能需要在windows启动配置中启用测试签名的驱动程序,以便启用此驱动程序的安装。右键单击设备,选择更新驱动程序软件,然后选择构建的QDMA驱动程序的文件夹(通常为。创建一个新工程,在IP Catalog中搜索QDMA,双击创建qdma ip核。驱动程序安装安装驱动程序最简单的方法是通过Windows的“设备管理器”。如果系统提示未经验证的驱动程序发布者,请选择无论如何安装此驱动程序软件。本节主要介绍QDMA驱动在Windows系统的源文件、编译和安装过程。

qq_28455081的博客 2287

27-eMMC电路设计

eMMC硬件电路设计

weixin_66510961的博客 4006

【数据挖掘】数据挖掘总结 ( 贝叶斯分类器示例 ) ★

一、 贝叶斯分类器分类的流程、 二、 贝叶斯分类器分类示例 1

让 学习 成为一种 习惯 ( 韩曙亮 の 技术博客 ) 1941

几种常见的Web攻击

几种常见的Web攻击 文章目录几种常见的Web攻击一、DoS攻击1.SYN洪水攻击2.IP欺骗3.Land攻击4.针对DoS攻击的防御二、CSRF攻击1. CSRF攻击的发生有三个必要条件:2.几种防护方法:三、XSS漏洞攻击1.非持久型XSS漏洞2.持久型XSS漏洞四、SQL注入1.SQL注入的危害2.SQL注入的方式3.防止SQL注入的解决方案 一、DoS攻击 DoS(Denial of Service),拒绝服务,顾名思义这种攻击是为了让服务器无法提供正常服务,最常见的DoS攻击是网络带宽攻击和连

wolfGuiDao的博客 1259

朴素贝叶斯分类器:例子解释

戳上面的蓝字关注我们! 作者:alg-flody 编辑:Emily 今日话题在昨天推送了用一个例子引入贝叶斯公式的基本思想,然后用贝叶斯公式对一个很简单的问题做分类,最后引出来一个问题:后验概率 P(c | x) 的求解转化为求解 P(c)和 P(x | c),P(c) 根据大数定律容易求得,所以 P(x | c)成为了最核心也是最迫切需要求解的问题。下面,借助一

算法channel 7654

【教程4>第4章>第20节】基于FPGA的costas环整体实现与仿真测试

Costas 环是一种用于载波同步的闭环反馈控制系统,主要应用于通信系统中的相干解调。其基本原理是通过鉴相器(Phase Detector,PD)比较接收信号与本地载波信号的相位差,将这个相位差信息经过环路滤波器(Loop Filter,LF)滤波后,去控制数控振荡器(Numerically Controlled Oscillator,NCO)的输出频率和相位,使得本地载波能够跟踪接收信号的载波,最终实现载波同步。Costas 环环路滤波器在载波同步过程中起着不可或缺的作用。

FPGA/MATLAB学习教程/源码/项目合作开发 1263

Mastercam软件二次开发:使用C#进行Mastercam二次开发

C#(发音为“C Sharp”)是一种现代、面向对象的编程语言,由微软开发,首次发布于2000年。它结合了C和C++的强大功能,同时引入了Java的垃圾回收机制,使得C#在开发效率和运行性能之间找到了一个良好的平衡点。C#的设计目标是提高开发者的生产力,它支持多种编程范式,包括面向对象、泛型、委托和事件等,这使得它成为开发Windows应用程序、Web应用程序、游戏(尤其是使用Unity引擎)和企业级应用的理想选择。

kkchenjj的博客 2214

第七章:贝叶斯分类器

在“同父”(common parent)结构中,给定父结点a1的取值,则xg与a4条件独立.在“顺序”结构中,给定α的值,则y 与z条件独立.V型结构(V-structure)亦称“冲撞”结构,给定子结点x4的取值, x1与x2必不独立;贝叶斯网训练好之后就能用来回答“查询”(query),即通过一些属性变量的观测值来推测其他属性变量的取值.例如在西瓜问题中,通过已知变量观测值来推测待查询变量的过程称为“推断”(inference),已知变量观测值称为“证据”(evidence).

qq_63029071的博客 1307

【深度学习新浪潮】Nano Banana(Gemini 2.5 Flash Image)技术解析与开发者实操指南

重新定义了 AI 图像生成的产业标准。它不仅是“平民化的视觉工厂”,更是推动内容生产从“创意试错”转向“精准制造”的关键工具。未来,随着视频生成能力的加入(谷歌计划支持“文字指令 - 动态场景 - 多平台适配”全流程),Nano Banana 有望进一步颠覆影视、广告等领域的创作范式。:批量生成多场景图,模特姿态自然,服装褶皱和材质细节高度一致,节省 90% 拍摄成本。模型的非正式代号,是一款革命性的 AI 图像生成与编辑工具,主打。:生成细节丰富的厨师特写,光影自然,皮肤纹理和刀具反光逼真。

专注:太空算力、AI infra、异构调度、大模型成本工程 888

机器学习-贝叶斯分类器

主要来源于西瓜书!🍉yyds!主要讲述了贝叶斯公式,贝叶斯分类器,朴素贝叶斯分类器。

fzz97_的博客 682

扣子Coze触发器使用指南:实现工作流定时执行的完整教程

Coze平台触发器功能详解:定时触发器配置指南 摘要:Coze平台的触发器是实现自动化任务的核心组件,其中定时触发器能够按预设时间自动执行工作流。本指南介绍了定时触发器的配置方法,包括每日、每周、每月及Cron表达式等多种时间设置方式,以及如何关联工作流执行具体任务。文章还提供了健身提醒等实用案例,并涵盖了触发器调试、发布及常见问题解决方案。通过合理配置定时触发器,用户可以轻松实现各类自动化任务,如定时发送消息、数据采集等,大幅提升工作效率。

互联网架构师笔记 1922

YOLO26改进 - C3k2 | C3k2 融合 ARConv 自适应矩形卷积:动态调整卷积核形状与采样点 | CVPR 2025

本文介绍了将自适应矩形卷积(ARConv)模块与YOLO26相结合的方法。ARConv是针对遥感图像全色锐化任务设计的创新卷积模块,可自适应调整卷积核形状与采样点数量,解决传统卷积刚性限制,实现高效特征提取。其工作流程包括学习卷积核高度和宽度、选择采样点数量、生成采样图、卷积实现与空间自适应增强。我们将集成ARConv的C3k2_ARConv模块引入YOLO26,对相关代码进行修改和注册,并配置了YOLO26 - C3k2_ARConv.yaml文件。实验脚本显示,该结合方式应用于目标检测任务。

魔改工程师的博客 496

6.1、贝叶斯分类器

1、贝叶斯分类器: 1)、实例一: 考虑一个医疗诊断问题,有两种可能的假设:(1)病人有癌症。(2)病人无癌症。样本数据来自某化验测试,它也有两种可能的结果:阳性和阴性。假设我们已经有先验知识:在所有人口中只有0.008的人患病。此外,化验测试对有病的患者有98%的可能返回阳性结果,对无病患者有97%的可能返回阴性结果。   上面的数据可以用以下概率式子表示: P(cancer)=0.0

军军的专栏 2087

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

朴素贝叶斯分类器(Naive Bayes Classifiers)

原文地址:Naive Bayes Classifiers 本文讨论的是朴素贝叶斯分类器( Naive Bayes classifiers)背后的理论以及其的实现。朴素贝叶斯分类器是分类算法集合中基于贝叶斯理论的一种算法。它不是单一存在的,而是一个算法家族,在这个算法家族中它们都有共同的规则。例如每个被分类的特征对与其他的特征对都是相互独立的。开始之前,先看一下数据集。这是一个虚构的数据集,这个

K.Sun 6万+

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

贝叶斯分类器做文本分类案例

贝叶斯分类器做文本分类 文本分类是现代机器学习应用中的一大模块,更是自然语言处理的基础之一。我们可以通过将文字数据处理成数字数据,然后使用贝叶斯来帮助我们判断一段话,或者一篇文章中的主题分类,感情倾向,甚至文章体裁。现在,绝大多数社交媒体数据的自动化采集,都是依靠首先将文本编码成数字,然后按分类结果采集需要的信息。虽然现在自然语言处理领域大部分由深度学习所控制,贝叶斯分类器依然是文本分类中的一颗明珠。现在,我们就来学习一下,贝叶斯分类器是怎样实现文本分类的。 文本编码技术简介 单词计数向量 在开始分

Grateful_Dead424的博客 3333

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

【转】朴素贝叶斯分类器的应用

作者: 阮一峰 日期: 2013年12月16日 生活中很多场合需要用到分类,比如新闻分类、病人分类等等。 本文介绍朴素贝叶斯分类器(Naive Bayes classifier),它是一种简单有效的常用分类算法。 一、病人分类的例子 让我从一个例子开始讲起,你会看到贝叶斯分类器很好懂,一点都不难。 某个医院早上收了六个门诊病人,如下表。   症状  职业  ...

anshi5303的博客 1120

朴素贝叶斯分类算法简单实例

贝叶斯分类是一类分类算法的总称,这类算法均以贝叶斯定理为基础,故统称为贝叶斯分类。而朴素朴素贝叶斯分类是贝叶斯分类中最简单,也是常见的一种分类方法。这篇文章我尽可能用直白的话语总结一下我们学习会上讲到的朴素贝叶斯分类算法,希望有利于他人理解。 1 分类问题综述 对于分类问题,其实谁都不会陌生,日常生活中我们每天都进行着分类过程。例如,当你看到一个人,你的脑子下意识判断他是学生还是社会上的人;你可能经常会走在路上对身旁的朋友说“这个人一看就很有钱”之类的话,其实这就是一种分类操作。 ..

signal___的博客 1万+

机器学习之Naive Bayes算法:日撸Java三百行day58-59

一、什么是Naive Bayes算法 Naive Bayes(NB)算法,亦称为朴素贝叶斯算法,是一个经典的、有代表性的分类算法。该算法是基于贝叶斯定理的分类方法,也是一种用后验概率公式推导出的算法。在NB算法中,采用了“属性条件独立性假设”(attribute conditional independence assumption):对已知类别,假设所有属性相互独立。换言之,假设每个属性独立地对分类结果发生影响。NB算法不仅能够处理符号型数据,也能够处理数值型数据。 朴素贝叶斯中的“朴素”就代表着:特征之

. 1686

朴素贝叶斯分类器

  朴素贝叶斯分类器基于统计的分类器一、病人分类的例子让我从一个例子开始讲起,你会看到贝叶斯分类器很好懂,一点都不难。某个医院早上收了六个门诊病人,如下表。      症状  职业   疾病      打喷嚏 护士   感冒      打喷嚏 农夫   过敏      头痛  建筑工人 脑震荡      头痛  建筑工人 感冒      打喷嚏 教师   感冒      头痛  教师   脑震...

liyonghui123的专栏 469

Naive Bayes Classifier详解(附带概率论公式推导)

Naive Bayes Classifier详解 第八次写博客,本人数学基础不是太好,如果有幸能得到读者指正,感激不尽,希望能借此机会向大家学习。这一篇的内容来自于各种书籍和网上资料,以及自己的一些见解。 预备知识: 这一部分主要是谈一谈概率论中的相关内容,以及贝叶斯决策论的介绍。 贝叶斯定理(Bayes’ theorem)   假设X,YX,YX,Y是一对随机变量,他们...

Ἥλιος 8452
上一篇: 【机器学习】LDA算法 (主题模型算法)
下一篇: 【机器学习】 SVD矩阵分解 整理
CWS_chen
博客等级 码龄11年 220粉丝 51原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值