


给你一个整数数组 nums,其中包含的正整数 互不相同 ,另给你一个整数 target。
请判断是否可以将 nums 分成两个 非空、互不相交 的 子集 ,并且每个元素必须 恰好 属于 一个 子集,使得这两个子集中元素的乘积都等于 target。
如果存在这样的划分,返回 true;否则,返回 false。
子集 是数组中元素的一个选择集合。
示例 1:
输入: nums = [3,1,6,8,4], target = 24
输出: true
解释:子集 [3, 8] 和 [1, 6, 4] 的乘积均为 24。因此,输出为 true 。
示例 2:
输入: nums = [2,5,3,7], target = 15
输出: false
解释:无法将 nums 划分为两个非空的互不相交子集,使得它们的乘积均为 15。因此,输出为 false。
提示:
3 <= nums.length <= 12
1 <= target <= 10^15
1 <= nums[i] <= 100
nums 中的所有元素互不相同。
解题思路:枚举所有可能的子集合
class Solution {
public:
    bool checkEqualPartitions(vector<int>& nums, long long t) {
        int n=nums.size();
        for(int i=1;i<(1<<n);i++){
            long long a0=1,a1=1;
            for(int j=0;j<n;j++){
                if(i>>j&1) a0*=nums[j];
                else a1*=nums[j];
                if(a0>t||a1>t) break;
            }
            if(a0==t&&a1==t) return true;
        }
        return false;
    }
};
// C 5_1+ C 5_2 + C 5_3 + C 5_4 = 2^n-1给你一个 m x n 的整数矩阵 grid 和一个整数 k。
对于矩阵 grid 中的每个连续的 k x k 子矩阵,计算其中任意两个 不同值 之间的 最小绝对差 。
返回一个大小为 (m - k + 1) x (n - k + 1) 的二维数组 ans,其中 ans[i][j] 表示以 grid 中坐标 (i, j) 为左上角的子矩阵的最小绝对差。
注意:如果子矩阵中的所有元素都相同,则答案为 0。
子矩阵 (x1, y1, x2, y2) 是一个由选择矩阵中所有满足 x1 <= x <= x2 且 y1 <= y <= y2 的单元格 matrix[x][y] 组成的矩阵。
示例 1:
输入: grid = [[1,8],[3,-2]], k = 2
输出: [[2]]
解释:
只有一个可能的 k x k 子矩阵:[[1, 8], [3, -2]]。
子矩阵中的不同值为 [1, 8, 3, -2]。
子矩阵中的最小绝对差为 |1 - 3| = 2。因此,答案为 [[2]]。
示例 2:输入: grid = [[3,-1]], k = 1
输出: [[0,0]]
解释:
每个 k x k 子矩阵中只有一个不同的元素。
因此,答案为 [[0, 0]]。
示例 3:输入: grid = [[1,-2,3],[2,3,5]], k = 2
输出: [[1,2]]
解释:
有两个可能的 k × k 子矩阵:
以 (0, 0) 为起点的子矩阵:[[1, -2], [2, 3]]。
子矩阵中的不同值为 [1, -2, 2, 3]。
子矩阵中的最小绝对差为 |1 - 2| = 1。
以 (0, 1) 为起点的子矩阵:[[-2, 3], [3, 5]]。
子矩阵中的不同值为 [-2, 3, 5]。
子矩阵中的最小绝对差为 |3 - 5| = 2。
因此,答案为 [[1, 2]]。
提示:1 <= m == grid.length <= 30
1 <= n == grid[i].length <= 30
-105 <= grid[i][j] <= 105
1 <= k <= min(m, n)
解题思路:直接枚举所有的子矩阵即可, 将子矩阵中的元素进行排序+去重, 求元素的相邻最小差值, 类似于今年某桥杯中的那个平滑度, 时间复杂度是(n-k)*(m-k)*k^2, (m 和 n都很小)
class Solution {
public:
    vector<vector<int>> minAbsDiff(vector<vector<int>>& grid, int k) {
        int m=grid.size(), n=grid[0].size();
        vector<vector<int>> ans; ans.resize(m-k+1,vector<int>(n-k+1,0));
        for(int i=0;i<=m-k;i++){
            for(int j=0;j<=n-k;j++){
                vector<int> a;
                for(int x=0;x<k;x++){
                    for(int y=0;y<k;y++){
                        a.push_back(grid[i+x][j+y]);
                    }
                }
                sort(a.begin(),a.end());
                a.erase(unique(a.begin(),a.end()),a.end());
                int min_diff=INT_MAX;
                for(int i=1;i<a.size();i++){
                    min_diff=min(min_diff,abs(a[i]-a[i-1]));
                }
                ans[i][j]=a.size()==1?0:min_diff;
            }
        }
        return ans;
    }
};

// 1 -2 3
// 2 3 5给你一个 m x n 的网格图 classroom,其中一个学生志愿者负责清理散布在教室里的垃圾。网格图中的每个单元格是以下字符之一:
'S' :学生的起始位置
'L' :必须收集的垃圾(收集后,该单元格变为空白)
'R' :重置区域,可以将学生的能量恢复到最大值,无论学生当前的能量是多少(可以多次使用)
'X' :学生无法通过的障碍物
'.' :空白空间
同时给你一个整数 energy,表示学生的最大能量容量。学生从起始位置 'S' 开始,带着 energy 的能量出发。每次移动到相邻的单元格(上、下、左或右)会消耗 1 单位能量。如果能量为 0,学生此时只有处在 'R' 格子时可以继续移动,此区域会将能量恢复到 最大 能量值 energy。
返回收集所有垃圾所需的 最少 移动次数,如果无法完成,返回 -1。
示例 1:
输入: classroom = ["S.", "XL"], energy = 2
输出: 2
解释:
学生从单元格 (0, 0) 开始,带着 2 单位的能量。
由于单元格 (1, 0) 有一个障碍物 'X',学生无法直接向下移动。
收集所有垃圾的有效移动序列如下:
移动 1:从 (0, 0) → (0, 1),消耗 1 单位能量,剩余 1 单位。
移动 2:从 (0, 1) → (1, 1),收集垃圾 'L'。
学生通过 2 次移动收集了所有垃圾。因此,输出为 2。
示例 2:输入: classroom = ["LS", "RL"], energy = 4
输出: 3
解释:
学生从单元格 (0, 1) 开始,带着 4 单位的能量。
收集所有垃圾的有效移动序列如下:
移动 1:从 (0, 1) → (0, 0),收集第一个垃圾 'L',消耗 1 单位能量,剩余 3 单位。
移动 2:从 (0, 0) → (1, 0),到达 'R' 重置区域,恢复能量为 4。
移动 3:从 (1, 0) → (1, 1),收集第二个垃圾 'L'。
学生通过 3 次移动收集了所有垃圾。因此,输出是 3。
示例 3:输入: classroom = ["L.S", "RXL"], energy = 3
输出: -1
解释:
没有有效路径可以收集所有 'L'。
提示:
1 <= m == classroom.length <= 20
1 <= n == classroom[i].length <= 20
classroom[i][j] 是 'S'、'L'、'R'、'X' 或 '.' 之一
1 <= energy <= 50
网格图中恰好有 一个 'S'。
网格图中 最多 有 10 个 'L' 单元格。
解题思路: 用BFS 求出 a[i][j][w][k]: 表示位于(i,j), 还有w的能量, 捡垃圾的情况是 k 所需的最小步数(给每个垃圾一个 0-9 的编号),用一个二进制 k 表示哪些垃圾已经捡过了), 注意有个重要的剪枝 ,如果这个 (x,y,new_k) 状态 已在更高能量访问过,就不必用较低能量访问,避免重复搜索。
class Solution {
public:
    const int d[4][2]={{1,0},{-1,0},{0,1},{0,-1}};
    int minMoves(vector<string>& a, int energy) {
        int m=a.size(),n=a[0].size();

        int r_cnt=0;
        int s_i=0,s_j=0;
        vector<vector<int>> f(m,vector<int>(n,-1));
        for(int i=0;i<m;i++){
            for(int j=0;j<n;j++){
                if(a[i][j]=='L'){
                    f[i][j]=r_cnt++;
                }else if(a[i][j]=='S'){
                    s_i=i,s_j=j;
                }
            }
        }
        vector<vector<vector<vector<int>>>> b(m, vector<vector<vector<int>>>(n, vector<vector<int>>(energy+1,vector<int>(1<<r_cnt,-1))));
        queue<tuple<int,int,int,int>> q;
        b[s_i][s_j][energy][0]=0;
        q.push({s_i,s_j,energy,0});
        while(!q.empty()){
            auto [i,j,w,k]=q.front(); q.pop();
            int s=b[i][j][w][k];
            for(int t=0;t<4;t++){
                int x=i+d[t][0],y=j+d[t][1];
                if(x<0||y<0||x>=m||y>=n) continue;
                if(a[x][y]=='X') continue;
                if(w==0&&a[i][j]!='R') continue;
                int new_w=(a[x][y]=='R'?energy:w-1);
                int new_k=k;
                if(a[x][y]=='L'&&f[x][y]!=-1){
                    new_k|=(1<<f[x][y]);
                }
                bool z=true;
                for(int e=new_w+1;e<=energy;e++){
                    if(b[x][y][e][new_k]!=-1){
                        z=false;
                        break;
                    }
                }
                if(z&&b[x][y][new_w][new_k]==-1){
                    b[x][y][new_w][new_k]=s+1;
                    q.push({x,y,new_w,new_k});
                }
            }
        }
        int res=-1;
        for(int i=0;i<m;i++){
            for(int j=0;j<n;j++){
                for(int w=0;w<=energy;w++){
                    if(b[i][j][w][(1<<r_cnt)-1]!=-1){
                        res=(res==-1?b[i][j][w][(1<<r_cnt)-1]:min(res,b[i][j][w][(1<<r_cnt)-1]));
                    }
                }
            }
        }
        return res;
    }
};给你一个长度为 'n' 的整数数组 nums,以及一个二维整数数组 queries,其中 queries[i] = [idx, val]。
对于每个查询:更新 nums[idx] = val。
选择一个满足 1 <= k < n 的整数 k ,将数组分为非空前缀 nums[0..k-1] 和后缀 nums[k..n-1],使得每部分中 不同 质数的数量之和 最大 。
注意:每次查询对数组的更改将持续到后续的查询中。返回一个数组,包含每个查询的结果,按给定的顺序排列。
质数是大于 1 的自然数,只有 1 和它本身两个因数。
示例 1:
输入: nums = [2,1,3,1,2], queries = [[1,2],[3,3]]
输出: [3,4]
解释:
初始时 nums = [2, 1, 3, 1, 2]。
在第一次查询后,nums = [2, 2, 3, 1, 2]。将 nums 分为 [2] 和 [2, 3, 1, 2]。[2] 包含 1 个不同的质数,[2, 3, 1, 2] 包含 2 个不同的质数。所以此查询的答案是 1 + 2 = 3。
在第二次查询后,nums = [2, 2, 3, 3, 2]。将 nums 分为 [2, 2, 3] 和 [3, 2],其答案为 2 + 2 = 4。
最终输出为 [3, 4]。
示例 2:输入: nums = [2,1,4], queries = [[0,1]]
输出: [0]
解释:
初始时 nums = [2, 1, 4]。
在第一次查询后,nums = [1, 1, 4]。此时数组中没有质数,因此此查询的答案为 0。
最终输出为 [0]。
提示:2 <= n == nums.length <= 5 * 10^4
1 <= queries.length <= 5 * 10^4
1 <= nums[i] <= 10^5
0 <= queries[i][0] < nums.length
1 <= queries[i][1] <= 10^5
解题思路: 题意是将原数组进行分割成一个非空前缀和一个非空后缀数组, 其实就是枚举数组的空隙,然后就是统计前缀和后缀中不同质数的总和,统计的时候, 我们可以在原质数总和的基础上, 去计算一个最大的增量
区间+1 && 区间求最大者 => lazy 线段树
题目中有个query 会修改数组中的值, 此时线段树中区间质数相同值就会发生变化, 所以我们要把一个子区间等于left 和 right 的相同值都维护起来,
eg: unordered_map<int,set<int>>;
key: 质数 value: 这个质数的下标的有序集合
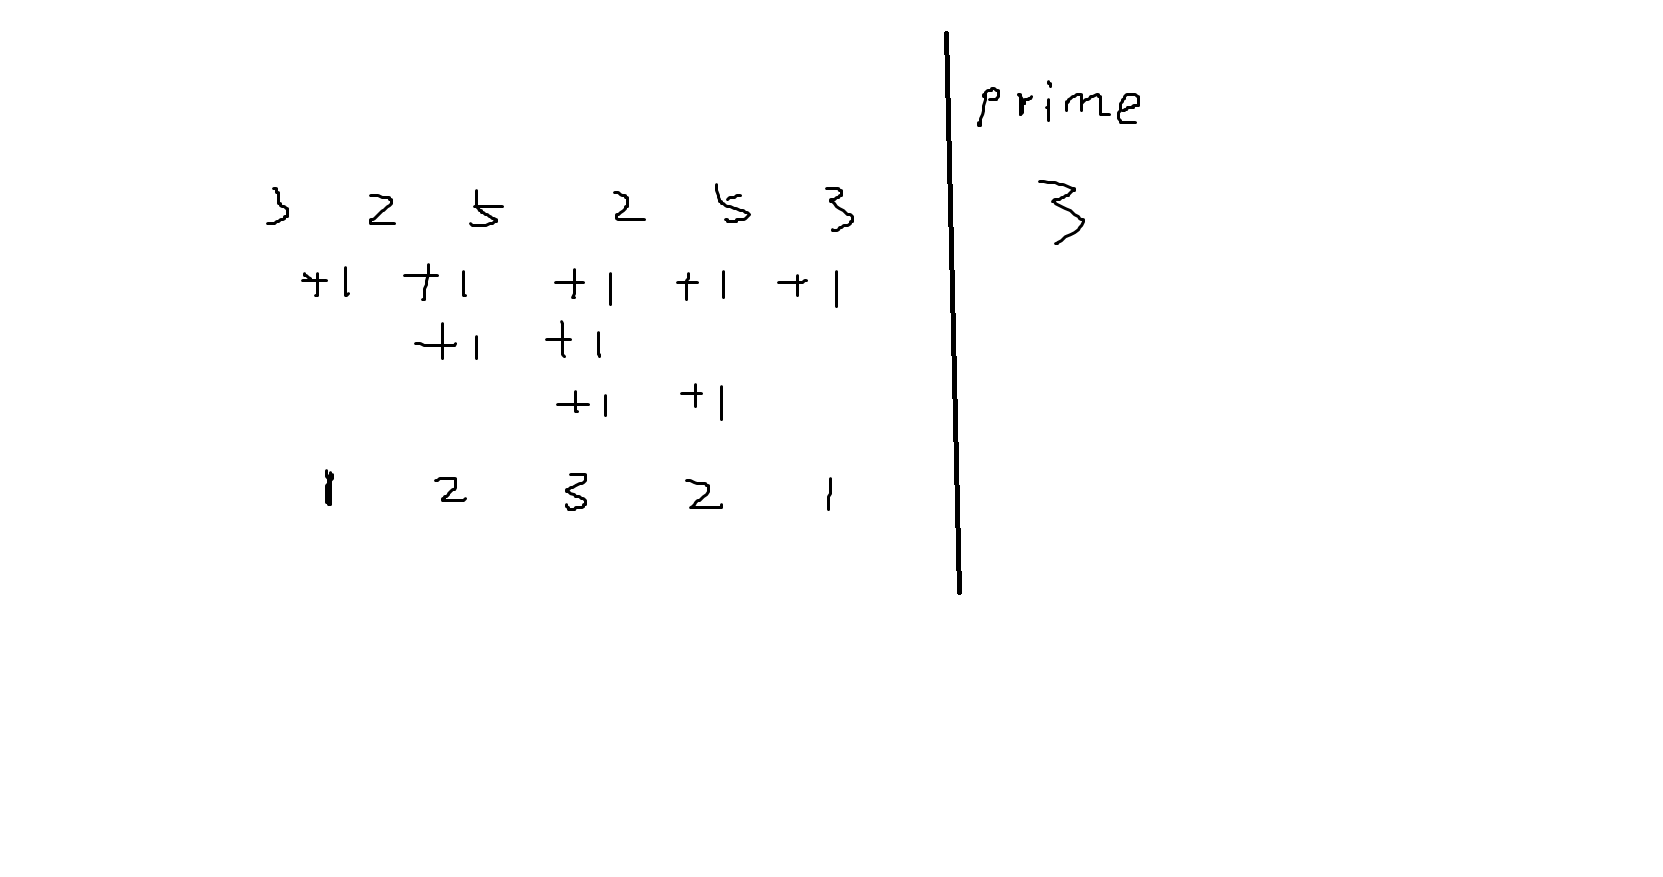
const int MX = 100'000;
bool np[MX + 1];

int init = []() {
    np[0] = np[1] = true;
    for (int i = 2; i <= MX; i++) {
        if (!np[i]) {
            for (int j = i; j <= MX / i; j++) { // 避免溢出的写法
                np[i * j] = true;
            }
        }
    }
    return 0;
}();

template<typename T, typename F>
class LazySegmentTree {
    // 注:也可以去掉 template<typename T, typename F>,改在这里定义 T 和 F
    // using T = pair<int, int>;
    // using F = pair<int, int>;

    // 懒标记初始值
    const F TODO_INIT = 0;

    struct Node {
        T val;
        F todo;
    };

    int n;
    vector<Node> tree;

    // 合并两个 val
    T merge_val(T a, T b) const {
        return max(a, b);
    }

    // 合并两个懒标记
    F merge_todo(F a, F b) const {
        return a + b;
    }

    // 把懒标记作用到 node 子树(本例为区间加)
    void apply(int node, int l, int r, F todo) {
        Node& cur = tree[node];
        // 计算 tree[node] 区间的整体变化
        cur.val += todo;
        cur.todo = merge_todo(todo, cur.todo);
    }

    // 把当前节点的懒标记下传给左右儿子
    void spread(int node, int l, int r) {
        Node& cur = tree[node];
        F todo = cur.todo;
        if (todo == TODO_INIT) { // 没有需要下传的信息
            return;
        }
        int m = (l + r) / 2;
        apply(node * 2, l, m, todo);
        apply(node * 2 + 1, m + 1, r, todo);
        cur.todo = TODO_INIT; // 下传完毕
    }

    // 合并左右儿子的 val 到当前节点的 val
    void maintain(int node) {
        tree[node].val = merge_val(tree[node * 2].val, tree[node * 2 + 1].val);
    }

    // 用 a 初始化线段树
    // 时间复杂度 O(n)
    void build(const vector<T>& a, int node, int l, int r) {
        Node& cur = tree[node];
        cur.todo = TODO_INIT;
        if (l == r) { // 叶子
            cur.val = a[l]; // 初始化叶节点的值
            return;
        }
        int m = (l + r) / 2;
        build(a, node * 2, l, m); // 初始化左子树
        build(a, node * 2 + 1, m + 1, r); // 初始化右子树
        maintain(node);
    }

    void update(int node, int l, int r, int ql, int qr, F f) {
        if (ql <= l && r <= qr) { // 当前子树完全在 [ql, qr] 内
            apply(node, l, r, f);
            return;
        }
        spread(node, l, r);
        int m = (l + r) / 2;
        if (ql <= m) { // 更新左子树
            update(node * 2, l, m, ql, qr, f);
        }
        if (qr > m) { // 更新右子树
            update(node * 2 + 1, m + 1, r, ql, qr, f);
        }
        maintain(node);
    }

    T query(int node, int l, int r, int ql, int qr) {
        if (ql <= l && r <= qr) { // 当前子树完全在 [ql, qr] 内
            return tree[node].val;
        }
        spread(node, l, r);
        int m = (l + r) / 2;
        if (qr <= m) { // [ql, qr] 在左子树
            return query(node * 2, l, m, ql, qr);
        }
        if (ql > m) { // [ql, qr] 在右子树
            return query(node * 2 + 1, m + 1, r, ql, qr);
        }
        T l_res = query(node * 2, l, m, ql, qr);
        T r_res = query(node * 2 + 1, m + 1, r, ql, qr);
        return merge_val(l_res, r_res);
    }

public:
    // 线段树维护一个长为 n 的数组(下标从 0 到 n-1),元素初始值为 init_val
    LazySegmentTree(int n, T init_val = 0) : LazySegmentTree(vector<T>(n, init_val)) {}

    // 线段树维护数组 a
    LazySegmentTree(const vector<T>& a) : n(a.size()), tree(2 << bit_width(a.size() - 1)) {
        build(a, 1, 0, n - 1);
    }

    // 用 f 更新 [ql, qr] 中的每个 a[i]
    // 0 <= ql <= qr <= n-1
    // 时间复杂度 O(log n)
    void update(int ql, int qr, F f) {
        update(1, 0, n - 1, ql, qr, f);
    }

    // 返回用 merge_val 合并所有 a[i] 的计算结果,其中 i 在闭区间 [ql, qr] 中
    // 0 <= ql <= qr <= n-1
    // 时间复杂度 O(log n)
    T query(int ql, int qr) {
        return query(1, 0, n - 1, ql, qr);
    }
};

class Solution {
public:
    vector<int> maximumCount(vector<int>& nums, vector<vector<int>>& queries) {
        int n = nums.size();
        unordered_map<int, set<int>> pos;
        for (int i = 0; i < n; i++) {
            int x = nums[i];
            if (!np[x]) {
                pos[x].insert(i);
            }
        }

        LazySegmentTree<int, int> t(n);
        for (auto& [_, s] : pos) {
            if (s.size() > 1) {
                t.update(*s.begin(), *s.rbegin(), 1);
            }
        }

        vector<int> ans;
        for (auto& q : queries) {
            int i = q[0], v = q[1];
            int old = nums[i];
            nums[i] = v;

            // 处理旧值
            if (!np[old]) {
                auto& s = pos[old];
                if (s.size() > 1) {
                    t.update(*s.begin(), *s.rbegin(), -1); // 撤销之前的区间 +1
                }
                s.erase(i);
                if (s.size() > 1) {
                    t.update(*s.begin(), *s.rbegin(), 1); // 新的区间 +1
                } else if (s.empty()) {
                    pos.erase(old);
                }
            }

            // 处理新值
            if (!np[v]) {
                auto& s = pos[v];
                if (s.size() > 1) {
                    t.update(*s.begin(), *s.rbegin(), -1); // 撤销之前的区间 +1
                }
                s.insert(i);
                if (s.size() > 1) {
                    t.update(*s.begin(), *s.rbegin(), 1); // 新的区间 +1
                }
            }

            // 整个数组的不同质数个数 + 切一刀的最大额外收益
            ans.push_back(pos.size() + t.query(0, n - 1));
        }

        return ans;
    }
};
感觉牛客最后一题喜欢出组合数的问题, 力扣更偏向于线段树
想追求AK的同学可以重点突破一下, 线段树的板子可以去我基础算法那栏找一下
感谢大家的点赞和关注,你们的支持是我创作的动力!

 4018


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


