python进行数据预处理的4个重要步骤

深入解析数据预处理技术 数据清洗是数据预处理的重要环节,可以帮助提高数据质量,减少错误和噪声的影响,使数据更适合后续分析和应用。数据清洗的对象是数据,目的是发现并纠正数据文件中可识别的错误,包括检查数据一致性,处理无效值和缺失值等。理解数据:在选择数据预处理方法之前,首先要深入理解数据的特点、分布和含义。这包括了解数据的类型(数值型、类别型、文本型等)、数据的缺失情况、数据的分布和偏度等。只有对数据有深入的理解,才能选择合适的预处理方法。选择合适的缺失值处理方法:根据缺失值的类型和缺失值的比例选择合适的缺失值处理方法。 阅读详情

在数据科学项目中,数据预处理是最重要的事情之一。

如果有正确的数据预处理和特征工程,该模型更有可能与数据未得到很好预处理的模型相比,产生更好的结果。

数据预处理主要有4个重要步骤。

  • 拆分训练集和测试集
  • 处理缺失值
  • 处理分类特征
  • 进行标准化处理
拆分训练集和测试集

训练集和测试集拆分是机器学习中的重要步骤之一。

这非常重要,因为你的模型需要在部署之前进行评估。

训练集和测试集拆分背后的主要思想是将原始数据集转换为两部分

  • 训练集
  • 测试集

其中训练集由训练数据和训练标签组成,测试集由测试数据和测试标签组成。

最简单的方法是使用 scikit-learn 的 一个内置函数 train_test_split。

from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.2)

在这里,我们在 train_test_split 中传入了 X 和 y 作为参数 ,它将 X 和 y 进行拆分,其中训练集占 80%,测试集占 20% 。

处理缺失值

你可能听说过一个著名的机器学习短语,它是

Garbage in Garbage out

如果你的数据集充满了缺失值,那么你的模型效果也不好。

因此,处理此类缺失值很重要。

让我们用一个虚拟数据集来看看我们如何解决这个问题。

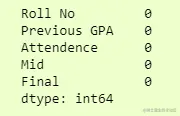
首先查看一下数据集中的缺失值。

df.isna().sum()
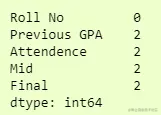
我们可以看到数据集中有缺失值。

填充缺失值的一种方法是用该列的平均值填充。

例如,我们可以用该列所有学生的平均值来填充 Final 列的缺失值。

为此,我们可以使用 sklearn.impute 中的 SimpleImputer 。

from sklearn.impute import SimpleImputer

imputer = SimpleImputer(fill_value=np.nan, startegy='mean')
X = imputer.fit_transform(df)

这将使用 该列的 平均值 填充数据框 df 中的所有缺失值 。

可以使用 fit_transform 函数来做到这一点。

X = pd.DataFrame(X, columns=df.columns)
print(X)
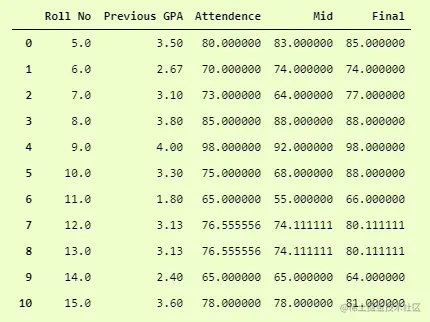
现在,可以看到所有缺失值都用均值进行了填充。

X.isna().sum()
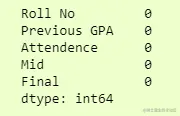
我们也可以在 SimpleImputer 中使用 mean、 meadian、 mode 等 。

如果 缺失值的行数较少,或者我们的数据不建议填充缺失值,那么可以在 pandas 中使用 dropna 删除缺失的行。

dropedDf = df.dropna()

在这里,我们删除了数据框中的所有空行并将其存储在另一个数据框中。

dropedD.isna().sum()
处理分类特征

我们可以通过将它们转换为整数来处理分类特征。有两种常见的方法可以做到这一点。

  • Label Encoding
  • One Hot Encoding

在 Label Encoder中,将分类值转换为数字标签。假设这是我们的数据集
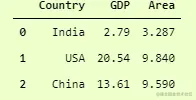
在 Country 列上使用 Label Encoding 会将 India 转换为 1,将 USA 转换为 2,将 China 转换为 0。

这种技术有一个缺点,即由于 USA 的标签高,它给予 USA 最高优先级,而 China 的优先级最低,标签为 0。

from sklearn.preprocessing import LabelEncoder

l1 = LabelEncoder()
l1.fit(catDf['Country'])
catDf.Country = l1.transform(catDf.Country)
print(catDf)
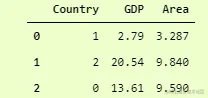
如代码所示,我们实例化了一个 LabelEncoder 对象,然后使用 fit 方法将其应用到分类列上,然后使用 transform 方法进行转换。

在 OneHotEncoder 中 ,我们为每个唯一的分类值创建一个新列。

下面通过一个例子来了解一下。

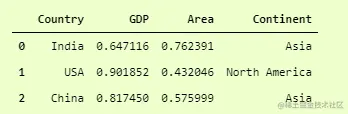
我们将添加另一个分类列,即 “Continent”。

catDf['Continent'] = ['Asia', 'North America', 'Asia']
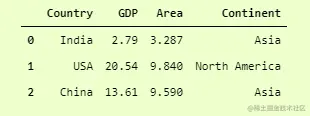
现在因为我们有 2 个分类列,它们是 [[‘Country’, ‘Continent’]],我们可以对它们进行独热编码。

有两种方法可以做到这一点。

1.DataFrame.get_dummies

这是一种非常常见的方法,我们使用 pandas 内置函数 get_dummies 将数据帧中的分类值转换为独热编码。

pd.get_dummies(data=catDf)

这将 返回 一个数据帧。
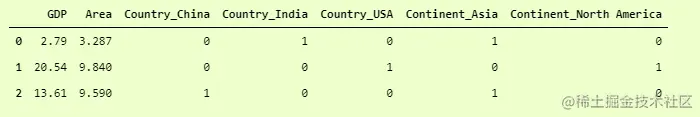
在这里我们可以看到它已经将 Country 列的唯一值转换为 3 个不同的列,分别是 Country_China、Country_India 和 Country_USA。同样,Continent 列的 2 个唯一值已转换为 2 个不同的列,分别命名为 Continent_Asia 和 Continent_North America。

2.OneHotEncoder

使用 scikit-learn 中的 OneHotEncoder 也是一种常见的做法。

它提供了更多的灵活性和更多的选择,但使用起来有点困难。

让我们看看如何为我们的数据集做这件事。

from sklearn.preprocessing import OneHotEncoder

oh = OneHotEncoder()
s1 = pd.DataFrame(oh.fit_transform(catDf.iloc[:, [0,3]]))
catDf = pd.concat([catDf, s1], axis=1)

在这里,我们已经初始化了 OneHotEncoder 对象,并在数据框中对我们想要的列(列号 0 和列号 3)上使用了它的 fit_transform方法。

fit_transform 的返回类型 是 numpy.ndarray ,所以我们通过pd.DataFrame 将其转换为数据框 ,并存储在一个变量中。

然后,为了将它加入我们的原始数据帧,可以使用 pd.concat 连接 2 个不同数据帧。
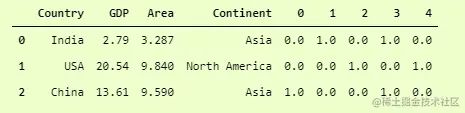
你可以看到,与 pd.get_dummies 相比,它的可读性并不清晰

但是如果你比较使用 pd.get_dummies 和 OneHotEncoder 获得的最后 5 列,它们都是相等的。

标准化数据集

某些实验证明,与未标准化的数据集相比,机器学习和深度学习模型在标准化数据集上的表现更好。

有几种方法可以做到这一点。我将讨论标准化数据集的 2 种常用方法。

1、Standard Scaler
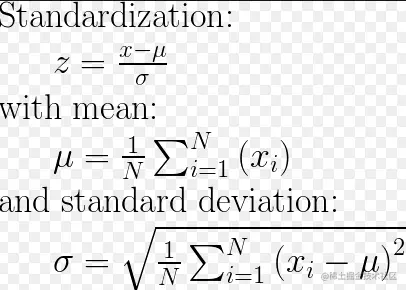
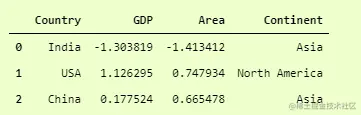
使用这种技术,可以将数据集转化为均值为 0,标准差为 1。

from sklearn.preprocessing import StandardScaler

ss = StandardScaler()
catDf.iloc[:,1:-1] = ss.fit_transform(catDf.iloc[:,1:-1])
print(catDf)
2、Normalization

正则化是将 **每个样本缩放到单位范数(每个样本的范数为1)**的过程。

如果你计划使用二次型(点积)或任何其他核方法来计算两个样本之间的相似性,则此过程会很有用。

Normalization 主要思想是对每个样本计算其p-范数,然后对该样本中每个元素除以该范数,这样处理的结果是使得每个处理后样本的p-范数(l1-norm,l2-norm)等于1。

使用过程非常简单,与 StandaradScaler 类似。

from sklearn.preprocessing import Normalizer

norm = Normalizer()
catDf.iloc[:,1:-1] = norm.fit_transform(catDf.iloc[:,1:-1])
catDf
---------------------------END---------------------------

题外话

当下这个大数据时代不掌握一门编程语言怎么跟的上脚本呢?当下最火的编程语言Python前景一片光明!如果你也想跟上时代提升自己那么请看一下.

在这里插入图片描述

感兴趣的小伙伴,赠送全套Python学习资料,包含面试题、简历资料等具体看下方。


👉优快云大礼包🎁:全网最全《Python学习资料》免费赠送🆓!(安全链接,放心点击)

一、Python所有方向的学习路线

Python所有方向的技术点做的整理,形成各个领域的知识点汇总,它的用处就在于,你可以按照下面的知识点去找对应的学习资源,保证自己学得较为全面。

img
img

二、Python必备开发工具

工具都帮大家整理好了,安装就可直接上手!img

三、最新Python学习笔记

当我学到一定基础,有自己的理解能力的时候,会去阅读一些前辈整理的书籍或者手写的笔记资料,这些笔记详细记载了他们对一些技术点的理解,这些理解是比较独到,可以学到不一样的思路。

img

四、Python视频合集

观看全面零基础学习视频,看视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

img

五、实战案例

纸上得来终觉浅,要学会跟着视频一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

img

六、面试宝典

在这里插入图片描述

在这里插入图片描述

简历模板在这里插入图片描述

👉优快云大礼包🎁:全网最全《Python学习资料》免费赠送🆓!(安全链接,放心点击)

若有侵权,请联系删除

Python数据预处理 数据预处理是指在机器学习、数据分析和数据挖掘等领域中,对原始数据进行一系列的处理和转换,以便为后续的分析和建模做好准备。数据预处理是数据科学项目中的重要步骤,因为原始数据往往存在各种质量问题,如缺失值、异常值、重复数据、不一致的格式等,这些问题会直接影响模型的性能和最终结果的准确性。因此在数据分析中,对数据做数据预处理是必不可少的一个环节。 阅读详情

相关推荐

用Breakfast数据集复现动作分割?先搞定这5个Python预处理脚本(附代码)

本文详细介绍了如何使用5个Python预处理脚本处理Breakfast数据集,以复现动作分割研究。从数据解构、视频抽帧到标签对齐和数据集划分,提供了完整的代码示例和工程技巧,帮助研究者高效处理复杂数据并优化DataLoader性能。

weixin_31236101的博客 279

数据预处理

介绍了数据预处理的基本概念,缺失值,异常值,重复值的处理方法,以及数据转换的方法,数据预处理常用的一些类库

JasonH2021的博客 1万+

CAMS数据下载与WRF-Chem预处理全流程指南

大气成分数据是气象与空气质量模拟的重要输入,其中CAMS全球再分析数据因其高时空分辨率和多组分覆盖,成为WRF-Chem等模型的理想数据源。通过ECMWF API实现自动化下载与Python脚本处理,可将原始GRIB数据高效转换为WRF-ready格式。关键技术环节包括变量提取、时空维度合并、单位系统转换以及垂直层插值,最终生成符合WRF-Chem要求的ANTHRO排放文件。这套方案特别适用于温室气体模拟场景,能显著提升CO2、CH4等组分的模拟精度。数据处理过程中需注意内存管理、缺值处理和变量命名映射等典

319

python数据预处理

python数据预处理(缺失值处理,异常值处理,特征分析,标准化/归一化处理,相关性分析)

m0_67790374的博客 3万+

【数据预处理】Python数据预处理常见操作

  文章总结了拿到原始数据后,做数据预处理的常见操作。后续会根据总结不断更新。 目录一、数据查看二、数据转换三、数据清洗1.异常值2.重复值3.缺失值四、数据获取五、数据合并1.join,基于index连接DataFrame的列2.merge,基于column连接,类似SQL的join3.concat,合并相同的Excel或给DataFrame添加行或列时使用六、其他操作1.数据分组聚合2.列表生...

WANG_hl的博客 4856

在机器学习中,如何用Python进行数据预处理?

数据分析之路持续学习中- - - 近期学习了机器学习中的数据预处理章节,在此进行分享,欢迎大家讨论指正。 顺便说一下,这里我使用的软件是Anacnoda 3中已经安装好的Spyder 3,这个软件用起来很爽,适合用来做数据分析,缺点就是不好进行调试以及管理大型项目。 如果是要用来做网页等大型工程的话,建议:Anacnoda + Pycharm。 数据预处理有哪些步骤? 机器学习中,数据预处理全流程...

lailq的博客 7367

python进行数据预处理的4个重要步骤!

在数据科学项目中,数据预处理是最重要的事情之一。如果有正确的数据预处理主要有4个重要步骤。

z099164的博客 795

数据预处理:如何准备你的数据集

1. 背景介绍 1.1 数据的重要性 在当今这个数据驱动的时代,数据已经成为了企业和科研机构的核心资产。通过对数据的挖掘和分析,我们可以发现潜在的规律、趋势和关联,从而为决策提供有力支持。然而,原始数据往往是不完整、不准确、不一致和冗余的,这给数据分析带来了很大的挑战。因此,数据预处理成为了数据挖掘和机

AI天才研究院 227

数据挖掘入门避坑指南:手把手教你用Python搞定数据预处理的4个核心步骤(附Educoder习题思路)

本文详细解析了数据挖掘中数据预处理的4个核心步骤,包括缺失值处理、离散化、规范化和相关性分析,特别针对Educoder平台习题提供了实用解题策略。通过实际案例和代码示例,帮助读者避开常见陷阱,掌握Python数据预处理的精髓,提升数据挖掘实战能力。

weixin_30256901的博客 289

无人机目标检测:在VisDrone数据集上使用YOLOv4进行目标检测任务

同时,还可以尝试其他先进的目标检测算法和数据增强技术来改进无人机目标检测的效果。YOLOv4是一种高效的目标检测算法,它结合了YOLO系列算法的速度和准确性。VisDrone数据集是专门用于无人机视觉任务的数据集,其中包含大量无人机图像和注释,适合用于训练和评估目标检测算法。训练过程中,需要定义损失函数和优化器,并设置训练的超参数,如学习率、批量大小和训练轮数。使用VisDrone测试集对训练后的模型进行评估。将测试集中的图像输入到训练好的模型中,通过计算预测结果与真实标签的差异来评估模型的性能。

XlltEditor的博客 442

高速接口电平标准互连设计:LVPECL、PECL与LVDS的实战解析

本文深入解析了LVPECL、PECL与LVDS三种高速接口电平标准的互连设计实战。针对信号共模电压、阻抗匹配等核心差异,详细对比了直流耦合与交流耦合两种主流方案,并提供了电阻网络计算、布局布线要点及光模块等特殊场景下的选型建议,帮助工程师解决高速信号间的“翻译”难题,确保信号完整性。

weixin_29198045的博客 542

数据采集及预处理——针对“数据”“采集”“预处理”的理解与解析

数据采集及预处理 文章目录数据采集及预处理前言一、 数据二、 采集1.系统日志采集2.网络数据采集3.ETL三. 预处理总结 前言 一、 数据 在计算机系统中,各种字母、数字符号的组合、语音、图形、图像等统称为数据,数据经过加工后就成为信息。 数据(data)是事实或观察的结果,是对客观事物的逻辑归纳,是用于表示客观事物的未经加工的的原始素材。 数据是信息的表现形式和载体,可以是符号、文字、数字、语音、图像、视频等。 数据和信息是不可分离的,数据是信息的表达,信息是数据的内涵。 数据本身没有意义,数据只

weixin_47366863的博客 1万+

强化学习 reward 曲线可视化:从基础绘制到顶刊级对比分析

本文详细介绍了强化学习reward曲线的可视化方法,从基础绘制到顶刊级对比分析。通过matplotlib和seaborn的实战示例,展示了如何优化曲线图的视觉效果,包括多实验对比、置信区间添加和分面图应用。文章还分享了顶刊级图表的进阶技巧,如字体排版、颜色选择和关键标注,帮助研究者提升论文图表质量。

weixin_29096377的博客 272

字段缺失_Python数据预处理——缺失值、重复值

一、缺失值处理 isnull( ) 、fillna( ) 、dropna( )(1)查看缺失查看数据集缺失,返回每列的缺失个数 df.isnull().sum() 查看某字段有缺失的行 df[df.a.isnull()] 查看某字段每行的缺失情况:返回T/F:df.score.isnull() 、返回0/1:df.score.isnull().astype(int)缺失占比返回每列的缺失占比:...

weixin_36439481的博客 1041

手把手教你用ESP32驱动MAX30102心率血氧传感器(含完整代码)

本文详细介绍了如何使用ESP32微控制器驱动MAX30102心率血氧传感器,构建智能健康监测系统。内容涵盖PPG原理、硬件连接、驱动配置、信号处理算法以及Web服务器数据可视化,提供完整代码实现,帮助开发者快速上手物联网健康设备开发。

weixin_29208077的博客 590

ORB-SLAM3代码详解 - 第 18 篇 · Atlas 多地图系统、地图保存与全系统调优

会跑:理解三线程架构与数据流(01/08/10/13),能编译、配参、复现各数据集结果。会改:掌握相机模型抽象(05)、g2o 顶点与边(14)、预积分(15),能接入新传感器、新相机、新约束。会调:理解每个参数背后的物理含义与耦合(03/15/16/18),能针对自己的平台与场景做精度/实时/鲁棒的权衡。ORB-SLAM3 的价值不止于一个可用的 SLAM 系统,更在于它是一套工程化的几何状态估计模板:清晰的模块边界、可替换的相机/传感器抽象、紧耦合优化的标准范式。

PX4-SLAM-PNC 173

STARFM4py:Python中的高效时空影像融合解决方案

STARFM4py:Python中的高效时空影像融合解决方案 项目基础介绍与编程语言 STARFM4py是一个专门针对Python环境开发的开源项目,它致力于简化遥感图像的时空融合过程。本项目由Nikolina Mileva匠心打造,采用广受认可的GPL-3.0许可协议。STARFM4py依托Python的强大库支持,特别适合从事高级遥感数据分析的专业人士,让复杂的时空融合任务变得更加可访问和高效...

gitblog_09141的博客 547

零基础学simulink仿真建模--使用Simulink来构建一个混合动力无人机中燃料电池与锂电池协同控制的仿真模型

延长飞行时间:燃料电池的能量密度高于锂电池,适合长时间稳定供电。提高功率密度:锂电池能够快速响应瞬时高功率需求,比如起飞和加速阶段。优化能源管理:通过有效的能量管理系统,可以根据实际需求动态调整燃料电池和锂电池的工作状态,从而提高整体效率。通过上述步骤,我们简要介绍了如何基于Simulink实现混合动力无人机中燃料电池与锂电池协同控制的仿真模型。

amy_mhd的博客 191

数据挖掘-C4.5算法

参考: 1,《数据挖掘十大算法》清华大学出版社版本。 2,http://blog.youkuaiyun.com/zjsghww/article/details/51638126

xt720shuaji的博客 609

OpenAI Function Calling 实战:让 Agent 自动调用外部 API 接口

在 2023 年 6 月之前,大语言模型(LLM)的能力边界是清晰的:它能说会道,能写诗作赋,也能帮你润色文案。但如果你问它"北京现在天气怎么样",它要么答不上来,要么基于过时的训练数据给你一个错误答案。原因很简单——LLM 的训练数据是有截止日期的,它活在"过去"。2023 年 6 月,OpenAI 在 GPT-4 的更新中引入了 Function Calling 功能,彻底改变了这一局面。Function Calling(也叫 Tool Use 或工具调用)是一种让 LLM 与外部系统交互的机制。

2201_76125393的博客 92

Python 爬虫实战:社交媒体(Facebook)评论数据抓取与情感分析

在当今数字化时代,社交媒体平台如 Facebook 已成为人们日常生活中不可或缺的一部分。它不仅是人们分享生活点滴、交流思想的场所,也为企业和研究人员提供了丰富的数据资源。通过分析社交媒体上的评论数据,我们可以了解用户的情感倾向、产品反馈以及社会热点话题等。本文将详细介绍如何使用 Python 爬虫技术抓取 Facebook 上的评论数据,并进行情感分析。这不仅是一次技术实战,更是一次数据探索之旅。

yansideyucsdn的博客 672

python 标准差_Python数据清洗学习笔记(八):数据的预处理

有时候我们需要对一些特定的数值进行处理,比如重复值,异常值或缺失值等等。今天我们从以下四个方面入手:1.重复值处理2.异常值处理3.缺失值处理4.数据离散化一:重复值处理我们先可判断是否存在重复值,然后在进行处理:删除或者保留1.df.duplicated方法2.df.drop_duplicates方法二:缺失值处理对于缺失值,我们可以对之删除,或者用一些特殊值替代。1.df.isnull方法2....

weixin_39948824的博客 174

手把手教你学pcie--用Verilog搭建PCIe控制器核心模块

PCIe控制器是硬件设计的核心模块,负责实现设备与主机之间的高速通信。本文将以Verilog语言为例,分步骤讲解如何从零构建一个简化的PCIe控制器核心模块,涵盖事务层(TLP)生成、数据链路层(DLLP)处理和物理层(PHY)接口适配。目标是为嵌入式开发者、FPGA工程师提供一个可扩展的硬件设计框架。​。

MHD0815的博客 341

机器学习中的数据预处理方法与步骤

机器学习预处理详细方法

全栈川川 4万+

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

上一篇: Python基础教程:Matplotlib图形绘制
下一篇: 一步到位!Python中Reduce函数轻松解决复杂数据聚合
Python_P叔
博客等级 码龄3年 5455粉丝 827原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值