收藏!小白程序员必看:RLHF与DPO大模型对齐区别及DPO为何成主流?

LVGL v9的lv_scale控件实战:5分钟打造动态仪表盘(附完整代码) 本文详细介绍了LVGL v9中lv_scale控件的实战应用,通过5个关键步骤快速打造动态仪表盘。文章涵盖核心特性解析、代码实现、样式定制及性能优化,适用于工业HMI、智能家居等场景,并附完整代码示例。 阅读详情

收藏!小白程序员必看:RLHF与DPO大模型对齐区别及DPO为何成主流?

大模型对齐技术是确保模型输出符合人类伦理和安全规范的关键。RLHF通过SFT、奖励模型训练和PPO三阶段优化,效果强但流程复杂、成本高、不稳定。DPO直接优化人类偏好,跳过奖励模型和强化学习,具有端到端可训练、稳定高效、实证表现好等优势,成为主流替代方案。文章还提供大模型学习路线图,涵盖基础、进阶和实战项目,助小白快速掌握大模型核心技术。

一、先搞懂:大模型为啥非要做“对齐”?

大语言模型(LLM)经过海量文本预训练后,本质上就是一台高效的“下一个词预测机器”。你可以把它理解成一个博闻强记但缺乏是非判断能力的“超级学霸”——它能精准调用脑海里的知识库输出内容,却分不清自己的回答是“好”是“坏”:问它极端对立的观点,它会顺着逻辑一路续写;问它违规风险内容,它甚至可能给出看似“逻辑自洽”的执行方案。

这种“价值观缺失”“输出不可控”的问题,直接制约了大模型的商业化落地,于是“对齐(Alignment)”技术应运而生。简单说,对齐技术就是通过一系列算法手段,让模型的输出贴合人类的伦理准则、安全规范和实际使用偏好。而RLHF(人类反馈强化学习),就是最早成熟、应用最广泛的对齐方案。

二、RLHF:三阶段的“人类反馈强化学习”

RLHF 由三步组成:

1.SFT(Supervised Fine-tuning)

  • 用高质量指令数据(如“问答”“总结”“翻译”)微调模型,让它学会遵循人类指令。
  • 这是“教模型说话”的第一步。

  1. Reward Model 训练
  • 给同一个问题生成多个回答,让人工标注者排序哪个更好。
  • 用这些排序训练一个奖励模型 ( R(x, y) ),预测回答的“人类偏好分数”。

  1. 强化学习阶段(PPO)
  • 用奖励模型当“人类代理”,指导语言模型生成输出。
  • 优化目标是:让模型生成的回复能最大化奖励,同时约束不要偏离原语言模型(通过 KL 散度惩罚)。

公式上可以表示为:

这一步的关键是:模型通过强化学习,在“奖励函数”的指引下逐步调整生成策略。

三、RLHF 的痛点

RLHF 效果强,但也很“重”:

  • 流程复杂:要三步训练,特别是强化学习(PPO)部分非常难调;
  • 不稳定:奖励模型噪声会导致训练不收敛;
  • 成本高:每次都要采样、评估、梯度更新,计算量巨大;
  • 不可控性:有时候模型会学会“讨好”奖励模型,而非真正遵循人类偏好(Reward Hacking)。

这些问题让 RLHF 成为大模型训练中最“烧 GPU”的环节之一。于是研究者开始思考:有没有办法跳过强化学习那一步,直接学到相同的偏好?

四、DPO:直接偏好优化

2023 年,Anthropic 提出了 DPO(Direct Preference Optimization),它一出现就成了替代 RLHF 的轻量方案。DPO 不用训练奖励模型,也不用强化学习,而是直接在原始语言模型上优化人类偏好。

它的关键思想是我们其实已经有人工标注的“好回答”和“坏回答”对,既然知道哪一个更好,为什么还要额外学一个奖励模型再强化学习?直接优化概率分布,让模型对“好回答”的概率更高,对“坏回答”的概率更低,不就行了吗?

于是 DPO 提出了一个简洁的目标函数:

简单理解就是让模型在参考模型基础上,倾向生成被人类偏好的回答 ( y^+ ),同时降低生成不被偏好的回答 ( y^- ) 的概率。

DPO 的神奇之处在于——它等价于一个简化版的 RLHF:

  • 不显式训练奖励模型;
  • 不需要采样环境;
  • 直接用对比损失优化语言模型。

五、为什么 DPO 能替代 RLHF?

DPO 的核心优势有三点:

  1. 端到端可训练
    不需要单独的奖励模型,也不需要强化学习框架,直接基于语言建模损失优化即可。
  2. 稳定高效
    不存在 PPO 的梯度不稳定问题,训练速度更快,显存占用更低。
  3. 实证表现好
    多篇论文和开源模型(如 Zephyr、Yi、Mistral-Instruct)已经证明DPO 在人类偏好评测上几乎可以媲美 RLHF。

正因如此,现在大多数开源模型都采用 SFT + DPO 流程,既能获得接近 RLHF 的效果,又节省了大部分训练成本。

面试官问这个问题时,你可以这样结构化回答:

RLHF 是通过“奖励模型 + 强化学习”间接优化人类偏好,而 DPO 则直接用人工偏好数据优化语言模型概率分布,跳过了强化学习。
二者的本质区别在于:RLHF 依赖显式奖励建模,DPO 通过对比损失实现隐式偏好优化。
DPO 不仅更简单、稳定、低成本,还能在大多数任务上取得与 RLHF 相当的效果,因此逐渐成为主流替代方案。

最后

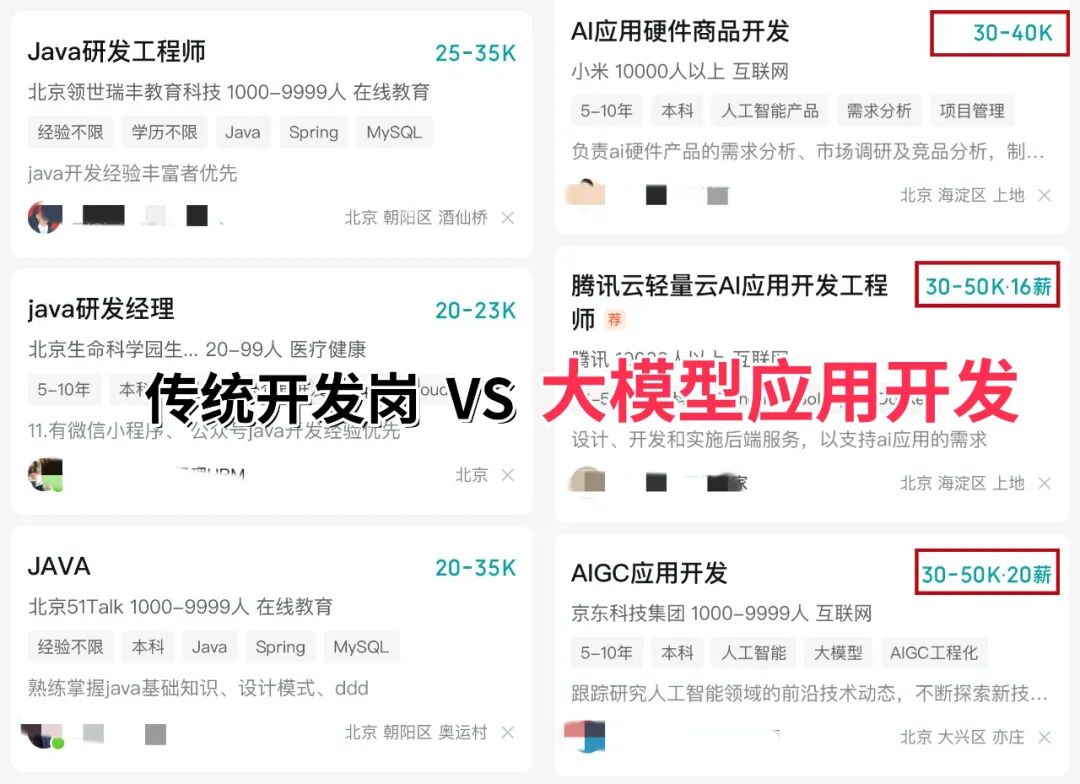
近期科技圈传来重磅消息:行业巨头英特尔宣布大规模裁员2万人,传统技术岗位持续萎缩的同时,另一番景象却在AI领域上演——AI相关技术岗正开启“疯狂扩招”模式!据行业招聘数据显示,具备3-5年大模型相关经验的开发者,在大厂就能拿到50K×20薪的高薪待遇,薪资差距肉眼可见!
图片

业内资深HR预判:不出1年,“具备AI项目实战经验”将正式成为技术岗投递的硬性门槛。在行业迭代加速的当下,“温水煮青蛙”式的等待只会让自己逐渐被淘汰,与其被动应对,不如主动出击,抢先掌握AI大模型核心原理+落地应用技术+项目实操经验,借行业风口实现职业翻盘!

深知技术人入门大模型时容易走弯路,我特意整理了一套全网最全最细的大模型零基础学习礼包,涵盖入门思维导图、经典书籍手册、从入门到进阶的实战视频、可直接运行的项目源码等核心内容。这份资料无需付费,免费分享给所有想入局AI大模型的朋友!

图片

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

部分资料展示

1、 AI大模型学习路线图

img

2、 全套AI大模型应用开发视频教程

从入门到进阶这里都有,跟着老师学习事半功倍。
在这里插入图片描述

3、 大模型学习书籍&文档

在这里插入图片描述

4、 AI大模型最新行业报告

2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

img

5、大模型大厂面试真题

整理了百度、阿里、字节等企业近三年的AI大模型岗位面试题,涵盖基础理论、技术实操、项目经验等维度,每道题都配有详细解析和答题思路,帮你针对性提升面试竞争力。

img

在这里插入图片描述

6、大模型项目实战&配套源码

学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。

img

👉学会后的收获:👈

• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

  • 👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

这些资料真的有用吗?

这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。

在这里插入图片描述
在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

fbx bip互转 测试OK fbx bip互转 阅读详情

相关推荐

SFR算法实现详解:从边缘检测到MTF计算的完整流程

本文详细解析了SFR算法从边缘检测到MTF计算的完整流程,包括边缘检测、ESF超采样、LSF差分等关键步骤。通过代码示例和实战经验,帮助开发者高效实现成像系统解析力评估,优化MTF测量精度。适用于摄像头模组调试、工业检测等场景。

Black的专栏 1009

RLHF 和 DPO:简化和增强语言模型的微调

人类反馈强化学习 (RLHF) 是人工智能领域的一种前沿方法,它利用人类偏好和指导来训练和改进机器学习模型。RLHF的核心是一种机器学习范式,它结合了强化学习和监督学习的元素,使人工智能系统能够以更加人性化的方式学习和做出决策。RLHF的重要性在于它有可能解决人工智能中的一些基本挑战,例如需要模型来理解和尊重人类的价值观和偏好。传统的强化学习模型通过与环境交互产生的奖励来学习,而 RLHF 则不同,它引入了人类反馈作为宝贵的指导来源。

yanqianglifei的专栏 3853

双击文件夹弹窗“找不到应用程序”,但是右键点击打开可以

此电脑、回收站、c、d、f盘、控制面板、任意文件夹等都没有办法双击打开。 右键中包含“使用filemanager打开”,是由于FileManager卸载残留导致的。 懒人专用附件 下载解压上面附件,双击导入可以清理FileManager软件残留 参考: 双击此电脑出现找不到应用程序,但是右键点击可以-其他-优快云问答https://ask.youkuaiyun.com/questions/7631439 电脑上的文件夹双击都提示找不到应用程序,但是右击打开就能打开,该怎么解决? - 知乎 (z

webmasterqpwou的博客 1万+

RLHF的替代之DPO原理解析:从RLHF、Claude的RAILF到DPO、Zephyr

今年5月份,斯坦福的一些研究者提出了RLHF的替代算法:直接偏好优化(Direct Preference Optimization,简称DPO),其对应论文为《那其与ChatGPT所用的RLHF有何本质区别呢,简言之RLHF将奖励模型拟合到人类偏好数据集上,然后使用RL方法比如PPO算法优化语言模型的策略,以输出可以获得高奖励的responses(同时不会偏离原始SFT模型太远)

结构之法 算法之道 2万+

5分钟搞定Nano-Banana图片编辑API对接:从Base64编码到生成图片全流程

本文详细介绍了如何快速对接Nano-Banana图片编辑API,基于gemini-2.5-flash-image-preview模型,从环境准备、Base64编码到API调用的全流程。通过实战示例和优化技巧,帮助开发者高效集成AI图片处理能力,提升产品竞争力。

dog123的博客 260

用 dism 合并与删除 wim 映像

一、合并 假设 installA.wim 有 3 个映像,installB.wim 有 1 个映像。 1、全部合并 将 installA.wim 中的 3 个卷映像合并到 installB.wim 中,这样 installB.wim 中的卷映像增加到 4 个。 dism/export-image/sourceimagefile:d:\installA.wim/sourceindex:1/destinationimagefile:d:\installB.wim dism/export-image/source

KefanWon的博客 5199

小学生也能听得懂的大模型 - Transformer 1

参考 [小学生也能听得懂的大模型 Transformer 1]

2401_85325557的博客 1737

eCognition易康操作教程(一):如何利用eCognition易康软件进行影像分割之棋盘分割、四叉树分割、光谱差异分割

进程执行完成后,植被覆盖区域与裸地区域合并了。第三步:清除分割结果,点击“Image Objects”菜单栏,点击“Delete Level(s)”,选中“ResultLevel1”,点击”ok”删除棋盘分割结果。四叉树分割之后,有的正方形大一些,有的正方形小一些,大说明该区域的光谱特性更加均一,而小说明不太均一。Leve:选择运行算法的矢量层名称,这里选择四叉树分割算法得到的矢量层“ResultLevel2”。Image Layer weights:图层权重,这里设置为“1,1,1,1”。

蒹葭苍苍 4608

大模型微调:RHLF与DPO浅析

大模型应用性能的提升不仅在于其预训练,而微调的作用也非常显著。对于多数从事大模型应用领域的团队而言,微调是一个核心的工作之一,为专门任务完善大模型并确保其产出符合我们的预期。1. 关于微调微调涉及调整预训练的LLM ,以更有效地执行特定的功能,提高其在不同应用程序中的效用。尽管LLM通过预训练获得了广泛的知识基础,仍需要定制以在特定领域或任务中表现出色。例如,对一般数据集上训练的大模型进行微调,以...

我相信...... 2925

国科大学习资料--模式识别与机器学习(黄庆明)--期末复习题2(含答案)

国科大学习资料–模式识别与机器学习(黄庆明)–期末复习题2(含答案) 国科大学习资料–模式识别与机器学习(黄庆明)–期末复习题2(含答案) 国科大学习资料–模式识别与机器学习(黄庆明)–期末复习题2(含答案) ...

无名何许人的博客 1万+

日常工作记录---在虚拟机中进行slam建图

   今天是10月24号,首先祝各位程序员们节日快乐!!!    最近一周由于实习的原因,对ROS的探索学习,停滞了一段时间,所以今天也就没什么大的进展,本篇文章仅仅记录一下,我在虚拟机中进行slam建图可行性验证的过程,本篇文章同样使用古月学院《如何在Gazebo中实现阿克曼转向车的仿真》的课程资料来进行验证    下面各条之间并没有严格的顺序关系,每一条都是独立的,都是我在验证过程中的经验或者记录:    1、在运行roslaunch bringup racecar_gazebo_rviz.lau

慕羽★的博客 4828

dpo相对于rlhf的优化,或两者之间的异同

DPO (Direct Preference Optimization) 和 RLHF (Reinforcement Learning from Human Feedback) 在处理人类偏好优化方面采用了不同的方法。DPO 确实不需要训练奖励模型,而 RLHF 是需要训练奖励模型的。总的来说,DPO为RLHF提供了一个简化和高效的替代方案,特别适合资源受限或需要快速实现的场景。总之,DPO 通过直接优化来简化了人类偏好的学习过程,而 RLHF 则通过显式的奖励建模和强化学习来实现这一目标。

AI生成式技术曾小健 2703

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

面试直击:大模型对齐中RLHF与DPO的核心差异,为何DPO成主流替代?

RLHF和DPO在大模型对齐中究竟有何本质不同?为什么现在越来越多团队用DPO取代RLHF?”——在AI算法岗面试中,这个问题堪称高频考点。它不仅考察你对技术术语的记忆,更核心是检验你是否吃透大模型“安全可控”背后的优化逻辑。看似两者都在解决“让模型听人类的话”的问题,但从技术路径到落地成本,二者存在决定性差异。今天我们就从对齐的本质出发,把这组核心技术的区别讲透。

xxue345678的博客 1488

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

收藏!RLHF与DPO大模型对齐核心差异解析:为何DPO成主流替代方案?

RLHF和DPO在大模型对齐中到底有啥本质区别?为啥现在越来越多团队用DPO替代RLHF?”——这道题在AI算法岗面试中堪称“必考题”。它不只是考察你对技术术语的记忆准确度,更核心的是检验你是否真正吃透大模型“安全可控”背后的核心优化逻辑,能不能从技术原理层面讲清方案选型的底层逻辑。表面上看,两者都在解决“让模型听懂人话、输出符合预期”的问题,但从技术实现路径、落地部署成本到工程稳定性,二者存在着决定性的差异。

kaka0722ww的博客 980

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

【LLM】大模型之RLHF和替代方法(DPO、RAILF、ReST等)

SFT使用交叉熵损失函数,目标是调整参数使模型输出与标准答案一致,不能从整体把控output质量,RLHF(分为奖励模型训练、近端策略优化两个步骤)则是将output作为一个整体考虑,优化目标是使模型生成高质量回复。 启发1:像可以用6b、66b依次得到差一点、好一点的target构造排序数据集,进行DPO直接偏好学习或者其他RLHF替代方法(RAILF、ReST等),比直接RLHF更方便训练 启发2:为了减少幻觉(如拒绝回答),可以构造排序数据集(如good response为拒绝话术,bad respo

发现问题,并解决问题,批判性思维 1万+

面试官:大模型对齐中的 RLHF 与 DPO有什么本质区别?为何 DPO 能替代 RLHF?

这道题其实是面试官想看你是否真的理解大模型安全对齐(Alignment)背后的优化逻辑。 我们都知道这两个词看起来都跟“让模型更听话”有关,但它们在原理、流程和优化目标上,差别非常关键。今天我们来把这件事讲清楚。

和大家一起涨芝士 1180

RLHF与DPO的本质区别:一文搞懂大模型对齐技术的演进与选择!

RLHF与DPO都是大模型对齐技术,让模型行为更符合人类期望。RLHF通过三阶段流程(SFT、奖励模型训练、PPO强化学习)实现,但流程复杂、成本高且不稳定。DPO则直接优化语言模型概率分布,跳过奖励模型和强化学习,实现端到端训练。DPO具有稳定高效、成本低的优势,且效果可媲美RLHF,已成为大多数开源模型的首选方案(SFT+DPO)。理解二者区别对大模型训练和优化至关重要。

2401_84495872的博客 1136

【技术收藏】为什么大模型都用DPO替代RLHF?详解对齐技术背后的优化逻辑

本文解析了大模型对齐技术中RLHF和DPO的本质区别。RLHF通过三阶段(SFT、奖励模型训练、强化学习)实现对齐,但存在流程复杂、不稳定、成本高等问题。DPO作为替代方案,直接优化人类偏好,无需训练奖励模型和强化学习,具有端到端可训练、稳定高效、实证表现好等优势。如今大多数开源模型采用SFT+DPO流程,既获得接近RLHF的效果,又大幅降低训练成本。大语言模型(LLM)预训练后,本质上只是一个“下一个词预测机”。它虽然学到了知识,但——你问什么它都可能“合理续写”,包括错误、偏见或有害内容。

qq_46094651的博客 1080

大模型 RLHF 实战!【OpenAI独家绝技RLHF!RLHF的替代算法DPO!Claude 暗黑科技 RAIHF!】

作者在训练 DPO 模型时省略了奖励模型训练的步骤,而是通过设计一种包含正负样本对比的损失函数,在训练过程中得到一个满足人类偏好的模型。意思是,可以通过一个加权的参考策略来构造一个新的策略,该策略会偏向于高奖励的行为,同时保持与参考策略的相似性。改进:RAIHF 是通过 AI 排序,而非人工排序数据集,训练出来的偏好模型PM的指引下迭代模型策略。正样本和负样本的对比,使得模型能够更好地学习到人类偏好的特征,从而提升了生成的质量。DPO:直接偏好优化算法,专门替代传统的基于奖励的 RL 方法。

Debroon 1963

DPO PPO GRPO RLHF 的区别

PPO 要估 Advantage,需要价值函数(critic);步骤:直接在(prompt, preferred, dispreferred)三元组上最小化上式即可。适合需要采样多条长解链的“深度推理”场景(DeepSeekMath、DeepSeek-R1)。介于 DPO 和 PPO 之间:保留在线改进,但通过“组相对评分”省掉 critic,当 Advantage,直接做 PPO-Clip 更新 —— 省掉 critic。训练像普通 SFT 一样简单,速度快,效果与 RLHF 接近甚至更好。

kkx2002的博客 2182

RLHF和DPO的区别和优劣势什么

语言任务缺乏显式奖励信号,需要用人类偏好数据来构建奖励模型。人类更易提供相对(比较)反馈,而非绝对反馈,Bradley-Terry模型自然适合这种数据结构。神经网络(如Transformer)作为参数化模型,具有泛化能力,可以捕捉复杂的人类偏好模式。因此,这种设计是RLHF方法中从数据性质、模型结构到优化方法的必然选择,体现了对人类反馈数据本质的深刻理解与建模技巧。

具身机器人和通用AI 1943

LLM 对齐技术综述:RLHF、RLAIF、PPO 和 DPO 等

24年7月来自 Salesforce 的论文"A Comprehensive Survey of LLM Alignment Techniques: RLHF, RLAIF, PPO, DPO and more"。 随着自监督学习的进步、预训练语料库中数万亿个 token 的出现、指令微调以及拥有数十亿参数的大型 Transformer 的开发,大语言模型 (LLM) 现已能够对人类查询生成真实且连贯的响应。然而,训练数据的质量参差不齐可能会导致生成不理想的响应,从而带来重大挑战。在过去的两年中,人们从不

yorkhunter的博客 1979

从RLHF到DPO:大模型强化学习全景揭秘,解锁AI对齐核心密码

强化学习为大模型注入了 “理解人类偏好” 的能力,从 RLHF 到 DPO、RLOO,算法演进的核心是 “更简单、更高效、更稳定”。未来,随着多模态大模型的发展,强化学习将进一步扩展到 “文本 + 图像 + 语音” 的联合对齐,同时需在 “对齐税”“Reward Hacking” 等挑战中寻找平衡。 对于从业者,理解这些算法不仅能优化大模型训练,更能把握 “AI 如何更好服务人类” 的技术脉络 —— 毕竟,让 AI 生成 “人类真正需要的内容”,才是大模型价值的核心。

weixin_52610848的博客 1108

从RLHF到DPO再到TDPO,大模型对齐算法已经是「token-level」

在人工智能领域的发展过程中,对大语言模型(LLM)的控制与指导始终是核心挑战之一,旨在确保这些模型既强大又安全地服务于人类社会。早期的努力集中于通过人类反馈的强化学习方法(RLHF)来管理这些模型,成效显著,标志着向更加人性化 AI 迈出的关键一步。尽管 RLHF 取得了巨大成功,但是在训练过程中 RLHF 非常消耗资源。因此,近段时间学者们在 RLHF 奠定的坚实基础上,继续探索更为简单且高效的策略优化路径,催生了直接偏好优化(DPO)的诞生。

机器学习社区 1550

让大模型“更懂人话”:对齐训练(RLHF & DPO)全流程实战解析

在大语言模型日益强大的今天,我们会发现一个问题:它们虽然“能说会道”,但有时候却说得不靠谱——比如编造事实、回答偏激,甚至出现违背常识和伦理的问题。 为了让模型“听得懂话、说得靠谱”,我们就需要对齐训练(Alignment Training)。这背后的核心方法是 **人类反馈强化学习(RLHF)**,它通过人类偏好来调整模型行为,确保模型输出不仅正确,而且符合价值观。 本文将系统介绍 RLHF 的三个阶段:监督微调(SFT)、奖励模型训练(RM)、策略优化(如PPO、DPO),结合 HuggingFac

记录从移动端、鸿蒙到物联网与AI的完整实战与思考。专注于分享可复用的工程方案与产品思维,尤其深入鸿蒙生态与全栈开发。以十年工程与管理沉淀,为你提供清晰的技术纵深路径。坚信技术的价值在于“贯通”与“落地”。 2733

AI大模型核心训练技术:SFT、RLHF、DPO、IFT,看这篇就够了!

随着 ChatGPT 等强大模型的发布,大语言模型(Large Language Models,LLMs)的浪潮席卷而来,并逐渐走进千家万户。LLMs 可以协助文字工作者寻找创作灵感,可以为各年龄段的学生详解知识点,甚至可以帮助心情不好的人做心理疏导。可以说,LLMs 正在成为许多人日常工作与生活的必需品。

m0_59235245的博客 1242
上一篇: 收藏 | AI+颠覆未来:小白程序员必备大模型学习与进阶指南
下一篇: 小白程序员必看:收藏这份GraphRAG指南,轻松驾驭大模型知识图谱
SQL11192001
博客等级 码龄1年 0粉丝 21原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符  | 博主筛选后可见
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值