


小白程序员必看:收藏这份GraphRAG指南,轻松驾驭大模型知识图谱
本文深入剖析了传统RAG系统的局限性,并详细介绍了微软GraphRAG解决方案。GraphRAG通过构建知识图谱,使大模型能理解信息间的逻辑连接,而非简单检索文本。文章提供了完整的GraphRAG实现流程,包括使用Neo4j构建知识图,以及结合传统RAG与GraphRAG构建混合知识库系统,让大模型能更好地回答复杂问题。通过代码实战和混合知识库系统的构建,帮助读者快速上手并应用GraphRAG技术。
一、传统RAG的天花板
如果你用过RAG系统,可能也遇过类似的问题:
- 跨文档的信息无法连贯
- 检索文档越多,回答质量反而下降
- 融合多个数据源的知识特别困难
想象一下,用传统搜索方式在食谱书里找"炒鸡蛋"和"西红柿鸡蛋面"的做法,速度快得很。但如果你想知道为什么西红柿和鸡蛋搭配得这么完美,关键词搜索就显得无力了。
这正是传统语义检索方式的局限——它很擅长精确匹配,但不擅长理解隐藏在信息后面的深层逻辑。
二、GraphRAG出现了

微软推出了一套新方案来解决这个问题:GraphRAG(图检索增强生成)。核心思路很简单——与其把知识存成散乱的文本块,不如把它组织成一张知识图谱,其中实体是节点,实体之间的关系是边。
这样做有什么好处呢?
当大模型需要回答一个复杂问题时,它不再是盲目地找相似的文本段落,而是能够:
- 看到实体之间的关系
- 理解信息之间的逻辑连接
- 跨多个社区综合回答
简单说,GraphRAG让大模型从"查字典"升级到了"读书"。
三、它是怎么工作的
GraphRAG的工作流程分为两个阶段:索引阶段和查询阶段。
1、索引阶段:构建知识的骨架
首先,系统会把源文档分成可管理的文本单元。然后大模型出手了,它会自动:
- 识别实体和关系——从文本中提取出人、地点、公司等实体,以及它们之间的联系
- 构建知识图——用节点代表实体,用边代表关系
- 检测社区——使用Leiden算法找出紧密相关的实体集群
- 生成摘要——为不同级别的社区生成分层摘要
这个过程中,有两个关键步骤特别值得关注:
图抽取的目标是从原始数据中识别有意义的信息,把它们组织成图的形式。图摘要则是把复杂的图结构简化,去掉冗余信息,突出关键内容。就像整理一个杂乱的书架,既要保留重要的书,又要删除过期的杂志。
2、查询阶段:精准找到答案

当用户提问时,系统会:
- 判断问题的复杂程度,选择合适的社区级别
- 在选定的社区中检索相关信息
- 从多个相关社区综合生成答案
- 最后整合成一个完整的回复
这比传统RAG的做法要聪明得多。传统方式是匹配用户查询和文本块的相似度,而GraphRAG是在理解的基础上进行推理。
四、怎样实现它
理论讲到这儿,你可能想知道——这东西怎么落地?
市面上有现成的工具可用。微软有官方的GraphRAG实现,但也有更灵活的方案。比如用Neo4j + LangChain的组合,就特别受欢迎。
Neo4j是一个图数据库,专门用来存储和查询图结构的数据。LangChain是一个大模型框架,能把各种工具串联起来。把它们组合使用,就能搭建一个强大的GraphRAG系统。
五、代码实战:一步步搭建你的GraphRAG
我把整个实现过程整理成了可运行的代码。假设我们要构建一个关于科技公司的知识图。
第一步:准备环境和数据
# 安装必要的库
# pip install langchain neo4j langchain-openai langchain-experimental
from langchain_core.documents import Document
# 准备你的数据(可以是公司信息文档)
content = """
小米科技有限责任公司是一家专注于研发和推出创新技术的公司。
小米推出了智能家居产品和5G技术。
华为技术有限公司与清华大学建立了深度合作。
华为参与了5G标准的制定。
小米与美团合作开发物流解决方案。
"""
# 转化为Document对象
documents = [Document(page_content=content)]
print(f"加载了{len(documents)}份文档")
第二步:连接Neo4j并创建知识图

from langchain_community.graphs import Neo4jGraph
from langchain_experimental.graph_transformers import LLMGraphTransformer
from langchain_openai import ChatOpenAI
# 连接到Neo4j数据库(使用免费的Neo4j Aura)
graph = Neo4jGraph(
url="neo4j+s://your-db-uri",  # 替换为你的Neo4j URI
username="neo4j",
password="your-password",      # 替换为你的密码
database="neo4j"
)
# 初始化LLM
graph_llm = ChatOpenAI(temperature=0, model_name="gpt-4o-mini")
# 创建图转换器,定义你要提取的实体和关系类型
graph_transformer = LLMGraphTransformer(
llm=graph_llm,
allowed_nodes=["公司", "产品", "技术", "教育机构", "合作伙伴"],
allowed_relationships=["推出", "参与", "合作", "位于", "开发"],
)
# 执行转换:从文档中提取实体和关系
graph_documents = graph_transformer.convert_to_graph_documents(documents)
# 将图数据导入Neo4j
graph.add_graph_documents(graph_documents)
print(f"成功导入{len(graph_documents)}个图文档")
print(f"提取的实体: {[node.id for node in graph_documents[0].nodes]}")
print(f"提取的关系: {[(rel.source.id, rel.type, rel.target.id) for rel in graph_documents[0].relationships]}")
第三步:用GraphRAG查询知识图
from langchain.chains import GraphCypherQAChain
llm = ChatOpenAI(model="gpt-4o-mini", temperature=0)
# 创建Cypher查询链
cypher_chain = GraphCypherQAChain.from_llm(
graph=graph,
cypher_llm=llm,
qa_llm=llm,
validate_cypher=True,
verbose=True,  # 设置为True可以看到生成的Cypher查询过程
allow_dangerous_requests=True
)
# 测试几个问题
queries = [
"小米科技有限责任公司推出了哪些创新技术?",
"华为技术有限公司与哪些教育机构建立了合作?",
"都有哪些公司在我的数据库中?"
]
for query in queries:
print(f"\n问题: {query}")
response = cypher_chain.invoke(query)
print(f"答案: {response['result']}")
print("-" * 50)
六、更进一步:混合知识库系统
如果你想同时使用GraphRAG和传统RAG,我也准备了代码。这样可以兼得两种方法的优势。

第四步:建立向量数据库(传统RAG)
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings
from langchain_milvus import Milvus
# 分割文本
text_splitter = RecursiveCharacterTextSplitter(
chunk_size=250,
chunk_overlap=30
)
splits = text_splitter.split_documents(documents)
# 创建向量嵌入
embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
# 连接到Milvus向量数据库(使用免费的Zilliz云服务)
vectorstore = Milvus.from_documents(
documents=splits,
collection_name="company_rag_milvus",
embedding=embeddings,
connection_args={
"uri": "https://your-milvus-uri",  # 替换为你的Milvus URI
"user": "your-username",
"password": "your-password",
}
)
print(f"向量数据库已创建,包含{len(splits)}个文本块")
第五步:构建传统RAG代理
from langchain.prompts import PromptTemplate
from langchain_core.output_parsers import StrOutputParser
# 定义RAG提示词
prompt = PromptTemplate(
template="""你是一个问答助手。
使用以下检索到的上下文来回答问题。如果你不知道答案,就说你不知道。
最多使用三句话,保持简洁:
问题: {question}
上下文: {context}
答案:""",
input_variables=["question", "context"],
)
# 构建RAG链
rag_chain = prompt | graph_llm | StrOutputParser()
# 执行查询
question = "我的知识库中都有哪些公司信息?"
retriever = vectorstore.as_retriever(search_kwargs={"k": 2})
# 检索相关文档
docs = retriever.invoke(question)
# 生成回答
generation = rag_chain.invoke({
"context": "\n\n".join([doc.page_content for doc in docs]),
"question": question
})
print(f"RAG系统的回答: {generation}")
第六步:多代理系统——让两种方法协同工作
from langgraph.graph import StateGraph, MessagesState, START, END
from langchain_core.messages import HumanMessage
from typing import Literal
from typing_extensions import TypedDict
class AgentState(MessagesState):
next: str
class Router(TypedDict):
"""路由到不同的子代理"""
next: Literal["graph_kg", "vec_kg", "FINISH"]
# 图数据库代理
def graph_kg_agent(state: AgentState):
messages = state["messages"][-1]
response = cypher_chain.invoke(messages.content)
return {
"messages": [HumanMessage(content=response["result"], name="graph_kg")]
}
# 向量数据库代理
def vec_kg_agent(state: AgentState):
messages = state["messages"][-1]
retriever = vectorstore.as_retriever(search_kwargs={"k": 2})
docs = retriever.invoke(messages.content)
generation = rag_chain.invoke({
"context": "\n\n".join([doc.page_content for doc in docs]),
"question": messages.content
})
return {
"messages": [HumanMessage(content=generation, name="vec_kg")]
}
# 主管代理:判断用何种方式回答
def supervisor(state: AgentState):
system_prompt = """你是一个任务主管,管理两个工作者:
- graph_kg: 基于知识图,擅长回答全局、综合性问题
- vec_kg: 基于向量检索,擅长回答细节问题
根据用户问题,判断应该使用哪个工作者。"""
messages = [{"role": "system", "content": system_prompt}] + state["messages"]
response = graph_llm.with_structured_output(Router).invoke(messages)
next_worker = response["next"]
if next_worker == "FINISH":
next_worker = END
return {"next": next_worker}
# 构建图
builder = StateGraph(AgentState)
builder.add_node("supervisor", supervisor)
builder.add_node("graph_kg", graph_kg_agent)
builder.add_node("vec_kg", vec_kg_agent)
# 设置工作流
builder.add_edge(START, "supervisor")
for worker in ["graph_kg", "vec_kg"]:
builder.add_edge(worker, "supervisor")
builder.add_conditional_edges("supervisor", lambda state: state["next"])
# 编译并运行
multi_agent_graph = builder.compile()
# 测试多代理系统
test_queries = [
"都有哪些公司在我的数据库中?",  # 应该用graph_kg
"小米推出了什么技术?"            # 应该用graph_kg
]
for query in test_queries:
print(f"\n用户问题: {query}")
for output in multi_agent_graph.stream(
{"messages": query},
stream_mode="values"
):
last_message = output["messages"][-1]
print(f"{last_message.name}: {last_message.content}")
print("-" * 50)
七、快速上手的步骤
第一步:准备Neo4j实例。可以用免费的Neo4j Aura云服务,注册即用,不需要本地部署。
第二步:用LLM把文档转换成图。这里可以自定义节点类型和关系类型,比如:
- 节点:公司、产品、技术、市场
- 关系:推出、合作、开发、位于
系统会自动提取文档中对应的实体和关系,构建知识图。
第三步:可视化和验证。登录Neo4j平台,就能看到生成的完整知识图。确保数据准确后,就可以用来回答问题了。
八、更进一步:混合知识库
这是我最近在做的一个有意思的尝试——同时使用GraphRAG和传统RAG。
想法是这样的:GraphRAG擅长回答宏观、全面的问题,比如"这个公司有哪些合作伙伴"。而传统RAG擅长处理细节问题,比如"某个产品的具体参数是什么"。
所以我搭建了一个多代理系统,用supervisor来判断用户问题的类型,然后路由到不同的知识库:
- graph_kg:基于知识图的代理,处理全局性问题
- vec_kg:基于向量的代理,处理细节问题
向量数据库我选择了云端的Milvus,这样避免了本地部署的麻烦。两个代理各司其职,大模型在它们之间充当主管,协调分工。
实际测试效果还不错。问"数据库里有哪些公司"时,graph_kg会遍历整个知识图给出完整列表。问"某个公司推出了哪些创新技术"时,它会基于实体之间的关系进行推理。
九、总结
从传统RAG到GraphRAG,这不仅是技术的升级,更是思维方式的转变。
我们不再只是被动地检索信息片段,而是主动构建知识的结构。大模型也不再只是做语言匹配,而是真正在理解和推理。
虽然GraphRAG还不是完美的(毕竟也依赖于大模型的抽取质量),但方向是清楚的——让AI系统更像人类思考一样,理解信息之间的关系,看到知识的全貌。
如果你的业务涉及复杂的知识库问答,值得尝试一下。而且现在有免费的云服务可以用,技术上的壁垒已经不那么高了。
把上面的代码复制下来,替换成你自己的API密钥和数据库URI,就可以跑起来了。
最后
近期科技圈传来重磅消息:行业巨头英特尔宣布大规模裁员2万人,传统技术岗位持续萎缩的同时,另一番景象却在AI领域上演——AI相关技术岗正开启“疯狂扩招”模式!据行业招聘数据显示,具备3-5年大模型相关经验的开发者,在大厂就能拿到50K×20薪的高薪待遇,薪资差距肉眼可见!
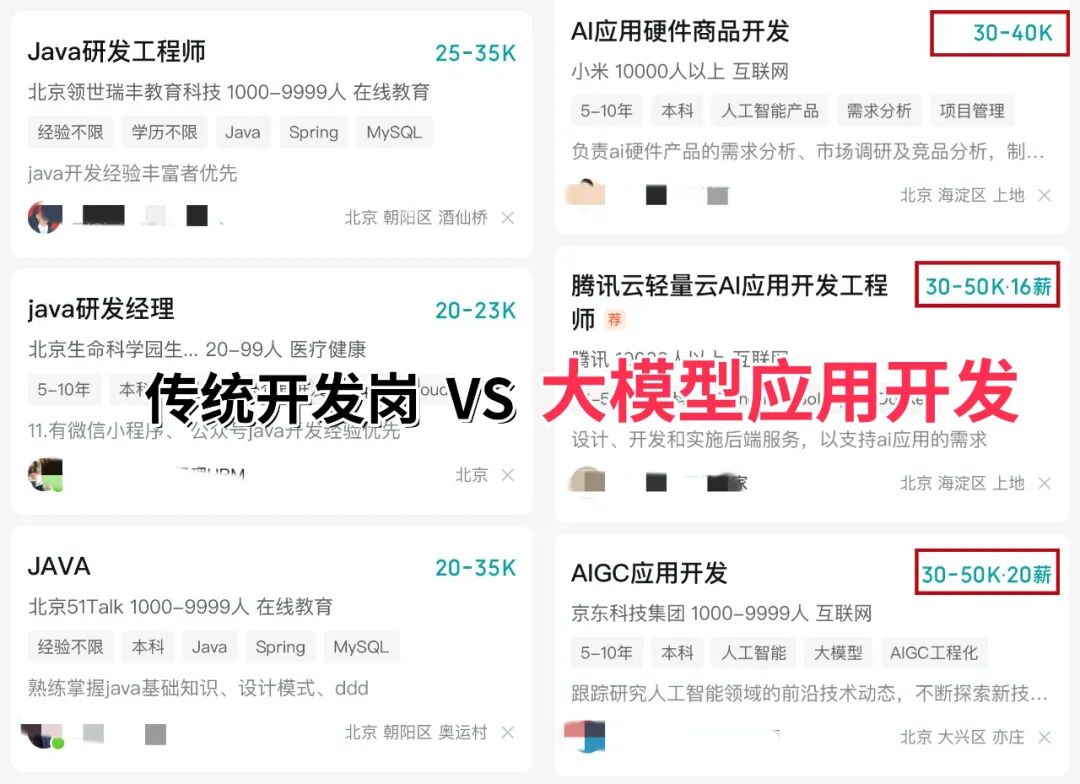
业内资深HR预判:不出1年,“具备AI项目实战经验”将正式成为技术岗投递的硬性门槛。在行业迭代加速的当下,“温水煮青蛙”式的等待只会让自己逐渐被淘汰,与其被动应对,不如主动出击,抢先掌握AI大模型核心原理+落地应用技术+项目实操经验,借行业风口实现职业翻盘!
深知技术人入门大模型时容易走弯路,我特意整理了一套全网最全最细的大模型零基础学习礼包,涵盖入门思维导图、经典书籍手册、从入门到进阶的实战视频、可直接运行的项目源码等核心内容。这份资料无需付费,免费分享给所有想入局AI大模型的朋友!

👇👇扫码免费领取全部内容👇👇
部分资料展示
1、 AI大模型学习路线图

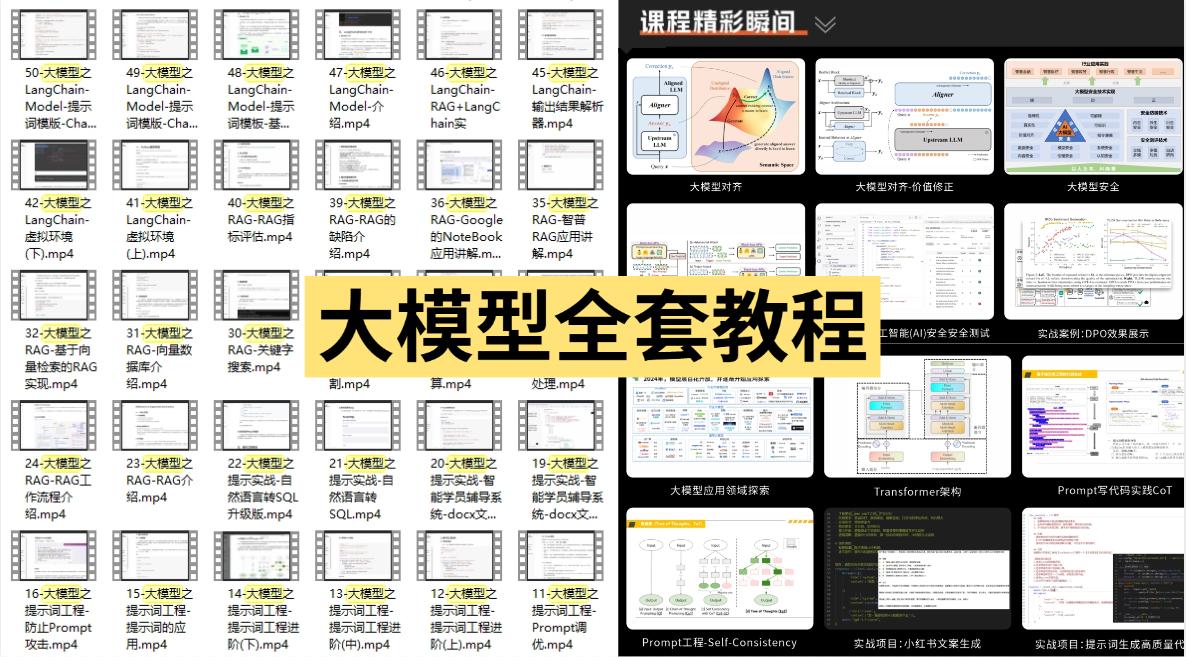
2、 全套AI大模型应用开发视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。
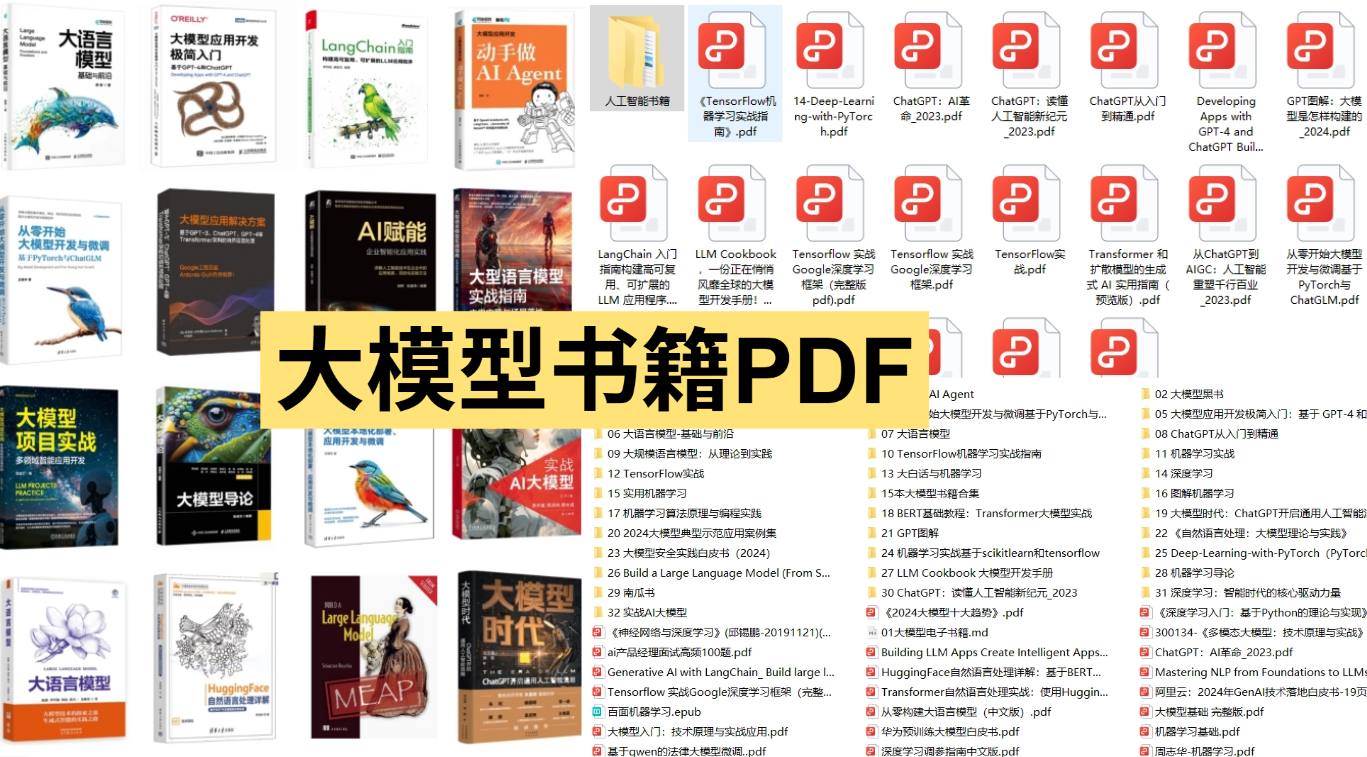
3、 大模型学习书籍&文档
4、 AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

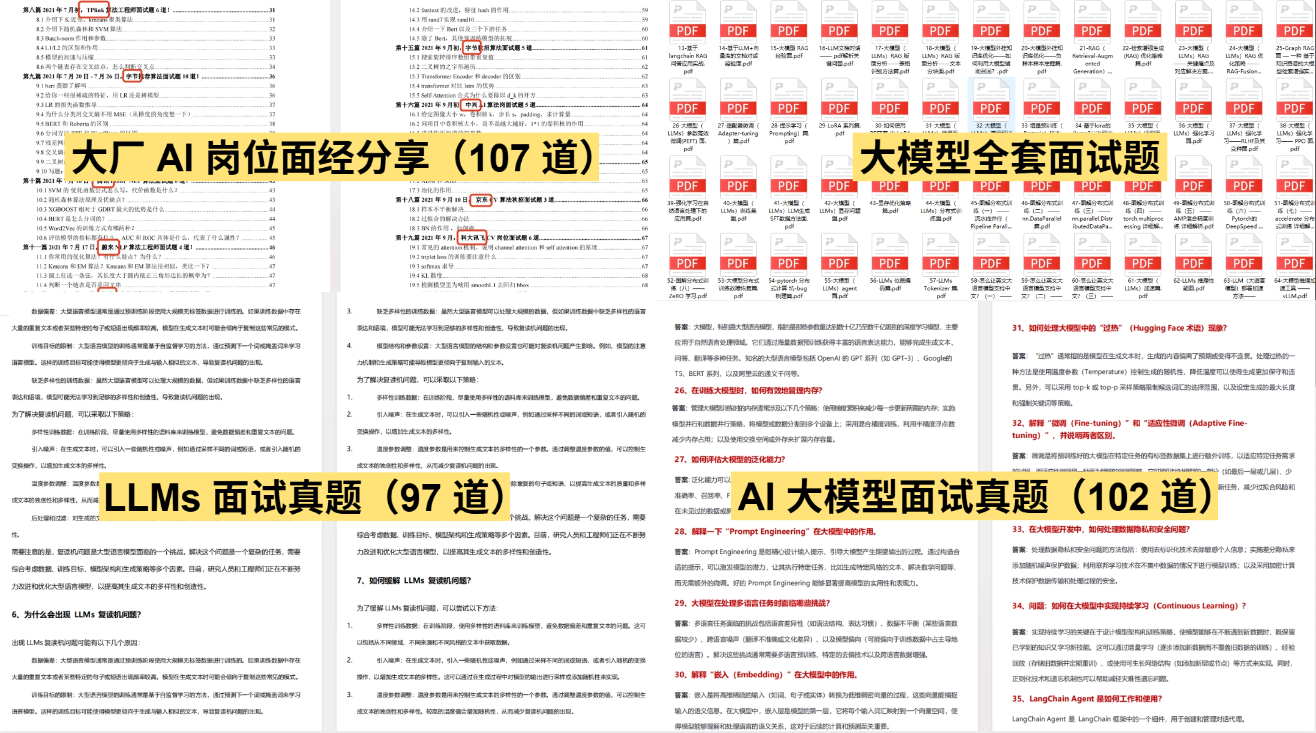
5、大模型大厂面试真题
整理了百度、阿里、字节等企业近三年的AI大模型岗位面试题,涵盖基础理论、技术实操、项目经验等维度,每道题都配有详细解析和答题思路,帮你针对性提升面试竞争力。

6、大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
- 👇👇扫码免费领取全部内容👇👇
这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 194


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


