


快速体验
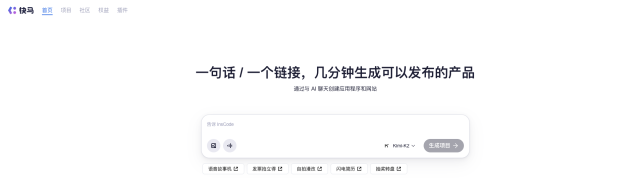
- 打开 InsCode(快马)平台 https://www.inscode.net
- 输入框输入如下内容
帮我开发一个豆瓣电影Top250爬虫,用于展示电影名称和评分。系统交互细节:1. 发送HTTP请求获取网页内容 2. 使用BeautifulSoup解析HTML 3. 提取电影名称和评分 4. 打印结果。注意事项:需添加User-Agent请求头模拟浏览器访问。 - 点击'项目生成'按钮,等待项目生成完整后预览效果
爬虫基础知识
-
爬虫工作原理:爬虫本质上是通过程序模拟浏览器行为,向目标网站发送HTTP请求,获取响应内容后解析并提取所需数据。整个过程可以分为三个主要步骤:请求数据、解析数据和存储数据。
-
HTTP请求:这是爬虫的第一步,我们需要构造GET或POST请求来获取网页内容。Python中常用的请求库是requests,它简单易用,可以方便地添加headers、cookies等参数。
-
HTML解析:获取到网页内容后,我们需要从中提取有用的信息。常用的解析方法包括正则表达式、XPath和使用解析库如BeautifulSoup。BeautifulSoup提供了简单直观的API来定位和提取HTML中的特定元素。
-
数据存储:解析得到的数据可以多种形式保存,如CSV、Excel文件,或者存入数据库如MySQL、MongoDB等,具体选择取决于数据量和后续使用需求。
爬虫核心工具
-
Requests库:Python中最流行的HTTP请求库,可以轻松发送各种HTTP请求并处理响应。它支持会话保持、代理设置、超时控制等功能,是爬虫开发的基础工具。
-
BeautifulSoup:强大的HTML/XML解析库,能够自动将复杂的HTML文档转换为树形结构,通过简单的API就能查找和提取特定元素。最新版本是BeautifulSoup4,建议使用这个版本。
-
Selenium:用于处理JavaScript动态渲染的网页。当目标网站的内容是通过JavaScript动态加载时,普通的请求无法获取完整内容,这时就需要Selenium来模拟浏览器操作。
-
Scrapy:一个完整的爬虫框架,适合大型爬虫项目。它提供了完整的爬虫工作流程管理,包括请求调度、数据提取、数据处理和存储等功能。
实战案例解析
-
目标分析:以豆瓣电影Top250为例,我们需要获取每部电影的名称和评分。首先分析网页结构,发现电影信息包含在class为"item"的div中,电影名称在"title"类下的span标签,评分在"rating_num"类下的span标签。
-
请求构造:使用requests发送GET请求获取页面内容。需要注意设置User-Agent请求头模拟浏览器访问,否则可能会被网站拒绝。
-
内容解析:用BeautifulSoup解析HTML文档,使用find_all方法找到所有电影条目,然后分别提取名称和评分。这种方法简洁高效,适合初学者理解爬虫的基本流程。
-
结果输出:将提取的数据存入列表,最后遍历输出。在实际应用中,可以将这些数据保存到文件或数据库中供后续分析使用。
合规与注意事项
-
爬虫道德:爬虫开发者应遵守robots.txt协议,尊重网站的爬取规则。过快或过频繁的请求可能会对目标网站造成负担,甚至被视为攻击行为。
-
法律风险:部分网站明确禁止爬取数据,尤其是商业用途。在使用爬虫前,务必了解相关法律法规和网站的使用条款,避免法律风险。
-
反爬机制:许多网站设有反爬措施,如验证码、IP限制等。在开发爬虫时需要考虑这些因素,合理设置请求间隔和使用代理IP。
-
数据使用:即使成功爬取到数据,也要注意数据的使用方式,避免侵犯他人版权或隐私权。公开或商业使用前应获得授权。
平台体验
在InsCode(快马)平台上,我们可以快速生成和运行这个爬虫示例。平台提供了完整的Python环境,无需本地配置就能直接运行代码,特别适合初学者快速验证想法。
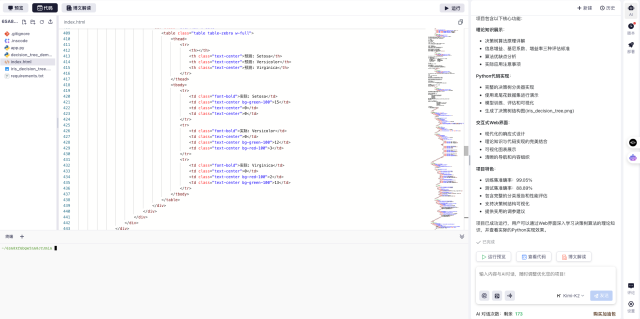
对于更复杂的项目,平台的一键部署功能让分享和展示变得更加简单。我实际使用时发现,从代码编写到运行测试的整个流程非常顺畅,省去了环境配置的麻烦,让开发者能更专注于逻辑实现。
 2118


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


