缓存系统在游戏业务中的特异性

作者介绍:韩伟,1999年大学实习期加入初创期的网易,成为第30号员工,8年间从程序员开始,历任项目经理、产品总监。2007年后创业4年,开发过视频直播社区,及多款页游产品。2011年后就职于腾讯游戏研发部公共技术中心架构规划组,专注于通用游戏技术底层的研发。

在中国的互联网诸多业务领域中,游戏一直是充当“现金牛”而存在的。但是,在游戏服务器端开发领域中的很多重要问题,并没有被明确的分辨出其特异性,从而得到专门的对待。我们不管是在业界开源领域,还是内部分享中,很少会有专门针对游戏业务特征进行专门设计的组件、类库或者框架。我们从游戏的客户端方面来看,一款专业的游戏客户端引擎,已经是游戏开发的标配,比如最早的Flash Builder,到后期的Cocos2d-X,Unity,Unreal;但是服务器端,我们几乎找不到同样重量级的产品。

在游戏服务器端开发所有要面对的问题中,有两个是最核心和最普遍的:一是和客户端的通讯;二是游戏登录用户的数据处理。对于和客户端通讯的这个问题,大量的游戏开发者会使用“通用”的开源组件,比如Protocol Buffer,Thrift,Jetty,Node.js等等通信或RPC框架。虽然针对游戏,还是要做大量的改造,但一般都有很多现成的代码可供修改。但是对于第二个问题,不管是memcache还是MySQL,或者是Redis,都不能完全满足游戏开发者的需求。很多团队尝试过各种组合和修改,试图创造出利用现有开源软件,建设既能迎合灵活的需求变化,又具备高延迟和高可用的数据处理系统,但最后这些努力基本上都很难圆满成功。因此我们在游戏服务器端代码中,还是充斥着大量的内存、缓存管理,数据同步、落地等等代码。而且每个游戏都要重新去写一遍这些类似的功能,不能不说一种浪费。

如果我们要想出一种能满足“游戏”这个业务领域的数据系统设计,那么就一定要搞清楚为什么在如此之多的开源项目和游戏团队中,没能实现完美契合的原因。

电子商务/一般互联网类业务的数据处理流程

Memcache、Redis、MySQL在一般互联网业务中的应用非常广泛。而且基本上能很好的应对各种常见的应用场景,包括类似BBS的社区、新闻门户、电子商务类系统。在企业内部信息系统中(Intranet),这一类数据软件也能发挥非常好的功效。由于电子商务类是其中最复杂的系统,所以我在这里以此为例说明,一般数据处理的流程是如何的。
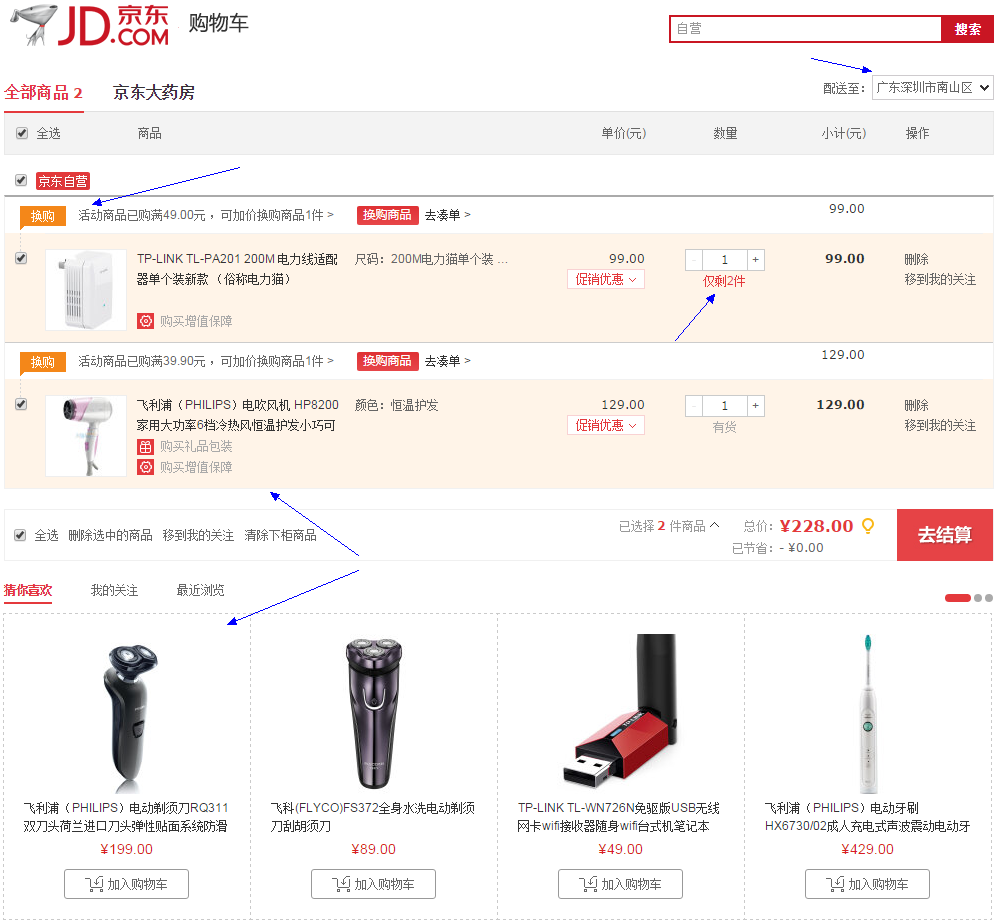
假设我们浏览了一个网店,选中了一个商品,点击了下单这个流程,实际上需要的后台流程可能是下图所示:
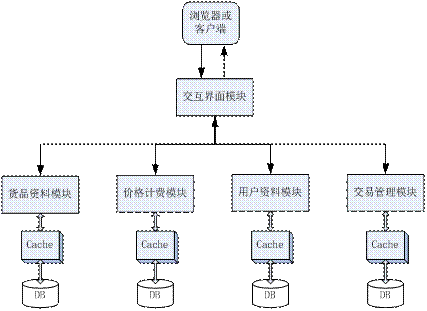
从上面的分析大概可以总结出几个特点:
1. 忍受延迟:每个操作的延迟要求较低,操作频率不会太高。一般我们页面在5秒内打开,都不会引起太多客户的抗议。所以,就算我们处理一个请求的时候,后台进行多次的进程间调用,产生的延迟和带宽消耗也是可以忍受的。
1. 在线交互少:互联网业务大多数是基于浏览器的,所以在线用户之间很少实时交互。
1. 数据分散:一般来说,互联网应用的数据可以在多个不同的业务系统中共用,但是需要专门的业务模块来做管理,以维持数据的一致性。
1. 数据变更面广:系统需要持续处理很多数据变更,互联网业务有很大一部分数据是来源于普通用户、网络编辑、店主等等使用者,在使用的过程中,他们会大量的修改系统所存储的数据。

以上四个特点,导致了我们一般会把后台要处理的数据,分别用Cache系统和DB系统来处理。并且,我们一般会按业务功能划分模块,同时也划分业务系统。由于延迟和在线交互的需求较弱,所以使用大量进程来做模块隔离,依然是非常可行的,总体来说,就是一种比较“分散”的数据使用方式。

游戏类业务的数据处理流程

在各种游戏中,MMORPG是数据处理最为复杂的一类,也是最典型的一种“重服务器端”的游戏类型,因此可以作为游戏业务中通用性的参考标准。在MMORPG中,我们可以发现,数据的处理需求,和一般互联网业务大相径庭,它体现出的是一种明显的“集中”式的数据处理需求。我们可以从一般MMORPG的服务器架构中体现出来:

在游戏业务中,一般我们都会发现以下的特点:
1. 延迟敏感:游戏中用户会产生大量操作,都要求“实时”进行反馈,所以一般都不能忍受1秒以上的延迟,在大量动作类型的游戏中,一般都会要求服务器的反馈时延在50ms左右。因此游戏开发者都习惯于尽量减少后台进程间的交互,尽管这对提高系统吞吐量很不利。所以大部分游戏服务器端都有一个所谓“GameServer”,里面运行了游戏70%以上的功能。
1. 大量实时交互:在线游戏的特点,就是很多玩家可以通过服务器“看见”彼此,能实时的互动。因此我们必须要把用户的在线数据,集中到一起,才能提供互相操作的可能;而且A用户操作B用户的数据,是最常见的数据操作,所谓战斗玩法,就是互相修改对方的数据的过程。
1. 数据集中:游戏是一个几乎完全虚拟的世界,在游戏中的数据,实际上很少能在其他系统中产生价值。而游戏逻辑也禁止通过游戏以外的方式,修改游戏的数据。所以游戏中的数据,一般都会集中存放在单独的数据库中。由于没有数据共用的需求,所以也不需要把GameServer里面集中的逻辑划分出很多单独的进程模块来。
1. 数据变更少:实际上游戏的数据变更还是很快的,比如游戏中的每次中弹,都要减少HP的数值。但是游戏里的数据,一般都遵守这样一个规则:“变化越快的数据,重要性越低”。也就是说,游戏中是可以容忍一定程度的数据不一致和不完整的。而游戏中的数据,一般会分成两类:玩家存档和游戏设置。对于玩家存档来说,其单条数据量一般不大,但会有大量的记录数,因为每个玩家都会有一个存档。但是其读取、修改,一般很典型的和玩家的登录、登出、升级等业务逻辑密切关联,所以其缓存时机是比较容易根据业务逻辑来把握的。而对于游戏设置数据来说,几乎只有升级游戏版本的时候才会修改,大部分运行时是只读的,其缓存简单的读入内存就解决问题了。

一般的缓存系统的特点在游戏中的问题

根据以上的分析,我们可以看到,普通的缓存系统,如memcache和Redis,实际上其特点是不太适合游戏业务的:
- 一般跨进程的缓存系统,无法解决游戏要求的低延迟问题。级别是同机房,每次数据存取都需要10-20ms的时间,对于游戏战斗中大量的数据读、写来说,是很难接受的。(但是一些回合制战斗、低频操作还是有用的)
- 通用型的缓存系统或者数据库,一般都比较难集结多个进程,形成一个完整的数据存储网格。这让玩家间的互相交互产生了额外的难度,开发者必须先想办法确定玩家的数据在哪个后台进程上,然后才能去读写。一般的数据库或缓存系统,为了保证数据的一致性或者完整性,往往会需要牺牲一些分布式的能力。而这种牺牲在游戏业务中,其实是一种浪费,因为游戏的很多数据都无需这种能力。
- 通用性数据系统一般不依赖于特定的语言,所以很少能直接把某种“对象”存入到数据系统中。在游戏开发中,需要存储的数据结构数量往往是非常大量的:一个普通的游戏,基本上都会超过100种数据结构。对于每个数据结构,都去建表或者编写序列化/反序列化配置,是一种非常累人的工作。——明明在代码中,已经用编程语言定义了他们的结构,还要重复的搞一次。

根据上面说的这些问题,我们实际上是需要另外一种完全不同设计思想的数据系统。

本地分布式缓存服务的特点和优势

对于游戏业务来说,一个好用的数据系统,应该包括这样一些特点:
- 可以利用GameServer进程内的内存进行自动化的缓存管理。由于GameServer进程往往集中了大部分的逻辑运算,所以大部分的数据缓存也应该在这个进程中,这样才能符合游戏所需的延迟要求。
- 自动进行数据落地和容灾管理。由于游戏数据中有大量的“过程数据”,所以其一致性和完整性要求会稍微低于其他业务,所以应该利用这一点,让GameServer本身也可以是分布式的程序,从而提高系统整体的吞吐量。
- 具备良好的编程易用性。最好是能直接存取编程中的对象,避免反复对数据结构的描述,节省大量的开发时间。

本文首发腾云阁 缓存系统在游戏业务中的特异性

相关推荐

大模型的Agent Skill功能,在LLM HTTP底层交互流中是怎么承载的?

网络文章文本的 skill,昨天我实现了之后也就开始好奇起 Skills 的底层原理了——相比起各种花里胡哨的 agrnt 应用,我一直以来都很对大模型在纯粹的 HTTP 交互层面是如何交互的更感兴趣。Skill 的全部"魔法"都发生在 system prompt 的措辞和 SKILL.md 文件的编写质量上——本质上是一种 prompt engineering + 文件系统的组合。但是各种天花乱坠的 skills,是如何在底层的 HTTP 中,与大模型——这个只会嘴遁的工具交互的呢?

QcloudCommunity的博客 407

万字入门AI Infra:深入理解大模型中的数学与Infra优化

关注腾讯云开发者,一手技术干货提前解锁👇AI Infra科普、入门或者进阶 ~~ 不到 5 万字,带你融会贯通理解大模型的数学、算法、硬件到系统工程。任何问题欢迎沟通交流。可怕,我竟然有点认同这句话。当然大概率是因为姚顺宇太懂AI了,而我则是因为无知者无畏。不过仔细想想,大模型推理中的数学逻辑确实不复杂,很多原理只需要高中数学知识就能看懂。但是为什么像 vLLM 这种推理系统这么复杂呢?本文将拆解大模型中几个核心操作(RMSNorm、Softmax、Causal Mask、Sampling)背后的数学与

QcloudCommunity的博客 1168

平平无奇的源码,竟藏着Agent的核心秘密?

System Prompt 是剧本,Skill 是剧本的扩展包,Agent Loop 是演员按剧本行动。欢迎留言,我们将邀请作者针对性回复你的评论,我们将选取1则优质的评论,送出腾讯云定制文件袋套装。,让 Agent 能主动"巡逻",而不只是被动等待用户消息。OpenClaw 的 System Prompt 分层结构。的"行为底线",任何 Skill 或用户命令都无法覆盖它。精华 2:Skill 的"按需加载"避免 token 浪费。精华 1:System Prompt 是"分层乐高积木"

QcloudCommunity的博客 426

QQ音乐Harness Engineering实践

一个看似简单的需求,背后可能牵动服务调用链、配置、灰度、埋点、错误码、接口契约和历史兼容性。当 AI 开始快速生成大量代码,真正的瓶颈就不再是"写不出来",而是"看不完、想不清、管不住"。在对话式编码阶段,一种典型的工作模式逐渐流行:开发者把需求丢给 AI,扫一眼输出"看起来对"就直接采纳,不审 diff、不追问逻辑、不验证边界。以音乐商业化业务为例,一个需求可能从 TAPD 单开始,经过需求评审、技术方案、服务影响面分析、IDL 契约变更、业务代码实现、测试验证、CR、灰度上线,最后才进入稳定运行。

QcloudCommunity的博客 715

从Prompt、Context到Harness,工程的三次进化与终局之战

同时,强制要求散落各处的决策记录(Slack、邮件、文档)全部迁移至代码仓库,确保 Agent 的唯一信息来源是可信的、版本受控的仓库。更坑爹的是,研究表明,当上下文过长时,模型会出现"中间遗忘(Lost in the Middle)"现象:它对开头和结尾的内容记忆较好,对中间大段内容的关注度大幅下降。这篇文章,我想带你完整走一遍这三次进化的逻辑:它们分别解决了什么问题,它们之间是什么关系,它们的边界在哪里,以及:当三者融合,AI 工程师的终极形态究竟是什么?大语言模型的本质,就是这位金鱼助理。

QcloudCommunity的博客 719

让Skill自己训练自己:8阶段Loop、3层评测、5维AND门控,从此实现自进化

所以每一轮改动都是有据可查的,不是「感觉这里可以优化」,而是「Case 41 挂了,因为 agent 把离职问题路由到了邮箱分类,但正确答案在通讯录,所以我改 root_index.md 加个易混淆提示」。但让我最后决定把它记录下来的,不是这的个「吸收」过程,而是它真的在替我探索我不想费脑力触达的边界,这看起来更像是一个机器智能应该有的样子。不准跨层,每轮只改一层的东西。但我经过这 19 轮之后觉得,更准确的描述是互补——你在明处看着,AI 在暗处替你试错,你看不见的那一半就是 AI 能贡献的地方。

QcloudCommunity的博客 1127

只加两行代码,为什么要两天?一文深度理解业务系统的复杂性

关注腾讯云开发者,一手技术干货提前解锁👇业务系统复杂性一直是令开发者头痛的问题。复杂的不是增加一个需求需要耗费多少时间,而是在增加一个需求后带来的蝴蝶效应:其它功能会不会受到影响、要如何去找到这些影响,最终如何实现系统正常运行......功能之间隐秘增加的耦合、不可避免的代码腐化在导致业务复杂性增加。大家都在说的软件开发提效到底在提什么?程序员日常工作中应该如何提升开发效率?敏捷开发、瀑布流式开发孰是孰非?欢迎阅读。业务背景与目标我依然非常清晰地记得某个时候,我所在团队 Leader 曾讲过一段话:“我担

QcloudCommunity的博客 713

从零设计生产级 Multi-Agent Harness:架构、评估、记忆、成本与 MCP 工具接入全拆解

在 AI Agent 领域,Multi-Agent Harness 指的是把多个 Agent 的能力、工具、状态、通信、编排、监控统一收束在一个运行时之内的框架。第三,Agent 路由。一个输入框,一个大模型,几个工具,一段写得很漂亮的 System Prompt,再配上一个炫酷的前端,看起来就像一个能干活的“数字员工”。Multi-Agent 完全不一样——它有计划、有中间步骤、有工具调用、有 Agent 协作、有重试、有反思、有最终合成。增加 Budget、权限、重试、压缩、轨迹评估、审计、回归测试。

QcloudCommunity的博客 710

拆完Hermes源码,我发现Agent的“自我进化“根本不需要训练模型

两个月 5.2 万 Star,Hermes Agent 用一个"LLM 审判官"机制实现了 Agent 的自我进化——不改模型权重,只改"怎么用模型"的策略。OpenClaw(社区昵称"龙虾"🦞)是 2025-2026 年最火的开源 Agent 框架,30 万+ Star,插件市场 ClawHub 里有数千个插件,能接入 Telegram、WhatsApp、Slack、飞书、企业微信——几乎是一个"个人 AI 操作系统"。Skill 是英语写的,Memory 是英语写的,审查 Prompt 也是英语写的。

QcloudCommunity的博客 910

AI Infra 其实没有多少新东西

传统 Infra 追求横向扩展,而 AI Infra 呈现 “AI 大型机”特性,是因为传统后台服务的可以容忍毫秒级延迟,但 AI 集群不行,GPU 的算力是 CPU 的数百倍,微秒级的延时等待也会造成很大的算力损耗,需要硬件的高度集成。在可预见的1-3年的未来,这样的专用硬件+网络的集中式架构很难发生比较大的改变。与之相似,模型推理的批处理就是将多个输入样本打包(batch),将原本串行的 N 次轻量的推理计算,合并为 1 次重量的计算,实现单位时间内处理更多的请求,提高了 GPU 利用率。

QcloudCommunity的博客 826

程序员越早想通这些越好

永远没有正确架构,你永远无法偿还完所有的技术债务,如同你永远不会设计出完美的界面,请避开完美主义的陷阱,永远没有完美的代码,能够满足当前需求,又为未来不管是自己还是他人留有扩展空间,就很好了。我们努力的方向就是将现实世界映射到有限的数据结构中,这就需要用户自定义类型,如果你的代码中包含类似 trader portfolio 这样的概念,你就可以使用他们的名称来建模,而不是使用基本数据类型复杂嵌套表述你的目的。从另一个角度看,代码里的注释都是补丁,是碎片化的,局部的注释很难推导模块整体的顺序及耦合关系。

QcloudCommunity的博客 466

RAG已死?不,是Grep回归了!

这样一来可以直接复用已有的计算缓存,只为新增的增量部分付全价,前面累积的大头按约 1/10 的缓存价计费。所以实际的工具组合方式是灵活的:Grep(默认模式)→ Read 是最常见的路径,但 Grep(content 模式)可以独立使用,LLM 也可以直接调 Read(如果已经知道文件路径),或者一次同时发起多个 Grep 并行搜索。它从零开始构建自己的对话历史,不继承主对话的消息,这意味着它搜索过程中产生的大量 grep 结果、代码片段都留在自己的 context 里,主对话只收到一段总结性的文本结论。

QcloudCommunity的博客 576

深入浅出Harness Engineerring之核心模式与理念

在智能体生命周期的关键节点(如会话开始、工具调用后)自动触发预设动作(如代码格式化),由系统确保关键流程被执行,不依赖可能被模型遗忘的指令。简单讲就是利用向量存储这个技术,来实现模糊检索,原理是:即使字面不同,但语义相近的文本,其向量在数学空间中的位置也很接近。根据命令类型、参数和影响,自动评估其风险等级(安全、有风险、危险),并采取自动执行、请求确认或直接拦截等不同策略。关键特性是可隔离、可重建、可扩展。不是一次判断就定终身,允许你改变、允许情况复杂,通过不断观察、思考、调整,越来越懂真实的你。

QcloudCommunity的博客 624

Harness Engineering实践心得:如何高效驾驭AI?

但如果这些经验被拆成一条条 Rule、一个个 Skill、一项项 Script 检查——"XAML 不能有中文"、"编译要用这个路径的 MSBuild"、"SVN 命令必须带认证参数"——AI 就能在秒级时间里"吸收"十年的踩坑经验。然后可以看到下方的图,我的PM会很顺利的调度其他agent分别负责不同的事项,遇到问题的时候也能准确的找到合适的agent。MCP 本质上是在扩展 AI 的"感知范围"——Rule 管"该怎么做",Skill 管"怎么操作",MCP 管"能看到什么、能碰到什么"。

QcloudCommunity的博客 843

从第一性原理思考 Agentic Engineering

需要注意的是,这一结论是有条件的:如果 AI 缺乏领域知识,过早介入反而可能引入 1.2 节所述的"似是而非"损耗——因此上下文供给(实践 1)是 AI 全链条参与的前提,而非结果。通过一个专门的自迭代 Skill 实现——当 AI 在协作过程中识别到自己被纠正(用户否定了 AI 的输出并给出了正确方向),它自动评估这个错误的根因,搜索现有的 Rules 和 Skills 中是否已有针对该类问题的处理规则。事实上,越是复杂的项目,工程师的认知负担越重(公理 3),AI 分担认知负担的潜在边际价值也越大。

QcloudCommunity的博客 757

万字干货!Harness Engineering如何工程化落地?

关注腾讯云开发者,一手技术干货提前解锁👇Harness Engineering 的概念已经火了有一阵了,全网很多文章基本都是在讲理念,讲为什么今天做 AI 开发,不能只靠一段提示词,也不能把模型当一个“更聪明的代码补全”。但与此同时,一个问题也在持续地发酵:这个问题特别重要。因为 Harness 这个词听上去很大,很像一个抽象的方法论,但它如果不能落到工程、目录、文档、脚本、工作流里,那它最后就只是一句漂亮的话。事实上,不同项目落地出来的 Harness,表面上可能完全不一样。有的项目是 CI 很强,有的

QcloudCommunity的博客 1170

全方位对比:Hermes VS OpenClaw

多账号矩阵运营 如果你的业务涉及同时管理多个社交媒体账号、多个平台的内容分发、多渠道的客户互动——OpenClaw是目前市场上的"无可替代的底座"。一个有专业背景的个人,现在可以快速构建一个垂直领域的AI助手:比如"财务分析Hermes"、"法律咨询Hermes"、"技术架构Hermes",直接通过微信提供服务,积累自己的专业IP。跨平台生态融合 如果你的工作流涉及飞书、Slack、Discord等多个平台的深度集成,需要这些平台之间的数据流转和联动——OpenClaw的生态支持是强大的。

QcloudCommunity的博客 1217

一文讲透:Harness Engineering即控制论!

而研发模式的升级我认为将会是一个飞跃的过程,之所以现在我们仍然需要需要参与编码,一个非常大的原因就是缺乏传感器和基建,仍然需要人来串流程,比如需要人来验证UI是否正确、需要人来告诉AI代码不符合代码规范,因此在有些场景我们仍然感觉 AI 完成的很吃力,但这不是 AI 能力不行,而是我们并没有为 AI 提供友好的环境……控制论中的突变理论介绍了矫枉过正和飞跃现象之间的矛盾,如果质变中经历的中间过渡态是不稳定的,那么他就是一个飞跃的过程,如果中间过渡态是稳定的,那么他就是一个渐变的过程。但是这些阶段要解决的。

QcloudCommunity的博客 1204

神级开源插件!一句话让QClaw变3D小镇,Agent工作可视化,赛博云监工

这个架构是翻了几次车才想通的—原有AI的实现机制是用 setTimeout 猜动画时长导致了幽灵 NPC、工位撞车、越改越崩,后面我停下来换了思路,推翻原有的架构,按照“意图+回传”的架构进行重构,之前的问题一次性全部解决。15 天,我和 AI 吵了 185 次架, 4.5 万行代码,开发了一款 QClaw / OpenClaw 的UGC游戏插件,这可能是人类跟 Agents 交互的新范式,插件已完全开源,有需要的欢迎自取~我天天用,用着用着我就在思考,Agent 产品现在的交互体验,基本都一个样。

QcloudCommunity的博客 1197

一文搞懂Hermes:新顶流Agent如何从经验中自我进化

Voyager 是一个能在 Minecraft 中自主探索、学习技能、无限积累能力的 AI Agent,它提出了 "Skill Library"(技能库)的概念——Agent 将成功的行为序列编码为可复用的技能函数,存储在一个持续增长的代码库中。如果 Skill 的名称和描述不够精准,或者用户的任务描述与 Skill 的触发条件有语义差距,Agent 可能会错过相关的 Skill。如果进程在写入过程中崩溃,目标文件要么是旧内容(还没被替换),要么是新内容(替换已完成),绝不会出现写了一半的损坏文件。

QcloudCommunity的博客 2636

自掏腰包一万元,拥抱AI这一年,我的工具、实践和思考

其实也很好理解,过往的每个领域(比如前端、后端、设计、测试等等)都主要是这个领域的从业者在为它添砖加瓦,但是大模型时代的 AI 应用领域却几乎是所有使用 AI 的人类一起在迭代,无分领域,无分文理,无分老少。因为每个时期的 AI 都有着不同的特点,很多时候当我费尽心思去钻研,自以为有点弄明白 AI 应该怎么玩的时候,基座模型和行业范式常常就会迎来颠覆式的变革,很多过往的经验都会倾覆,然后只能从头再来。过去一年多,被热议的 AI 范式大概是沿着四个阶段递进演化,每一个阶段其实都在解决前一个阶段的核心问题。

QcloudCommunity的博客 627

办公Agent的CI/CD时刻到来了

核心观点是:企业给员工配了一堆 AI 工具,试点跑了几百个,但真正拖慢 AI 转型速度的瓶颈不在模型能力,在"最后一公里":AI 输出和实际工作流之间的那道鸿沟。代码写完,打个 tar 包,开 FTP 传到服务器上,SSH 进去解压,改配置文件,重启服务,刷一下页面祈祷别 500。你复制,切窗口,粘贴到腾讯文档里,发现 Markdown 格式全乱了,手动调标题层级,代码块重新标记语言类型,表格散架了重排一遍。模型是越来越聪明了,但"生成"到"落地"之间那段路,还是你自己在走,一步一步,手动搬运。

QcloudCommunity的博客 608

4亿token买来5个教训:让6个AI Agent连写4天代码发生了什么?

Watchdog 检测到崩溃 → 启动诊断 Agent 分析原因 → 诊断 Agent 跑满 20 轮没搞定 → Watchdog 判定“已修复”,重启系统 → 重启的系统因为诊断 Agent 留下的环境变量被继承,连续 3 次拒绝启动 → 触发连续失败保护退出 → Watchdog 第 3 次巡检,发现进程和记录文件都没了,尝试手动重启,自己也停了。启动前我翻了论文、做了架构设计、写了监控+修复异常的脚本。这个发现让我的情绪从沮丧变成了兴奋——不是那种"终于修好了"的释然,是"我找到根因了"的快感。

QcloudCommunity的博客 584

赛博斗蛐蛐:9大模型决战三国志,天命在谁?

我猜是这样的,当Gemini面临决策的时候,一系列关键词比如 守城,劣势,粮草,三国等等,在语义层面的关联性中LLM发现了竖壁清野这个关键词概率非常高,所以以此为策略,然后再根据这个策略完美执行操作。MiMo 的外交是三方中最精明的。Kimi作为国产模型,也同样颠覆了我对他的看法,最后的比赛他甚至一度是优势者,存在很多夺冠的可能性,要知道他的对手可是claude和gemini,而他经常出兵慢,回过头来想想或许正是他的策略,毕竟中后期他的优势都来自于稳健的发展和较少的战斗频率(和claude比).

QcloudCommunity的博客 874

Claude Code是怎么知道你在骂他的?这 12 条发现值得关注

确实存在——5,500+ 行,集成了消息队列、工具装配、MCP 编排、会话状态、权限、分析、文件持久化和优雅关闭,基本上一个文件干了所有事。对抗虚假声明——"不要在输出显示失败时声称所有测试通过,不要压缩或简化失败的检查来制造绿色结果"。完整的 KAIROS 是一个持续驻留的守护进程,能感知你在不在电脑前、主动寻找有用的工作做,更像是住在终端里的全职同事。源码里藏着一个叫 "Buddy" 的电子宠物系统,完整度令人惊讶——这不是一个 TODO,而是一个从数值系统到 ASCII 动画都实现了的完整功能。

QcloudCommunity的博客 701

逆向深扒Claude Code源码,我发现了什么!?

Anthropic 内部用户获得更严格的质量控制 prompt、更好的验证机制(独立 Verification Agent)、以及针对 model 弱点的专门对策(如 Capybara v8 的 29-30% 错误声明率对策)。这不是代码混乱的标志——它是整个 Agent Loop 的心脏,所有的流式处理、工具调度、上下文压缩、子代理管理都在这个文件中协调。这种"胖核心"设计是刻意的:保持核心循环的原子性,避免分散到多个模块导致的协调复杂度。核心价值:Fork 代理的工具输出不会回到主代理的上下文窗口。

QcloudCommunity的博客 892

一文讲透如何构建Harness——六大组件全解析

本文将从"裸模型的四个硬伤"出发,逐一拆解 Harness 的六大组件——文件系统、Bash + 沙箱、记忆(AGENTS.md)、Web Search + MCP、上下文工程、编排 + Hooks——带你看清 AI Agent 真正的竞争壁垒,不在模型层,而在 Harness 层。如果你用过 Agent 做复杂任务,你一定有过这样的体验:一开始 Agent 的表现很好,但随着对话变长,它开始"变笨"——遗忘之前的约定,重复之前犯过的错误,甚至对同一个问题给出前后矛盾的回答。对于简单的问答场景,这无所谓。

QcloudCommunity的博客 761

Harness Engineering 来了,SDD 还有意义吗?

他们的解法是把「品味」编码进规则,然后用一个定期运行的「doc-gardening」Agent 自动扫描漂移、发起修复 PR——「技术债务就像一笔高息贷款,不断地以小额贷款的方式偿还,总比让债务不断累积要好」。代码仓库本地的、已版本化的工件,才是 Agent 所能看到的全部。在 Vibe Coding 模式下(即不做规划、随意向 AI 提需求的开发方式),大量设计决策、跨服务约定、「为什么不选另一个方案」的讨论,全部停留在一次性的 AI 对话里——下一个人,或者下一次 AI 会话,完全无从获取。

QcloudCommunity的博客 419

零废话!一文讲透从0构建AI Agent

每个工具都要写一套"定义→解析→执行"的胶水代码。上下文管理就是在"记住足够多"和"别超标"之间找平衡,常见策略包括滑动窗口、摘要压缩、RAG 检索增强。上下文窗口是 Agent 的"工作记忆",但它有硬性限制。LLM 负责"动脑"决策,代码负责"动手"执行。这是从"聊天机器人"进化到"Agent"的关键一步。每次调 API 都把完整对话历史发过去,LLM 本身是无状态的,"记忆"完全靠客户端的数组模拟。这样 Agent 一开始就知道自己"在哪里"、"手头有什么",不需要先花一轮工具调用去探索环境。

QcloudCommunity的博客 711

距离AI把小编我裁掉还有72小时

这是一个基于 OpenClaw 开源生态打造的本地化 AI Agent 助手,已于上周开启全量公测,无需复杂配置,三步即可上手,自带安全防护,支持微信直连绑定,内置多款优质国产大模型,现阶段也是完全免费使用,基本上前面提到过的痛点都可以靠它解决。对了,这里特别强调一点,上面的截图让产品同事汗流浃背,再三找我确认 QClaw 思考过程中优美的“草”字说法,不会是默认出现的吧?AI 好,AI 得学,但更重要的是,在你的工作和生活里,哪些东西是能结构化地被 AI 所接入的,不要死守着那些脏活累活不放。

QcloudCommunity的博客 674
上一篇: Redis设计思路学习与总结
下一篇: Hbase的WAL在RegionServer基本调用过程
腾讯云开发者
腾讯云开发者 企业官方账号 企业官方账号
博客等级 码龄10年 6291粉丝 1962原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值