


👉目录
1 单模态:文本识别与生成
2 单模态:图像识别与生成
3 单模态:音频识别与生成
4 跨模态关联
5 跨模态:文本引导-生成图像
6 跨模态:文本引导-音频生成
7 其他
本文做为一篇“门户”文章,主要目的是进行相关技术的梳理和指引。所以不会详细介绍每个技术的具体方案,只是简单描述内容,或以连接形式指路到笔者认为比较好的详解。由于时间原因,本文必定会有不少遗漏和疏忽,各位看官如果发现,请在评论区指出~(备注:本文创作发布于2023年初)
关注腾讯云开发者,一手技术干货提前解锁👇
01
单模态:文本识别与生成
文本生成模型中,与靠实力大火的 GPT 族相比,其他很多早期的研究就略显暗淡。所以这里主要介绍 GPT 族模型及其相关研究。
1.1 重点论文解读
GPT123:GPT-1/GPT-2/GPT-3 简介
(https://mp.weixin.qq.com/s/bCYgzE4LF_P9gsWp7opZKQ)
GPT123:GPT,GPT-2,GPT-3 论文精读【论文精读】
(https://www.bilibili.com/video/BV1AF411b7xQ/?spm_id_from=333.337.search-card.all.click&vd_source=a1fb1825fbb0bd2b96afe2b90efca991)
InstructGPT:OpenAI 是如何“魔鬼调教” GPT的?——InstructGPT 论文解读
(https://zhuanlan.zhihu.com/p/595891945)
InstructGPT:InstructGPT 论文精读【论文精读·48】
(https://www.bilibili.com/video/BV1hd4y187CR/?spm_id_from=333.788&vd_source=ece125d5e4180da1606ccc843d1f1f04)
1.2 相关资料
| 论文/资料 | 描述 |
Efficient Training of Language Models to Fill in the Middle (2022) (https://arxiv.org/pdf/2207.14255) | OpenAI的,通过将一段话移到末尾,来学习文本填充能力,同时不损害模型正常的预估能力 |
Text and Code Embeddings by Contrastive Pre-Training (2022) (https://arxiv.org/pdf/2201.10005) | OpenAI的,文本embedding,就是将一对样本通过transformer-encode映射到x和y,然后计算相似度损失,解读:OpenAI: Text and Code Embeddings by Contrastive Pre-Training(https://zhuanlan.zhihu.com/p/496870495) |
WebGPT: Browser-assisted question-answering with human feedback (2022) (https://arxiv.org/pdf/2112.09332) | OpenAI的,基于GPT3进行finetune,用于浏览器的辅助回答 |
Training Verifiers to Solve Math Word Problems (2021) (https://arxiv.org/pdf/2110.14168) | OpenAI的,解决数学提问的语言模型 |
Evaluating Large Language Models Trained on Code (2021) (https://arxiv.org/pdf/2107.03374) | OpenAI的Codex,用github上的数据,基于GPT3的finetune,进行代码生成 |
| Process for Adapting Language Models to Society (PALMS) with Values-Targeted Datasets (2021) | OpenAI的,调整lm的结果,减少“毒性/偏见”输出,其实就是标了一批badecase的数据,进行finetune |
Understanding the Capabilities, Limitations, and Societal Impact of Large Language Models (2021) (https://arxiv.org/pdf/2102.02503) | OpenAI对于LLM的一些讨论 |
Generative Language Modeling for Automated Theorem Proving (2020) (https://arxiv.org/pdf/2009.03393) | OpenAI的,用于定理证明 |
BPE 算法原理及使用指南【深入浅出】 (https://juejin.cn/post/7088322473640329230) | BPE算法 |
FEB94 A New Algorithm for Data Compression (http://www.pennelynn.com/Documents/CUJ/HTML/94HTML/19940045.HTM) | BPE算法 |
Learning to Summarize with Human Feedback (2022) (https://arxiv.org/pdf/2009.01325) | OpenAI的文本摘要,微调GPT3,加上和Instruct类似的强化学习 |
Summarizing Books with Human Feedback (2021) (https://arxiv.org/pdf/2109.10862) | OpenAI的长文本(书)摘要,微调GPT3,分2阶段进行摘要 |
02
单模态:图像识别与生成
之前的图像生成技术主要采用 GAN,但是随着人们意识到了扩散模型生成效果多样性的好处,扩散模型现在逐渐取代了 GAN 在图像生成中的地位。
图像生成模型可抽象成“图像特征提取器 + 生成器”的范式(图像特征提取器可缺失,即直接从像素层级生成图片),其中特征提取器通常会采用 VQ-VAE 等方式,生成器就是常见的 GAN、扩散模型、自回归生成模型等。
2.1 重点论文解读
MAE:
(https://openaccess.thecvf.com/content/CVPR2022/papers/He_Masked_Autoencoders_Are_Scalable_Vision_Learners_CVPR_2022_paper.pdf)
MAE 论文逐段精读【论文精读】
https://www.bilibili.com/video/BV1sq4y1q77t/?spm_id_from=333.788&vd_source=ece125d5e4180da1606ccc843d1f1f04
Image GPT:Generative Pretraining from Pixels - 郑之杰的个人网站
(https://0809zheng.github.io/2020/12/29/igpt.html)
GLIDE:
(https://arxiv.org/pdf/2112.10741)
从 DDPM 到 GLIDE:基于扩散模型的图像生成算法进展
(https://zhuanlan.zhihu.com/p/449284962)
2.2 相关资料
| 论文/资料 | 描述 |
Deep Residual Learning for Image Recognition (2015) (https://arxiv.org/pdf/1512.03385) | 微软的ResNet,经典结构。 |
Generating Long Sequences with Sparse Transformers (2019) (https://arxiv.org/pdf/1904.10509v1) | OpenAI的Sparse Transformers,主要用来加速训练,减少内存消耗 |
Momentum Contrast for Unsupervised Visual Representation Learning (2020) (https://openaccess.thecvf.com/content_CVPR_2020/papers/He_Momentum_Contrast_for_Unsupervised_Visual_Representation_Learning_CVPR_2020_paper.pdf) | FAIR的MOCO,较早在CV用无监督对比学习,可进行图像特征提取、分类、检测等,结构:解读:MoCo 论文逐段精读【论文精读】(https://www.bilibili.com/video/BV1C3411s7t9/?spm_id_from=333.788&vd_source=ece125d5e4180da1606ccc843d1f1f04) github:facebookresearch/moco(https://github.com/facebookresearch/moco) 另外还讨论了对比学习中目标函数、代理任务的一些内容,值得学习 |
Improved Baselines with Momentum Contrastive Learning (2020) (https://arxiv.org/pdf/2003.04297v1) | FAIR的MOCO V2,在MOCO基础上引入SimCLR的设计:MLP映射头+数据增强。(github同MOCO) |
An Empirical Study of Training Self-Supervised Vision Transformers (2021) (https://arxiv.org/pdf/2104.02057v4) | FAIR的MOCO V3,弃用队列,采用新的Loss。并研究采用ViT后的稳定性和效果,以及一些细节,github:facebookresearch/moco-v3 |
An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale (2021) (https://arxiv.org/pdf/2010.11929) | Google的ViT,CV领域重要的基石结构:解读:ViT论文逐段精读【论文精读】github:GitHub - google-research/vision_transformer |
Masked Autoencoders Are Scalable Vision Learners (2022) (https://openaccess.thecvf.com/content/CVPR2022/papers/He_Masked_Autoencoders_Are_Scalable_Vision_Learners_CVPR_2022_paper.pdf) | FAIR的MAE,在视觉领域做到无监督预训练(类似AutoEncoder,遮住一部分patches),结构 |
An Introduction to Image Synthesis with Generative Adversarial Nets (2018) (https://arxiv.org/pdf/1803.04469) | 图像生成:基于GAN进行图像生成的综述,用于补充背景知识。结构示意图:解读:超详综述:GAN在图像生成上的应用 (https://zhuanlan.zhihu.com/p/56157840) |
Autoencoders (2021) (https://arxiv.org/pdf/2003.05991) | AutoEncoder,这不是一个新技术,不能进行图像生成,作为知识补充。 |
Generalized Denoising Auto-Encoders as GenerativeModels (2013) (https://proceedings.neurips.cc/paper/2013/file/559cb990c9dffd8675f6bc2186971dc2-Paper.pdf) | 图像生成:介绍Denoising AutoEncoder用于生成模型,DAE不是一个新技术,主要是在Encoder前加了一个噪声。 |
Auto-Encoding Variational Bayes (2013) (https://arxiv.org/pdf/1312.6114) | VAE,与AE的区别在于,AE中间是抽取的Feature,VAE学习中间的分布,用于生成时,从中间的分布随机生成Feature,给后面的生成器。 |
Neural Discrete Representation Learning (2017) (https://proceedings.neurips.cc/paper/2017/file/7a98af17e63a0ac09ce2e96d03992fbc-Paper.pdf) | VQ-VAE,与VAE相比,把中间的分布改成了一个离散的codebook。由于codebook时固定的,为了做随机生成,还要单独训练一个prior网络。结构:非官方github:deepmind/sonnet / vqvae_example (https://github.com/google-deepmind/sonnet/blob/v1/sonnet/python/modules/nets/vqvae.py)/(https://github.com/google-deepmind/sonnet/blob/v1/sonnet/examples/vqvae_example.ipynb) |
Generating Diverse High-Fidelity Images with VQ-VAE-2 (2019) (https://proceedings.neurips.cc/paper/2019/file/5f8e2fa1718d1bbcadf1cd9c7a54fb8c-Paper.pdf) | 图像生成:用VQ-VAE 2进行图像信息提取得到Latent Codes,并学习Latent Codes的先验分布,最后的生成器用的是PixelCNN。结构: |
VideoGPT: Video Generation using VQ-VAE and Transformers (2021) (https://arxiv.org/pdf/2104.10157) | VideoGPT(不是OpenAI的),生成视频,利用C3D构建VQ-VAE,生成器用Transformer。结构:github:wilson1yan/VideoGPT |
U-Net: Convolutional Networks for Biomedical Image Segmentation (2015) (https://arxiv.org/pdf/1505.04597) | u-Net结构,一种扩散模型中常用的卷积结构。结构:网络结构和代码 |
Denoising Diffusion Probabilistic Models (2020) (https://proceedings.neurips.cc/paper/2020/file/4c5bcfec8584af0d967f1ab10179ca4b-Paper.pdf) | DDPM,用扩散模型进行图像生成,解读。 官方github(1.6k star):hojonathanho/diffusion(https://github.com/hojonathanho/diffusion) 非官方github(3.3k star):lucidrains/denoising-diffusion-pytorch(https://github.com/lucidrains/denoising-diffusion-pytorch) |
Improved Denoising Diffusion Probabilistic Models (2021) (https://arxiv.org/pdf/2102.09672) | OpenAI的Improved DDPM,改动点:不仅学均值还学方差 + 线性schedule改成余弦schedule,大模型有效。github:openai/improved-diffusion(https://github.com/openai/improved-diffusion) |
Diffusion Models Beat GANs on Image Synthesis (2021) (https://proceedings.neurips.cc/paper/2021/file/49ad23d1ec9fa4bd8d77d02681df5cfa-Paper.pdf) | OpenAI用更大的模型,采用分类引导的方式,生成图像。业界除了分类引导,还可以采用文本引导、图片引导等多种方式,这里不一一列举。 |
Classifier-Free Diffusion Guidance (2022) (https://arxiv.org/pdf/2207.12598) | classifire-free guidance,学习一个有条件 -> 无条件的映射,在无引导时进行纠偏。 |
GLIDE: Towards Photorealistic Image Generation and Editing with Text-Guided Diffusion Models (2022) (https://arxiv.org/pdf/2112.10741) | OpenAI的GLIDE,用到了classifire-free guidance。只用了3.5B参数,达到了很好的效果。 |
03
单模态:音频识别与生成
3.1 重点论文解读
Whisper(语音识别):OpenAI Whisper 精读【论文精读·45】
(https://www.bilibili.com/video/BV1VG4y1t74x/?spm_id_from=333.788&vd_source=ece125d5e4180da1606ccc843d1f1f04)
语音识别是一个比较老的领域了,本文通过对比学习的技术,在68W小时的语音文本对上进行训练。
贡献1:可以进行 zero-shot 不需要微调就能在复杂的数据上取得较好效果,而且开放了预训练模型,大家可以直接用。
贡献2:综合考虑了多个任务(英语、原语言、是否有人说话、翻译等)的情况。
Jukebox(2020):OpenAi Jukebox 算法介绍(中文字幕)
(https://www.bilibili.com/video/BV1rA411t7bH/?spm_id_from=333.337.search-card.all.click&vd_source=ece125d5e4180da1606ccc843d1f1f04)
通过三个 VQ-VAE(分别采用不同密度对音频进行分割)进行自编码。
获得自编码分布(codebook)后,分别通过 prior、upsampler、decode r来生成新的音乐。其实就是一个很正常的生成式模型,即编码、prior 以及一个 autoregressive Transformers 作为 decoder 的流程。
3.2 相关论文
| 论文/资料 | 描述 |
Conformer: Convolution-augmented Transformer for Speech Recognition (2020) (https://arxiv.org/pdf/2005.08100) | Conformer,在语音领域比较常应用的结构,在Transformer基础上加了一个卷积操作。 非官方github:sooftware/conformer / lucidrains/conformer / (https://github.com/sooftware/conformer) |
wav2vec: Unsupervised Pre-training for Speech Recognition (2019) (https://arxiv.org/pdf/1904.05862) | wav2vec,语音识别,无监督对比学习,用的是卷积结构,主要是训练一个编码器对语音数据进行encoding |
wav2vec 2.0: A Framework for Self-Supervised Learning of Speech Representations (2020) (https://arxiv.org/pdf/2006.11477v3) | wav2vec 2.0,引入latent space。但是这类无监督的方式不可避免需要额外的一个decoder,来转化成最终识别出来的text。 github:facebookresearch/fairseq (https://github.com/facebookresearch/fairseq) |
SingSong: Generating musical accompaniments from singing (2023) (https://arxiv.org/pdf/2301.12662) | 它使用现成的“声源分离算法”从大量音乐音频创建出合成训练数据集。然后训练一个 Transformer 来预测人声中到乐器声音映射。demo (https://storage.googleapis.com/sing-song/index.html) |
04
跨模态关联
CLIP 的思想(图文配对+对比学习)是目前进行文本与图像关联方面的共识。
4.1 重点论文解读
CLIP:[中文字幕] OpenAI CLIP 论文解读
(https://www.bilibili.com/video/BV1Cv411h72S/?vd_source=7eca43a1454e93ec38151f0f751ee623)
CLIP:CLIP 论文逐段精读【论文精读】
(https://www.bilibili.com/video/BV1SL4y1s7LQ/?spm_id_from=333.788&vd_source=ece125d5e4180da1606ccc843d1f1f04)
CLIP:【CLIP 系列 Paper 解读】CLIP: Learning Transferable Visual Models From Natural Language Supervision
(https://zhuanlan.zhihu.com/p/486857682)
4.2 相关论文
| 论文/资料 | 描述 |
Large-scale Contrastive Language-Audio Pretraining with Feature Fusion and Keyword-to-Caption Augmentation (2022) (https://arxiv.org/pdf/2211.06687) | CLAP,类似于CLIP,只不过是文本与音频之间的关联模型。 结构:github:LAION-AI/CLAP (https://github.com/LAION-AI/CLAP) 数据集:LAION-AI/audio-dataset (https://github.com/LAION-AI/audio-dataset/) |
ViLT: Vision-and-Language Transformer Without Convolution or Region Supervision (2021) (https://arxiv.org/pdf/2102.03334) | ViLT,在多模态领域,将图像和文本特征融合的时候,针对图像patchs特征选用轻量的特征提取器。结构: github:dandelin/ViLT (https://github.com/dandelin/vilt) |
Language-driven Semantic Segmentation (2022) (https://arxiv.org/pdf/2201.03546) | L-Seg(分割),加入CLIP的text-encoder部分做初始化,并冻结参数,来辅助训练。但还是有监督,也不是对比学习。结构: github:isl-org/lang-seg (https://github.com/isl-org/lang-seg) |
GroupViT: Semantic Segmentation Emerges from Text Supervision (2022) (https://arxiv.org/pdf/2202.11094) | GroupViT(分割),采用像素点向上聚合,加入Grouping Block。同时加入CLIP的text-encoder(从头训练)。采用对比学习,结构: github:NVlabs/GroupViT (https://github.com/NVlabs/GroupViT) |
Open-vocabulary Object Detection via Vision and Language Knowledge Distillation (2022) (https://arxiv.org/pdf/2104.13921) | ViLD(检测),加入了text的一路,同时用CLIP作为teacher进行蒸馏。但是是二阶段,工业上不好应用。结构: github:tensorflow/tpu (https://github.com/NVlabs/GroupViT) |
Grounded Language-Image Pre-Training (2022) (https://openaccess.thecvf.com/content/CVPR2022/papers/Li_Grounded_Language-Image_Pre-Training_CVPR_2022_paper.pdf) | GLIP(检测),把一系列标签变成一句话,Loss包括分类的Loss和定位的Loss,然后学习CLIP来进行检测。结构: github:microsoft/GLIP (https://github.com/microsoft/GLIP) |
CLIPasso: semantically-aware object sketching (2022) (https://dl.acm.org/doi/abs/10.1145/3528223.3530068) | CLIPasso,抽象结构得到最简形式的简笔画。给定n个笔画(每个笔画由4个点组成的Bezier曲线),学习笔画与画面的语义+结构的Loss。CLIP作为teacher负责辅助计算衡量语义相似的Loss。结构: |
CLIP4Clip: An empirical study of CLIP for end to end video clip retrieval and captioning (2022) (https://arxiv.org/pdf/2104.08860) | CLIP4Clip(视频检索),其实就是把keys视频的多个帧分别抽取特征,然后把与query文本的相似度进行聚合(mean_pool,seq_type, tight_type)。结构: github:ArrowLuo/CLIP4Clip (https://github.com/ArrowLuo/CLIP4Clip) |
ActionCLIP: A New Paradigm for Video Action Recognition (2021) (https://arxiv.org/pdf/2109.08472.pdf) | ActionCLIP(视频动作识别),相当于把CLIP中的Image Encoder换成Video Encoder,相比CLIP另外改动:目标是多分类+视频中多帧的表示。结构: github:sallymmx/ActionCLIP (https://github.com/sallymmx/ActionCLIP) |
How Much Can CLIP Benefit Vision-and-Language Tasks? (2021) (https://arxiv.org/pdf/2107.06383) | 研究预训练的CLIP进行下游任务的效果,验证了CLIP的迁移效果。 |
Audioclip: Extending Clip to Image, Text and Audio (2022) (https://arxiv.org/pdf/2106.13043) | AudioCLIP(音频领域),在CLIP基础上加入了语音的一路,采用ECResNet作为语音Encoder,然后进行对比学习。结构: |
PointCLIP: Point Cloud Understanding by CLIP (2022) (https://openaccess.thecvf.com/content/CVPR2022/papers/Zhang_PointCLIP_Point_Cloud_Understanding_by_CLIP_CVPR_2022_paper.pdf) | PointCLIP(3D领域),把CLIP学到的2D表征迁移到3D中,具体来说是将3D投影到2D上形成多个视图。结构: |
Can Language Understand Depth? (2022) (https://dl.acm.org/doi/abs/10.1145/3503161.3549201) | 用分类方法,计算图片中的东西距离远近。 |
Multimodal Neurons in Artificial Neural Networks (2021) (https://distill.pub/2021/multimodal-neurons/#introduction) | 多模态神经元,作者发现CLIP中隐藏层神经元的输出可以看出来时图像,且与输入的text相关。官网:Multimodal Neurons in Artificial Neural Networks (https://openai.com/index/multimodal-neurons/) |
05
跨模态:文本引导-生成图像
目前,“特征提取+带引导的扩散模型”成为了生成式模型的主流。
5.1 重点论文解读
DALL·E:【一起读论文】OpenAI文本驱动的图像生成DALL-E (DALLE)。
(https://www.bilibili.com/video/BV16U4y1J7RQ/?vd_source=ece125d5e4180da1606ccc843d1f1f04)
首次用文本引导图像生成,但当时还没有开始采用扩散模型进行生成。
图像信息抽取就是用的 VQ-VAE2。
文字信息抽取用的 BPE。
然后把文字在前和图像在后,把特征拼接起来,后面用 GPT 作为生成器。
DALL·E V2:DALL·E 2(内含扩散模型介绍)【论文精读】
(https://www.bilibili.com/video/BV17r4y1u77B/?spm_id_from=333.788&vd_source=ece125d5e4180da1606ccc843d1f1f04)
decoder 就是一个 GLIDE 模型的变体,改动包括:分类引导改成 CLIP guidance 和 classifire-free guidance,以及进行级联式的生成,结构用的卷积(U-Net)而不是 Transformer。
prior用的也是一个classifire-free guidance的扩散模型,主体时一个 Transformer-Encoder。
Stable Diffusion(Latent Diffusion):【Stable Diffusion】 论文解读
(https://www.bilibili.com/video/BV1CG411V7jt/?spm_id_from=333.337.search-card.all.click&vd_source=ece125d5e4180da1606ccc843d1f1f04)
Latent Diffusion 论文主要是,通过一个 autoencoder 学习在 latent space(比像素空间小)上的扩散,以降低算力要求。另外,引入交叉注意力层可以将多模态信息统一注入到模型中。而 Stable Diffusion 只是在文本引导情况下的产品化。
5.2 相关论文
| 论文/资料 | 描述 |
NÜWA: Visual Synthesis Pre-training for Neural visUal World creAtion (2021) (https://arxiv.org/pdf/2111.12417.pdf) | 女娲(nvwa),北大和微软做的统一多模态预训练模型。可进行:text2image、sketch2image、image completion、video prediction、Image Manipulation、Video Manipulation等。github:microsoft/NUWA (https://github.com/microsoft/NUWA) |
ERNIE-ViLG: Unified Generative Pre-training for Bidirectional Vision-Language Generation (2021) (https://arxiv.org/abs/2112.15283) | 百度的ERNIG-ViLG,统一的生成式预训练框架,特点是文/图双向生成,不开源。WebDemo (https://huggingface.co/spaces/PaddlePaddle/ERNIE-ViLG) |
ERNIE-ViLG 2.0: Improving Text-to-Image Diffusion Model with Knowledge-Enhanced Mixture-of-Denoising-Experts (2022) (https://arxiv.org/pdf/2210.15257) | 百度的ERNIG-ViLG,提升图片质量,不开源 |
CogView: Mastering Text-to-Image Generation via Transformers (2021) (https://arxiv.org/pdf/2105.13290) | 清华的CodeView,文案生成图片,对标DALL·E。WebDemo。 (https://models.aminer.cn/CogView/index.html) github:THUDM/CogView (https://github.com/THUDM/CogView) |
CogView2: Faster and Better Text-to-Image Generation via Hierarchical Transformers (2022) (https://arxiv.org/pdf/2204.14217) | 清华的CodeView,文案生成图片,对标DALL·E V2。github:THUDM/CogView2 (https://github.com/THUDM/CogView2) |
CogVideo: Large-scale Pretraining for Text-to-VideoGeneration via Transformers (2022) (https://arxiv.org/pdf/2205.15868.pdf) | 清华的CogVideo,文案生成短视频。github:THUDM/CogVideo (https://github.com/THUDM/CogVideo) |
Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding (2022) (https://arxiv.org/pdf/2205.11487) | Google的Imagen,文案生成图片,用到了。没有开源代码和预训练模型。官网 (https://imagen.research.google/) 非官方项目:lucidrains/imagen-pytorch (https://github.com/lucidrains/imagen-pytorch) |
IMAGEN VIDEO: HIGH DEFINITION VIDEO GENERATION WITH DIFFUSION MODELS (2022) (https://imagen.research.google/video/paper.pdf) | Google的Imagen Video,文案生成视频。没有开源代码和预训练模型。官网 (https://imagen.research.google/video/) |
Imagen Editor and EditBench: Advancing and Evaluating Text-Guided Image Inpainting (2022) (https://arxiv.org/pdf/2212.06909) | Google的Imagen Editor,文本引导图像编辑。官网 (https://imagen.research.google/editor/) |
06
跨模态:文本引导-音频生成
6.1 重点论文解读
MusicLM:解读谷歌 MusicLM: 用文本生成高保真音频音乐。
(https://zhuanlan.zhihu.com/p/601360520)
6.2 相关论文
| 论文/资料 | 描述 |
AudioLDM: Text-to-Audio Generation with Latent Diffusion Models (2023) (https://arxiv.org/pdf/2301.12503.pdf) | 同样是一种用于音频生成的latent diffusion模型,类似于 Google 的 MusicLM,它训练称为 CLAP 的类似CLIP 风格的音频文本对比模型(contrastive),以提供高质量的嵌入。 demo, (https://audioldm.github.io/) github:haoheliu/AudioLDM (https://github.com/haoheliu/AudioLDM) |
Moûsai: Text-to-Music Generation with Long-Context Latent Diffusion (2023) (https://arxiv.org/pdf/2301.11757.pdf) | 利用latent diffusion的文本到音乐生成模型,类似Stable Diffusion原理。文本提示词被预训练模型编码为文本嵌入,然后用于生成latent embedding,然后训练diffuser和解码器转换为最终波形。demo (https://anonymous0.notion.site/anonymous0/Mo-sai-Text-to-Audio-with-Long-Context-Latent-Diffusion-b43dbc71caf94b5898f9e8de714ab5dc) github:archinetai/audio-diffusion-pytorch (https://github.com/archinetai/audio-diffusion-pytorch) |
Neural Codec Language Models are Zero-Shot Text to Speech Synthesizers (2023) (https://arxiv.org/pdf/2301.02111.pdf) | 文本转语音,而不是生成音乐。github:microsoft/unilm (https://github.com/microsoft/unilm) |
07
其他
除了以上内容,本章节补充一些虽然杂乱,但是比较有用/有趣的信息:
OpenAI Microscope(用来可视化模型中间层)
lucidrains有很多优质的代码:lucidrains (Phil Wang) · GitHub(https://github.com/lucidrains)
-End-
原创作者|仲崇禹
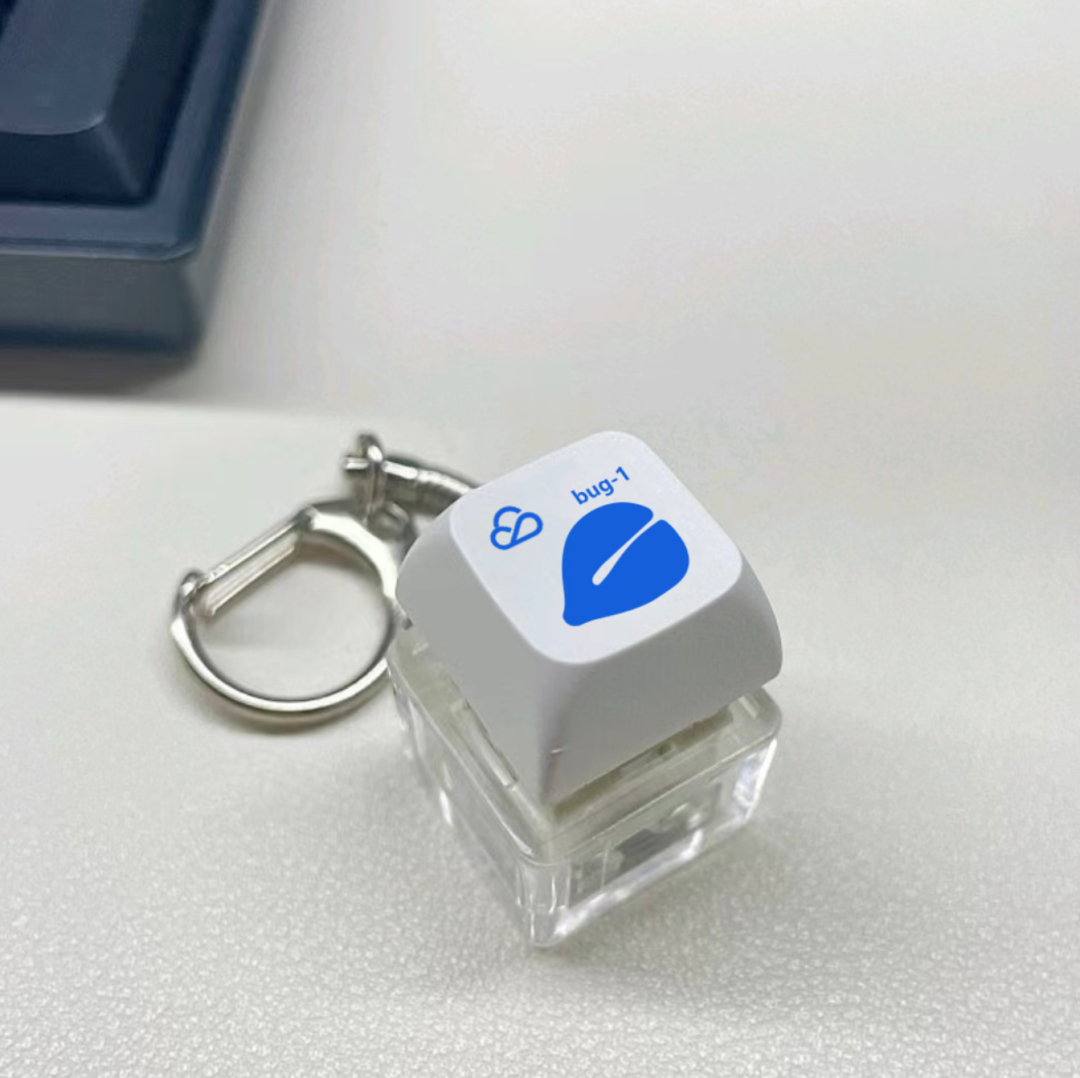
你还有哪些论文可以推荐?欢迎评论分享。我们将选取点赞本文并且留言评论的一位读者,送出腾讯云开发者定制发财按键1个(见下图)。11月6日中午12点开奖。
📢📢欢迎加入腾讯云开发者社群,享前沿资讯、大咖干货,找兴趣搭子,交同城好友,更有鹅厂招聘机会、限量周边好礼等你来~
(长按图片立即扫码)

 405


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


