python爬虫学习之路(3) urllib.error异常

python爬虫-urllib,urllib3库的使用 理解虚拟机的使用 由于服务器的开发往往是基于linux系统的,例如Ubuntu,Centos等等,所以如果我们是windows操作系统的个人电脑,利用虚拟机来进行相关后端的学习是非常有好处的,这里只陈述在开发时物理机和虚拟机的python文件的逻辑关系。 本地windows物理机需要有python解释器,pycharm; pycharm是对本地文件进行编辑的; 虚拟Ubuntu机需要有python... 阅读详情

urllib.error可以捕获有urllib.request产生的异常。urllib.error有两个方法,URLError和HTTPError。
URLError是OSError的一个子类,HTTPError是URLError的一个子类,服务器上HTTP的响应会返回一个状态码,根据这个HTTP状态码,我们可以知道我们的访问是否成功。例如200状态码,表示请求成功,再比如常见的404错误等。
下面我们来学习这两个异常:
一, URLError

from urllib import request
from urllib import error

if __name__ == '__main__':
    # 访问一部不存在的网站
    url = "http://www.bucunzai.com/"
    req = request.Request(url)
    # 捕获异常
    try:
        response = request.urlopen(req)
        html = response.read().decode("utf-8")
        print(html)
    except error.URLError as e:
        # 输出异常
        print(e.reason)

我们可以看见输出的结果是:
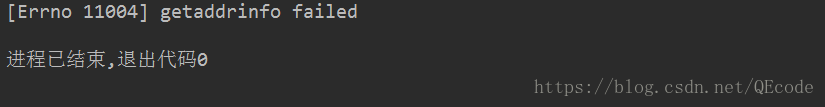
这里写图片描述

二, HTTPError
修改了捕获异常的的方法

from urllib import request
from urllib import error

if __name__ == '__main__':
    # 访问一部不存在的网站
    url = "http://www.douyu.com/Qcode.html"
    req = request.Request(url)
    # 捕获异常
    try:
        response = request.urlopen(req)
        html = response.read().decode("utf-8")
        print(html)
    except error.HTTPError as e:
        # 输出异常
        print(e.code)
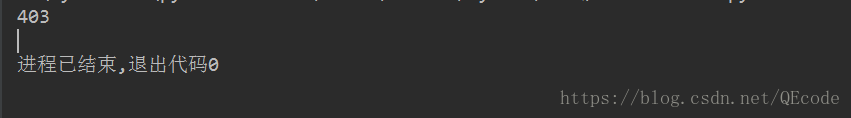
这里写图片描述

三, URLError和HTTPError混合使用
如果想用HTTPError和URLError一起捕获异常,那么需要将HTTPError放在URLError的前面,因为HTTPError是URLError的一个子类。如果URLError放在前面,出现HTTP异常会先响应URLError,这样HTTPError就捕获不到错误信息了。

四, 其他获取异常信息方法
使用hasattr函数判断URLError含有的属性,如果含有reason属性表明是URLError,如果含有code属性表明是HTTPError。

Python常用模块 之 urllib&&urllib3 【爬虫库】 阅读详情

相关推荐

轴承故障诊断——领域知识

幅域分析、频域分析及轴承方面的领域知识

qq_58516607的博客 3537

Python3网络爬虫(三):urllib.error异常

运行平台:Windows Python版本:Python3.x IDE:Sublime text3 转载请注明作者和出处:http://blog.csdn.net/c406495762/article/details/59488464

Jack-Cui 6万+

【重启后nvidia-smi 命令出现错误】

NVIDIA-SMI has failed because it couldn't communicate with the NVIDIA driver. Make sure that the latest NVIDIA driver is installed and running.

qq_44769377的博客 5217

urllib.error 简介

这是由模块引发的所有错误的基本类。它包括无效 URL、连接错误和超时等错误。这是URLError的子类,表示 HTTP 通信期间发生的错误。它包括 404 未找到、401 未授权和 500 内部服务器错误等错误。这是URLError的子类,表示检索 URL 时发生的错误。它包括内容太短、证书错误和重定向循环等错误。这是URLError的子类,表示打开 URL 时发生的错误。它包括文件未找到、权限被拒绝和不支持的方案等错误。这是URLError的子类,表示使用 HTTP 代理时发生的错误。

weixin_43765541的博客 690

经纬度转换为UTM坐标

UTM(通用横向墨卡托投影): 是一种以米为单位的坐标系统,用于地图和GPS导航。将地球划分为60个纵向的区域。每个区域宽6度,从赤道开始往南北两级方向划分。每个区域都有一个特定的字母。

weixin_45626706的博客 7282

100天精通Python(可视化篇)——第109天:Pyecharts绘制各种常用地图(参数说明+代码实战)

100天精通Python(可视化篇)——第109天:Pyecharts绘制各种常用地图(参数说明+代码实战)

努力让自己发光,对的人才能迎着光而来 8万+

python爬虫基础--3(urllib.error异常)

一.urllib.error urllib.error可以接收由urllib.request产生的异常。urllib.error有两个方法,URLError和HTTPError。 1.URLError from urllib import request from urllib import error if __name__ == "__main__": url = "http://...

qq_43109978的博客 302

嵌入式工程师必学(52):储能系统ESS

能量存储系统(ESS,Energystoragesystems)存在于各种各样的尺寸、形状和技术中。储能系统的技术,即基本的储能机制,自然会影响其重要特性,包括成本、安全性、性能、可靠性和寿命。然而,尽管基础技术很重要,但一个成功的储能项目依赖于对该技术的彻底和深思熟虑的实施,以实现项目的目标。成功的实施取决于储能系统的架构和组装情况。系统的体系结构可以决定其性能和可靠性,与它所使用的技术一致,甚至与之无关。

码农17年的博客 1444

【Python3 爬虫】03_urllib.error异常处理

urllib.error可以接受来自urllib.request产生的异常。urllib.error有两个方法:①URLError ②HTTPErrorURLErrorURLError产生的原因①网络无连接,即本机无法上网②连接不到特定的服务器③服务器不存在运行结果表明:连接超时HTTPErrorHTTPError是URLError的子类,在你利用URLopen方法发出一个请求时,服务器...

ajsyipsc40270的博客 473

用 ABAP 的 AMDP 把计算推到数据库:概念、场景、以及可运行示例

摘要:AMDP(ABAP Managed Database Procedures)是SAP HANA环境下优化ABAP性能的关键技术,通过将数据计算逻辑推送到数据库端执行,减少数据传输和应用层处理开销。其核心价值在于利用HANA的集合运算能力,适用于大数据量聚合、窗口函数等复杂计算场景。AMDP不是通用解决方案,而是针对CDS无法高效处理的特定性能瓶颈的优化手段。典型应用包括财务统计、零售分析等需要高性能数据处理的业务场景。本文通过概念解析、性能逻辑推导和实际代码示例(包括直接调用的AMDP Procedu

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 264

Android 埋点信息分析——statsd框架

StatsPullAtomService 用以采集数据,并将数据填充到参数中,在StatsManager.PullAtomCallbackInternal 中会转换成 Parcel 格式传入到 native。 StatsCallbackPuller::PullInternal 中会回调StatsManager.PullAtomCallbackInternal 的onPullAtom,该函数中会回调StatsCallbackPuller::PullInternal 中定义的PullResultRecei

私房菜 2631

python爬虫入门--urllib篇之urllib.error异常

urllib.error urllib.error异常可以接收urllib.request尝试的异常,urllib.error有两个方法,URLError和HTTPError如下图所示: URLError是OSError的一个子类,HTTPError是URLError的一个子类,服务器上HTTP的响应会返回一个状态码,根据这个HTTP状态码,我们可以知道我们的访问是否成功。常见的状态码200表...

北冥有鱼丶 1781

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

post 爬虫request_爬虫(七十三)urllib 的基本使用

爬虫(七十三)urllib 的基本使用​mp.weixin.qq.com从今天开始,从零开始将一些基础的,常用的一些开发包的使用情况,为我们搞正式的爬虫做一些准备工作,哈哈,有兴趣的可以跟着小编一起来学习啊我的电脑 win10, 我使用的环境是 anaconda3.7 版本,我们一起来看看 urllib目录的组成结构如下pycache :其实这个文件就是将相关 py 代码编译成 .pyc 文件,这...

weixin_39686230的博客 278

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

python3网络爬虫一《使用urllib.request发送请求》

python 爱好者交流群:810306356 这里有很多像你一样的伙伴,共同分享学习python的经验! 使用urllib 在Python2版本中,有urllib和urlib2两个库可以用来实现request的发送。而在Python3中,已经不存在urllib2这个库了,统一为urllib。Python3 urllib库官方链接 https://docs.pytho...

软件测试技术的博客 7万+

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

python网络爬虫实战教学——urllib的使用(2)

掌握urllib库中的异常处理和URL解析功能,对于进行网络编程和网页数据抓取来说是非常重要的。它们能够帮助我们编写更加健壮和灵活的程序,应对各种网络请求场景。

阿极的博客 9434

Python3.X网络爬虫学习(一)

刚刚研一,导师要求我开始学习Python网络爬虫,于是结合《精通Python网络爬虫:核心技术、框架与项目实战》和各种博客对比学习,开始真正接触网络爬虫。 关于Python的入门基础可以参考MOOC上的课程,简单易懂,也有相应的练习和资料,在此不加赘述。 我用的IDE是PyCharm,然后下载了Anaconda作为管理环境资源的工具。 一、什么是网络爬虫 网络爬虫又称网络蜘蛛、网络机器人等...

Apple_hzc的博客 908

【Python3网络爬虫】 urllib库的使用

1.库的作用,让我们在使用时不需要关心底层,不再需要关心怎么做,而是只需要关心做什么。2.urllib is a package that collects several modules for working with URLs:urllib.request for opening and reading URLsurllib.error containing the exceptions(例...

搬砖者也 1701

Python网络爬虫---urllib库介绍

·用途:urllib库是python的标准库之一,是python内置的HTTP请求库,用于发送HTTP/FTP请求,它可以看作处理URL的组件集合。·特点:简单易用,支持HTTP、HTTPS、FTP等协议。urllib.request是Python的标准库之一,用于发送HTTP请求。它提供了一个简单的接口来发送HTTP请求,并获取服务器的响应。以下是urllib.request的一些主要功能:1.打开和读取URLs:urllib.request模块提供了函数来打开和读取URLs。最常用的函数是urlopen

2301_77572709的博客 3038

urllib,urllib3,爬虫一般开发流程

urllib urllib是一个用来处理网络请求的Python标准库,包含四个模块 urllib.requests:请求模块,用于发起网络请求 urllib.parse:解析模块,用于解析URL urllib.error:异常处理模块,用于处理request引起的异常 urllib.robotparse:用于解析robots.txt文件 urllib.request模块 request...

xiaogeldx的博客 2625

Python网络爬虫(一) | urllib包基本使用教程

阅读目录urllib包 介绍1、urllib.request 模块1.1 urllib.request.urlopen()1.2 urlopen函数实例:2.1 urllib.request.Request()2.2 Request 函数实例2、urllib.error 模块1.1 urllib.error.URLError异常1.2 urllib.error.HTTPError异常3、urllib.parse 模块1.1 urllib.parse.urlparse()1.2 urlparse函数实例2..

go 1224

Python3网络爬虫:urllib.error异常

Python3网络爬虫:urllib.error异常一.urllib.errorurllib.error可以接收有urllib.request产生的异常。urllib.error有两个方法,URLError和HTTPError。如下图所示:URLError是OSError的一个子类,HTTPError是URLError的一个子类,服务器上HTTP的响应会返回一个状态码,根据这个HT...

Bruce小鬼 2175

python3网络爬虫

网络爬虫的定义 网络爬虫,也叫网络蜘蛛(Web Spider),如果把互联网比喻成一个蜘蛛网,Spider就是一只在网上爬来爬去的蜘蛛。网络爬虫就是根据网页的地址来寻找网页的,也就是URL。举一个简单的例子,我们在浏览器的地址栏中输入的字符串就是URL,例如:https://www.baidu.com/ URL就是同意资源定位符(Uniform Resource Locator),它的一般格式如下...

蜗牛的博客 444

Python爬虫之Urllib库的使用

一直以来,对urllib库的使用次数很少,初学时便是用的requests库。相比较而言,requests库功能更加强大而且使用起来也很简单,非常适合初学者学习。那么有人可能会问为什么还要了解urllib库呢?因为这是Python内置的HTTP请求模块,可以加深自己对爬虫和其它库的认知和理解,并且运行速度也比较快。当然使用上还是更加推荐requests,稍后会写一篇来介绍requests库。 本文只...

Steven的博客 4523
上一篇: python爬虫学习之路(2) 利用urllib爬取有道翻译的结果
下一篇: python爬虫学习之路(4) User Agent和代理IP
QEcode
博客等级 码龄10年 39粉丝 147原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值