Tensorflow 学习(一) DNN的前世今生(一)加源代码展示

深度学习编程笔记:tensorflow2.1案例实战---神经网络实现鸢尾花分类 # 利用鸢尾花数据集,实现前向传播、反向传播,可视化loss曲线 # 导入所需模块 import tensorflow as tf from sklearn import datasets from matplotlib import pyplot as plt import numpy as np import time ##1## # 导入数据,分别为输入特征和标签 x_data = d... 阅读详情

这篇博客呢,主要记录的是自己对DNN的理解,然后呢,还记录了一下比较前沿的DNN的理论 ELU,Dropout,动量法,RMSProp。反向传播算法呢,由于优快云上面街上的已经很多了,不在这篇的讨论范围之类,这篇博客主要参考的台大李宏毅的机器学习、以及DeepLearning 这本书吧。

我只是知识的搬运工 JXinyee,嘿嘿

在此附上李宏毅老师的个人主页,讲的非常非常好http://speech.ee.ntu.edu.tw/~tlkagk/courses_MLDS18.html

我们刚开始在使用深度学习的使用,大多数人用的都是手写数字识别这个数据集。而且这个手写数字识别大概需要3个隐藏层就能达到92%以上的准确率。但是随着时代进步,社会发展。如果你需要解决非常复杂的问题,例如语音识别中的上百种语言,无数多个单词该怎么办? 这时候就要训练更深的 DNN,也许有 10 层,每层包含数百个神经元,通过数十万个连接来连接。这就引入了梯度爆炸的问题了,如果你对此抱有怀疑,不妨看一下下面这个函数。
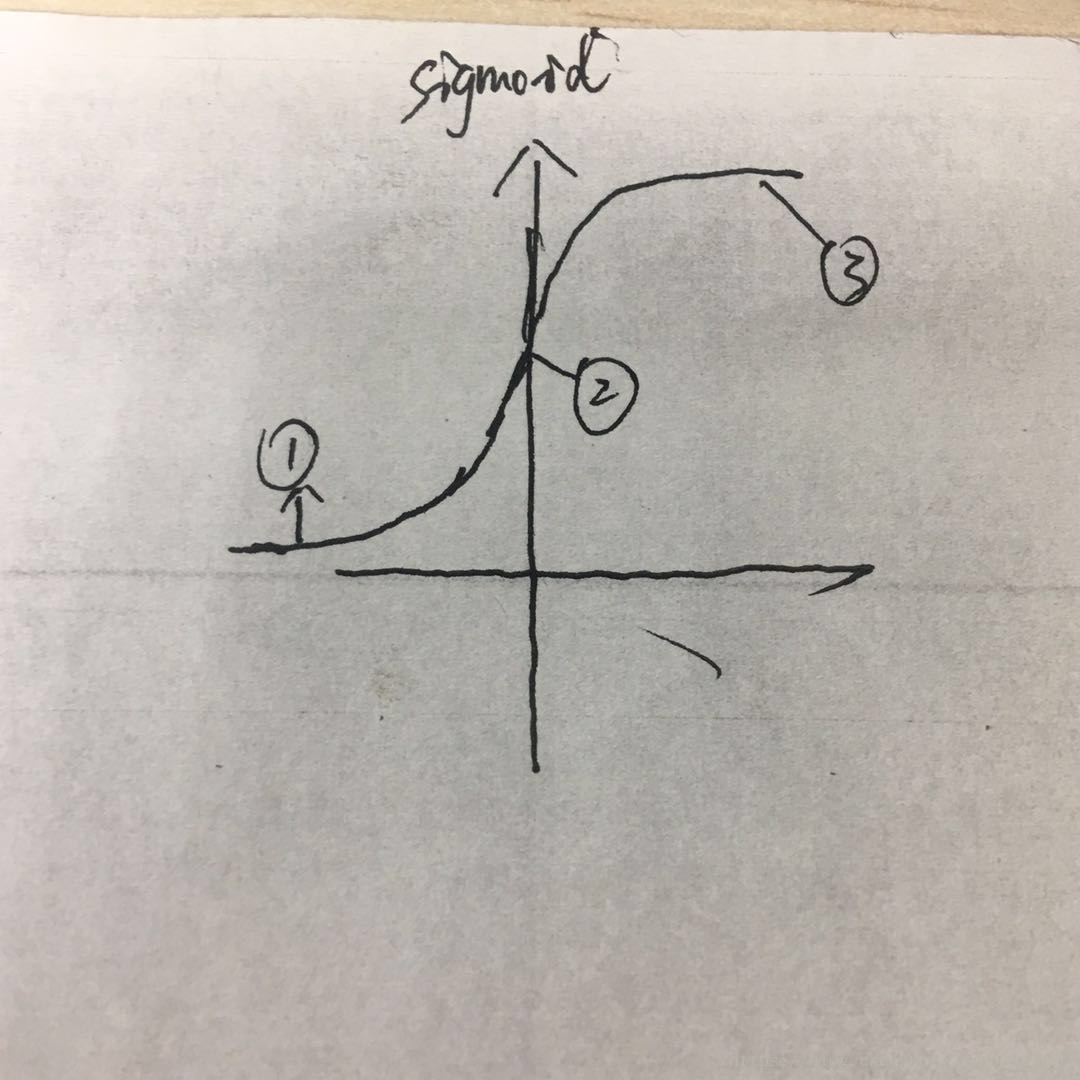
很长一段时间人们用sigmoid函数作为激活函数,人们认为这种连续性的函数似乎能模拟人的大脑神经元的活动,当然事实上,后来证明relu更好。

1 sigmoid 函数的y值 对应的都是正的,均值为0.5,这会让训练得到的方差随着层数递增不断加大,人们后来通过这个提出了tanh函数 均值为0,效果确实要好一些

2.如上图所示,函数上分别有1、2、3三个点当sigmoid函数的目标点是1的时候,但是你现在处于3这个位置时。你会发现从3用梯度下降多么多么的艰难,因为3的梯度接近于0,这也会出现,我们发现训练着训练着发现,越接近输入层的伸进网络的权重越发不动了,梯度似乎“消失”了,这会导致训练深层的神经网络,训练会非常缓慢,这也是一段时间内,神级网络臭名昭著的原因。

解决梯度消失的方法(Xavier初始化)

Glorot 和 Bengio 在2015年的一篇论文中认为,我们需要每层输出的方差等于其输入的方差。(这里有一个比喻:如果将麦克风放大器的旋钮设置得太接近于零,人们听不到声音,但是如果将麦克风放大器设置得太大,声音就会饱和,人们就会听不懂你在说什么。神经网络也是如此,我们既不希望权重在传递的过程中消失了,也不希望他爆炸饱和。

于是他们提出了一个公式:
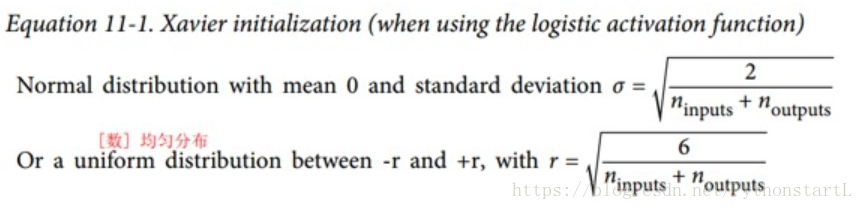
他们发现随机初始化连接权重必须如公式 11-1 所描述的那样。其中n_inputs和n_outputs是权重正在被初始化的层(也称为扇入和扇出)的输入和输出连接的数量。具体的证明公式,请看Glorot 和 Bengio 的论文。现在好多都是这么干的。

另外Glorot 和 Bengio 在 2010 年的论文中的一个见解是,消失/爆炸的梯度问题部分是由于激活函数的选择不好造成的。 在那之前,大多数人都认为,如果大自然选择在生物神经元中使用 sigmoid 激活函数,它们必定是一个很好的选择。 但事实证明,其他激活函数在深度神经网络中表现得更好,特别是 ReLU 激活函数,主要是因为它对正值不会饱和(也因为它的计算速度很快)。而且也很简单,这也是大自然的神奇之处,越简单的函数泛性反而越好。
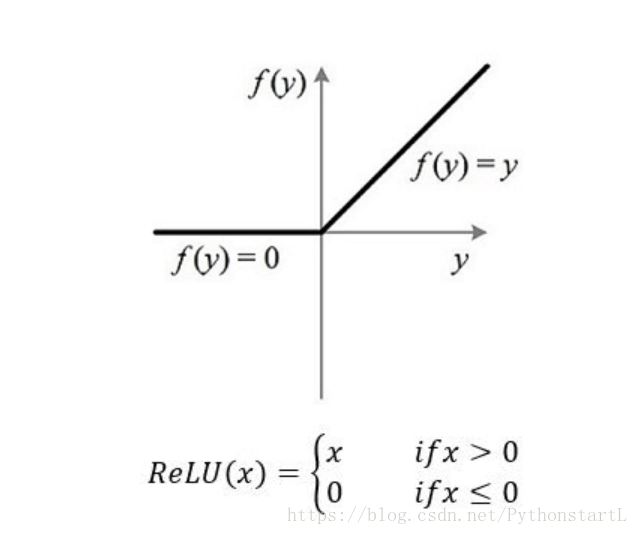
首先relu这个函数呢,我们可以看到求导非常的简单,而且是固定值,不会出现梯度消失的问题,在另一方面,relu能够更好的拟合函数,包括非常复杂的函数。拿李宏毅老师上课给的一个例子:
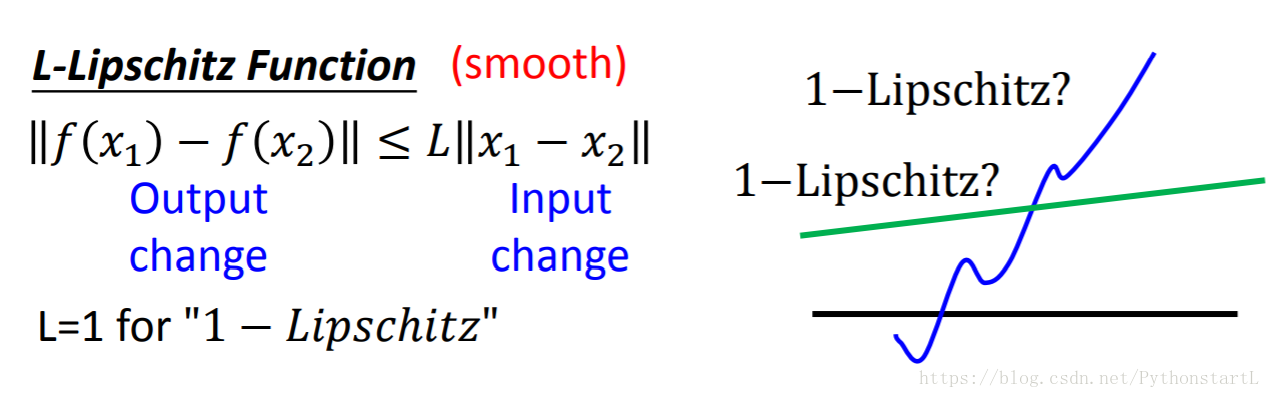
对于一个给定的函数f1,现在我们要找一个函数f2去拟合它,我们不妨假设这俩个


DNN(深度神经网络算法) 深度神经网络概念TensorFlow 成为最受欢迎的深度学习库,原因数据集tensorflow 读取数据通过feed_dict传递数据从文件中读取预加载的数据定义模型训练/学习评估模型 自从 1962 年 Rosenblat 提出感知机(Perceptron)以来,DNN 的概念就已经出现了,而自 Rumelhart、Hinton 和 Williams 在 1986 年发现了梯度下降算法后,DNN 的概念就变得可行了。直到最近 DNN 才成为全世界 AI/ML 爱好者和工程师的最爱。 一个算法出名后,它概念 阅读详情

相关推荐

Tensorflow:深度神经网络DNN预测波士顿房价(boston house price)【一】

刚学习TF,尝试拿sklearn的datasets来做下练习。波士顿房价数据是个不错的选择。 python3.5 tensorflow 0.12把所有的包import进来# coding: utf-8 import tensorflow as tf from sklearn.datasets import load_boston import matplotlib.pyplot as plt f

mvs2008的专栏 1万+

Tensorflow:深度神经网络DNN预测波士顿房价(boston house price)【二】

在Tensorflow:深度神经网络DNN预测波士顿房价(boston house price)【一】 中训练了网络还保存了模型。如何使用训练好的模型?请往下看。。import用到的包# coding: utf-8 import tensorflow as tf from sklearn.datasets import load_boston from sklearn.preprocessing i

mvs2008的专栏 8825

Tensorflow #3 使用DNN构造Iris分类器

1 前言这篇文章主要是根据Tensorflow官方的API文档整理得到的。 本文的主要目的是学习使用Tensorflow提供的机器学习API,构建一个基于神经网络的分类器,对经典的Iris分类数据进行分类。这里的高级API主要是指代tf.contrib.learn里提供的API,2 步骤首先这里说一下基本步骤: 从原始数据集的CSV里面读取数据,并且加载到Tensorflow当中 构建一个基于神经

MebiuW的专栏 2万+

Tensorflow实现DNN,手写数字识别

机器学习入门的时候,看吴恩达的视频,会有一个手写数字识别的作业,当时是用octave实现了核心的部分,之后了解了tensorflow,发现实现一个手写数字识别系统简直不要太简单,当时看的是这篇博客 ,清晰易懂。在此自己理清一下思路。注:代码参考这个博客 from tensorflow.examples.tutorials.mnist import input_data mnist = input...

qq_34806485的博客 3608

【深度学习】最强算法之:深度神经网络(DNN)

深度学习必会之:深度神经网络DNN

商务合作 | 面试培训 | 职场规划 ==>主页扫码 8177

tensorflow 搭建DNN网络

tensorflow 搭建DNN网络 tensorflow 搭建DNN, source code # -*- coding:utf-8 -*- # /usr/bin/python ''' @Author : Errol @Describe: @Evn : @Date : - ''' import tensorflow as tf import matplotl...

全网120W+关注AI拉呱,专注人工智能以及科技前沿! 730

GEE深度学习——使用Tensorflow进行神经网络DNN土地分类

这是地球引擎和 TensorFlow 演示笔记本。具体来说,本笔记本展示了以 TFRecord 格式从 Earth Engine 导出训练/测试数据。准备用于 TensorFlow 模型的数据。在 TensorFlow 中训练和验证一个简单的模型。对从地球引擎导出的 TFRecord 格式图像数据进行预测。将分类图像数据以 TFRecord 格式输入地球引擎。这旨在演示一个完整的输入/输出。有关使用顶点人工智能平台托管模型进行交互式预测的工作流程,请参阅本示例笔记本。

此星光明博客 1328

深度神经网络Python实现:DNN.py全解析

TensorFlow是由谷歌开发的开源机器学习框架,首个版本在2015年发布,迅速成为业界首选的深度学习平台。TensorFlow的设计理念是使模型的构建、训练和部署能够无缝进行,同时提供跨平台支持,包括桌面操作系统和移动设备。随着技术的演进,TensorFlow经历了多个版本的更新,尤其在2019年发布的TensorFlow 2.x,该版本引入了eager execution模式,使得编写代码的方式更接近传统的Python开发体验,极大地提升了易用性。

weixin_30591519的博客 1224

深度神经网络DNN多目标学习与源码实战项目

多目标学习并非简单地将多个损失函数相加求和,而是一种具有明确结构设计和优化逻辑的机器学习范式。其核心思想在于利用任务之间的相关性,通过共享部分模型参数来促进知识迁移,从而提升整体学习效率和泛化能力。相比传统的单任务训练模式,多目标学习更贴近人类认知系统的“举一反三”机制:例如视觉系统既能识别物体类别,又能估计距离、运动方向和遮挡状态,这些能力相互支持、共同演进。在深度神经网络中,这种协同学习过程可通过特定的网络拓扑结构和损失融合机制得以实现。

weixin_42443533的博客 884

图论:Dijkstra算法——最详细的分析,图文并茂,一次看懂!

Dijstra算法

普罗米修斯的博客 18万+

Xilinx FPGA中利用JTAG实现MicroBlaze调试信息输出

本文详细介绍了在Xilinx FPGA开发中,如何利用JTAG接口为MicroBlaze软核处理器实现调试信息输出的完整方案。通过配置调试模块、设置Vitis软件工程以及使用XSCT工具,开发者可以建立一条不依赖外部硬件的可靠调试通道,有效解决早期硬件验证阶段串口不可用的问题,大幅提升调试效率。

weixin_29201859的博客 292

C# 实现文件和字符串的AES加密解密

C# 实现文件和字符串的AES128加密解密

m0_72044573的博客 5938

程序员实战:DINOv3 权重文件下载与本地化部署全流程指南

Meta开源的DINOv3视觉大模型凭借70亿参数和17亿图像训练,在语义分割、目标检测等任务表现优异。本文详解预训练权重的获取渠道、校验方法和加载实践。开发者可通过HuggingFace或GitHub获取不同版本权重,包括针对服务器端的ViT系列和边缘设备的ConvNeXt系列。文章提供MD5校验代码确保文件完整性,并给出PyTorch和Transformers两种加载方式。特别强调7B模型需16GB GPU内存,建议根据硬件条件选择合适版本,如边缘设备使用ConvNeXt-Tiny。最后指出DINOv3

xiugou3365的博客 5911

NAT反向代理技术的实现(外网访问内网)

NAT反向代理技术的实现(外网访问内网)(版权所有,引用 请联系作者,注明出处) NAT技术是网络中的重要应用之一。当有一个场景:内网搭建了服务器,需要外网访问时,可以借助NAT映射来实现。如:单位建立了一个Web服务器,我们希望在员工回家之后,依然可以访问到它,那怎么实现呢? 下面的拓扑图,就用来示范这个应用反面场景的实现过程。 一、题目要求: 地址配置如图。使用静态路由: 1、配置右侧交换机2950T,实现单臂路由; 2、配置路由使网络连通; 3、配置NAT访问,实现外网对风网服务器的

joyousmime的博客 8491

Arch Linux双系统安装避坑指南:从Windows分区到桌面环境全流程

本文提供了一份详尽的Arch Linux与Windows双系统安装避坑指南。内容涵盖从安装前的UEFI环境确认、BitLocker处理、分区规划,到Live环境进入、基础系统安装、GRUB引导配置,再到显卡驱动安装、KDE/GNOME桌面环境部署及中文化设置的全流程。重点解决了双系统安装中的核心痛点,帮助用户在不破坏现有Windows系统的前提下,顺利完成Arch Linux的安装。

nice1的博客 536

从开源到落地:SimpleBGC 三轴稳像平台全栈技术解析(上)

SimpleBGC是一款开源的稳定云台控制系统,相比专业设备具有显著的价格优势(仅为1/5-1/10),采用模块化设计支持全场景适配。系统包含硬件设计、软件代码和算法三大核心:硬件采用STM32主控和IMU传感器,支持6步换向和FOC电机驱动;软件采用三层架构(驱动层、算法层、应用层),实现姿态解算和PID控制;算法方面提供互补滤波(基础版)和卡尔曼滤波(高端版),可达到±0.5°至±0.1°的稳定精度。该系统适用于无人机航拍、工业检测等多种应用场景,特别适合DIY开发者和中小企业进行定制化开发。

bother3000的博客 3689

超临界二氧化碳发电技术深度解析

超临界二氧化碳发电技术正在突破传统热电转换的物理边界。作为新一代发

硬核科技 602

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

上一篇: python 装饰器的运用 在剑指offer中的运用
下一篇: 用sklearn做一个完整的机器学习工程——以波士顿房价预测为例。(一、用自定义转换器、Pipeline Feature_Union做特征工程)
PythonstartL
博客等级 码龄9年 31粉丝 16原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值