ViT原理及用法

ViT结构详解(附pytorch代码) ViT详解 阅读详情

ViT原理及用法

ViT简介

ViT是Vision Transformer的缩写,它是一种基于Transformer架构的模型,用于处理图像识别任务。Transformer最初是在自然语言处理(NLP)领域提出的,特别是在语言模型和机器翻译任务中取得了巨大成功。ViT将Transformer的思想扩展到了计算机视觉领域。

ViT的基本原理

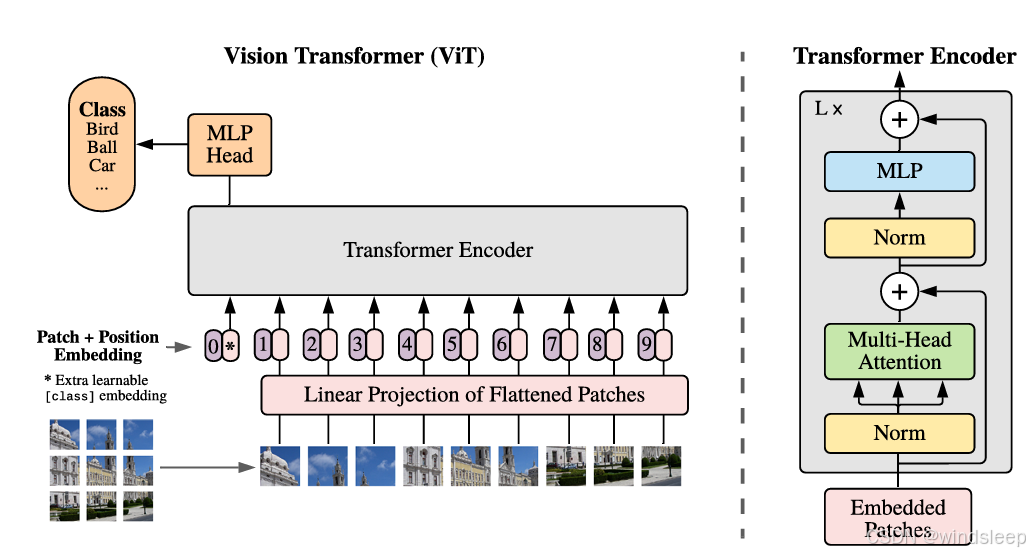
ViT将输入图像转换为一个序列化的表示形式。通过将图像分割成多个固定大小的小块(patches),然后将每个patch线性投影到一个D维的嵌入空间来实现。
ViT

  1. Patch Embedding:
  • 与卷积神经网络(CNN)不同,ViT不直接处理原始像素值。它首先将输入图像划分为多个小块(称为"patches")。
  • 每个patch通过一个线性层(即全连接层)被转换成一个D维的特征向量。这一步将图像的二维空间信息转换为一维序列数据。
  1. Class Token:
  • 类似于在Transformer模型中的[CLS] token,ViT引入了一个特殊的类别token,它与图像patches的嵌入向量一起输入到模型中。这个token的最终状态将被用作分类任务的表示。
  1. Positional Encoding:
  • 与Transformer在NLP中使用位置编码类似,ViT向每个patch嵌入向量添加位置编码,以保持序列中每个patch的位置信息。位置编码通常使用正弦和余弦函数的组合来生成,确保模型能够理解图像中的空间结构。
  1. Multi-head Self-Attention:
  • 与NLP中的Transformer相同,ViT使用多头自注意力机制来捕捉不同位置之间的依赖关系。
  • 每个头学习图像的不同子空间表示,增强了模型捕获全局上下文的能力。
  1. Value(V)、Key(K)、Query(Q)的计算:
  • 在自注意力层中,模型会为输入序列的每个元素计算K、V和Q。这些计算是通过线性层完成的,然后通过这些向量计算注意力权重,这些权重决定了在生成输出序列时每个元素对其他元素的影响程度。
  1. Feed-Forward Networks:
  • 在自注意力层之后,ViT使用前馈神经网络(FFN)来进一步处理特征。
  1. Layer Normalization and Residual Connections:
  • 与Transformer一样,ViT在每个子层(自注意力和FFN)之后使用层归一化(Layer Normalization)和残差连接(Residual Connections),以促进深层网络的训练。
  1. Pooling:
  • 与CNN中的池化操作不同,ViT不使用固定的池化策略。相反,它可以通过不同的方式(如全局平均池化或通过类别token)来聚合特征。

ViT模型在多个视觉识别任务上表现出色,包括图像分类、目标检测和图像分割等。ViT的成功证明了Transformer架构不仅适用于序列数据,也能够处理具有空间结构的图像数据。

ViT的原始论文名:An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale
链接:https://arxiv.org/pdf/2010.11929

ViT( Vision Transformer)详解 VIT详解:( Vision Transformer):也希望大家Attention all you need。 阅读详情

相关推荐

VIT模型个人笔记

前言 VIT模型即vision transformer,其想法是将在NLP领域的基于自注意力机制transformer模型用于图像任务中,相比于图像任务中的传统的基于卷积神经网络模型,VIT模型在大数据集上有着比卷积网络更强的效果和更节约的成本。 transformer transformer模型 ...

qq_45836365的博客 1万+

【Transformer系列】深入浅出理解ViT(Vision Transformer)模型

【Transformer系列】深入浅出理解ViT(Vision Transformer)网络模型

IT菜鸟 6万+

Transformer Mask机制详解:从原理到BERT/GPT/ViT实战应用

在深度学习与自然语言处理领域,注意力机制是Transformer架构的核心组件,它通过计算序列元素间的关联权重实现信息交互。然而,原始注意力计算存在信息泄露风险,例如在语言模型训练中模型可能‘偷看’未来答案。为解决此问题,Mask机制应运而生,其本质是在注意力计算过程中引入遮罩矩阵,通过加法或乘法操作控制信息流向。这一技术价值在于确保了模型训练的因果性,防止未来信息泄露,同时支持可变长度序列的批处理。在工程实践中,Mask机制广泛应用于三大场景:编码器中的Padding Mask处理序列填充、解码器中的Ca

weixin_29038537的博客 340

Visual Transformer (ViT)模型详解

ViT是2020年Google团队提出的将Transformer应用在图像分类的模型,虽然不是第一篇将transformer应用在视觉任务的论文,但是因为其模型“简单”且效果好,可扩展性强(scalable,模型越大效果越好),成为了transformer在CV领域应用的里程碑著作,也引爆了后续相关研究。

十年以上架构设计经验,专注于软件架构和人工智能领域,对机器视觉、NLP、音视频等领域都有涉猎 9万+

别再瞎调了!Llamafactory的lora_targets参数详解:如何精准微调VIT、LLM和Llama Pro的不同模块

本文深入解析Llamafactory框架中的`lora_targets`参数,指导如何精准微调VIT、LLM和Llama Pro的不同模块。通过差异化微调策略,显著降低显存消耗并提升模型性能,适用于视觉语言模型和复合模型的轻量级调整。

weixin_33724046的博客 396

ViT基本原理,图像预训练

ViT作者团队出品,在CNN和Transformer大火的背景下,舍弃了卷积和注意力机制,提出了MLP-Mixer,一个完全基于MLPs的结构,其MLPs有两种类型,分别是和,前者独立作用于image patches(融合通道信息),后者跨image patches作用(融合空间信息)。实验结果表明该结构和SOTA方法同样出色,证明了convolution和attention不是必要操作,如果将其替换为简单的MLP,模型依然可以完美work。

AI生成式技术曾小健 5399

你的AI还在单模态硬撑?多模态架构焊死「多模态大模型」,从ViT到LLM融合架构一篇打通

用自有业务数据微调,适配特定视觉任务。"""视觉指令微调的数据格式——和纯文本微调完全不同"""sample = {"value": "<image>\n提取这张发票的金额、日期、税号。},# ⚠️ 关键:<image>占位符必须放在conversation里,不是外面# 微调时只训投影层+LLM的LoRA,冻结ViT(别动眼睛)# 训坏了眼睛,整个模型就瞎了"""训练配置原则:- ViT: frozen (学习率=0)

2601_96614951的博客 274

【原理+源码详细解读】从Transformer到ViT

文章目录参考文献简介Transformer架构Position EncodingSelf-attentionMulti-head Self-attentionMasked Multi-Head Self-attentionLayer NormalizationFeed Forward NetworkEncoder LayerEncoderDecoder LayerDecoder总体流程ViT流程图片分块Patch EmbeddingClass TokenPosition EncodingTransforme

weixin_43441742的博客 1457

轻松理解ViT(Vision Transformer)原理及源码

轻松理解ViT(Vision Transformer)原理及源码

qq_17027283的博客 3871

ViT原理与代码实例讲解

ViT原理与代码实例讲解 作者:禅与计算机程序设计艺术 / Zen and the Art of Computer Programming / TextGenWebUILLM ViT原理与代码实例讲解 关键词:ViT原理,图像识别,Vision Transformer

AI天才研究院 1092

一文带你弄懂thermal governor IPA

当current temp < target temp时,使用k_pu,当current temp >= target temp时,使用k_po。如果current_temperature = switch_on_temp时,则k_p = k_pu,这时Pmax。如果current_temperature = target_temp时,则k_p = k_po,这时Pmax。2、解析dts,获得switch_on_temp和target_temp。3、初始化k_pu/k_po/k_i/k_d的常数。

yxw0609131056的博客 1245

详解VIT(Vision Transformer)模型原理, 代码级讲解

详解VIT(Vision Transformer)模型原理, 代码级讲解

qq_43449643的博客 1万+

网络系统实现技术之IPX与SPX

IPX/SPXNovell NetWare网络Novell公司为适应网络发展,将主机网络转换为PC网络,开发了Novell NetWare网络系统。该系统中基于客户机/服务器模式。以普通PC机做为客户机,以性能强大的服务器做为服务器,为客户机提供文件服务、数据库服务及其他服务。与前面的SNA模型一样,Novell NetWare也早于OSI模型,所以不能与OSI模型严格对应,但也有很明

成片的大树 9164

VIT里面的patch是怎么生成的,原理是什么

将图像划分为固定大小的 Patch(P×P将每个Patch 展平为 1D 向量。通过线性变换将1D 向量嵌入到 Transformer 的输入维度 DDD。这种方法的核心思想是将图像从 2D 表示转化为 1D 的序列表示,从而使 Transformer 模型能够处理图像数据。相比 CNN,ViT 的 Patch 生成更简单直接,但依赖于 Transformer 的全局建模能力。Patch 的大小和嵌入维度是 ViT 的关键超参数,会显著影响模型的性能和计算复杂度。为什么每一个patch是一个p。

zengxiaojian2的博客 1972

ESP32S3编译micropython固件

编译ESP32芯片的micropython固件

m0_73253860的博客 2553

DBeaver连接IoTDB避坑指南:手动配置JDBC驱动的完整流程(附问题排查)

本文提供了在DBeaver中手动配置Apache IoTDB JDBC驱动的完整流程与避坑指南。详细解析了从驱动创建、库文件添加(关键是指向整个lib目录)到连接测试的每一步,并重点针对常见的ClassNotFoundException、连接拒绝等错误提供了深度排查方案,帮助用户高效建立图形化管理连接。

weixin_28327051的博客 395

CV攻城狮入门VIT(vision transformer)之旅——VIT原理详解篇

​  在上一篇,我已经详细为大家介绍了NLP邻域中的,足足写了10000+字,酝酿了好多天才下笔,也写了很久,自认为写的还算是通俗全面。如若你对Transformer还没什么了解,建议你点击☞☞☞了解详情。​  其实,作为CV程序猿的我们,学习NLP邻域的Transformer更像是被迫之举,毕竟现在基于Transformer的算法在CV邻域可谓是大杀特杀。那么今天我就为大家带来将Transformer引入到视觉物体分类中的一篇文章,标题为download📥📥📥。

秃头小苏的博客 6871

风控要略-互联网业务反欺诈之路(一)

当前中国互联网安全产业答题可以分为基础安全和业务安全两个领域。从互联网诞生至2014年,互联网安全行业关注的热点基本都聚焦在网络安全、系统安全和应用安全这个三大基础安全领域上,“DDOS“(分布式拒绝服务攻击)1、“漏洞“、“拖库“2和“挂马“3等大家耳熟能详的术语也是从这些领域中衍生出来的。2014年前后,随着互联网业务的爆炸式发展,黑产团伙开始从“攻击渗透系统“的传统套路进化到“利用业务风控确实进行大规模牟利“的模式,并且逐渐形成规模庞大、分工明确的黑色产业链。

Despacito1006的博客 1012

全网最强ViT (Vision Transformer)原理及代码解析

今天我们来详细了解一下Vision Transformer。基于timm的代码。 1. Patch Embedding Transformer原本是用来做NLP的工作的,所以ViT的首要任务是将图转换成词的结构,这里采取的方法是如上图左下角所示,将图片分割成小块,每个小块就相当于句子里的一个词。这里把每个小块称作Patch,而Patch Embedding就是把每个Patch再经过一个全连接网络压缩成一定维度的向量。 这里是VisionTransformer源代码中关于Patch Em...

fulva的专栏 2万+

【异常】SpringCloud Gateway报错503 SERVICE_UNAVAILABLE “Unable to find instance for xxx-gen“

网关服务报错,如下。

奶爸的编程之路,也就一周冷个三天 4224

R语言深度学习实战:基于YOLO的目标检测

目标检测是计算机视觉领域的一项任务,旨在识别图像或视频中的物体,并确定它们的位置。与图像分类不同,目标检测要求模型能够识别多个物体,并为每个物体提供边界框(bounding box)的位置信息。这种任务在众多应用中都具有重要价值,例如自动驾驶、安防监控、物体跟踪等。YOLO(You Only Look Once)是一种非常流行的目标检测算法,它在速度和准确性之间取得了良好的平衡。与传统的目标检测方法不同,YOLO将目标检测任务视为回归问题,直接从输入图像中预测目标的类别和位置信息。

YOLO 330

ViT(vision transformer)原理快速入门

本专题需要具备的基础: 了解深度学习分类网络原理。 了解2017年的transformer。 Transformer 技术里程碑: ViT简介 时间:2020年CVPR 论文全称:《An Image is Worth 16*16 Words: Transformers for Image Recognition at Scale》 发明人:谷歌团队 简介:论文中提出了 Vision Transformer (ViT),能直接利用 Transformer 对图像进行分类,而不需要卷.

不精,不诚,不足以动人 2万+

IgH EtherCAT 从入门到精通:第 30 章 实战:高可用 EtherCAT 系统设计

摘要:构建高可用EtherCAT系统的关键技术 本章详细介绍了工业级EtherCAT系统的高可用性设计方法,主要包括: 冗余链路架构:采用双网卡环形拓扑设计,主备网卡同时工作,通过IgH Master的冗余配置实现线缆故障自动切换。 状态监控机制:提供专用API实时监控主备链路状态,包括从站响应数、链路状态和冗余激活标志,形成完整的故障判断矩阵。 自动恢复功能:系统内置FSM架构支持热插拔自动检测和重配置,从站断线/重连时可自动完成状态恢复,同时允许应用层实施安全措施。 这些技术共同构成了生产环境下Ethe

从事嵌入式linux android驱动开发,拥有全栈能力 243

【ViT系列(2)】ViT(Vision Transformer)代码超详细解读(Pytorch)

ViT(Vision Transformer)代码超详细解读

路人贾的博客 1万+

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

Vision Transformer (ViT) 核心原理详解与应用解析

模型最初是为自然语言处理(NLP)任务而提出的,尤其是在序列建模任务上(如机器翻译、文本生成等)表现出色。Transformer 的核心机制是自注意力机制(Self-Attention),它可以高效地捕获序列中任意位置之间的依赖关系。与循环神经网络(RNN)不同,Transformer 并不依赖于顺序处理,这让它在处理长距离依赖时更加高效。由于其并行化的特性,Transformer 成为 NLP 领域的主流模型。的关键创新在于将 Transformer 引入到计算机视觉任务中,特别是图像分类任务。

hello.reader 4951

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

上一篇: nvidia-smi命令详解
下一篇: RNN Encoder-Decoder
风眠玄清
博客等级 码龄7年 21粉丝 8原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值