Python网络爬虫教程:轻松掌握数据采集!

Python爬虫基础教程(65)Python Scrapy爬虫框架实战:获取音悦台榜单之目标分析:Scrapy爬虫秘籍:轻松抓取音悦台榜单,让你的数据采集六到飞起! 你是否曾想过,只需几行代码就能轻松获取音悦台最新最热的MV榜单数据?今天,我们将一起探索如何使用Python的Scrapy框架,快速抓取音悦台榜单信息,让你的数据采集工作事半功倍! 阅读详情

包含编程籽料、学习路线图、爬虫代码、安装包等!【点击领取】

在这里插入图片描述

在当今大数据时代,数据采集成为了许多项目的核心环节。Python凭借其丰富的库和简洁的语法,成为了网络爬虫开发的首选语言。本文将带你从零开始,轻松掌握Python网络爬虫的基本技能,并通过详细的代码示例,帮助你快速上手数据采集。

目录
1.网络爬虫简介

2.环境准备

3.基本爬虫实现

4.数据解析与存储

5.高级技巧与反爬虫策略

6.实战案例

1. 网络爬虫简介
网络爬虫(Web Crawler)是一种自动化程序,用于从互联网上抓取数据。它可以模拟浏览器行为,访问网页并提取所需的信息。常见的应用场景包括搜索引擎索引、数据挖掘、价格监控等。

2. 环境准备
在开始编写爬虫之前,我们需要安装一些必要的Python库。常用的库包括requests、BeautifulSoup、lxml和pandas。

在这里插入图片描述

在这里插入图片描述

3. 基本爬虫实现
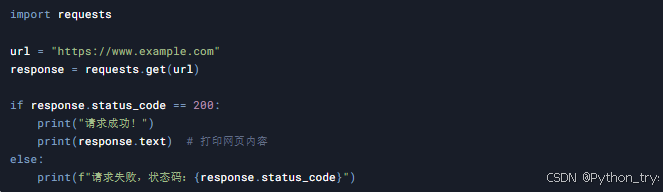
3.1 发送HTTP请求
首先,我们需要使用requests库发送HTTP请求,获取网页内容。
在这里插入图片描述

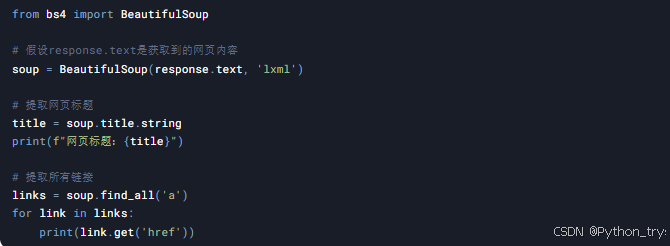
3.2 解析HTML内容
获取到网页内容后,我们需要解析HTML,提取出有用的信息。这里我们使用BeautifulSoup库。
在这里插入图片描述

4. 数据解析与存储
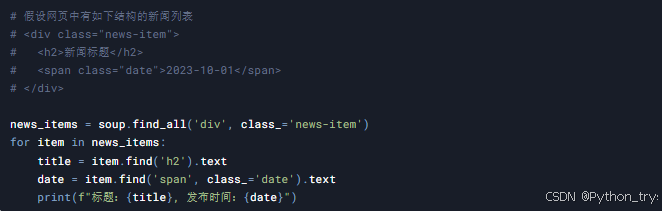
4.1 提取结构化数据
通常我们需要从网页中提取特定的结构化数据,例如新闻标题、发布时间等。
在这里插入图片描述

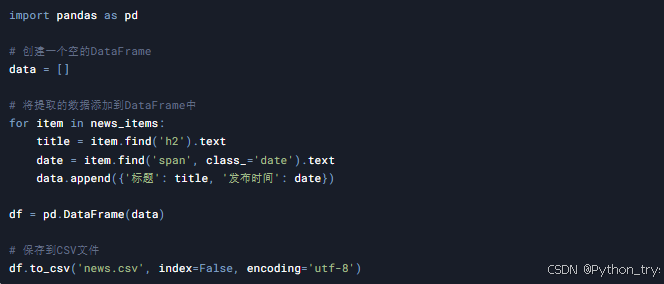
4.2 存储数据
我们可以将提取到的数据存储到CSV文件中,方便后续分析。
在这里插入图片描述

5. 高级技巧与反爬虫策略
5.1 处理动态加载内容
有些网页使用JavaScript动态加载内容,直接使用requests无法获取到这些内容。这时可以使用Selenium模拟浏览器行为。
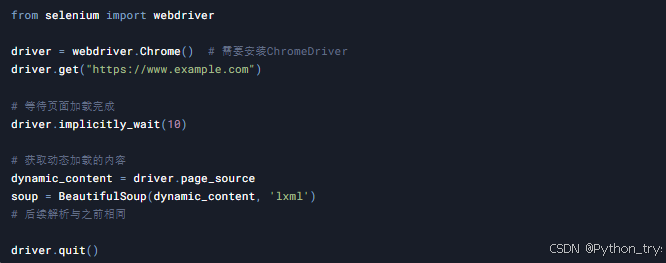
在这里插入图片描述

5.2 应对反爬虫策略
许多网站会设置反爬虫机制,如IP封禁、验证码等。我们可以通过以下方法应对:

设置请求头:模拟浏览器请求。

使用代理IP:避免IP被封禁。

降低请求频率:避免触发反爬虫机制。
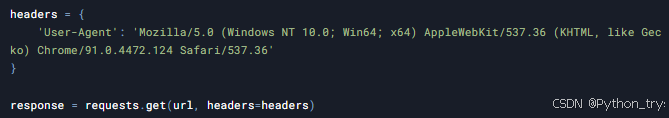
在这里插入图片描述

6. 实战案例
6.1 爬取豆瓣电影Top250
我们以爬取豆瓣电影Top250为例,综合运用前面所学的知识。
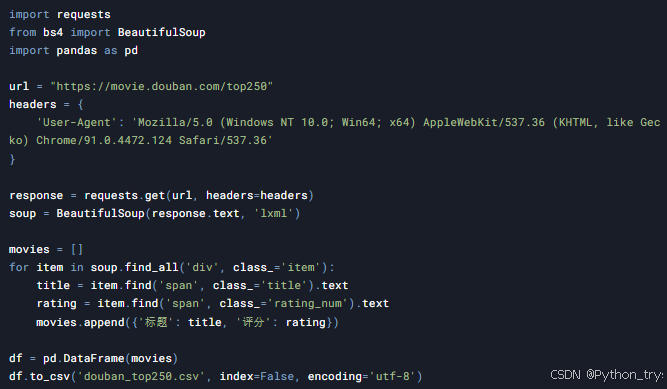
在这里插入图片描述

结语
通过本文的学习,你已经掌握了Python网络爬虫的基本技能,并能够进行简单的数据采集。在实际项目中,你可能会遇到更复杂的情况,但万变不离其宗,掌握了基础,再复杂的爬虫也能应对自如。

希望这篇教程对你有所帮助,如果你有任何问题或建议,欢迎在评论区留言!

最后:
希望你编程学习上不急不躁,按照计划有条不紊推进,把任何一件事做到极致,都是不容易的,加油,努力!相信自己!

文末福利
最后这里免费分享给大家一份Python全套学习资料,希望能帮到那些不满现状,想提升自己却又没有方向的朋友,也可以和我一起来学习交流呀。

包含编程资料、学习路线图、源代码、软件安装包等!【点击这里领取!】
① Python所有方向的学习路线图,清楚各个方向要学什么东西
② 100多节Python课程视频,涵盖必备基础、爬虫和数据分析
③ 100多个Python实战案例,学习不再是只会理论
④ 华为出品独家Python漫画教程,手机也能学习

在这里插入图片描述

使用 Python 编写网络爬虫:从入门到实战 网络爬虫是一种自动化程序,通过模拟浏览器的行为向网络服务器发送 HTTP 请求,获取网页内容并进一步提取所需信息的过程。网络爬虫主要用于数据采集、信息监控、搜索引擎等领域,为用户提供更便捷、全面的数据检索服务。发送 HTTP 请求:模拟浏览器向目标网站发送请求,获取网页内容。解析网页内容:使用解析库解析 HTML 或其他标记语言,提取所需信息。处理信息:对提取的信息进行处理、存储或进一步分析。循环操作:根据需求循环执行上述步骤,实现自动化的数据采集和处理。 阅读详情

相关推荐

Python 网络爬虫进阶:突破数据采集的边界

在成功踏入 Python 网络爬虫的入门之境后,我们犹如初窥宝藏的探险家,领略到了数据采集世界的奇妙与潜力。而此刻,进阶之路在脚下徐徐展开,它将引领我们深入这片领域的更深处,挖掘出更为强大和精妙的爬虫技艺,去征服那些更为复杂和富有挑战性的数据高峰。

m0_74620645的博客 3206

python爬虫入门教程(一):开始爬虫前的准备工作

python爬虫(数据采集)入门教程

笔墨留年。 8万+

Python 网络爬虫的应用

Python网络爬虫作为一种强大的自动化工具,在多个领域展现了广泛的应用潜力。从数据采集到舆情监控,从市场研究到金融分析,Python爬虫为各行各业提供了高效的数据获取和处理手段。然而,在实际应用中,开发者需注意遵守法律法规,合理使用技术,并克服反爬机制带来的挑战。随着互联网技术的不断发展,Python网络爬虫的应用前景将更加广阔。

kcarly的专栏 1439

Python 网络爬虫教程:从入门到高级的全面指南

网络爬虫是自动访问互联网并提取信息的程序。它可以用于数据采集、市场分析、学术研究等多种场景。简单来说,网络爬虫就是模拟用户在浏览器中的行为,获取网页内容。本文详细介绍了 Python 网络爬虫的基础知识、实现步骤及实战案例。随着技术的不断发展,网络爬虫的应用场景也在不断扩大。未来,你可以结合机器学习等技术,进一步提升数据分析能力。

孤客科技 9013

Python 网络爬虫入门与实战

网络爬虫(Web Crawler)是自动访问网络并提取信息的程序。它可以模拟人类用户在浏览器中的行为,访问网页、抓取数据并存储到本地或数据库中。网络爬虫在信息检索、数据挖掘、搜索引擎等领域有广泛应用。Scrapy 是一个强大的爬虫框架,支持异步处理和数据存储。它适合大型爬虫项目,可以高效抓取和解析数据。yield item通过本文的学习,您应该对 Python 网络爬虫有了全面的了解。从基础的 Requests 库到高级的 Scrapy 框架,再到实战案例,涵盖了网络爬虫的方方面面。

985工科博士毕业,专攻定位、导航和滤波等算法研究。从业10年,主要使用MATLAB 2212

Python网络爬虫编程实战

本文还有配套的精品资源,点击获取 简介:Python语言因其简洁易学,是网络爬虫开发的理想选择。网络爬虫广泛用于数据分析、信息挖掘等领域。本课程将从基础开始,指导如何使用Python中的requests、BeautifulSoup、Scrapy等库来实现网络爬虫,以及处理一些高级话题如反爬机制、异步请求和数据存储。学生将通过实践学习构建高效、可控的爬虫。 1. P...

weixin_34618526的博客 2053

Python 网络爬虫入门:开启数据采集之旅

网络爬虫,也称为网页蜘蛛,是一种按照一定规则自动抓取互联网信息的程序或脚本。它能够模拟人类在浏览器中的操作,访问网页、解析页面内容,并提取出我们感兴趣的数据,如文本、图片、链接等。例如,当我们想要收集某电商平台上特定商品的价格信息、用户评价,或者获取新闻网站的新闻标题和正文时,网络爬虫就可以派上用场。它可以在短时间内遍历大量的网页,将分散的数据集中起来,为后续的处理和分析提供素材。

m0_74620645的博客 3584

MOSFET和IGBT栅极驱动器电路的基本原理学习(2)

1.PWM直接驱动 驱动主开关晶体管栅极的最简单方法是利用 PWM 控制器的栅极驱动输出,如图 (1)如 图 8中所示,PWM 控制器和 MOSFET 之间可能有较大距离。由于栅极驱动和接地环路迹线形成的环路,这个距离形成了寄生电感,从而降低了开关速度,并导致栅极驱动波形中形成振铃。为了降低与栅极驱动连接相关的电感,需要更宽的 PCB 迹线。 (2)直接栅极驱动的另一个问题是PWM 控制器的驱动电流能力有限。极少有集成电路能提供高于 1A 的峰值栅极驱动能力。 2.旁路电容的确定 (1)位置 如果是独立的

weixin_43732932的博客 5830

Python网络爬虫详解:实战豆瓣电影信息采集

随着互联网的迅猛发展和数据分析需求的不断增加,网络爬虫成为了一项重要的技术。通过网络爬虫,用户可以自动化地从互联网获取大量数据,从而实现各种数据分析、市场调查等目标。本文将介绍什么是爬虫,以及在爬虫开发中经常用到的一些Python库和其作用,并展示一个简单的爬虫实现步骤。通过本篇博客,我们学习了如何使用Python进行网络爬虫。首先,我们介绍了爬虫的基本概念和工作流程,然后详细介绍了常用的爬虫库及其作用。通过一个具体的示例演示了从环境准备、数据采集、数据处理到数据存储的全过程。

Huahua_1223的博客 2748

A-Level CS 计算机科学 考试知识点——考试介绍&第1章

前言:该系列文章是本人在给学生辅导本课程的过程中结合英文教材所总结的,该系列共分为30章,主要介绍了考试的核心知识点。若需要A-Level CS 计算机科学考试辅导也可以私信我。 目录 关于A-Level CS 计算机科学考试 考试简介 考试内容 考试时间 评分情况 第1章 信息表示 本章学习内容 1.01 数字系统 1.02 数字的内部编码 整数编码(Coding for integers) 二进制编码的十进制(Binary coded decimal——BCD) 1.03.

王俊的博客 6454

mtk-drm初始化

mtk-drm初始化走读

zhexingsunba的博客 4928

《Python 网络爬虫》

本文介绍了 Python 网络爬虫的基本概念、技术原理、常用工具以及实战案例,希望能够帮助读者快速掌握 Python 网络爬虫技术。在实际应用中,需要根据具体的需求选择合适的工具和方法,并注意遵守法律法规和网站的使用条款,避免对网站造成过大的负担和影响。Scrapy 是一个功能强大的 Python 爬虫框架,它提供了一套完整的爬虫开发工具,包括请求发送、网页解析、数据存储等。网络爬虫,又称为网页蜘蛛、网络机器人,是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。(一)爬取新闻网站数据。

weixin_47266126的博客 1703

Android dex, odex, oat, vdex, art文件介绍

下图可以简化将Java源转换为OAT的过程: .dex Dalvik虚拟机字节码文件 .vdex 其中包含APK的未压缩DEX代码,以及一些旨在加快验证速度的元数据 .odex .oat // JIT,Just-in-time,即时编译,边运行边编译; // AOT,Ahead Of Time,提前编译,指运行前编译。 其中包含APK中已经过AOT编译的方法代码。 原始DEX文件(例如classes.dex)被转换为另一个包含本机代码的文件。这个新文件通常具有.odex。.oat扩展名,并由ELF格式

he980725866的博客 3618

带你一起全面了解关于Python网络爬虫的相关知识点!

关于【python 网络爬虫】 目录: 一、什么是python 网络爬虫 二、Python网络爬虫的工作原理 三、Python网络爬虫的应用场景 四、Python 网络爬虫的自动化数据提取利器 五、Python爬虫的优点

zhaoylzy的博客 1438

C++11、C++14 和 C++17 标准新特性详解

特性C++11C++14C++17auto类型推导✅范围 for 循环✅Lambda 表达式✅✅✅智能指针✅移动语义✅nullptr✅统一初始化{}✅✅constexpr✅✅✅✅数字分隔符✅结构化绑定✅✅✅文件系统库✅。

h a 6 6 6 c k 为 你解决复杂难题! 439

UE5实现建筑剖切效果

UE5实现建筑剖切效果

专注GIS开发 8458

别找了,这是python3网络爬虫从入门到进阶最详细的干货教程(附最强理论总结和五大代码案例)

历时数十天打磨,参考了诸多爬虫理论和实战资料,制作出爬虫从入门到进阶的详细纯干货教程,相信对于想学习爬虫的同学来讲是非常好的福利。此外更好的内容可以关注公众号“雨云飞”,笔者研究生即将毕业,签约BAT,后续会奉献更好的作品给大家~谢谢! 目录 Python网络爬虫数据采集实战:基础知识 内容概要 链接直达 Python网络爬虫数据采集实战:Requests和Re库 内容概要 链接...

大数据之眸 2914

容器化部署指南——Docker/K8s环境下的OpenClaw实践(附Dockerfile)

通过本文的详细指导,你已经掌握了OpenClaw在Docker和Kubernetes环境中的容器化部署方法。从基础镜像构建到高级部署策略,从开发环境到生产环境,你现在已经具备了完整的容器化部署能力。 容器化技术为OpenClaw提供了灵活、可扩展、可移植的部署方案,能够满足不同规模和需求的应用场景。通过合理使用Docker和Kubernetes,你可以实现高效的部署管理和运维自动化。 在实际应用中,建议根据具体的业务需求选择合适的部署策略,并结合监控、日志、安全等最佳实践,确保系统的稳定性和可靠性。同时

博客 493

基于Python的三种主流网络爬虫技术

简单介绍了目前基于Python的主流网络爬虫技术以及常见的反爬虫技术

weixin_62640246的博客 2803

[VT虚拟化驱动]正式启动VT

文章目录前言一、vmlaunch正式开始虚拟化二、使用步骤1.引入库2.读入数据总结 前言 本章开始真正实现一个最简单的VT框架,当然,只是能跑起来一个VT驱动了,没有并包括EPT,EPT后面再讲 提示:以下是本篇文章正文内容,下面案例可供参考 一、vmlaunch正式开始虚拟化 执行VMLAUNCH指令执行后,就正式进入虚拟化了,再该指令执行之前,得先保存Guest当前的环境,执行完VMLAUNCH后,要恢复Guest的环境,让Guest就像什么都没发生一样,所以需要保存和恢复Guest的各种寄存器的值

吾无法无天的博客 3661

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Python网络爬虫:深入数据的海洋

Scrapy是一个强大的爬虫框架,提供了许多功能,如自动处理请求、解析响应、存储数据等。使用Scrapy可以快速构建复杂的爬虫项目。然后在生成的爬虫文件中编写爬取逻辑。网络爬虫是一个强大的工具,它可以帮助我们从海量的网络数据中提取有价值的信息。通过Python,我们可以快速上手并开发出功能强大的爬虫程序。但同时,我们也必须意识到,技术的使用应当遵循法律和道德的约束,以确保网络环境的健康和可持续发展。这篇文章只是一个起点,网络爬虫的世界广阔无垠,等待着你去探索和发现。

ciweic的博客 1431

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

上一篇: 2025版最新超详细PycharmIDE安装配置完整教程!
下一篇: 如何利用Python列表实现栈和队列!
Python_trys
博客等级 码龄2年 4347粉丝 377原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
