


一、爬虫基础简介
1. 爬虫简介
什么是爬虫:通过编写程序,模拟浏览器上网,然后让其去互联网上抓取数据的过程
2. 爬虫合法性探究
爬虫究竟是合法还是违法的?
- 在法律中是不被禁止的
- 具有违法风险
- 善意爬虫 & 恶意爬虫
爬虫带来的风险可以体现在如下两个方面:
- 爬虫干扰了被访问网站的正常运营
- 爬虫抓取了受到法律保护的特定类型的数据或信息
如何在编写使用的过程中避免进入局子的厄运?
- 时常优化自己的程序,避免干扰被访问网站的正常运行
- 在使用,传播爬取到的数据时,审查抓取到的内容,如果发现了涉及到用户隐私或者商业机密等敏感内容,需要及时停止爬取或者传播。
3. 爬虫初试深入
爬虫在使用场景中的分类:
- 通用爬虫:抓取系统的重要组成部分。抓取的是一整张页面数据。
- 聚焦爬虫:是建立在通用爬虫的基础之上。抓取的是页面中特定的局部内容。
- 增量式爬虫:监测网站中数据更新的情况。只会抓取网站中最新更新出来的数据。
爬虫的矛与盾:
- 反爬机制:门户网站,可以通过制定相应的策略或者技术手段,防止爬虫程序进行网站数据的爬取。
- 反反爬策略:爬虫程序,可以通过制定相关的策略或者技术手段,破解门户网站中具备的反爬机制,从而可以获取门户网站中相关的数据。
robots.txt协议:君子协议。规定了网站中那些数据可以被爬虫爬取,那些数据不允许被爬取。
4. http&https协议
(1)http协议
概念:就是服务器和客户端进行数据交互的一种形式。
常用请求头信息:
- User-Agent:请求载体的身份标识
- Connection:请求完毕后,是断开连接还是保持连接
常用响应头信息:
- Content-Type:服务器响应回客户端的数据类型
(2)https协议
概念:安全的超文本传输协议
(3)加密方式
- 对称秘钥加密
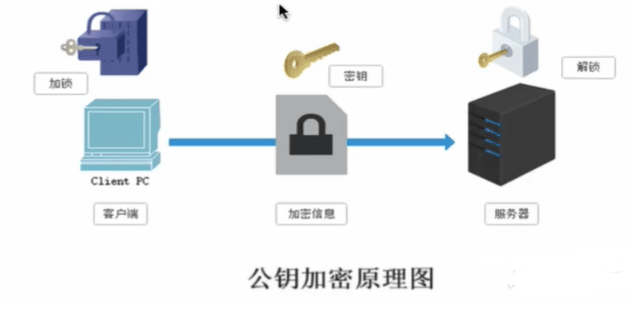
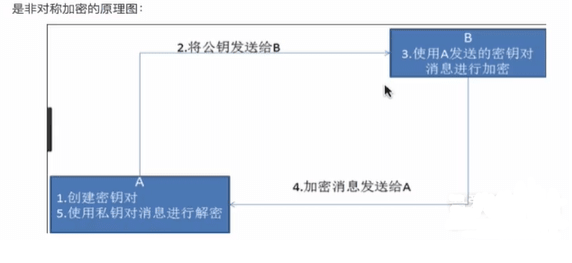
非对称秘钥加密
存在缺点:第一个是如何保证接收端向发送端发出公开秘钥的时候,发送端确保收到的是预先要发送的,而不会被挟持,只要是发送秘钥,就有可能有被挟持的风险;第二个是非对称秘钥加密方式效率比较低,处理起来更为复杂,通信过程中使用就有一定的效率问题而影响通信速度。
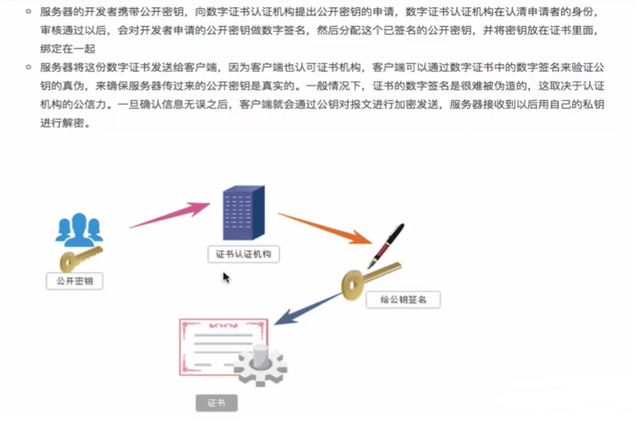
证书秘钥加密:
- 服务器的开发者携带公开密钥,向数字证书认证机构提出公开密钥的申请,数字证书认证机构在认清申请者的身份审核通过以后,会对开发者申请的公开密钥做数字签名,然后分配这个已签名的公开密钥,并将密钥放在证书里面,绑定在一起;
- 服务器将这份数字证书发送给客户端,因为客户端也认可证书机构,客户端可以通过数字证书中的数字签名来验证公钥的真伪,来确保服务器传过来的公开密钥是真实的。一般情况下,证书的数字签名是很难被伪造的,这取决于认证机构的公信力。一旦确认信息无误之后,客户端就会通过公钥对报文进行加密发送,服务器接收到以后用自己的私钥进行解密。
二、requests模块基础
1. requests第一血
requests模块:Python中原生的一款基于网络请求的模块,功能非常强大,简单便捷,效率极高。
作用:模拟浏览器发请求。
如何使用:(requests模块的编码流程)
- 指定 url
- 发起请求
- 获取响应数据
- 持久化存储
环境的安装:pip install requests
实战编码:
- 需求:爬取搜狗首页的数据
import requests
if __name__ == '__main__':
    #step1 指定url
    url = 'https://www.sogou.com/'
    #step2 发起请求
    #get方法会返回一个响应对象
    response = requests.get(url = url)
    #step3 获取响应数据,text返回的是字符串形式的响应数据
    page_text = response.text
    print(page_text)
    #step4 持久化存储
    with open('./sogou.html','w',encoding = 'utf-8') as fp:
        fp.write(page_text)
    print('爬取数据结束!')
2. requests巩固深入案例介绍
(1)简易网页采集器
- UA检测
- UA伪装
#UA:User-Agent请求载体的身份标识
'''UA检测:门户网站的服务器会监测对应请求的载体身份标识,
如果检测到请求载体身份标识是某一款浏览器,说明该请求时一个正常的请求;
但是,如果检测到请求的载体身份不是基于某一款浏览器的,则表示该请求为不正常请求(爬虫),
则服务器很有可能拒绝该次请求'''

#UA伪装:让爬虫对应的请求载体身份标识伪装成某一款浏览器,躲过UA检测
import requests
if __name__ == '__main__':
    #UA伪装:将对应的User-Agent封装到一个字典中
    headers = {
    'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/72.0.3626.121 Safari/537.36'
    }
    #step1 指定url query
    url = 'https://www.sogou.com/web'
    #处理url携带的参数 封装到字典中
    kw = input('Enter a word:')
    param ={
        'query':kw
    }
    #step2 对指定的url发起请求,对应的url是携带参数的,并且处理过程中处理了参数
    response = requests.get(url = url,params = param,headers = headers)
    #step3
    page_text = response.text
    #step4
    fileName = kw + '.html'
    with open(fileName,'w',encoding ='utf-8') as fp:
        fp.write(page_text)
    print(fileName,'保存成功!!')
(2)破解百度翻译
- post请求(携带了参数)
- 响应数据是一组json数据
import requests
import json
if __name__ == '__main__':
    #step1 指定URL
    post_url = 'https://fanyi.baidu.com/sug'

    #step2 进行UA伪装
    headers = {
    'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/72.0.3626.121 Safari/537.36'
    }

    #step3 post请求参数处理(同get请求类似)
    word = input('Enter a word:\n')
    data = {
        'kw':word
    }

    #step4 请求发送
    response = requests.post(url = post_url,data = data,headers = headers)

    #step5 获取响应数据:json()方法返回的是obj  (如果确认响应数据是json类型-->通过Content-Type分辨,才可以直接用json方法)
    dict_obj = response.json()
    print(dict_obj)

    #step6 持久化存储
    fileName = word + '.json'
    fp = open(fileName,'w',encoding='utf-8')
    json.dump(dict_obj,fp = fp,ensure_ascii = False)

    print('Over!')
(3)豆瓣电影
import requests
import json
if __name__ == '_

 2355


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


