基于深度学习的动物检测识别系统(yolo26、yolo12、yolo11、yolov8、yolov5+UI界面+Python项目源码+模型+标注好的数据集)2027毕业版

深度学习之Encoder-Only原理与实战 【代码】深度学习之Encoder-Only原理与实战。 阅读详情


项目介绍

本项目基于 PyQt5 构建了简洁易用的图形用户界面,支持用户选择本地图片或视频进行目标检测。系统界面美观,交互流畅,具备良好的用户体验。

项目附带完整的 Python 源码和详细的使用说明,适合学生进行学习或有一定 Python 基础的开发者,参考与二次开发。您可以在文末获取完整的代码资源文件。


✨ 项目亮点

  • 🔧 完整系统级项目: 包括pyqt5界面、后台检测逻辑、模型加载等模块

  • 🧠 支持深度学习模型扩展: 源代码,支持个人添加改进、模型修改等

  • 🚀 可用于毕(she)/课(she)/个人项目展示: 结构清晰,逻辑完整,便于演示


在这里插入图片描述

🎯 功能展示

本系统具备多个核心功能,支持图像、视频、摄像头等多种输入源的目标检测需求:

  • 🎴功能1:支持单张图片识别
    加载本地图片进行目标识别,支持多种图片格式(如 .jpg、.png 等)。

  • 📁功能2:支持遍历文件夹识别
    可批量读取指定文件夹中的所有图像,并依次完成目标检测任务。

  • 🎫功能3:支持识别视频文件
    支持导入本地视频文件,逐帧分析,实时显示检测效果。

  • 📷功能4:支持摄像头识别
    直接调用笔记本/外接USB摄像头进行实时目标检测。(此功能识别不准,仅仅是为了有这个功能。)

  • 📤功能5:支持结果文件导出(.xls 格式)
    自动保存检测结果为表格文件,包含类别、位置、置信度等信息,方便后续统计与分析。

  • 🔄功能6:支持切换检测目标进行查看
    可自定义选择或切换需要检测的目标种类,仅显示感兴趣的目标。

🎥 更多功能细节、代码演示效果获取请参考下方视频演示。此视频是必看的,里面的信息比文章要丰富,很多内容无法通过博客文字表达出来。

05-基于YOLO12的动物检测识别系统项目实战!-全网最全资料(附赠任务书、开题报告模板课程)人工智能/深度学习/计算机视觉/神经网络

05-基于深度学习的动物检测识别系统-yolo11-彩色版界面(附赠任务书、开题报告模板课程)

05-基于深度学习的动物检测识别系统-yolov8/yolov5-经典版界面(附赠任务书、开题报告模板课程)

05-基于深度学习的动物检测系统(yolov5)(附赠任务书、开题报告模板课程)


🌟 一、环境安装

🎆 环境配置说明

本项目已准备好 完整的环境安装资源包,包含:

  • Python、PyCharm
  • CUDA、PyTorch
  • 其他依赖库(版本已适配)

所有依赖版本均已过验证,确保彼此兼容,可直接参考配套文档或视频教程一步步安装,无需手动调试。


📘 安装指南说明

本项目附带的环境配置文档及配套视频,文档是我在辅导上千名同学安装环境过程中,持续整理总结而成的经验合集,内容覆盖:

  • GPU 与 CPU 两种版本的详细安装流程
  • 安装过程中常见问题汇总
  • 每个问题对应的解决方案
  • 实测可行的安装顺序建议与注意事项

🧩 无论你是新手还是有经验的开发者,相信这份文档都能为你省下大量踩坑时间!

🎥 环境安装教学视频

环境安装-03GPU版


🌟 二、数据集介绍

使用数据集一部分个人标注,一部分来源网络,已统一标注格式并完成预处理,可直接用于训练与测试。
数据集样式如下:

训练样例1训练样例2
train_batch0.jpgtrain_batch1.jpg

数据集制作流程
标注数据: 使用标注工具(LabelImg)对图像中的目标进行标注。每个目标需要标出边界框,并且标注类别。

转换格式: 将标注的数据转换为YOLO格式。YOLO标注格式为每行: <x_center> <y_center> ,这些坐标是相对于图像尺寸的比例。

分割数据集: 将数据集分为训练集、验证集和测试集,通常的比例是80%训练集、10%验证集和10%测试集。

准备标签文件: 为每张图片生成一个对应的标签文件,确保标签文件与图片的命名一致。

调整图像尺寸: 根据YOLO网络要求,统一调整所有图像的尺寸(如416x416或608x608)。

这里只是简单大概介绍,我实际的文档里,内容更要比这里丰富很多,保姆级的教程。这里放太多链接,大家容易看不到😂😂😂。


🌟 三、系统环境(框架/依赖库)说明

以下内容是简单的介绍,方便大家写文章,可直接套用。

🧱 系统环境与依赖配置说明

本项目采用 Python 3.8.10 作为开发语言,整个后台逻辑均由 Python 编写,主要依赖环境如下:

🎡 图形界面框架:

  • PyQt5 5.15.9:用于搭建系统图形用户界面,实现窗口交互与组件布局。

🧠 深度学习框架:

  • torch 1.9.0+cu111:PyTorch 深度学习框架,支持 CUDA 11.1 加速,用于模型构建与推理。
  • torchvision 0.10.0+cu111:用于图像处理、数据增强及模型组件辅助。

⚡ CUDA 与 cuDNN(GPU 加速支持):

  • CUDA 11.1.1(版本号:cuda_11.1.1_456.81):用于 GPU 加速深度学习运算。
  • cuDNN 8.0.5.39(适用于 CUDA 11.1):NVIDIA 深度神经网络库,用于加速模型训练与推理过程。

🧪 图像处理与科学计算:

  • opencv-python 4.7.0.72:实现图像读取、显示、处理等功能。
  • numpy 1.24.4:用于高效数组计算及矩阵操作。
  • PIL (pillow) 9.5.0:图像文件读写与基本图像处理库。
  • matplotlib 3.7.1(可选):用于结果图形化展示与可视化调试。

📈 模型训练参数说明

本项目中提供了两个训练好的模型,均基于如下参数完成训练。具体训练时的设置需根据您自己的硬件配置灵活调整:

🎯 基本训练参数

  • batch size:16
  • epoch:200
  • imgsz(输入尺寸):640
  • 优化器:SGD
  • 学习率:初始学习率 0.01,最终学习率 0.0001
  • 学习率衰减策略:余弦退火(Cosine Annealing)
  • 激活函数:SiLU
  • 损失函数:CIOU(Complete IOU)

🔁 实时数据增强策略

训练过程中使用了多种 在线增强 方法,包括:

  • HSV 色域变换
  • 上下翻转、左右翻转
  • 图像旋转
  • Mosaic 图像拼接增强

⚠️ 特别说明:
以上所有增强操作均为 实时数据增强,只在训练过程中动态生成,用作模型输入,不会将增强后的图像保存到本地。

这种策略具有以下优势:

  • 节省磁盘空间
  • 提高训练样本的多样性
  • 增强模型的泛化能力

若需要可视化增强效果,可自行编写脚本或借助工具(如 Photoshop、美图秀秀等)生成示例图像进行展示。


🌟 四、YOLO相关介绍

🎀 yolov5相关介绍

YOLOV5有YOLOv5n,YOLOv5s,YOLOv5m,YOLOV5l、YOLO5x五个版本。这个模型的结构基本一样,不同的是deth_multiole模型深度和width_multiole模型宽度这两个参数。就和我们买衣服的尺码大小排序一样,YOLOV5n网络是YOLOV5系列中深度最小,特征图的宽度最小的网络。其他的三种都是在此基础上不断加深,不断加宽。不过最常用的一般都是yolov5s模型。
在这里插入图片描述

  本系统采用了基于深度学习的目标检测算法YOLOv5,该算法是YOLO系列算法的较新版本,相比于YOLOv3和YOLOv4,YOLOv5在检测精度和速度上都有很大的提升。YOLOv5算法的核心思想是将目标检测问题转化为一个回归问题。此外,YOLOv5还引入了一种称为SPP(Spatial Pyramid Pooling)的特征提取方法,这种方法可以在不增加计算量的情况下,有效地提取多尺度特征,提高检测性能。

  在YOLOv5中,首先将输入图像通过骨干网络进行特征提取,得到一系列特征图。然后,通过对这些特征图进行处理,将其转化为一组检测框和相应的类别概率分数,即每个检测框所属的物体类别以及该物体的置信度。YOLOv5中的特征提取网络使用CSPNet(Cross Stage Partial Network)结构,它将输入特征图分为两部分,一部分通过一系列卷积层进行处理,另一部分直接进行下采样,最后将这两部分特征图进行融合。这种设计使得网络具有更强的非线性表达能力,可以更好地处理目标检测任务中的复杂背景和多样化物体。

在这里插入图片描述

  在YOLOv5中,每个检测框由其左上角坐标(x,y)、宽度(w)、高度(h)和置信度(confidence)组成。同时,每个检测框还会预测C个类别的概率得分,即分类得分(ci),每个类别的得分之和等于1。因此,每个检测框最终被表示为一个(C+5)维的向量。在训练阶段,YOLOv5使用交叉熵损失函数来优化模型。损失函数由定位损失、置信度损失和分类损失三部分组成,其中定位损失和置信度损失采用了Focal Loss和IoU Loss等优化方法,能够有效地缓解正负样本不平衡和目标尺寸变化等问题。

  YOLOv5网络结构是由Input、Backbone、Neck、Prediction组成。Yolov5的Input部分是网络的输入端,采用Mosaic数据增强方式,对输入数据随机裁剪,然后进行拼接。Backbone是Yolov5提取特征的网络部分,特征提取能力直接影响整个网络性能。YOLOv5的Backbone相比于之前Yolov4提出了新的Focus结构。Focus结构是将图片进行切片操作,将W(宽)、H(高)信息转移到了通道空间中,使得在没有丢失任何信息的情况下,进行了2倍下采样操作。

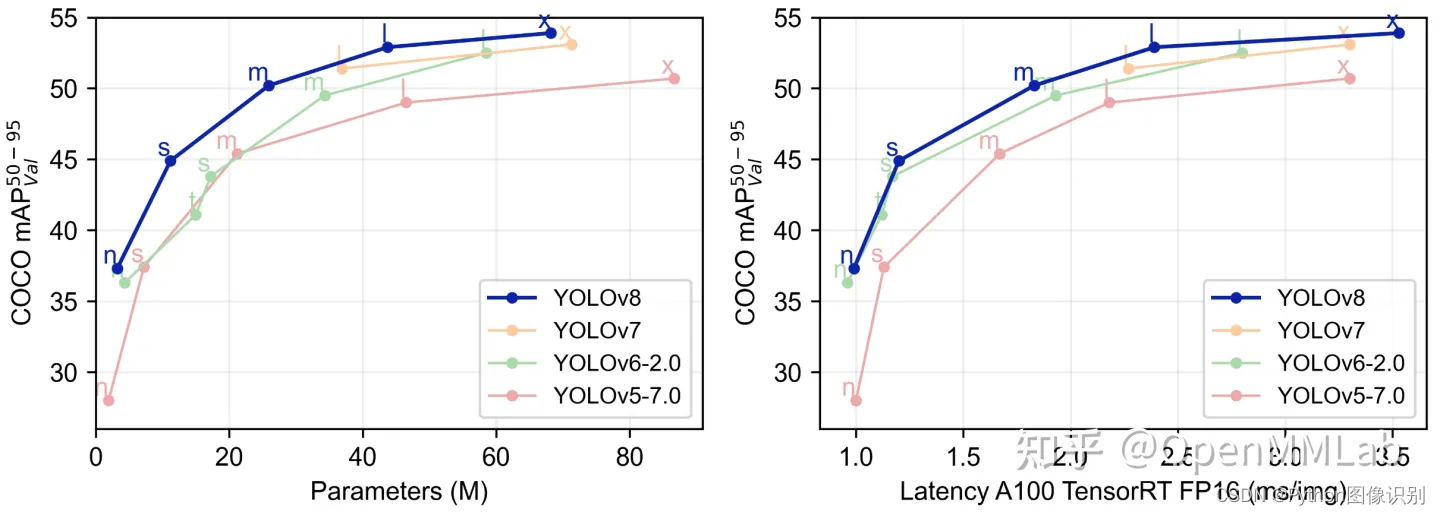
🎑 yolov8相关介绍

YOLOv8 是一个 SOTA 模型,它建立在以前 YOLO 版本的成功基础上,并引入了新的功能和改进,以进一步提升性能和灵活性。具体创新包括一个新的骨干网络、一个新的 Ancher-Free 检测头和一个新的损失函数,可以在从 CPU 到 GPU 的各种硬件平台上运行。

不过 ultralytics 并没有直接将开源库命名为 YOLOv8,而是直接使用 ultralytics 这个词,原因是 ultralytics 将这个库定位为算法框架,而非某一个特定算法,一个主要特点是可扩展性。其希望这个库不仅仅能够用于 YOLO 系列模型,而是能够支持非 YOLO 模型以及分类分割姿态估计等各类任务。
总而言之,ultralytics 开源库的两个主要优点是:

  • 融合众多当前 SOTA 技术于一体

  • 未来将支持其他 YOLO 系列以及 YOLO 之外的更多算法

在这里插入图片描述

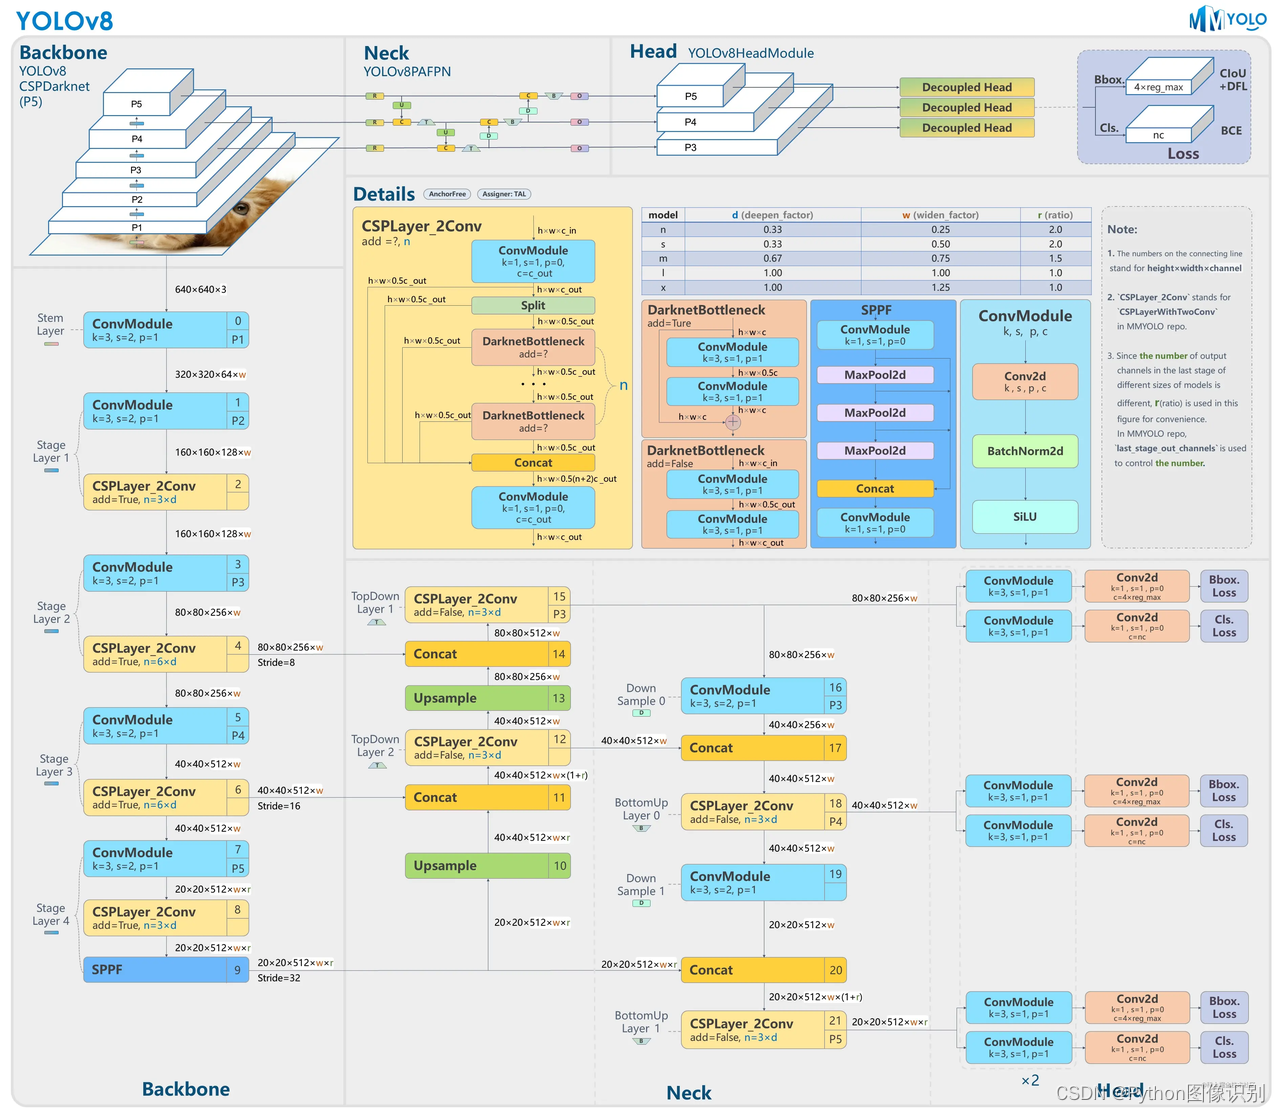
网络结构如下:
在这里插入图片描述

🎐 yolo11相关介绍

YOLO11 是Ultralytics YOLO 系列实时物体检测器的最新版本,以尖端的精度、速度和效率重新定义了可能性。基于先前 YOLO 版本的令人印象深刻的进步,YOLO11 在架构和训练方法方面引入了重大改进,使其成为各种计算机视觉任务的多功能选择。
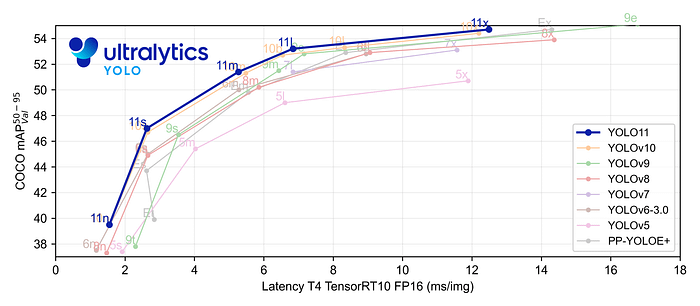
在这里插入图片描述

Key Features 主要特点:

  • 增强的特征提取:YOLO11采用改进的主干和颈部架构,增强了特征提取能力,以实现更精确的目标检测和复杂任务性能。
  • 针对效率和速度进行优化:YOLO11 引入了精致的架构设计和优化的训练管道,提供更快的处理速度并保持准确性和性能之间的最佳平衡。
  • 使用更少的参数获得更高的精度:随着模型设计的进步,YOLO11m 在 COCO 数据集上实现了更高的平均精度(mAP),同时使用的参数比 YOLOv8m 少 22%,从而在不影响精度的情况下提高计算效率。
  • 跨环境适应性:YOLO11可以无缝部署在各种环境中,包括边缘设备、云平台以及支持NVIDIA GPU的系统,确保最大的灵活性。
  • 支持的任务范围广泛:无论是对象检测、实例分割、图像分类、姿态估计还是定向对象检测 (OBB),YOLO11 旨在应对各种计算机视觉挑战。
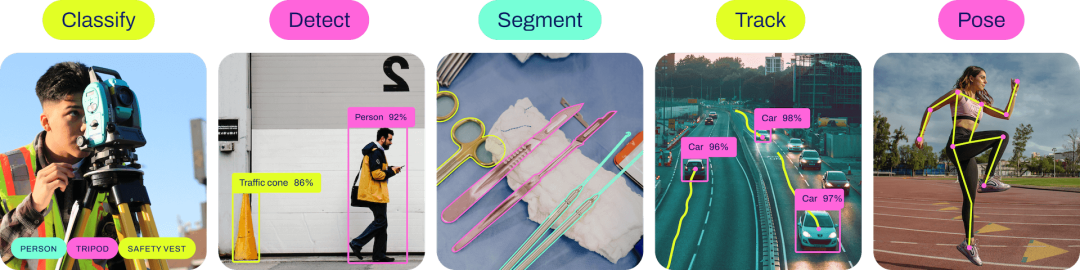
    在这里插入图片描述

🌟 五、模型训练步骤

以下操作步骤,每年我都会更新,所以下方操作步骤可跳过,可以去我文档里查看最新的操作步骤。

  1. 使用pycharm打开代码,找到train.py打开,示例截图如下:
    在这里插入图片描述

  2. 修改 model_yaml 的值,根据自己的实际情况修改,想要训练 yolov5s模型 就 修改为 model_yaml = yaml_yolov5s, 训练 添加SE注意力机制的模型就修改为 model_yaml = yaml_yolov5_SE

  3. 修改data_path 数据集路径,我这里默认指定的是traindata.yaml 文件,如果训练我提供的数据,可以不用改

  4. 修改 model.train()中的参数,按照自己的需求和电脑硬件的情况更改

    # 文档中对参数有详细的说明
    model.train(data=data_path,             # 数据集
                imgsz=640,                  # 训练图片大小
                epochs=200,                 # 训练的轮次
                batch=2,                    # 训练batch
                workers=0,                  # 加载数据线程数
                device='0',                 # 使用显卡
                optimizer='SGD',            # 优化器
                project='runs/train',       # 模型保存路径
                name=name,                  # 模型保存命名
                )
    
  5. 修改traindata.yaml文件, 打开 traindata.yaml 文件,如下所示:
    在这里插入图片描述
    在这里,只需修改 path 的值,其他的都不用改动(仔细看上面的黄色字体),我提供的数据集默认都是到 yolo 文件夹,设置到 yolo 这一级即可,修改完后,返回 train.py 中,执行train.py。

  6. 打开 train.py ,右键执行。
    在这里插入图片描述

  7. 出现如下类似的界面代表开始训练了
    在这里插入图片描述

  8. 训练完后的模型保存在runs/train文件夹下
    在这里插入图片描述


🌟 六、模型评估步骤

以下操作步骤,每年我都会更新,,所以下方操作步骤可跳过,可以去我文档里查看最新的操作步骤。

  1. 打开val.py文件,如下图所示:
    在这里插入图片描述

  2. 修改 model_pt 的值,是自己想要评估的模型路径

  3. 修改 data_path ,根据自己的实际情况修改,具体如何修改,查看上方模型训练中的修改步骤

  4. 修改 model.val()中的参数,按照自己的需求和电脑硬件的情况更改

    model.val(data=data_path,           # 数据集路径
              imgsz=300,                # 图片大小,要和训练时一样
              batch=4,                  # batch
              workers=0,                # 加载数据线程数
              conf=0.001,               # 设置检测的最小置信度阈值。置信度低于此阈值的检测将被丢弃。
              iou=0.6,                  # 设置非最大抑制 (NMS) 的交叉重叠 (IoU) 阈值。有助于减少重复检测。
              device='0',               # 使用显卡
              project='runs/val',       # 保存路径
              name='exp',               # 保存命名
              )
    
  5. 修改完后,即可执行程序,出现如下截图,代表成功(下图是示例,具体输出结果以自己的实际项目为准。)
    在这里插入图片描述

  6. 评估后的文件全部保存在在 runs/val/exp... 文件夹下
    在这里插入图片描述


🌟 七、训练结果

模型训练完成后,所有相关文件(包括权重文件、训练日志、评估结果等)均统一保存在代码工程的weights文件夹下,便于后续模型部署与复用。文件夹内包含训练过程中生成的所有最优权重(best.pt)及最终权重(last.pt),整体结构清晰,可直接用于推理或二次训练。

训练结果截图.jpg

训练的曲线图:
训练过程中,模型的关键指标(如损失值、精度、召回率等)变化曲线已自动记录并可视化。从曲线中可以清晰观察到:

  • 训练集与验证集的损失值(Loss)随迭代次数增加逐步下降并趋于稳定,表明模型有效学习到数据特征;
  • 核心评估指标(如 mAP@0.5、准确率)在训练后期逐步收敛,验证集性能与训练集保持一致,无明显过拟合现象;
  • 通过对比不同阶段的指标变化,可直观判断模型收敛速度与稳定性,为参数调优提供参考。

results.png

评估的结果示例图:
为更直观展示模型性能,选取val中具有代表性的样本进行可视化评估,涵盖不同场景、不同目标密度及复杂背景下的检测 / 分类效果:

评估示例图1评估示例图2
val_batch0_labels.jpgval_batch1_labels.jpg

🌟 获取方式说明

这是一套完整的资源,经过往届学长学姐检验过,是OK的项目,我这里就不做过多的介绍了,说的太多了,大家容易看不到。如果想要获取源码进行学习,可观看一下前面 功能展示 章节的视频演示。如有疑问,也可通过下方的名片或者留言进行交流,一起学习、进步。

🌟 获取方式说明

这是一套完整的资源,经过往届学长学姐检验过,是OK的项目,我这里就不做过多的介绍了,说的太多了,大家容易看不到。如果想要获取源码进行学习,可观看一下前面 功能展示 章节的视频演示。如有疑问,也可通过下方的名片或者留言进行交流,一起学习、进步。

💡 温馨提示:资源仅用于学习交流,请勿用于商业用途,感谢理解与支持!

深度学习之Seq2Seq原理与实战 【代码】深度学习之Seq2Seq原理与实战。 阅读详情

相关推荐

深度学习之TF-IDF原理与实战

【代码】深度学习之TF_IDF原理与实战。

yumiwangzi30的博客 186

AI公益项目:用免费资源搭建野生动物识别系统

通过本文介绍的方法,动物保护组织可以零成本搭建基础的野生动物识别系统。虽然性能可能不如商业解决方案,但对于资金有限的公益项目已经足够使用。结合声音识别监测动物活动使用小样本学习技术提高识别率开发移动端应用方便志愿者使用希望这套方案能帮助更多保护组织利用AI技术守护野生动物。现在就可以下载代码尝试搭建你自己的识别系统了!

EmeraldTiger56的博客 575

深度学习之LoRA(低秩适配)原理与实战

【代码】深度学习之LoRA(低秩适配)原理与实战。

yumiwangzi30的博客 256

SpeciesNet - 谷歌开源的AI模型,助力野生动物识别和保护

别担心,谷歌开源的 SpeciesNet 正是来解决这个问题的 —— 这个专门为野生动物研究设计的 AI 模型,能让计算机自动识别红外相机照片中的物种,把研究人员从繁重的看图工作中解放出来。SpeciesNet 用的 MegaDetector 技术就像个经验丰富的护林员,能快速扫描图像内容,区分出动物、人类、车辆或者空场景。最聪明的是,它还会结合拍摄地的经纬度数据,避免出现 "在北极发现非洲狮" 这种地理错误。物种标签,从具体的 "非洲象" 到更广义的 "象科" 和 "哺乳动物",分级识别确保不会漏判。

Qynwang的博客 1382

GLM-5.2模型自部署实战:如何通过量化与vLLM优化实现远超官方API的推理速度

在大模型应用开发中,模型推理速度是影响用户体验和系统性能的核心指标。其原理在于通过优化计算图、内存管理和并行计算来提升吞吐量与降低延迟。技术价值体现在能够为高并发、低延迟的实时应用提供稳定高效的AI服务能力,广泛应用于智能客服、代码生成、内容创作等场景。其中,模型量化通过降低权重精度(如INT4/INT8)来大幅减少显存占用和计算量,而推理引擎(如vLLM)则通过连续批处理和PagedAttention等技术最大化硬件利用率。本文聚焦于GLM-5.2模型,详细阐述如何通过量化技术与vLLM推理引擎的深度优化

weixin_29032337的博客 319

【国产化信创实践】宝兰德bes中间件集成springboot

【国产化信创实践】宝兰德bes中间件集成springboot

项目管理、软件工厂、vue研发、Java研发、中国文化等。 1万+

Qwen3-VL野生动物:追踪识别系统案例

本文以 Qwen3-VL-WEBUI 为核心,展示了如何构建一套高效、智能的野生动物识别与追踪系统。通过集成阿里开源的✅ 高精度物种识别(涵盖哺乳类、鸟类、爬行类等)✅ 复杂环境下的空间与遮挡理解✅ 视频序列中的个体行为推断✅ 手写文本与设备信息自动提取✅ 批量处理与 API 自动化集成Qwen3-VL 不仅是一个强大的视觉语言模型,更是连接AI与生态保护的实际桥梁。其在长上下文、空间感知、多模态推理等方面的全面升级,使其特别适合处理真实世界中混乱、多样、低质量的野外影像数据。

weixin_42590539的博客 717

使用PyTorch设计卷积神经网络(CNN)来处理遥感图像Indian Pines数据集

使用PyTorch设计卷积神经网络(CNN)来处理遥感图像Indian Pines数据集

XAX520_1314的博客 2490

利用魔搭中的开源模型进行动物识别

利用魔搭中的开源模型进行动物识别

m0_73604812的博客 777

MBD-从一个示例看代码生成过程(rtw文件、TLC语言)

大概介绍了MBD代码生成流程,rtw文件、TLC语言

小胡同学的工程师学习之路 4214

PLC控制气缸与电磁阀:从原理到实战编程详解

在工业自动化领域,很多工程师都能编写PLC程序控制电机启停,但当涉及到气缸和电磁阀的精确控制时,却常常遇到动作不协调、响应延迟甚至设备损坏的问题。这背后的关键不在于PLC编程本身,而在于对气动元件特性和控制逻辑的深入理解。 本文将从实际工程问题出发,深入解析气缸与电磁阀的工作原理、PLC控制逻辑设计、常见故障排查方法,并通过完整的梯形图实例,帮助读者掌握气动系统自动化编程的核心要点。无论你是刚接触PLC的初学者,还是希望提升气动控制技能的工程师,都能从中获得实用的技术指导。 1. 气缸与电磁阀在自动化控制中

weixin_42522374的博客 338

阿里开源图像识别:万物识别模型实战,从安装到识别一气呵成

本文介绍了如何在星图GPU平台上自动化部署阿里开源的‘万物识别-中文-通用领域’镜像,实现高效的图像识别功能。该平台简化了环境配置,用户可快速搭建识别服务,并将其应用于电商平台的‘拍照搜同款’、智能相册分类等典型场景,为项目快速集成视觉能力提供便利。

weixin_35753291的博客 343

SAP SEGW 事物码里的 Association 建模方式

Association 模型用于描述 OData 模型里不同 Entity Type 之间的关联关系。我们来看一个具体的例子:Principal Entity(主体):代表 association 的主导端。Cardinality(基数):指定主体实体类型和依赖实体类型之间的关系。按 F4 或点击从列表中选择。关联的多重性如下:为引用约束()指定以下参数,目的是将主体实体类型的每个键,关联到从属实体类型的一个属性:Referential Constraints 的一个例子如下: 引用约束(Referenti

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 909

【完整源码+数据集+部署教程】动物检测与分类系统源码 [一条龙教学YOLOV8标注好的数据集一键训练_70+全套改进创新点发刊_Web前端展示]

【完整源码+数据集+部署教程】动物检测与分类系统源码 [一条龙教学YOLOV8标注好的数据集一键训练_70+全套改进创新点发刊_Web前端展示]

weixin_43860634的博客 706

ReAct 智能体 Agent:架构解析与实践拓展

ReAct 智能体 Agent 凭借其推理与行动协同的独特架构,在众多人工智能应用场景中展现出巨大的潜力。从智能办公到教育辅导,从智能家居到工业物联网,ReAct 智能体通过精准推理和高效行动,为用户提供了更加智能、便捷的服务体验。然而,在实际应用过程中,仍面临工具调用安全、模型持续学习、多智能体协作管理以及性能优化等多方面的挑战。通过合理的策略和技术创新,如强化工具审核机制、构建持续学习框架、设计高效协作协议和采用性能优化手段,我们有望逐步克服这些挑战,进一步提升 ReAct 智能体的性能和可靠性。

加入“Super Entity”,与全能开发团队共探AI智能体与数字人项目,开启前沿技术之旅。 1687

基于RK3588平台的高分辨率多摄像头系统深度优化:从48M单摄到双摄分时复用的完整解决方案

本文深入解析了RK3588平台的高分辨率摄像头实现方案。重点介绍了:1)RK3588的MIPI PHY硬件架构,包括DCPHY和DPHY的资源配置及工作模式;2)双ISP合成技术,通过并行处理提升48M高分辨率图像的处理能力;3)以OV50C40传感器为例,详细展示了48M单摄系统的硬件连接、I2C设备配置和关键参数设置。文章为开发者提供了从硬件连接到软件配置的完整技术方案,有助于实现高性能嵌入式视觉系统。

FJN110的博客 675

毕业设计 深度学习yolo藻类细胞检测识别(科研辅助系统)(源码+论文)

🔥这两年开始毕业设计和毕业答辩的要求和难度不断提升,传统的毕设题目缺少创新和亮点,往往达不到毕业答辩的要求,这两年不断有学弟学妹告诉学长自己做的项目系统达不到老师的要求。并且很难找到完整的毕设参考学习资料。 为了大家能够顺利以及最少的精力通过毕设,学长分享优质毕业设计项目提供大家参考学习,今天要分享的是 🚩 **毕业设计 深度学习yolo藻类细胞检测识别(科研辅助系统)(源码+论文)** 🥇学长这里给一个题目综合评分(每项满分5分) 难度系数:3分 工作量:4分 创新点:5分

HUXINY的博客 1583

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

毕业设计 深度学习yolo11水稻病害检测识别系统(源码+论文)

毕业设计 深度学习yolo11水稻病害检测识别系统(源码+论文)

HUXINY的博客 1752

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

【深度学习毕设项目】基于YOLOv11的番茄叶片病虫害识别检测技术研究python农作物叶片病虫害检测与识别系统的设计与实现

本文介绍了一个基于YOLOv11深度学习模型的番茄叶片病虫害智能检测系统。该系统通过Python框架实现,能够对图片和视频中的番茄病害进行实时识别,自动计算病斑面积占比并评估病情等级。系统集成了Echarts可视化工具和MySQL数据库,提供检测结果的多维度展示和历史数据管理功能。研究背景阐述了番茄病害防治的迫切需求,研究目的强调了该系统的技术价值与经济、社会、生态效益。系统内容包括YOLOv11模型部署、病情评估算法、数据管理模块等核心功能。页面设计展示了用户友好的交互界面。参考文献列举了相关领域的研究成

m0_72599287的博客 1186

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

深度学习0:数学知识:正态分布1

步骤内容结果1引入e−x2e^{-x^2}e−x2钟形曲线2算它的面积I∫−∞∞e−x2dxI∫−∞∞​e−x2dx3平方变成二重积分I2I^2I24换极坐标简化计算5算出I2πI^2 = \piI2πIπIπ​6代入σ\sigmaσ和μ\muμ做变量替换得到σ2πσ2π​7除以它归一化得到正态分布公式2π2π​不是随便写的,它来自高斯积分∫−∞∞e−x2。

tellmewhoisi的博客 195

图解循环神经网络(RNN)

RNN(循环神经网络)就是“带记忆的网络”:让网络拥有一块“记忆”,在处理当前数据时,能同时参考之前看过的内容;它不一次性看完全部输入,而是像人读书一样,一个字一个字地读,每读一个字就更新一次脑子里的记忆,然后用这份记忆去理解当前这个字。但便签一直在被改写,新信息不断挤占旧信息,传到第 40 步时,“巴黎”的痕迹已经淡得几乎没了。读到“贵”的时候,网络并没有重新去查“好看”这个词——但“好看”的影响已经融在了便签里(那个 1.5)。这三个困难的共同点:答案不在当前这一个字里,而在“前面那串东西”里。

技术管理两手抓,两手都要硬. 357

【原创深度学习项目】基于深度学习的建筑工地防护装备检测系统|安全帽与反光衣检测系统(RT-DETR-L 模型)

本文设计并实现了一套基于RT-DETR-L的建筑工地防护装备检测系统,采用Django+Vue前后端架构,实现对安全帽、反光背心等7类装备及“无PPE”“未戴安全帽”等缺失状态的精准识别。系统支持图片、视频、摄像头实时检测,具备参数可调、数据可视化与统计分析功能,有效解决小目标漏检、误检及管理难问题,助力智慧工地安全管理落地。文末可获取源码。

qq_1445749146的博客 214

神经网络入门指南:从 CNN、RNN 到 Attention

神经网络的学习,本质是“预测—比较—纠错”的循环;CNN 通过局部连接与权重共享理解图像;RNN 通过隐藏状态传递上下文;LSTM 和 GRU 用门控机制管理记忆;Encoder–Decoder 把理解与生成拆成两个阶段;Attention 则让模型在每一步都能主动寻找最相关的信息。到这里,我们已经走完了从普通神经网络到 Attention 的完整路线。下一篇将正式进入 Transformer,看看它如何摆脱 RNN 的顺序计算,又如何让每个 Token 直接找到与自己相关的信息。

爱敲代码的小黄 350

基于深度学习的垃圾分类系统的设计与实现

本系统是一个基于 Flask Web 框架与 PyTorch 深度学习模型的垃圾分类智能识别平台。系统面向垃圾图像分类场景,能够对上传图片中的玻璃、纸张、纸板、塑料、金属、其他垃圾等六类垃圾进行自动识别与置信度评估,并提供识别历史、数据统计、模型在线训练与记录导出等完整功能。系统使用 TrashNet 公开垃圾分类数据集进行模型训练,管理员可手动发起模型训练,训练完成后自动加载新权重。启动服务不会自动训练。

aiyuanma_vip的博客 384
上一篇: 基于yolov8的钢铁缺陷检测系统-2027毕业版(UI界面+Python项目源码+模型+标注好的数据集)
下一篇: 基于深度学习的火灾检测识别系统(yolo26、yolo12、yolo11、yolov8、yolov5+UI界面+Python项目源码+模型+标注好的数据集)2027毕业版
Python图像识别-1
博客等级 码龄2年 1010粉丝 199原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值