微调数据集:决定成败的不是模型,是你喂进去的几百条数据

【大模型原理与微调实战09】微调数据集实战精讲:数据格式、清洗规范、样本构造(彻底解决微调效果差、过拟合) 模型效果 80% 取决于数据集,20% 取决于训练参数。绝大多数新手微调翻车,全部是以下问题:1. 数据杂乱、长短不一;2. 问答不对应、回答不标准;3. 数据太少导致过拟合;4. 格式错误、模型学不到规律;5. 数据重复严重,模型只会背答案不会推理。代码其实网上到处都有,真正拉开微调效果差距的,是数据质量。本篇手把手、通俗落地讲解:SFT微调数据集怎么建、怎么写、怎么清洗、怎么规避坑。1. 微调成败80%看数据,代码和参数只是辅助; 阅读详情

第一版用了 5000 条爬来的数据微调,效果还不如原模型。排查三天发现 30% 的数据 output 是空的或者格式错乱。

阅读提示

  • 适合谁看:已经确认需要微调(看完《先别急着微调》后判断过)、现在卡在数据准备阶段的工程师
  • 看完能做什么:知道微调数据从哪来、标准格式长什么样、质量怎么检查、大概需要多少条
  • 不适合谁:还没确认要不要微调的读者(先看上一篇)

先给结论

  • 微调效果的天花板由数据决定,不是由模型或参数决定——脏数据微调出来的模型,比不微调还差
  • 数据不在多,在精——几百条高质量数据,往往比几万条低质量数据效果更好
  • 数据构造有三个致命坑:格式不统一、正负样本失衡、训练集泄漏到评估集

01 一次脏数据微调翻车

先把失败经验讲清楚。

某团队做内部知识问答微调,从 Confluence 和内部文档里爬了 5000 条 QA 对,直接拿来微调 Llama-3-8B。

微调完一测,效果还不如原模型——原模型至少能正常回答通用问题,微调后的模型连"你好"都会回一段乱码。

排查了三天,发现问题出在数据上:

  • 30% 的数据 output 是空的——爬虫抓到了问题但没抓到回答
  • 20% 的数据格式错乱——有些回答里混了 HTML 标签、有些有 Markdown 格式、有些是纯文本
  • 10% 的数据是重复的——同一个问题在不同页面出现了多次,模型对这些问题严重过拟合

5000 条数据里只有 2000 条是能用的。但因为没有做质量检查,这 3000 条垃圾数据把模型的分布带偏了。

这就是"数据决定上限"的含义:模型只是在拟合你给的分布,如果你给的分布是脏的,模型拟合出来的也是脏的。


02 微调数据的四条来源路径 + 质量检查
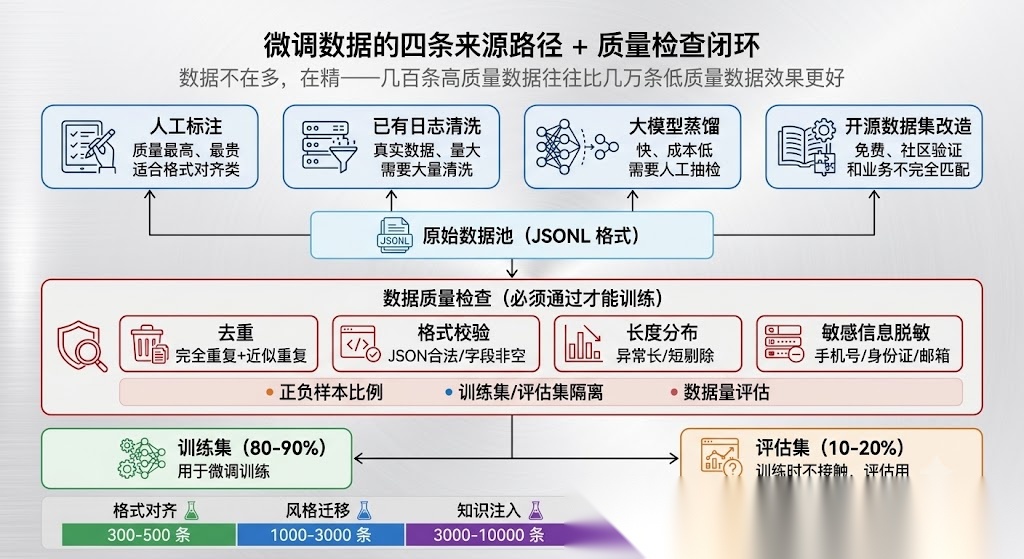
图 1|微调数据的四条来源路径 + 质量检查闭环

路径 1:人工标注

微调数据有两种主流格式,取决于你用的框架:

格式 1:instruction / input / output 三段式(Alpaca 格式)

{"instruction": "将以下英文翻译成中文", "input": "Hello, how are you?", "output": "你好,你怎么样?"}{"instruction": "提取以下文本中的关键信息", "input": "张三,男,28岁,北京", "output": "{\"name\":\"张三\",\"gender\":\"male\",\"age\":28,\"city\":\"北京\"}"}

格式 2:messages 对话格式(ShareGPT / OpenAI 格式)

{"messages": [{"role": "system", "content": "你是一个专业的翻译助手"}, {"role": "user", "content": "将以下英文翻译成中文:Hello, how are you?"}, {"role": "assistant", "content": "你好,你怎么样?"}]}

选哪个? 如果你的任务是单轮问答,用 Alpaca 格式更简单。如果是多轮对话、或者需要 System Prompt 控制行为,用 messages 格式。LLaMA-Factory、Unsloth 等主流框架都支持这两种格式。

关键注意点:同一批数据必须格式统一。不要一半用 Alpaca 一半用 messages——框架解析时会报错或者静默丢弃格式不对的数据。

格式 3:DPO 偏好数据格式(chosen/rejected 成对)

如果你要做 DPO(Direct Preference Optimization)偏好对齐训练,数据格式和 SFT 不同——需要 chosen(好回答)和 rejected(差回答)成对出现:

[  {    "instruction": "解释什么是机器学习",    "chosen": "机器学习是人工智能的一个分支,它让计算机通过数据自动学习规律,而不需要显式编程。比如,通过大量邮件数据,模型可以学会识别垃圾邮件。",    "rejected": "机器学习就是让电脑自己学习,不需要人管。反正就是很厉害的技术。"  },  {    "instruction": "写一段产品描述:无线蓝牙耳机",    "chosen": "这款无线蓝牙耳机采用最新蓝牙5.3技术,支持主动降噪,续航长达30小时。IPX5防水设计,适合运动和日常通勤。",    "rejected": "蓝牙耳机,能听歌,能打电话,挺好的。"  }]

DPO 数据的关键:chosen 和 rejected 的差距要足够明显——如果两个回答差不多,模型学不到偏好。chosen 必须在准确性、完整性、条理性上明显优于 rejected。人工构造 DPO 数据的成本比 SFT 数据高,建议先用大模型生成 rejected 版本,再人工写 chosen 版本。


03 数据从哪来:四条路径

路径 1:人工标注

最可靠,也最贵。适合任务明确、标注规则清晰的场景。

  • 优点:质量最高、分布最可控
  • 缺点:慢、贵、需要领域专家
  • 适合:格式对齐类任务(几百条就够了)、需要精确标注的任务

路径 2:已有日志清洗

从线上日志、客服记录、历史问答里提取。比如从客服系统里捞"用户问了什么 + 客服怎么回的",清洗后作为训练数据。

  • 优点:数据真实、量大、成本低
  • 缺点:质量参差不齐、需要大量清洗工作
  • 适合:问答类任务、有历史数据积累的场景

路径 3:大模型蒸馏(用强模型造数据)

用 GPT-4 / Claude 等强模型,给它任务描述和示例,让它批量生成训练数据。

  • 优点:快、成本可控、能快速拿到一批数据验证方向
  • 缺点:生成的数据可能有模式偏差(“GPT 味”)、需要人工抽检
  • 适合:快速验证微调方向、补充数据量

路径 4:开源数据集改造

HuggingFace 上有大量开源微调数据集,找一个和你任务接近的,改造后使用。

  • 优点:免费、量大、社区验证过
  • 缺点:和你的业务场景可能不完全匹配
  • 适合:通用任务的冷启动、作为基础数据集补充

我们的经验是:大多数项目会组合使用多条路径——先用大模型蒸馏快速拿到一批数据验证方向,再用人工标注补充高质量数据,最后用日志清洗扩充量。


04 大模型蒸馏造数据的最小流程

如果你选择路径 3(大模型蒸馏),下面是最小可行流程:

Step 1:设计 Prompt 模板

给强模型(GPT-4 / Claude)一个任务描述 + 几个示例,让它批量生成。

你是一个训练数据生成器。请根据以下任务描述,生成 10 条训练数据。任务:将用户的自然语言问题转换为 SQL 查询。输入示例:"查一下昨天的订单量" → 输出示例:"SELECT COUNT(*) FROM orders WHERE dt = '2024-01-06'"请生成 10 条不同难度的训练数据,确保:1. 输入问题多样化(简单查询、多表 JOIN、聚合、子查询)2. 输出 SQL 语法正确3. 覆盖不同的业务表和字段

Step 2:人工抽检(关键步骤)

生成的数据不要直接用。随机抽 20% 做人工检查:

  • SQL 语法对不对?
  • 逻辑和问题匹配吗?
  • 有没有明显错误?
  • 有没有重复或过于相似的条目?

Step 3:规则过滤

用脚本做自动化过滤:

  • 去重(完全重复 + 近似重复)
  • 格式校验(JSON 格式是否合法、必填字段是否为空)
  • 长度过滤(input 或 output 过长/过短的剔除)
  • 敏感信息脱敏(手机号、身份证号、邮箱等)

05 数据质量检查清单

不管数据从哪来,用这份清单过一遍:

□ 去重:完全重复 + 近似重复(编辑距离 < 5)都剔除□ 格式校验:每条数据都能被 JSON 解析、必填字段不为空□ 长度分布:input/output 长度分布是否合理,有没有异常长/异常短的□ 正负样本比例:如果你的任务有正负样本(比如分类),比例是否均衡□ 敏感信息脱敏:检查 output 里有没有泄露真实手机号/身份证/邮箱□ 训练集/评估集隔离:确保评估集的数据没有出现在训练集里(这条最容易被忽略)

06 数据量怎么估

不同任务类型需要的数据量差异很大:

任务类型最少数据量推荐数据量说明
格式对齐(JSON/模板)100-300 条300-500 条模式简单,几百条就够学到格式
风格迁移(写作风格)500-1000 条1000-3000 条需要更多样本来捕捉风格特征
知识注入(领域知识)1000-3000 条3000-10000 条知识量大,需要更多数据覆盖
能力蒸馏(小模型替代大模型)5000-10000 条10000+ 条需要大量数据来压缩大模型的能力

这些数字是经验区间,不是精确阈值。在格式对齐类任务上,我们用 300 条精标数据的效果,超过了 3000 条粗标数据(评估方法:在 50 条留出测试集上对比格式正确率)。

关键判断:先用少量数据(几百条)跑一轮微调,看看效果趋势。如果效果有明显提升但不够,说明方向对了,增加数据量。如果效果没变化甚至变差,说明问题不在数据量——先排查数据质量。


07 什么任务靠造数据也救不了

需要真实分布的场景

如果你的任务依赖真实用户行为数据(比如推荐系统、风控模型),大模型蒸馏造的数据帮不上忙——造出来的数据没有真实的分布特征。

需要时效性的场景

如果你的知识经常变化(比如金融、法律),造数据的时刻知识就是旧的。这类场景更适合 RAG(实时检索)而不是微调(静态知识)。

需要极高精度的场景

医疗、法律、金融合规——这些领域容错率极低,大模型蒸馏的数据可能有细微错误,人工逐条审核的成本又太高。


08 给读者一个能用来做决策的结论

决策帮助

  • 如果你任务简单(格式对齐):先用大模型蒸馏造 300 条 + 人工抽检,快速验证微调方向
  • 如果你任务复杂(知识注入):先用日志清洗 + 大模型蒸馏拿到 1000+ 条,再用人工标注补充 500 条高质量数据
  • 如果你有历史日志:优先从日志里提取,真实数据的价值远高于造出来的数据
  • 如果你只能先做一步:跑完数据质量检查清单再开始训练——这一步比调任何超参都重要

学AI大模型的正确顺序,千万不要搞错了

🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!

有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!

就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋

在这里插入图片描述

📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇

学习路线:

✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经

以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!

我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

手把手实战:用LLaMA-Factory与QLoRA微调你的专属领域大模型 大语言模型(LLM)的微调(Fine-tuning)技术,是解决通用模型在垂直领域表现不佳的关键。其核心原理是通过在特定领域的高质量数据上进行额外训练,让模型学习专有知识、任务格式和对话风格,从而实现从“博而不精”到“领域专家”的转变。这项技术的价值在于,它能以相对较低的成本(如使用LoRA/QLoRA技术)显著提升模型在专业场景下的准确性和可靠性,有效缓解“幻觉”问题。其应用场景广泛,包括构建专业客服、法律顾问、代码生成等智能助手。本文将以当前热门的开源微调框架LLaMA-Factory和高效的QLoRA 阅读详情

相关推荐

“我们想微调一个大模型“——先别急,先回答这三个问题

"到底该微调还是用 RAG?"是 2026 年企业 AI 落地被问得最多的问题,也是选错代价最高的问题——选错直接决定项目的成本结构、迭代节奏和效果上限。本文用真实项目开场,给一套能直接抄的决策框架:三个问题初步分流(知识变不变、要不要可追溯、格式特不特殊)、七个维度细化打分、RAG+微调组合的三种标准架构,最后附微调实操五步与常见坑清单。立项前照一遍,能帮你省下一笔冤枉钱。

aigcharness的博客 498

大模型微调项目的营销之道:从数据到评测,程序员必看收藏指南

本文强调大模型微调项目的营销价值远超技术本身。新手程序员应避免简单复刻教程,而应注重数据质量与多样性,构建独特且贴近业务场景的数据集。建立科学评测方法,避免仅凭主观感受。调参有用但非最高效,应更多优化数据集。通过有深度的项目展示,体现业务思维和潜力,才能在面试中脱颖而出,超越只会复现项目的竞争者。

Android_XG的博客 885

低资源下RLVR微调实战:数据、模型与样本效率的平衡艺术

在自然语言处理领域,模型微调是使预训练大模型适应下游任务的关键技术。其核心原理是通过在特定任务数据上更新模型参数,使其学习到任务相关的知识分布。参数高效微调(PEFT)技术,如LoRA,通过引入低秩适配器,极大地降低了微调对计算资源的需求,为资源受限场景提供了可行方案。这一技术的核心价值在于,它使得个人开发者和小型团队也能利用大模型的能力,推动了AI技术的民主化。在模型对齐,特别是基于人类反馈的强化学习(RLHF)中,奖励模型的训练至关重要。然而,高质量人类反馈数据稀缺且标注成本高昂,构成了主要瓶颈。本文聚

weixin_30736301的博客 324

超越复刻:大模型微调项目全流程包装指南,让简历脱颖而出

本文针对大模型算法岗新人,强调微调项目不应仅是技术复现,而应注重"营销"包装。核心观点包括:避免简单复现项目,应自行构建独特高质量数据集;设计科学系统的评测方法;采用"case驱动"优化数据而非过度依赖调参。通过展示业务思维和创新意识,将"玩具"项目包装成有深度、有亮点的作品,从而在面试中脱颖而出,超越只会复现项目的竞争者。

aolan123的博客 1401

大模型优化实战:提示工程、RAG与微调三大技术路径选型指南

在构建企业级AI应用时,如何让大语言模型(LLM)更好地服务于特定业务场景,是开发者面临的核心挑战。其技术原理在于,基础大模型作为通用知识库,需要通过特定方法注入领域知识或调整其行为模式,以提升任务执行的准确性和专业性。从技术价值看,这直接决定了AI应用的落地效果与成本效率。针对不同的应用场景,业界主要形成了三种主流优化范式:提示工程(Prompt Engineering)通过优化输入指令来引导模型输出,实现零成本快速迭代;检索增强生成(RAG)通过引入外部知识库,赋予模型实时、准确的私有知识查询与回答能力

weixin_33725126的博客 412

eCognition易康面向对象分类批量选择样本,批量导出shp

可以的,使用这个工具条最右边那个三角尺manual editing toolbar,这是用来直接指定类别的,咱们可以拿它选完以后把指定的类别转成训练样本。另一个好处是,这个选出来的样本可以直接导出成shp,但select sample是不可以的,只能导出TTAMask也就是栅格掩膜。如果要导出shp,要在转之前导出。中间那条有点点的红线就是我的鼠标轨迹,只要碰到的对象就会全部选中,然后一点3的那个按钮就直接全部划分为林地了,十分丝滑。在弹出来的工作条里,首先选择你的类别,比如这里选一个forest。

qq_61845364的博客 4070

收藏必备!AI大模型微调项目保姆级教程:从零基础到面试通关,这一篇就够了!

本文分享如何将AI大模型微调项目"营销"给面试官,强调数据质量与多样性比数量更重要,建议自制独特数据集体现业务思维;提倡科学评测模型效果而非主观感受;指出调参不如优化数据,应采用"case驱动"方法。通过深度思考和项目包装,新人算法工程师可超越简单复现项目的竞争者,展现业务潜力与创新能力。声明:本文含大语言模型生成内容为0,图片则使用Dall-E3生成。

Everly_的博客 834

LoRA训练成败关键:数据集质量与rank/alpha参数调优实战指南

LoRA(Low-Rank Adaptation)作为一种高效大模型微调技术,其核心并非增强模型知识容量,而是精准调控预训练模型在特定任务上的行为响应能力。其训练效果高度依赖两个底层要素:高质量、高对齐度的指令-响应数据集,以及rank与lora_alpha这对耦合超参数的科学配比。数据噪声、格式错位或任务不聚焦会直接导致LoRA学习到错误的注意力模式;而rank设置过高易引发梯度震荡,alpha/r比值失衡则影响收敛稳定性。在客服问答、法律咨询、工业诊断等真实场景中,严格的数据清洗、信噪比控制、最小功能单

weixin_34090562的博客 458

KiCad插件安装太慢?试试华秋版,再手把手教你装这5个实用插件

本文介绍了KiCad华秋发行版如何解决插件安装慢的问题,并详细推荐了5个实用插件及其安装方法。华秋版优化了国内用户的下载速度,预装了常用扩展包,包括BOM生成器、3D模型增强工具等,显著提升PCB设计效率。

weixin_29184075的博客 547

Agilent N5230A矢量网络分析仪在射频器件S参数测试中的关键操作指南

本文详细介绍了Agilent N5230A矢量网络分析仪在射频器件S参数测试中的关键操作流程与技巧。内容涵盖从开机预热、校准(SOLT/ECal)、参数设置(频率、点数、功率、IFBW)到连接测量、数据保存分析的全过程,并分享了夹具去嵌入、时域分析等进阶功能与常见问题避坑指南,旨在帮助工程师获得精准可靠的散射参数测试结果。

kotlin6android的博客 401

大模型微调效果差?数据准备与参数设置优化

其实,大模型微调效果差,绝大多数时候不是模型本身的问题,而是两个环节出了问题——数据准备和参数设置。如果把学习率设得太大,模型会快速忘记预训练学到的通用知识,出现“灾难性遗忘”——原本能回答的问题,微调后反而答不出来了。好的微调数据,应该是“少而精”,而不是“多而杂”。举个例子,如果你想让模型学会做文本摘要,微调数据里全是“请总结以下内容”这种指令,那么当用户问“用一句话概括一下”时,模型可能就不知道该怎么办了。如果微调数据都来自同一个模板、同一种表达方式,模型学到的就不是“理解任务”,而是“匹配模板”。

renhongxia1的博客 656

SAP 运费处理方式

从直接的处理方式上看,情况1/2/3可以将运费记账到物料成本中,但情况4/5/6是直接记账到成本对象中,具体是要体现在损益表中,还是要结转到物料成本中,可依据业务要求进行好处理。如果体现在损益表中,不需要多过多额外的操作,如果要体现在物料成本中心,则需要再进行一系列的处理,最终将金额结转到物料成本中。因为在创建采购订单时不知道具体运费,可以不维护运费,只需要维护材料价格。:创建采购订单时,运费是由供应商承担,很多时候是包含在材料报价中,这种情况不需要专门针对运费进行处理,材料价格中已包含运费。

weixin_44506537的博客 3371

本地部署LLaMA-Factory并微调Qwen2.5模型

通过LLaMA-Factory框架在本地部署并使用LoRA微调Qwen2.5-7B-Instruct模型,结合自定义数据集进行训练、评估与对话测试,最终导出模型并用vllm部署为API服务,实现高效中文问答与角色扮演能力。

weixin_42230607的博客 1139

2025.1.16——五、LoveSQL1 sqlmap文件类|万能密码

题目来源:BUUCTF[极客大挑战2019]LoveSQL1。

2402_87387800的博客 1067

5、OpenClaw(龙虾助手)飞书机器人完整对接指南(2026最新版)

OpenClaw v2026.2.2+ 版本,防火墙内也能正常工作,是目前最稳定、最简单的企业内部AI助手部署方案。

欢迎光临~知1而N的博客 457

算法新人必看:如何巧妙包装你的大模型微调项目,提升简历吸引力!

本文针对算法岗求职者分享大模型微调项目的实战经验,强调营销思维比技术本身更重要。作者指出新手常犯的错误是简单复现教程项目,建议从数据入手构建独特数据集(如爬取聊天记录),并强调评测体系的重要性。文中提出"像工程师一样做评测"的理念,建议建立科学的评估标准和对比实验。最后提醒不要过度依赖调参,而应通过分析badcase优化数据质量。文章还附带了大模型学习资源包的推广内容。全文核心观点是:优秀项目应展现业务思维,数据质量比技术细节更能体现求职者价值。

m0_63171455的博客 944

FFDNet-pytorch版本代码训练教程

该文章为FFDNet-pytorch版本代码训练教程,抓紧订阅学习!尽早入门发论文哦!

假技术Po主 1507

大模型微调到底是什么?LoRA、SFT、RLHF 一次讲清楚

第一,它的输入是什么,来自用户、数据库、文档还是传感器;如果这个环节没有验证和兜底,后面即使接了更强的模型,也只是把风险包装得更像一个完整答案。比如本文中提到的场景,预训练成本极高,普通团队一般不会从零训练一个通用大模型,而是选择开源模型或商业模型作为底座。简单说,微调是在已经训练好的基础模型上,继续用一批特定数据训练,让模型在某些任务、格式、语气或领域上表现更好。实际方案可能是组合:底座模型负责语言能力,SFT 负责输出格式,RAG 负责最新知识,Prompt 负责当次任务约束,人工审核负责高风险内容。

争者留其名 264

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

【NLP】36. 从指令微调到人类偏好:构建更有用的大语言模型

从指令微调到人类偏好:构建更有用的大语言模型

weixin_48846514的博客 1282

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

大语言模型微调实战:从领域适配到生产部署

大语言模型(LLM)微调是将通用预训练能力转化为垂直领域专业能力的关键技术路径,其核心原理在于冻结主干网络、仅优化低秩适配参数,从而在保留世界知识的同时精准校准输出行为。相比提示词工程与RAG,微调在领域术语识别、结构化输出约束和业务逻辑建模三类场景中具备不可替代的确定性与泛化性。技术价值体现在低成本(单卡A100即可)、高效果(F1提升超20个百分点)与强鲁棒性(抗OCR噪声、ASR错误等)。典型应用场景覆盖智能客服意图识别、制造业维修报告生成、法律合同条款抽取及跨境电商多语种描述生成——这些正是Fine

weixin_33402252的博客 368

InternLM2-Chat-1.8B模型微调概念入门与实践指引

本文介绍了如何在星图GPU平台上自动化部署【书生·浦语】internlm2-chat-1.8b镜像,并对其进行轻量级微调。通过LoRA等高效方法,用户可利用该平台快速定制模型,使其在特定领域(如技术文档撰写、专业问答等)生成更符合需求的文本,实现个性化AI助手部署。

weixin_36282234的博客 217

ECG深度学习实战:预训练与数据规模如何影响模型性能

深度学习模型训练通常面临数据稀缺与计算成本高的挑战,其核心原理在于通过大量数据学习特征表示。预训练技术通过在大规模通用数据集上学习通用特征,能显著提升下游任务的数据效率与模型性能,这一技术价值在医疗、金融等数据获取困难的领域尤为突出。在医疗AI场景中,如心电图(ECG)信号分析,高质量标注数据获取成本极高。通过系统评估预训练微调策略与数据规模缩放实验,本实践发现,利用跨任务预训练或自监督学习,能在有限标注数据下实现性能的显著提升,并快速找到模型性能随数据增长的边际收益拐点,为资源受限的项目提供高效的启动路径

weixin_30480075的博客 1089

ms-swift + Mistral微调体验:小批量数据也能出好效果

本文介绍了如何在星图GPU平台上自动化部署ms-swift镜像,高效完成Mistral-7B模型的轻量级微调。仅需327条中文指令数据与单卡RTX 4090,即可在90分钟内实现客服话术生成、技术文档问答等企业级场景的精准适配,显著提升业务响应质量与一致性。

weixin_35829279的博客 125

大模型微调实战:LoRA、SFT与DPO技术解析与Llama-Factory应用指南

大语言模型微调是提升模型在特定领域表现的关键技术。其核心原理是通过在预训练模型的基础上,利用特定数据调整模型参数,使其输出更符合特定任务或人类偏好。这项技术的核心价值在于,能以相对较低的成本,让通用大模型快速适应专业场景,如企业知识问答、客服对话风格定制等。在工程实践中,参数高效微调方法(PEFT)如LoRA,通过冻结原模型参数、仅训练低秩适配矩阵,大幅降低了计算和存储开销。而监督微调(SFT)和直接偏好优化(DPO)则代表了两种核心训练范式:SFT侧重于通过指令-输出配对数据教会模型新知识或技能;DPO则

weixin_30471561的博客 361

LoRA微调实战:6小时打造业务专属大模型

大语言模型微调(Fine-tuning)是将通用基座适配垂直场景的核心工程能力,其本质并非重新训练,而是通过参数高效方法(如LoRA)对模型权重进行低秩增量更新,在保留原始知识的同时精准校准领域术语、格式与逻辑。相比全量微调,LoRA显著降低显存占用与计算成本,规避灾难性遗忘,支持消费级GPU快速验证。技术价值体现在可复现、可部署、零改造接入现有推理服务,广泛应用于金融文档解析、客服话术优化、法律合同审查等强结构化输出场景。本文聚焦LoRA在真实产线中的数据构建、配置调优、评估闭环与一键融合部署全流程。

weixin_30521161的博客 439
上一篇: AI Agent 的四层工程-小白也能看懂的 Agent 设计原理
下一篇: 美团面试官问:AI 能删库、发邮件、提交 PR,哪几步必须交给人?
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值