LoT视觉推理入门基础教程(非常详细),搞定知识型VQA看这篇就够了!

OpenViking上下文数据库Golang集成实践 技术创新文件系统范式:将AI Agent的上下文管理从扁平向量存储提升为结构化文件系统分层检索策略:L0/L1/L2三层加载机制,减少62.1%的Token消耗记忆自迭代:会话提交触发Agent经验沉淀,实现越用越智能工程实践完整Golang实现:提供生产级可用的OpenViking客户端库企业级集成方案:涵盖文档摄入、检索、会话管理等全流程性能优化成果:检索准确率提升24.1%,响应时间减少53.3%可观测性提升可视化检索轨迹:实现检索过程的白盒化,调试效率提升77.1%全面监控指标。 阅读详情

一、研究方向及背景

这篇论文属于多模态大语言模型(MLLM)与知识增强视觉问答(Knowledge-based VQA, KB-VQA)交叉方向,核心关注的是:当模型回答图像问题时,不仅要看图,还要结合外部检索到的文本知识,但这些知识往往有噪声、图像中真正相关的区域也未必能被模型准确关注,因此模型容易出现证据选择不准、推理受干扰的问题。论文提出一种无需训练、仅在推理阶段运行的方法,帮助 MLLM 在视觉证据和文本证据中“二次聚焦”,提升回答质量。

从更细的学术脉络看,它同时落在以下几个子方向中:

  1. 检索增强多模态推理

    :面向 KB-VQA,将外部知识与图像共同输入模型;

  2. 注意力机制解释与利用

    :把模型内部注意力当作“隐式相关性信号”;

  3. 推理时增强(inference-time enhancement)

    :不改模型参数、不额外训练,只在推理时动手;

  4. 多模态幻觉缓解与视觉定位增强

    :通过高亮真正相关区域,减少模型被无关内容误导。


二、主要研究方法或创新点
  1. 提出 Look Twice(LoT):让模型“先看一眼,再重点看一眼”

论文的核心方法叫 Look Twice (LoT)。它的思想很直观:
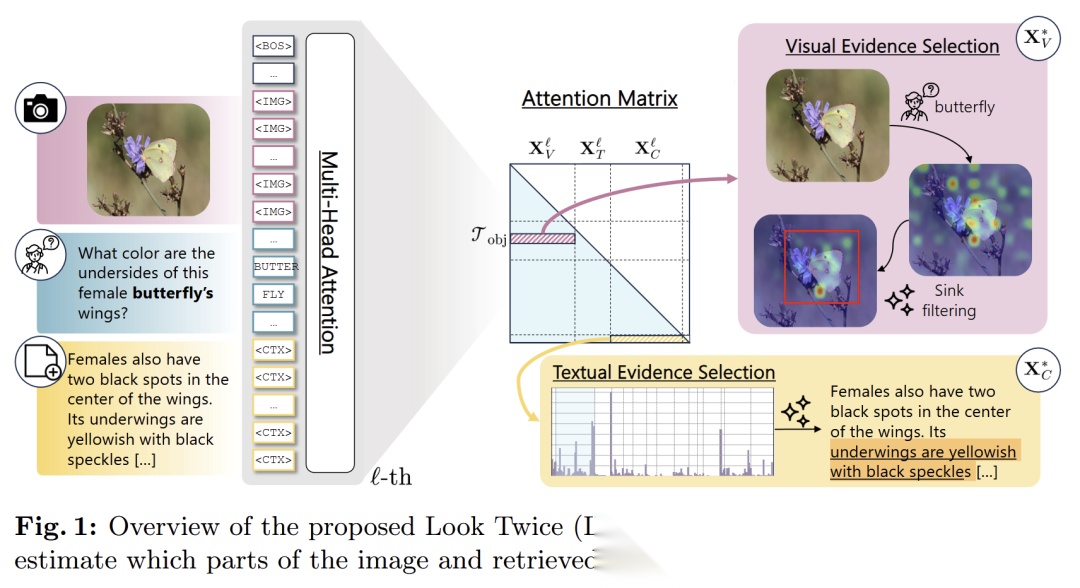
先让模型做一次非常轻量的前向分析,只生成一个额外 token,借此读取模型内部注意力;然后根据这些注意力判断“图里哪里重要、文本里哪句话重要”;最后再把这些关键证据显式高亮,送给模型进行正式回答。整个过程不需要重新训练模型,也不改模型结构。

论文在第 1 页和第 2 页就明确指出,LoT 的关键价值在于:利用预训练 MLLM 自己的内部注意力动态,做多模态证据筛选与再强调。这比重新设计复杂 RAG 流程或额外训练模块更轻量。

  1. 视觉侧创新:基于“问题对象→图像 token”的注意力做目标区域定位

在视觉证据选择上,LoT不是粗暴看整图,而是从问题中先识别出目标对象,比如问题里真正被问到的是“female butterfly”。然后它提取这些对象词 token 到视觉 token 的注意力,聚合多层、多头,得到每个视觉 token 的相关性分数,再形成二维注意力图。

这一点在图1(第5页)里画得很清楚:方法从问题、图像和检索文本三部分出发,分别做视觉证据选择和文本证据选择,最后把重要区域和重要句子高亮出来。图中上半部分展示了视觉证据选择,下半部分展示了文本证据选择。

  1. 视觉侧另一关键点:引入 attention sink filtering,抑制伪高响应区域

论文认为,MLLM 的注意力里存在类似“attention sink”的问题,也就是某些 token 或图像区域会无意义地吸走大量注意力,导致模型关注偏了。为此,作者设计了多层 attention sink 过滤机制:
先找出那些在隐藏维度上表现得像 sink 的视觉 token,再把它们从视觉相关性分数中压掉,使最终热图更集中到真正相关的目标区域。
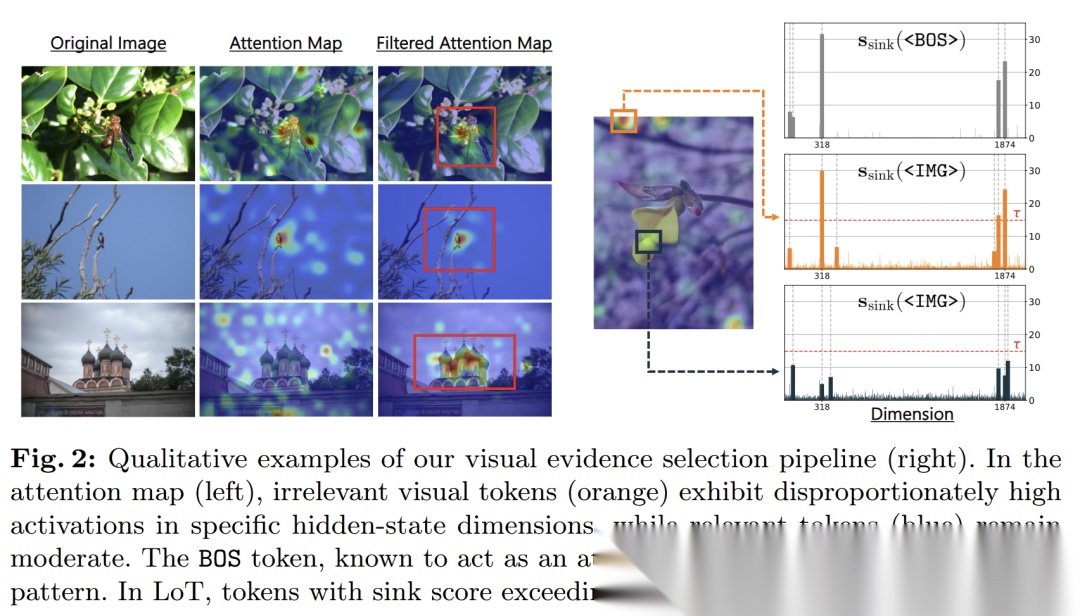
这一点在图2(第6页)特别重要。图2左边展示了原始 attention map,能看到许多高响应点其实并不对应目标;过滤之后的 attention map 明显更集中,红框也更贴近目标实体。图2右侧还展示了 sink token 在某些隐藏维度上的异常高激活特征。

  1. 文本侧创新:用“最后生成 token→上下文 token”的注意力选关键句

对于检索到的文本知识,LoT 不直接全盘相信,而是分析模型在生成答案前最后一个 token 对上下文 token 的注意力,计算每个句子的得分,再选出最相关的句子进行高亮。

换句话说,它不是重新训练 reranker,而是借助模型自身的注意力,找到“模型本来就最可能依赖的句子”,再把这些句子显式包上特殊标记,提醒模型重点使用。论文将这种方式称为 Self-Guided Textual Evidence Selection。

  1. 用 prompt-level markers 显式高亮证据,而非修改模型

LoT 的一个很实用的设计是:

  • 对文本证据,插入 <START_IMPORTANT_TXT> 和 <END_IMPORTANT_TXT>;
  • 对视觉证据,用裁剪出的关键图像区域插入 <START_IMPORTANT_IMG> 和 <END_IMPORTANT_IMG>。

第 21 页给出了具体 prompt 模板:系统提示会明确告诉模型,这些 marker 包围的内容是重要视觉/文本证据,不要把 marker 输出到答案里;用户模板则将裁剪图像和关键句子嵌入输入。这个设计说明论文不是靠新训练技巧取胜,而是靠推理时的证据组织方式优化。

  1. 只增加极小推理开销

作者强调,LoT 只要求多生成一个 token 来分析注意力,因此计算额外成本非常低。第 21 页统计显示,在 E-VQA 上用 Qwen2.5-VL-3B 时,最终回答平均生成约 18 个 token,多出来的 1 个 token 仅带来大约 5.6% 的生成开销。同时,视觉裁剪还把平均视觉 token 数从 291 降到 208,减少了约 28.5%。

这说明 LoT 不只是“效果涨一点”,而且在工程上也有较好的可部署性。


三、实验结果

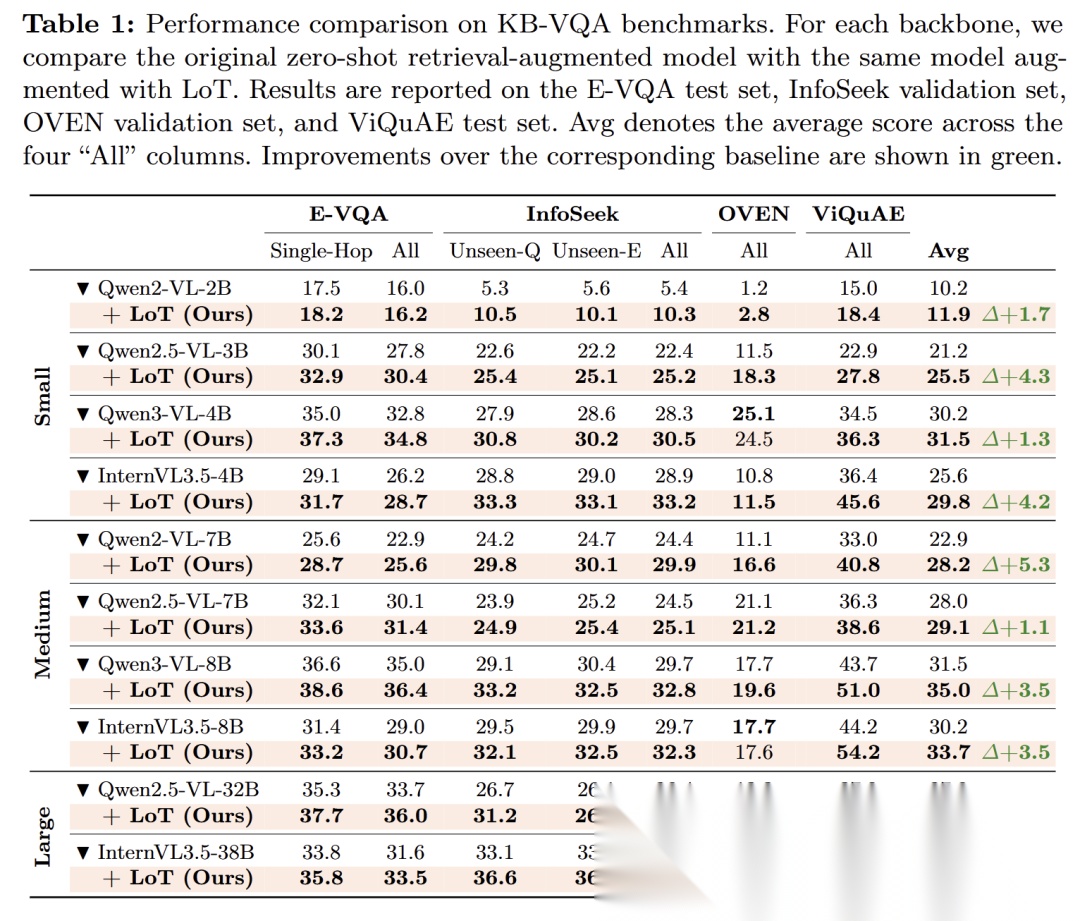
  1. KB-VQA 主实验:在多个数据集和多个模型上稳定提升

论文在 表1(第11页) 报告了 KB-VQA 主结果,覆盖 E-VQA、InfoSeek、OVEN、ViQuAE 四个基准,以及 Qwen2-VL / Qwen2.5-VL / Qwen3-VL / InternVL3.5-VL 多种不同规模模型。整体趋势非常一致:LoT 在所有模型规模上都能带来提升。

几个有代表性的结果如下:

  • Qwen2-VL-2B

    :平均分从 10.2 提升到 11.9,增益 +1.7;

  • Qwen2.5-VL-3B

    :平均分从 21.2 提升到 25.5,增益 +4.3;

  • Qwen2-VL-7B

    :平均分从 22.9 提升到 28.2,增益 +5.3;

  • Qwen3-VL-8B

    :平均分从 31.5 提升到 35.0,增益 +3.5;

  • InternVL3.5-38B

    :平均分从 34.1 提升到 37.5,增益 +3.1。

从这些结果可以看出,LoT 对小模型和大模型都有效,不是某个单一 backbone 的偶然收益。

  1. 在 InfoSeek 和 ViQuAE 上提升尤其明显

论文特别指出,LoT 在需要更强知识对齐和检索证据整合的场景里收益更显著。
例如在 InfoSeek 上,Qwen2-VL-2B 从 5.4 提升到 10.3;InternVL3.5-4B 从 28.9 提升到 33.2。
在 ViQuAE 上,InternVL3.5-4B 从 36.4 提升到 45.6,Qwen3-VL-8B 从 43.7 提升到 51.0。

这说明 LoT 更像是在“证据选择”这个瓶颈上发力,因此在知识密集型、多证据干扰强的任务上优势更大。

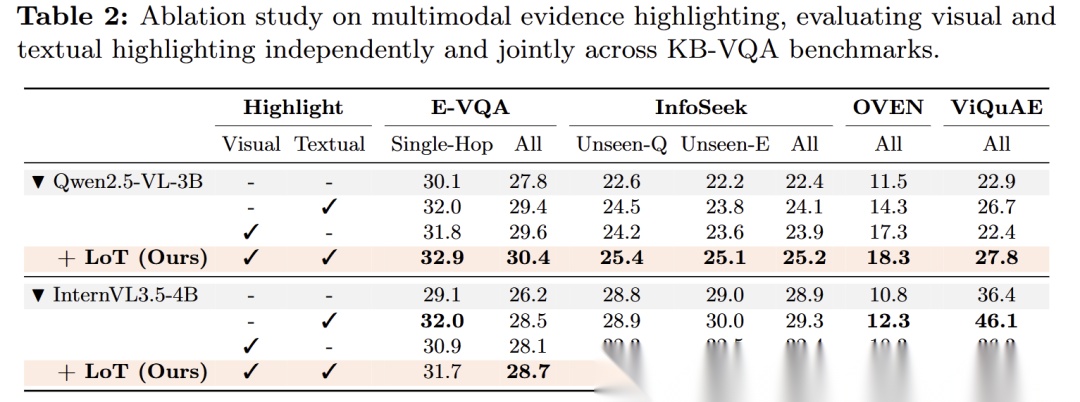
  1. 消融实验:视觉高亮和文本高亮都有效,联合最好

表2(第13页) 对视觉高亮、文本高亮、两者联合进行了消融。结果显示:

  • 单独做文本高亮,性能提升;
  • 单独做视觉高亮,性能也提升;
  • 二者结合时通常效果最好。

以 Qwen2.5-VL-3B 为例:

  • E-VQA All 从 27.8 提升到:
  • 文本高亮 29.4
  • 视觉高亮 29.6
  • LoT 全部启用 30.4
  • InfoSeek All 从 22.4 提升到:
  • 文本高亮 24.1
  • 视觉高亮 23.9
  • LoT 全部启用 25.2。

这表明视觉与文本证据是互补的,不是二选一。

  1. 检索文档越多时,LoT 更能抗噪声

论文在图4(第13页)左图研究了检索 passage 数量 n 的影响。结论是:随着检索文档数增加,普通 baseline 往往因为噪声变多而收益有限;但 LoT 仍能保持稳定提升,因为它能把真正相关证据从更多候选中挑出来并高亮。

这点对于实际 RAG 系统很重要,因为真实部署时检索结果很难做到完全纯净。

  1. 即便给 oracle evidence,LoT 仍有增益

图4(第13页)右图显示,即使直接给模型正确实体的 Wikipedia 页面,也就是“oracle evidence”,LoT 仍然能继续提升表现。

这说明它不仅是在“纠正检索错误”,更是在优化模型如何使用证据本身——即便证据本身是对的,模型也未必能第一时间聚焦最关键片段。

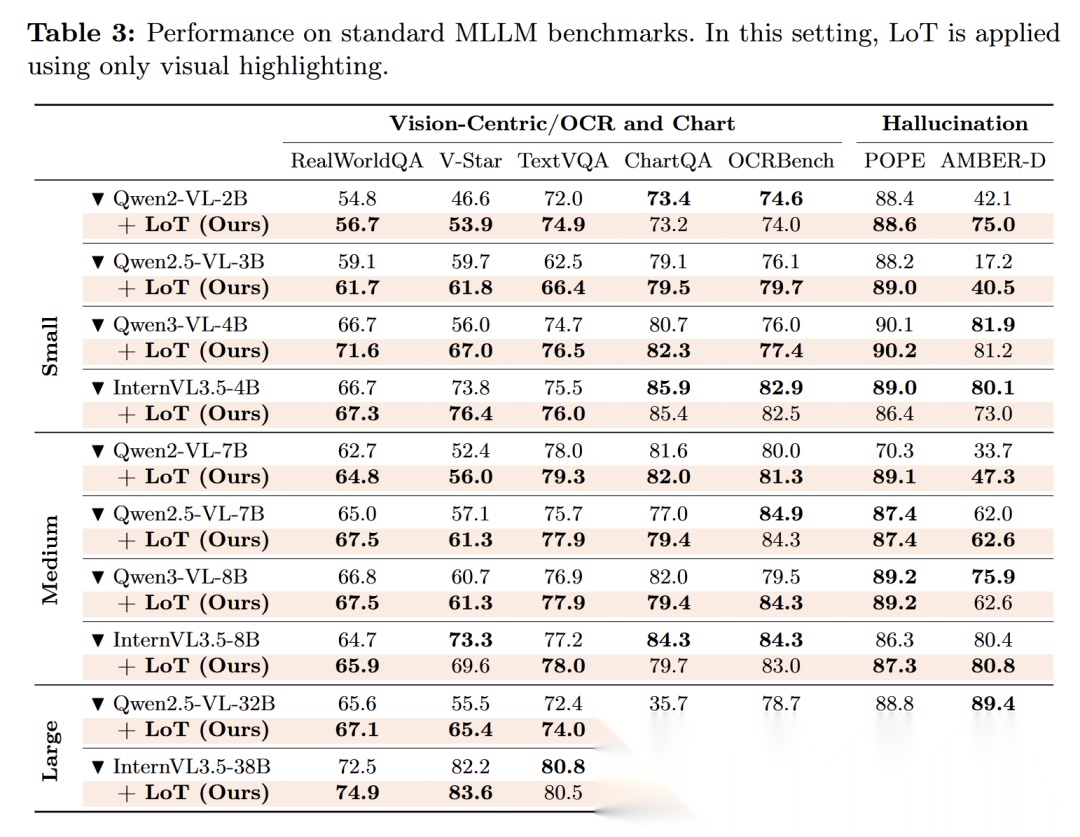
  1. 对一般多模态基准也有泛化能力

论文在 表3(第14页) 还测试了不带外部文本检索的标准 MLLM 任务,此时 LoT 只保留视觉高亮。结果显示,在 RealWorldQA、V-Star、TextVQA、OCRBench、ChartQA、POPE、AMBER-D 等任务上,多数模型都能取得提升或持平表现。

例如:

  • Qwen2.5-VL-3B 在 RealWorldQA 从 59.1 提升到 61.7;
  • 在 V-Star 从 59.7 到 61.8;
  • 在 TextVQA 从 62.5 到 66.4;
  • 在 OCRBench 从 76.1 到 79.7;
  • 在 AMBER-D 从 17.2 大幅提升到 40.5。

这说明 LoT 不只是 KB-VQA 专用技巧,它对一般视觉定位、OCR、图表理解和幻觉抑制也有帮助。

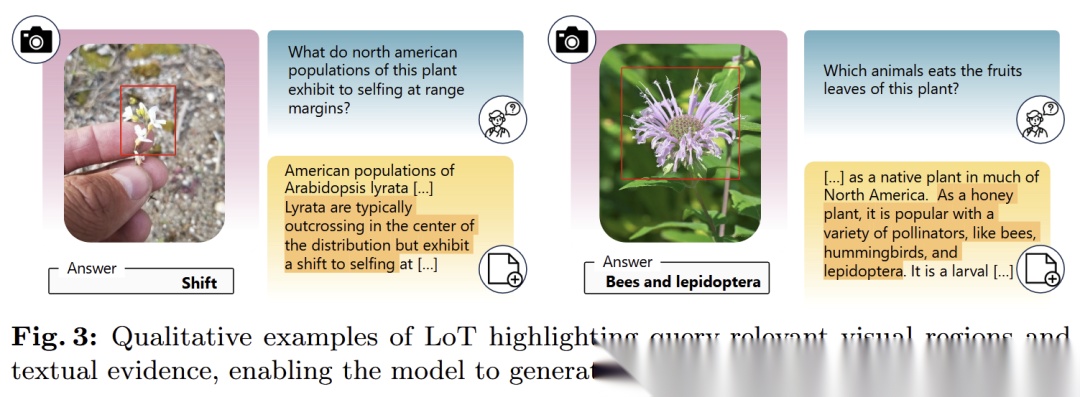
  1. 定性结果说明方法确实找到了“该看哪里、该读哪句”

论文的图3(第12页)和图6(第24页)展示了多个 KB-VQA 定性例子:
模型会把问题对应的目标对象框出来,同时从长段检索文本里高亮出真正回答问题的那一句,然后成功给出正确答案。

而图7(第24页)则展示了在 POPE 和 AMBER 等幻觉基准上的例子,说明视觉高亮可以帮助模型更准确地判断图中到底有没有目标物体。


四、总结

这篇论文的核心贡献,不在于提出一个更重、更复杂的多模态 RAG 体系,而在于提出一种极轻量、训练自由、推理时可插拔的方法 LoT。它利用模型自身内部注意力,把“相关的图像区域”和“相关的文本句子”先找出来,再显式高亮给模型看,从而提升知识型视觉问答的准确率。

它的优点主要有三点:
第一,无需训练,易于迁移到现有 MLLM;
第二,额外成本小,只增加一个 token 的前置分析;
第三,泛化性强,不仅 KB-VQA 提升明显,在一般视觉问答与幻觉评测上也有效。

当然,这篇文章也有一定局限:它本质上仍依赖模型内部注意力是否能可靠反映“相关性”;如果注意力本身偏差很大,LoT 的上限也会受到影响。但就论文呈现结果来看,这种“从模型内部挖掘证据,再反过来指导模型自己”的思路,非常适合做轻量级推理增强,具有很强的方法学启发意义。

学AI大模型的正确顺序,千万不要搞错了

🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!

有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!

就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋

在这里插入图片描述

📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇

学习路线:

✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经

以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!

我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

视觉特征-自监督-掩码特征预测【2026-03】:V-JEPA2.1【2B】【全Token稠密预测损失】【多层深度自监督】【图像/视频多模态Tokenizer】【160万小时视频】【1.42亿张图像】 Lorenzo Mur-Labadia1,2,∗, Matthew Muckley1, Amir Bar1, Mido Assran1, Koustuv Sinha1, Mike Rabbat1, Yann LeCun1, Nicolas Ballas1,†, Adrien Bardes1,†1FAIR at Meta, 2Universidad de Zaragoza ∗Work done at Meta, †Joint last authorWe present V-JEPA 2.1, a family 阅读详情

相关推荐

用AI学习graphify

Graphify是一个AI驱动的知识图谱构建工具,能够将代码、文档、论文、图像和视频等多模态数据转换为结构化知识图谱。其核心技术特点包括: 多模态处理能力: 支持25+编程语言的AST解析 处理PDF、Markdown等文档 集成Whisper进行音视频转录 高效知识提取: 采用确定性AST解析与LLM语义提取结合 相比直接读取源文件,查询token消耗最多减少71.5倍 增量更新机制仅处理变更文件 智能分析功能: 自动识别高中心性的"上帝节点" 发现跨领域的"意外连接&quo

我的专栏 752

基于RAG的企业智能客服项目,已拿70万offer!

基于 RAG 构建一套企业智能客服系统📖。

m0_59164520的博客 1453

到底什么是Harness工程?一篇文章从入门到企业落地全解析

随着OpenClaw爆火,Harness Engineering(驾驭工程)成为AI编程时代的热门概念,很多小白对其感到陌生。本文用通俗类比和真实案例,避开复杂术语,从基础定义入手,讲清Harness Engineering的核心逻辑——人类工程师设计“约束系统”(马具),让AI模型(烈马)安全高效地完成代码工作,同时拆解其核心组件、企业落地场景和实战成果,帮小白快速入门,读懂这项能解放人力、提升效率的新技术,轻松掌握它的核心价值和落地思路。

program哲学 3291

从Vibe Coding到可控生产力:Harness Engineering的实践启示

摘要:OpenAI提出的Harness Engineering(工程化治理)理念为AI Agent时代的软件工程提供了关键方法论,旨在解决代码高产出下的质量闭环、上下文管理等核心矛盾。其三大目标包括重构工程师角色、将AI纳入可控体系、实现低成本纠错,通过六大举措(如角色重构、机械化约束、反熵机制等)重构工程流程。该理念与vibe coding高度互补,既保留灵感驱动的敏捷性,又通过工程化体系保障稳定性,最终推动工程师从"代码生产者"升级为"工程体系设计者"。

小程故事多的博客 4403

手机拍照也能玩高光谱?教你用TensorFlow Lite在Android上实现实时RGB转高光谱

本文介绍了如何利用TensorFlow Lite在Android设备上实现实时RGB到高光谱的图像重构技术。通过深度学习模型优化和移动端部署策略,使智能手机具备专业级光谱分析能力,适用于农业检测、化妆品分析等多个领域。

weixin_29091105的博客 247

别再只盯着MES了!半导体/面板厂CIM系统全家桶(EAP/YMS/SPC)保姆级入门指南

本文深入解析半导体制造中的CIM系统,涵盖EAP、YMS和SPC等关键子系统的协同工作。通过实战案例和技术细节,展示如何利用CIM系统提升生产效率、良率管理和设备维护,为半导体/面板厂提供全面的实施指南和优化策略。

weixin_33693070的博客 464

基于LoT技术的知识型视觉问答(VQA)实战指南

多模态大语言模型(MLLM)通过融合视觉与文本信息,正在重塑视觉问答系统的技术范式。LoRa over Transformers(LoT)作为高效的微调方法,通过低秩矩阵分解显著降低训练成本,使消费级GPU也能处理复杂的视觉推理任务。知识型VQA需要模型结合图像内容与外部知识进行深度推理,这传统上依赖复杂的知识图谱构建。现代解决方案采用检索增强生成(RAG)技术,将多模态模型的视觉理解能力与动态知识检索相结合。在医疗、教育等专业领域,这种技术能实现从药材识别到症状分析的端到端推理。MiniGPT-4等中文优

weixin_29051193的博客 278

ESP32 Arduino学习篇 (一) 引脚和串口的基本使用

简单来讲arduino就是通过源代码控制开发板的信号输入输出从而实现对一些电子元件的控制,例如LED灯,蜂鸣器,按键arduino程序首先来讲arduino程序是基于C语言,而实现类似对于LED灯和蜂鸣器的简单控制只需简单C语言知识即可实现。arduino程序是基于函数的,而在arduino的库有很多函数,我们只需要调用即可。arduino的程序主体是**setup()函数和loop()**函数以及其它在使用过程中需要构建的函数:setup()函数。

DOF526570的博客 1万+

LoT视觉推理与知识型VQA技术解析与应用实践

视觉推理作为多模态人工智能的核心技术,通过结合视觉特征与逻辑推理实现图像深层理解。其技术原理主要基于视觉编码、符号转换和逻辑推理三层架构,其中CLIP、DINOv2等视觉骨干网络与Prolog推理引擎的协同工作尤为关键。在知识型视觉问答(VQA)场景中,该技术能有效解决需要常识推理的复杂问题,如医疗诊断、工业质检等垂直领域。通过融合知识图谱与神经符号计算,系统准确率可提升40%以上。当前最前沿的LLaVA-1.5框架结合ConceptNet知识库,已成为实现工业级视觉推理系统的优选方案。

weixin_29055137的博客 203

基于MCP协议的AssistAI:深度集成Eclipse的AI编程助手实战指南

在AI辅助编程领域,大型语言模型(LLM)与开发工具的深度集成是提升开发效率的关键。其核心原理在于通过标准化的协议(如MCP,Model Context Protocol),将IDE的功能封装为AI可调用的工具集,从而实现环境感知与操作同步。这项技术的价值在于打破了传统AI编程工具与开发者工作流的割裂,使AI能够以符合工程规范的方式直接操作项目,如进行代码重构、运行测试和交互式调试。其典型应用场景包括复杂代码导航、自动化测试生成与精准的增量编译。本文以Eclipse插件AssistAI为例,详细解析了如何通

weixin_42531579的博客 564

ComfyUI安装包运行前准备:增加虚拟内存

在Windows系统中,虚拟内存是一种重要的系统资源管理机制,它主要通过将硬盘空间用作内存来扩展系统的可用内存容量。以下是虚拟内存的主要作用: 1. 扩展物理内存容量 当物理内存(RAM)不足时,系统会将一部分数据从内存转移到硬盘上的虚拟内存区域(也称为“分页文件”或“交换文件”)。这样可以为正在运行的程序提供额外的“内存空间”,确保系统能够继续运行,而不会因为内存不足而崩溃。 2. 提高系统稳定性 虚拟内存为系统提供了一个缓冲区。如果没有虚拟内存...

聚梦小课堂 1万+

Transformers pipeline 推理管道实战指南:音频、视觉、文本与多模态模型的一站式调用

本文基于 Transformers 仓库的官方文档 [pipeline_tutorial.md](https://link.gitcode.com/i/e91c0d8de44a1adde5d0cfe7d3e6ac8f) 展开,讲解 `pipeline()` 这一统一推理抽象的完整用法:从一行代码加载默认模型完成语音识别、图像分类、零样本文本分类与文档问答,到 `device`、`dtype`、`d

gitblog_01173的博客 250

ZYNQ RFSoC 的DAC如何做到从 0到Fs频段 信号输出

之前一直没太了解 RFSoC 的DAC如何输出在 Fs/2 到 Fs 频率范围内的信号,例如 ZCU216中的 ZU49DR,其RF-DAC最大采样率是 9.85GSPS,如果想输出的信号中心频率在5.8G,它是如何有效输出在第二奈奎斯特区域范围的信号的。

weixin_44630490的博客 1555

Hugging Face Transformers Pipeline 推理实战指南:核心参数、数据集迭代与大模型部署

本文基于 Transformers 官方 Pipeline 教程([docs/source/es/pipeline_tutorial.md](https://link.gitcode.com/i/b84a998dd62a864c50d974aa95279b31),西班牙语版;英文等其他语言版本位于 [docs/source/](https://link.gitcode.com/i/a2708b0b

gitblog_00597的博客 472

杰理SDK入门教程(一):编译环境的安装和程序下载

本文档提供了杰理SDK在Windows系统下的开发环境配置与代码编译指南。主要内容包括:1) 开发环境安装步骤,需下载Code::Blocks和杰理工具链;2) 编译过程中常见问题的解决方案,如安全警告提示和链接文件缺失问题;3) 代码编译流程说明,包括打开工程、连接开发板、执行编译等步骤。文档特别强调了强制升级模式的操作方法,并指出需避免点击运行/调试按钮。最后提示了杀毒软件可能误报工具链的注意事项。

qq_42014563的博客 2746

逻辑判断1-逻辑基础知识

判断推理学习笔记

小y的学习笔记 2138

大模型工程化:从Prompt到Harness,驾驭AI生产力新时代

大模型工程化三大范式:提示词工程、上下文工程与驾驭工程 摘要:随着大模型技术的成熟,行业焦点转向如何实现能力稳定落地。文章系统阐述大模型工程化的三大范式:提示词工程(Prompt Engineering)作为基础,通过标准化指令引导模型输出;上下文工程(Context Engineering)通过信息注入解决知识边界与幻觉问题;驾驭工程(Harness Engineering)构建全链路管控体系。三者呈递进互补关系,共同支撑生产级应用。当前趋势呈现三大特点:自动化Prompt优化、多模态场景融合、体系化管控

m0_63171455的博客 1861

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

graphify构建代码知识库,一行代码搭建属于自己的知识图谱

graphify 是一个将任意文件夹(代码、文档、图片、视频等)转化为可查询知识图谱的工具。它的核心理念是:与其让 AI 逐文件读取,不如先把所有内容构建成一张图,让 AI 按图索骥。 你可以把它理解为一个"代码库地图生成器"。输入一个项目目录,它会分析所有文件,提取概念、关系、调用链,然后用可视化的方式呈现给你。更重要的是,这张图是可以查询的——你可以问"认证模块和数据库之间有什么关系",而不需要自己去 grep 几十个文件。

努力前行,总会成为自己心中的那道光 8550

贝叶斯统计 [韦来生编]

贝叶斯(Bayes)统计是近几十年来迅速发展起来的数理统计的一个重要分支。贝叶斯方法与经典统计方法的主要不同之处是进行统计推断时除了利用样本信息外,还要利用参数的先验信息,因此可以提高统计推断或统计决策的效果。它在经济、金融、生物、医学、自然科学和社会科学等许多领域具有广泛的应用。贝叶斯方法的研究已渗透到了统计学的几乎所有领域。作者在给中国科学技术大学概率论与数理统计专业本科生开设的“数理统计”课程中有一章专门讲授“贝叶斯方法和统计决策理论”,近十年来也给中国科学技术大学概率统计专业研究生开设过几次“贝叶斯分析”课。本书是在对过去讲稿的内容作了适当的增减和调整的基础上完成的。  本书共分六章。第1章是绪论,介绍了贝叶斯统计的若干基本概念,同时对必要的数理统计的基础知识有重点地作了回顾。第二章介绍了确定先验分布的若干可供选择的方法。第三章介绍了几类常见统计模型参数的后验分布的主要结果和计算方法。第四章和第五章分别介绍了“贝叶斯统计推断”和“贝叶斯统计决策”的内容。第六章介绍了贝叶斯统计计算的若干方法,包括蒙特卡洛方法和马尔可夫链蒙特卡洛(MCMC)方法以及相关统计软件的简介。本书的每一章附右大量的例题和习题,书末附有常用的几个表格和部分习题解答供读者查用。  大约可在54学时内讲授本书的第1章至第六章的主要内容,教师可根据学时需要选讲本书第1章至第六章的部分内容。书中标“*”号的章节可略去不讲,留给读者作为阅读材料。第六章例题中的R代码和部分例题的数据文件等可从作者个人主页下载。  作者在编写本书的过程中参考了J.O.Berger教授的《统计决策论及贝叶斯分析》和茆诗松教授编写的《贝叶斯统计》等书中的一些内容,以及《贝叶斯分析》一书中由张伟平博士编写的有关贝叶斯统计计算的一些内容。在此表示衷心感谢。  本书编写准备过程中,中国科学技术大学统计与金融系的几个研究生帮助完成了本书部分中文的录入和排版,作者对他们的辛勤工作表示真诚的感谢。高等教育出版社为本书的出版给予了大力支持。在此一并致谢。

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

GitNexus 核心引擎深度解析

GitNexus 核心引擎深度解析:GitNexus 是一个将代码库转换为可查询知识图谱的系统,由索引流水线、社区检测和混合搜索三大子系统组成。索引流水线通过9个阶段将代码转换为知识图谱,支持多语言解析和并行处理。社区检测采用Leiden算法进行功能聚类,流程追踪则通过BFS算法从入口点生成执行流程。混合搜索结合关键词和语义搜索,使用RRF算法融合结果。系统优化包括Worker池并行解析、语言感知导入解析、调用关系置信度计算等,实现了高效的代码分析与搜索能力。

2843

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

Harness Engineering:2026年最被低估的工程革命

2026年2月,OpenAI的工程师Ryan Lopopolo在官方博客发布了一篇看似平淡的技术文章。文章描述了一个内部实验:一个3人小组,用5个月时间,构建并上线了一个拥有百万行代码的生产级产品。

xx_nm98的博客 1090

Harness Engineering(驾驭工程)核心解析

Harness Engineering(国内常译“驾驭工程/管控工程”)是2026年Agent开发领域爆火的新一代工程化范式,是AI工程化从“提示工程→上下文工程”之后的第三次范式跃迁,核心解决Agent在生产环境中长期可靠运行的核心痛点。

weixin_58753619的博客 1402

Graphify从入门到精通(非常详细),彻底搞懂下一代AI知识库,看这一篇就够了!

Graphify是一款开源命令行工具,由开发者captainkink07在Andrej Karpathy发文后连夜构建。它能将任意文件夹一键转化为持久化知识图谱,支持19种编程语言,与Claude Code深度集成,实现每次查询减少71.5倍token消耗。上线48小时内获得逾6000个GitHub星标,零遥测、无厂商锁定,数据永不离机。

m0_59164520的博客 7516

驾驭未来:零基础读懂“驾驭工程”(Harness Engineering)

在混乱中建立秩序,在复杂中寻找路径。

举世誉之而不加劝,举世非之而不加沮,定乎内外之分,辩乎荣辱之境,斯已矣。 2524

OpenViking 深度解析:字节跳动为 AI Agent 设计的上下文数据库

OpenViking 是字节跳动火山引擎 Viking 团队于 2026 年 1 月开源的上下文数据库(Context Database),专为 AI Agent 设计。。把 Agent 所需的一切——记忆、资源文档、技能说明——统一抽象为"文件",组织在一个虚拟文件系统中,通过专属协议viking://进行寻址和访问。OpenViking 解决的是真实存在的问题,技术思路也有其创新之处——用文件系统范式统一管理 Agent 上下文,L0/L1/L2 分层加载在 token 效率上确实能做到显著优化。

潇汀 2394

一文分清用法Dify-Plugin与SkillS

很多人会把插件(Plugin)和Skill(技能)混为一谈,二者看似都是为应用拓展能力、实现更多功能,核心定位、适用范围、使用方式却有着明确差异。

legend24and8的博客 1852

dify查询接口响应到默认的图表渲染

之后走两条线,一条线流式响应返回数据分析的回复,另一条线走图表生成线,负责生成合适的图表。由于ECharts图表生成插件,支持生成的图表有柱状图,线形图,饼图,那么我们可以设置一个问题分类,然后对于数据分类的结果再做模型数据的抽取。在工作流中新建接收http请求的节点,用以接收http请求体数据。实现的效果:可以根据请求体自定义生成合适的图表数据。数据输入:来自于http请求体的数据。插件:ECharts图表生成插件。

qq_43781332的博客 812
上一篇: 多模态Agent从入门到精通:AgentVista全解析,收藏这篇就够了!
下一篇: 一文搞懂Milvus:从基本概念到Schema定义、向量搜索全解析
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2841原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值