【硬核干货】BEiT-v3多模态大模型全解析:一个模型架构通吃图像+文本,AI开发者的“大一统“神器!

从BEIT到VLMo再到BEIT v3:微软团队的多模态预训练‘分阶段’策略演进与实战避坑指南 本文深入解析微软团队从BEIT到VLMo再到BEIT v3的多模态预训练‘分阶段’策略演进,重点探讨VLMo的混合模态专家(MoME)架构和三阶段训练方法。通过视觉预训练、语言预训练和多模态微调,实现高效知识迁移与参数共享,为处理多模态数据稀缺场景提供实战指南。 阅读详情

0. 背景

不论是在Language、Vision还是在多模态领域,Big Convergence是大势所趋。

也就是在超大的数据集上做大规模的预训练,一旦模型训练好之后,它的特征就已经非常好了,可以直接Transfer到下游任务上去,尤其是当模型足够大、数据足够多的时候,有可能预训练出来一个有通用性能的Foundation Model,这个Foundation Model能解决各种的模态或者各种下游任务,非常的强大。

相比之前的多模态模型如CLIP和CoCa,BEiT-v3 的关键词就是:Big Convergence大一统,即:将图像看成一种“语言”,用一个模型架构和一个训练任务,打造出多模态领域的集大成者,统一多模态学习中的模型结构、预训练任务以及模型规模。

BEiT-v3 使用Transformer模型统一处理视觉和文本信息,使用Mask Data Modeling的训练策略统一建模视觉和文本信息。

  • BEiT-v3从三个方面实现了大一统:
  • 模型架构 Multiway Transformer
  • 其实就是VLMo中MoME
  • 统一输入形式(将图像看作是一种“语言”),文本English、图像Imaglish、图文对 Parallel Sentences
  • 预训练任务 Mask Data Modeling
  • 输入形式统一之后,也就不需要ITC、ITM、MLM等其他目标函数,可以使用统一的mask “language” modeling 的方式进行训练
  • 模型scaling up(将模型放大)
  • 模型扩大到了ViT-giant的配置,参数量达到了1.9B(vision/language各一半),提升多模态效果

1.模型架构

1.1 架构详解

BEiT-v3采用的是VLMo中使用的MoME(Mixture-of-Modality-Experts),这里改了个名字叫Multiway Transformer.
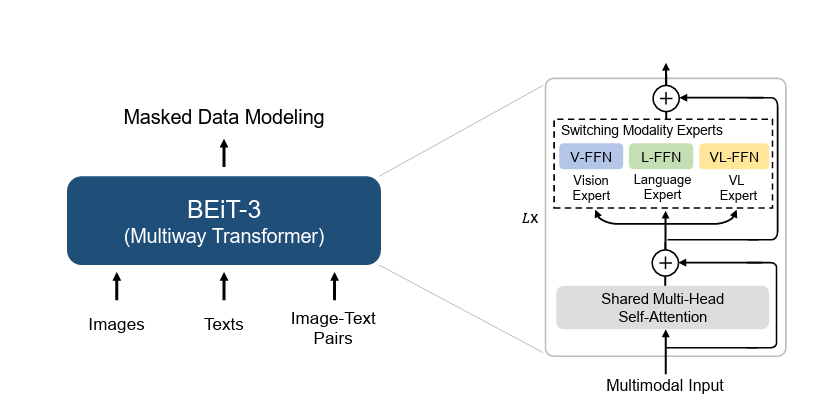
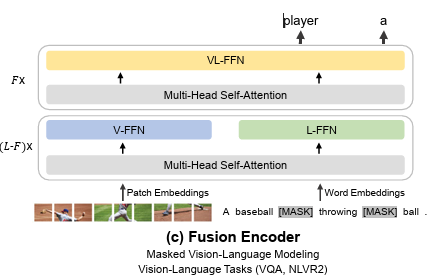
  BEiT-v3 预训练一个模型,通过模块化的搭积木,就可以灵活处理各种下游任务(每一个训练好的Transformer Block、SA层、FFN都可以随意的拼装和组合)。

输入的数据根据模态的不同选择不同的Expert,比如图片数据就使用Vision FFN,文本数据就使用Language FFN。模型前面的一些层是只有Vision FFN 和Language FFN,到了最后3层为了特征融合会再有 Vision-Language FFN.
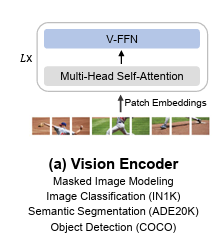
  • 图中(a)所示是BEiT-v3模型转换为视觉编码器,适配任务:图像分类,目标检测,语义分割;
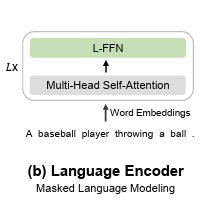
  • 图中(b)所示是BEiT-v3模型转换为文本编码器;

  • 图中©所示是单塔结构,联合编码图像-文本对以进行深度交互的融合编码器,适配任务:多模态理解任务;
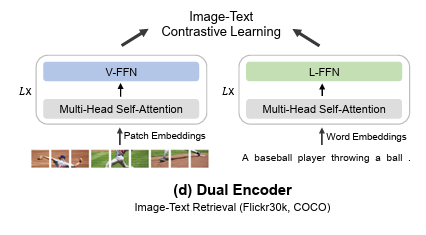
  • 图中(d)所示是双塔结构,对每个模态进行单独编码以求高效的图文检索,适配任务:图文检索任务;
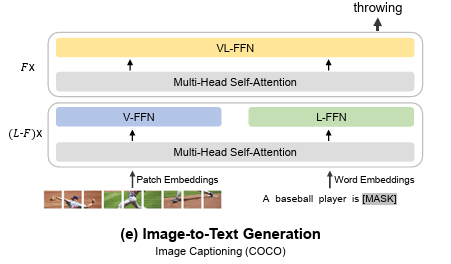
  • 图中(e)所示是单塔结构,用于图像到文本生成任务,适配任务:多模态生成任务。

1.2 Multiway Transformer详解

1.2.1 为什么需要 Multiway Transformer?

在 BEIT-3 之前,多模态模型面临一个根本性矛盾:

模型类型优势劣势
双编码器 (Dual Encoder)(如 CLIP)推理快,内存小,适合检索。图像和文本在训练后期才对齐,缺乏深层交互,不适合 VQA 这类需要精细推理的任务。
融合编码器 (Fusion Encoder)(如 ViLT, ALBEF)图像和文本 token 在每一层都深度交互,适合复杂理解计算慢,内存消耗大,不适合任何需要高效推理的场景。
编码器-解码器 (Encoder-Decoder)(如 OSCAR, CoCa)适合生成任务(如 Captioning)。架构复杂,不灵活,解码器对于纯分类任务是冗余的。

根本问题:这些架构是互斥的。你无法用同一个模型,既高效地做检索,又深度地做问答。

Multiway Transformer 的设计目标就是:创建一个单一的、可微调的骨干网络,它既能作为双编码器高效运行,又能作为融合编码器深度交互,还能作为序列生成器生成文本。

1.2.2 Multiway Transformer Block 内部原理
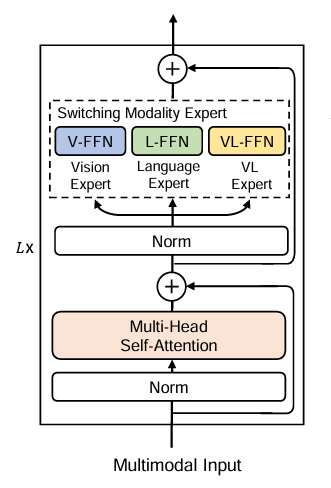
Multiway Transformer 的基本单元叫 Multiway Transformer Block,它被堆叠了 40 层,形成完整的骨干。这个 block 的结构可以拆解为以下两个核心组件:

1. 共享的多头自注意力(Shared Multi-Head Self-Attention, MSA)
  1. 共享的多头自注意力(Shared Multi-Head Self-Attention, MSA)
  • “共享”的含义:所有输入序列的 token(无论是图像 patch 还是文本 word),都通过同一个多头自注意力模块进行处理。
  • 计算过程:标准的 Attention(Q, K, V)。
  • Q (Query), K (Key), V (Value) 向量都由输入 embeddings 通过线性层得到。
  • 计算所有 token 对之间的注意力权重: 。
  • 关键作用:
  • 跨模态对齐(Cross-modal Alignment):这是实现图像和文本“对话”的物理基础。例如,文本中的单词 “cat” 会通过高注意力分数“看到”图像中“猫”的区域。共享的MSA允许这种跨模态的信息流动。
  • 统一交互空间:为所有模态提供一个共用的交互平台,避免了为不同模态设计独立的注意力机制。
2. 模态专家前馈网络(Modality-Specific Feed-Forward Networks / Experts)

这是 “多路(Multiway)” 的具体体现。与共享的 MSA 不同,FFN 层是按模态划分的。 BEIT-3 定义了三个池中的 三种专家:

专家类型处理的 Token 类型使用层
视觉专家 (V-FFN)图像的 patch embeddings所有 40 层
语言专家 (L-FFN)文本的 word embeddings所有 40 层
视觉-语言专家 (VL-FFN)混合模态的 token (在图文任务中)仅顶层 3 层

每个专家本质上是一个标准的两层前馈网络(MLP):

但它们的参数矩阵 是完全独立的,不会跨模态共享。

3. 路由机制(Modality Routing)

这是将“共享”与“分离”结合起来的关键机制。它可以看作是一个“智能开关”。 在每个 Transformer Block 内:

  1. 输入的 token 序列进入 共享 MSA 层进行处理,所有 token 可以互相“看到”。
  2. MSA 的输出是一系列经过注意力加权的新表示。
  3. 核心步骤:系统为每个 token 贴上一个“模态标签”(是“图”还是“文”)。
  4. 根据这个标签,MSA 的输出被路由(Routed)到对应的 FFN 专家中:
  • 来自图像块的 token → 送入 V-FFN 进行计算。
  • 来自文本词元的 token → 送入 L-FFN 进行计算。
  1. (顶层特殊处理)在第 38、39、40 层,拼接后的图文对中的 token 在经过 MSA 后,还会被额外路由到 VL-FFN,进行更深层次的模态融合。

1.3 使用场景

Multiway Transformer 的神奇之处在于,它自身的结构是固定的,但它的行为会随着输入数据的组合方式而动态变化。这使得 BEIT-3 可以在不修改任何代码的情况下,扮演多个角色。

1.3.1. 场景 1:纯视觉输入(如图像分类)

  • 输入:只有图像 patch tokens。
  • 路由:所有 token 都是“图像”模态。
  • 行为:所有的 token 都经过 MSA(计算 patch 间关系),然后全部路由到 V-FFN。
  • 结果:Multiway Transformer 退化成了一个标准的 ViT(Vision Transformer)。L-FFN 专家完全不激活。

1.3.2. 场景 2:纯文本输入

  • 输入:只有文本 word tokens。
  • 路由:所有 token 都是“文本”模态。
  • 行为:经过 MSA(计算词间依赖),然后全部路由到 L-FFN。
  • 结果:退化成了一个 BERT-style 文本 Transformer。V-FFN 专家完全不激活。

1.3.3. 场景 3:图文对拼接输入(如VQA - 融合编码器模式)

  • 输入: [Image_patch_1, …, Image_patch_N, Text_word_1, …, Text_word_M] 的一个拼接长序列。
  • MSA:共享注意力起关键作用。每个图像 patch token 和每个文本 word token 都会计算彼此之间的注意力。
  • 图像 patch A 会“看”到所有文本词,尤其是与其相关的词。
  • 文本词 “ball” 会“看”到图像中可能有球的几个 patch。
  • 路由:
  • 图像 patch tokens → V-FFN
  • 文本 word tokens → L-FFN
  • 顶层特殊处理:在最后三层,这些混合 token 可能还会通过 VL-FFN 进行更深入的跨模态融合。
  • 结果:实现了深度的跨模态理解,适合 VQA、NLVR2 等任务。

1.3.4. 场景 4:图像和文本独立处理(如图像-文本检索 - 双编码器模式)

  • 输入:图像和文本不拼接。它们分别独立地送入同一个 Multiway Transformer 网络。
  • 图像路径:
  • 输入纯图像 patches。
  • 仅激活 V-FFN 专家。
  • 文本路径:
  • 输入纯文本 words。
  • 仅激活 L-FFN 专家。
  • 结果:网络分别输出一个图像嵌入向量和一个文本嵌入向量。它们在整个过程中从未“见面”,但它们的表示空间是通过预训练(掩码建模)对齐的。这实现了与 CLIP 完全相同的双编码器架构,但使用的是同一个模型权重。

2. 预训练任务

文本中以BERT为代表的MLM+视觉中以BEiT为代表的MIM,这两种Mask Data Modeling(MDM)预训练方式已经 取得了成功。 BEiT-v3,将MDM扩展到多模态领域,进一步将所有多模态数据都看作是一种“语言”,以此统一预训练:

  • 文本 English
  • 图像 Imaglish(Image+English造出来的词,Sequence of Token)
  • 图文对 Parallel Sentences(双语句对,句子1后面跟了个句子2)

MDM的具体方法:

  • 文本数据:由SentencePiece tokenizer进行token化
  • 图像数据:由BEiT-v2的tokenizer进行token化,变成Sequence of Token
  • 具体mask方法:还是原来的MLM、MIM中的mask方法,从单模态文本中随机mask掉15%的文本,从图片-文本对中随机mask掉50%的文本,在mask图像时采用block-wise掩码策略mask掉40%。
  • 预训练目标:还是一样做完形填空,恢复掉被遮住的图像或文本。

4. 总结

BEiT-v3其实从方法上来说就是之前BEiT、BEiT-v2、VL-BEiT、VLMo等一系列的工作的一个集合体,本身没有提出新的内容,主要就是把它做大做强,展示了一个Unified Framework能达到的性能。

到这里时,其实已经呈现了一个趋势,多模态模型的规模在不断扩大,训练用的数据规模也在扩大,虽然一定程度上对性能有利的,但是端到端训练的成本也会随之增加。

此时也就会有另外一种思考,有没有什么高效的对齐方法,直接利用已经预训练好的视觉、文本模型就能快速对齐,完成对模态任务。BLIP2就进行了验证。

5. 对比
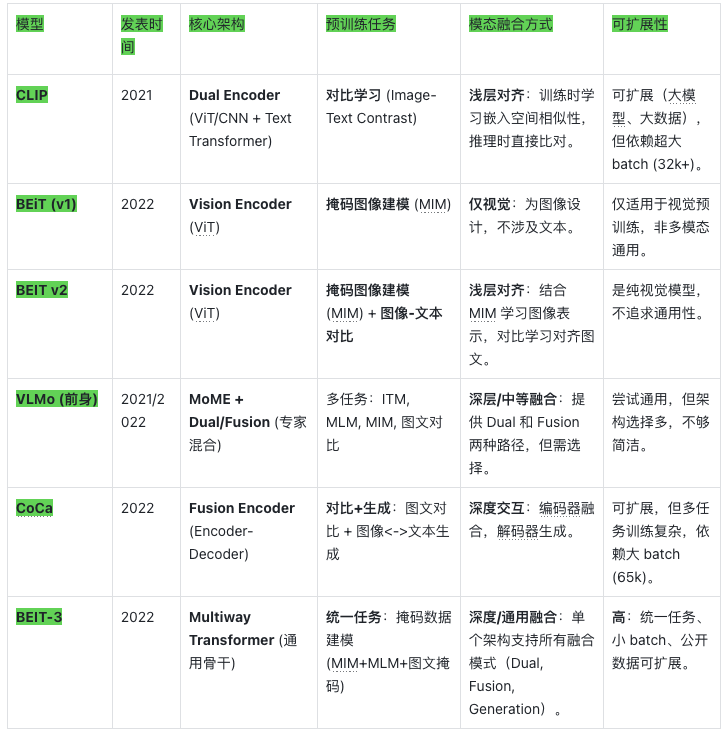
如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

多模态之论文笔记BEiT, BEiT V2, BEiT V3 BEiT, BEiT V2, BEiT V3综述,附PPT 阅读详情

相关推荐

DIY音频必备:手把手教你用AB类功放模块打造高保真桌面音响(含电路图)

本文详细指导如何利用AB类功放模块DIY高保真桌面音响,涵盖选型指南、核心元器件清单、电路搭建与焊接工艺,以及系统调试与音质优化技巧。AB类功放以其接近A类功放的音质和B类功放的效率,成为音频爱好者的理想选择,适合有一定电子基础的实践者。

weixin_42665725的博客 445

【多模态】paper阅读笔记:BEiT V3

再加上本文提出的将图像视为一种语言的方式,可直接复用已有的大规模语言模型的预训练方法,从而更有利于视觉基础模型的扩大。对应之前提到的,这三方面的统一概念了解后,就能知晓big convergence的相关概念早已存在,即大模型发展成熟的几项条件:一是 Transformers 成为不同领域和问题的通用神经网络架构和建模方式,二是生成式预训练(generative pre-training)成为最重要的自监督学习方法和训练目标,三是数据和模型参数的规模化(scaling up)进一步释放基础模型的潜力。

weixin_43071505的博客 2117

【CQUT】从零开始龙芯杯-开始前的准备

不同级别的Cpu对于vivado综合的时间有较大影响,其中Cpu的单核、多核性能以及cache性能影响权重较高。因此,为了保证学习进度和效率,我们建议在Cpu不低于I5 12400的环境下进行学习。Vivado2023.2安装包约100GB,为了保证成功安装建议留出300GB硬盘空间。龙芯杯的许多资料被托管在gitee,你需要git指令将资料克隆到本地。指定用书:CPU设计实战 Loongarch版 作者:汪文祥、邢金璋。Cpu性能对比网站:https://www.cpu114.com/

weixin_73689971的博客 911

多模态模型:学习笔记(一)

例如,在图像中,遮挡掉的补丁可以通过预测正确的像素值来学习图像特征,这涉及到了图像的低频和高频信息的处理。例如,将224x224的图像分割为14x14的patch,每个patch是16x16像素,然后将每个patch的像素值展平为一个256维的向量,通过线性层投影到768维的嵌入空间。例如,在Transformer架构中,不同层的特征具有不同的语义级别(低层偏向于边缘、纹理等细节,高层偏向于对象、场景等语义),跨层注意力可以促进不同语义层次之间的信息流动,让模型更全面地掌握图像的细节和整体信息。

m0_72708335的博客 1157

基于ESP32与JavaScript的Stack-chan桌面机器人:从硬件组装到AI交互的完整实践

嵌入式系统开发是连接物理世界与数字世界的核心技术,其核心原理在于通过微控制器直接操作硬件外设,实现感知、决策与执行。这项技术的核心价值在于为物联网、智能硬件和机器人等领域提供了低功耗、高可靠性的解决方案。在机器人应用场景中,嵌入式平台常作为主控大脑,驱动舵机、传感器并处理交互逻辑。本文聚焦的Stack-chan项目,正是这一理念的生动实践:它采用流行的ESP32微控制器,并创新性地通过Moddable运行时支持使用JavaScript进行嵌入式开发,极大地降低了机器人编程的门槛。开发者可以基于此平台,轻松实

weixin_28729173的博客 439

Workbench中直接调用ICEM CFD进行网格划分

自从ANSYS 12.0之后,ICEM CFD就从Workbench中被分离出去,作为一个独立的程序使用了。取而代之的是Meshing模块。 在Meshing的属性节点菜单中右键点击Mesh,选择Insert > Method,插入方法。 选择需要划分网格的几何体,点击apply。此时Geometry显示为1 Body。 设置Method为MultiZone,如果不设置成这个的话,找不到进入ICEM CFD的入口。如果要划分四面体,可以在Mapped Mesh Type中选择其他类型。

Yan的博客 6513

【多模态】BEiT V3:Image as a Foreign Language: BEIT Pretraining for All Vision and Vision-Language Tasks

论文:Image as a Foreign Language: BEIT Pretraining for All Vision and Vision-Language Tasks链接:https://arxiv.org/pdf/2208.10442。

vivid 1012

离散数学期末考试试卷(两套)-熟悉题型

3.设集合A={a,b,c,d}上有自反关系R={,,,,},对称关系S={,,,}。6.设集合A={1,2,3},B={u,v,w},C={a,b,c},f是集合A到集合B上的映射,g是集合B到集合C上的映射,f={, , },g={},则复合函数g。5. 设集合A={a,b,c,d,e},下列选项中哪一个集合不是A的划分( )。

muse3159546973的博客 6959

AI模型的大一统!浅析微软的BEIT3:多模态领域乱杀的十二边形战士

点击上方“视学算法”,选择加"星标"或“置顶”重磅干货,第一时间送达作者丨战斗系牧师@知乎(已授权)来源丨https://zhuanlan.zhihu.com/p/558533740编辑丨极市平台导读微软最新升级的 BEiT-3 预训练模型,用一个模型搞定多领域SOTA。无敌的十二寸Pizza饼战士BEIT3说在前面的话(有点小长,可以直接跳过的)期待在Swin-v2出来不久之后,我预感一个很棒...

zandaoguang的博客 1845

西门子S7-1200模拟量的使用

模块类型核心参数输入信号处理输出信号配置转换原理数值范围TIA Portal配置编程要点 转换公式: 输出模拟量: 五、校准与线性化 硬件校准非线性补偿抗干扰措施数字滤波温度控制压力监控流量调节信号异常精度不足实践操作参考文档项目案例借鉴博客

weixin_51020122的博客 4774

allegro如何设置走线等长

设置走线等长!

weixin_42499230的博客 6938

李沐多模态串讲笔记

李沐精读论文视频多模态串讲笔记

m0_46381421的博客 3564

科研——BIBM论文修改和提交

BIBM的相关操作流程汇总

Blackoutdragon的博客 6691

VLMo~~

如果输入由多模态的向量组成,比如是图像和文本的拼接,就先使用视觉专家和文本专家分别对输入的图像和文本进行编码,再使用多模态专家进行联合地交互。,预训练完成后,使用时既可以是双塔结构,实现高效地对图像和文本进行检索,又可以是单塔结构,对融合的图像和文本的特征进行建模和交互。VLMo 相当于是一个混合专家 Transformer 模型,预训练完成后,使用时既可以是双塔结构,实现高效地对图像和文本进行检索,又可以是单塔结构,对融合的图像和文本的特征进行建模和交互。在微调期间,使用图像-文本对比损失来优化。

whaosoft143ai的博客 991

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

图像也是一门语言?微软提出19亿参数的超大通用模型BEIT-3,刷榜多个CV和多模态任务!

在本文中,作者提出了 BEIT-3,这是一种通用的多模态基础模型,它在广泛的视觉和视觉语言基准测试中实现了最先进的性能。BEIT-3 的核心思想是图像可以建模为一门外语,这样就可以统一对图像、文本和图文对进行蒙版“语言”建模。作者还展示了 Multiway Transformers 可以有效地对不同的视觉和视觉语言任务进行建模,使其成为通用建模的有趣选择。BEIT-3简单有效,是扩大多模态基础模型的一个有前途的方向。...

努力努力再努力的小马 1028

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Visual 预训练模型:BEiT、BEiT v2

基于的双向编码、自监督视觉表征模型,使用任务进行预训练。图1为预训练过程。,利用以自编码的方式训练,以将图片切分为离散的visual tokens。,图像有image patches和visual tokens两种表示,首先将图片大小缩放至224x224,以网格法分割成14x14的patches,每个patch的大小为16x16,。随机掩盖部分image patches,即图中灰色的patches替换为[M]

十里清风 2333

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

多模态预训练精读总结(zhu老师的课

1.这篇工作的 visual encoder 不仅diss 之前的效率不高(之前是目标检测),更重要的一点是,在它看来,之前预先提取好的目标检测的物体特征 因为已经提取好了,不是end-to-end,所以导致多模态融合那块或者说多模态匹配那块,很可能会得到不好的结果。(multimodal encoder 学不好)how to do?它们决定 先 align 再 fuse,使用一个对比学习loss——ITC(看到这里感觉这个不是之前有的吗?

The smart is sexy 766

多模态论文串讲:ALBEF & VLMo & BLIP & CoCa & Beit V3

image text matching loss(ITM Loss):经由fc layer,实际上是一个二分类loss,判断一个【text,image】是不是一对数据,但实际训练中,会有大量的分类结果为否的情况,使得ITM Loss看起来很低,但实际并不一定起到足够的效果。因此,从ITC对比学习计算的cosine distance中选择和真实样本距离最近的(最难分辨的,称之为hard negatives),用于ITM loss训练;损失函数:2个IT,2个MLM,1个ITM。

林宋的搬砖流水账 1658

【论文精读】多模态系列:ALBEF、VLMo、BLIP、CoCa、BeiTv3

这个多路Transformer其实也是微软之前的工作VLMo,多路Transformer的核心是模型的MHSA模块是共享的,而设置不同的FFN来分别处理图像(V-FFN),文本(L-FFN)和多模态数据(VL-FFN)。给定任何一张图片,按照vision transformer的方法,打成patch,然后通过patch embedding layer,送进vision transformer,图像这边对应的编码器就是一个标准的12层的vision transformer的base模型。

weixin_47748259的博客 2190

一文搞懂Embedding:大模型必备的基础知识,建议收藏!

Embedding是将无意义的符号(如词语、图像ID等)转化为机器可理解的低维、稠密向量的技术。它既能压缩数据提高计算效率,又能在向量空间中保留语义相似性,使相似对象在空间中距离更近。在传统深度学习中,Embedding广泛应用于NLP、推荐系统和计算机视觉;而在大模型时代,它成为语言模型、多模态模型和生成式模型的基础。Embedding本质上是机器理解世界的"坐标系"和"翻译器"。

2401_84204413的博客 988

BEIT-3多模态大模型深度解析:统一架构实现图像与文本的“语言“融合!

BEIT-3创新地将图像视为"外语",采用统一Transformer架构处理图像、文本和图文对,核心是"蒙面数据建模"预训练任务。作为拥有近20亿参数的巨型模型,其架构简洁且通用,无需修改即可直接应用于图像分类、目标检测、视觉问答和图文检索等多种下游任务。在20多个权威数据集上取得SOTA性能,证明了"统一架构+蒙面建模+超大模型"技术路线的有效性,为构建通用多模态基础模型指明方向。

m0_59162248的博客 825

论文解读:(BEIT-3)Image as a Foreign Language: BEIT Pretraining for All Vision and Vision-Language Tasks

语言、视觉和多模态预训练的大融合正在出现。在这项工作中,我们介绍了一个通用的多模态基础模型BEIT-3,它在视觉和视觉语言任务上实现了最先进的迁移性能。具体来说,我们从主干架构、预训练任务和模型扩展三个方面推进了大收敛。我们介绍了用于通用建模的多路Transformers,其中模块化体系结构支持深度融合和特定于模态的编码。基于共享主干,我们以统一的方式对图像(英语)、文本(英语)和图像-文本对(“平行句”)执行掩码“语言”建模。

weixin_50917576的博客 3007

#今日论文推荐# 多边形战士模型!微软提出19亿参数的超大通用模型BEIT-3,刷榜多个CV和多模态任务

语言、视觉和多模态预训练的大融合正在出现。在这项工作中,作者引入了一个通用的多模态基础模型 BEIT-3,它在视觉和视觉语言任务上都实现了最先进的迁移性能。

w1hsxn的博客 488

经典多模态模型

传统多模态模型以及一些笔记 vilt,clip, albef, vlmo, blip, coca, beit v3

Scabbards_的博客 5229

BeiT:当BERT用于图像任务——超越ViT新范式

基于Paddle实现BeiT-ft结构,top1 88.60%,可能是目前paddle开源模型精度最高的

m0_63642362的博客 7219

【多模态大模型】系列2:Transformer Encoder-Decoder——BLIP、CoCa、BEITv3

本文介绍基于Transformer Encoder-Decoder的BLIP、CoCa和BEITv3

https://github.com/Donvink,专注于计算机视觉、目标检测、目标跟踪等方向 1570
上一篇: 大模型RAG“翻车“?原来是分块没做好!小白程序员必看的分块秘籍,让你的AI应用准确率飙升300%
下一篇: 震惊!AI三剑客横空出世,小白也能玩转单细胞数据分析!CellAgent框架让你秒变生物数据专家
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2840原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值