图像也是一门语言?微软提出19亿参数的超大通用模型BEIT-3,刷榜多个CV和多模态任务!

51-13 多模态论文串讲—BEiTv3,Image as a Foreign Language:BEiT Pretraining for All Vision and Vision-Lan论文精读 BEIT-3的核心思想是将图像建模为一种语言,这样我们就可以对图像、文本以及图像-文本对进行统一的maskmodeling。Multi-way transformer模型可以有效地完成不同的视觉和视觉语言任务,使其成为通用建模的一个有效选择。同时,本文也对多模态大模型的发展作了一个简单的总结。 阅读详情

【写在前面】

语言、视觉和多模态预训练的大融合正在出现。在这项工作中,作者引入了一个通用的多模态基础模型 BEIT-3,它在视觉和视觉语言任务上都实现了最先进的迁移性能。具体来说,作者从三个方面推进大融合:骨干架构、预训练任务和模型扩展。作者为通用建模引入了 Multiway Transformers,其中模块化架构支持深度融合和特定于模态的编码。基于共享主干,作者以统一的方式对图像(Imglish)、文本(English)和图像-文本对(“parallel sentences”)进行掩码“语言”建模。实验结果表明,BEIT-3 在对象检测 (COCO)、语义分割 (ADE20K)、图像分类 (ImageNet)、视觉推理 (NLVR2)、视觉问答 (VQAv2)、图像字幕方面获得了最先进的性能(COCO)和跨模态检索(Flickr30K,COCO)。

1. 论文和代码地址
Image as a Foreign Language: BEIT Pretraining for All Vision and Vision-Language Tasks

论文地址:https://arxiv.org/abs/2208.10442

代码地址:https://aka.ms/beit-3

2. 动机

近年来,语言、视觉和多模态预训练大融合的趋势。通过对海量数据进行大规模预训练,可以轻松地将模型迁移到各种下游任务。可以预训练一个处理多种模态的通用基础模型,这很有吸引力。在这项工作中,作者从以下三个方面推进视觉语言预训练的收敛趋势。

首先,Transformers的成功是从语言翻译运用到视觉和多模态的问题。网络架构的统一使我们能够无缝地处理多种模态。对于视觉语言建模,由于下游任务的不同性质,有多种方法可以应用 Transformer。例如,双编码器架构用于高效检索,编码器-解码器网络用于生成任务,融合编码器架构用于图像-文本编码。然而,大多数基础模型必须根据特定架构手动转换最终任务格式。此外,参数通常不能有效地跨模态共享。在这项工作中,作者采用** Multiway Transformers **进行通用建模,即为各种下游任务共享一个统一架构。模块化网络还综合考虑了特定于模态的编码和跨模态融合。

其次,基于掩码数据建模的预训练任务已成功应用于各种模态,例如文本 、图像和图像-文本对。当前的视觉语言基础模型通常会同时处理其他预训练目标(例如图像-文本匹配),从而导致放大不友好且效率低下。相比之下,本文只使用一个预训练任务,即 mask-then-predict,来训练一个通用的多模态基础模型。通过将图像视为一门外语(即 Imglish),作者以相同的方式处理文本和图像,而没有基本的建模差异。因此,图像-文本对被用作“平行句子”,以学习模态之间的对齐。作者还表明,这种简单而有效的方法学习了强大的可迁移表示,在视觉和视觉语言任务上都实现了最先进的性能。显着的成功证明了生成式预训练的优越性。

第三,**扩大模型规模和数据规模普遍提高了基础模型的泛化质量,以便可以将它们转移到各种下游任务中。**作者遵循这一理念并将模型规模扩大到数十亿个参数。此外,作者在实验中扩大了预训练数据的大小,同时仅将可公开访问的资源用于学术。尽管没有使用任何私人数据,但本文的方法在相当大的程度上优于依赖内部数据的最先进的基础模型。此外,扩大规模得益于将图像视为外语,因为作者可以直接重用为大规模语言模型预训练开发的管道。

在这项工作中,作者利用上述想法来预训练一个通用的多模态基础模型** BEIT-3**。通过对图像、文本和图像-文本对执行掩码数据建模来预训练 Multiway Transformer。在预训练期间,作者随机屏蔽一定比例的文本标记或图像块。自监督学习的目标是在给定损坏的输入的情况下恢复原始标记(即文本标记或视觉标记)。该模型是通用的,因为无论输入模态或输出格式如何,它都可以重新用于各种任务。

[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-pbABggTE-1661823629908)(https://files.mdnice.com/user/18705/6a5cbbb0-b44e-4b56-9244-9a194486ed9b.png)]
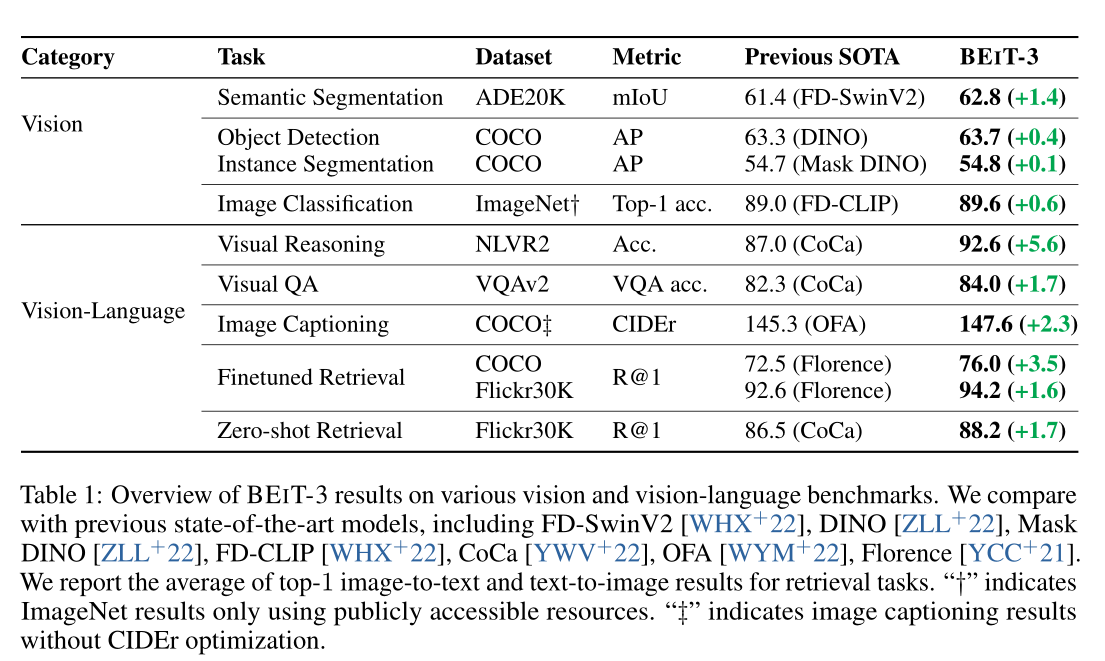
如上图和上表所示,BEIT-3 在广泛的视觉和视觉语言任务中实现了最先进的迁移性能。作者在广泛的下游任务和数据集上评估 BEIT-3,即对象检测 (COCO)、实例分割 (COCO)、语义分割 (ADE20K)、图像分类 (ImageNet)、视觉推理 (NLVR2)、视觉问答 (VQAv2) ,图像字幕(COCO)和跨模态检索(Flickr30K,COCO)。具体来说,尽管作者只使用公共资源进行预训练和微调,但本文的模型优于以前的强大基础模型。该模型也比专门的模型获得了更好的结果。此外,BEIT-3 不仅在视觉语言任务上表现出色,而且在视觉任务(如对象检测和语义分割)上也表现出色。

3. 方法

如上图所示,BEIT-3 使用共享的 Multiway Transformer 网络通过对单模态和多模态数据的掩码数据建模进行预训练。该模型可以转移到各种视觉和视觉语言下游任务。

3.1 Backbone Network: Multiway Transformers

作者使用 Multiway Transformers 作为主干模型来编码不同的模态。如上图所示,每个 Multiway Transformer 模块都由一个共享的自注意模块和一个用于不同模态的前馈网络(即模态专家)池组成。根据其形式将每个输入token路由给专家。在本文的实现中,每一层都包含一个视觉专家和一个语言专家。此外,前三层有专为融合编码器设计的视觉语言专家。使用模态专家池鼓励模型捕获更多特定于模态的信息。共享的自注意模块学习不同模态之间的对齐,并为多模态(例如视觉语言)任务实现深度融合。

[外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传(img-GWZYDK7b-1661823629909)(image/image_EF8bZIz0Pb.png)]

如上图所示,统一的架构使 BEIT-3 能够支持广泛的下游任务。例如,BEIT-3 可以用作各种视觉任务的图像主干,包括图像分类、对象检测、实例分割和语义分割。它还可以微调为双编码器,用于高效的图像-文本检索,以及用于多模态理解和生成任务的融合模型。

3.2 Pretraining Task: Masked Data Modeling

通过统一的掩码数据建模目标对单模态(即图像和文本)和多模态数据(即图像-文本对)进行预训练 BEIT-3。在预训练期间,作者随机屏蔽一定百分比的文本标记或图像块,并训练模型以恢复被屏蔽的标记。统一的掩码然后预测任务不仅学习表示,还学习不同模态的对齐。具体来说,文本数据由 SentencePiece 标记器 进行标记。图像数据通过 BEIT v2 的分词器进行分词,得到离散的视觉分词作为重建目标。作者从图像-文本对中随机屏蔽 15% 的单模态文本标记和 50% 的图文对中的文本标记。对于图像,作者使用 BEIT 中的分块屏蔽策略屏蔽 40% 的图像块。

作者只使用一个预训练任务,这使得训练过程的扩展友好。相比之下,以前的视觉语言模型通常采用多个预训练任务,例如图文对比、图文匹配和单词-patch/区域对齐。作者展示了一个小得多的预训练batch大小可以用于 mask-then-predict 任务。相比之下,基于对比的模型通常需要非常大的batch size进行预训练,这带来了更多的工程挑战,例如GPU内存成本。

3.3 Scaling Up: BEIT-3 Pretraining

Backbone Network
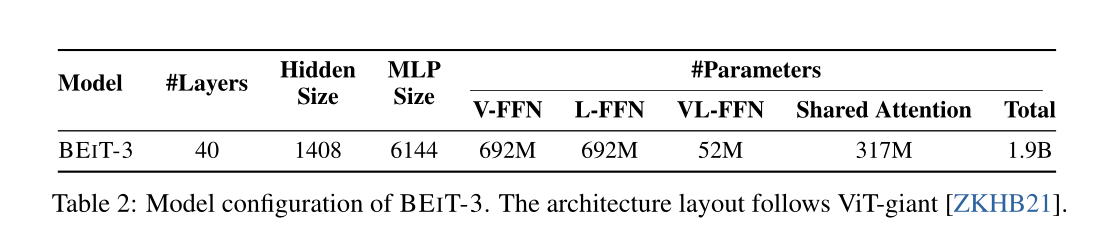
BEIT-3 是继 ViTgiant搭建之后的巨型基础模型。如上表所示,该模型由一个 40 层的 Multiway Transformer 组成,具有 1408 的隐藏大小、6144 的中间大小和 16 个注意力头。所有层都包含视觉专家和语言专家。视觉语言专家也采用于前三个 Multiway Transformer 层。自注意力模块在不同的模态中共享。 BEIT-3总共由1.9B个参数组成,其中视觉专家参数692M,语言专家参数692M,视觉语言专家参数52M,共享自注意力模块参数317M。请注意,当模型用作视觉编码器时,仅激活与视觉相关的参数(即,与 ViT-giant 相当的大小;大约 1B)。

Pretraining Data
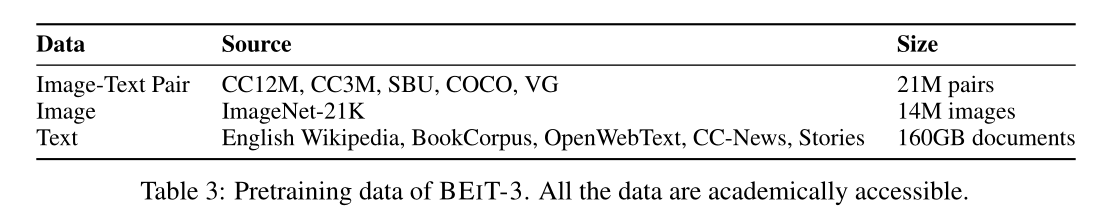
BEIT-3 在上表中显示的单模态和多模态数据上进行了预训练。对于多模态数据,从五个公共数据集中收集了大约 1500 万张图像和 2100 万张图文对:Conceptual 12M (CC12M)、Conceptual Captions (CC3M) 、SBU Captions (SBU) 、COCO 和视觉基因组 (VG) 。对于单模态数据,使用来自 ImageNet-21K 的 14M 图像和来自英语 Wikipedia、BookCorpus 、OpenWebText3、CC-News 和 Stories 的 160GB 文本语料库。

4.实验
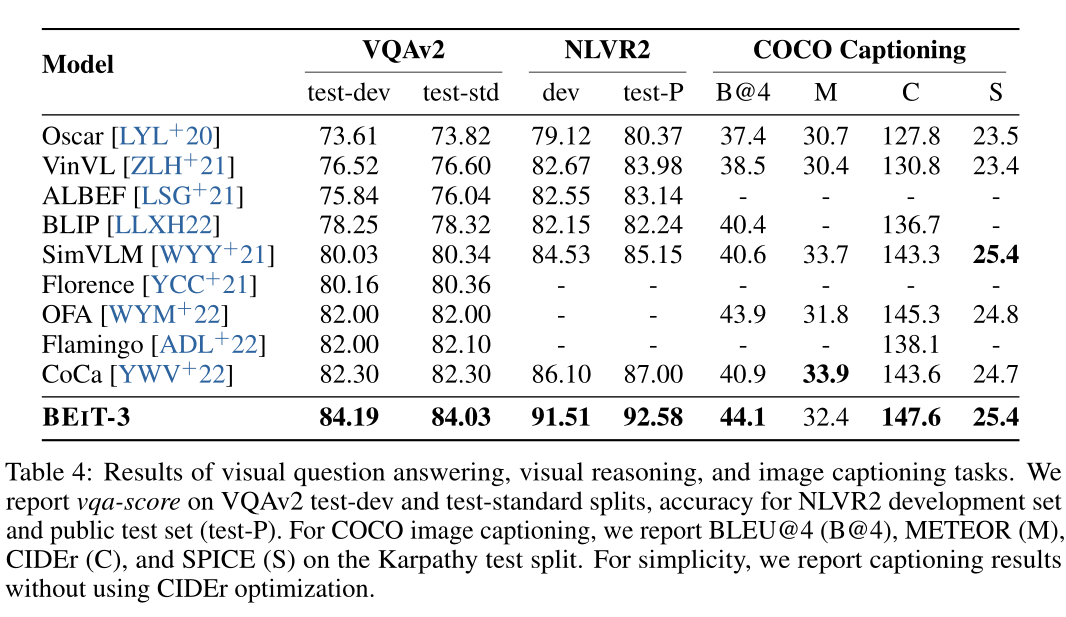
上表展示了本文方法在三个多模态数据集上的实验结果。
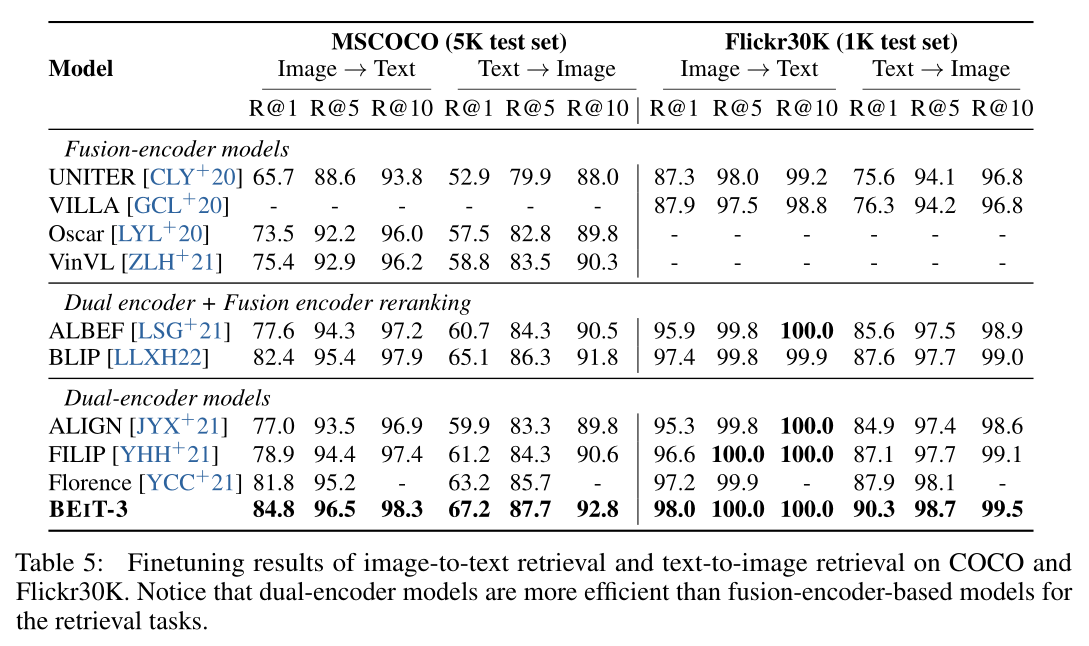
多模态检索数据集上的结果。
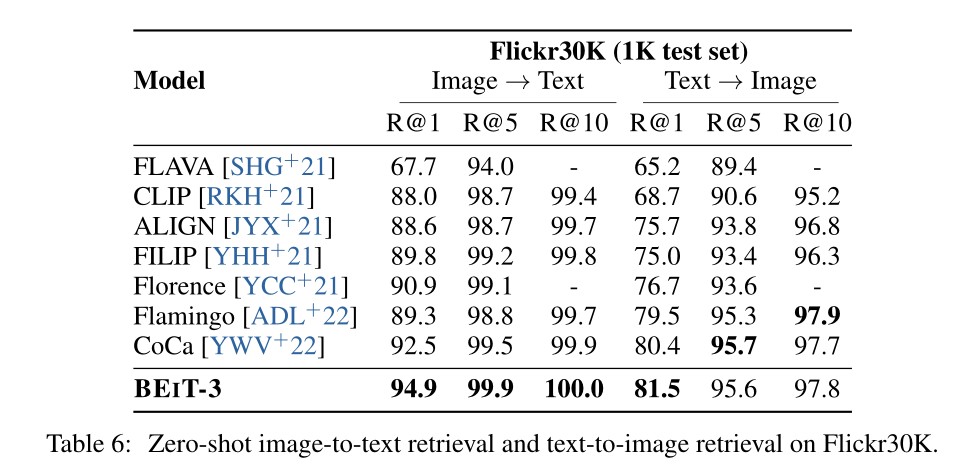
多模态检索数据集上的Zero-shot结果。

目标检测和实例分割的实验结果。
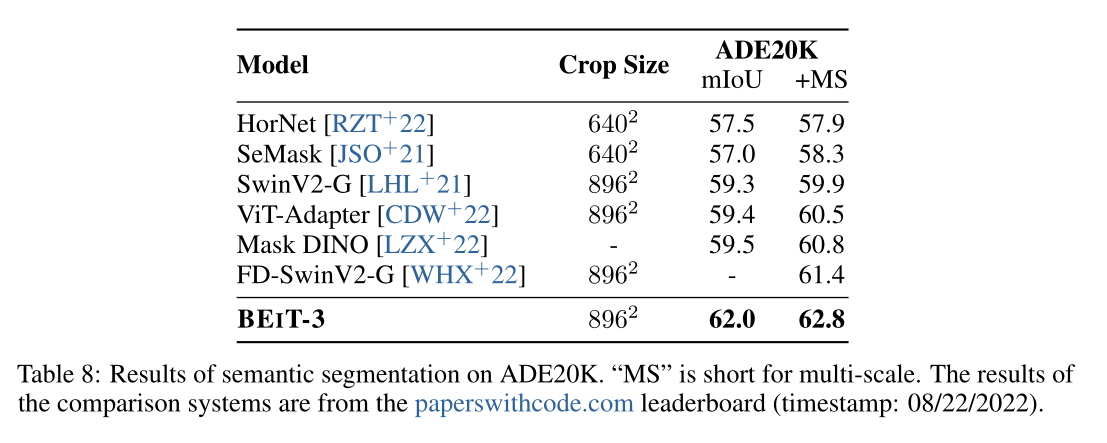
语义分割的实验结果。
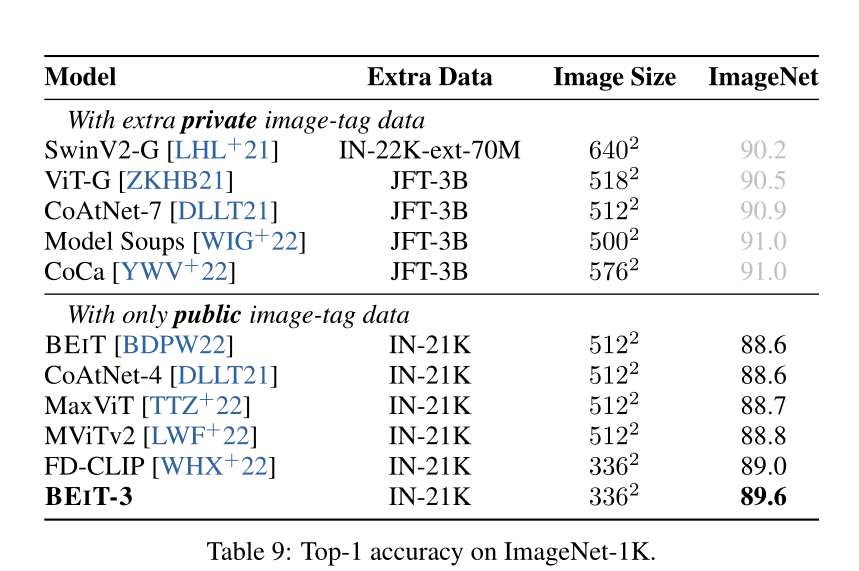
图像分类的实验结果。

5. 总结

在本文中,作者提出了 BEIT-3,这是一种通用的多模态基础模型,它在广泛的视觉和视觉语言基准测试中实现了最先进的性能。 BEIT-3 的核心思想是图像可以建模为一门外语,这样就可以统一对图像、文本和图文对进行蒙版“语言”建模。作者还展示了 Multiway Transformers 可以有效地对不同的视觉和视觉语言任务进行建模,使其成为通用建模的有趣选择。 BEIT-3简单有效,是扩大多模态基础模型的一个有前途的方向。对于未来的工作,作者正在努力对多语言 BEIT-3 进行预训练,并在 BEIT-3 中加入更多的模态(例如音频),以促进跨语言和跨模态的迁移,并推动大规模预训练跨任务的大融合、语言和方式。

【技术交流】

已建立深度学习公众号——FightingCV,关注于最新论文解读、基础知识巩固、学术科研交流,欢迎大家关注!!!

请关注FightingCV公众号,并后台回复ECCV2022即可获得ECCV中稿论文汇总列表。

推荐加入FightingCV交流群,每日会发送论文解析、算法和代码的干货分享,进行学术交流,加群请添加小助手wx:FightngCV666,备注:地区-学校(公司)-名称

面向小白的顶会论文核心代码库:https://github.com/xmu-xiaoma666/External-Attention-pytorch

面向小白的YOLO目标检测库:https://github.com/iscyy/yoloair
【赠书活动】

为感谢各位老粉和新粉的支持,FightingCV公众号将在9月10日包邮送出4本**《深度学习与目标检测:工具、原理与算法》来帮助大家学习,赠书对象为当日阅读榜和分享榜前两名。想要参与赠书活动的朋友,请添加小助手微信FightngCV666**(备注“城市-方向-ID”),方便联系获得邮寄地址。

自研半导体Fab缺陷分析系统:从Klarf解析到Defect Map可视化的实战替代方案 本文分享了自研半导体Fab缺陷分析系统的实战经验,重点解析了Klarf文件格式与坐标系转换的核心技术,并详细介绍了从数据解析到Defect Map可视化的完整实现路径。该系统旨在为成本敏感或追求技术自主的团队提供一套功能完备的Klarity Defect平替方案,有效降低对昂贵商业软件的依赖,实现缺陷数据的自主分析与可视化。 阅读详情

相关推荐

Cesium实战:全球海洋动态水面与自定义区域波浪效果实现

本文详细介绍了在Cesium中实现全球海洋动态水面与自定义区域波浪效果的实战方法。通过解析核心概念Primitive与Geometry,并深入讲解Water材质的关键参数调节,指导开发者快速创建逼真的动态海洋。文章重点阐述了如何利用多边形坐标定义不规则图形区域,实现精准的局部水域波浪效果,并提供了性能优化与视觉提升的实用技巧。

weixin_29256771的博客 501

BEiT-3:将图像视为一种外语:用于视觉和视觉-语言任务的BEiT预训练(速读版)

在本文中,我们提出了一个通用的多模态基础模型BEiT-3,它在广泛的视觉和视觉-语言基准上实现了最先进的性能。BEiT-3的核心思想是,将图像视为一种外语,这样我们就可以对图像、文本以及图像-文本对进行统一的掩码“语言”建模。...

weixin_51697828的博客 2328

AXI 1G/2.5G Ethernet Subsystem IP核使用过程中参数配置全解

AXI 1G/2.5G Ethernet Subsystem 是一个为FPGA设计的以太网子系统,它支持1Gbps和2.5Gbps的数据传输速率,使得FPGA能够直接进行高速以太网通信。这个子系统通常包含以太网MAC控制器、GMII(千兆媒体独立接口)或RGMII(简化GMII)接口、以及可选的PHY(物理层)接口支持。

u011565038的博客 1万+

【论文笔记】BEIT 3 ——Image as a Foreign Language: BEIT Pretraining forAll Vision and Vision-Language Tasks

beit,beit2都还只是单模态的工作,到第三代变成了一个多模态的工作,半响不敢确认是不是beit3... 这篇工作还是能看到他们组其他工作的影子,beit系列自不必多说,还有vlmo等,可以算是一个集大成的工作。六边形战士。

weixin_50862344的博客 799

静态与动态LACP链路聚合:原理、配置与排错实战指南

链路聚合技术是提升网络带宽与可靠性的核心方案,通过将多个物理端口逻辑捆绑,实现带宽叠加与链路冗余。其原理基于IEEE 802.3ad标准,通过负载均衡算法将数据流分布到不同物理链路,既避免了数据包乱序,又提升了整体吞吐量。该技术的核心价值在于消除单端口瓶颈、提供毫秒级故障切换,并能简化网络拓扑管理。在企业服务器接入、数据中心互联及虚拟化平台等场景中,链路聚合已成为构建高可用网络的基础。实践中,动态LACP模式通过协议报文协商,能主动检测链路故障并防止配置错误导致的网络环路,相比静态聚合更为可靠。本文将深入解

weixin_31412781的博客 270

DSP复习笔记(5)——外部接口模块XINTF

【注意】 1. 芯片型号:TMS320F28335 2. 适用于NJUSTEO李彧晟老师课程 3. 参考资料:《TMS320F28335 DSP原理、开发及应用》 4. 对应PPT第二章 5. 本章内容较多而且较为重要,请结合PPT一起复习

BerenCamlost的博客 1万+

BEiT-3论文阅读笔记

BEiT-3论文阅读笔记

qq_37662375的博客 3938

jmeter问题系列:Begin size 0 is not equal to fixed size 5

Begin size 0 is not equal to fixed size 5 ,问题的解决

雨水的早晨的博客 2415

AI模型的大一统!浅析微软的BEIT3:多模态领域乱杀的十二边形战士

点击上方“视学算法”,选择加"星标"或“置顶”重磅干货,第一时间送达作者丨战斗系牧师@知乎(已授权)来源丨https://zhuanlan.zhihu.com/p/558533740编辑丨极市平台导读微软最新升级的 BEiT-3 预训练模型,用一个模型搞定多领域SOTA。无敌的十二寸Pizza饼战士BEIT3说在前面的话(有点小长,可以直接跳过的)期待在Swin-v2出来不久之后,我预感一个很棒...

zandaoguang的博客 1845

点云从入门到精通技术详解100篇-基于三维点云的机器人抓取位姿检测(续)

集到的深度信息会存在噪点,因此需要将生成的场景点云进行预处理,获得平滑、降采样处理场景点云,本文设计的预处理操作更能从冗杂的场景点云中提取清晰、平滑的目标点云,便于后续的抓取位姿采样,提高后续算法的处理效率。因此需要对场景点云进行适当的分割,仅保留目标物体的点云,整个过程可以通过。场较小时,空间中的点云密度会更加提高;觉子系统的效率,再保持全局点云几何形状不改变的前提下,通过对目标点云进行。体素降采样可以快速地减少点云数据并同时保持点云的形。个点,由于我们实施抓取的目标物体只占整个场景点云图的一部分,

getusushu的博客 774

Ardupilot EKF3核心算法《开篇》

Ardupilot EKF3核心算法本专栏重点,透彻,详细的分析了ardupilot的EKF3,保证是你看到的最完美的EKF3资料,相信你的选择不会错误。网上EKF资料真是太多,说真的没有一篇讲解好的。!!

陌城烟雨 1415

#今日论文推荐# 多边形战士模型,微软提出19亿参数的超大通用模型BEIT-3,刷榜多个CV和多模态任务

语言、视觉和多模态预训练的大融合正在出现。在这项工作中,作者引入了一个通用的多模态基础模型 BEIT-3,它在视觉和视觉语言任务上都实现了最先进的迁移性能。

w1hsxn的博客 790

使用 Simulink 进行电力电子系统的大信号模型仿真

电力电子系统(Power Electronics System)包括各种功率转换器(如 DC-DC 转换器、逆变器等)。这些设备中的关键组件(如 MOSFET、IGBT、电容器、电感器等)不仅影响系统的性能,还直接关系到系统的稳定性、效率和可靠性。因此,在设计阶段进行详细的建模和仿真至关重要。大信号模型仿真的目的是通过模拟系统在非线性条件下的真实行为,评估其瞬态响应、稳态性能以及对不同负载和输入电压变化的响应。通过本教程,我们介绍了如何使用 Simulink 进行电力电子系统的大信号模型仿真。背景介绍。

xiaoheshang_123的博客 305

#今日论文推荐# 多边形战士模型!微软提出19亿参数的超大通用模型BEIT-3,刷榜多个CV和多模态任务

语言、视觉和多模态预训练的大融合正在出现。在这项工作中,作者引入了一个通用的多模态基础模型 BEIT-3,它在视觉和视觉语言任务上都实现了最先进的迁移性能。

w1hsxn的博客 488

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

BEIT-3论文阅读笔记

BEIT-3 使用掩码数据建模的方式,借助 Transformer 这一方便处理图片和文本的模型架构,统一进行训练,在多个纯视觉任务和视觉-文本任务中都取得了 SOTA 性能。

hollyprince的博客 562

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

beitv3训练自己的数据集

下载处理数据的模型:(https://conversationhub.blob.core.windows.net/beit-share-public/beit3/sentencepiece/beit3.spm)数据集2:(https://cs.stanford.edu/people/karpathy/deepimagesent/caption_datasets.zip)工程:https://github.com/microsoft/unilm。数据集1:Download。

weixin_41012399的博客 1795

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

论文解读:(BEIT-3)Image as a Foreign Language: BEIT Pretraining for All Vision and Vision-Language Tasks

语言、视觉和多模态预训练的大融合正在出现。在这项工作中,我们介绍了一个通用的多模态基础模型BEIT-3,它在视觉和视觉语言任务上实现了最先进的迁移性能。具体来说,我们从主干架构、预训练任务和模型扩展三个方面推进了大收敛。我们介绍了用于通用建模的多路Transformers,其中模块化体系结构支持深度融合和特定于模态的编码。基于共享主干,我们以统一的方式对图像(英语)、文本(英语)和图像-文本对(“平行句”)执行掩码“语言”建模。

weixin_50917576的博客 3007

BeiT:当BERT用于图像任务——超越ViT新范式

基于Paddle实现BeiT-ft结构,top1 88.60%,可能是目前paddle开源模型精度最高的

m0_63642362的博客 7219

谷歌多模态大模型PaLI:采用参数量为4B的ViT-e,效果超过BEiT-3

选自arXiv作者:Xi Chen等视学算法编译编辑:张倩PaLI-17B 在多个 benchmark 上都达到了 SOTA。语言和视觉任务的建模中,更大的神经网络模型能获得更好的结果,几乎已经是共识。在语言方面,T5、GPT-3、Megatron-Turing、GLAM、Chinchilla 和 PaLM 等模型显示出了在大文本数据上训练大型 transformer 的明显优势。视觉方面,CNN...

zandaoguang的博客 857

BEIT-3

BEIT-3 的背景来自于 Transformer 这个架构和 Masked Data Modeling 的这个训练策略已经在视觉 (代表作 BEIT[2], BEIT v2[3]),文本 (代表作 GPT[4], BERT[5]),多模态 (代表作 VLMo[6], CLIP[7], CoCa[8]) 领域取得了成功,通过对海量数据进行大规模预训练,可以很容易地将这些得到的预训练模型转移到各种下游任务中。实验结果如下图7所示,BEIT-3 大大优于所有先前的模型,达到了 84.03 的精度whaosoft

whaosoft143ai的博客 662

多模态模型:学习笔记(一)

例如,在图像中,遮挡掉的补丁可以通过预测正确的像素值来学习图像特征,这涉及到了图像的低频和高频信息的处理。例如,将224x224的图像分割为14x14的patch,每个patch是16x16像素,然后将每个patch的像素值展平为一个256维的向量,通过线性层投影到768维的嵌入空间。例如,在Transformer架构中,不同层的特征具有不同的语义级别(低层偏向于边缘、纹理等细节,高层偏向于对象、场景等语义),跨层注意力可以促进不同语义层次之间的信息流动,让模型更全面地掌握图像的细节和整体信息。

m0_72708335的博客 1157

图解BERT模型

1. 模型的输入/输出 BERT模型的全称是:BidirectionalEncoder Representations from Transformer。从名字中可以看出,BERT模型的目标是利用大规模无标注语料训练、获得文本的包含丰富语义信息的Representation,即:文本的语义表示,然后将文本的语义表示在特定NLP任务中作微调,最终应用于该NLP任务。煮个栗子,BERT模型训练文本语...

qq_38343151的博客 1万+

从rookie到基佬~018:BEIT-3基础概念解析-Multiway Transformer

BEiT-3 的创新之处包含三个方面:骨干网络:Multiway Transformer。研究员们将 Multiway Transformer 作为骨干网络以对不同模态进行编码。每个 Multiway Transformer 由一个共享的自注意力模块(self-attention)和多个模态专家(modality experts)组成,每个模态专家都是一个前馈神经网络(feed-forward network)。

bnanaber的博客 554

SOTA模型飞入寻常百姓家-BEiT模型在AIStudio动手实践

转自AI Studio,原文链接:​​​​​​SOTA模型飞入寻常百姓家-BEiT模型在AIStudio动手实践 - 飞桨AI Studio 一、缘起 众所周知Transformer模型精度高,但是训练费时费力,8卡或16卡不训练个几天,是不会出论文结果的。同时很多SOTA模型根本就没考虑放出单卡运行代码,直接就是多卡并行计算,实践准入门槛很高。 学习的最佳方法就是在实践中学习,代码跑起来才更容易看得懂,理解也更深刻。本项目致力于**在AIStudio平台动手实践BEiT模型训练,让SOTA模型飞入寻

m0_63642362的博客 993

BEIT-3多模态大模型深度解析:统一架构实现图像与文本的“语言“融合!

BEIT-3创新地将图像视为"外语",采用统一Transformer架构处理图像、文本和图文对,核心是"蒙面数据建模"预训练任务。作为拥有近20亿参数的巨型模型,其架构简洁且通用,无需修改即可直接应用于图像分类、目标检测、视觉问答和图文检索等多种下游任务。在20多个权威数据集上取得SOTA性能,证明了"统一架构+蒙面建模+超大模型"技术路线的有效性,为构建通用多模态基础模型指明方向。

m0_59162248的博客 826

屠榜各大CV任务!微软提出BEiT-3:引领图像/文本/多模态预训练迈向“大一统”!...

点击下方卡片,关注“CVer”公众号AI/CV重磅干货,第一时间送达点击进入—>CV微信技术交流群转载自:微软研究院AI头条编者按:近年来,基础模型(foundation models,也被称为预训练模型)的研究从技术层面逐渐趋向于大一统(the big convergence),不同人工智能领域(例如自然语言处理、计算机视觉、语音处理、多模态等)的基础模型从技术上都依赖三个方面:一是 ...

阿木寺的博客 1587
上一篇: 超越所有MIM模型的BEiT v2来了!微软使用矢量量化视觉Tokenizers的掩码图像建模!
下一篇: CVPR2022|比VinVL快一万倍!人大提出交互协同的双流视觉语言预训练模型COTS,又快又好!
FightingCV
博客等级 码龄9年 154粉丝 105原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值