工业标准文档被大模型“劝退“?知识图谱三步法让AI秒变学霸,F1提升64%!小白程序员也能上手的开源神器

从小白到专家:DeepSeek 模型硬件配置完全指南 DeepSeek是由深度求索(DeepSeek)推出的一系列大语言模型,涵盖从轻量级到超大规模的不同版本。高效性:优化了推理和训练效率,适合多种应用场景。灵活性:支持从单机到分布式集群的部署方式。多场景适配:适用于文本生成、代码补全、对话系统等任务。为了充分发挥DeepSeek模型的性能,合理的硬件配置至关重要。以下是针对不同规模模型的具体硬件需求。 阅读详情

🔍工业标准文档为何难以“理解”?

工业标准文档(如 ASTM、API 等)是制造业、船舶、能源等行业的“技术宪法”,但它们有一个共同特点:

结构复杂、规则密集、条件嵌套、表格繁多。

传统大模型(LLM)在这些文档上的表现如何?

方法平均 F1问题
LLM-only0.016几乎“看不懂”
LLM + 全文0.235信息过载
传统 RAG0.277检索不到“条件-结果”逻辑
普通 KG-RAG0.304无法捕捉表格与规则的语义结构

📌 核心挑战

  1. 文档结构复杂:章节嵌套、表格、脚注、例外条款交织
  2. 逻辑规则密集:大量“如果…那么…”、“当…时…”条件语句
  3. 数值与单位混杂:英制/公制并存,需统一转换
  4. 同义表达多样:同一概念有多种表述,导致图谱冗余

🧪 三步构建“工业级”知识图谱

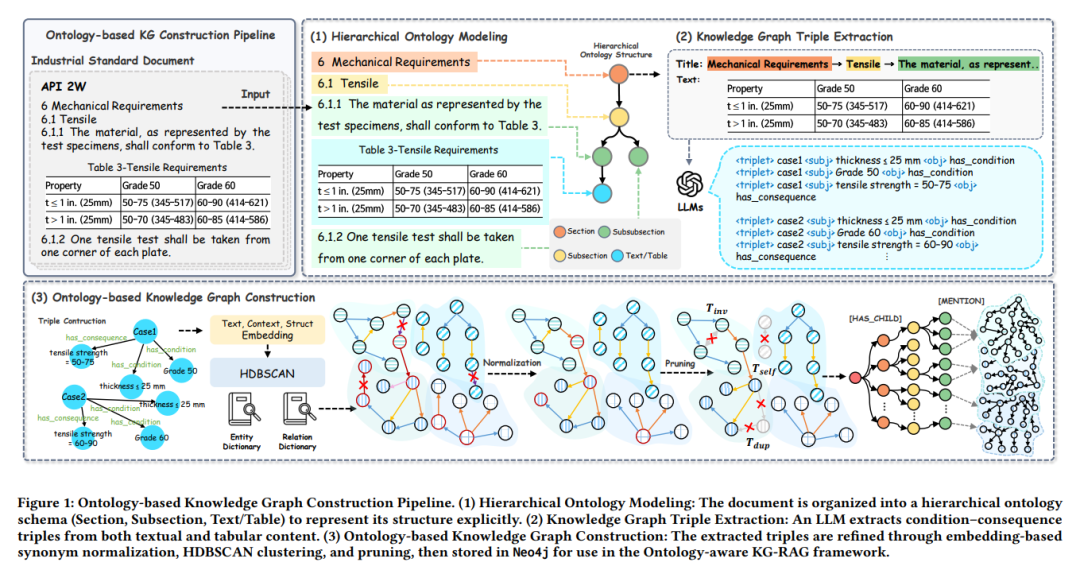
作者提出三阶段管道:本体建模 → 原子命题分解 → 知识图谱构建与精炼

🔧 阶段1:层次化本体建模

将文档结构映射为“本体骨架”:

Document├── Section│   ├── Subsection│   │   ├── Subsubsection│   │   │   ├── Text / Table│   │   │   │   └── Footnote
  • 保留文档的层级语义
  • 每个文本单元绑定其“上下文路径”

🔬 阶段2:原子命题本体建模

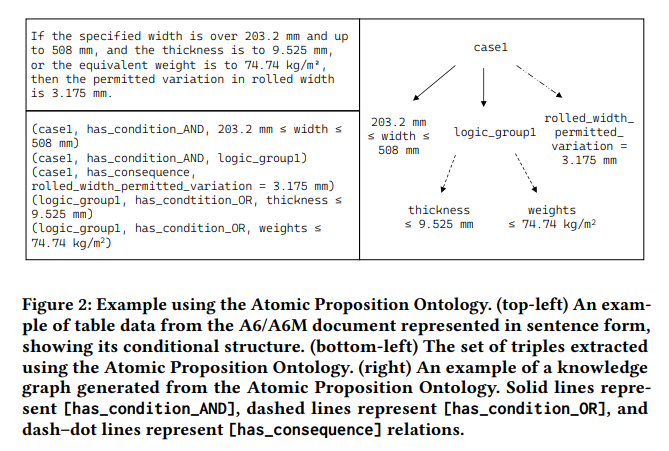
把复杂句子拆成“原子命题”,再提取三元组:

示例:
“若板厚 ≤ 25 mm 且为 Grade 50,则抗拉强度为 50–75 ksi。”

case1├── has_condition_AND│   ├── thickness ≤ 25 mm│   └── grade = 50└── has_consequence    └── tensile_strength = 50–75 ksi
  • 支持表格逻辑(每格=一个 case)
  • 支持条件嵌套(AND/OR/THEN)
  • 支持数值单位统一(英寸↔毫米)

🧹 阶段3:知识图谱精炼

解决“同义不同词”问题:

原始实体标准化后
plate thicknessthickness
tensile strengthstrength
  • Sentence-BERT + HDBSCAN 聚类同义词
  • 剪枝:去自环、去反向边、去重复三元组 最终图谱片段(Cypher 风格):
(:Section {title:"6.1 Tensile"})-[:HAS_CHILD]->(:Table)(:case1)-[:has_condition]->(:thickness ≤ 25 mm)(:case1)-[:has_consequence]->(:tensile_strength = 50–75)
```![](http://cdn.zhipoai.cn/5d0cf837.jpg)

📈 实验结果:全面碾压现有方法
---------------

### 📊 数据集:IndusSpec-QA

| 标准文档 | 页数 | 问题数 | 类型分布 |
| --- | --- | --- | --- |
| ASTM A578/A578M | 5 | 501 | 规则/表格/多跳 |
| API 2W | 27 | 384 | 同上 |
| ASTM A6/A6M | 63 | 663 | 同上 |

![](http://cdn.zhipoai.cn/10601313.jpg)

### 🔍 细分任务

| 任务 | 本体 KG-RAG vs KG-RAG | 提升 |
| --- | --- | --- |
| 表格问答 | 0.306 vs 0.158 | **+93.7%** |
| 规则问答 | 0.412 vs 0.367 | **+12.3%** |
| 多跳推理 | 0.369 vs 0.231 | **+59.7%** |

![](http://cdn.zhipoai.cn/c5bf4ddc.jpg)

### 🧪 毒性条款检测

| 方法 | F1 | Recall |
| --- | --- | --- |
| 最佳基线 | 0.900 | 0.893 |
| **本体 KG-Retriever** | **0.910** | **0.913** |

---

🧠 消融实验
------

| 配置 | F1 | 说明 |
| --- | --- | --- |
| 仅 LLM + 文档 | 0.298 | baseline |
| + 本体结构 | 0.413 | 结构即知识 |
| + KG 三元组 | 0.334 | 语义增强 |
| **+ 本体 + KG** | **0.494** | **1 + 1 > 2** |

![](http://cdn.zhipoai.cn/77c124ef.jpg)

---

✅ 结论与启示
-------

> **工业标准不再是 LLM 的“禁地”。**

### 🌟 核心贡献

1. 方法论:首个面向工业标准的“本体+KG+RAG”统一框架
2. 数据:发布 IndusSpec-QA 与 Toxic Clause 数据集
3. 工程:全流程开源(Neo4j + LLM + 提示模板)
4. 性能:平均 F1 提升 \*\*64%\*\*,表格任务 **+93.7%**

---

🧭 未来方向
------

1. 多语言标准支持(ISO、EN、GB、JIS)
2. 动态更新机制(标准版本迭代)
3. 合规审计助手(自动标注“毒性条款”)
4. 多模态扩展(图纸 + 标准 + 检测报告)

---

**传送门:**

```plaintext
> 论文地址:[arXiv:2512.08398](https://arxiv.org/pdf/2512.08398)  > 标题:《Ontology-Based Knowledge Graph Framework for Industrial Standard Documents via Hierarchical and Propositional Structuring》https://anonymous.4open.science/r/ontology_based_kg_paper/README.md

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

DeepSeek R1本地化部署与联网功能实战指南:从零搭建智能对话系统 在人工智能技术快速发展的今天,如何将先进的对话模型DeepSeek R1部署到本地环境并赋予其联网能力,成为许多开发者和企业关注的重点。本文将深入讲解完整的本地化部署流程,并通过实例代码演示如何为模型添加实时网络访问功能。 阅读详情

相关推荐

未来已来?2026最新国内15家AI大模型应用盘点(附体验网址,持续更新)

未来已来?国内15家AI大模型盘点及体验网址,一起来看看吧!

Code_流苏:在代码中寻诗意,在实践中觅真知 11万+

TensorFlow相关组件的安装

TensorFlow相关组件的安装

AAI666666的博客 3934

编译CycloneDDS和CycloneDDS-CXX踩过的坑——CMake Error at CMakeLists.txt:227 (find_package):

最近编译CycloneDDS和CycloneDDS-CXX踩了两个坑,花了不少时间。做个简单的记录,免得以后又踩到。注意:CycloneDDS-CXX编译依赖CycloneDDS,因此必须先编译CycloneDDS需要严格按照步骤进行,否则要入坑步骤如下,1先编译CycloneDDS以上步骤完成CycloneDDS的编译和安装,生成的bin include lib等位于install目录下面。

usstmiracle的博客 1900

本地部署DeepSeek大模型电脑配置推荐

针对本地部署DeepSeek大模型的配置需求,需根据模型规模(如7B/13B/70B参数)和量化方案进行区分。

huang9604的博客 3万+

Python Trimesh库实战:5分钟搞定STL文件解析与3D模型可视化

本文介绍了如何使用Python的Trimesh库快速解析STL文件并进行3D模型可视化。通过简洁的代码示例,演示了从环境搭建、模型加载、几何数据提取到基础变换和批量处理的核心流程,帮助开发者和工程师在5分钟内高效完成3D数据处理与可视化任务。

weixin_32005771的博客 160

【BUAA】【计组】计算机组成 pre (含详细解析)

BUAA 计算机组成 本文章旨在为@走肖暂时无法接通的系列文章创造一个目录,收藏本文章,方便查阅! 1. 入门测试 2. 基础知识 3. Logisim   欢迎来到 Logisim 的世界   Logisim 门电路   Logisim 组合电路   Logisim 时序电路   Logisim 仿真与调试   应用与挑战 4. Verilog 与仿真工具   前言   ISE 入门   VCS 入门   Verilog 语法   Verilog 题目实例与分析   Verilog 工程的设计开发调试

Schrodinger007的博客 9809

部署deep seek需要什么样的硬件配置?

部署DeepSeek(或其他类似的大语言模型)的硬件配置需求取决于具体场景(如推理、微调、训练)、模型规模(参数量)、并发请求量以及性能要求。使用量化(4/8-bit)、模型并行(Tensor Parallelism)、流水线并行等技术降低资源需求。:70B模型需2-4张A100(80GB)进行推理,或使用量化技术(如GPTQ/GGUF)降低显存需求。:2-4张显存≥40GB的显卡(如NVIDIA A100 40GB/80GB、H100):NVMe SSD ≥ 512GB(模型文件约占用20-30GB)

5万+

【QGIS】PyCharm集成pyqgis的processing工具箱:环境配置与初始化实战

本文详细介绍了如何在PyCharm中配置QGIS的Python环境并成功集成其强大的Processing工具箱。文章核心解决了独立环境下导入processing模块失败、算法无法调用等常见难题,通过手动添加插件路径和执行关键初始化步骤,实现了在PyCharm中丝滑调用QGIS地理处理算法,从而将复杂的空间分析流程自动化。

weixin_28831399的博客 391

【大模型】—AI大模型总体概述

本文将对AI大模型进行简要介绍,包括其定义、发展历程以及分类等。

crystal_csdn8的博客 2万+

Win7运行豆包桌面版的兼容性原理与实操方案

Windows 7作为已停止主流支持的操作系统,其与现代Electron应用的兼容性问题本质是API层面的系统调用断层。Electron 28+依赖的GetSystemTimePreciseAsFileTime、SetThreadDescription等Windows 10专属API,在Win7 SP1中天然缺失,导致‘无法定位程序输入点’等典型错误。解决路径并非简单打补丁,而是需理解底层ABI差异、补丁堆叠边界及动态API转发机制。关键技术价值在于通过兼容层(如VxKex NEXT)或运行时降级(Elec

weixin_33290540的博客 1352

大白话讲解Numpy中什么是一维、二维、三维数组,以及5种创建方式

NumPy中提供了多种创建数组的方式,其中最基本的方式就是通过array()函数创建数组在使用该函数时直接传入列表或元组即可。 通过array()函数分别创建一维数组、二维组和三维数组,那么什么是维度呢?一维、二维、三维有什么区别? 1、什么是维度? 维度可以理解为描述数据的一种 “方向” 或者 “层次”。在数组中,维度的数量决定了我们需要用多少个索引来访问一个元素 2、一维、二维、三维的区别? (1)一维:一维数组就像是一条直线上排列的一组数据,例如: a = np.array([1, 2

1365

DeepSeek本地部署详细指南

DeepSeek本地部署详细指南随着人工智能技术的飞速发展,本地部署大模型的需求也日益增加。DeepSeek作为一款开源且性能强大的大语言模型,提供了灵活的本地部署方案,让用户能够在本地环境中高效运行模型,同时保护数据隐私。以下是详细的DeepSeek本地部署流程。(一)硬件需求最低配置:CPU(支持AVX2指令集)+ 16GB内存 + 30GB存储。推荐配置:NVIDIA GPU(RTX 3090或更高)+ 32GB内存 + 50GB存储。(二)软件依赖。

weixin_49684553的博客 3万+

AI原生应用在UGC内容审核中的实战经验

AI原生应用(AI-Native Application)——以机器学习模型为核心驱动力,深度整合数据、算法、工程架构的完整系统——为破解这一三角难题提供了全新范式。全链路数据驱动:从数据采集、模型训练到决策优化,形成闭环自治系统,无需人工规则干预多模态深度理解:同时处理文本、图像、音频、视频等多类型内容,理解语义而非简单匹配特征自适应进化能力:通过人机协同反馈持续学习新型违规模式,模型周级迭代成为常态审核效率提升300%:单条视频审核耗时从2.3秒降至0.7秒。

AI算力网络与通信的博客 1149

一文让你搞懂什么是AI大模型

AI大模型(Large AI Models)是指具有大量参数和复杂结构的人工智能模型。这些模型通常基于深度学习技术,能够处理大量数据并从中学习复杂的模式和关系。大模型的出现,极大地提升了AI在各个领域的表现能力。通过本文的介绍,相信你已经对AI大模型有了全面的了解。无论是自然语言处理、图像识别,还是自动驾驶、医疗健康,AI大模型都展现出了强大的能力和广泛的应用场景。希望本文能够帮助你更好地理解和应用AI大模型,推动你的技术创新和实践。

码上飞扬的博客 9979

QGIS安装与使用教程

QGIS安装与使用教程

weixin_46713695的博客 2万+

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

最近,大模型岗位爆了。。。

重磅消息,国资委打响了国内AI第一枪!这意味着传统行业又迎来了一次大洗牌,现在国内头部人工智能公司已经开始用AI数字人助力各行各业,除此之外,知名大厂也都在布局AI市场。懂的程序员年薪已经翻到风口之下,与其焦虑被行业淘汰,不如先人一步掌握 AI 大模型技术。为帮助大家提升竞争力,为了帮助普通程序员享受时代红利,

qq_46094651的博客 1017

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

什么是AI大模型(非常详细)从零基础入门到精通,收藏这篇就够了

瞧瞧这张表,OpenAI的GPT系列,Google的Gemini、PaLM,Meta的Llama……个个都是响当当的名号。参数量一个比一个吓人,发布时间一个比一个新。这哪是技术竞赛,分明是烧钱大赛!每个模型都吹嘘自己多牛逼,能干多少事。但用户真正能用上的、用得爽的,又有多少?别光看广告,疗效才是关键。而且,这些巨头们的技术壁垒越筑越高,小玩家还怎么活?

leah126的博客 6324

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

2025年全球AI大模型排行:DeepSeek、通义千问、GPT‑4o

2025年国内外AI大模型排名显示,国内领先的模型包括阿里巴巴的通义千问、字节跳动的豆包大模型和百度的文心一言4.0,这些模型在中文理解、多模态融合和商业化应用方面表现突出。国外的领先模型如OpenAI的GPT‑4o和Google的Gemini 2.0 Ultra,则在多模态输入、大规模参数和全球化应用上具有显著优势。国内外模型均持续迭代,优化性能并拓展应用场景,满足不同行业需求。

Explinks的博客 1万+

DeepSeek-VL2部署指南

DeepSeek-VL2是一款力图学习和实现深度学习和视觉语言结合的工具包。本文将介绍如何在本地环境中安装和部署DeepSeek-VL2。

haibo2144的博客 3万+

PyTorch基础(14)-- torch.roll()方法

一、前言 二、torch.roll()方法解析 三、案例分析

奋斗の博客 9036

AI大模型知识点大梳理

AI大模型是指具有巨大参数量的深度学习模型,通常包含数十亿甚至数万亿个参数。这些模型可以通过学习大量的数据来提高预测能力,从而在自然语言处理、计算机视觉、自主驾驶等领域取得重要突破。AI大模型的定义具体可以根据参数规模来分类

yang1fei2的博客 3万+

国内12家主流大模型,谁是地表最强?亲测后发现是它!。。。

大模型GPT-3.5,2022年11月发布。 可谓春风化雨,雨后春笋一般。 到现在2024年,国产大模型工信部注册的,已有几百家。 国产大模型崛起速度之快,令人惊叹。

ytt0523_com的博客 3382

盘点2024国内热门AI大模型:哪个最好!

近年来,中国AI技术迅猛发展,特别是在大模型领域取得了显著成就。众多科技巨头和初创企业纷纷推出各具特色的AI大模型,这些模型在智能问答、知识推理、内容创作等多个方面展现出强大的能力。今天,我们来盘点一下国内几个主流的AI大模型。

helphelptongxue的博客 6964

2024中国排名前十AI大模型进展、应用案例与发展趋势

2024年,中国在AI大模型领域的发展取得了显著进展。以下是中国排名前10的AI大模型及其主要进展:讯飞星火认知大模型:具备文本生成、语言理解、知识问答、逻辑推理、数学能力、代码能力和多模态能力。在知识学习和内容创作方面表现出色,能进行要素抽取、问题生成,并结合外部知识进行合理拓展。文心一言大模型(百度):能理解复杂提示词,适用于文学创作、商业文案撰写、多模态生成等。在数理科学、语言能力、道德责任、行业能力及综合能力等方面表现优异。

2401_85280106的博客 5192

值得收藏!十大中国流行的AI大模型企业及平台汇总

在当今这个信息化迅速发展的时代,人工智能技术已经成为推动社会进步的重要力量。特别是在我国,AI大模型技术的发展速度令人瞩目,各种平台纷纷涌现,表现出强大的技术实力和广泛的应用前景。

kaka0722ww的博客 1万+
上一篇: 一文搞懂KG+RAG!如何利用知识图谱突破瓶颈,实现高质量问答?建议收藏!
下一篇: 真香警告!企业知识库检索命中率从73%干到92%,让LLM先写“小抄“再检索,小白也能秒懂!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2835原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值