


导语
从视觉与语言的初步对齐,到跨模态理解与生成的深度融合,多模态大语言模型(Multimodal LLM)的演进正以前所未有的速度重塑人机交互的边界。
回溯这一技术脉络,CLIP 首次通过对比学习在海量图文数据中建立起语义对齐的“通用坐标系”,为后续模型奠定了感知基础;
而如今,以 Qwen3-Omni 为代表的新型多模态智能体,已不再满足于被动理解——它们能同步处理文本、图像、音频乃至视频输入,并以统一的语言接口进行实时、连贯、上下文感知的推理与生成。
这一跃迁不仅标志着对齐范式从“表征对齐”迈向“行为对齐”,更预示着通用人工智能在多模态世界中的真正落地。本文将解构这一演进之路,揭示对齐技术如何从静态匹配走向动态协同。
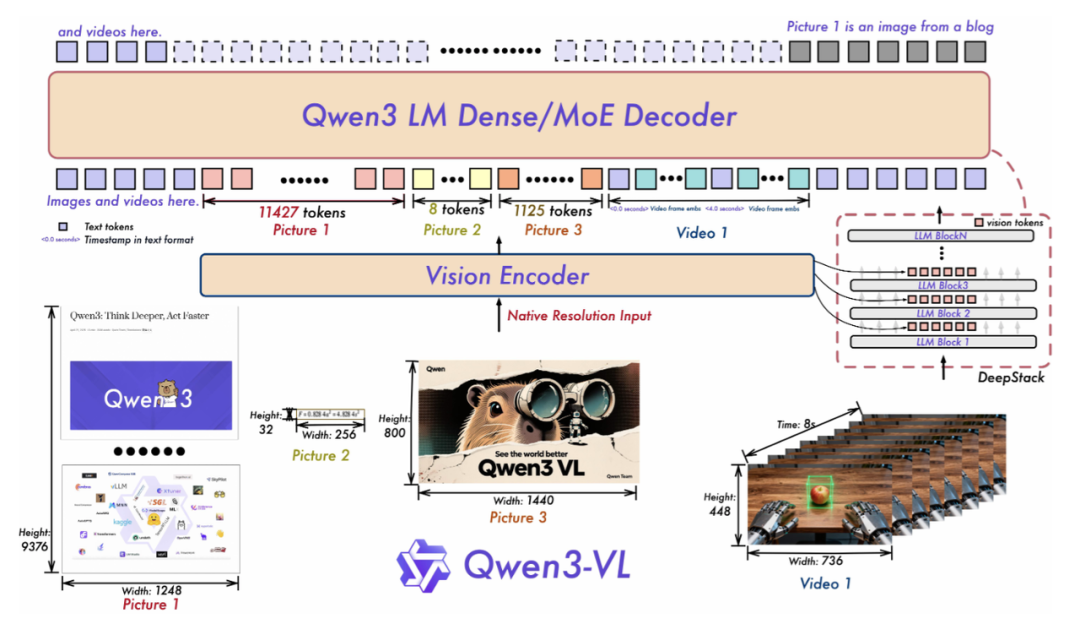
Qwen3-VL(2025)
多模态大模型的对齐演进可归纳为三条并行而互补的技术路线:
路线1(CLIP模型 / 对比对齐底座) 以对比学习为核心,构建通用、稳定、可复用的跨模态表征空间,强调高效检索与语义对齐;
路线2(生成模型 / 组装式对齐) 则通过“组装+轻对齐”策略,将预训练视觉与语言大模型深度融合,赋予系统视觉理解、推理与生成能力,逐步走向统一架构与多尺度感知;
路线3(Data Agent系统) 跳出静态对齐框架,构建自监督、自迭代的数据飞轮,利用智能体自动合成高质量多模态数据,并在工具交互与环境反馈中持续进化。
这三条路线分别从表征基础、模型架构与数据生态三个维度,共同推动多模态智能从“感知对齐”迈向“行为协同”与“自主进化”。
路线1 (CLIP模型 / 对比对齐底座):
CLIP 路线通过对比学习将图像与文本编码器对齐,为多模态系统提供通用的“对齐底座”。 视觉模型与语言模型各自使用海量的非配对单模态数据训练,再用少量图文对进行 embedding 对齐,形成一个稳定、可复用的模态共享空间。
特征
- • 视觉 encoder 与文本 encoder 分开训练,模型之间没有结构性的交互;
- • 通过 对比损失(InfoNCE) 对齐;
- • 适用于检索、embedding 提供、过滤数据,不具备视觉推理、对话、生成能力,对非常复杂的Vision-Language任务支持能力有限。
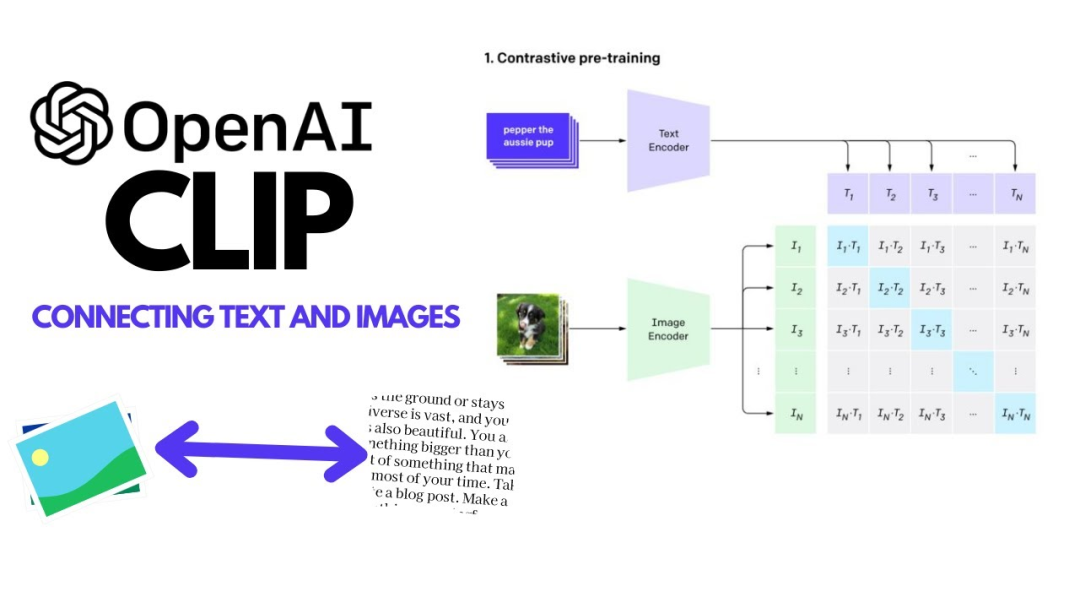
图源自网络
发展趋势(至 2025.12)
- 高质量 / 精炼 / 蒸馏 + 更少数据
- 更强的 “细粒度 + 长文本 + 组合性语义” 对齐能力
- 轻量化 / 高效部署 + 低资源环境适配
主要技术路线
| 模型 | 发表时间 | 创新概括 |
|---|---|---|
| CLIP | 2021 | 首次用大规模图文对比学习统一视觉与语言表示,定义了多模态对齐的基础范式。 |
| ALIGN | 2021 | 使用大规模 noisy 图文对实现弱监督大规模对齐,展示“噪声也能驱动语义对齐”。 |
| EVA-CLIP | 2023 | 通过更强视觉 backbone(EVA/Vision Transformer),显著提升 CLIP 图像表征质量。 |
| SigLIP | 2024 | 用 sigmoid contrastive loss 替代 softmax,使图文对齐更稳定且更高效。 |
| CLOC | 2024 | 引入区域级对齐(region-text contrastive),提升细粒度视觉文本对齐能力(Contrastive Localized Language-Image Pre-training) |
| jina-clip-v2 | 2024 | 多语言、多模态通用 embedding,对比学习扩展到跨语言检索与理解。 |
| Long-CLIP | 2024 | 扩展 CLIP 以处理更高分辨率与更长序列输入,显著强化细节密集图像的理解能力。 |
| SigLIP 2 | 2025 | 在 SigLIP 基础上进一步改进表征与训练策略,结合更强视觉塔与更鲁棒对齐目标。 |
| HQ-CLIP | 2025 | 利用VLM 驱动的数据精炼管道,以十分之一数据量超越传统 CLIP 性能。 |
| DCLIP (Distilled CLIP) | 2025 | 用 transformer teacher + 少量高质量图文对蒸馏,保持 94% Zero-shot 能力同时大幅提升检索。 |
| HiMo-CLIP | 2025 | 通过语义层级化与单调性对齐,解决 CLIP 在面对长 / 复杂 /分层文本描述 + 图像上的弱点。 |
路线2 (生成模型 / 组装式对齐):
总结:通过“组装”预训练好的多个大模型(视觉、语言、音频等),再用少量配对数据或高质量蒸馏数据进行轻量对齐,使大模型具备视觉理解、生成、推理能力。
主要技术路线
| 技术路线 | 描述 | 特点 | 代表模型 |
|---|---|---|---|
| Cross-Attention / Resampler 对齐(Shallow Fusion) | 通过跨注意力或 Perceiver-Resampler,让 LLM 在推理过程中动态访问视觉 token。 | 泛化能力强、few-shot 性能优,但结构更复杂、训练成本高。 | Flamingo (2022)、OpenFlamingo (2023) |
| Q-Former 查询式对齐 | 用一组可学习的 query 从视觉 backbone 中抽取语义紧凑与语言更契合的视觉 token。 | 特征抽取质量高,对不“LLM-friendly”的视觉编码器效果更佳,但模块偏重。 | BLIP-2 (2023)、InstructBLIP (2023),BLIP-3(2024) |
| Adapter / Projection 对齐 | 将视觉特征通过 Linear/MLP 投影到 LLM 的 embedding 空间,让 LLM 能直接读取视觉 token。 | 模块轻、训练数据需求低,对齐成本极小,适合快速构建多模态原型。 | LLaVA (2023)、MiniGPT-4 (2023)、Phi-3-Vision (2024)、LLaVA-NeXT (2024)、LLaVA-OneVision-1.5 (2025) |
| 视觉 Token 压缩 / Token Reduction | 用 Token Merging / Pooling / Cluster 等方法减少视觉 token 数量,降低跨模态计算 | 提升推理速度、减少冗余视觉信息、提升对齐效率 | Token Merging (2022)、SigLip-Compress (2024)、InternVL2-Compress (2024) |
| 对齐训练范式(蒸馏 / 指令微调/ 合成数据) | 使用LLM生成高质量配对数据,或用指令微调/蒸馏方式让学生模型学习跨模态语义一致性。 | 大幅降低对真实标注需求 | LLaVA-1.5/NeXT (2023–24)、OmniQuant (2024) |
| 多尺度/层级视觉 Token 对齐(Hierarchical / Multi-Scale) | 构建结构化、多尺度的视觉 token (DeepStack),作为标准 token 注入 LLM。 | 将不同的视觉token输入到LLMs的不同层中, 显著减轻了视觉token引入的效率开销 | Qwen2-VL (2024)、InternVL2 (2024)、Yi-VL (2024)、Qwen3-VL((2025) |
| MoE 多模态专家(Multimodal MoE) | 根据输入模态动态路由到不同专家(视觉/跨模态专家),提高模型容量与效率。 | 扩展性强、成本可控 | Qwen3-Omni (2025),Uni-MoE-2.0-Omni (2025) |
| 非配对数据训练(unpaired training) | 无配对多模态表征学习 | 无需严格配对的多模态数据 | Unpaired Multimodal Learner (2025)、DoraCycle (2025) |
发展趋势(至 2025.12):
- 对齐模块极简化(Minimal Alignment): 复杂 Adapter/Q-Former 正在被 Linear projection或 MLP 取代,视觉特征越来越“LLM-friendly”。
- 蒸馏数据取代大规模配对数据: 依靠 GPT-4V / Gemini 生成的高质量小数据(几万到几十万)即可完成强对齐,取代传统上亿规模图文对。
- 视觉 Token 统一化与多尺度化: 越来越多模型采用统一的 Multimodal MoE + Multi-scale 视觉 token 结构,使 LLM 能直接读取视觉层级信息(如 Qwen3-VL、Qwen3-Omni)。
- 视觉推理能力成为对齐目标: 对齐不再只是“看懂图”,而是要求模型具备跨模态推理、步骤分解 (CoT)、视觉任务规划等能力。
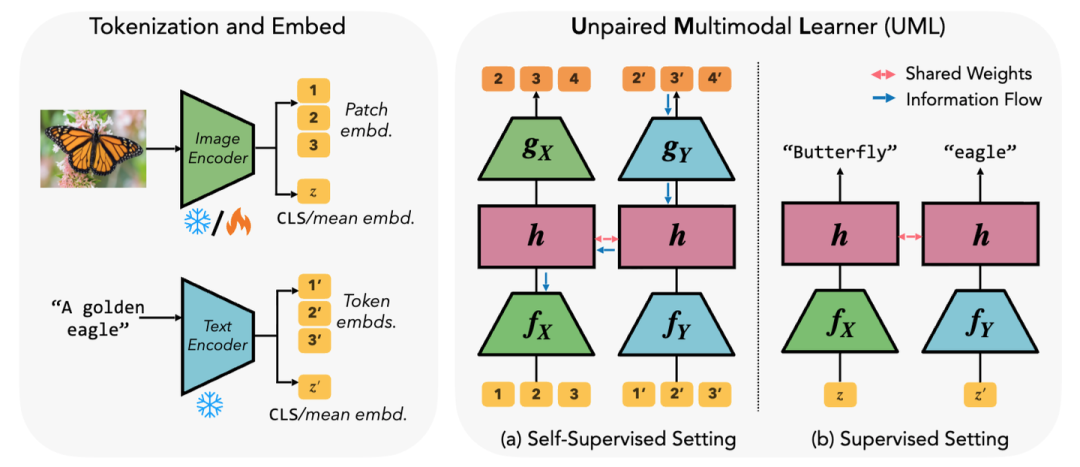
Unpaired Multimodal Learner (2025):非配对多模态对齐
路线3 (Data Agent系统):
本质上是一种 自动数据生成 + 自监督迭代改进 的体系。
任务:
- 自动生成伪标注或合成对齐数据
- 筛选数据
- 训练或微调学生模型
- 闭环迭代
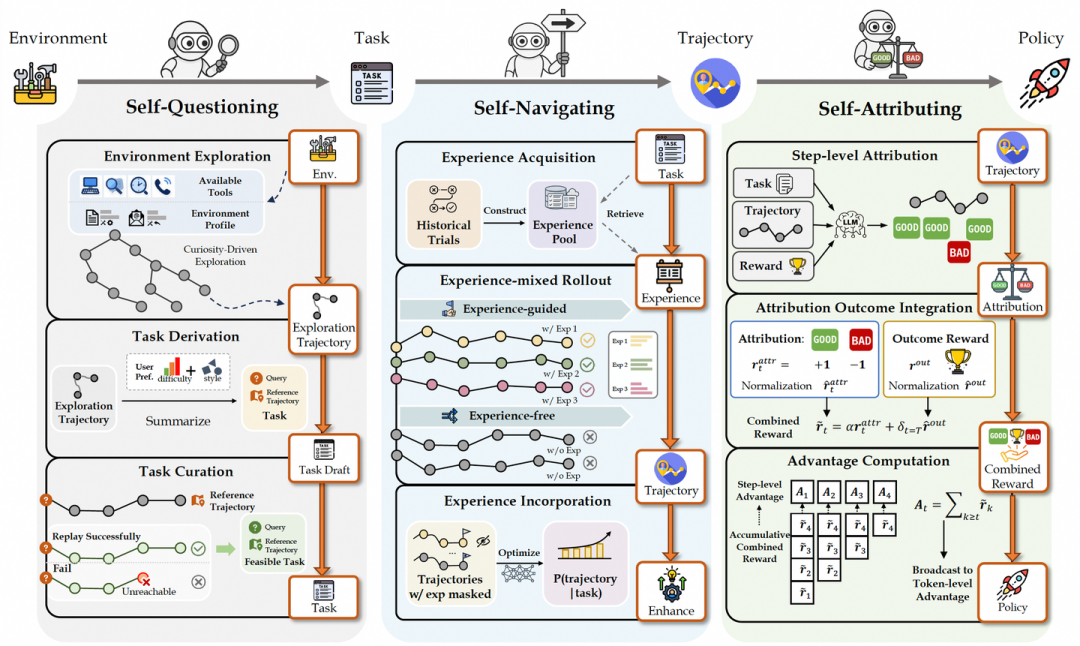
AgentEvolver(2025)
发展趋势(至 2025.12):
1.多模态 + 工具使用融合 :不仅仅是视觉 + 文本 + 对话,还包含工具调用、环境操作、网页 UI 操作等复杂动作,并逐渐拓展至更广泛虚拟/现实环境 (游戏、仿真、机器人、业务系统等)。
2.大规模轨迹 & 数据合成 / 自动化 data-engine :为多模态 Agent 提供丰富的、多样化的训练 + 评估数据 (网页交互、工具调用、多轮任务等),降低对人工标注 / 人为构造任务的依赖。
3.长时记忆 + 自我改进机制 : Agent 能跨任务 / 跨 session 总结经验、学习、优化,提升持续性、稳定性与样本效率。
主要技术路线:
1. 自监督 / 自进化 Agent(Self-Evolving Agents)
| 代表论文 / 系统 | 时间 | 概括 |
|---|---|---|
| Voyager | 2023 | 提出 技能库自动扩展(automatic skill library growth) 与 代码进化循环(code self-evolution loop);让 LLM 通过环境反馈自主生成、改写、验证技能代码。 |
| CAMEL | 2023 | 设计 双角色协同对话框架(role-playing multi-agent system),通过角色分工促进任务自动分解与收敛;引入稳定的 multi-agent self-consistency protocol |
| AgentEvolver | 2025 | 通过 self-questioning、self-navigating、self-attributing 三阶段自进化机制,让 Agent 自动提出训练任务、生成经验轨迹,并形成持续的自我提升循环。 |
2. 自动任务生成与数据合成(Automatic Task/Data Generation)
| Self-Instruct | 2023 | 提出 LLM bootstrap task generation:利用模型自身迭代生成指令 → 过滤 → 扩展,实现无人工介入的大规模任务集构建。 |
|---|---|---|
| LLaVA-1.6/Next Data Engine | 2024 | 构建基于 GPT-4V 的 多模态蒸馏管道,生成视觉链式推理数据(visual CoT)与目标导向对话,提升复杂视觉任务数据的自动化构造能力 |
| Graph2Eval | 2025 | 从知识图谱自动生成任务图(task graph),再转译为 多模态 + 网页交互 + 工具调用 的任务;同时提供自动化评测生成机制。 |
| Explorer | 2025 | 提出一种可扩展的数据合成方案,自动生成 94K+ 成功网页交互轨迹 (screenshot + 元素 + 动作),使 Web-Agent 的训练/评估具备更大规模数据基础 |
3. 多模态 Agent 基础模型(Multimodal Agent Models)
| ViperGPT | 2023 | 提出 视觉推理程序生成(vision-program synthesis):LLM 自动调用视觉模型组成执行链,实现可解释的视觉推理 pipeline。 |
|---|---|---|
| Qwen2-VL, InternVL2 | 2024 | 构建 统一视觉 token 体系(multi-scale unified V-tokens),实现图像、视频、文档等视觉格式的统一 token 化,为 Agent 输入提供结构一致的视觉接口 |
| Magma | 2025 | A Foundation Model for Multimodal AI Agents,将“感知(vision tower)—推理(LLM)—行动(action module)”统一进一个基础多模态 Agent 模型,并引入 vision-conditioned plan token 结构进行视觉驱动行为规划。 |
4. 工具使用 / 外部环境操作(Tool-Use & Environment Agents)
| ReAct | 2023 | 提出将 LLM 的 reasoning traces(思维链) 与 action traces(动作调用) 融合,使推理与行动可以在统一轨迹中交替执行 |
|---|---|---|
| Toolformer | 2023 | 通过 self-labeling tool demonstration,让 LLM 自动学习何时调用 API、如何构造参数,不依赖人工示例。 |
| WebVoyager | 2024 | 使用 网页 UI 结构解析(DOM + Vision) 与策略生成,使 Agent 能够稳健理解复杂网页并进行操作规划 |
| Multi-modal Agent Tuning | 2024 | 构建 multi-modal tool-usage 数据集 (MM-Traj),并 fine-tune VLM 使其能基于视觉 + 文本决定工具调用与操作序列 |
| WebSailor | 2025 | 提出覆盖全流程的 端到端后训练框架:从不确定性数据合成 → 推理轨迹优化 → 冷启动小样本微调 → 高效网页强化学习的一体化体系。 |
| WebCoach | 2025 | 引入 persistent external memory + memory-guided advice 注入机制,让 Web-Agent 能“记住”过去交互经验、复用历史轨迹、减少重复错误 |
| MLLM‑Tool | 2025 | 结合开源 LLM + 多模态 encoder,使 Agent 能够根据视觉/音频 + 自然语言指令选择、调用合适工具 |
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

 2003


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


