别再凭感觉调参了!LangChain内部评估体系首次公开,这才是衡量智能体好坏的唯一标准!

智能体记忆系统评测基准:从概念到实践的统一标准 在人工智能与智能体开发领域,记忆系统是实现长期交互与持续学习的关键技术组件。其核心原理是通过信息存储、检索与管理机制,使智能体能够积累和利用历史经验。这一技术的价值在于突破传统无状态模型的局限,为复杂任务处理提供上下文支持。从工程实践角度看,记忆系统需在准确性、完整性、检索效率与存储成本之间取得平衡,其应用场景广泛覆盖多轮对话、任务状态追踪与知识积累等智能体核心功能。当前,随着LangChain、LlamaIndex等框架的普及,如何客观评估不同记忆方案的性能成为行业痛点。Agent Memory Chal 阅读详情

过去一个月,LangChain 基于 Deep Agents 框架交付了四个应用:

  • DeepAgents CLI: 一个编码 agent
  • LangSmith Assist: LangSmith 内置的智能助手
  • Personal Email Assistant: 能从用户交互中学习的邮件助手
  • Agent Builder: 无代码 agent 搭建平台

在开发和部署这些 agent 的过程中,团队为每个应用都配置了评估系统,积累了不少实战经验。这篇文章会深入探讨评估深度 agent 的几个关键模式:

  1. 深度 agent 需要为每个测试用例定制测试逻辑 —— 每个案例都有自己独特的成功标准
  2. 单步运行 特别适合验证特定场景下的决策(还能省 token)
  3. 完整轮次运行 适合测试 agent 的"最终状态"
  4. 多轮对话测试 能模拟真实用户交互,但需要保持测试可控
  5. 环境配置很关键 —— 深度 agent 需要干净、可复现的测试环境

一、术语说明

先解释几个后文会用到的概念。

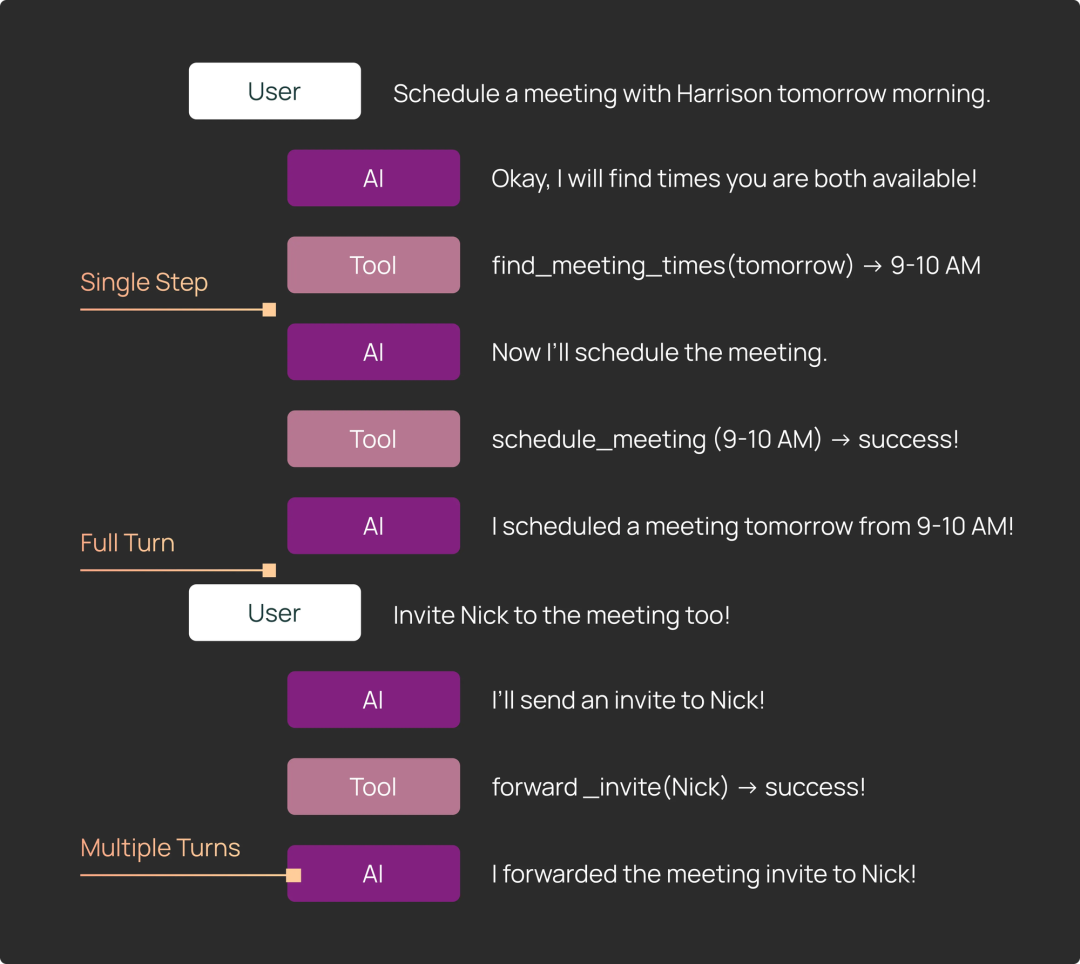
Agent 的运行方式:

  • 单步 (Single step): 限制核心 agent 循环只运行一轮,看它会采取什么行动
  • 完整轮次 (Full turn): 让 agent 完整处理一次输入,可能包含多次工具调用
  • 多轮对话 (Multiple turns): 让 agent 完整运行多次,模拟用户和 agent 之间的多次交互
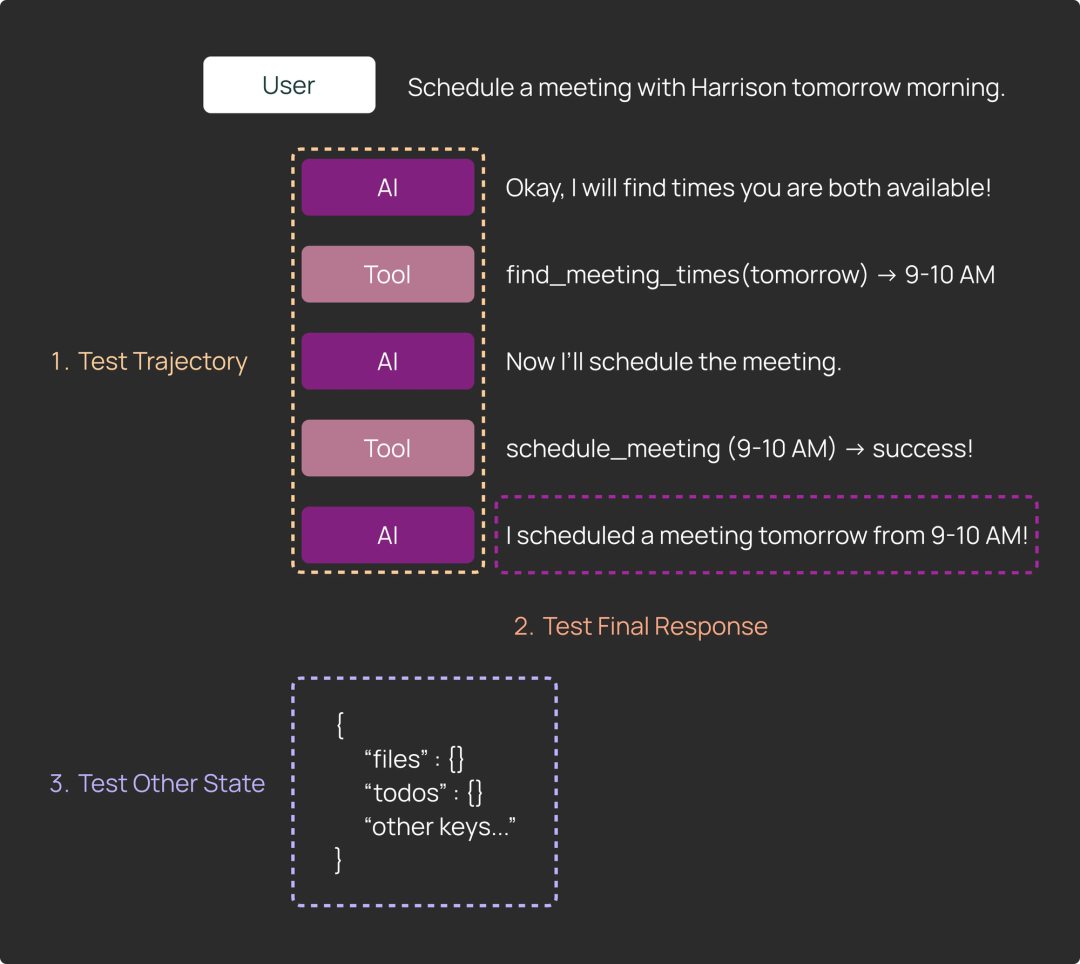
可以测试的内容:

  • 执行轨迹 (Trajectory): agent 调用了哪些工具,传了什么参数
  • 最终响应 (Final response): agent 返回给用户的最终回复
  • 其他状态 (Other state): agent 运行过程中产生的其他内容(比如文件、制品等)
二、智能体评估实战

1 深度 Agent 的每个测试用例都需要定制化逻辑

传统的 LLM 评估流程很直接:

  1. 构建示例数据集
  2. 写一个评估器
  3. 用应用处理数据集生成输出,然后用评估器打分

每个数据点的处理方式完全一样 —— 跑同样的应用逻辑,用同样的评估器打分。
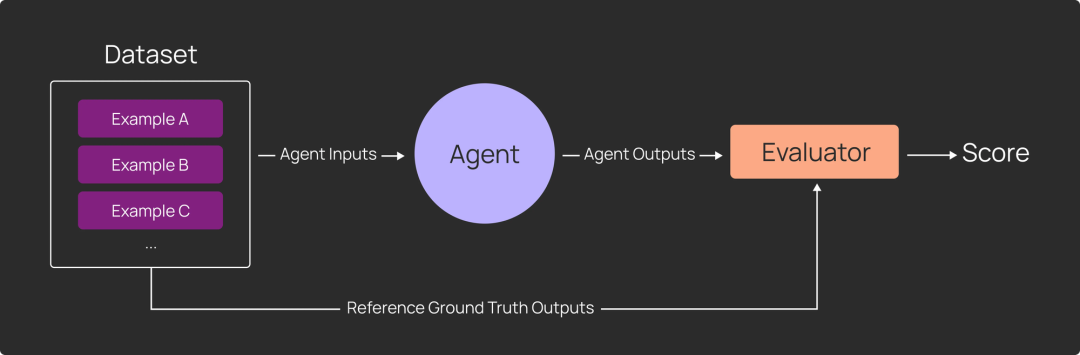
深度 Agent 打破了这个假设。除了最终消息,还需要测试更多内容。每个数据点的"成功标准"可能完全不同,需要针对 agent 的轨迹和状态做特定的断言。

看个例子:
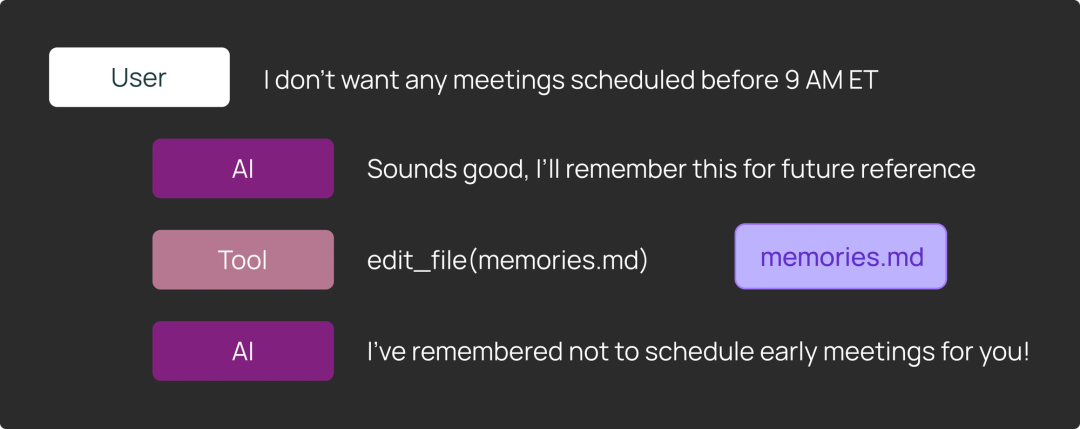
有个日历调度 agent,能记住用户偏好。用户说"记住,不要在早上 9 点前安排会议"。需要验证这个 agent 是否在文件系统中更新了自己的记忆。

为了测试这个场景,可能需要验证:

  1. agent 是否对 memories.md 文件调用了 edit_file
  2. agent 是否在最终消息中告知用户记忆已更新
  3. memories.md 文件是否真的包含了不安排早会的信息。可以:
  • 用正则表达式查找"9am"
  • 或者用 LLM-as-judge 配合特定成功标准,做更全面的文件更新分析

LangSmith 的 Pytest 和 Vitest 集成支持这种定制化测试。可以针对每个测试用例,对 agent 的轨迹、最终消息和状态做不同的断言。

# 标记为 LangSmith 测试用例@pytest.mark.langsmithdef test_remember_no_early_meetings() -> None:    user_input = "I don't want any meetings scheduled before 9 AM ET"    # 可以把 agent 的输入记录到 LangSmith    t.log_inputs({"question": user_input})    response = run_agent(user_input)    # 可以把 agent 的输出记录到 LangSmith    t.log_outputs({"outputs": response})    agent_tool_calls = get_agent_tool_calls(response)    # 断言 agent 调用了 edit_file 工具来更新记忆    assert any([tc["name"] == "edit_file"and tc["args"]["path"] == "memories.md"for tc in agent_tool_calls])    # 用 LLM-as-judge 记录反馈: 最终消息是否确认了记忆更新    communicated_to_user = llm_as_judge_A(response)    t.log_feedback(key="communicated_to_user", score=communicated_to_user)    # 用 LLM-as-judge 记录反馈: 记忆文件是否包含正确信息    memory_updated = llm_as_judge_B(response)    t.log_feedback(key="memory_updated", score=memory_updated)

关于如何使用 Pytest 的通用代码示例,可以查看这份文档:

这个 LangSmith 集成会自动把所有测试用例记录到实验中,这样就能查看失败用例的 trace(方便调试),还能跟踪结果的变化趋势。

2 单步评估很实用,效率也高
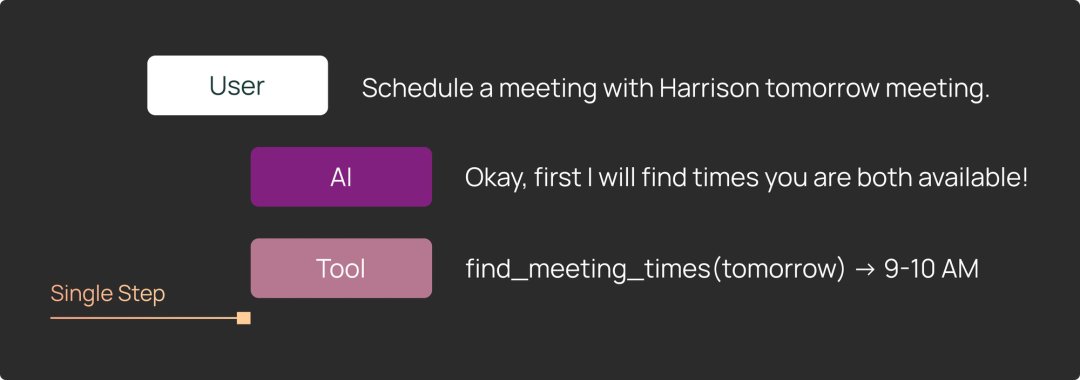
在深度 Agent 的评估中,大约一半的测试用例都是单步评估,也就是说,在特定的输入消息序列之后,LLM 会立即做什么决策?

这对验证 agent 在特定场景下是否用正确的参数调用了正确的工具特别有用。常见的测试场景包括:

  • 是否调用了正确的工具来搜索会议时间?
  • 是否检查了正确的目录内容?
  • 是否更新了记忆?

回归问题往往出现在单个决策点,而不是整个执行序列。如果用 LangGraph,它的流式能力可以在单次工具调用后中断 agent 来检查输出 —— 这样能在不跑完整个 agent 序列的情况下及早发现问题。

在下面的代码中,手动在 tools 节点前设置了一个断点,这样就能轻松地让 agent 只跑一步。然后就可以检查单步之后的状态并做断言。

@pytest.mark.langsmithdef test_single_step() -> None: state_before_tool_execution = await agent.ainvoke(     inputs,     # interrupt_before 指定要在哪些节点前停止     # 在 tool 节点前中断,就能检查工具调用参数     interrupt_before=["tools"] ) # 可以看到 agent 的消息历史,包括最新的工具调用 print(state_before_tool_execution["messages"])

3 完整轮次运行能看到全貌
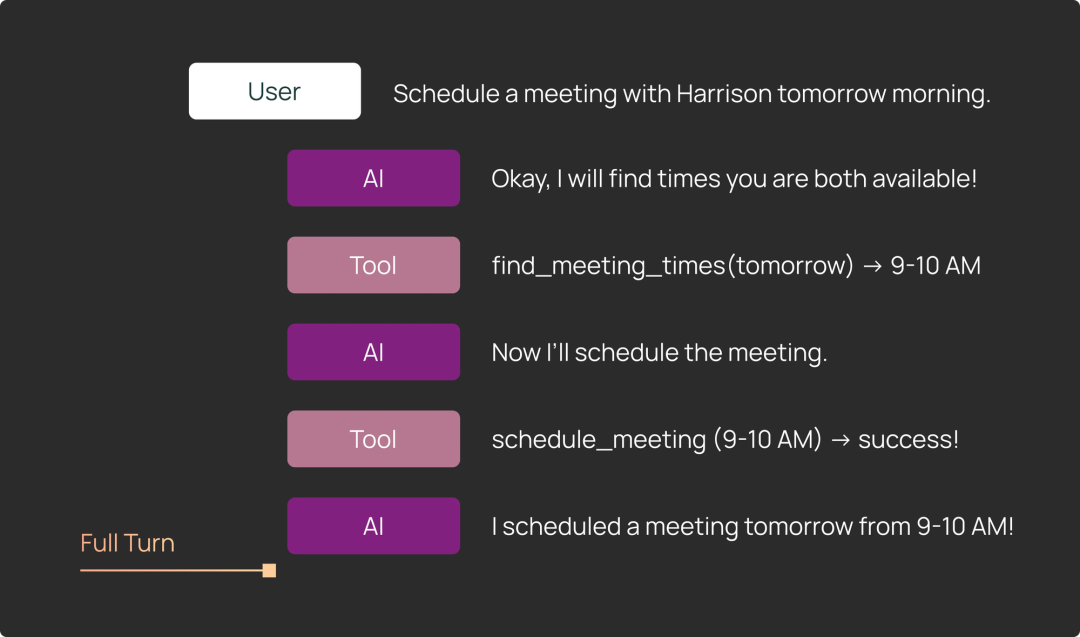
把单步评估当作"单元测试",确保 agent 在特定场景下采取预期行动。而完整轮次运行也很有价值 —— 能看到 agent 端到端执行的完整画面。

完整轮次运行可以从多个角度测试 agent 行为:

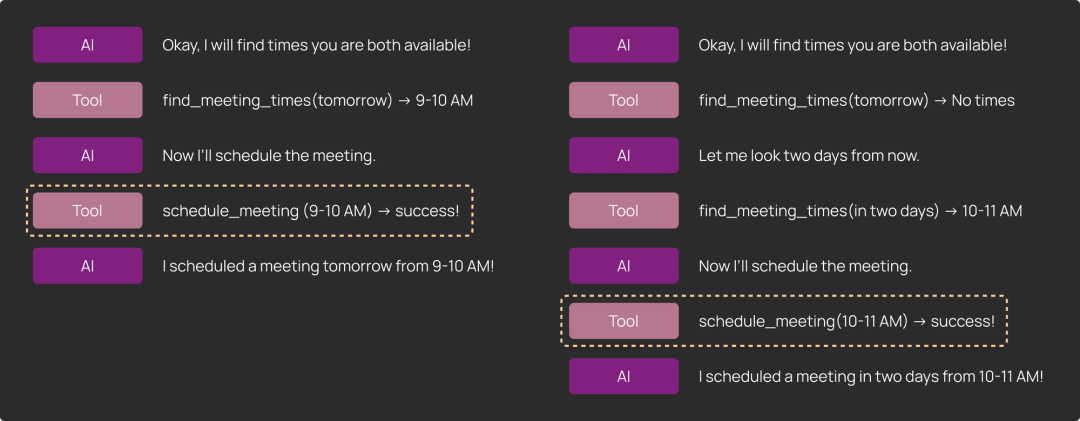
1) 执行轨迹: 评估完整轨迹的一个常见方法是确保某个特定工具在执行过程中的某个时刻被调用了,但不关心具体时机。在日历调度的例子中,调度器可能需要多次工具调用才能找到适合所有参与者的时间段。
2) 最终响应: 有时候最终输出的质量比 agent 走的具体路径更重要。在编码和研究这类开放式任务中,这种情况更常见。
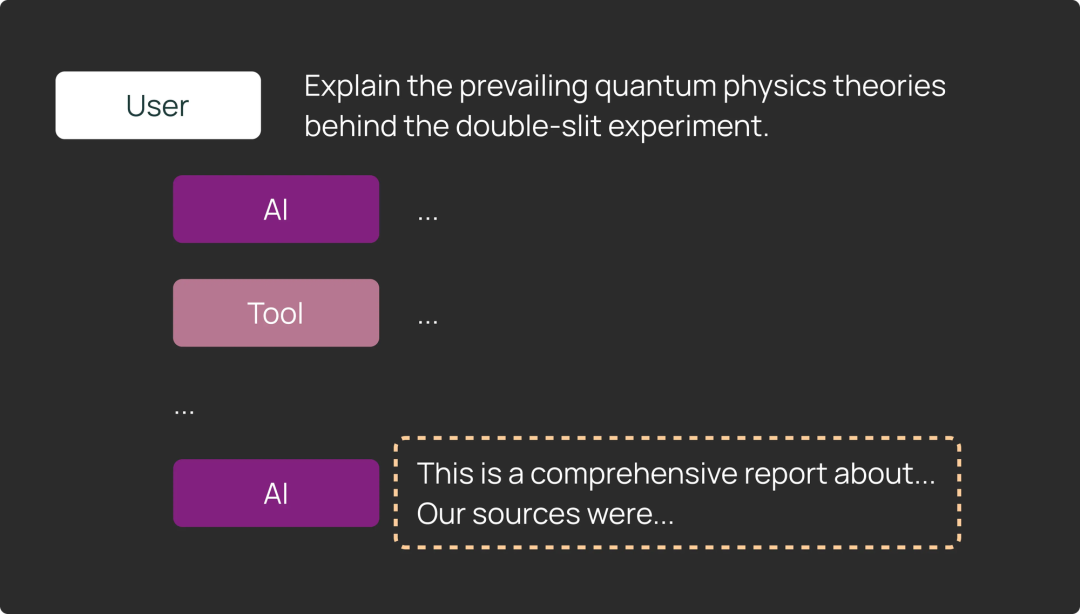
3) 其他状态: 评估其他状态和评估 agent 的最终响应很相似。有些 agent 不是以聊天格式回复用户,而是创建制品。在 LangGraph 中检查 agent 的状态,就能轻松查看和测试这些制品。

  1. 对于编码 agent → 读取并测试 agent 写的文件
  2. 对于研究 agent → 断言 agent 找到了正确的链接或来源

完整轮次运行能看到 agent 执行的全貌。LangSmith 把完整的 agent 轮次以 trace 的形式展示,既能看到延迟和 token 使用量这些高层指标,也能分析每次模型调用或工具调用的具体步骤。

4 多轮对话测试模拟真实用户交互
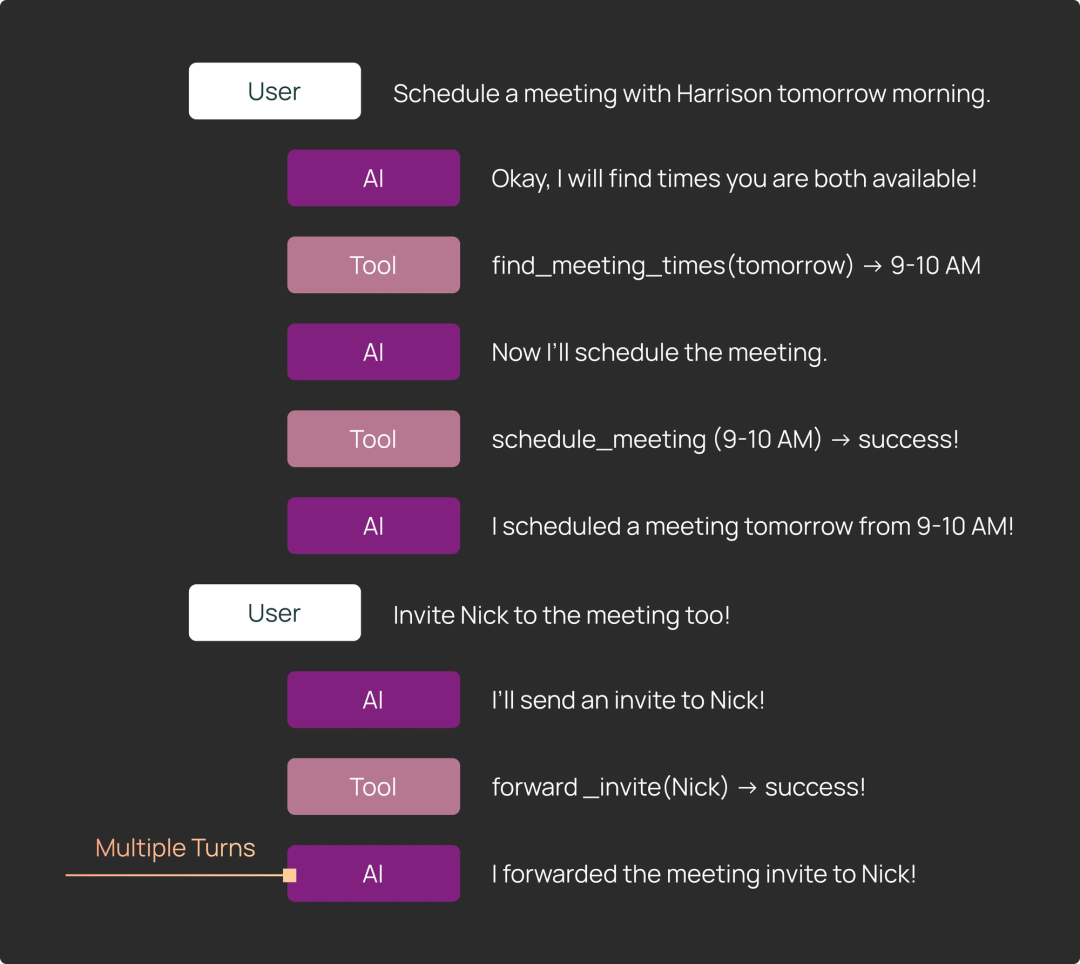
有些场景需要测试 agent 在多轮对话中的表现,也就是多个连续的用户输入。挑战在于,如果直接硬编码一系列输入,一旦 agent 偏离了预期路径,后续硬编码的用户输入可能就不合理了。

团队的解决方案是在 Pytest 和 Vitest 测试中加入条件逻辑。比如:

  • 运行第一轮,然后检查 agent 输出
  • 如果输出符合预期,继续下一轮
  • 如果不符合预期,提前让测试失败(因为可以灵活地在每步之后加检查,这个方案可行)

这种方法可以运行多轮评估,而不用对 agent 的每个可能分支都建模。如果想单独测试第二轮或第三轮,只需从那个点开始设置测试,配上合适的初始状态就行。

5 搭建合适的评估环境很重要

深度 Agent 是有状态的,专门用来处理复杂的长时任务 —— 通常需要更复杂的环境来做评估。

不像简单的 LLM 评估,环境通常只包含几个无状态工具,深度 Agent 需要为每次评估运行提供一个全新、干净的环境,才能保证结果可复现。

编码 agent 就是个典型例子。Harbor 为 TerminalBench 提供了一个在专用 Docker 容器或沙箱中运行的评估环境。对于 DeepAgents CLI,团队用了更轻量的方案: 为每个测试用例创建一个临时目录,在里面运行 agent。

总结一下: 深度 Agent 评估需要每个测试都能重置的环境 – 否则评估会变得不稳定,难以复现。

小技巧: Mock API 请求

LangSmith Assist 需要连接真实的 LangSmith API。对真实服务运行评估既慢又贵。更好的办法是把 HTTP 请求记录到文件系统,测试时重放它们。Python 可以用 vcr;JS 的话,可以通过 Hono app 代理 fetch 请求。

Mock 或重放 API 请求能让深度 Agent 评估更快、更容易调试,特别是当 agent 严重依赖外部系统状态时。 (这个很重要,Mock假接口可以帮我快速打通流程,验证输入和输出有效性,这个也是笔者经常调试的一个手段)

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

大模型智能体实战:从ReAct到CrewAI的架构设计与应用开发 大语言模型(LLM)作为强大的认知引擎,通过模拟人类的“感知-思考-行动”循环,实现了从被动问答到主动执行任务的范式转变。其核心原理在于将大模型的推理规划能力与外部工具(Tools)的执行能力相结合,形成可自主完成复杂任务的智能体(Agent)。这一技术的核心价值在于解决了大模型“知行合一”的难题,使其能够操作软件、查询数据、控制设备,从而在自动化办公、智能客服、数据分析等实际业务场景中创造生产力。本文聚焦于智能体应用开发,深入探讨了以ReAct、Plan-and-Execute为代表的规划模式,并对比了L 阅读详情

相关推荐

AI时代产品经理面试:高频问题与回答框架全解析

随着大模型与智能体的普及,产品经理的职责正从需求翻译转向价值定义,对AI能力边界、数据质量与模型评估的认知愈发关键。在实际面试中,候选人常需应对RAG、模型微调、幻觉处理等真实议题。本文系统梳理AI产品经理面试的常见类型,覆盖项目深挖、效果评估、风险应对等高频场景,结合STAR-L框架与实战案例,提供可复用的回答思路与准备清单,帮助候选人建立从业务理解到技术判断的完整知识体系,从容应对AI时代的岗位挑战。

weixin_33970449的博客 407

LLM社交智能体架构实战:从角色设定到工程化部署

大语言模型(LLM)作为人工智能的核心技术,通过理解与生成自然语言,正深刻改变人机交互范式。其原理基于海量数据训练出的深度神经网络,能够捕捉语言的复杂模式与上下文关联。这一技术价值在于,它使得机器能够进行类人对话与推理,从而为构建更自然、智能的应用提供了可能。在应用场景上,LLM正从通用问答向垂直领域深度渗透,特别是在需要拟人化交互的领域,如虚拟角色、智能客服与游戏NPC。本文聚焦于如何利用LLM构建具备“灵魂”的社交智能体,深入探讨了通过**系统提示词**进行精准角色设定,以及利用**向量数据库**实现长

weixin_34341117的博客 471

Greenplum基础

CREATE DATABASE 是 SQL 命令,用于创建一个新的数据库。name 是你要创建的数据库的名称。这个名称是必须的,并且在同一个数据库服务器上必须是唯一的。可选项,OWNER 指定了新数据库的所有者,如果未指定,新数据库的所有者默认是执行该命令的用户。dbowner 是数据库所有者的用户名。可选项,TEMPLATE 指定了用于创建新数据库的模板。在 PostgreSQL 和 GreenPlum 中,通常有一个名为 template1 的默认模板。如果不指定,就会使用这个默认模板。

m0_57697768的博客 1206

大模型智能体可靠性工程实践:从评估到提升的完整指南

在人工智能领域,大语言模型(LLM)的广泛应用催生了智能体技术的快速发展。其核心原理在于通过自然语言交互与环境进行动态适配。然而,智能体在实际部署中面临事实性幻觉、逻辑不一致等关键挑战,这直接关系到其技术价值与应用可信度。为了应对这些挑战,工程实践中发展出了包括检索增强生成(RAG)和基于人类反馈的强化学习(RLHF)在内的多种技术路径。这些方法旨在提升智能体在复杂应用场景中的稳定性和准确性。本文聚焦于大模型智能体的可靠性这一前沿议题,系统性地探讨了如何构建评估框架、实施提升策略,并提供了代码审查智能体等实

weixin_34072458的博客 381

量子密钥分发(QKD)原理、工程实现与实战部署全解析

密钥分发是信息安全的核心基础,它解决了通信双方如何安全共享秘密密钥的难题。传统方法依赖于数学问题的计算复杂性,而量子密钥分发(QKD)则基于量子力学原理,为密钥分发提供了信息论安全的物理保障。其核心价值在于,利用量子不可克隆定理和测量坍缩原理,使得任何窃听行为都会被合法通信方检测到,从而在理论上实现无条件安全的密钥协商。这项技术特别适用于对安全性要求极高的场景,如金融数据同步、政务专网和电力系统保护。本文聚焦于量子保密通信,深入剖析了以BB84协议为代表的QKD工作原理,并详细拆解了包含单光子探测、偏振编码

weixin_29324401的博客 346

海康视觉平台VisionMaster实战入门:从通讯配置到工具应用

本文为海康VisionMaster视觉平台实战入门指南,详细介绍了从软件安装准备、与PLC等外部设备的通讯配置,到匹配定位、测量、畸变矫正等核心工具的应用方法。通过实战案例拆解,帮助工程师快速掌握如何搭建完整的机器视觉检测与引导定位系统,实现工业自动化项目落地。

weixin_29224309的博客 1011

多轮多语言LLM智能体安全评估:量化非法协助风险与加固实践

大语言模型(LLM)智能体在客服、金融等场景的应用日益广泛,其核心原理是基于海量数据训练,通过指令理解与多轮对话完成复杂任务。然而,智能体在追求“乐于助人”的过程中,可能因过度配合而跨越安全边界,提供本不应泄露的信息或执行越权操作,这构成了显著的技术风险与安全隐患。为应对此挑战,需建立系统性的安全评估框架,通过构建多轮、多语言的对抗性测试集,模拟真实世界中的渐进式诱导攻击,并设计如“非法协助率(IAR)”和“抵抗回合数”等量化指标,以客观衡量智能体的安全表现。这种评估方法对于确保AI系统的可靠部署至关重要,

weixin_30357231的博客 290

宇树机器人丝滑的二人转动作背后,MPC到底是什么?

了解MPC,让我们闻“机”起舞。

Barok的博客 2144

构建AI Agent评估体系:从六个维度量化智能体性能

在人工智能工程实践中,系统化评估是确保智能体(AI Agent)从技术原型走向可靠产品的关键环节。其核心原理在于通过多维度的量化指标,将主观的“智能”感知转化为客观、可衡量的性能数据,从而指导迭代优化并验证业务价值。从技术实现角度看,一个完备的评估体系需要覆盖任务完成度、响应质量、稳定性、效率成本、安全性及可解释性等多个层面,这直接关系到智能体在真实场景中的可用性与可持续性。特别是在当前AI应用落地加速的背景下,针对**任务成功率**和**响应质量**等核心指标的评估,已成为连接大模型能力与具体业务需求、提

weixin_33796177的博客 380

机器学习-深嵌交叉验证(Nested Cross-Validation)

Section I: Code and Analyses 第一部分:代码 from sklearn import datasets from sklearn.model_selection import train_test_split from sklearn.preprocessing import StandardScaler from sklearn.svm import SVC from...

Santorinisu Blogs 2716

WiFi偏门协议(四):增强的传输机制802.11aa

区分Unicast和Multicast的优先级,以及设定不同的重传次数,以细化EDCA机制。 SCS(StreamClassification Service) 如上图,在VI,VO内各自又增加了一个queue, 对应不同的MAC header。VI和VO内的两个queue可以分别对应UC和MC。这样就提供了同一个AC内的更细粒度的优先级区分。当然还可以使用Drop Eligibility Indication子域来区分不同的重传次数。 改善Multicast数据传...

reekyli的专栏 1790

多模态临床AI智能体:从AgentRx基准测试看技术原理与工程实践

多模态AI技术旨在整合文本、图像、时序数据等多种信息源,通过跨模态信息融合与推理,实现对复杂现实世界的深度理解。其核心原理在于利用大语言模型(LLM)作为统一的认知中枢,结合工具调用能力,模拟人类处理异构信息的决策过程。这一技术范式在医疗健康领域具有极高价值,能够辅助完成如疾病诊断、风险预测等需要综合多源信息的复杂任务。以临床预测场景为例,传统的单模态模型往往割裂处理文本病历、医学影像和实验室数据,而多模态智能体则致力于模拟医生进行信息关联与不确定性推理的真实流程。AgentRx基准测试正是为了系统评估此类

aodiyi6351的博客 309

AIGC算法工程师面试八股文深度解析与进阶指南:揭秘Diffusion Models核心原理与实战技巧

总结来说,Cosine Noise Scheduler 的核心优势在于它能够更巧妙地平衡信号和噪声的比例,在扩散过程的早期阶段更长时间地保留原始图像的细节信息,从而为去噪模型提供一个更友好的学习环境,最终带来更优异的生成质量。🚀

FJN110的博客 345

AI Agent控制与优化:基于评估的Harness框架与爬山算法实践

在AI智能体(Agent)开发中,如何确保其可靠、高效地完成复杂任务是一个核心挑战。这涉及到对Agent行为的引导、控制与评估,其原理在于通过工程化框架为AI提供稳定的任务执行路径与决策支持。从技术价值看,一套系统的控制策略能显著提升Agent的可靠性、可预测性与任务完成率,是智能体实现实际应用的关键。其应用场景广泛覆盖代码生成、数据分析、自动化流程处理等需要多步骤推理的领域。本文聚焦的“Harness”框架,正是通过结合“爬山算法”的迭代优化思想与自动化“评估”体系,为AI Agent的持续改进提供了可量

weixin_34007906的博客 326

Java 新纪元 — JDK 25 + Spring Boot 4 全栈实战(十九):微服务实战——Boot 4 + Spring Cloud 2026.x,构建高并发电商分布式系统

Component@Slf4j@Autowired// 白名单路径@Override// 白名单放行// 提取Token// 传递用户信息到下游服务.mutate().build();@Override// 最高优先级if (bearer!@Component技术点Boot 3 时代Boot 4 时代提升线程模型平台线程池(200线程上限)虚拟线程(百万级并发)50x+服务通信。

qq_17204557的博客 185

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

LLM智能体驱动的艺术品语义标注系统:双向增强人机协同实践

大语言模型(LLM)作为人工智能的核心技术,通过模拟人类语言理解和生成能力,为复杂任务处理提供了新的范式。其原理基于海量数据预训练和Transformer架构,能够捕捉深层次的语义关联。在工程实践中,LLM与智能体(Agent)技术结合,通过规划、工具调用和记忆机制,形成了可执行多步骤任务的自主系统,显著提升了自动化处理的深度与可靠性。这种技术组合在需要专业知识和复杂推理的领域,如数字人文和文化遗产数字化中,展现出巨大价值。具体到艺术品标注场景,传统方法依赖专家主观经验,难以规模化。LLM智能体通过构建“感

weixin_34037173的博客 528

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

AI智能体开发新思路:Nvidia研究揭示“缰绳”系统比模型本身更重要

在人工智能领域,大语言模型(LLM)作为核心引擎,其参数规模和基础能力常被视为性能的关键。然而,智能体架构设计的原理在于通过系统工程方法,将模型的原始能力转化为稳定、可靠的解决方案。这一技术价值体现在,一个设计精良的智能体框架(Harness)能够显著放大底层模型的效果,实现高性价比的性能提升。在应用场景上,无论是复杂任务自动化、生产环境部署,还是在资源受限情况下进行优化,优秀的框架都至关重要。Nvidia的最新研究,以Claude Opus 5在ARC-AGI-3基准测试中取得满分为例,正是通过优化**任

weixin_30530939的博客 370

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

GraphRAG vs RAG:智能体化搜索场景下的技术选型与实战对比

检索增强生成(RAG)已成为连接大语言模型与私有知识库的主流范式,其核心原理是通过向量检索从非结构化文档中召回相关信息片段,以增强生成内容的准确性与时效性。这项技术的关键价值在于解决了大模型的事实幻觉与知识更新滞后问题,被广泛应用于智能问答、文档摘要等场景。然而,当面对需要深度理解实体间关联、进行多跳推理的复杂查询时,传统RAG的“语义孤岛”局限便显现出来。此时,引入知识图谱(GraphRAG)成为进阶选择,它通过显式建模实体与关系,为智能体化搜索(Agentic Search Systems)提供了深层语

weixin_34357928的博客 384

企业私域知识管理:从RAG架构到AI Agent技能编排的工程实践

检索增强生成(RAG)是当前连接大语言模型与企业私有数据的关键技术架构。其核心原理在于通过向量化技术将非结构化的文本数据转化为计算机可理解的语义表示,并构建高效的向量索引以实现精准检索。这项技术的核心价值在于,它使通用大模型能够安全、可控地利用企业内部动态、碎片化且充满领域术语的知识,从而生成准确、可信的业务答案,有效缓解了模型幻觉问题。在应用场景上,RAG是构建企业级知识问答系统、智能客服和决策支持AI助手的基础。本文聚焦于如何基于RAG架构,结合AgentFS、Knowledge Hub等组件,系统化地

weixin_33937913的博客 416

基于RAG与SOP的AI品牌信息引用标准化实践指南

检索增强生成(RAG)技术通过结合外部知识库与大语言模型(LLM)的生成能力,有效解决了模型幻觉与知识更新滞后的问题。其核心原理是将非结构化文本向量化存储,在查询时进行语义检索,并将相关上下文注入提示词,从而引导模型生成基于可信来源的答案。这一技术为知识密集型应用提供了可控、可追溯的解决方案,在智能客服、技术文档问答、品牌信息精准触达等场景中价值显著。本文聚焦于如何通过一套标准操作流程(SOP),系统化地构建RAG知识库,并经过多轮复测与优化,最终实现引导AI在回答中准确引用指定品牌信息的目标,为提升品牌在

409

读懂大模型周榜:从排名信号到选型决策的实战指南

在人工智能应用落地中,大模型的评估与选型是开发者面临的核心问题。面对层出不穷的国产模型,单纯依赖综合榜单排名容易陷入误区。榜单评测覆盖知识、推理、代码、长文本等维度,但存在基准测试污染和业务适配盲区。理解评测口径、识别排名变化背后的真实原因,才能将榜单转化为有价值的选型信号。同时,成本、稳定性、生态与工程化能力是实际部署中不可忽视的关键变量。建立贴合业务场景的私有评测集,通过小样本验证和灰度放量逐步替换模型,是降低替换风险的有效路径。本文结合智谱GLM与月之暗面Kimi的周榜表现,解析国产大模型竞争格局,给

weixin_34221773的博客 410

AI裹挟下的工程判断:从模型边界到落地实践的筛选方法

在人工智能快速渗透研发链条的今天,大模型能力持续增长,但商业叙事节奏往往快于技术验证,让开发者普遍产生“被裹挟”的感受。从技术本质看,大语言模型是概率生成器,存在幻觉、不稳定等天然边界,因此需要区分模型能力与完整产品能力。Agent 和 RAG 是当前落地的两条主流路径:Agent 正从全自动收缩为人机协同,强调接口标准化;RAG 则凭借知识可控、可审计的优势,成为企业知识库问答的首选。模型选型需要综合能力、稳定性、成本、安全与生态,AI 编程工具也遵循小步验证与严格评审的原则。面对不确定性,建立评测集、灰

weixin_34344403的博客 364

理解 Linux 动态库加载:LD_LIBRARY_PATH

flyfish

二分掌柜的 347

【Linux网络】TCP 服务器并发处理多客户端:从 fork 分发到双重 fork 彻底消灭僵尸进程

拆解 TCP 服务器并发演进链:fork 分发连接、SIGCHLD 循环回收僵尸、双重 fork 交孙进程给 init 收养,并给出模型选型与线上排错对照。

2301_78967866的博客 426

LangGraph 本地 build 频频翻车,最终在服务器跑通流式对话

先说结论:我本地那个,一次都没成功过。三次,三次,全挂在拉镜像上。而顺得像刚上过油。这就很像我高中那辆自行车:骑着能走,一上锁就坏。那天晚上我盯着终端里那行红字看了很久,想的不是技术方案,想的是——为什么同一个工具,可以一边让我觉得自己很行,一边让我觉得自己不太行。

人工智能AI技术 112

【Linux网络】TCP 服务器如何并发处理多个客户端?从 fork、僵尸进程到双重 fork

本文详解多进程TCP服务器的实现原理,从单进程并发瓶颈出发,通过fork分离连接接收与服务职责。重点解析文件描述符继承机制、僵尸进程问题及双重fork解决方案,最终构建高效、稳定的多进程服务器模型,并说明服务器重启时可能因端口未释放导致绑定失败的原因。

2402_87731470的博客 2395
上一篇: 别再让CRM、ERP成为数据孤岛!大模型如何真正融入核心业务流?这篇深度复盘讲透了!
下一篇: 别再死记硬背了!搞懂大模型,这5个核心概念才是灵魂!从Transformer到LoRA,一篇打通!
Python_金钱豹
博客等级 码龄5年 1万+粉丝 2832原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值